目录
前言
学习赵老师讲授的强化学习的数学原理视频,本篇文章记录第八讲 Part 2:值函数近似(原理-目标函数介绍),记录个人学习笔记,和大家一起分享交流😄
1. Objective function
通过刚才的 motivating example,相信大家对 value function approximation 有了一些直观的理解。下面正式介绍本讲第二节,它又包含很多小节,这一小节在本次课中非常重要,因为它 揭示了 value function approximation 的思想以及很多概念和细节,理解这一节后,后面再学习第 3、4、5 部分的算法就容易很多。
下面先看 objective function。
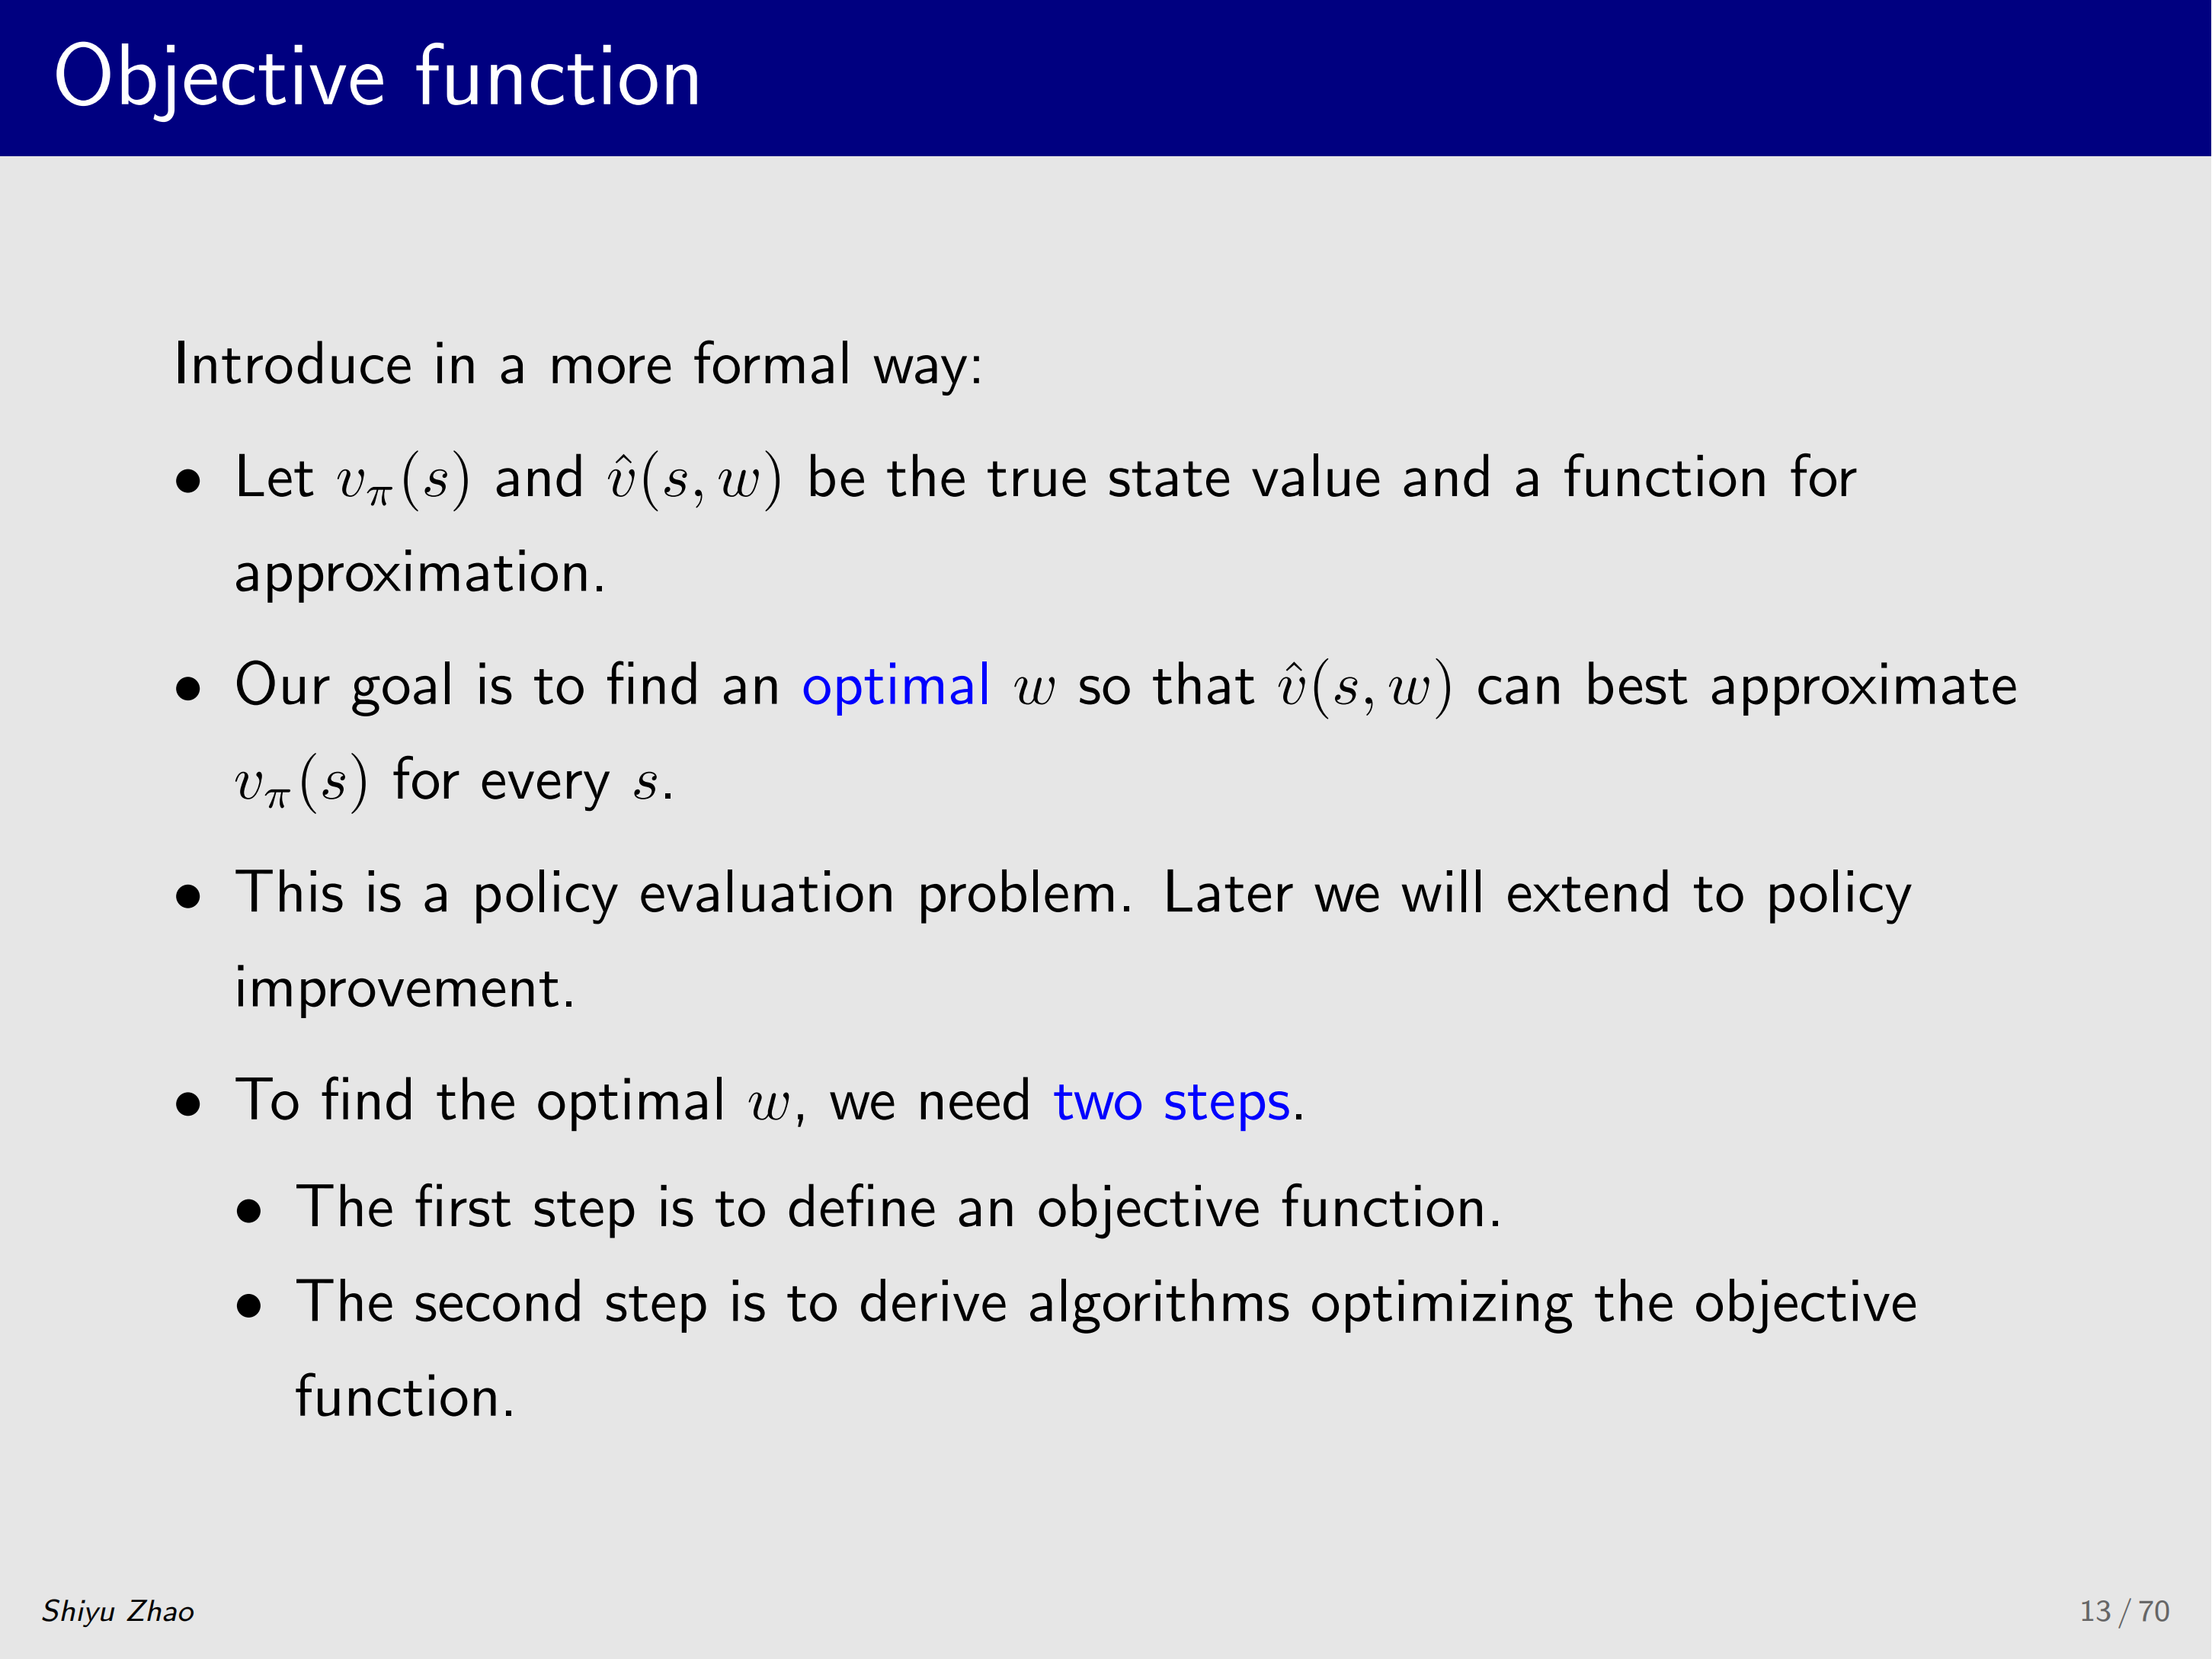
首先, v π ( s ) v_{\pi}(s) vπ(s) 是 s s s 真实的 state value , v ^ \hat{v} v^ 是它的估计值,我们的目标就是 让估计值尽可能接近真值 ,当 v ^ \hat{v} v^ 的结构确定时,比如之前的线性函数(直线、抛物线)或神经网络---当结构确定时,剩下能调节的就是 w w w 。
我们要做的就是 找到一个最优的 w w w ,让 v ^ \hat{v} v^ 尽可能接近 v π v_{\pi} vπ ,所以这实际上就是 policy evaluation 问题 ,因为给定一个策略,我们要找到一个近似函数 v ^ \hat{v} v^ 尽可能地去接近它真实的 state value,之后再推广到 action value、推广到怎么找最优策略。
一步一步来,我们先看怎么样做 policy evaluation。这和上节课介绍的 TD 算法一样,下面我们的目标就是 找最优的 w w w ,怎么找呢?
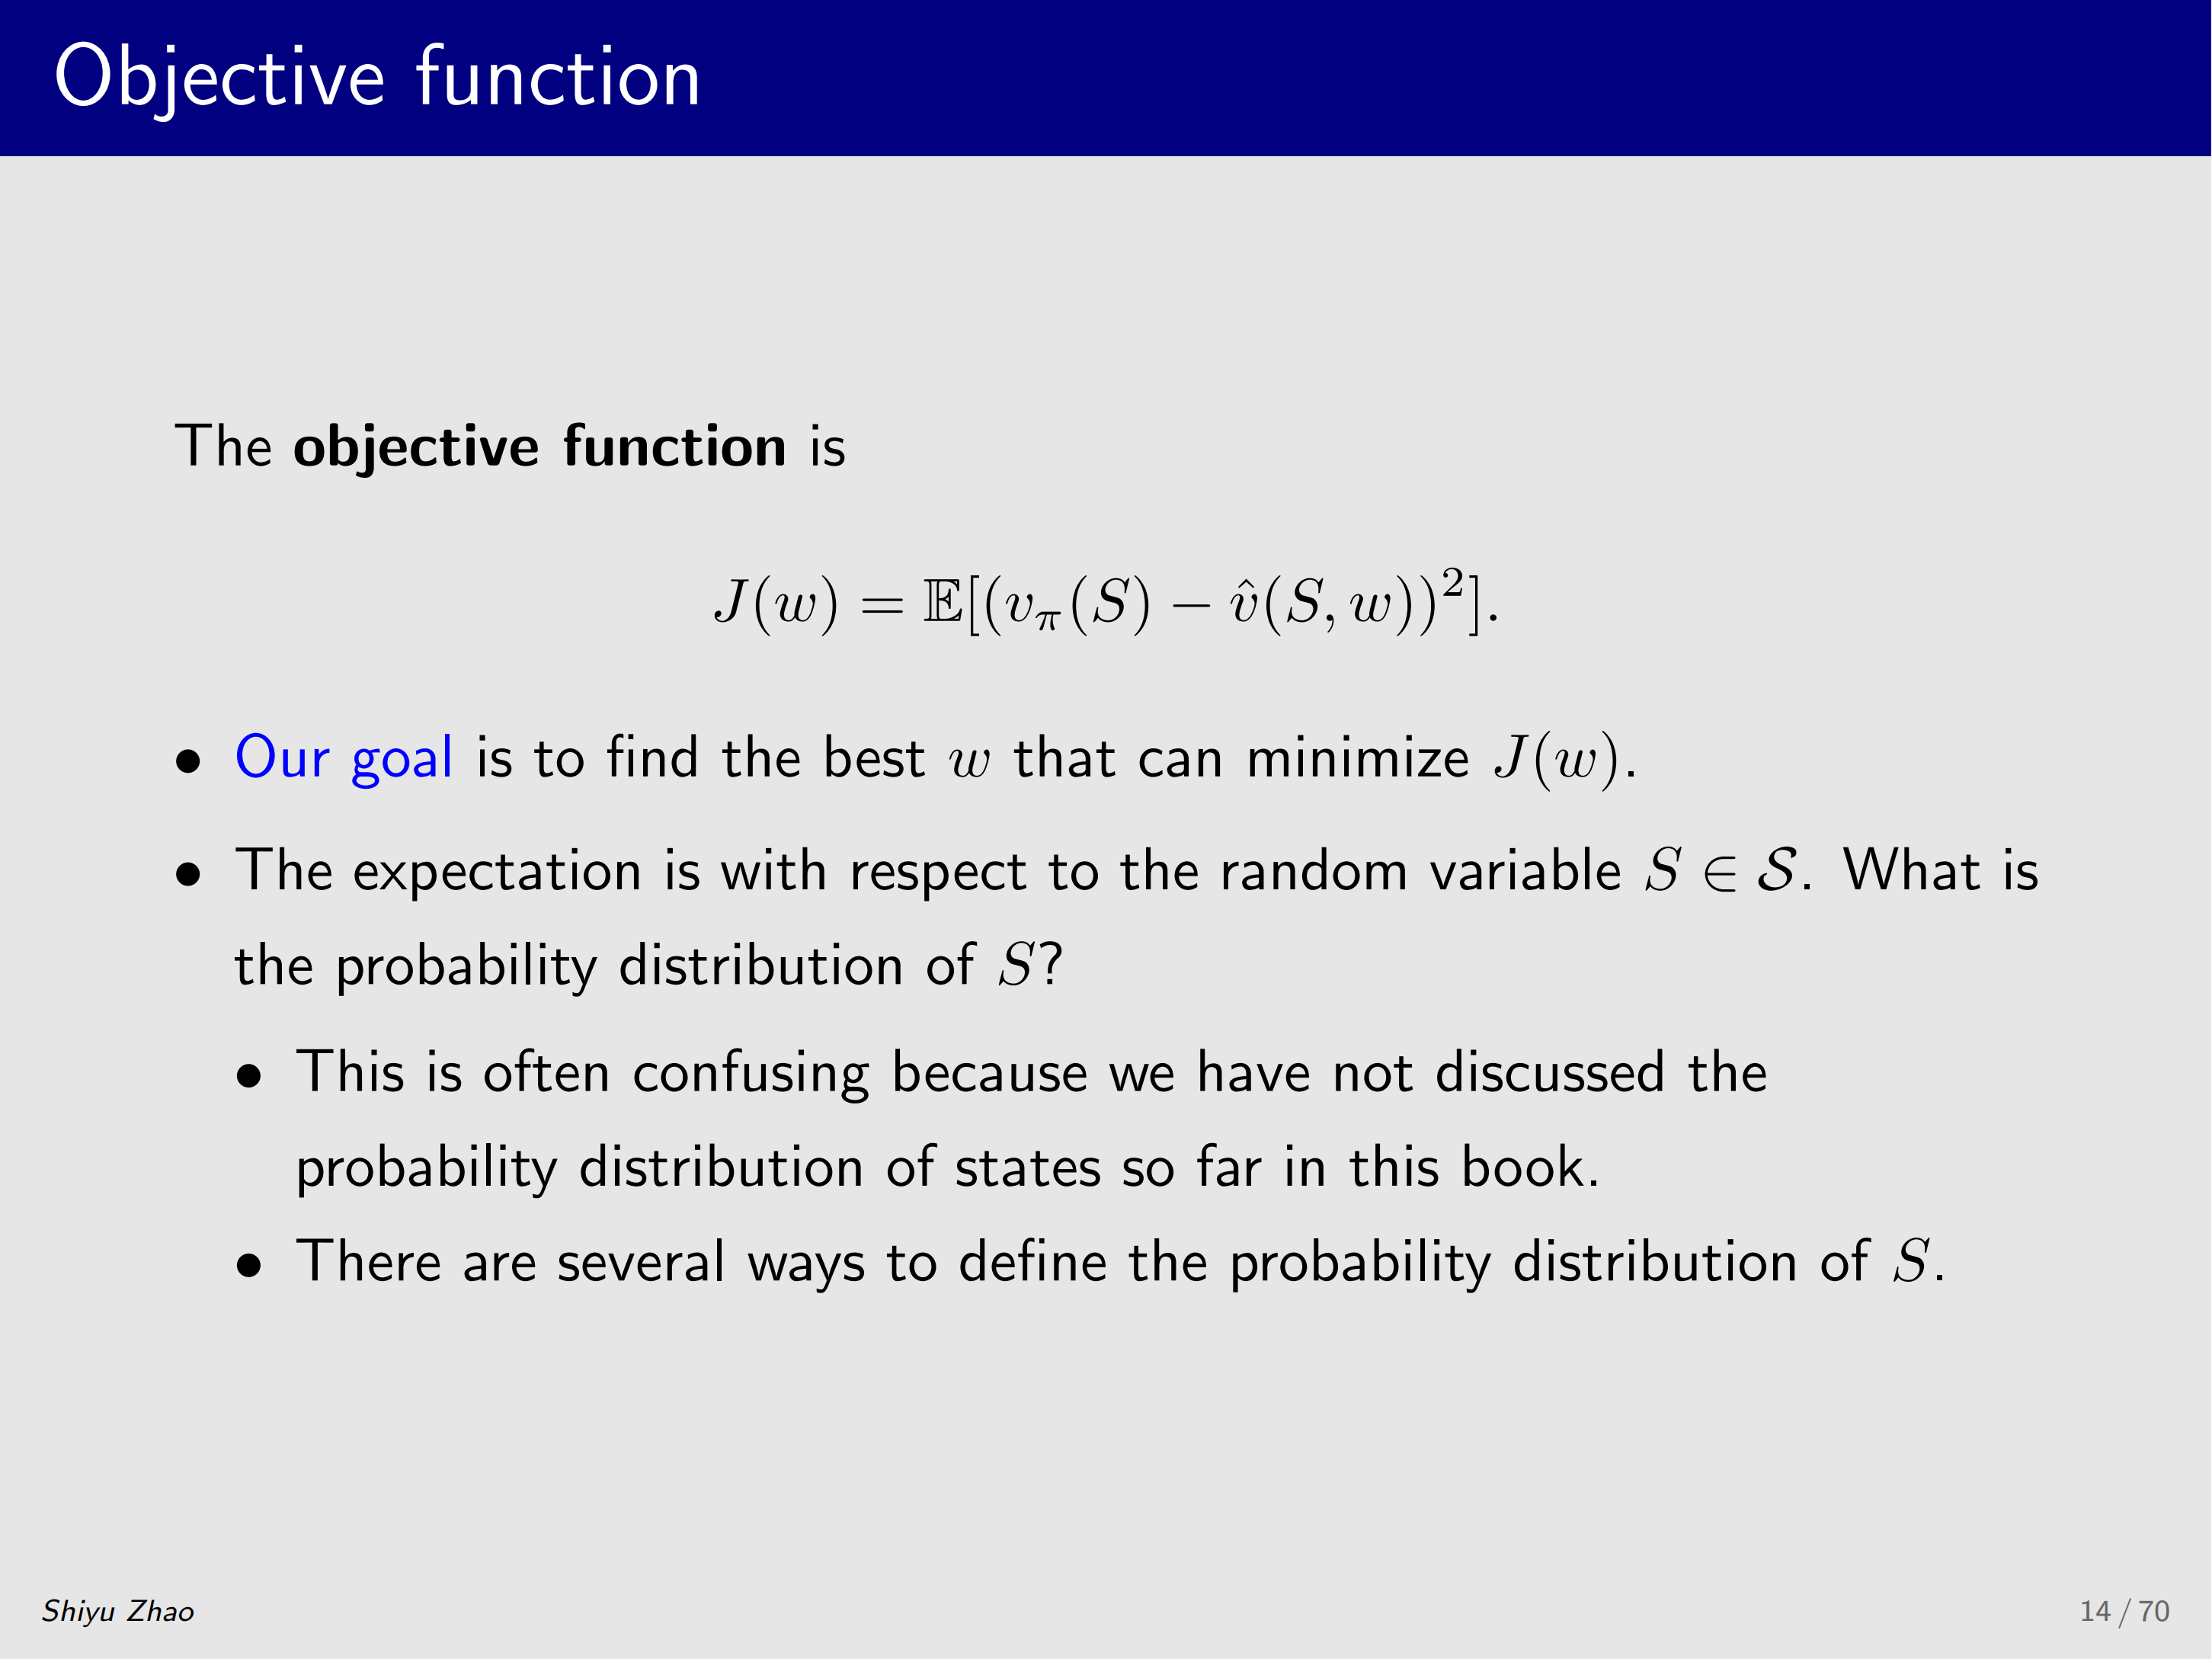
分两步,第一步:正式定义目标函数;第二步:优化目标函数,先来看怎么定义目标函数:
J ( w ) = E ( v π ( S ) − v \^ ( S , w ) ) 2 J(w) = \mathbb{E}(v_{\\pi}(S) - \\hat{v}(S,w))\^2 J(w)=E(vπ(S)−v\^(S,w))2
这就是 value function approximation 的目标函数 J ( w ) J(w) J(w) , w w w 是待优化的参数。它等于一个期望,里面是 state value 真值与估计值之差的平方,我们的目标是找到最优 w w w 使目标函数最小。
值得指出:S S S 是一个随机变量,随机变量一定有 probability distribution ,那么 S S S 的概率分布是什么呢?换个角度问:这里不是有 expectation 吗?expectation 本质上是做平均---对所有状态求平均时,该如何加权呢?这是同一问题的两种问法。
很多初学者初次接触 value function approximation 时,可能会对这个概率分布感到迷惑,所以下面重点介绍。其实有几种方法,这里介绍两种:第一种非常直观、最容易想到--- uniform distribution(均匀分布)。
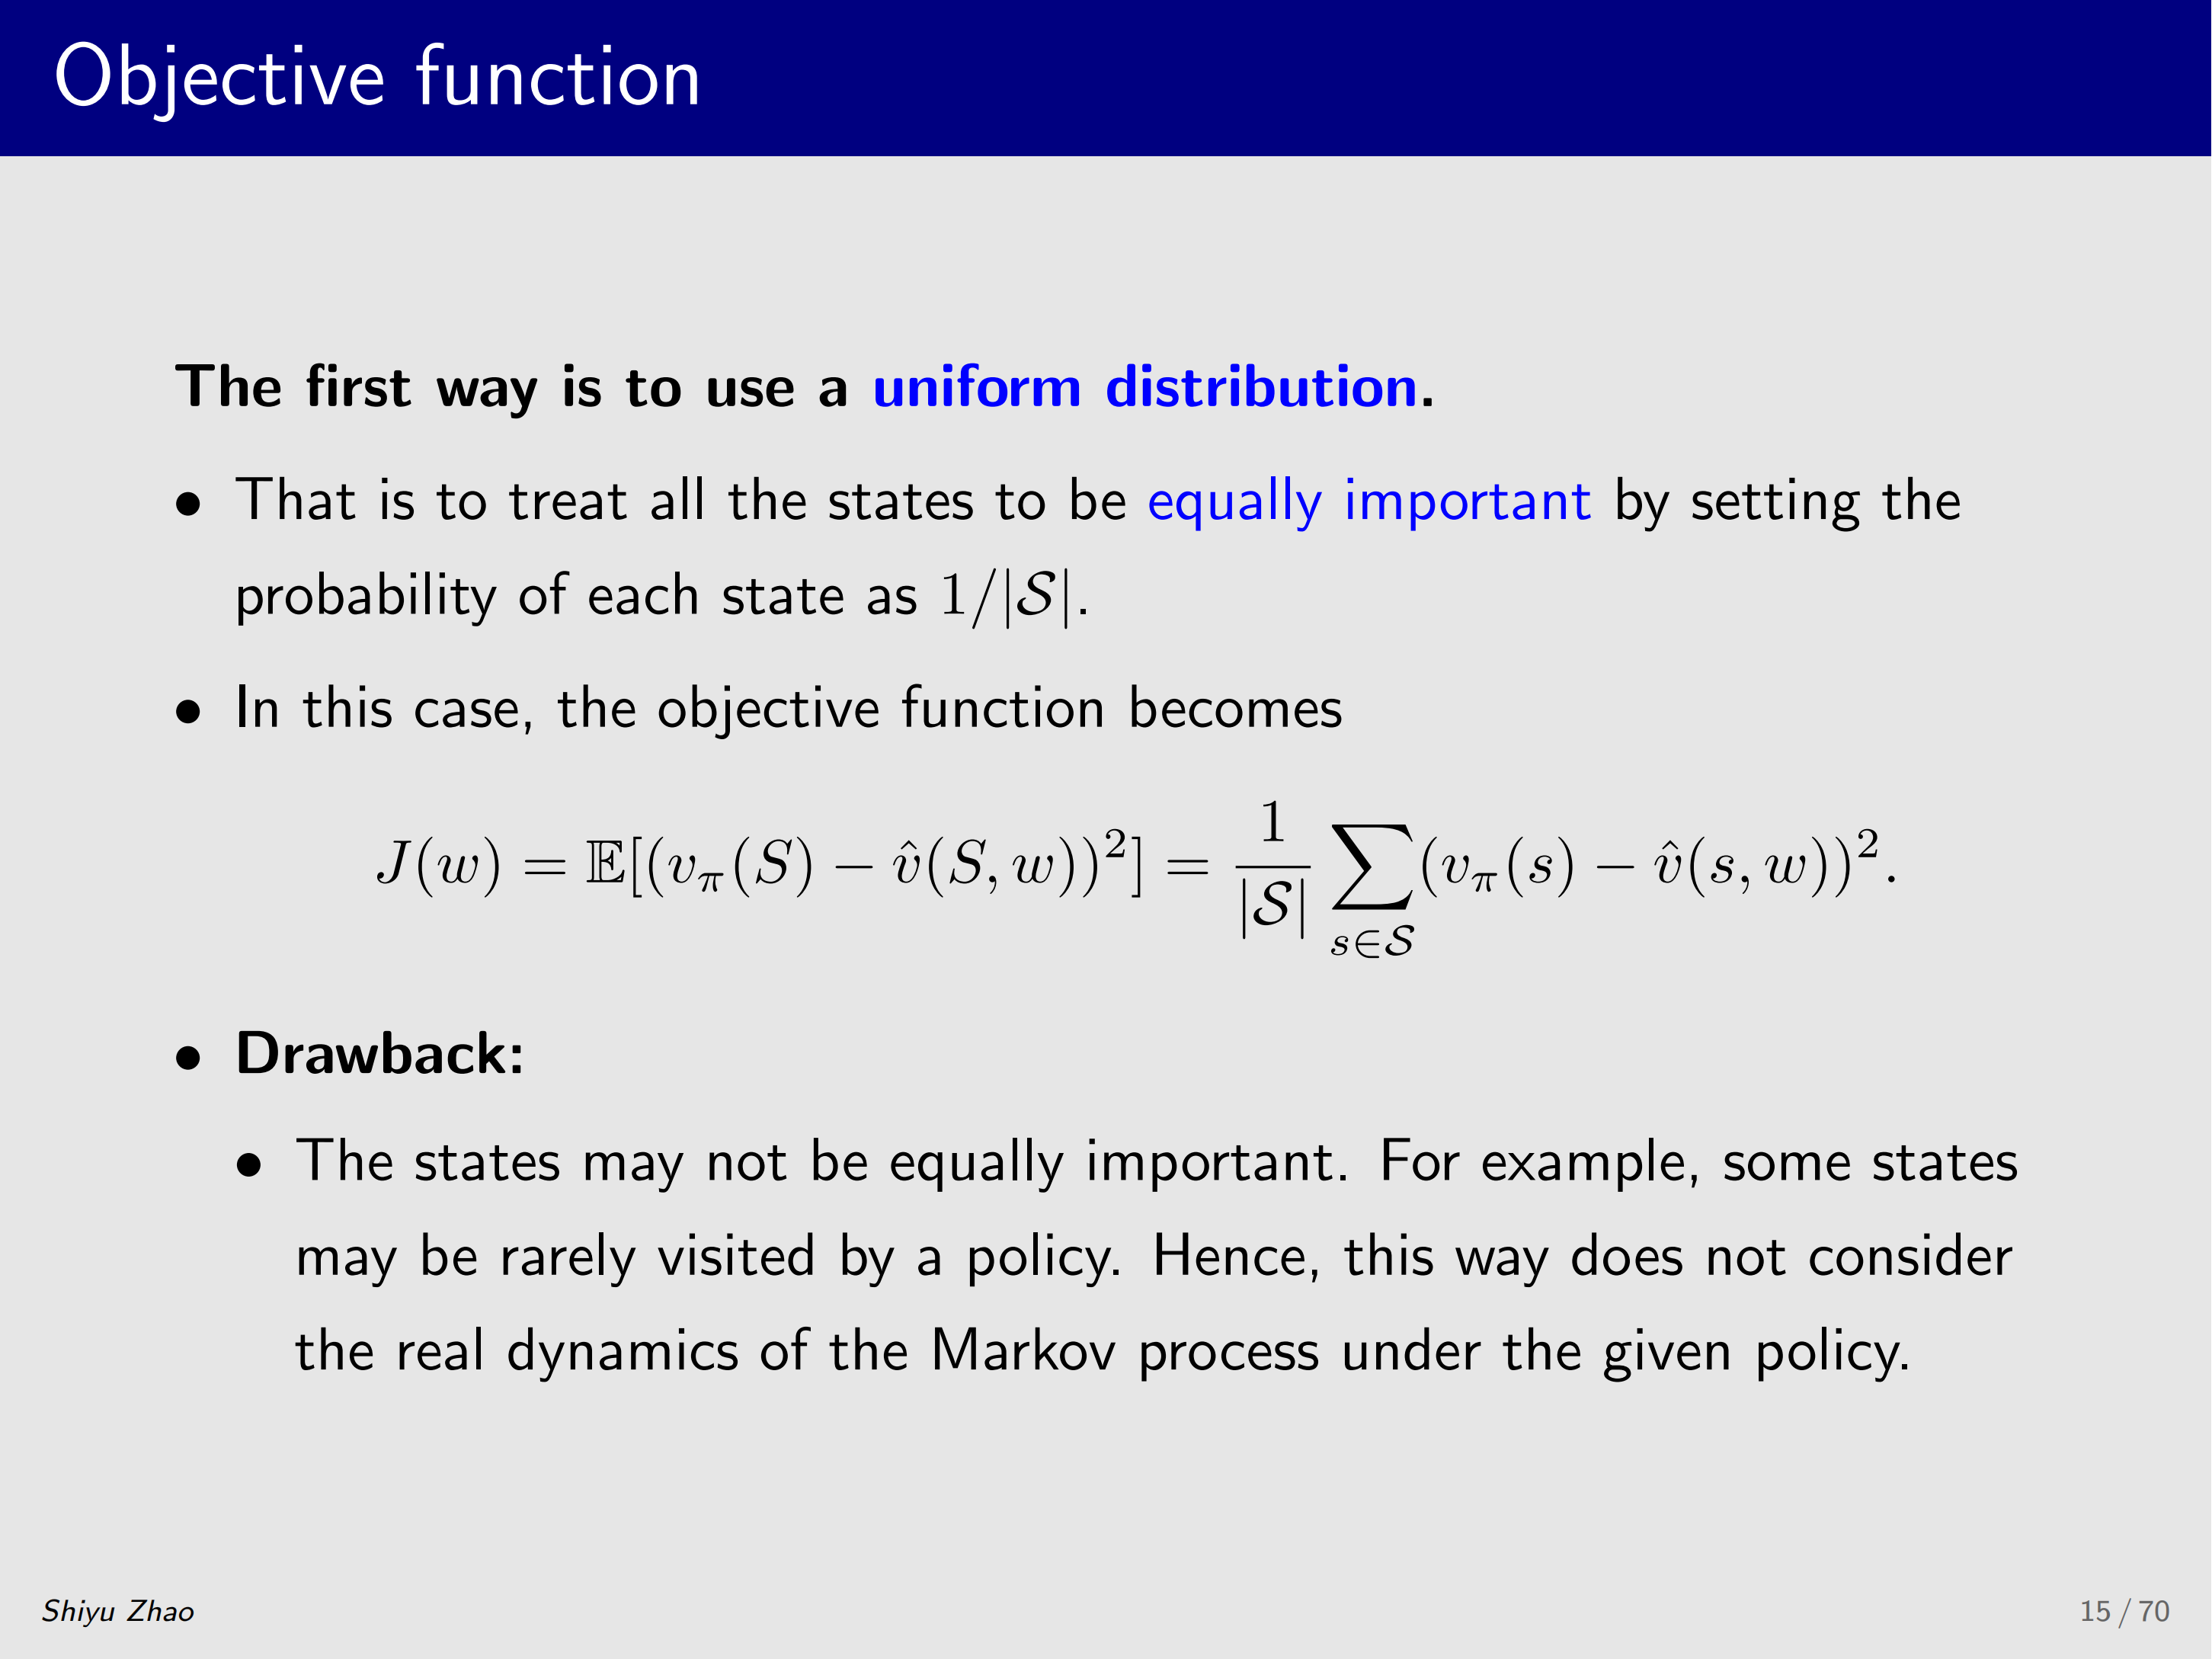
J ( w ) = E ( v π ( S ) − v \^ ( S , w ) ) 2 = 1 ∣ S ∣ ∑ s ∈ S ( v π ( s ) − v ^ ( s , w ) ) 2 . J(w) = \mathbb{E}(v_\\pi(S) - \\hat{v}(S, w))\^2 = \frac{1}{|\mathcal{S}|} \sum_{s \in \mathcal{S}} (v_\pi(s) - \hat{v}(s, w))^2. J(w)=E(vπ(S)−v\^(S,w))2=∣S∣1s∈S∑(vπ(s)−v^(s,w))2.
它是把所有的状态视为 equally important(同等重要) ---每个状态的概率(即求平均时的权重)都一样。假设共有 n n n 个状态,那么每个状态的概率/权重为 1 / n 1/n 1/n ,此时对目标函数求 expectation,根据定义就得到右边这个式子:每个状态权重相同, 1 / ∣ S ∣ 1/|\mathcal{S}| 1/∣S∣ 可提到求和号外---这个值就是所有状态估计误差的平方和再求平均。
虽然均匀分布非常直观,但有一个问题:那就是这里假设 所有状态平等、同等重要,但实际中可能不是这样 。比如我们的目标是从某个状态出发到达目标状态,那么目标状态和接近目标的状态更重要;相反,有些离目标很远的状态就不太重要。我们肯定希望 给重要状态更大的权重,更大权重意味着它们估计的误差更小;不重要状态的权重小,即使估计误差大也没关系(反正可能不会访问到、或很少访问到)。
有了这个想法,我们来引入第二个概率分布: stationary distribution,它也是 value function approximation 中使用的分布。
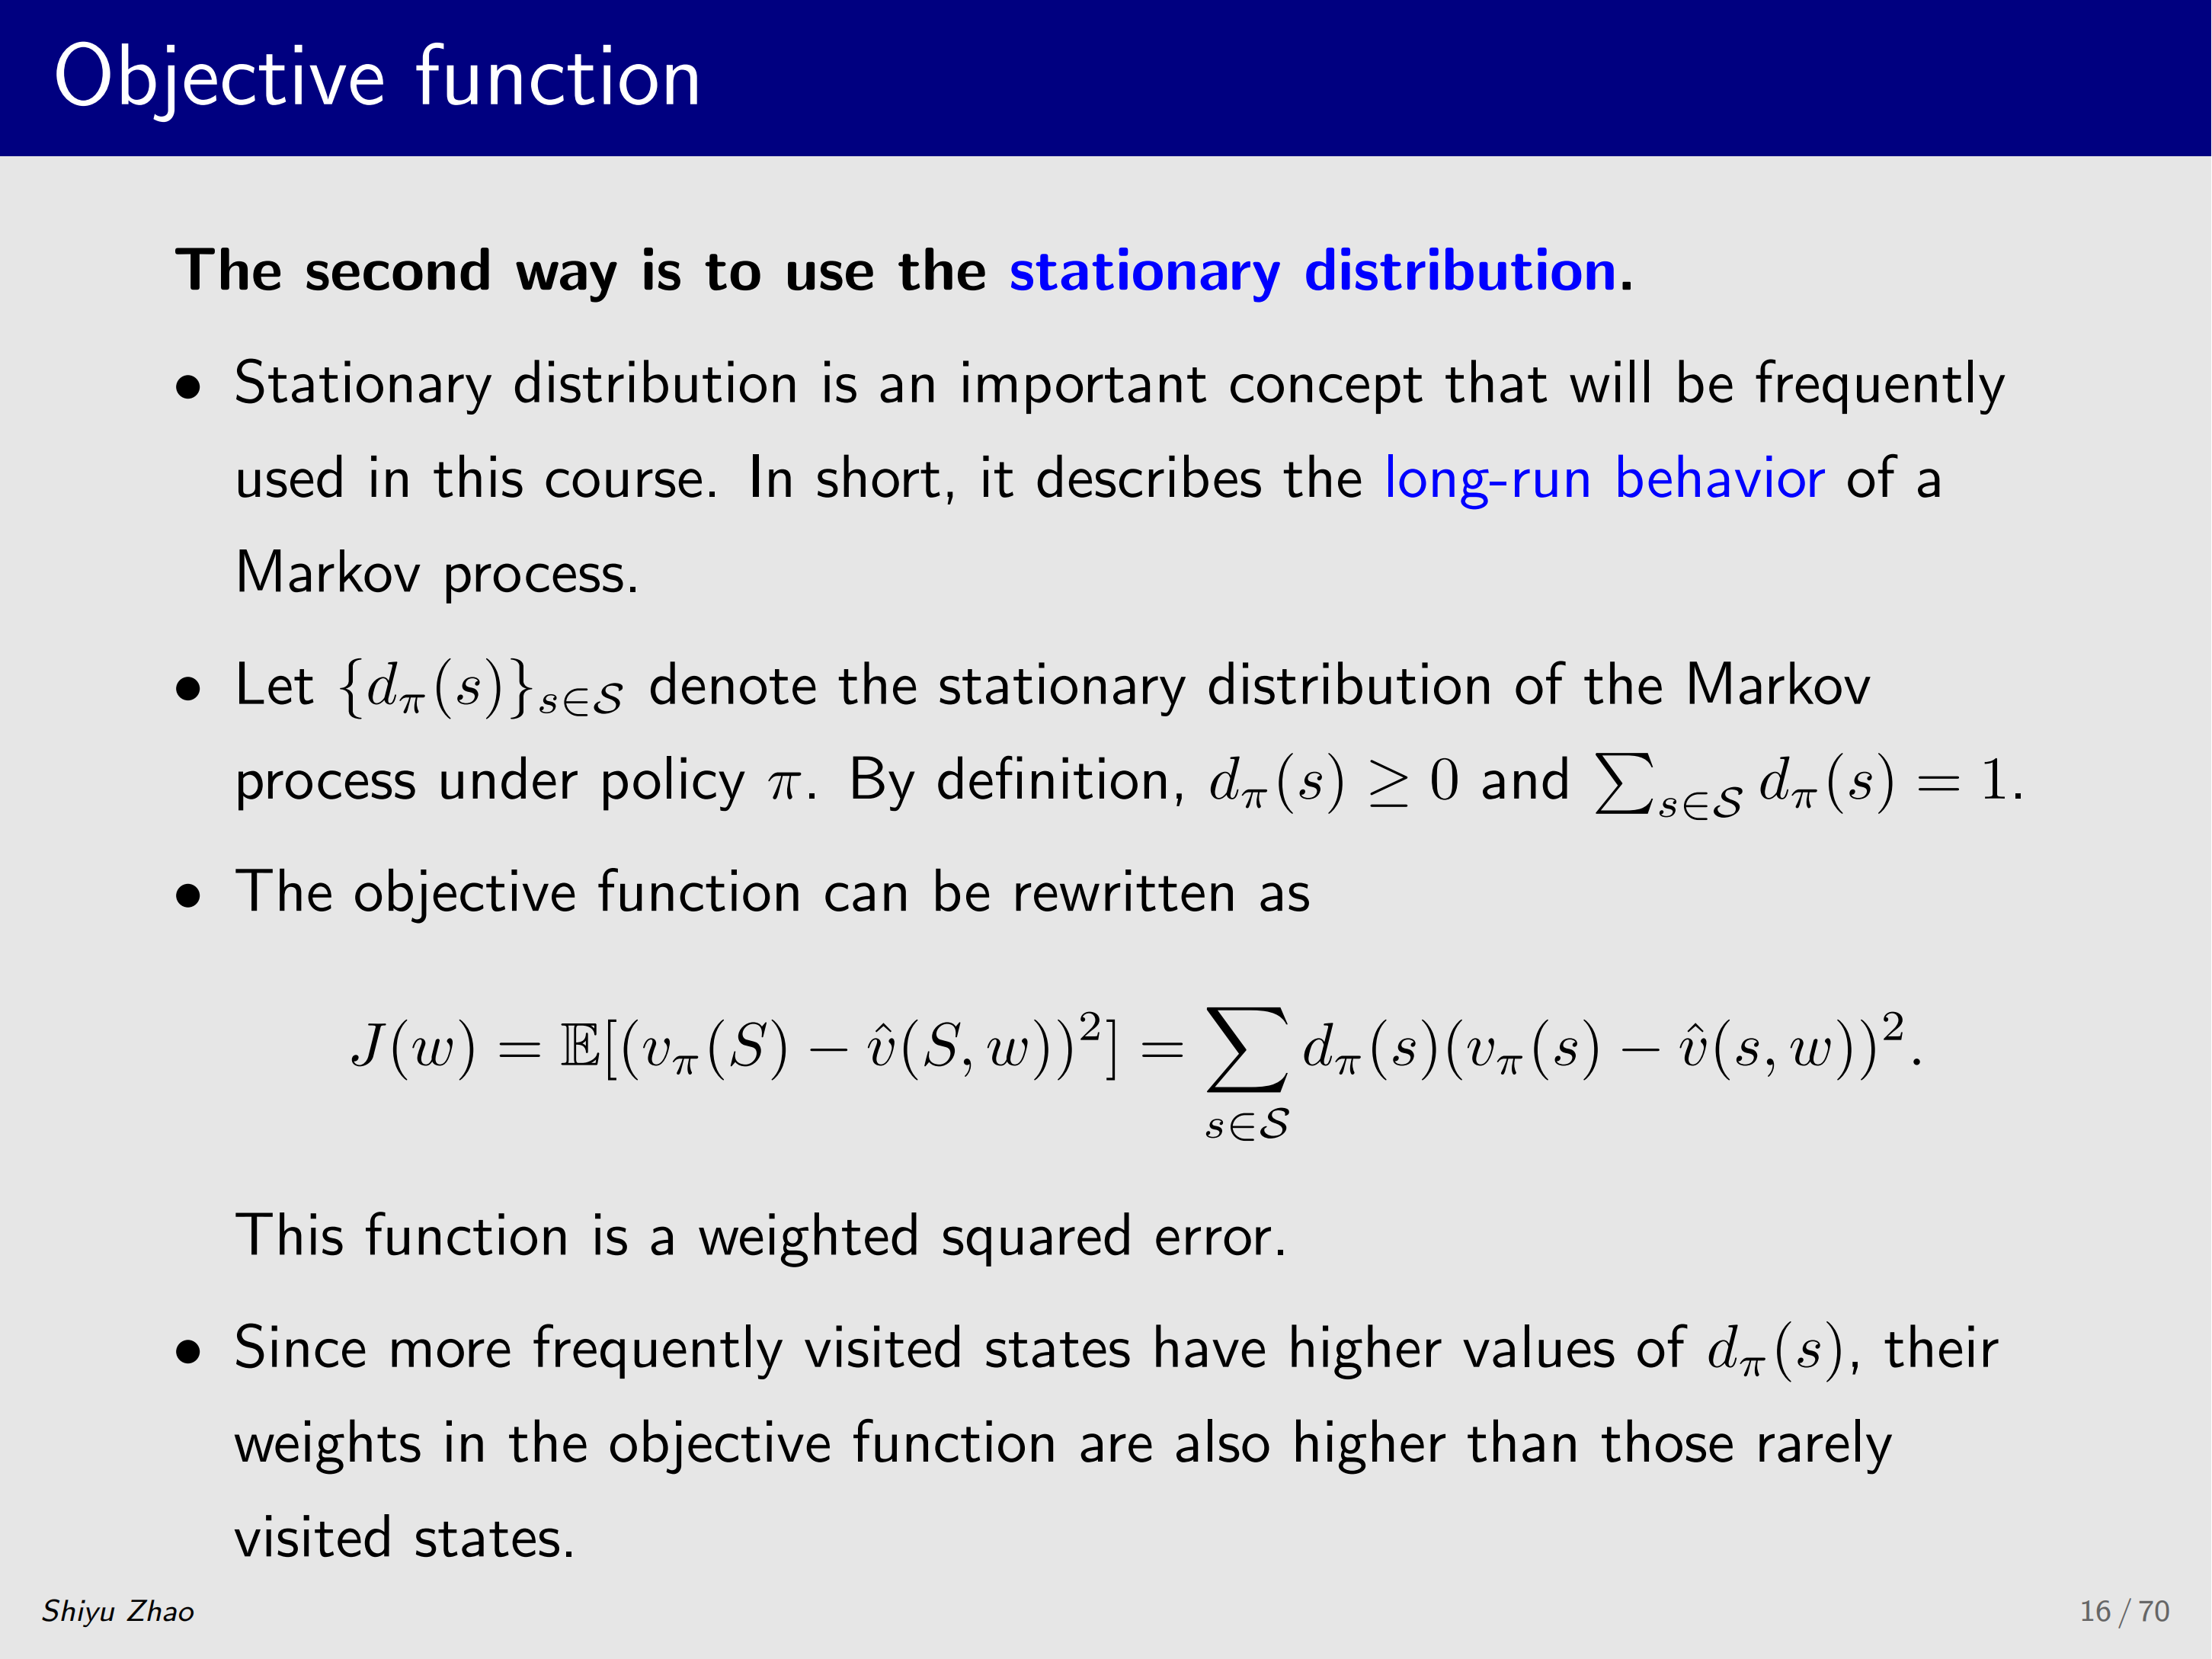
stationary distribution 是非常重要的一个概念,它描述了什么呢?描述了 long-run behavior ,下面先稍微介绍下,之后我们会给出一个例子,大家会更加清晰。什么是 long-run behavior 呢?从某个状态出发,按某个策略采取 action、不断与环境交互;一直采取该策略很多次之后,就会达到一种平稳状态。 在平稳状态下,能给出 agent 出现在每个状态的概率。之后通过例子会更清晰,现在大家先知道它是一个概率分布即可。
我们用 d π d_\pi dπ 来表示它, d π ( s ) d_\pi(s) dπ(s) 是它在 s s s 处的概率,作为概率分布,它在每个 s s s 上的概率大于等于 0,并且概率之和等于 1,也就是说
d π ( s ) ≥ 0 , ∑ s ∈ S d π ( s ) = 1 d_{\pi}(s) \ge 0 , \qquad \sum_{s \in \mathcal{S}} d_{\pi}(s)=1 dπ(s)≥0,s∈S∑dπ(s)=1
此时根据 expectation 的定义,目标函数自然写成:
J ( w ) = E ( v π ( S ) − v \^ ( S , w ) ) 2 = ∑ s ∈ S d π ( s ) ( v π ( s ) − v ^ ( s , w ) ) 2 . J(w) = \mathbb{E}(v_\\pi(S) - \\hat{v}(S, w))\^2 = \sum_{s \in \mathcal{S}} d_\pi(s)(v_\pi(s) - \hat{v}(s, w))^2. J(w)=E(vπ(S)−v\^(S,w))2=s∈S∑dπ(s)(vπ(s)−v^(s,w))2.
这里 d π d_{\pi} dπ 扮演权重的角色 ,某个状态权重较大,就希望它的估计误差更小,此外, d π d_{\pi} dπ 也是平稳状态下 agent 出现在该状态的概率(即被访问的概率),若这个概率大,就希望该状态的估计误差小。
2. Objective function - Stationary distribution
下面再稍微介绍一下 stationary distribution,它的内涵其实非常丰富。
从字面理解 stationary distribution 不难,首先它是 distribution ,即状态的概率分布,求加权平均时,可把它看作状态的权重。然后它是 stationary distribution,而 stationary(平稳) 的意思是:从当前状态出发执行某策略、跑非常多步后达到的概率分布,此时就处于平稳状态。
stationary distribution 又被称为 steady-state distribution 或者叫 limiting distribution,limiting 即极限---跑了很多步之后,它在本节课 value function approximation 和下节课 policy gradient 中都扮演重要角色,特别是在定义 objective function 的时候,都会出现这个 distribution。
下面通过一个例子来展示,相信大家就会比较明白,这个例子是什么呢?
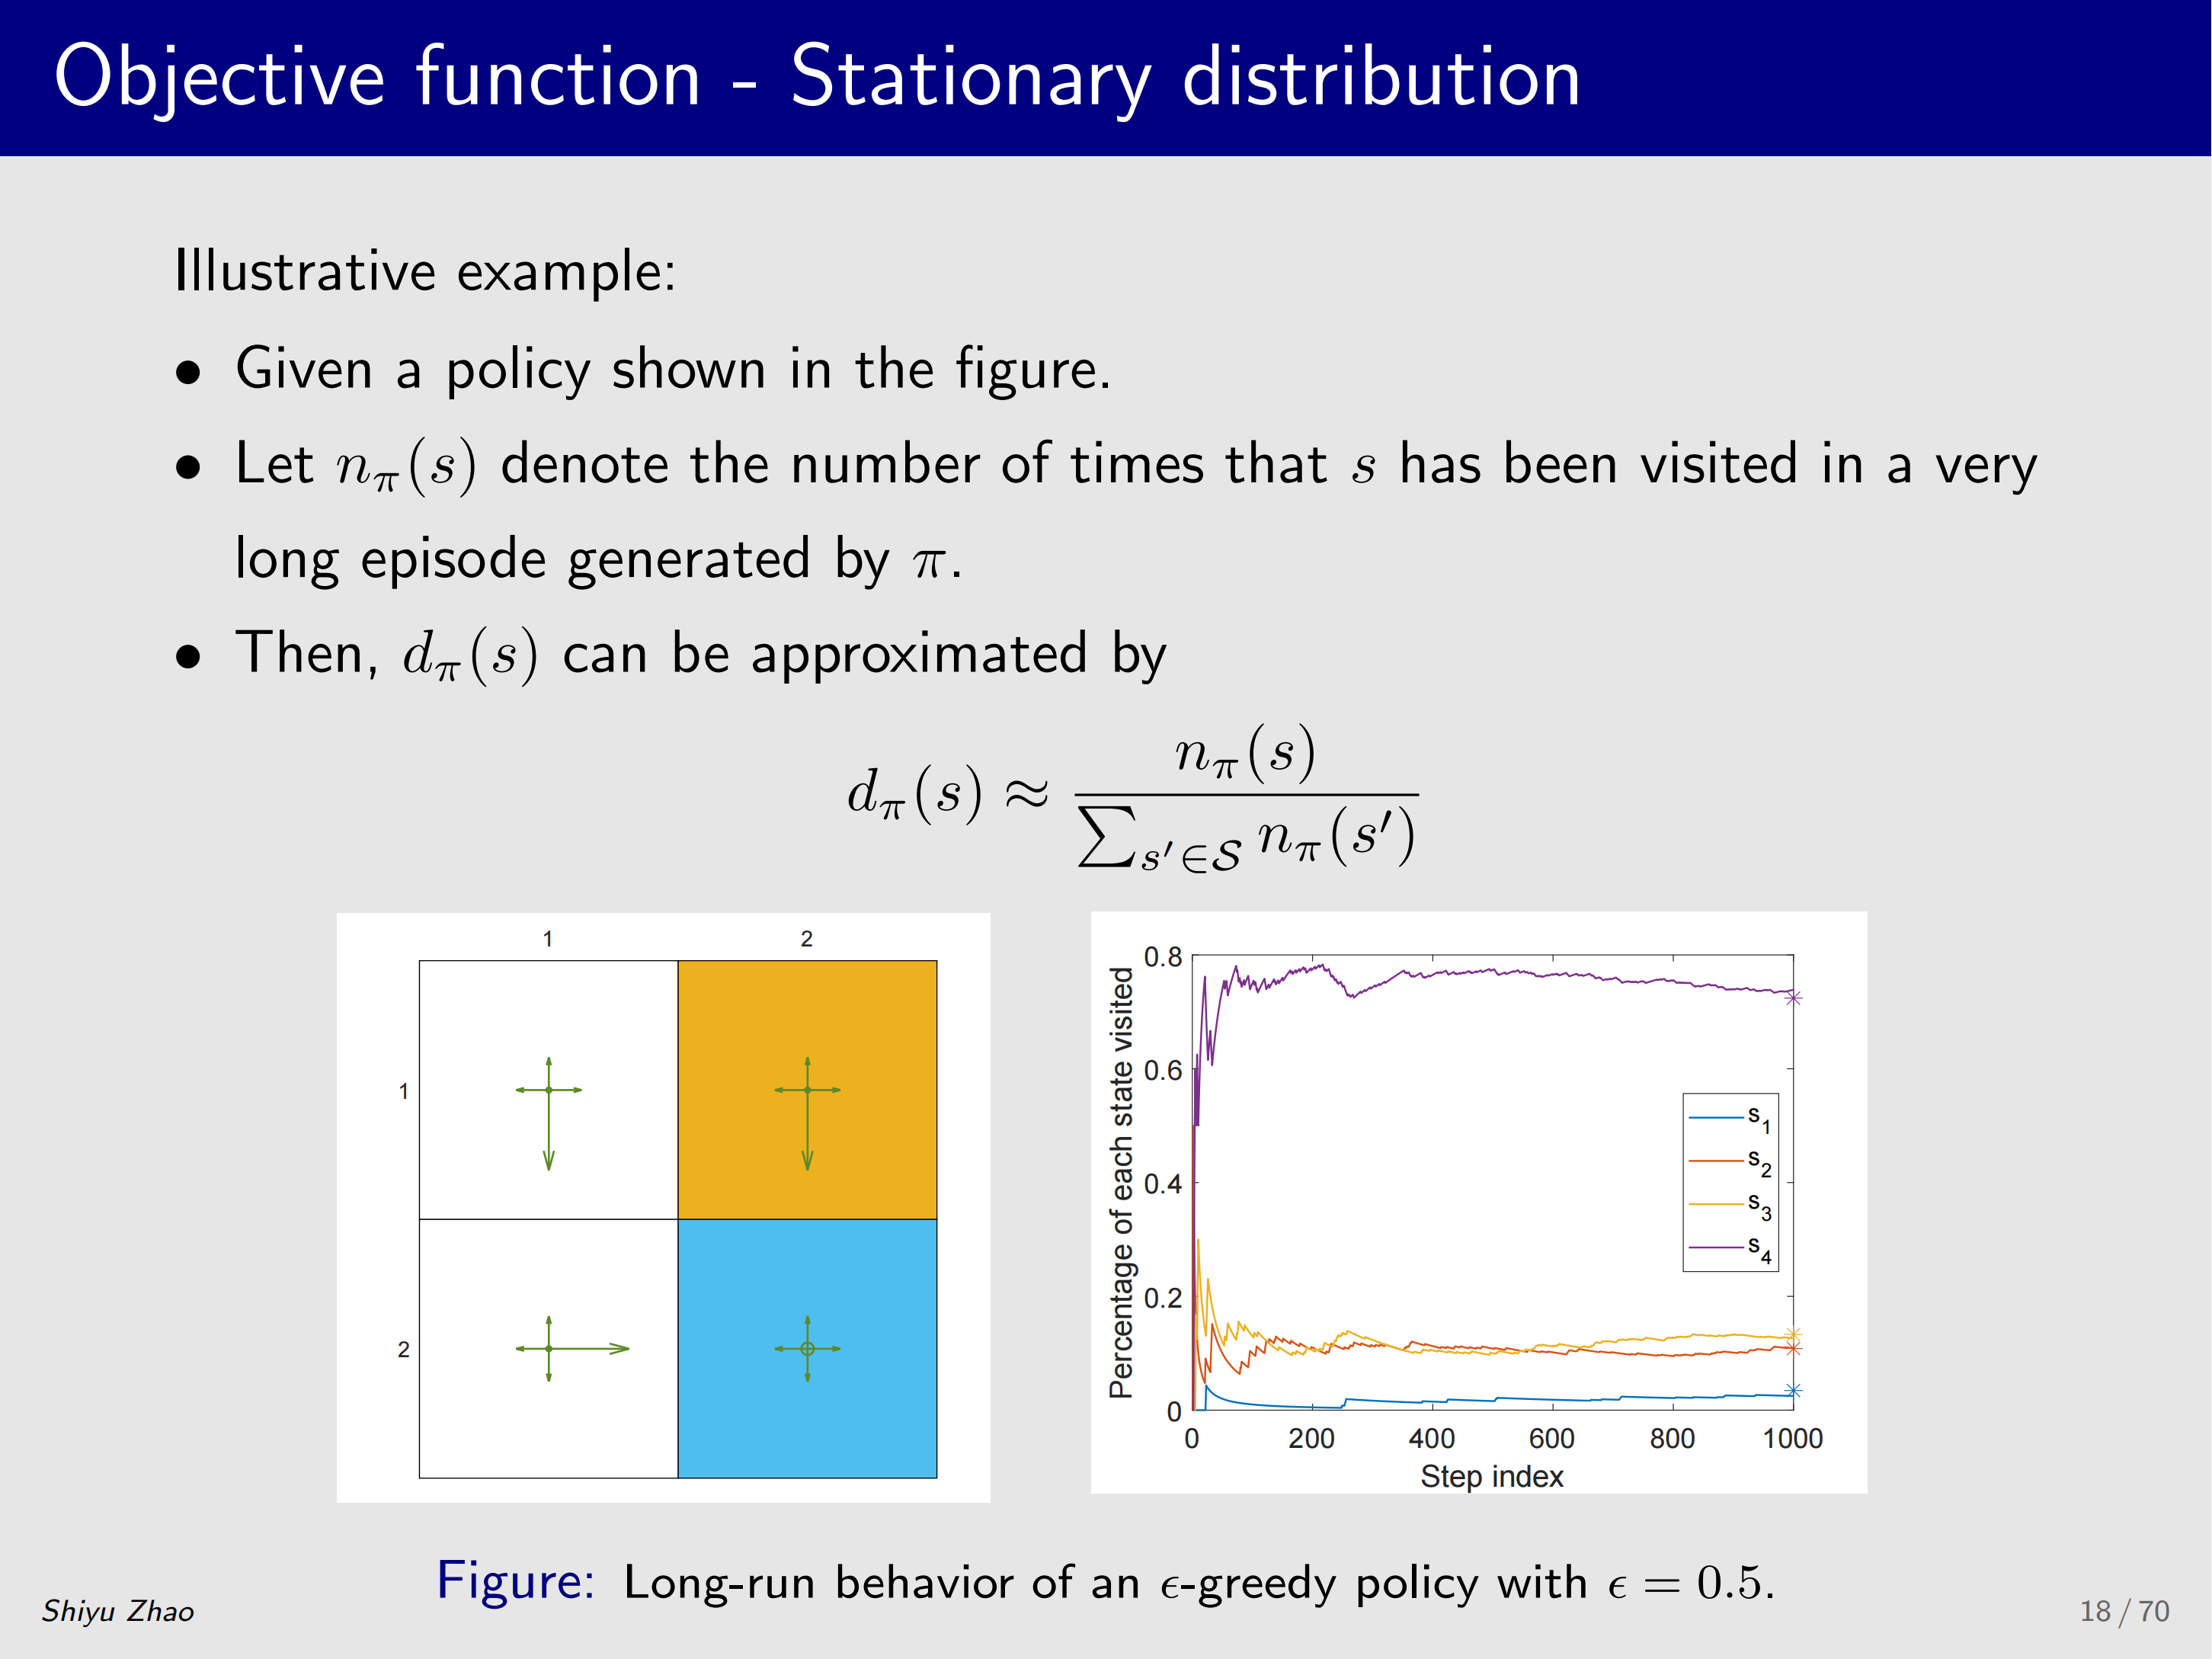
现在有一个策略(如图所示),它是 探索性 的:每个 action 都有正的概率被选中,但对某个特定 action 有较大的选择概率,比如说:在 s 1 s_1 s1、 s 2 s_2 s2 这两个状态向下,在 s 3 s_3 s3 向右, s 4 s_4 s4 处以较大的概率原地不动。
我们下面要做的是什么呢?让 agent 从某个状态出发跑很多次,看看按这个策略会发生什么,假设有一个非常长的 episode,这个 episode 会访问每个状态很多次,用 n π ( s ) n_\pi(s) nπ(s) 表示访问 s s s 的次数, n π ( s ) n_{\pi}(s) nπ(s) 除以访问所有状态的总次数(即 episode 长度),即
d π ( s ) ≈ n π ( s ) ∑ s ′ ∈ S n π ( s ′ ) d_\pi(s) \approx \frac{n_\pi(s)}{\sum_{s' \in \mathcal{S}} n_\pi(s')} dπ(s)≈∑s′∈Snπ(s′)nπ(s)
这个比值画在右下角图中,它实际可以 近似 stationary distribution,先看右下角的图,它是什么意思?横坐标是 episode 的步数------这个 episode 共 1000 步,纵坐标就是上面这个比值。
可以看到:不同状态被访问的概率(比值)不同,开始时波动较大,随着步数增加最终趋于平稳,所以什么叫 stationary(平稳)、long-run?就是跑很多次后就会趋向平稳,那它们的每一个比值或者是概率都会收敛到一个具体的值。
以 s 4 s_4 s4(紫色、最上面的线)为例,这条线对应的状态是 s 4 s_4 s4 ,也就是在跑很多次之后, s 4 s_4 s4 被访问的次数除以整个 episode 的长度,它最后趋向了一个比值,这个比值相比于其它状态还是比较大的,为什么呢?其实也容易理解,因为每个状态都以较大概率选择某个特定 action,而这些 action 使得无论从哪个点出发都有较大概率跑到 s 4 s_4 s4 ,跑很多步后 agent 在 s 4 s_4 s4 出现的概率较大,约等于 0.7。
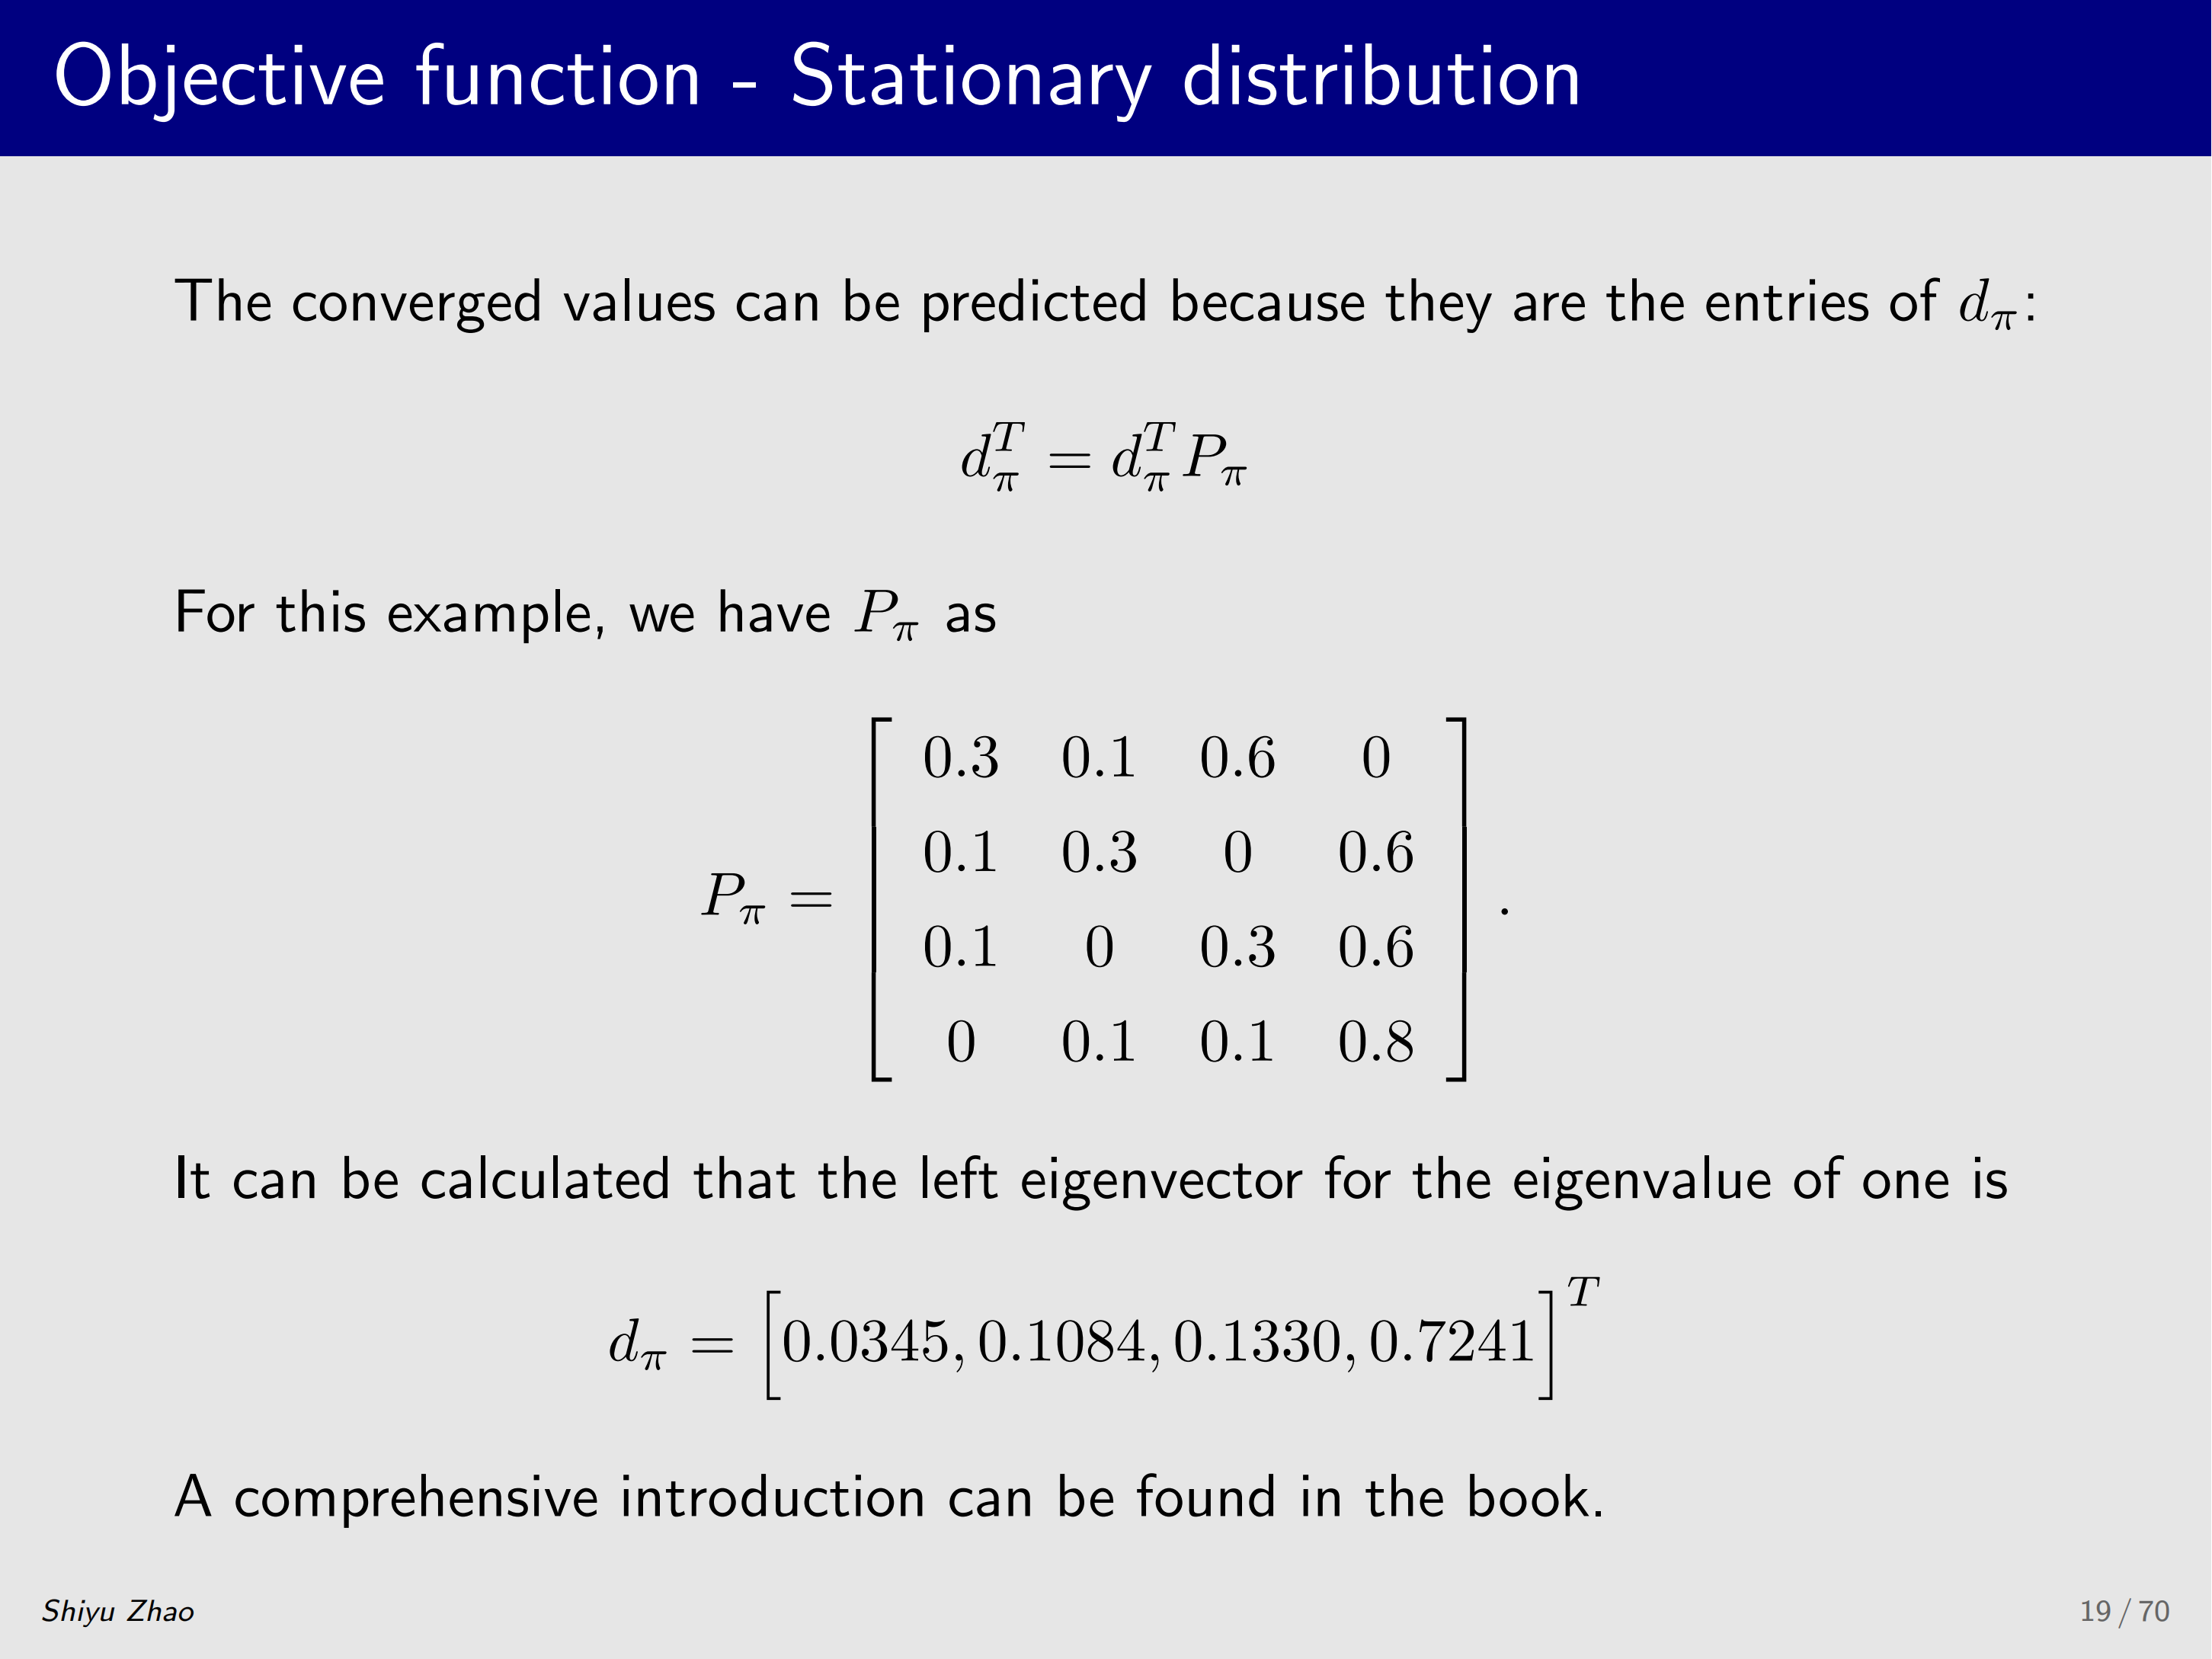
大家也注意到图中画了一些星号---它们代表 理论值 ,也就是说我们不需要跑很多次就能找到 d π ( s ) d_{\pi}(s) dπ(s) ,怎么找呢?我们来看一下 d π ( s ) d_{\pi}(s) dπ(s) 满足下面这样一个式子:
d π T = d π T P π d_{\pi}^T = d_{\pi}^T P_{\pi} dπT=dπTPπ
这个 P π P_{\pi} Pπ 是 状态转移矩阵 ,大家还记得 v π = r π + γ P π v π v_{\pi} = r_{\pi} + \gamma P_{\pi}v_{\pi} vπ=rπ+γPπvπ 吗?这就是贝尔曼公式的 matrix-vector form,式中的矩阵就是 P π P_{\pi} Pπ ,它的每个元素代表从 s s s 到 s ′ s' s′ 的转移概率。
由这个式子可见: d π d_{\pi} dπ 是 P π P_{\pi} Pπ 的(左)特征向量,对应特征值为 1 ,具体到我们这个 2×2 网格的例子,不难把 P π P_{\pi} Pπ 写出来:
P π = 0.3 0.1 0.6 0 0.1 0.3 0 0.6 0.1 0 0.3 0.6 0 0.1 0.1 0.8 . P_\pi = \begin{bmatrix} 0.3 & 0.1 & 0.6 & 0 \\3pt 0.1 & 0.3 & 0 & 0.6 \\3pt 0.1 & 0 & 0.3 & 0.6 \\3pt 0 & 0.1 & 0.1 & 0.8 \end{bmatrix}. Pπ= 0.30.10.100.10.300.10.600.30.100.60.60.8 .
如果大家感兴趣,可以自己动手验证 P π P_{\pi} Pπ 是不是这样,接下来可以算出 P π P_\pi Pπ 的特征值为 1 的左特征向量:
d π = 0.0345 , 0.1084 , 0.1330 , 0.7241 T d_\pi = 0.0345, 0.1084, 0.1330, 0.7241^T dπ=0.0345,0.1084,0.1330,0.7241T
这里每个元素分别对应各状态在平稳状态下的概率,大家可以看到 s 4 s_4 s4 对应的数值是 0.72,与刚才数值仿真的结果基本一致。
stationary distribution 就快速介绍到这里,它的内涵非常丰富,如果大家感兴趣的话可以参考教材。
结语
本讲第二部分正式构建了 value function approximation 的目标函数 J ( w ) = E ( v π ( S ) − v \^ ( S , w ) ) 2 J(w) = \mathbb{E}(v_\\pi(S) - \\hat{v}(S,w))\^2 J(w)=E(vπ(S)−v\^(S,w))2 ,并深入探讨了其中最关键的一个细节---随机变量 S S S 的概率分布。均匀分布假设所有状态同等重要,简单直观但脱离了实际;stationary distribution d π d_\pi dπ 则刻画了按策略 π \pi π 长期运行后 agent 出现在各状态的概率,让重要(经常被访问)的状态获得更大的权重、更小的估计误差。
stationary distribution 的内涵远不止一个权重:它是长期行为的概率描述,可通过仿真中访问频率的极限得到,也可从理论上直接求解---它是状态转移矩阵 P π P_\pi Pπ 的特征值为 1 的左特征向量( d π T = d π T P π d_\pi^T = d_\pi^T P_\pi dπT=dπTPπ)。这一概念在 value function approximation 与下一讲的 policy gradient 中都扮演着定义目标函数的核心角色,是连接 "策略" 与 "状态重要性" 的数学桥梁🤗。