 不会写复杂代码也能发 SCI?手把手教你用 InSpireR 交互系统一键提取、合并与导出临床科研宽表【第三章】
💡 导读与实战痛点
在第一章与第二章中,我们讲清了 INSPIRE 数据库的全貌与底层变量字典。但很多临床医生、麻醉科同道和护士朋友在跃跃欲试的同时,依然有一层深切的顾虑:"我平时只熟悉 Excel 和简单统计软件,不会写复杂的 R 语言数据处理脚本,几十张表怎么合并?长表转宽表转崩了怎么办?"
不必担心!针对临床研究人员的技术痛点,团队专门为 InSpireR 包 研发了配套的可视化交互系统(Shiny) 。你只需像网上购物一样在界面上勾选变量、搜索编码,系统不仅能一键自动合并导出规范的 Excel 科研宽表,更关键的是------它能实时反向生成标准、可复现的纯 R 语言分析脚本,让你在享受极简操作的同时,论文投稿完全经受得住 SCI 顶刊审稿人的严苛代码复查!
一、 痛点直击:传统写代码提取数据的四大"致命陷阱"
很多尝试手动写代码处理几千万行数据库的临床医生,经常陷入以下困境:
- 多对多连接导致数据爆炸 :手动使用
left_join合并用药记录与检验表时,由于一个患者有几十次微量泵调速和化验,稍不注意就会发生笛卡尔积膨胀,几十万行数据瞬间暴增至数千万行,电脑直接内存溢出蓝屏; - 时间窗逻辑颠倒:手动计算时间差极易出错,误将切皮后的化验当成术前基线,导致严重的"时间旅行偏倚(Immortal Time Bias)",直接被审稿人拒稿;
- ICD 编码匹配繁琐易漏:一个外科疾病或手术在 ICD-10 中有数十个细分编码,手动敲代码过滤极易遗漏关键亚型;
- 统计分析要求"宽表":SPSS、MedCalc 或回归模型建模必须要求"一人一行、一指标一列",而数据库原始记录是 5 列长表,手动透视转换经常出现缺失值填补错位。
为了让大家直观了解差异,我们将传统纯手动编写代码与 InSpireR 交互系统做了一个深度对照:
| 评估维度 | 传统手动编写 R/SQL 脚本 | InSpireR 可视化交互系统(Shiny) | 临床科研优势与保障 |
|---|---|---|---|
| 上手门槛 | 需掌握数据管道、连接语法与长宽转换 | 全界面鼠标点选,犹如网购勾选商品 | 临床医护人员零计算机门槛直接上手 |
| 防错机制 | 需自行写去重与窗口校验,易样本虚增 | 内置临床逻辑校验,自动锁定手术主键 | 从源头上杜绝多对多数据膨胀与时间窗错位 |
| 队列筛选 | 手动查阅海量 ICD 字典并敲入匹配代码 | 内置智能搜索弹窗,点选一键生成 0/1 标志变量 | 涵盖普外、心胸、骨科等全病种手术快速归队 |
| 最终输出 | 常常格式错位,导出 CSV 包含各种乱码 | 实时宽表预览 + 一键导出纯净 Excel | 每一行严格对应一次手术,直接送入统计建模 |
| 学术复现性 | 代码东拼西凑,投稿时审稿人难以复核 | 实时反向生成标准可复现纯 R 脚本 | 点选操作完全透明,完美响应 SCI 审稿要求 |
二、 双轨机制全景:既给临床医生极简,又给期刊严谨
有的老师可能会问:"在界面上点选导出的数据,投高分 SCI 期刊时审稿人承认吗?期刊要求提供数据处理的 R 代码怎么办?"
这就是 InSpireR 交互系统最具创新性的设计所在------双轨工作流机制!
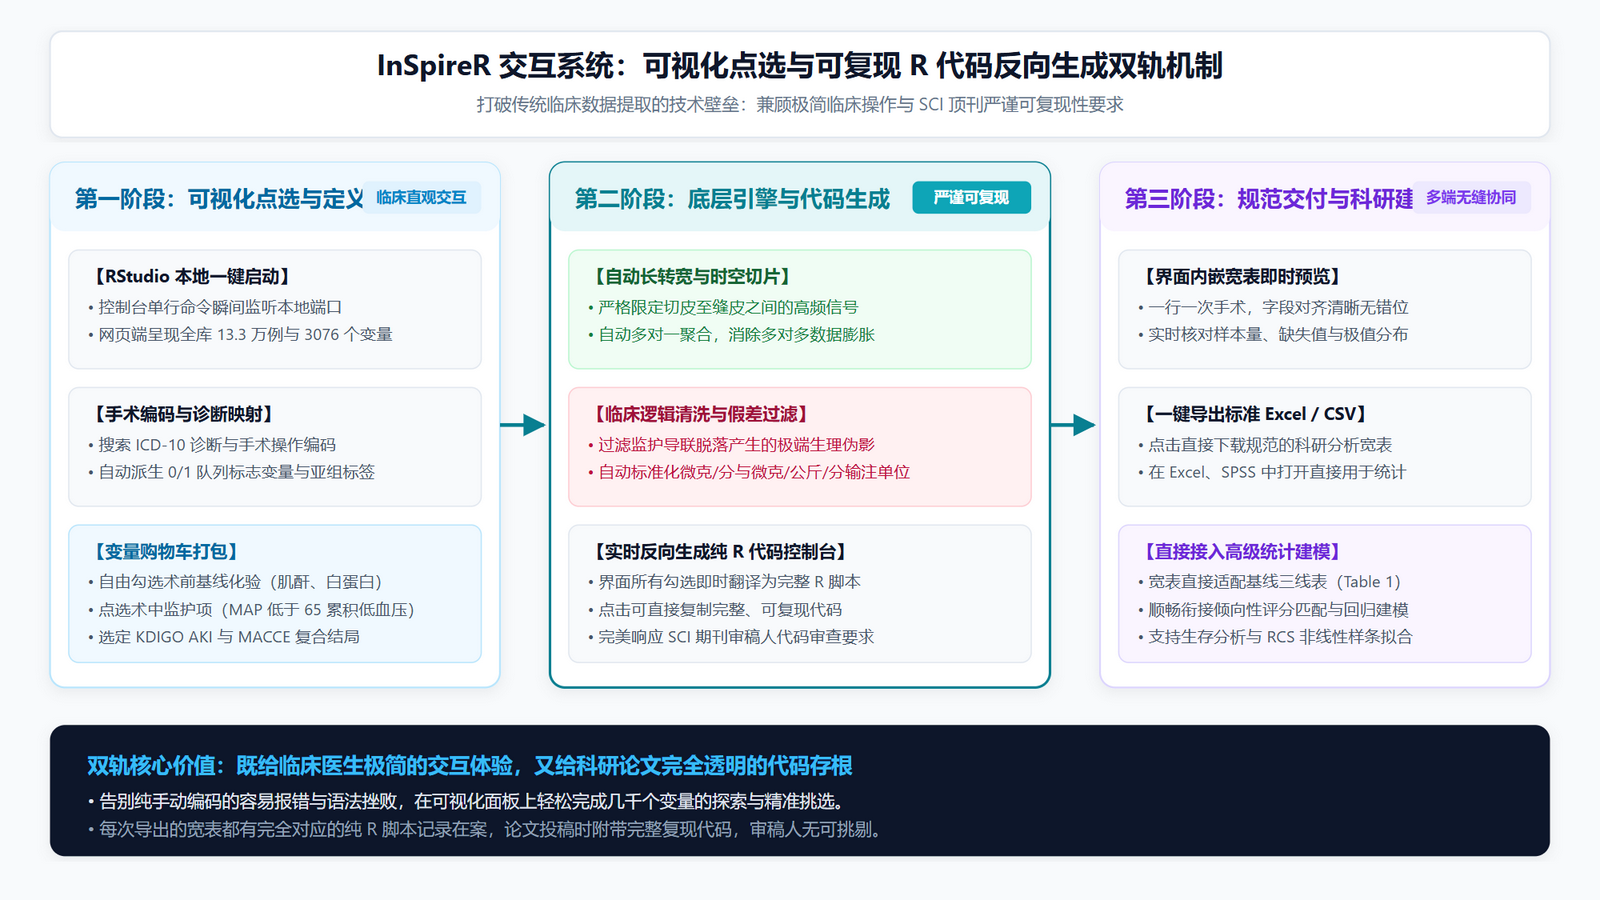
我们绘制了下面这张《InSpireR 交互系统:可视化点选与可复现 R 代码反向生成双轨机制图》:
▲ 出版级科研机制图:临床直观交互与底层可复现纯 R 代码反向生成的双轨闭环
如上图所示,整个系统完美兼顾了两个维度:
- 对临床医生(前端极简):你看到的是直观的科室下拉框、变量购物车和化验滑块,无需手写一行连接代码;
- 对 SCI 审稿人(后端透明):界面的每一次勾选、每一个时间窗设定,底层都在实时反向编写一段严谨、符合规范的纯 R 脚本。点击控制台即可一键复制全部代码,论文修回时作为附件提交,审稿人无可挑剔!
三、 手把手实战走读:从本地启动到变量购物车打包
接下来,我们跟着视频第 3 讲的实录画面,一步步体验这套系统的流畅操作流程。
第一步:在 RStudio 中两行代码启动系统
打开 RStudio,在控制台中仅需输入以下两行启动指令:
# ==============================================================================
# 启动 InSpireR 专属可视化交互系统
# ==============================================================================
library(InSpireR)

# 启动本地可视化网页服务(默认监听本地端口,无需联网上传数据,确保医院内网安全)
launch_inspirer_app()
回车后,系统瞬间完成初始化并在控制台输出本地监听地址:
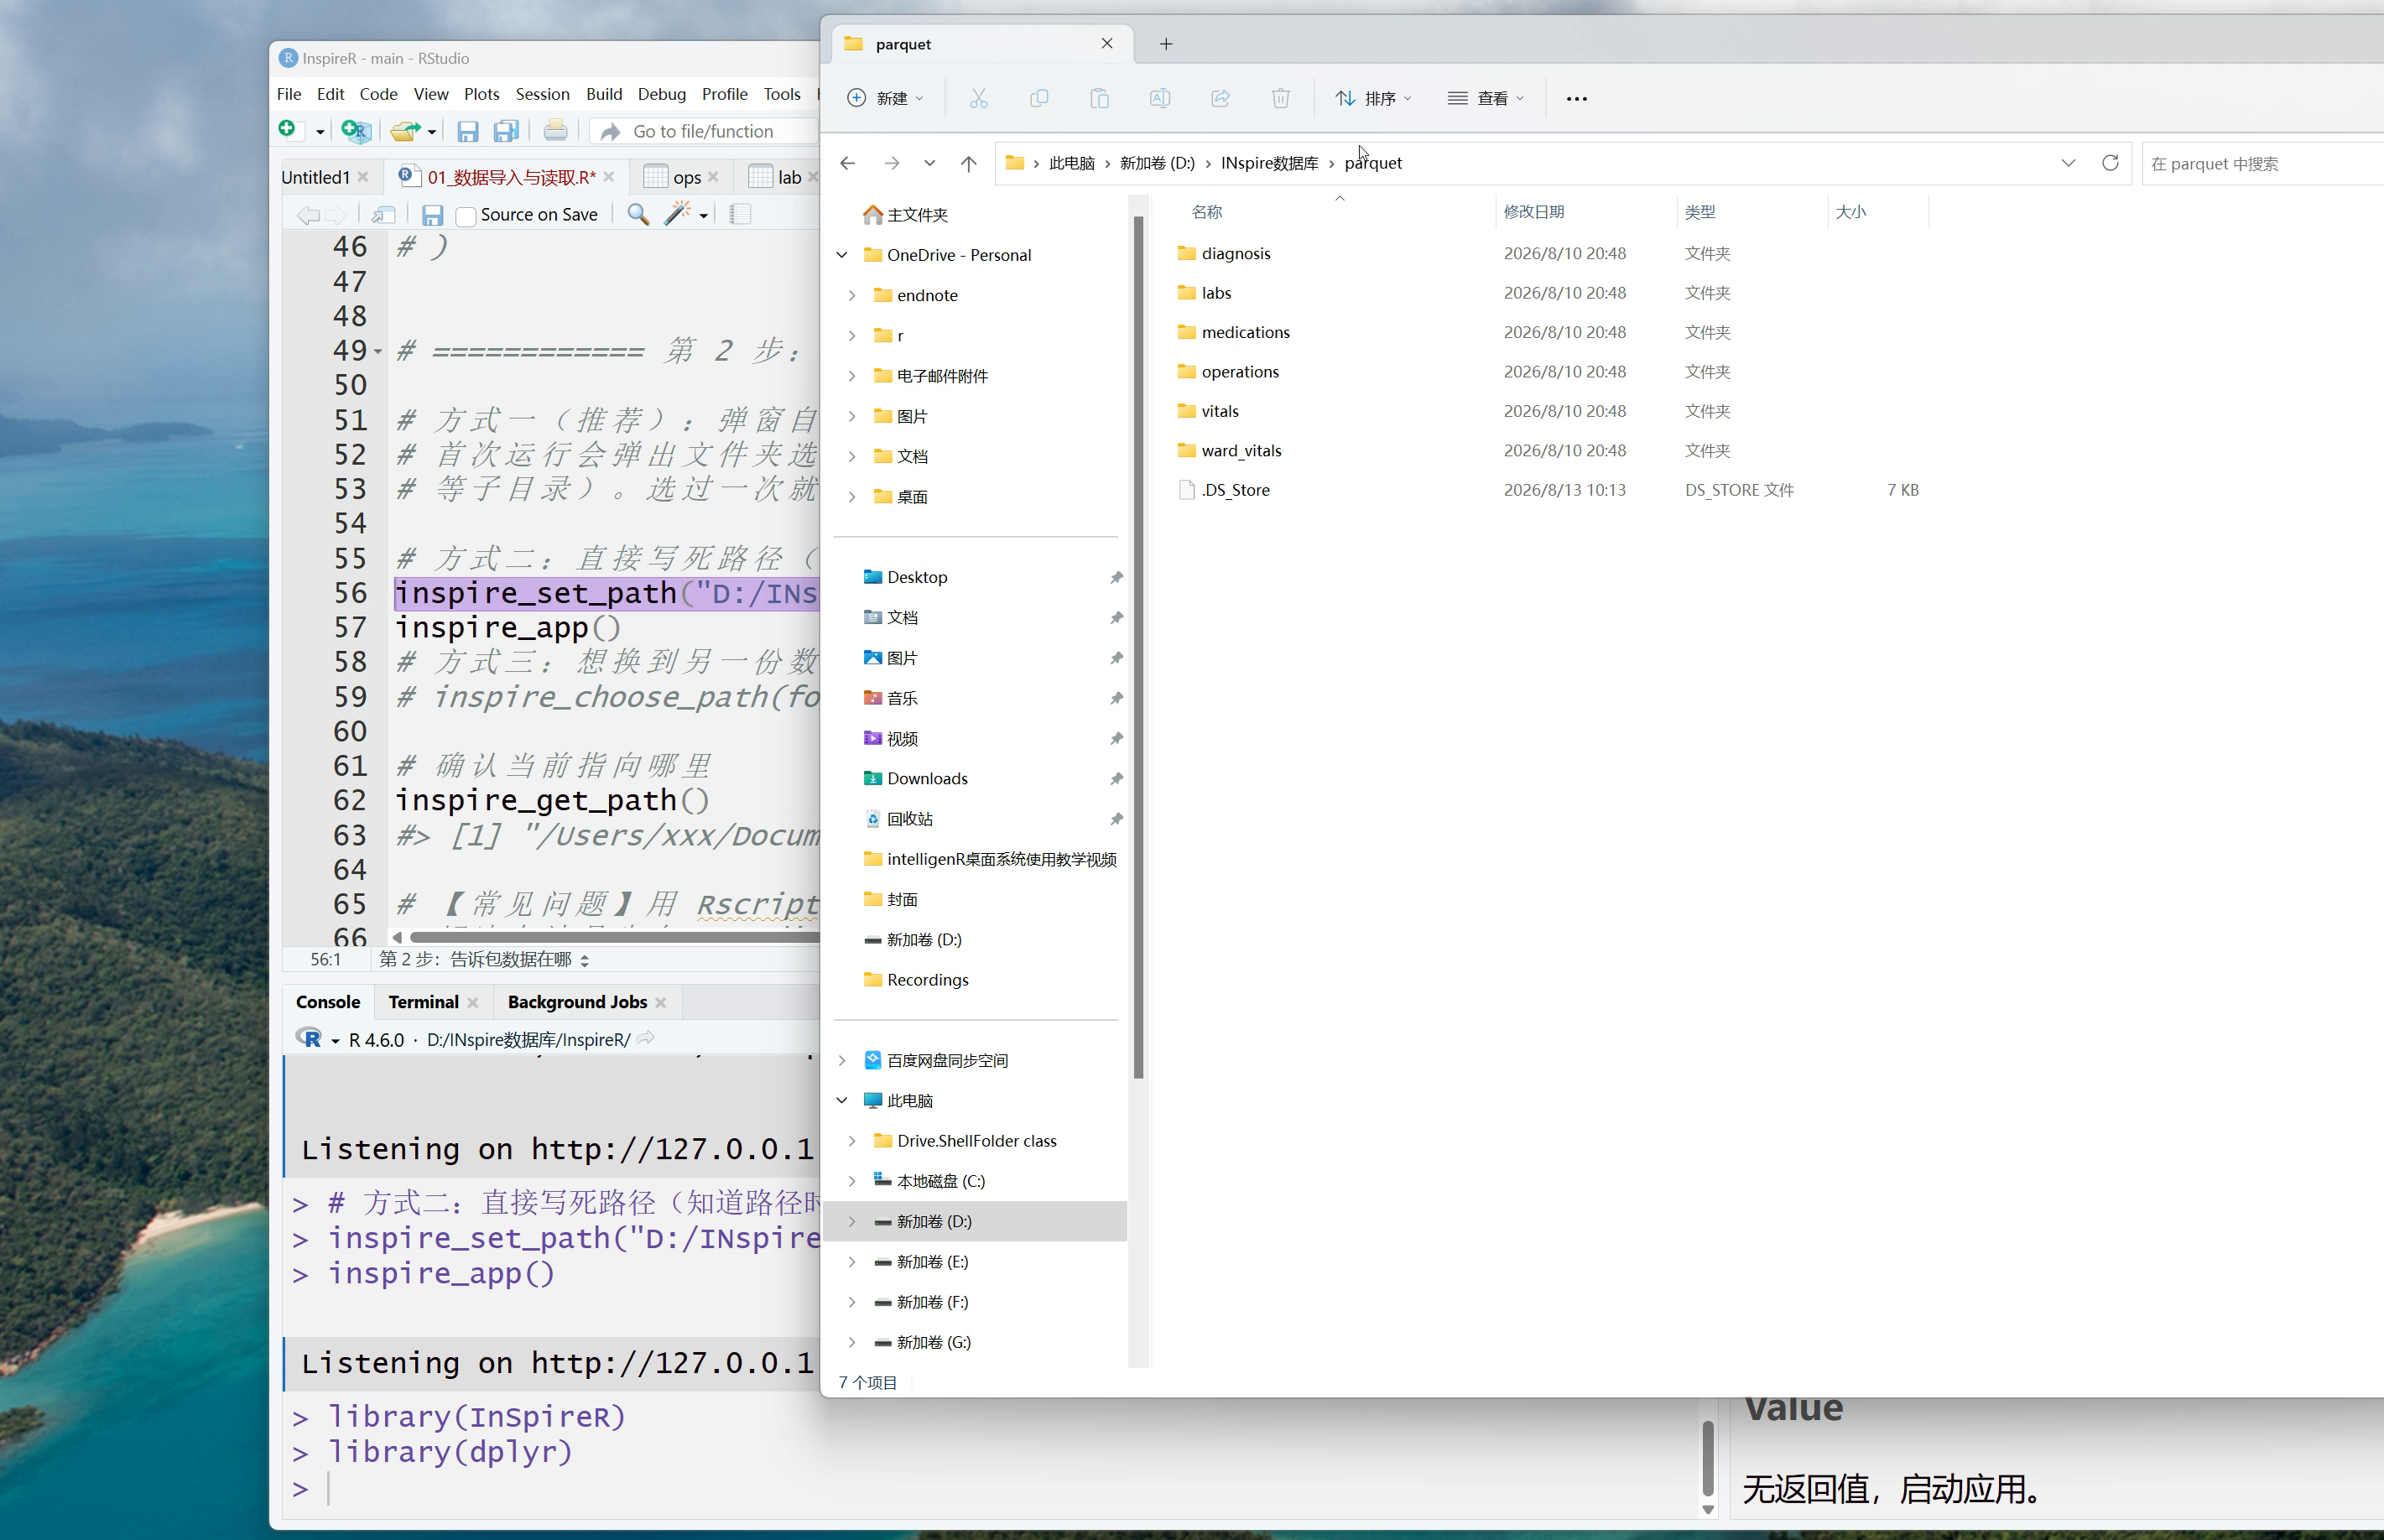
▲ 视频 3 实录:在 RStudio 控制台中单行命令快速启动本地交互服务
第二步:进入 InSpireR 变量中心全景概览
系统启动后,浏览器会自动打开如下清爽的可视化面板: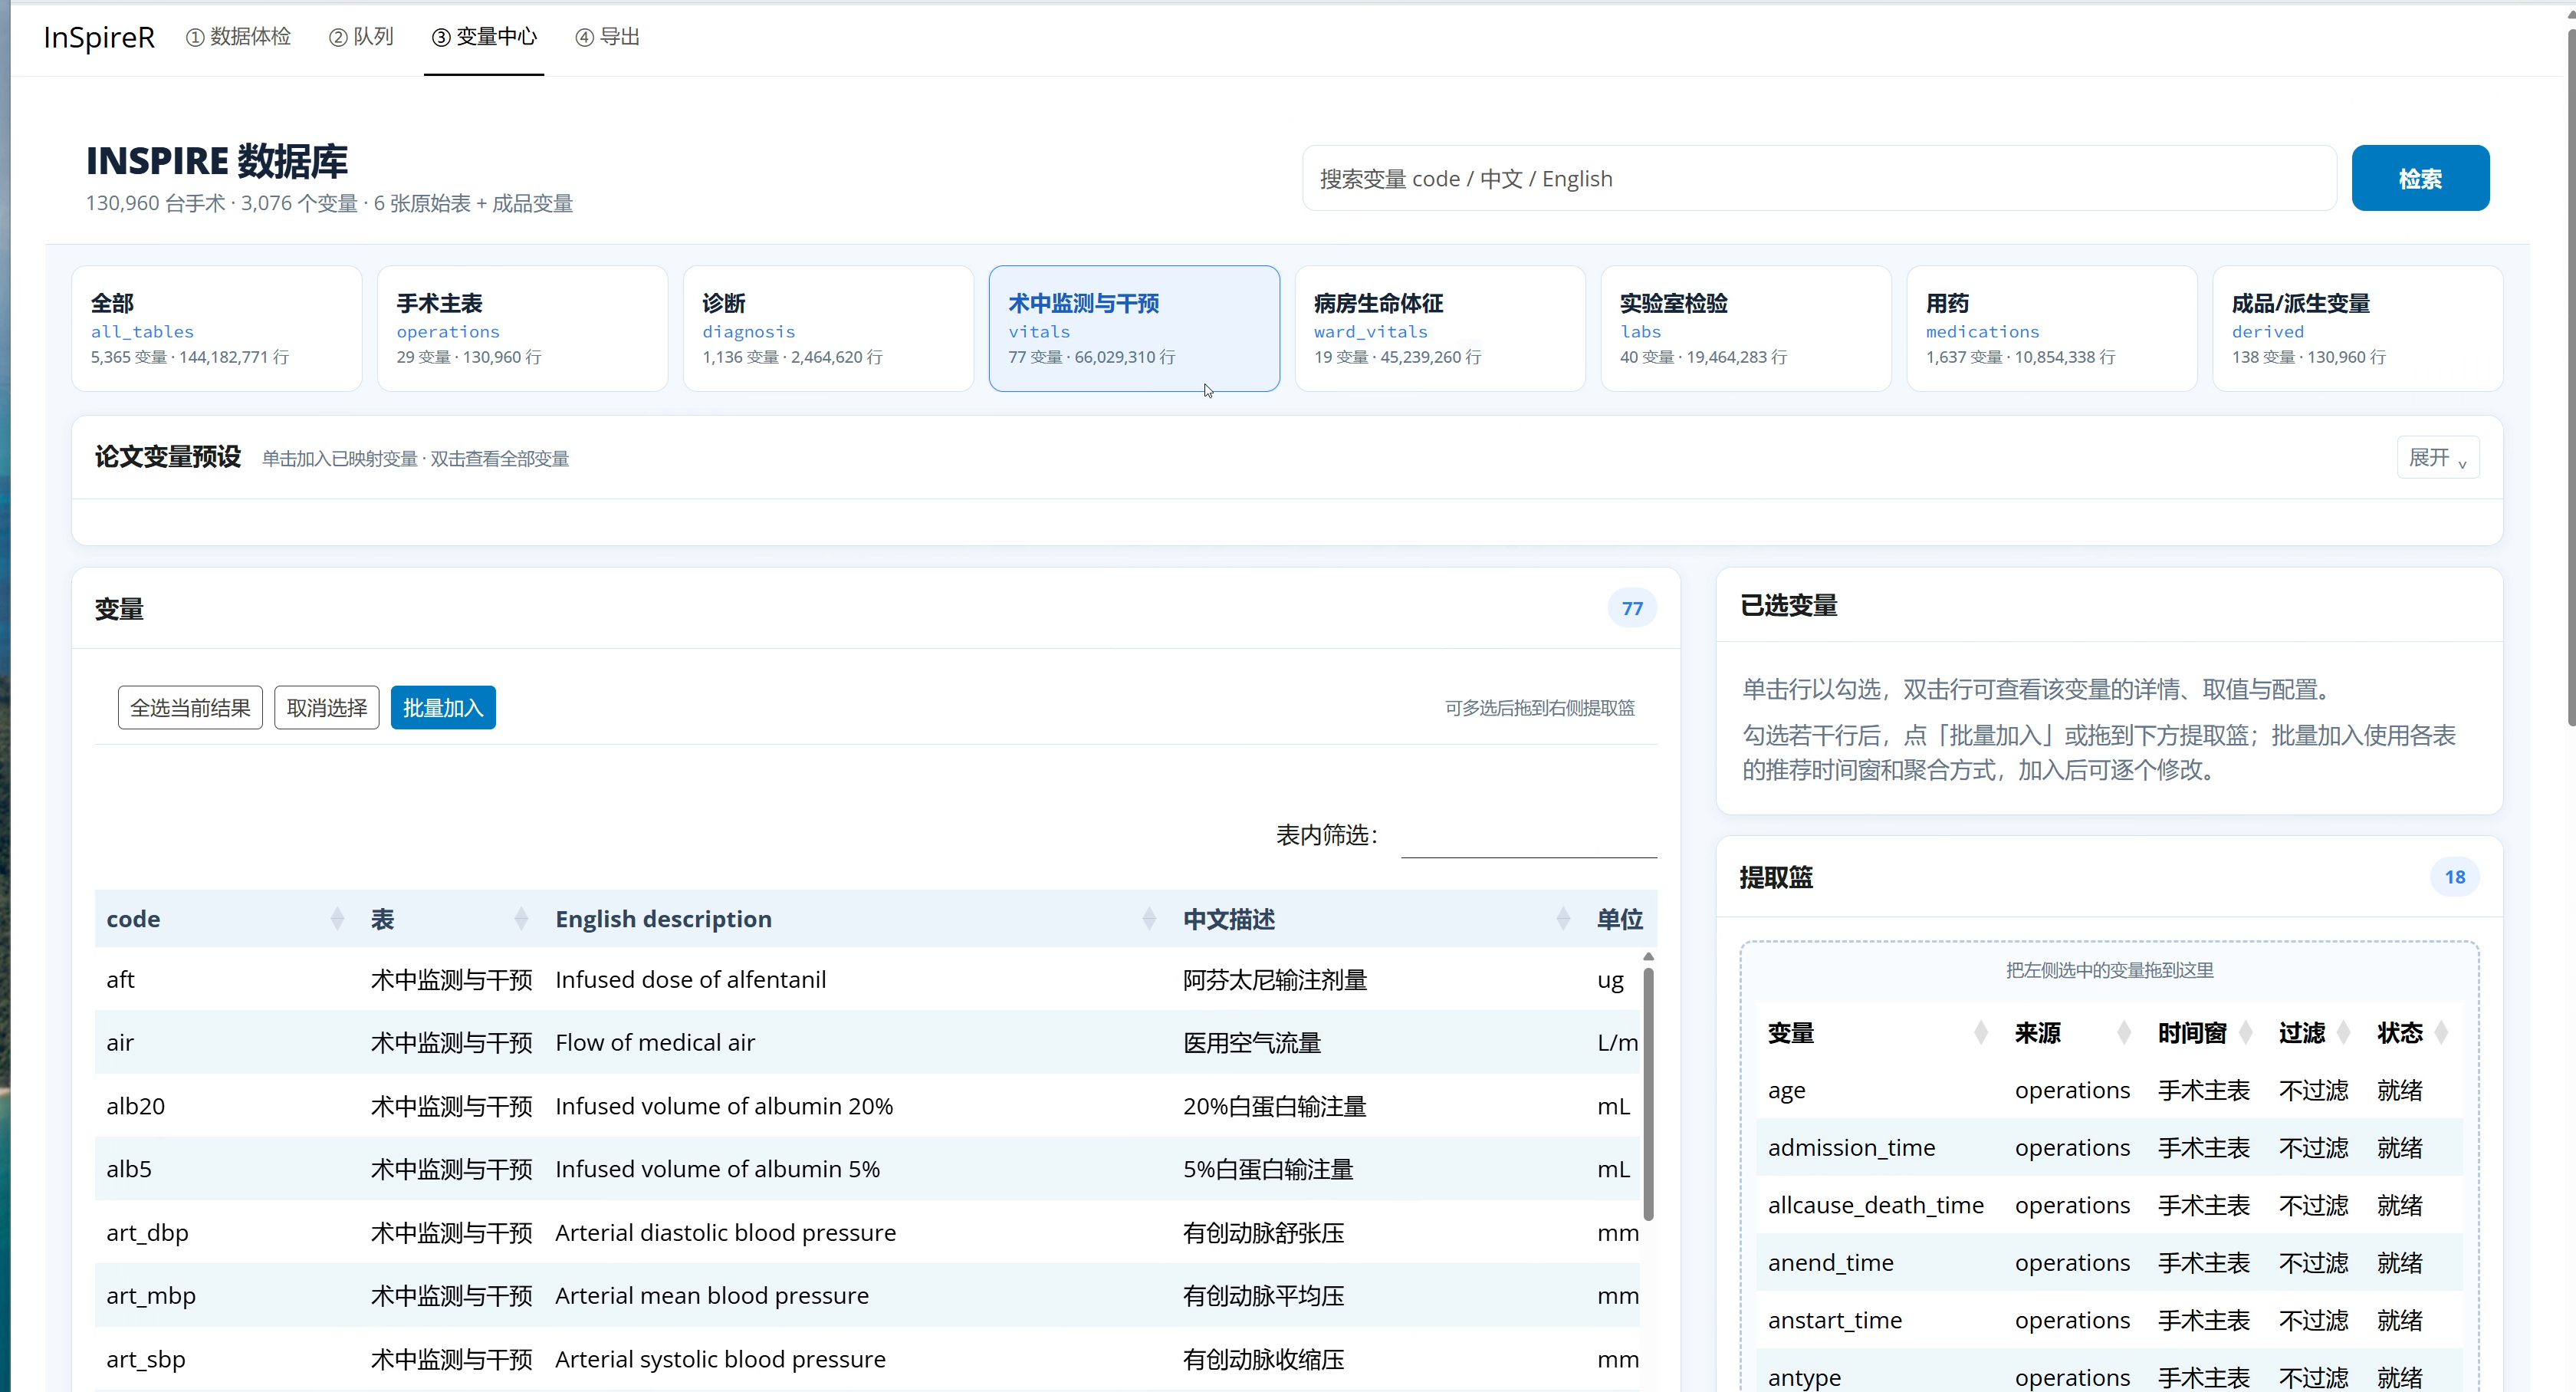
▲ 视频 3 实录:变量中心全库 133,021 例手术与 3076 个变量全景探索面板
在面板顶部,清楚显示着全库的权威基底:
- 全库总手术例数 :涵盖 133,021 例 真实世界手术事件;
- 纳入核心变量总数 :已归类索引 3,076 个 标准临床字段;
- 左侧导航栏:划分为"基础人口学与合并症"、"手术室信息"、"术前实验室化验"、"术中生命体征"、"术中药物输注"以及"术后器官结局"等清晰模块。
第三步:ICD 编码智能弹窗与亚组队列筛选
做外科临床科研,最重要的一步是精准界定手术队列。以往需要手动查阅复杂的 ICD 编码,而在 InSpireR 系统中,讲师现场演示了弹窗交互功能:
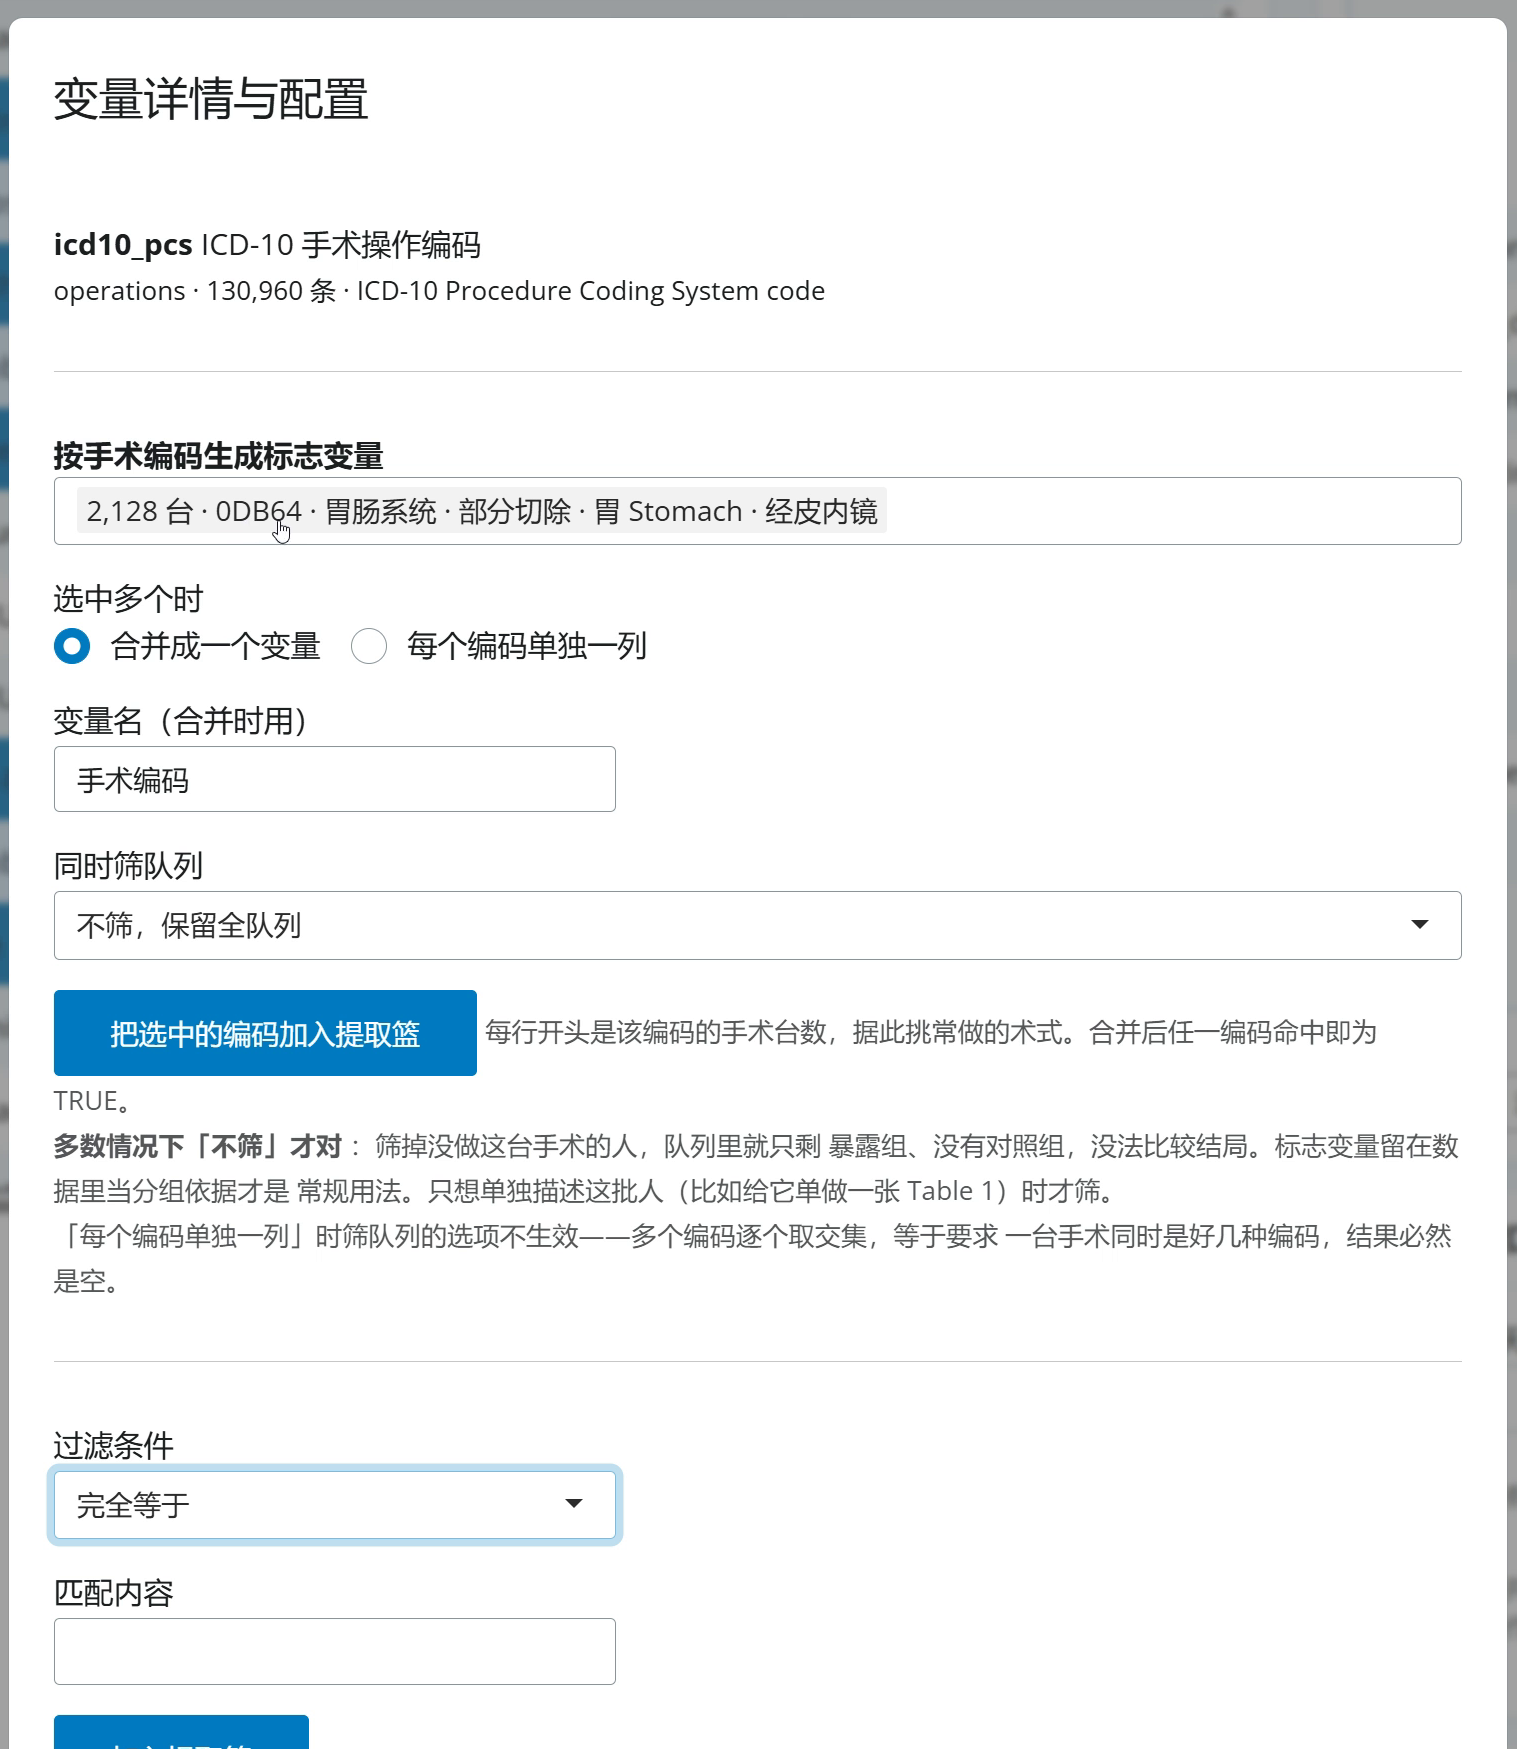
▲ 视频 3 实录:弹窗点选 ICD 手术编码,系统自动在宽表中派生 0/1 队列标志变量
输入手术中文或英文关键词(如"结肠切除术"、"全膝关节置换"),弹窗会自动联想并列出全部相关编码。勾选后,系统会自动在最终宽表中派生一个值为 0 或 1 的逻辑标志变量,一键锁定纳入分析人群!
第四步:变量购物车(Variable Basket)机制
这是整个系统最令人称赞的交互设计------变量购物车:
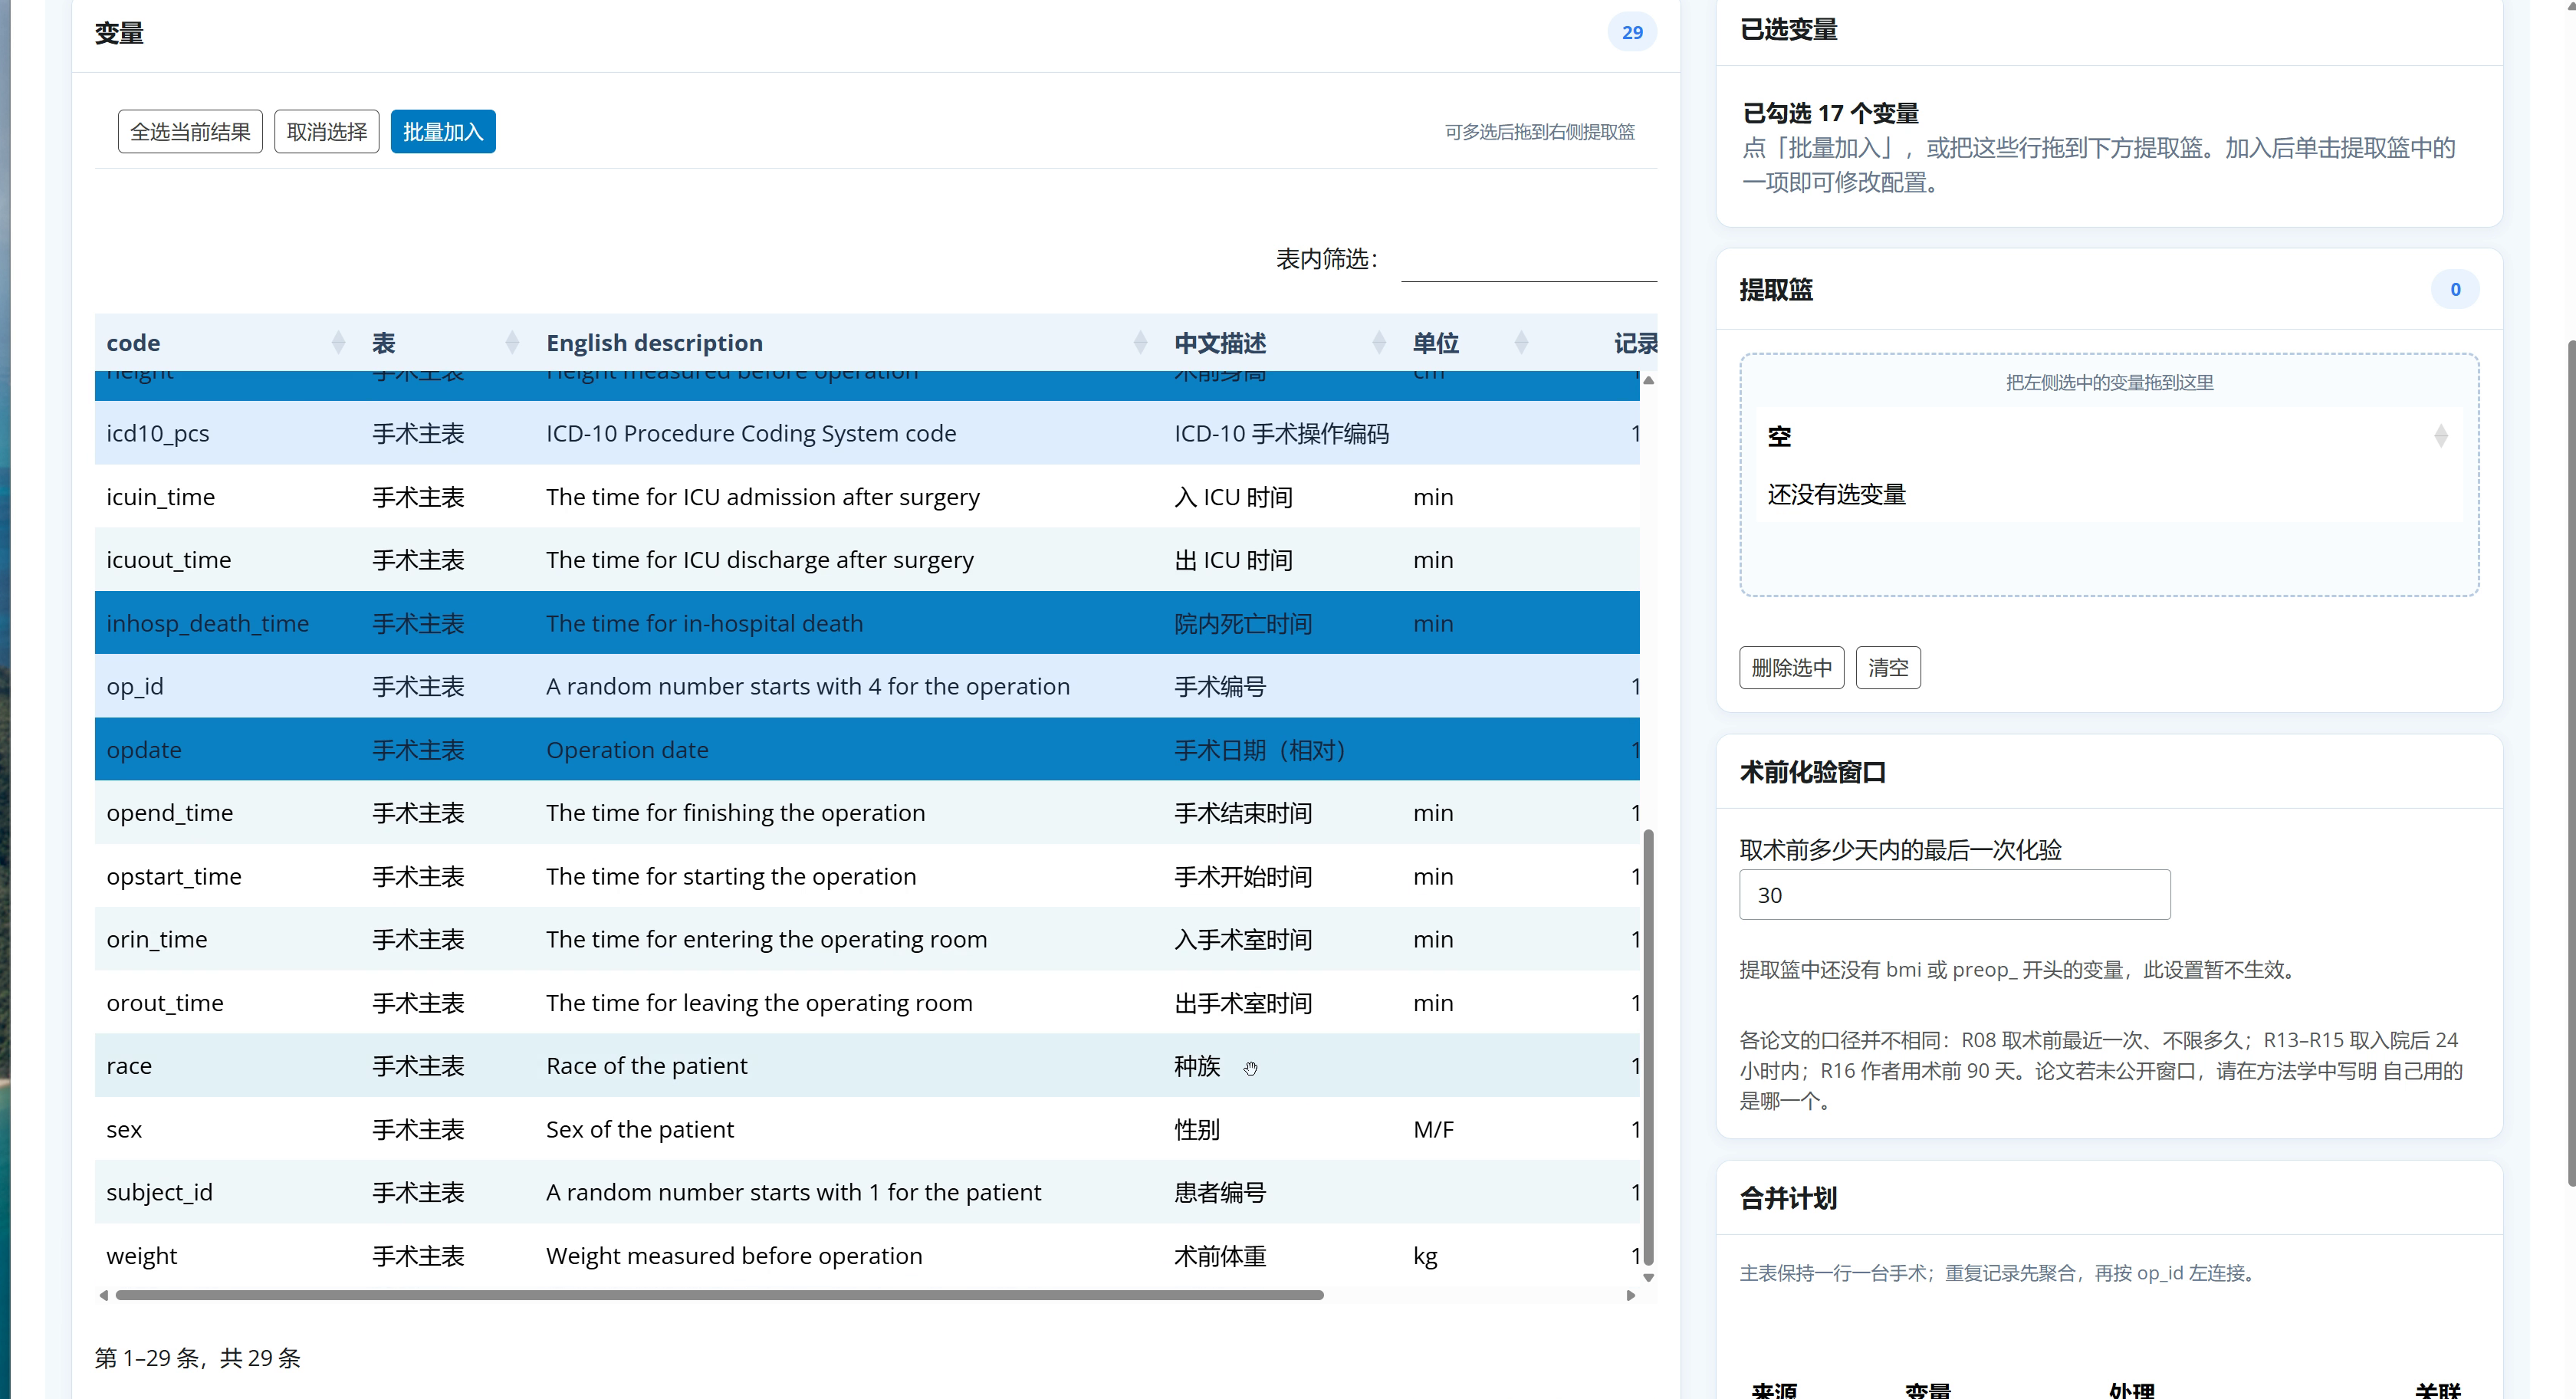
▲ 视频 3 实录:变量篮管理界面,勾选指标集中预览与时间窗参数确认
在各个分类面板中浏览时,你只需在目标变量旁边点击"加入变量篮":
- 基线指标:勾选年龄、性别、BMI、ASA 分级、术前 24h 基线肌酐与血红蛋白;
- 术中监护 :勾选切皮至缝皮期间的平均动脉压(MAP)最低值、平均值,以及 MAP < 65 mmHg 的累积低血压分钟数;
- 术中用药:勾选去甲肾上腺素泵注时间与累计剂量;
- 结局指标:勾选国际 KDIGO 标准的术后急性肾损伤(AKI 1/2/3 期)与住院天数。
所有选中的指标都会陈列在变量篮中,你可以随时查看、删除或微调其时间窗口参数。
四、 核心黑科技:实时反向生成标准纯 R 代码
当你在前端界面完成所有勾选后,点击"生成 R 代码"标签页,眼前将呈现极具震撼力的一幕:
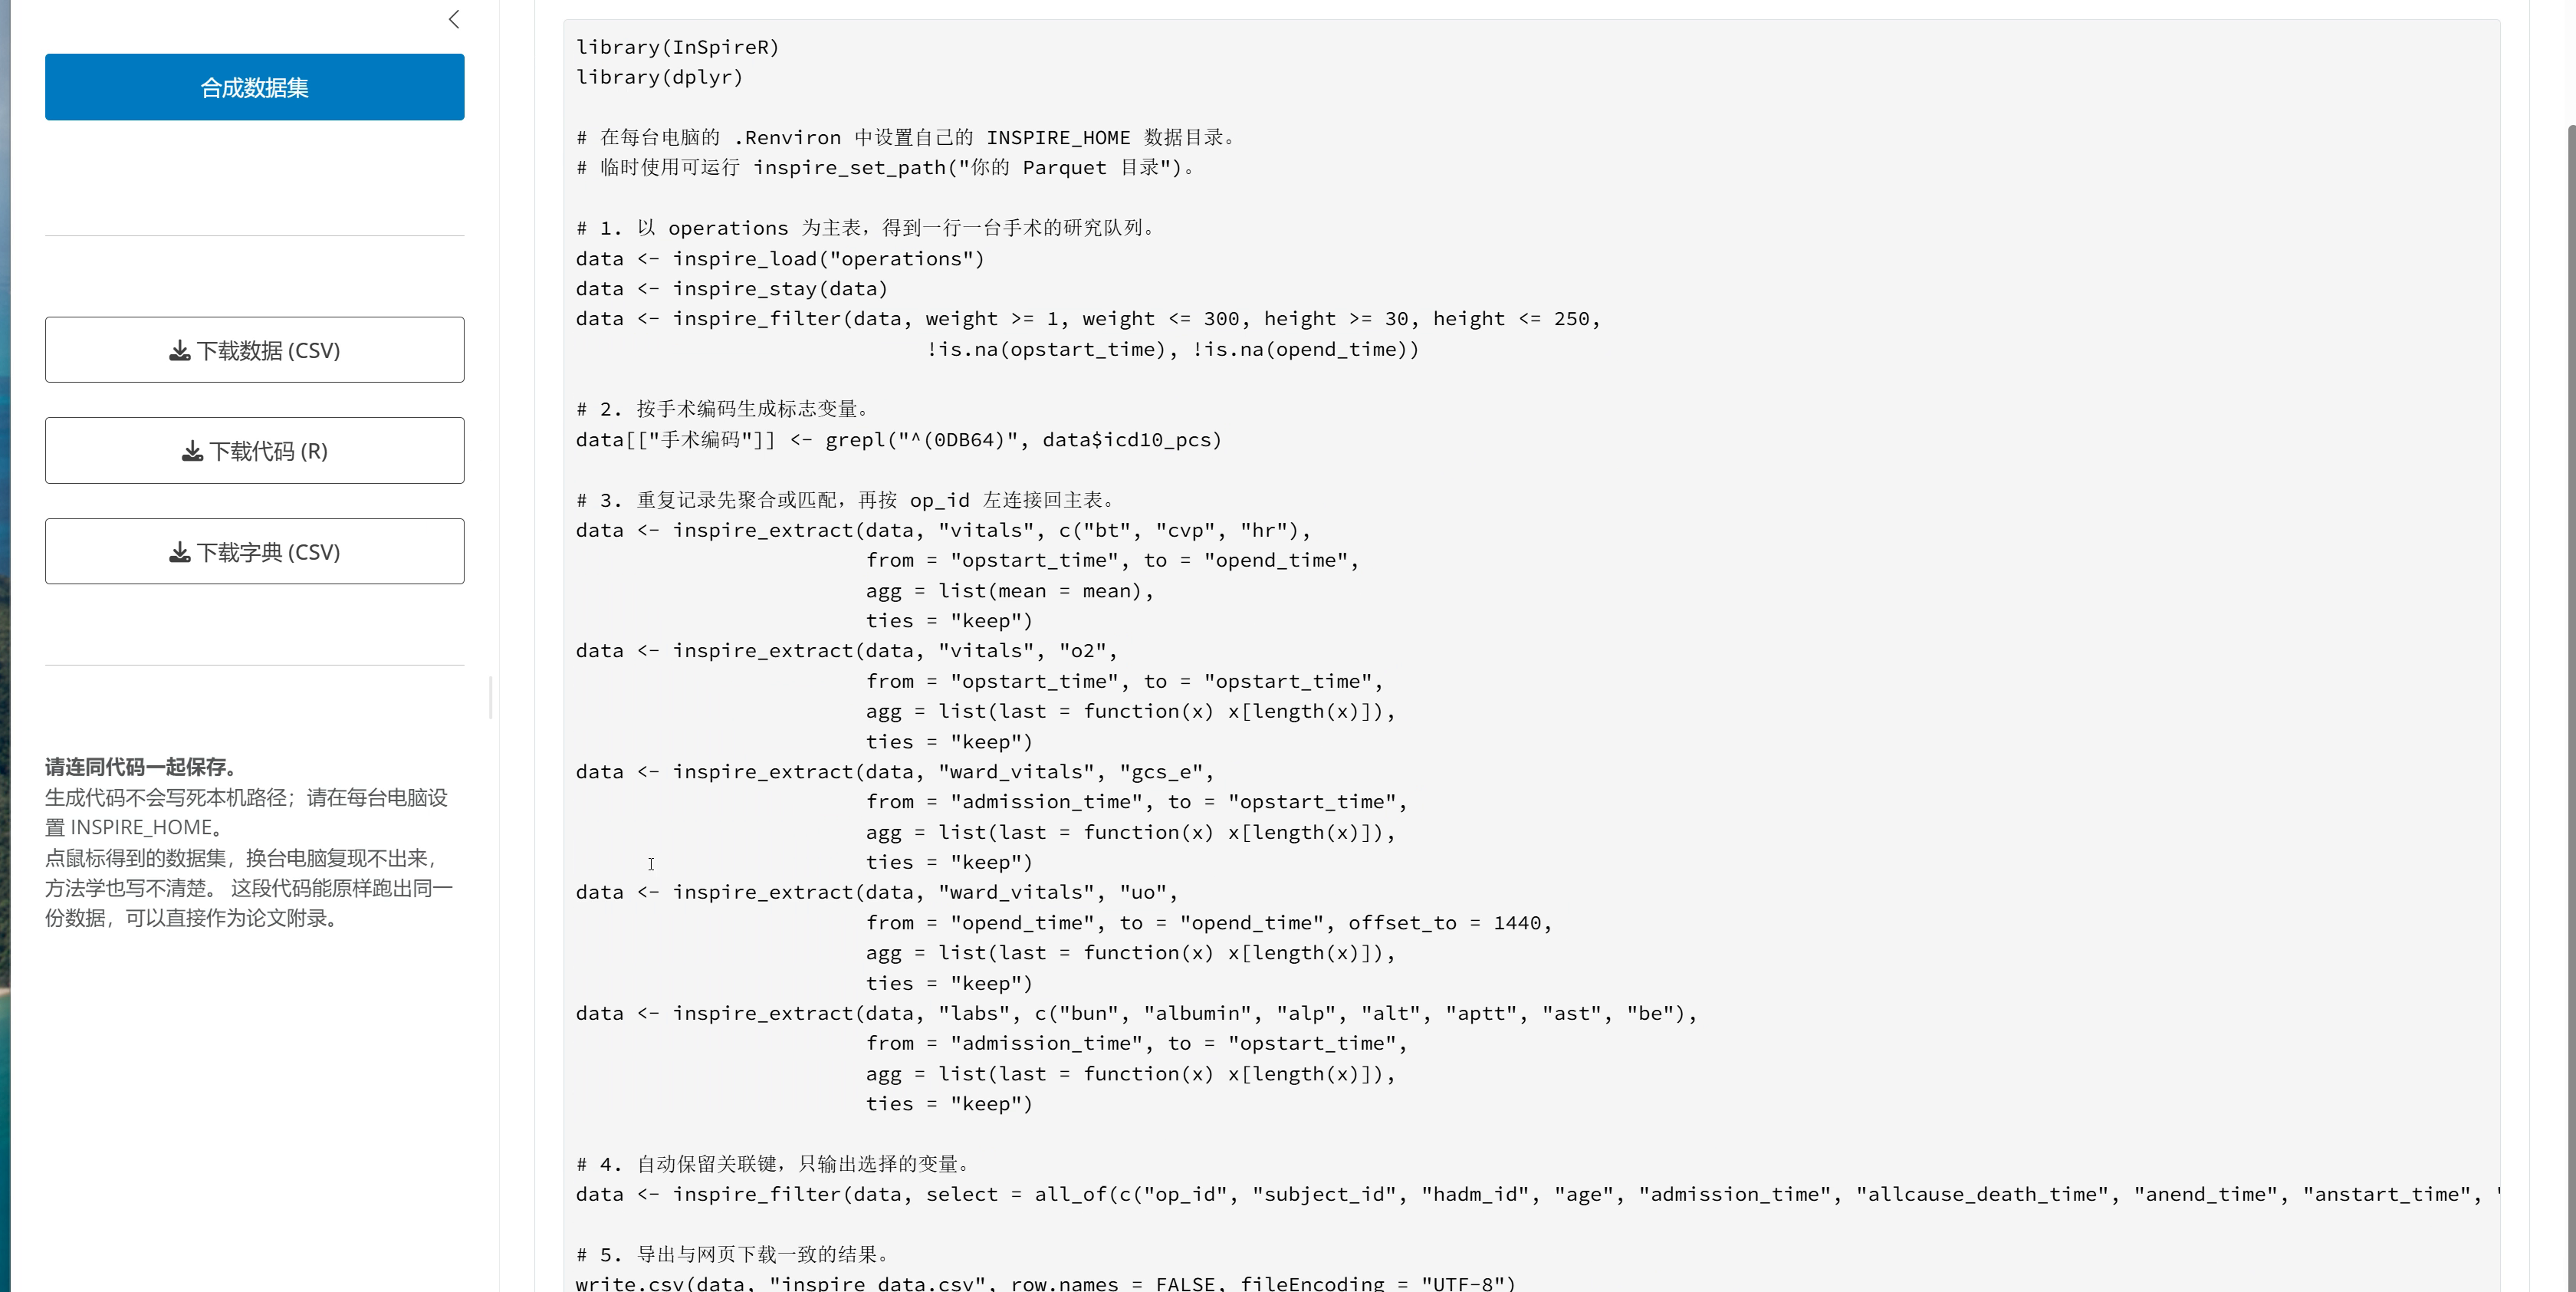
▲ 视频 3 实录:系统界面内嵌代码控制台,所有点选操作即时翻译为标准可复现 R 脚本
界面上的每一个点击动作,都被系统精准翻译成了模块化、带详细注释的标准纯 R 代码:
- 从数据库索引建立,到
extract_baseline_labs()提取基线; - 从
calc_hypotension_exposure()计算低血压,到最后使用left_join按照op_id精确对齐合并; - 完全透明,毫无黑盒 !你可以一键点击右上角的"复制完整代码",保存为自己的
.R脚本或放入 RMarkdown 中,作为论文投稿的附录支撑材料。
五、 成果交付:宽表实时预览与 Excel 一键导出
代码确认无误后,点击"合并宽表与预览"按钮,系统底层引擎飞速运转,几秒钟内便完成了千万级长表数据的清洗、聚合与长宽重构:
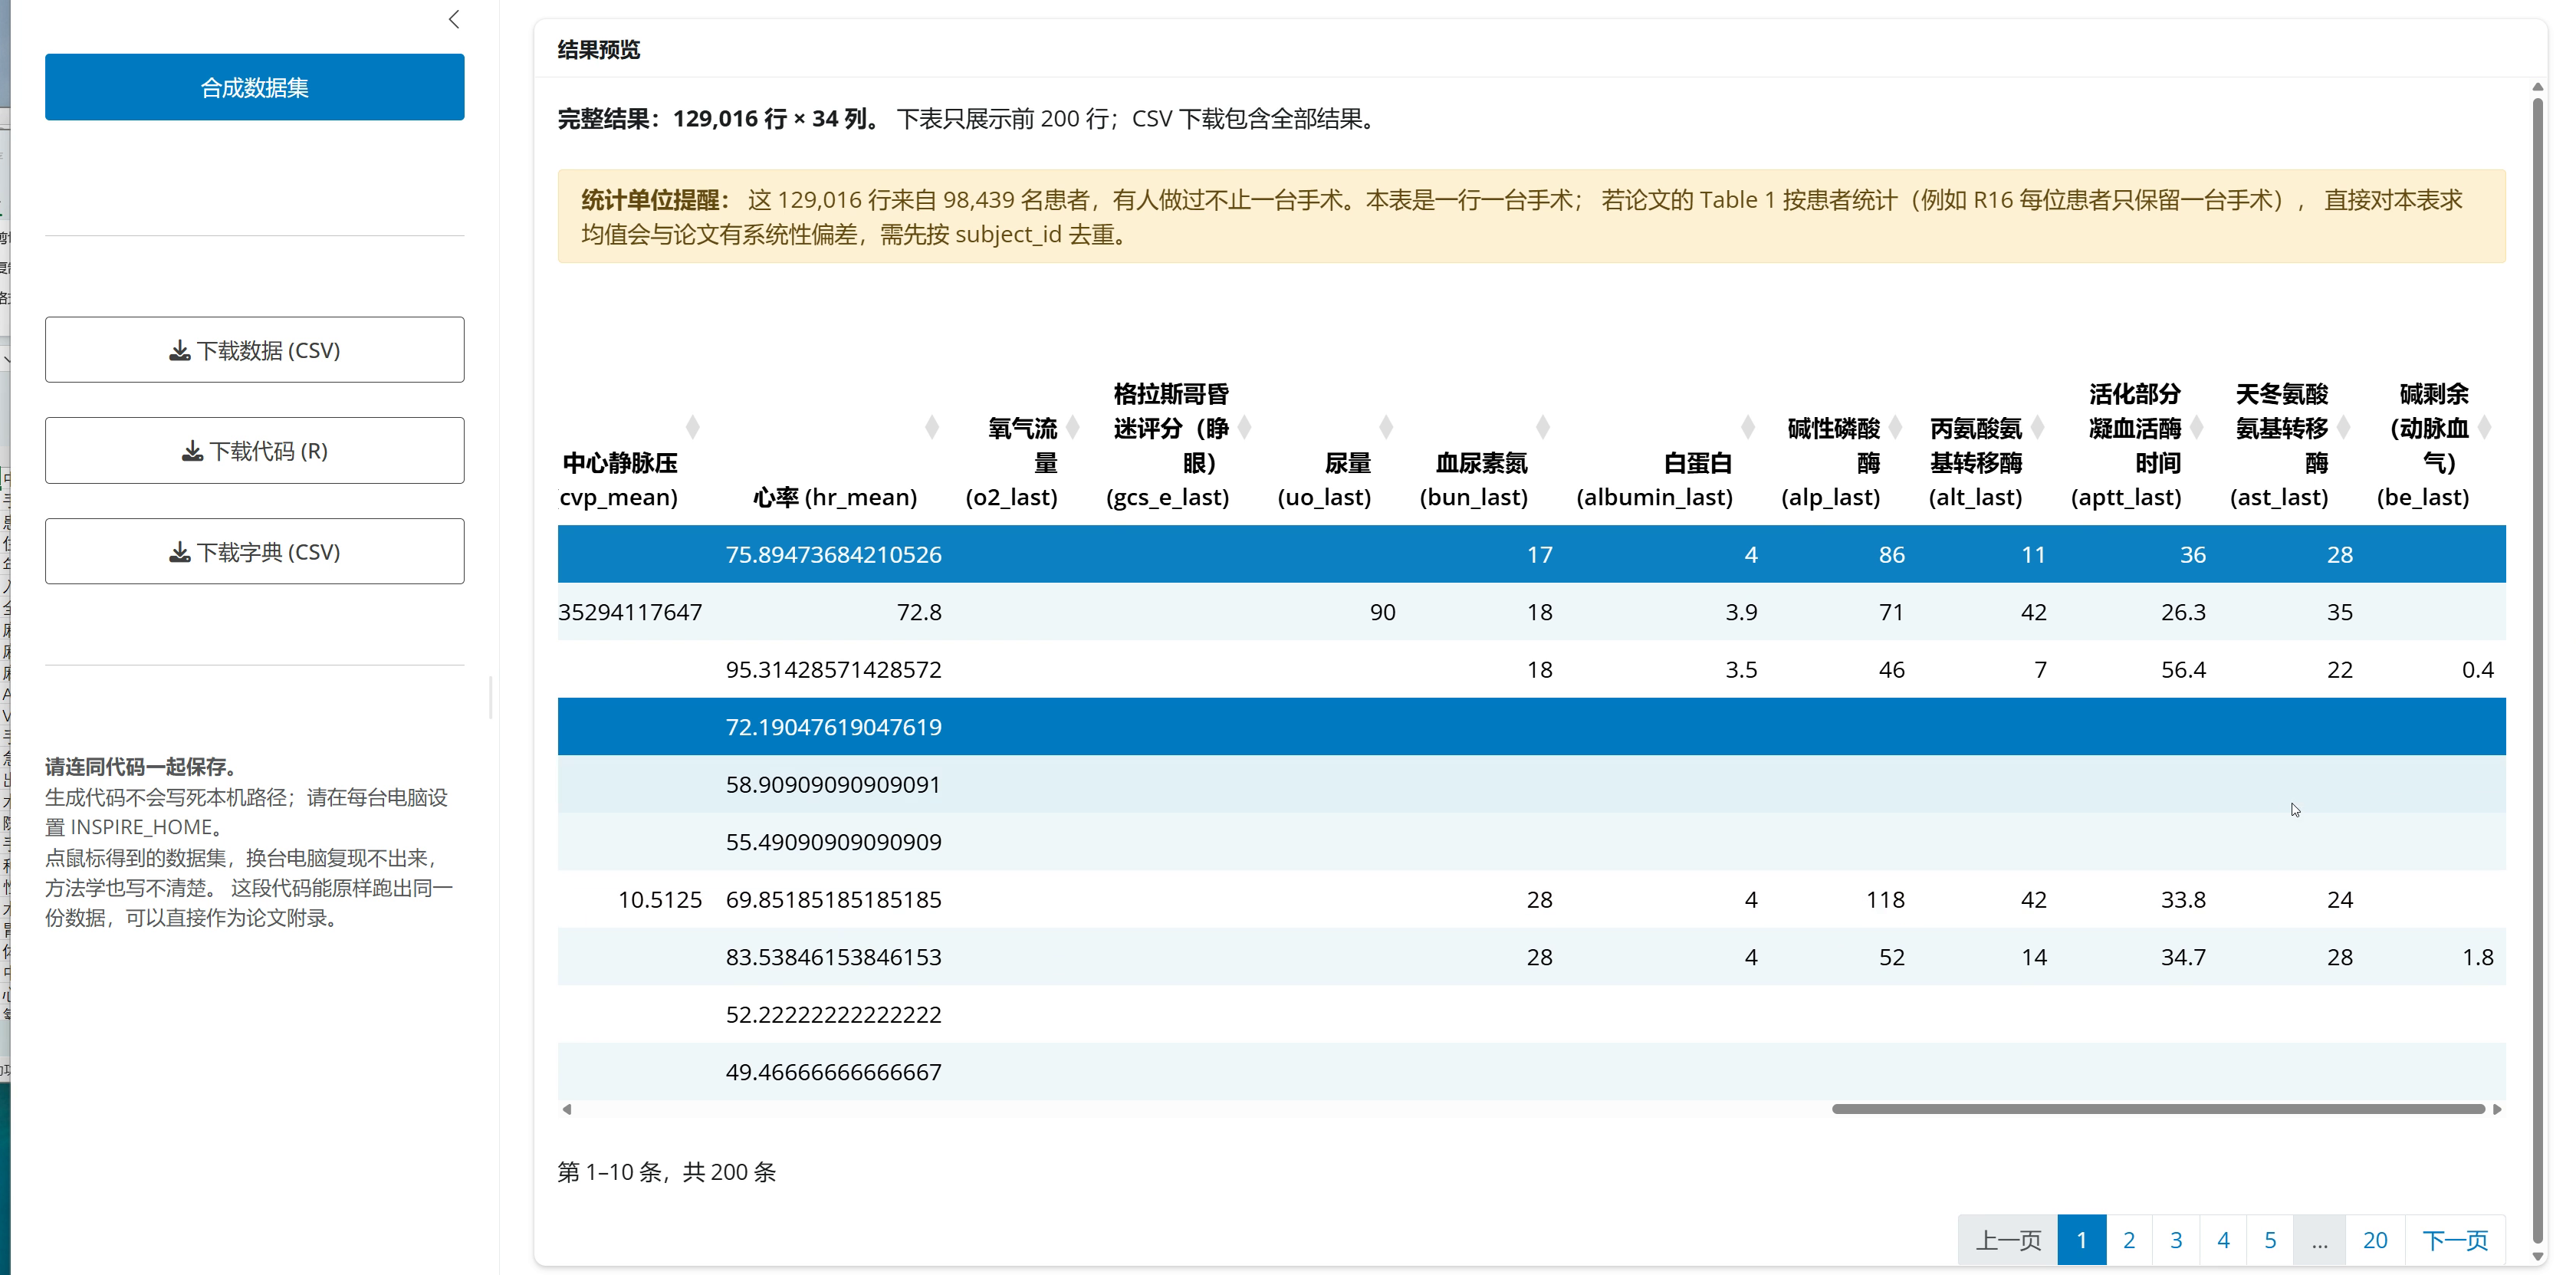
▲ 视频 3 实录:合并后生成的临床科研宽表在界面内即时预览与质量核查
在界面预览中,你可以清楚看到:
- 每一行严格代表一次独立手术事件(
op_id唯一); - 之前分散在不同长表中的年龄、科室、术前肌酐、术中低血压累积分钟数、升压药使用情况以及术后 AKI 状态,整齐划一地横向展开;
- 没有任何乱码,没有多对多引起的样本虚增。
点击界面右上角的"导出为 Excel / CSV",即可将这份凝聚了全库精髓的标准科研宽表下载到本地:
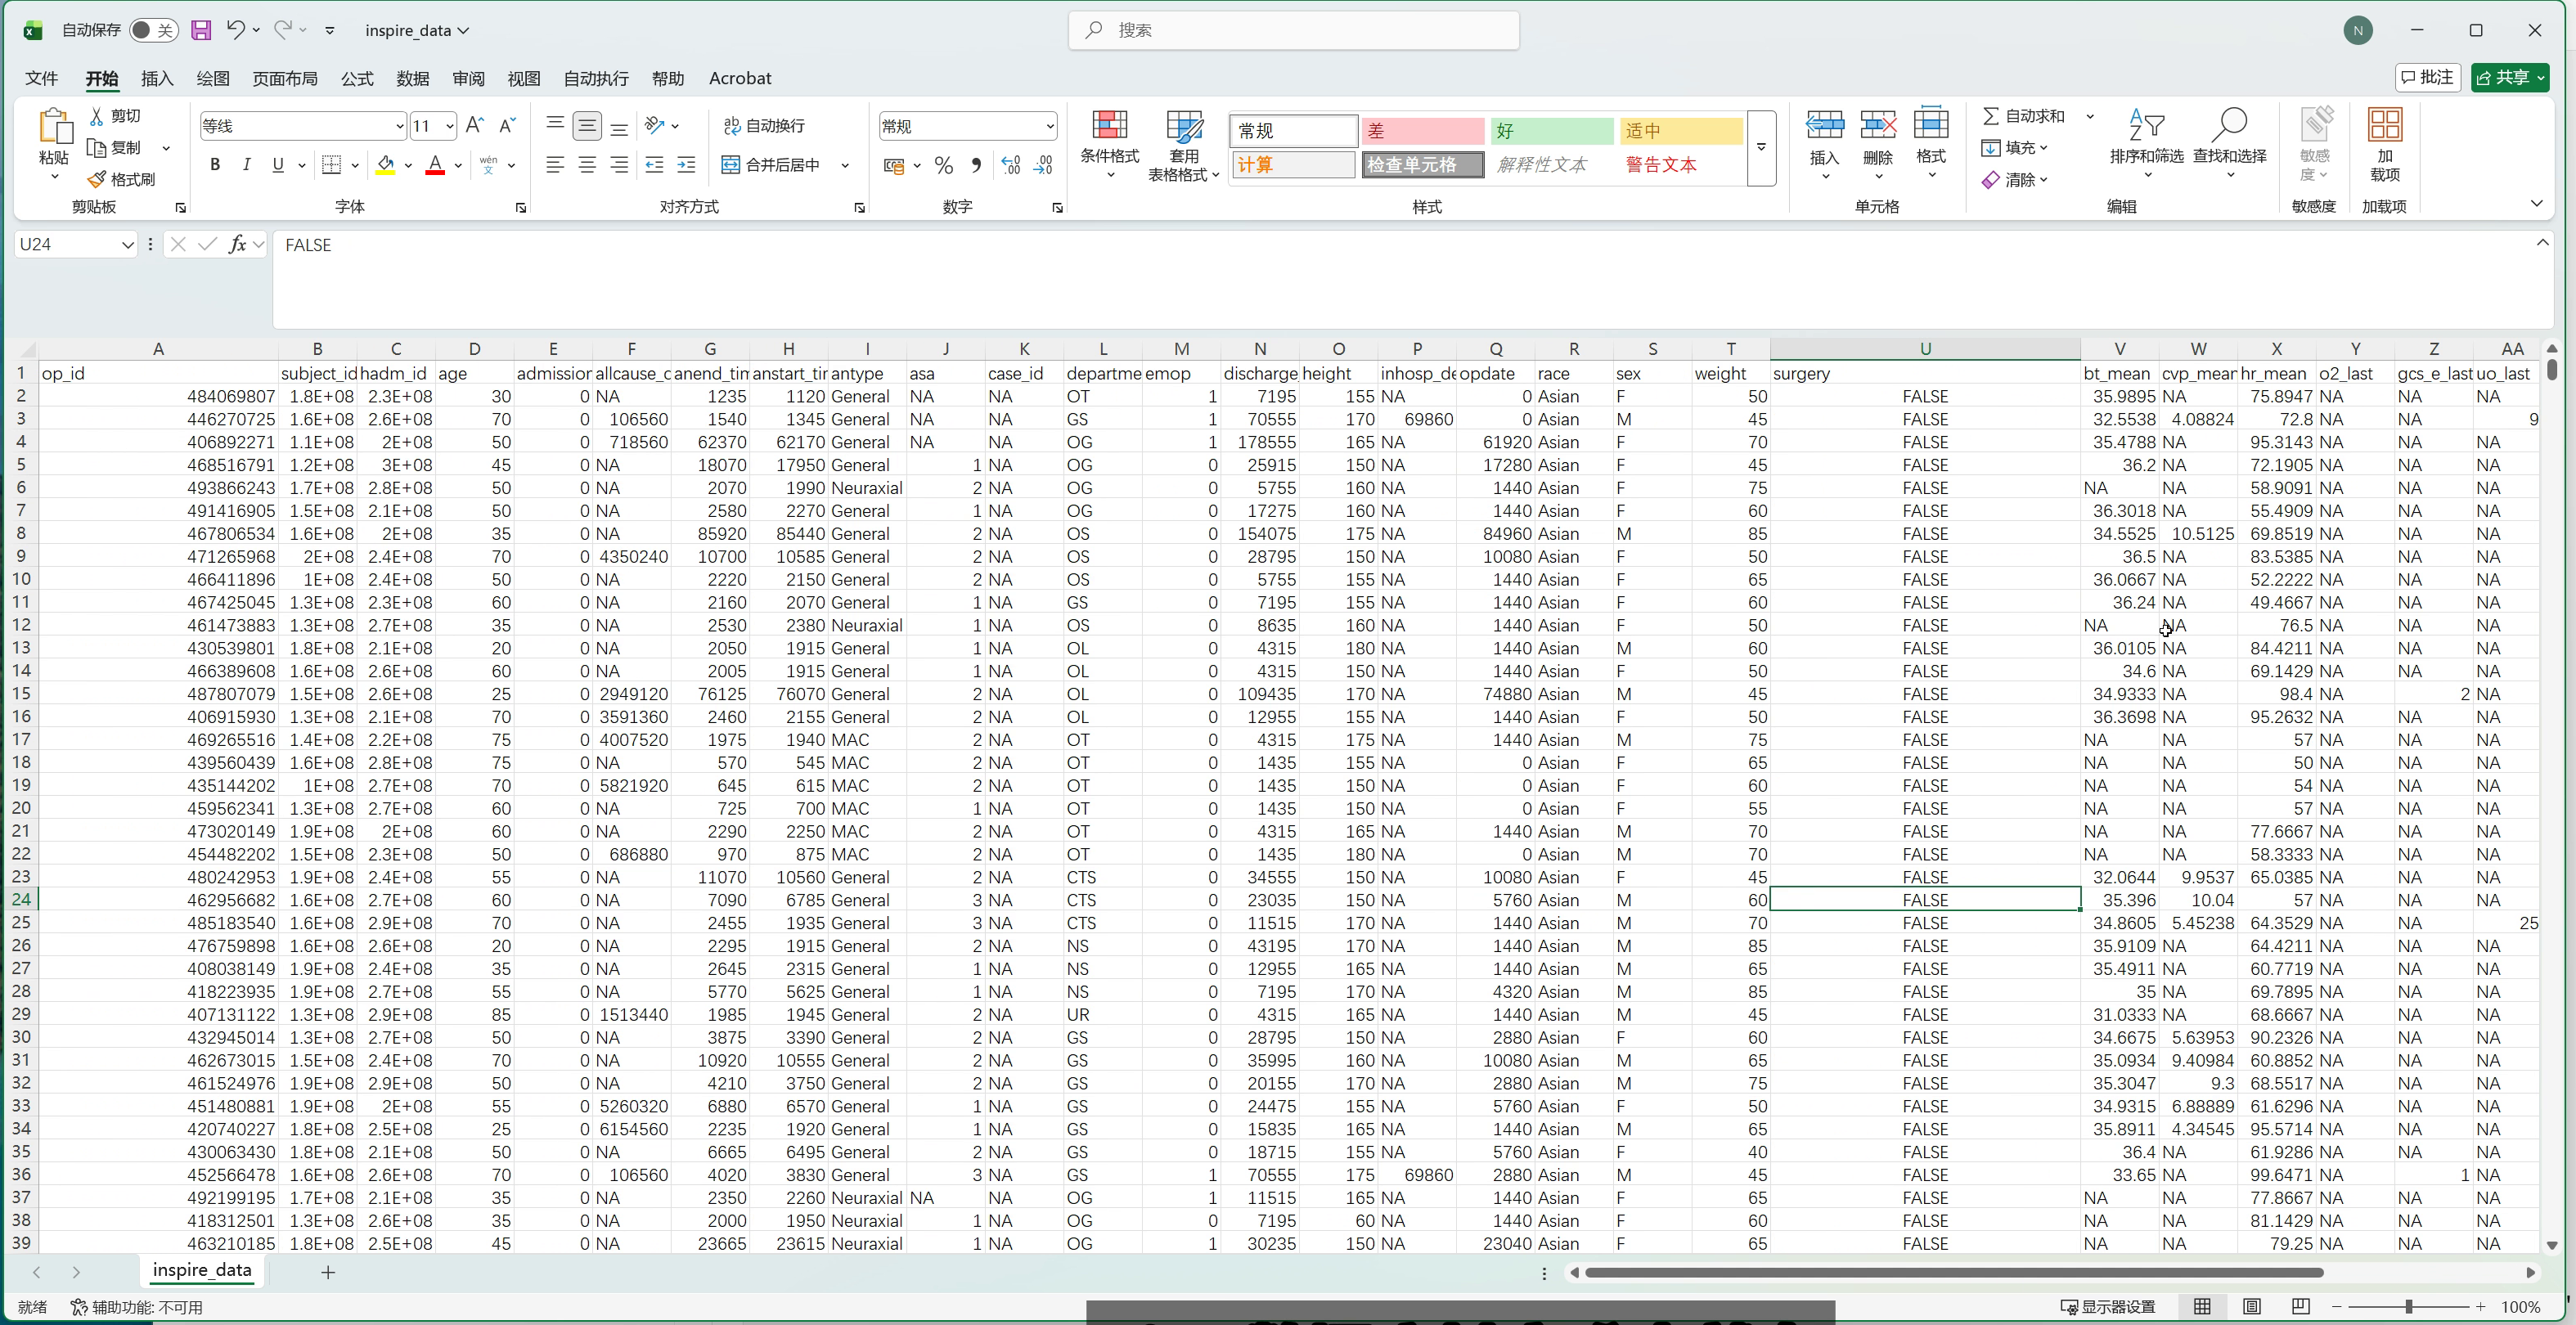
▲ 视频 3 实录:导出的临床科研宽表在 Excel 中原生打开,格式规范,可直接送入后续统计分析
六、 临床宽表质量核查清单:发文前的自我把关
拿到这份导出的规范宽表后,临床研究者可以直接将其导入 SPSS、R 或 MedCalc 开展统计建模。但作为严谨的科研学者,发文前建议对照以下标准清单进行最后核验:
| 核查维度 | 具体核查标准 | InSpireR 系统内置保障 |
|---|---|---|
| 主键唯一性 | 宽表总行数是否与纳入的手术例数严格相等?是否存在重复行? | 系统以 op_id 为基准锚点,强制多对一去重聚合,绝不发生膨胀 |
| 时间窗逻辑 | 术前基线变量采样时间是否严格在手术切皮前? | 函数预设切皮前 24~48h 窗口,杜绝术后指标混入基线 |
| 异常值过滤 | 有创动脉压是否存在生理不可能值(如 MAP > 250 或 < 15 mmHg)? | 底层清洗引擎自动剔除监护仪导联脱落产生的极端伪影 |
| 单位标准化 | 血管活性药物用药速率是否统一转换为微克/公斤/分钟? | 结合患者体重自动标准化单位,消除微克/分混杂误差 |
| 可复现存根 | 是否保存了对应这批数据的完整 R 脚本? | 随时可在代码面板一键导出纯 R 脚本,投稿时随附材料完美备齐 |
七、 总结:释放临床医生的学术生产力
传统的医学大数据研究,临床医生往往有极佳的科学假说,却被横亘在面前的数据库提取、复杂长宽表重构代码死死卡住。
InSpireR 交互系统(Shiny) 的核心意义,在于将繁杂的底层数据工程彻底封装起来,以符合临床直觉的可视化界面呈现给医生、护士和医学研究生;同时又以实时反向生成纯 R 代码的机制,筑牢了顶级科研发表所必须的可复现底线。
你负责提出深刻的临床科学问题,InSpireR 负责为你扫平数据提取的一切障碍。
📚 资源获取与下期预告
- 获取 InSpireR 交互系统完整部署包:欢迎在后台留言交流,获取包含 Shiny 模块的完整包源码与本地配置教程;
- 下期实战预告:在接下来的第 4 讲中,我们将现场演示如何使用 InSpireR 进行更精细的变量模糊搜索与时间序列截取,进一步挖掘罕见指标与高阶监测特征,敬请持续关注!