用 Redis 当消息队列,最直接的想法是 List:LPUSH 进,BRPOP 出,两端操作还都是 O(1)。
真拿它上生产会碰到三个硬伤。第一,BRPOP 弹出来的元素直接从 List 里删了,如果消费者拿到消息、还没处理完就崩了,这条消息就永远消失了,没有"处理失败重来一次"的机会,也就是没有 ACK 机制 。第二,多个消费者同时 BRPOP,一条消息只会被其中一个拿到,没法让"一组消费者共同消费一条流、各拿一部分",也就是没有消费组。第三,消息一旦弹出就没了,想回溯"三天前那条消息是什么"做不到。
换 Pub/Sub 也不行。它是广播,所有在线订阅者都能收到,但消息不落盘,订阅者断线期间的消息直接丢,同样没有 ACK。
Stream 是 Redis 5.0 为此加的,把上面这些缺的东西都补上了。
消息 ID
Stream 里每条消息都带一个 ID,格式是 时间戳-序号:
shell
XADD mystream * name tom
# "1735689600000-0"
* 让 Redis 自己生成 ID。前半段是当前毫秒时间戳,后半段是这一毫秒内的序号(同一毫秒有多条消息时,序号从 0 开始递增)。
也可以手动指定,但必须比已有的最大 ID 大,Stream 不允许插入一个"过去"的 ID:
shell
XADD mystream 1735689600000-5 name jerry这个单调递增的性质是整个 Stream 的基础。后面的范围查询、消费组进度,全都建立在"ID 有序且可比大小"这一点上。
- 和 + 是两个特殊的边界,分别表示最小 ID 和最大 ID:
shell
XRANGE mystream - +          # 读全部
XRANGE mystream - + COUNT 10 # 只读前 10 条
存储结构
Stream 的底层是 radix tree(rax,基数树)加 listpack 两层:
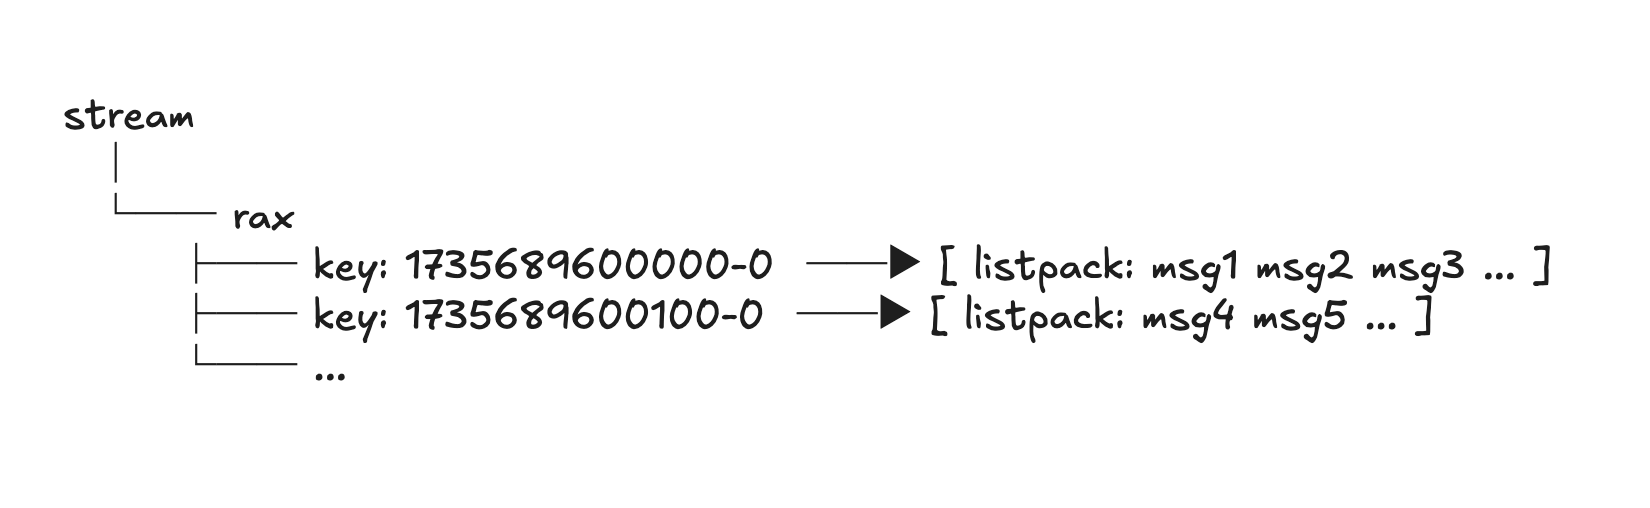
rax 的 key 是消息 ID(编码成 16 字节的字节串),value 是指向一个 listpack 的指针。一个 listpack 里装一批 ID 连续的消息,装满了就开下一个节点。
listpack 的容量由两个参数控制:
text
stream-node-max-bytes    默认 4096   一个 listpack 最多多少字节
stream-node-max-entries  默认 100    一个 listpack 最多多少条消息
为什么用 radix tree 而不是普通哈希表?因为消息 ID 是递增的,大量 ID 共享前缀(时间戳的高位在很长一段时间里都一样)。rax 按前缀压缩存储,共享前缀的 key 只存一份,内存省;而且它天生支持按 key 顺序的范围查询,XRANGE 找一段 ID 区间就是顺着树走,效率高。普通哈希表做不到范围查询。
至于每个节点又用 listpack,是同一套思路:一批连续的消息塞在一块连续内存里,没有每条消息一个指针的开销。
追加和裁剪
shell
XADD mystream * name tom      # 追加
XLEN mystream                 # 消息总数
Stream 默认不会自动删消息 ,XADD 一直加,内存一直涨。要控制长度得自己裁剪:
shell
# 直接裁到最多 1000 条
XTRIM mystream MAXLEN 1000

# 追加的时候顺手裁
XADD mystream MAXLEN 1000 * name tom
MAXLEN 后面加一个 ~ 是近似裁剪:
shell
XADD mystream MAXLEN ~ 1000 * name tom不加 ~ 时,Redis 会精确地把长度裁到 1000,可能需要从 listpack 中间删消息,成本高。加了 ~,Redis 按 listpack 节点整块整块地删,删到差不多 1000 就停,结果可能是 1000 多一点,但快很多。生产上一般都用 ~,反正多几条少几条无所谓。
除了按条数,还能按 ID 裁剪,XTRIM mystream MINID 1735689600000 表示删掉比这个 ID 小的消息。按时间删历史消息用这个。
消费组
消费组是 Stream 和 List 最大的区别。多个消费者加入同一个组,消息在组内分摊,每条新消息只被组里的一个消费者拿到。
shell
# 创建消费组,$ 表示从最新消息开始消费,0 表示从头开始
XGROUP CREATE mystream mygroup $
$ 和 0 的选择很关键。$ 是"只关心从现在开始的新消息",历史消息不管。如果这个流是用来接线上流量的,用 $;如果是想把已经攒下的消息也消费掉,用 0。
消费者从组里读消息:
shell
XREADGROUP GROUP mygroup consumer1 COUNT 10 STREAMS mystream >> 表示"只给我还没投递给任何人的新消息"。如果换成具体的 ID(通常是 0),意思是"给我这个消费者自己还没 ACK 的消息",这是用来重新处理积压的。
组内部维护一个 last_delivered_id,记录这个组已经投递到哪个 ID 了。同一组里不管有多少个消费者,每条新消息只会投给其中一个,last_delivered_id 一起往前推。
Pending 和 ACK
消息投出去不等于处理完了。消费者从组里读到一条消息,这条消息就进入这个组的 PEL(Pending Entries List,待确认列表),一直挂在那儿,直到消费者显式确认:
shell
XACK mystream mygroup 1735689600000-0XACK 把这条消息从 PEL 里移除,表示"处理完了"。
看看有哪些还没确认的:
shell
XPENDING mystream mygroup
# 1) (integer) 2                    待确认的消息总数
# 2) "1735689600000-0"              最小 ID
# 3) "1735689600100-0"              最大 ID
# 4) 1) 1) "consumer1"              每个消费者各有多少条待确认
#       2) "2"
PEL 是用来处理"消费者崩了"这个情况的。消费者从组里拿了消息但没 XACK 就挂了,这些消息不会丢,还挂在 PEL 里,属于那个已经死掉的消费者。可以用 XCLAIM 把它们转给别的消费者:
shell
# 把闲置超过 60 秒、属于别人的消息抢过来
XAUTOCLAIM mystream mygroup consumer2 60000 0-0XAUTOCLAIM(6.2 加的)里的 60000 是"闲置时间",单位毫秒,意思是"只抢那些超过 60 秒没被碰过的消息"。这样能防止把一个还在正常处理消息的消费者的活抢走。
PEL 加
XCLAIM这套机制,让 Stream 做到了至少一次投递 。一条消息保证不会因为消费者崩溃而丢,但它可能被投递多次------原消费者处理完了、还没来得及XACK就超时被XCLAIM走了,新的消费者又处理了一遍。所以消费端必须自己保证幂等,靠消息 ID 去重是最常见的做法。
XAUTOCLAIM 抢过来的消息如果又没处理成功,会一直留在 PEL 里,靠着它超过一个阈值,方便人发现"这批消息有问题"。队列的积压和死信就是在这个层面判断的。
和 List、Pub/Sub 的区别
| 能力 | List | Pub/Sub | Stream |
|---|---|---|---|
| 消息持久化 | 有(在内存里) | 无 | 有 |
| ACK 确认 | 无 | 无 | 有(PEL + XACK) |
| 消费组 | 无 | 无 | 有 |
| 一条消息给多个消费者 | 否,一个消费者拿走 | 是,广播给所有订阅者 | 可以,不同消费组各收一份 |
| 断线重连收到历史 | 否 | 否 | 可以(指定 ID 补读) |
| 回溯历史消息 | 否,弹出即删 | 否 | 可以(XRANGE) |
三者的定位不一样:
- List 最简单,
LPUSH+BRPOP。适合"发了就别管"的简单队列。它没有 ACK,BRPOP一弹出消息就没了,消费者崩了消息就丢,所以只能用在允许丢消息的场景 - Pub/Sub 是广播,适合"实时通知",比如配置变更通知所有节点。它不落盘,订阅者断线时的消息直接丢,这是设计如此,它就没打算做可靠投递
- Stream 是完整的消息队列,有持久化、ACK、消费组、回溯。代价是比 List 重,
XACK、XPENDING、XCLAIM这些都要自己管
不过要清楚,Stream 再完整也只是单机 Redis 上的一个结构。Redis 主从复制是异步的,主库挂了没同步过去的那部分消息仍然会丢;XAUTOCLAIM 的"至少一次"也需要消费端自己写幂等。真要做到不丢、还要跨机房,得上 Kafka、RabbitMQ 这类专门的中间件。Stream 适合的是"消息量不大、已经有了 Redis、不想再引一套 MQ"的场景。