文章目录
前言
在上一篇文章中,我们深入学习了 Redis 持久化、事务与主从复制,解决了数据安全、命令原子性和基础读写扩容的问题。但主从架构仍存在主节点故障需人工切换的致命痛点,单组主从无法支撑海量数据存储的业务需求,同时 Redis 作为缓存核心组件,还会面临穿透、击穿、雪崩三大经典生产问题,分布式系统下的多节点资源竞争,也需要专用的锁机制来保障线程安全。
本文将进入 Redis生产环境终极实战篇章,覆盖四大企业级核心能力:
哨兵模式:实现主从架构的自动故障转移、监控与通知,打造无人工干预的高可用 Redis 服务;
Redis 集群:基于哈希槽算法实现数据分布式存储,突破单节点容量与性能瓶颈,支持水平扩容、故障自愈;
缓存优化:详解内存淘汰策略、缓存预热,系统性解决缓存穿透、击穿、雪崩三大问题;
分布式锁:基于 Redis 实现分布式互斥控制,覆盖锁安全、看门狗续约、Redlock 算法等核心细节。
全文结合Docker 实战部署、原理剖析、生产避坑、解决方案,帮你构建完整的 Redis 生产级知识体系,真正实现 Redis 服务的高可用、分布式、高性能与安全可控。
哨兵
Redis主从复制模式下,如果主节点挂了(即无法正常访问了),就需要人工进行主从切换+把大量的客户端和从节点切换到新的主节点上
--如果使用哨兵模式的话就可以自动完成了
Redis哨兵核心功能:1.监控 2.自动的故障转移 3.通知哨兵节点不负责存储数据!
哨兵+主从复制解决的是提高可用性的问题,不能解决"数据极端情况下写丢失"的问题哨兵+主从复制不能提高数据的存储容量--redis集群才是解决存储容量的方案
一个哨兵进程会提供多个哨兵节点去监控现有的主从节点(通过跟那些节点建立tcp长连接来定期发送心跳包的方式来检查)
--如果是从节点挂了,不用管
--如果是主节点挂了:1.需要多个哨兵节点共同认同这件事
2.这些哨兵节点中会推举出一个
leader从现有的从节点中挑选出一个新的主节点(注意不是直接选出新的主节点!是先选leader再...)
选
leader:讲究的是先到先得(即谁网速快)--可以自己投给自己比如节点1反应最快,说自己要当
leader,其他人会把票投给最先发出拉票请求的人选新的主节点:
a.优先级:每个redis数据节点在配置文件中都有
slave-priority,优先级高的优先b.上面相同的话,就看
offset,offset越大的优先c.如果上面的都一样的话,就看
run id--此时就是随机的了3.挑选出新的主节点之后,哨兵节点就会自动控制该被选中的节点执行
slave no one并控制其他从节点slaveof到新的主节点上4.哨兵节点会自动通知客户端说明新的主节点,后续客户端再进行写操作,就是对新的主节点进行操作了
关于哨兵模式搞多少个节点:1.是可只搞单个节点的,但是误判的概率很高(因为网络传数据容易抖动、延迟、丢包)+自身本来也就容易挂--所以不推荐
2.节点数最好是单数--因为那里判断是不是挂了需要超过半数的节点认为挂了才是挂了 --大部分情况下三个就够了
在实际生产过程中,主节点、不同节点、不同哨兵节点都需要在不同的云服务器上运行才是有意义的--可以用
docker来构造出虚拟环境
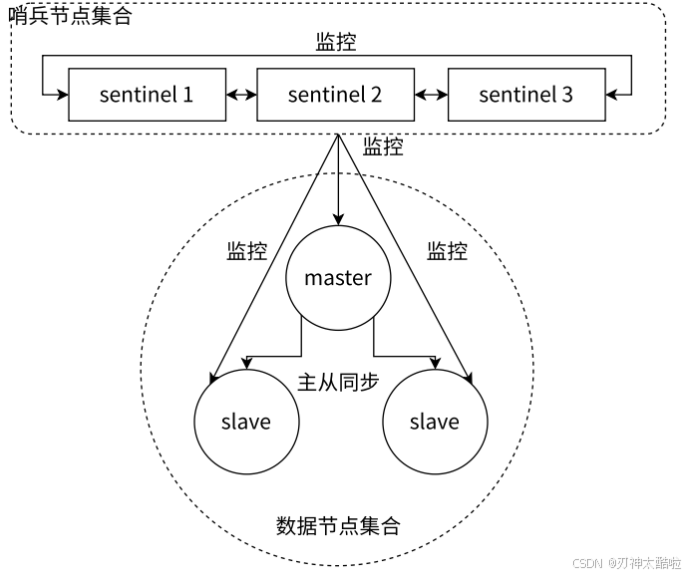
基于docker构建redis哨兵环境
具体操作不需要记忆,到时候查就行了
关于镜像和容器:镜像就是已经搞好了的环境(类似可执行程序) 容器就是镜像运行起来后的东西(进程)
docker的镜像的话可用去docker hub上面去找
docker里面的端口号跟外面宿主机的端口号是两个体系,不会彼此冲突的
docker-compose启动容器的顺序是不确定的!
具体步骤:1.安装
docker和docker-compose2.停止之前的redis服务器3.使用docker获取到redis的镜像(
docker pull redis:5.0.9--这里面是一个精简版的linux,里面有redis)4.编排redis主从节点:
a.写
docker-compose.yml(用yml格式)
ymlversion: '3.7' services: master: image: 'redis:5.0.9' container_name: redis-master restart: always command: redis-server --appendonly yes ports: - 6379:6379 slave1: image: 'redis:5.0.9' container_name: redis-slave1 restart: always command: redis-server --appendonly yes --slaveof redis-master 6379 ports: - 6380:6379 slave2: image: 'redis:5.0.9' container_name: redis-slave2 restart: always command: redis-server --appendonly yes --slaveof redis-master 6379 ports: - 6381:6379 #6381是宿主机端口号 6379是容器内部的端口号b.启动所有容器
docker-compose up -d(停止并删除容器是docker-compose down)c.查看运行日志
docker-compose logs5.编排哨兵节点:(要跟上一步分开两组启动,不然不能保证
redis-server一定在哨兵之前启动)a.编写
docker-compose.yml
ymlversion: '3.7' services: sentinel1: image: 'redis:5.0.9' container_name: redis-sentinel-1 restart: always command: redis-sentinel /etc/redis/sentinel.conf volumes: - ./sentinel1.conf:/etc/redis/sentinel.conf ports: - 26379:26379 sentinel2: image: 'redis:5.0.9' container_name: redis-sentinel-2 restart: always command: redis-sentinel /etc/redis/sentinel.conf volumes: - ./sentinel2.conf:/etc/redis/sentinel.conf ports: - 26380:26379 sentinel3: image: 'redis:5.0.9' container_name: redis-sentinel-3 restart: always command: redis-sentinel /etc/redis/sentinel.conf volumes: - ./sentinel3.conf:/etc/redis/sentinel.conf ports: - 26381:26379 networks: default: external: name: redis-data_default # 必须要加这个,来让这三个哨兵节点加入到上面的局域网中而不是创建新的局域网b.创建配置文件:
sentinel1.conf、sentinel2.conf和sentinel3.conf都放到/root/redis-sentinel/中
confbind 0.0.0.0 port 26379 sentinel monitor redis-master redis-master 6379 2 sentinel down-after-milliseconds redis-master 1000 //心跳包超时时间c.启动所有容器:
docker-compose up -dd.查看运行日志:docker-compose logs
日志里面:
sdown是主观下线--就是本哨兵节点认为主节点挂了
odown是客观下线--多个哨兵节点投票达成一致石锤挂了的事实
集群
广义的集群:多个机器构成了分布式系统都可用称作是集群
狭义的集群:指redis提供的集群模式
集群的主要作用就是解决容量不够、性能不够、单点故障的问题
把数据分成多份,三种主流的分法:1.哈希求余
针对要插入的数据的
key计算hash值(比如md5算法),再把这个hash值余上分片个数得到下标,然后把这个数据放到该下标对应的分片中 --后续查询key时,也是用的同样的方法--但是这种方法如果需要扩容(即引入新分片)的话,开销是很大的,几乎数据全都要进行迁移
2.一致性哈希算法
跟上面那种方法差不多,就是分片间这里是连续的,但是上面是间断的
--这种方法在扩容时,几个分片上的数据量会不均匀(数据倾斜)
3.哈希槽分区算法
hash_slot = crc16(key) % 16384这个值表示这个数据应该存储在哪个槽位里关于哪个分片拥有哪些槽位:刚开始就是把
16384个槽位平均连续分配给各分片--扩容时就是把每个分片的末尾割点给新分片(但是具体的方法可以在配置文件中改)--各分片记忆自己槽位是用位图的方法来记忆的(
16384个比特位...)--这个算法才是redis真正采用的算法
关于
16384:redis集群最多有16384个分片吗?
理论上是的,但是Redis作者建议集群分片数不应该超过
1000--因为多了不好保证数据在各分片上的均衡性+集群的可用性会很堪忧为啥是
16384个槽位?1.Redis集群不建议超过1k个分片--所以16k就够用了,同时也使对应的槽位配置位图体积不用很大
2.节点之间通过心跳包(里面包含了节点持有哪些哈希槽)通信,16k个哈希槽需要的位图是2KB,但是如果大了的话(比如65536个哈希槽),在频繁的通信里面,还是很吃网络带宽的
如果集群中有节点挂了--集群机制也是有故障转移的(Raft算法)1.判断是不是真挂了(主观下线 客观下线)--这里跟哨兵的一模一样
2.故障的迁移:
如果是从节点那就不用管了;如果是主节点,就会由他的从节点触发故障迁移
a.从节点先判断自己有无参选资格(太久跟主节点每通信的是没有竞选资格的)
b.具有资格的节点,会先休眠一段时间(休眠时间=500ms+0,500ms的随机时间+排名(offset越大,排名越靠前)+1000ms)
c.休眠时间到的就能进行拉票了(只有主节点有投票资格)--谁休眠时间短,大概率就是新的主节点了
d.收到的票数超过主节点数目一般的从节点就会晋升成主节点(那个从节点会自己执行
slaveof no one,然后其余原本的从节点转到这个节点下)e.这个从节点还会把自己成为主节点的信息同步给其他集群的节点来更新他们保存的集群结构信息
会出现集群宕机的情况:1.某个分片里面的所有主从节点都挂了 2.某个分片主节点挂了,并且没有从节点了
3.超过半数的主节点都挂了
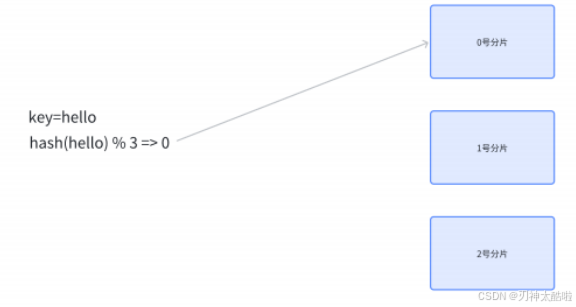
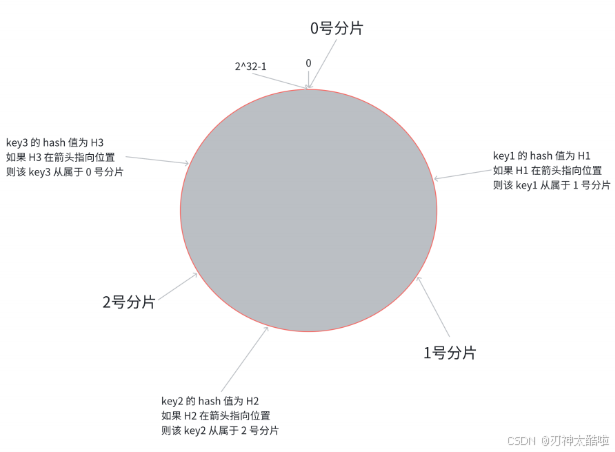
基于docker搭建一个redis集群
目标是构建成这样
具体步骤:
1.创建目录和配置
创建
redis-cluster目录,内部创建两文件docker-compose.yml和generate.sh
bash这是generate.sh的内容,执行bash generate.sh这个脚本就会执行了 # 批量创建端口1-9的Redis节点配置 for port in $(seq 1 9); \ do \ mkdir -p redis${port}/ touch redis${port}/redis.conf cat << EOF > redis${port}/redis.conf port 6379 bind 0.0.0.0 protected-mode no appendonly yes cluster-enabled yes cluster-config-file nodes.conf cluster-node-timeout 5000 cluster-announce-ip 172.30.0.10${port} cluster-announce-port 6379 cluster-announce-bus-port 16379 EOF done # 批量创建端口10-11的Redis节点配置 for port in $(seq 10 11); \ do \ mkdir -p redis${port}/ touch redis${port}/redis.conf cat << EOF > redis${port}/redis.conf port 6379 bind 0.0.0.0 protected-mode no appendonly yes cluster-enabled yes cluster-config-file nodes.conf cluster-node-timeout 5000 cluster-announce-ip 172.30.0.1${port} cluster-announce-port 6379 cluster-announce-bus-port 16379 EOF done
yml这是docker-compose.yml: version: '3.7' networks: mynet: ipam: config: - subnet: 172.30.0.0/24 services: redis1: image: 'redis:5.0.9' container_name: redis1 restart: always volumes: - ./redis1/:/etc/redis/ ports: - 6371:6379 - 16371:16379 command: redis-server /etc/redis/redis.conf networks: mynet: ipv4_address: 172.30.0.101 redis2: image: 'redis:5.0.9' container_name: redis2 restart: always volumes: - ./redis2/:/etc/redis/ ports: - 6372:6379 - 16372:16379 command: redis-server /etc/redis/redis.conf networks: mynet: ipv4_address: 172.30.0.102 redis3: image: 'redis:5.0.9' container_name: redis3 restart: always volumes: - ./redis3/:/etc/redis/ ports: - 6373:6379 - 16373:16379 command: redis-server /etc/redis/redis.conf networks: mynet: ipv4_address: 172.30.0.103 redis4: image: 'redis:5.0.9' container_name: redis4 restart: always volumes: - ./redis4/:/etc/redis/ ports: - 6374:6379 - 16374:16379 command: redis-server /etc/redis/redis.conf networks: mynet: ipv4_address: 172.30.0.104 redis5: image: 'redis:5.0.9' container_name: redis5 restart: always volumes: - ./redis5/:/etc/redis/ ports: - 6375:6379 - 16375:16379 command: redis-server /etc/redis/redis.conf networks: mynet: ipv4_address: 172.30.0.105 redis6: image: 'redis:5.0.9' container_name: redis6 restart: always volumes: - ./redis6/:/etc/redis/ ports: - 6376:6379 - 16376:16379 command: redis-server /etc/redis/redis.conf networks: mynet: ipv4_address: 172.30.0.106 redis7: image: 'redis:5.0.9' container_name: redis7 restart: always volumes: - ./redis7/:/etc/redis/ ports: - 6377:6379 - 16377:16379 command: redis-server /etc/redis/redis.conf networks: mynet: ipv4_address: 172.30.0.107 redis8: image: 'redis:5.0.9' container_name: redis8 restart: always volumes: - ./redis8/:/etc/redis/ ports: - 6378:6379 - 16378:16379 command: redis-server /etc/redis/redis.conf networks: mynet: ipv4_address: 172.30.0.108 redis9: image: 'redis:5.0.9' container_name: redis9 restart: always volumes: - ./redis9/:/etc/redis/ ports: - 6379:6379 - 16379:16379 command: redis-server /etc/redis/redis.conf networks: mynet: ipv4_address: 172.30.0.109 redis10: image: 'redis:5.0.9' container_name: redis10 restart: always volumes: - ./redis10/:/etc/redis/ ports: - 6380:6379 - 16380:16379 command: redis-server /etc/redis/redis.conf networks: mynet: ipv4_address: 172.30.0.110 redis11: image: 'redis:5.0.9' container_name: redis11 restart: always volumes: - ./redis11/:/etc/redis/ ports: - 6381:6379 - 16381:16379 command: redis-server /etc/redis/redis.conf networks: mynet: ipv4_address: 172.30.0.1112.启动容器:
docker-compose up -d--启动新的redis容器前要把系统里所有正在运动的redis全都关闭!3.构建集群:(这个是直接在命令行执行而不是
redis-cli)
bashredis-cli --cluster create 172.30.0.101:6379 172.30.0.102:6379 172.30.0.103:6379 172.30.0.104:6379 172.30.0.105:6379 172.30.0.106:6379 172.30.0.107:6379 172.30.0.108:6379 172.30.0.109:6379 --cluster-replicas 2构建完毕之后用客户端连上集群中的任何一个节点,都相当于连上整个集群
(连接时记得加
-c,这样才会自动把请求重定向到对应节点--不然不会自动给到对应分片)引申:使用
cluster nodes可以查看到整个集群的情况
关于集群扩容:(上面还有俩个节点没有进入集群的,来进行集群扩容的模拟--一个主一个从)具体步骤:
1.把新的主节点加入到集群:
redis-cli --cluster add-node 172.30.0.110:6379 172.30.0.101:63792.重新分配哈希槽位:
redis-cli --cluster reshard 172.30.0.101:6379,然后4096172.30.0.110all就行了3.给新的主节点添加从节点:
redis-cli --cluster add-node 172.30.0.111:6379 172.30.0.101:6379 --cluster-slave --cluster-master-id [172.30.0.110节点的nodeId]
关于集群缩容:(这个用到的特别特别少):就是把一些节点拿掉,减少分片的数量--具体操作有用到时再查
之后在使用时就跟正常的redis一样了--但是不支持跨节点的那种一次性批量操作比如mget k1 k2,这种需要哈希标签才行
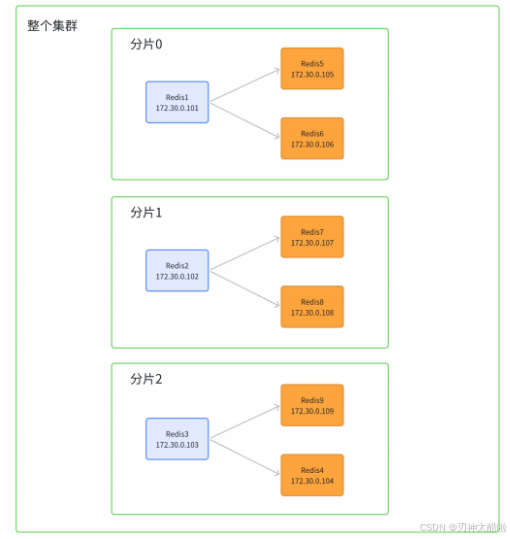
缓存
缓存的更新策略:
1.定期生成
通过日志的形式把最近被用到的词给记录下来,统计一个时间段内每个词出现的频率,把高频率的词涉及到的搜索结果放到缓存里面(这个步骤可通过写一个定时任务来触发)
--优点就是实现起来简单,过程可控,方便排查问题
--缺点是实时性不够,如果出现突发的一些热词,就压力很大(比如春节时会突然多出一些热词)
2.实时生成
如果在Redis中直接查到了,就返回;如果Redis中不存在,就从数据库查,把查到的结果同时也写入Redis
--这样的话,经过一段时间的动态平衡,热点数据就到redis中了
--为了解决redis中不断插入数据达到内存上限的问题,redis引入了内存淘汰策略
四种核心淘汰算法:
1.FIFO(先进先出):把缓存中存在时间醉酒的数据淘汰掉
2.LRU(淘汰最久未使用的):把最近访问时间最老的
key淘汰掉3.LFU(淘汰访问次数最少的):记录每个
key最近一段时间的访问次数,把访问次数最少的淘汰掉 --一般都是采用的这种策略4.Random(随机淘汰):从所有
key中抽取幸运儿被随机淘汰掉具体采取哪种策略,需要结合实际场景来具体问题具体分析:--可用在
redis.conf里面去改
volatile-lru:当内存不足以容纳新写入数据时,从设置了过期时间的key中使用LRU算法进行淘汰
allkeys-lru:当内存不足以容纳新写入数据时,从所有key中使用LRU算法进行淘汰
volatile-lfu:Redis4.0版本新增,当内存不足以容纳新写入数据时,在过期的key中,使用LFU算法进行删除key
allkeys-lfu:Redis4.0版本新增,当内存不足以容纳新写入数据时,从所有key中使用LFU算法进行淘汰
volatile-random:当内存不足以容纳新写入数据时,从设置了过期时间的key中,随机淘汰数据
allkeys-random:当内存不足以容纳新写入数据时,从所有key中随机淘汰数据
volatile-ttl:在设置了过期时间的key中,根据过期时间进行淘汰,越早过期的优先被淘汰(相当于FIFO,只不过是局限于过期的 key)
noeviction:默认策略,当内存不足以容纳新写入数据时,新写入操作会报错.
关于缓存预热:定期生成的话是不需要缓存预热的,只有实时生成才需要(Redis服务器首次接入的时候需要)
先通过离线的方式,通过一些统计的途径,把热点数据找到一批,导入到Redis中,随着时间的推移,逐渐使用新的热点数据去淘汰掉旧的热点数据
关于缓存穿透(Cache penetration):缓存穿透就是用户查询某个数据,但是这个数据在MySQL中都没有--这就会给数据库带来很大的压力
导致缓存穿透的原因:
1.业务设计不合理(缺少参数校验环节,导致非法的
key也被查询了)2.有人误操作把部分数据从数据库删了 3.有人恶意攻击
如何解决:
1.如果发现
key在MySQL中不存在,就在Redis中把其value设置成一个非法值2.使用布隆过滤器(把所有的key都插入到布隆过滤器中,每次查询redis/mysql之前都先判定一遍)
关于缓存击穿(Cache breakdown):缓存击穿相当于缓存雪崩的特殊情况--针对热点key,突然过期了,导致大量请求直接打在数据库上
如果解决:
1.基于统计的方式发现热点
key,并设置成永不过期--但是需要服务器结构做出较大的调整2.进行必要的服务降级(也就是关闭一些不重要的功能)
关于缓存雪崩:缓存雪崩就是在短时间内,redis上大规模的
key失效导致缓存命中率下降,导致mysql压力迅速上升,严重情况下还会导致宕机导致缓存雪崩的原因:
1.redis挂了(单节点模式下节点宕机或者集群模式下大量节点宕机) 2.给redis短时间内设置了太多过期时间相当的
key如何解决:
1.加强监控报警 2.不给key设置过期时间或者设置过期时间时添加随机因子
分布式锁
在分布式系统中,会出现多个节点访问同一个公共资源的问题,此时就需要分布式锁才能进行互斥控制
--C++里的
mutex是不行的,因为分布式是多进程
关于分布式锁:就是一组单独的服务器程序,给其他的服务器提供加锁服务(业界可能采取其他组件来实现分布式锁--比如mysql或者zookeeper组件等)
Redis中设置分布式锁的最好的方法:set key value ex 时间 nx为了防止服务器1加锁,但是服务器2给他解锁:所以需要校验机制来保证
del规范使用--给服务器编号,在加锁时,设置
key-value,key存针对哪个资源加锁,value存服务器的编号 --之后就是GET校验之后才进行加解锁错误做法:
1.
setnx然后再expire这个方法不太好--因为redis上多个命令之间无法保证原子性(跟事务一块用也不行,因为事务没有if/else)直接使用
setnx加锁,del解锁这个办法也不太好--如果某个服务器加锁成功后崩了,从而没执行到解决的话就惨了(解锁放到finally里面也没用,因为finally只对同一进程内的锁有用)
GET获取锁和DEL删除锁之间是有时间差的!所以可能会出现两个服务器同时
GET获取锁的校验信息,有一个加锁之后删除锁,又有一个删除锁--这样就会删成俩次了--所以这就需要事务,但是实践中
lua脚本是更好选择
关于锁的过期时间的续约问题:最好的方式是动态续约:需要专门的一个线程(这个线程叫做看门狗
watch dog)来管这件事--比如:本来设置的是1s,然后再还剩300ms时续时间,如果续上之后还不够的话,那就到时候再续
Redis主从模式+哨兵模式来使用分布式锁时,会有一个致命的问题:主节点在把锁给其他客户端之后,还没来得及同步给从节点就挂了,那新的主节点就不知道这个锁已经被分配出去了!
解决方法:
redlock算法--加锁时就是给所有的主节点都加锁,所有节点中超过半数的主节点加锁成功才认为加锁成功;解锁时,也是给所有的节点都解锁
注意:锁的有效时间要减去请求所有节点的耗时
当然redis中不只是有互斥锁,还有读写锁,公平锁,可重入锁等等