聊 AI 落地时,最常听到的困惑不是"要不要上 AI",而是"为什么别人的模型那么听话,我们的一用就差口气",答案常指向微调。但一提微调 700 亿参数模型,多数人第一反应是"那得一个集群"。在企业AI化转型进入深水区的当下,这个误解正拖慢不少团队------它把一件可以低成本试错的事挡在了立项审批之外。
所以写了这篇:先算清训练时显存被谁占掉,再讲 QLoRA 降门槛的三件设计,然后列出三条宣传里很少提、现场反复出现的硬边界,最后给出判断框架与方向。不推荐工具,只讲判断依据。
一、先算账:显存被谁占了
训练大模型时,显存花在四个科目上:模型权重,700 亿参数按 16 位存 140GB,压到 4 位仅约 35GB;梯度,每个可训练参数留一份同精度梯度;优化器状态,维护两个动量且 32 位保存,即每参数 8 字节;激活值随批大小与序列长度增长。
装得下只解决了第一项。全参数微调贵,本质不是模型大,而是每个参数都要配梯度与优化器状态------论文给出的数字是,650 亿模型做 16 位全参数微调需超过 780GB。为何不能用 4 位模型训练?因为训练与推理对误差的容忍度不同量级:推理时误差只让输出略偏;训练时误差进入反向传播被逐轮放大,低精度下优化器更新量本就细微,压缩后会失真停滞。
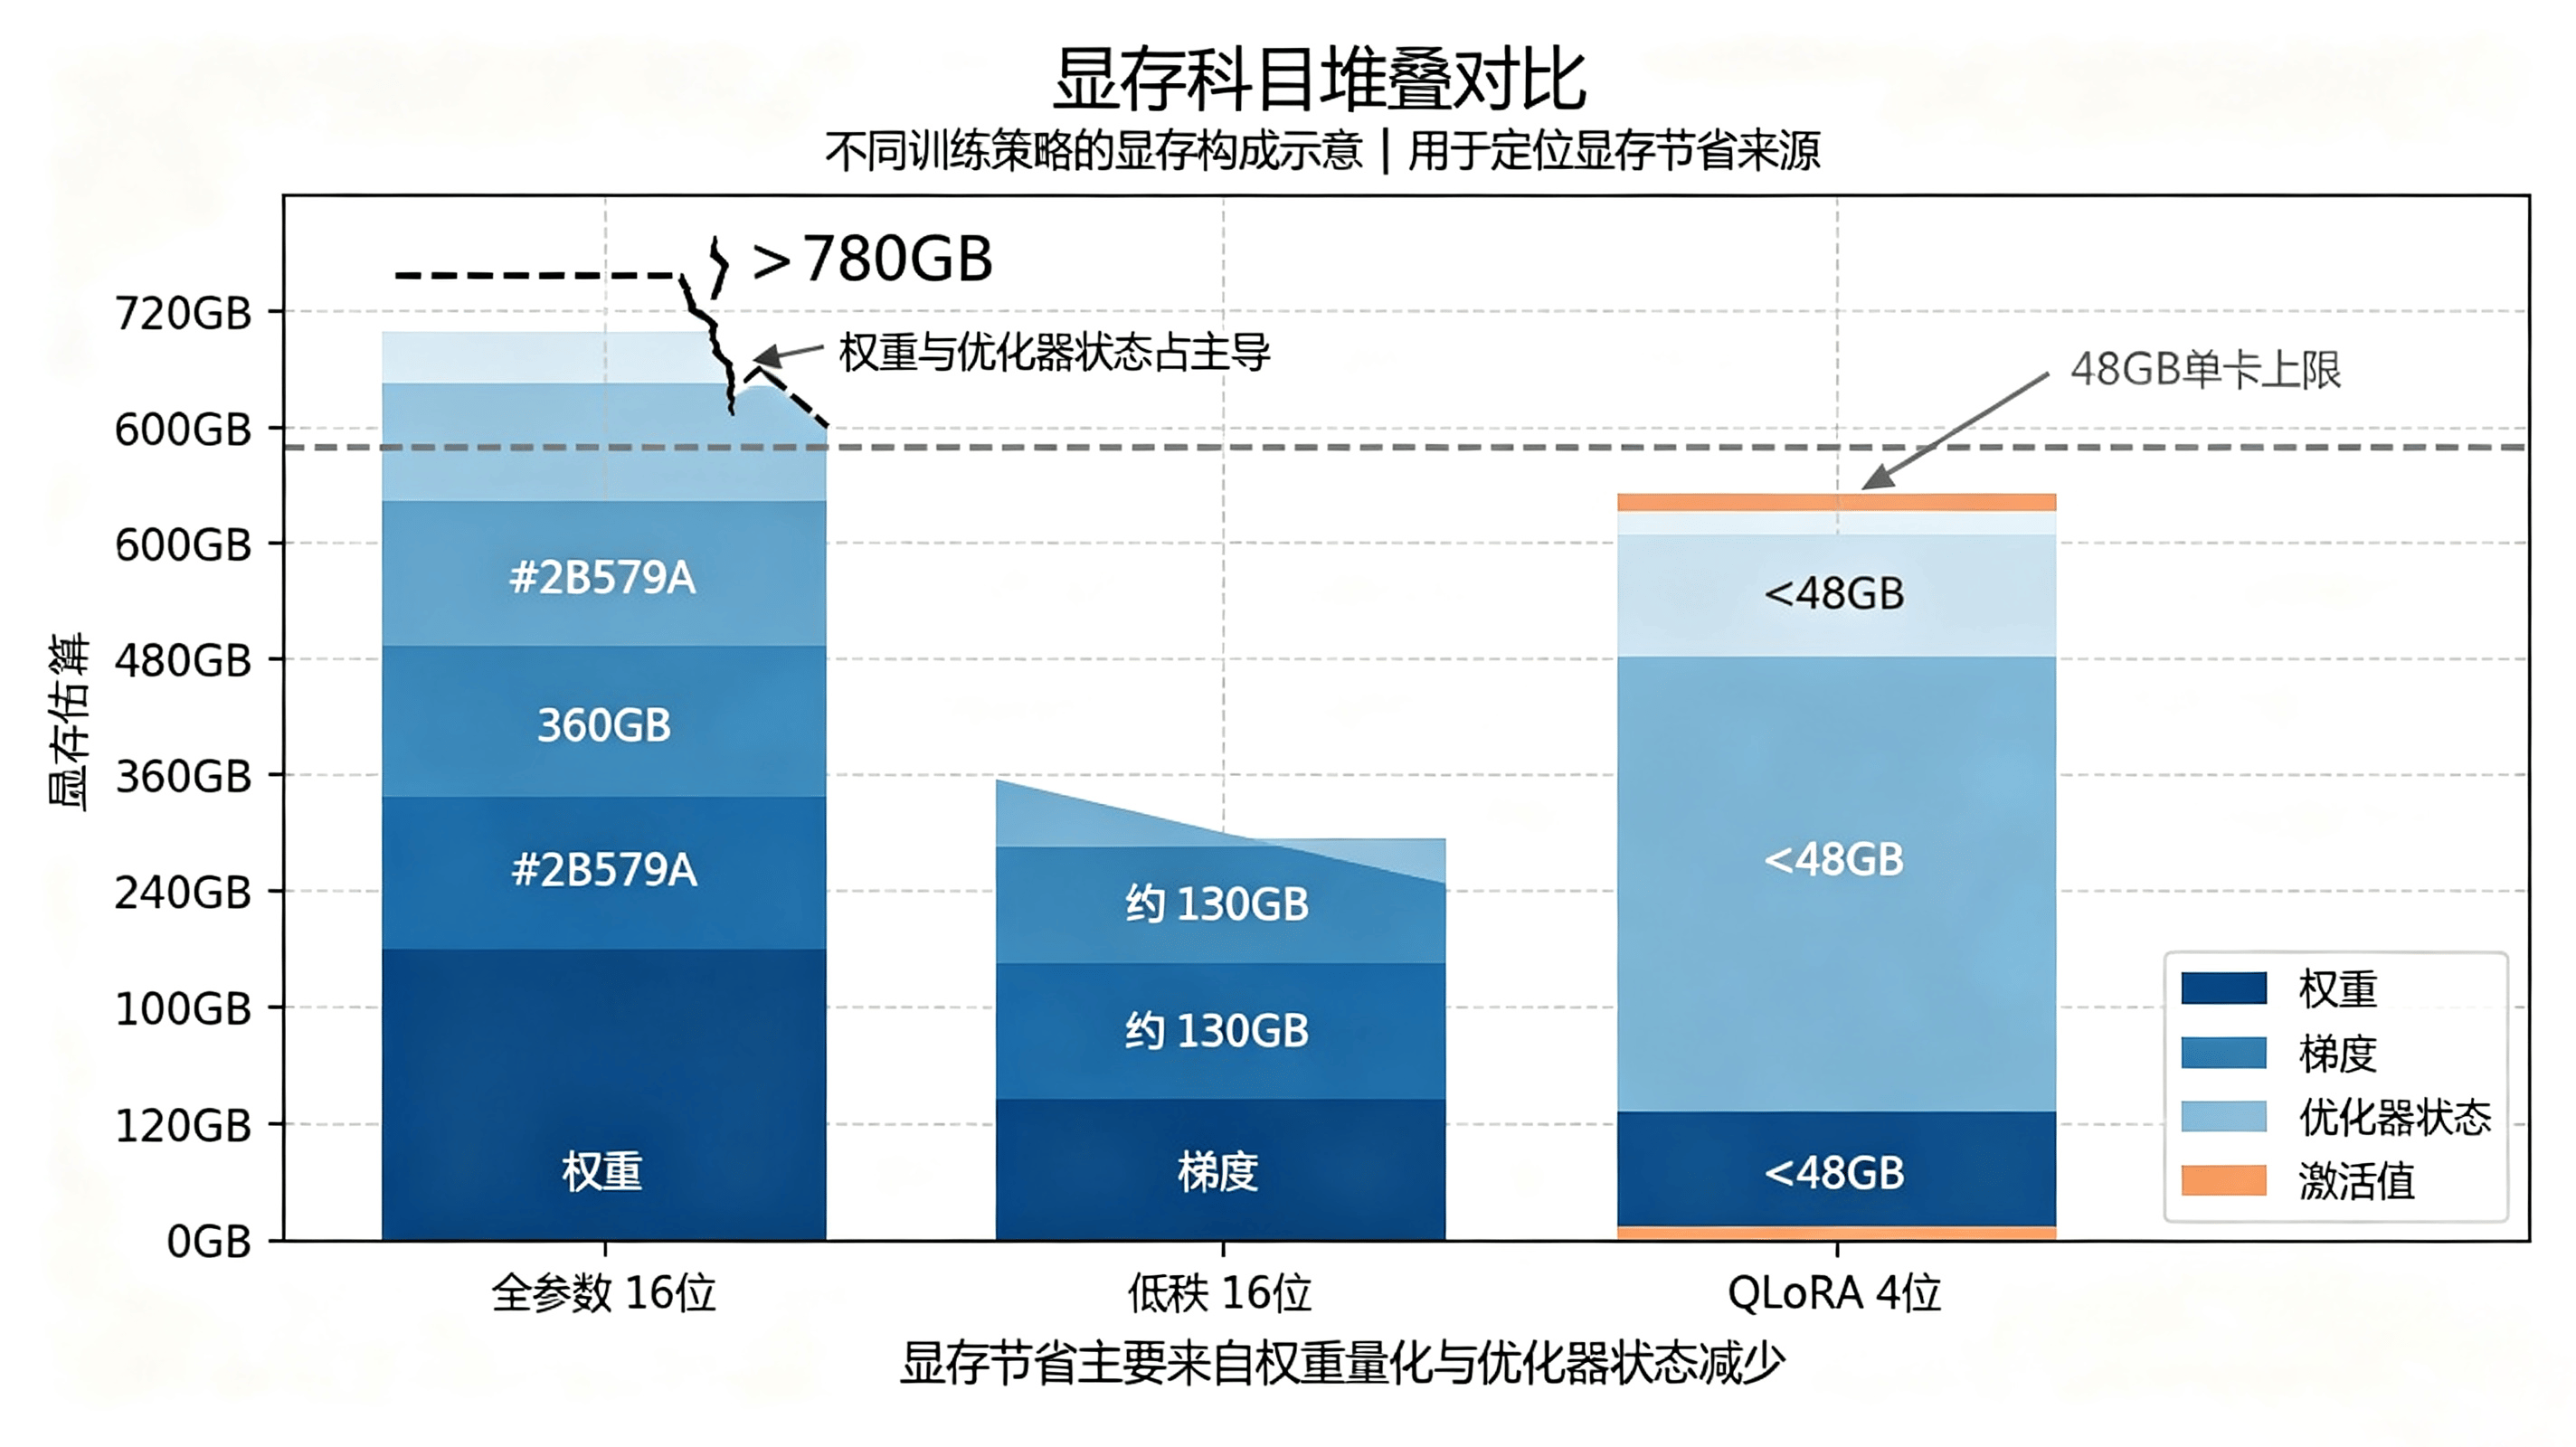
图1:显存堆叠对比图
二、三件设计,各解决一个科目
QLoRA 的突破不在"想到量化",而在把量化误差控制在训练可承受的范围。结构:基座量化到 4 位并冻结;插入很小的低秩适配器,仅它可训练且高精度保存;前向时冻结权重即时反量化参与运算,梯度穿过它流回适配器。一句话:知识留在冻结权重里,行为由适配器来学。
第一件是 4 位正态浮点(NF4)。权重集中在零附近呈钟形分布,等距量化让密集区分到太少档位;NF4 改为按"每档覆盖同等数量的权重"分配 16 个档位,还原误差更小。第二件是双重量化:缩放常数再压成 8 位,论文报告每参数省约 0.37 位,650 亿模型约 3GB------在 48GB 卡上跑 700 亿时,这 3GB 往往就是能否跑起来的差别。第三件是分页优化器:显存溢出常因瞬时尖峰,它借统一内存把状态搬到主机内存再搬回,掉速但不崩溃,买的是稳定性。
三、三条硬边界
其一,显存刚好够不等于训练轻松。700 亿处在临界:4 位权重约 35GB,加常数与适配器后,48GB 卡留给激活的余量不足 10GB。批大小锁死为 1,长序列须开梯度检查点,混入超长样本触发分页就断崖掉速,小模型十分钟能发现的错误这里要几小时。
其二,量化误差只是被压到可接受范围,并未消失。"与 16 位微调效果相当"有适用条件,不能无限外推;原论文也指出当时的对话基准不足以可靠衡量水平。另外适配器是在"4 位基座"下收敛的,部署时换 16 位再合并或又压回 4 位,效果未必一致,建议合并前后各跑一次固定测试集。
其三,也是最关键的一条:微调改的是行为,不是知识。适配器参数不到基座百分之一,只擅长学"怎么做"------格式、语气、任务分解;事实知识与产品资料装不进去。硬灌要么学不全,要么反复训练挤掉通用能力,形成灾难性遗忘。论文证据:不到一万条的高质量数据,好过大几十倍规模的低质量通用数据。
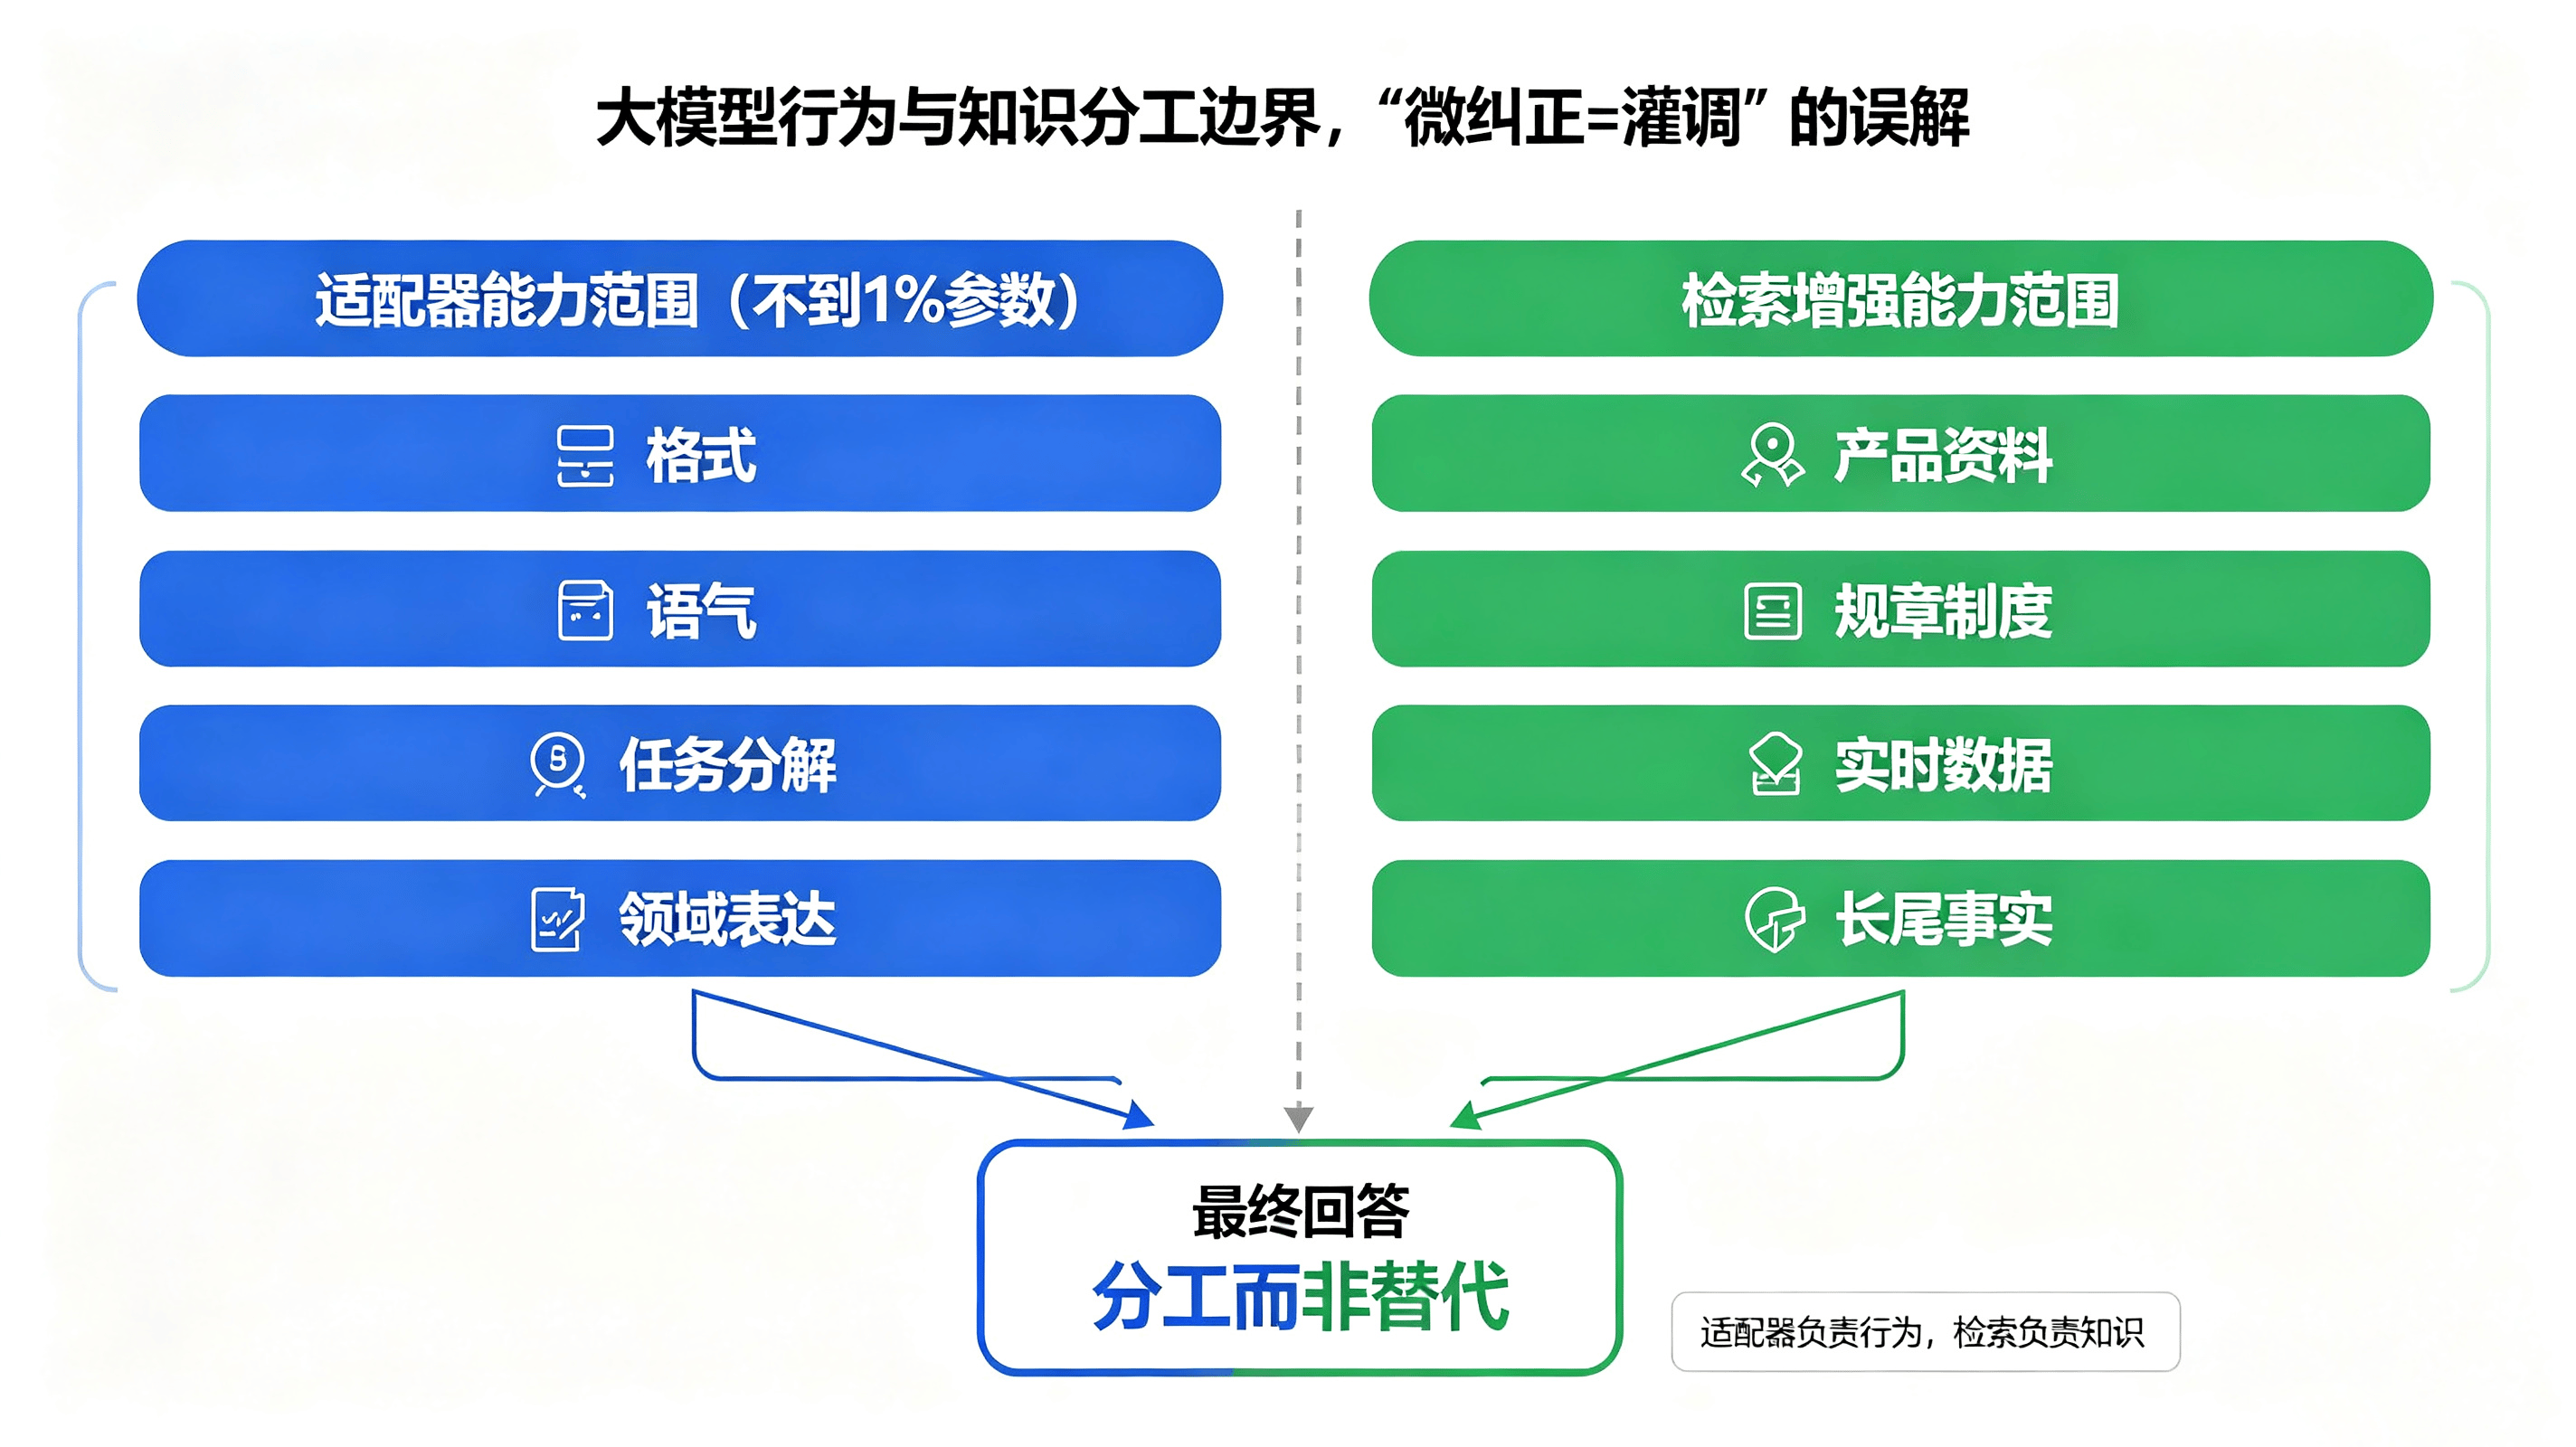
图2:大模型行为与知识分工边界图
四、全文总结与展望
收敛成三个判断:其一,先分清目标是行为还是知识------改格式、语气、任务套路用微调;要掌握大量私有资料或实时数据,应先做检索增强。其二,数据质量优先于数量,先用几百条打磨过的样本验证方向。其三,合并与否看切换频率:能力少且稳定就合并,多且常变则热切换。
一句话版本:QLoRA 买的不是"便宜地训练大模型",而是把微调从集群决策变成个人可执行的实验------真正被改变的不是成本,而是迭代速度。当一次实验从"排队跑三天"变成"改配置跑一晚",团队才可能靠几十次试错找到合适方案。对企业AI化转型而言,其意义在于把能力建设的主动权交还给业务团队:拥有选择权本身,就是一种结构性变化。
三个方向值得关注:一是更低位宽与更聪明的误差补偿,关键在按层自适应位宽与离群权重处理;二是打通训练与部署的精度链路,让合并、量化、部署成为一次连续可预期的过程;三是从单次微调走向持续学习流水线,难点不在算法而在工程治理。
五、技术FAQ
1. 48GB卡真能放下700亿参数吗?
放得下但余量极小。4位权重约35GB,留给激活不足10GB。批大小锁死为1,长序列须开梯度检查点,数据按长度分桶,否则触发分页。
2. 为何量化能推理却难训练?
推理时误差只让输出略偏;训练时误差进入反向传播被逐轮放大,且低精度下优化器更新量极细微,压缩后会失真停滞。QLoRA 冻结基座、只训高精度适配器,绕开了这一难题。
3. 秩和缩放系数怎么设?
秩决定容量,从小起步按验证集上调;缩放系数与秩的比值决定实际更新强度,两者要一起调,只调秩往往无效。注入上覆盖前馈层通常更好。
4. 微调能让模型记住产品资料吗?
不建议。适配器容量不到基座百分之一,装不下大量事实。硬灌要么学不全,要么反复训练导致灾难性遗忘。正确做法是检索增强提供资料,微调只教模型怎么用。
5. 训完要合并回基座吗?
看切换频率。能力少且稳定就合并,部署简单且无额外开销;能力多且常变则不合并,挂载不同适配器热切换。合并前后各跑一次测试集,隔离精度变化影响。
本文仅代表作者个人行业观察,不构成任何商业建议。