LangChain + LangGraph 核心组件:从 Agent 封装到可控工作流
文 | AI 编程实战笔记
很多人第一次接触 LangChain,看到的公式是:
用户消息 → Model → Tools → Model → 最终答案这条链路没有错,但它只解释了 Agent 的"主循环",没有解释谁负责切换模型、校验权限、保存对话、处理工具异常,以及在高风险操作前暂停等待人工审批。
更完整的理解应该是:
Agent = Model + Harness

Model:
  负责理解、推理和决定下一步动作

Harness:
  Tools + Prompt + Middleware + Context + State + Memory + Runtime
LangChain 负责把这些常用能力封装成容易使用的 Agent API;LangGraph 则把 Agent 进一步展开成状态、节点、边、分支、循环和中断,让开发者精确控制执行过程。
本文会先拆解 LangChain 的 Model、Tool、response format、middleware 和 runtime,再用 State、Node、Edge 解释 LangGraph,最后用 Python 和真实 OpenAI API 跑通一个"识别城市 → 查询天气"的最小 ReAct Agent。
本文 API 根据 2026 年 8 月 LangChain 与 LangGraph 官方 Python 文档整理。两个框架更新较快,旧教程中的
initialize_agent、AgentExecutor等写法,不代表当前推荐入口。
一、先看入口:create_agent 到底创建了什么
当前 LangChain 构建 Agent 的核心入口是 create_agent:
from langchain.agents import create_agent

agent = create_agent(
    model=model,
    tools=tools,
    system_prompt="你是一个天气助手",
    middleware=middleware,
    response_format=WeatherAnswer,
    checkpointer=checkpointer,
    context_schema=UserContext,
)

result = agent.invoke(
    {"messages": [{"role": "user", "content": "杭州今天天气如何?"}]},
    config={"configurable": {"thread_id": "weather-001"}},
    context={"user_id": "u-1001", "role": "member"},
)
这里的 create_agent 并不是立即执行一次模型调用,而是组装出一套可执行框架。真正开始运行的是 agent.invoke()。
配置阶段:
  model + tools + prompt + middleware
  + response_format + checkpointer + context_schema
  ↓
create_agent:
  编译 Agent 执行图
  ↓
agent.invoke:
  注入本轮 messages、config 和 context
  ↓
运行阶段:
  Model 判断 → Tool 执行 → Observation 回填 → Model 再判断
  ↓
结束阶段:
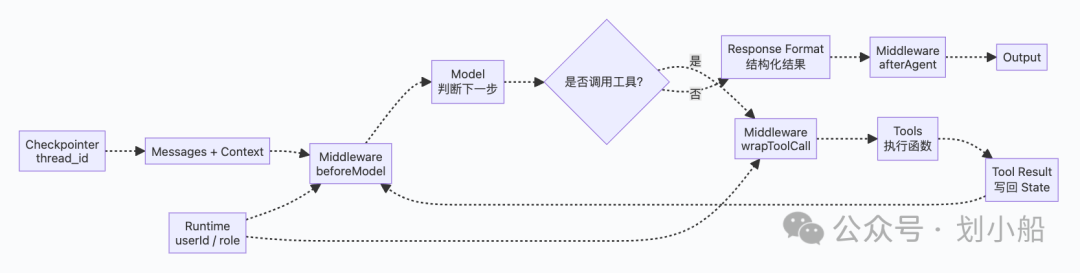
返回 messages、结构化结果和更新后的状态一个容易忽略的事实是:create_agent 底层运行在 LangGraph 上。它返回的不是一个简单函数,而是一张已经编译好的图,因此天然支持 invoke、stream、状态持久化和中断恢复。
💡 关键洞察 :LangChain 的
create_agent是预制好的 Agent Harness;LangGraph 是支撑这套 Harness 的图运行时,也是需要精细控制流程时可以直接使用的底层编排能力。
二、Model:用统一接口屏蔽不同模型供应商
Model 是 Agent 的推理引擎。它负责阅读消息和工具定义,判断应该直接回答,还是生成一个或多个 tool call。
LangChain 的价值不是"提供一个模型",而是为不同 Provider 提供相对统一的调用接口:
from langchain.chat_models import init_chat_model

model = init_chat_model(
    "openai:gpt-4.1-mini",
    temperature=0,
    timeout=30,
    max_retries=3,
)
如果换成 Anthropic,Agent 上层调用方式基本不变:
model = init_chat_model(
    "anthropic:claude-sonnet-4-6",
    temperature=0,
    timeout=30,
    max_retries=3,
)
Model 层可以拆成三部分:
| 部分 | 作用 | 示例 |
|---|---|---|
| Provider | 提供模型服务的厂商或平台 | OpenAI、Anthropic、Google、Azure |
| Model Object | 统一的模型调用对象 | init_chat_model() 、ChatOpenAI() |
| 调用策略 | 控制稳定性与流量分配 | temperature、timeout、retry、route、fallback |
temperature、timeout 和 max_retries 属于模型对象的基础配置;动态路由、fallback、缓存等更适合放在 middleware 的 wrap_model_call 中。因为路由通常需要结合本轮状态判断,而不是在 Agent 创建时永久写死。
例如:普通问答走小模型,长上下文或高风险任务走强模型;主模型超时后重试,仍失败再切换备用模型。
💡 关键洞察:Model 统一接口解决"怎么调用模型",middleware 解决"这一轮到底调用哪个模型,以及失败后怎么办"。
三、Tool:让普通函数成为模型可选择的动作
Tool 的本质,是把一个普通函数包装成模型能够理解和调用的动作。
一个完整 Tool 通常包含四部分:
| 字段 | 模型如何使用 | 天气工具示例 |
|---|---|---|
| name | 区分工具,生成 tool call 时指定名称 | get_weather |
| description | 判断什么时候调用、能解决什么问题 | 查询指定城市的天气 |
| schema | 生成参数,确定字段、类型和必填项 | city: str |
| function | 真正执行查询、写入或计算 | 调用天气 API 或数据库 |
最简单的写法是使用 @tool:
from langchain.tools import tool

@tool
def get_weather(city: str) -> dict:
    """查询指定城市的当前天气。仅在已经获得标准城市名后调用。"""
    return {
        "city": city,
        "temperature_c": 26,
        "condition": "晴",
    }
函数名默认成为 Tool name,docstring 成为 description,类型注解生成参数 schema。
复杂参数可以用 Pydantic 显式定义:
from pydantic import BaseModel, Field

class WeatherInput(BaseModel):
    city: str = Field(description="标准城市名,例如:杭州")
    unit: str = Field(default="celsius", description="温度单位")
这里需要纠正一个常见误解:模型通常看不到函数源码,也不会阅读 Python 或 TypeScript 里的业务实现。
模型能够看到:
  - name
  - description
  - 参数 schema

模型通常看不到:
  - function source code
  - Python 内部实现
  - TypeScript 函数内部逻辑
  - Zod 校验器的源码
在 TypeScript 中常用 Zod 定义 schema,但模型接收到的是转换后的 JSON Schema,不是 Zod 源码。真正决定工具是否容易被正确调用的,是清晰的名称、准确的 description 和不过度复杂的参数结构。
还有一个工程细节:某些参数只供运行时使用,例如 ToolRuntime。这些参数由系统注入,不会暴露给模型,因此可以安全地传递用户身份、当前 State、Store 或 tool call ID。
四、response_format:结构化输出不是"提醒模型返回 JSON"
如果 Agent 的结果还要交给程序消费,仅让模型"请返回 JSON"通常不够稳定。模型可能加 Markdown 围栏、漏字段、写错类型,甚至在 JSON 前后补解释。
LangChain 的 response_format 用 schema 定义最终结果:
from pydantic import BaseModel, Field

class WeatherAnswer(BaseModel):
    city: str = Field(description="标准城市名")
    temperature_c: int = Field(description="摄氏温度")
    condition: str = Field(description="天气状况")
    suggestion: str = Field(description="一句出行建议")
创建 Agent 时直接传入:
agent = create_agent(
    model=model,
    tools=[resolve_city, get_weather],
    response_format=WeatherAnswer,
)
调用结束后从 structured_response 读取:
result = agent.invoke({
    "messages": [{"role": "user", "content": "西湖那边今天热吗?"}]
})

print(result["structured_response"])
LangChain 会根据模型能力选择 ProviderStrategy 或 ToolStrategy:模型原生支持结构化输出时,优先使用 ProviderStrategy;否则可以通过工具调用策略生成并校验结构。
"返回 JSON":
  只是在 Prompt 中提出文本要求
  程序仍要自行解析和校验

response_format:
  用 Schema 定义字段、类型和约束
  框架负责结构化生成与校验
  结果作为 typed data 交给下游程序
💡 关键洞察:Tool schema 约束的是"Agent 调用动作时输入什么",response format 约束的是"Agent 最终向业务返回什么"。两者不要混为一谈。
五、Middleware:Agent 的执行控制面
如果 Model 是大脑,Tools 是手脚,middleware 就是控制面。
一次 Agent 调用可能经历多轮模型和工具调用:
User Message
  → Model Call
  → Tool Call
  → Tool Result
  → Model Call
  → Tool Call
  → Tool Result
  → Model Call
  → Final Answer
Prompt 很难可靠地承担身份校验、超时、重试、工具权限、成本限制和日志追踪。middleware 可以在每一步做确定性的检查、改写、拦截和兜底。
5.1 节点式 hooks:在阶段前后执行一次
节点式 hooks 适合执行阶段级逻辑:
| Hook | 触发位置 | 常见用途 |
|---|---|---|
before_agent |
整次 Agent 启动前 | 身份校验、初始化运行状态 |
before_model |
每次 Model 调用前 | 裁剪消息、改写 Prompt、统计调用次数 |
after_model |
每次 Model 返回后 | 检查输出、识别异常工具调用、统计 Token |
after_agent |
Agent 结束后 | 保存结果、写 Trace、记录业务指标 |
注意:before_model 和 after_model 可能执行多次,因为 ReAct Agent 会反复回到模型节点。
5.2 包裹式 hooks:接管某一次调用
wrap hooks 类似在目标调用外面包一层控制器:
| Hook | 包裹对象 | 适合处理 |
|---|---|---|
wrap_model_call |
一次模型调用 | 模型路由、retry、fallback、cache、动态工具集合 |
wrap_tool_call |
一次工具调用 | 工具权限、参数过滤、日志、超时、失败兜底 |
例如,工具异常时返回一条可理解的 ToolMessage,而不是让整个 Agent 直接崩溃:
from langchain.agents.middleware import wrap_tool_call
from langchain.messages import ToolMessage

@wrap_tool_call
def handle_tool_error(request, handler):
    try:
        return handler(request)
    except Exception as exc:
        return ToolMessage(
            content=f"工具暂时不可用:{exc}",
            tool_call_id=request.tool_call["id"],
        )
生产环境也可以直接使用 ModelRetryMiddleware、ToolRetryMiddleware 等预制中间件,不必为通用逻辑重复造轮子。
节点式 hook:
  在某个阶段前后增加处理节点

wrap hook:
  接管一次具体调用
  可以决定是否执行、执行几次、换谁执行,以及异常如何返回
middleware 并不是另一个独立运行时。它最终也会成为 create_agent 所编译 LangGraph 中的一部分。
六、Runtime:一次 invoke 运行需要哪些数据
agent.invoke() 不只是传一段 Prompt。一次完整运行通常有三类输入:
| 输入 | 生命周期 | 用途 |
|---|---|---|
| messages / state | 会随流程更新 | 用户消息、模型回答、工具结果、业务状态 |
| config | 控制本次执行 | thread_id、callbacks、tags、metadata |
| context | 本次运行只读业务信息 | user_id、role、tenant_id、feature_flags |
可以把它们记成一句话:
State:流程正在处理和修改的数据包
Config:框架如何运行这一次任务
Context:业务系统告诉 Agent"你正在为谁、以什么权限运行"
6.1 context 不是对话记忆
context 适合存放本次运行依赖但不应该由模型随意修改的信息:
from dataclasses import dataclass

@dataclass
class UserContext:
    user_id: str
    role: str
    tenant_id: str
创建 Agent 时声明 context_schema,调用时传入 context:
agent = create_agent(
    model=model,
    tools=tools,
    context_schema=UserContext,
)

agent.invoke(
    {"messages": [{"role": "user", "content": "查询杭州天气"}]},
    context=UserContext(
        user_id="u-1001",
        role="member",
        tenant_id="t-01",
    ),
)
Tool 或 middleware 可以通过 Runtime 读取这些信息,执行租户隔离或权限判断。
6.2 checkpointer + thread_id 才能保存多轮状态
如果希望第二次调用记住第一次对话,需要给 Agent 配置 checkpointer,并在调用时使用稳定的 thread_id:
from langgraph.checkpoint.memory import InMemorySaver

checkpointer = InMemorySaver()

agent = create_agent(
    model=model,
    tools=tools,
    checkpointer=checkpointer,
)

config = {"configurable": {"thread_id": "weather-001"}}
相同 thread_id 指向同一条会话状态;换一个 thread_id,就是另一条独立会话。
| 组件 | 保存什么 | 适合场景 |
|---|---|---|
| Checkpointer | 单个 thread 的 State 快照 | 多轮对话、故障恢复、人工审批 |
| Store | 跨 thread 的长期数据 | 用户偏好、共享知识、长期记忆 |
示例中的 InMemorySaver 只适合本地演示。进程退出后内容会消失,生产环境应换成数据库支持的持久化 Checkpointer。
七、LangChain 与 LangGraph 到底有什么区别
LangChain 和 LangGraph 不是二选一,也不是简单的"低级框架与高级框架"。两者解决的是不同层面的问题。
| 对比维度 | LangChain | LangGraph |
|---|---|---|
| 核心关注 | Model、Tools、middleware、structured output | State、Node、Edge、分支、循环、暂停、调度 |
| 开发方式 | 使用封装好的高层 API 快速搭建 Agent | 显式设计状态图和执行路径 |
| 默认决策 | 模型根据上下文决定是否调用工具 | 代码和状态共同决定走哪条边 |
| 灵活度 | 常见 Agent 模式开箱即用 | 可精确控制每个节点和状态变化 |
| 适合场景 | 问答、检索、工具型助手、标准 ReAct | 多分支流程、审批、长任务、复杂恢复逻辑 |
| 主要成本 | 深度定制时可能受到预制循环限制 | 需要自行设计 State、Node、Edge 和测试 |
优先选择 LangChain:
  目标是快速搭建标准工具调用 Agent
  主流程就是 Model ↔ Tools 循环
  使用 middleware 已能满足控制要求

优先直接使用 LangGraph:
  业务包含多个确定性分支
  需要显式循环、并行、暂停或人工审批
  需要精确保存和恢复每一步状态
  不希望所有流程选择都交给模型
实际项目经常组合使用:用 create_agent 构建一个标准 Agent,再把它作为 LangGraph 中的一个 Node 或 Subgraph。
💡 关键洞察:LangChain 关注"一个 Agent 需要哪些能力",LangGraph 关注"这些能力按照什么状态和路径运行"。
八、State + Node + Edge:把 Agent 展开成一张图
LangGraph 最重要的三个概念是 State、Node 和 Edge:
State:运行时携带的数据包
Node:读取 State、执行处理、返回 State 更新的函数
Edge:决定执行完当前 Node 后去哪里

State + Node + Edge = Agent Flow
8.1 State:流程携带的数据包
天气 Agent 的 State 可以包含:
from typing_extensions import TypedDict
from langgraph.graph import MessagesState

class WeatherState(MessagesState):
    city: str | None
    weather: dict | None
    retry_count: int
其中:
| State 字段 | 保存内容 |
|---|---|
| messages | 用户 Message、模型回答、tool call、ToolMessage |
| city | 标准化后的城市名 |
| weather | 工具返回的天气结构 |
| retry_count | 查询失败后的重试次数 |
State 不是一次性 Prompt,而是整张图运行时持续携带和更新的数据。
8.2 Node:流程中的处理步骤
Node 本质上是函数。它读取当前 State,执行一个明确步骤,并返回局部更新:
def resolve_city_node(state: WeatherState):
    city = parse_city(state["messages"][-1].content)
    return {"city": city}

def query_weather_node(state: WeatherState):
    weather = weather_api(state["city"])
    return {"weather": weather}
常见 Node 包括:
-
调用模型
-
查询工具或数据库
-
校验结果
-
人工审核
-
生成最终答案
Node 应该有清晰职责。一个节点同时查询数据库、调用模型、写文件并发送通知,会让状态恢复和失败重试变得困难。
8.3 Edge:决定下一步去哪里
普通边是固定路线:
builder.add_edge("resolve_city", "query_weather")表示 resolve_city 执行完后,一定进入 query_weather。
条件边根据 State 动态选择路径:
def route_after_model(state):
    last_message = state["messages"][-1]
    if last_message.tool_calls:
        return "tools"
    return "end"
这正是标准 ReAct Agent 的核心条件:
如果模型返回 tool_call:
  进入 Tools Node
  执行工具并把结果写回 messages
  再回到 Model Node

如果模型没有返回 tool_call:
  说明模型准备给出最终答案
  流程进入 END
Model 和 Tools 之间的循环,并不是神秘的"智能涌现",而是条件边和回边共同形成的执行路径。
九、Interrupt:让 Agent 在关键动作前停下来
当流程准备合并代码到 main 分支时,完全自动执行往往风险过高。更合理的流程是:先查询 CR 状态、生成审核建议,再暂停等待人工决定。
在这个案例中:
State:
  repo、branch、cr_status、review_summary、approved

Node:
  query_cr、generate_review、human_approval、merge_main、reject

普通 Edge:
  query_cr → generate_review → human_approval

条件 Edge:
  approved = true  → merge_main
  approved = false → reject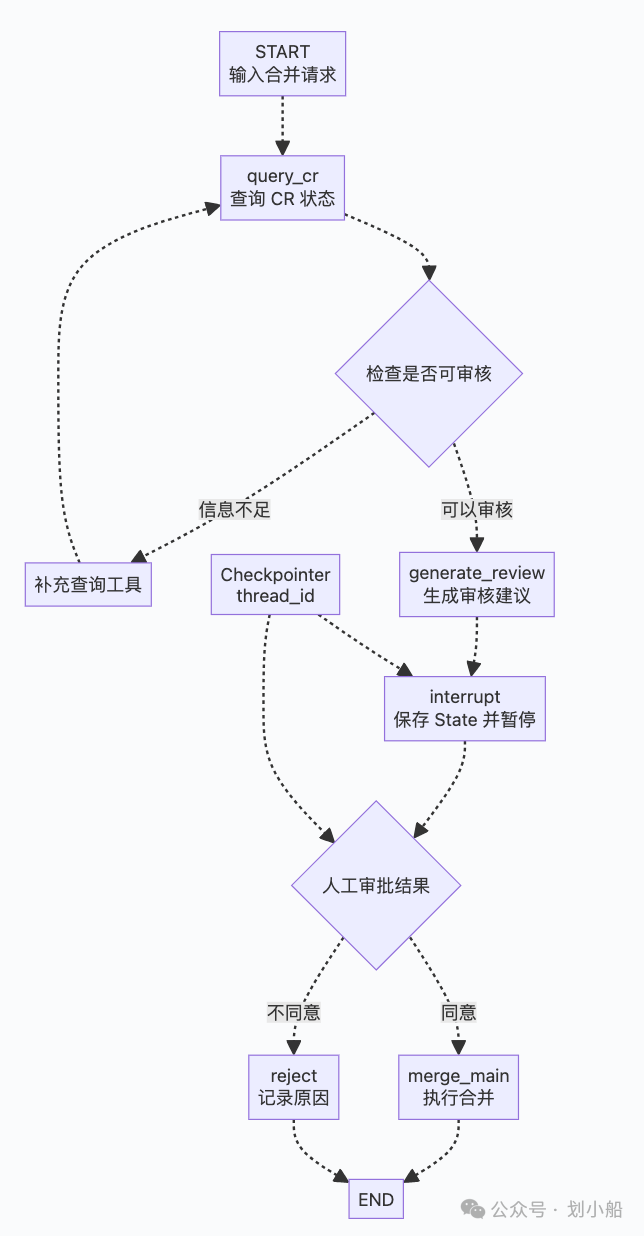
LangGraph 使用 interrupt() 暂停:
from langgraph.types import interrupt

def human_approval(state: ReviewState):
    approved = interrupt({
        "question": "是否同意合并到 main?",
        "cr_status": state["cr_status"],
        "review_summary": state["review_summary"],
    })
    return {"approved": approved}
为了恢复流程,必须同时具备:
-
编译图时配置 Checkpointer。
-
首次执行时提供稳定的
thread_id。 -
恢复时使用同一个
thread_id。 -
通过
Command(resume=...)传入人工结果。from langgraph.checkpoint.memory import InMemorySaver
from langgraph.types import Commandgraph = builder.compile(checkpointer=InMemorySaver())
config = {"configurable": {"thread_id": "merge-20260802-001"}}第一次运行,在 interrupt 处暂停
paused = graph.invoke(initial_state, config=config)
人工确认后恢复;True 会成为 interrupt() 的返回值
result = graph.invoke(Command(resume=True), config=config)
需要特别注意:恢复时,包含 interrupt() 的 Node 会从节点开头重新执行。因此,写在 interrupt 前面的数据库写入、扣费、发送消息等副作用必须保证幂等,或者移到审批后的独立 Node。
💡 关键洞察:interrupt 不是"让进程睡眠等待",而是保存 State、结束当前执行,等外部输入到来后再按 thread_id 恢复。
十、实战:用 Python 搭建最小 ReAct 天气 Agent
现在用真实 OpenAI API 跑通一个最小案例。
用户可以说"西湖那边今天热吗",Agent 需要先把地点解析为标准城市"杭州",再调用天气工具,最后返回结构化结果。
为了把注意力放在 Agent 机制上,天气数据使用本地模拟字典;模型调用是真实的 OpenAI API。生产环境只需要把 get_weather 内部替换成真实天气服务。
10.1 安装依赖
python -m venv .venv
source .venv/bin/activate
pip install -U langchain langgraph langchain-openai pydantic
export OPENAI_API_KEY="你的 OpenAI API Key"
10.2 完整代码
import os
from dataclasses import dataclass

from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langchain.tools import ToolRuntime, tool
from langgraph.checkpoint.memory import InMemorySaver
from pydantic import BaseModel, Field


@dataclass
class UserContext:
    user_id: str
    role: str


class WeatherAnswer(BaseModel):
    city: str = Field(description="标准城市名")
    temperature_c: int = Field(description="当前摄氏温度")
    condition: str = Field(description="天气状况")
    suggestion: str = Field(description="一句简短出行建议")


@tool
def resolve_city(place: str) -> str:
    """把景点、简称或自然语言地点转换成中国标准城市名。

    当用户没有直接提供标准城市名时先调用本工具。
    """
    aliases = {
        "西湖": "杭州",
        "魔都": "上海",
        "羊城": "广州",
        "帝都": "北京",
    }
    return aliases.get(place, place)


@tool
def get_weather(city: str, runtime: ToolRuntime[UserContext]) -> dict:
    """查询标准城市名对应的当前天气。

    只有获得标准城市名后才调用。不要把景点名或城市简称直接传入。
    """
    if runtime.context.role not in {"member", "admin"}:
        raise PermissionError("当前用户没有天气查询权限")

    weather_data = {
        "杭州": {"temperature_c": 31, "condition": "多云"},
        "上海": {"temperature_c": 30, "condition": "小雨"},
        "广州": {"temperature_c": 33, "condition": "晴"},
        "北京": {"temperature_c": 28, "condition": "晴"},
    }
    return {
        "city": city,
        **weather_data.get(
            city,
            {"temperature_c": 25, "condition": "暂无实时数据"},
        ),
    }


model = init_chat_model(
    os.getenv("OPENAI_MODEL", "openai:gpt-4.1-mini"),
    temperature=0,
    timeout=30,
    max_retries=3,
)

agent = create_agent(
    model=model,
    tools=[resolve_city, get_weather],
    system_prompt=(
        "你是天气助手。用户输入景点或城市别名时,先调用 resolve_city;"
        "得到标准城市名后,再调用 get_weather;最后给出简短出行建议。"
    ),
    response_format=WeatherAnswer,
    context_schema=UserContext,
    checkpointer=InMemorySaver(),
)

config = {"configurable": {"thread_id": "weather-demo-001"}}

result = agent.invoke(
    {
        "messages": [
            {"role": "user", "content": "西湖那边今天热吗?"}
        ]
    },
    config=config,
    context=UserContext(user_id="u-1001", role="member"),
)

print(result["structured_response"])
一次典型输出类似:
city: 杭州
temperature_c: 31
condition: 多云
suggestion: 天气较热,建议穿轻薄衣物并注意补水。
10.3 这段代码如何形成 ReAct
虽然我们没有手写 while 循环,但 create_agent 已经生成了标准的 Model ↔ Tools 循环:
第 1 轮 Model:
  发现"西湖"不是标准城市名
  生成 tool_call: resolve_city(place="西湖")

第 1 次 Tool:
  返回"杭州"
  结果作为 ToolMessage 写回 State

第 2 轮 Model:
  已获得标准城市名
  生成 tool_call: get_weather(city="杭州")

第 2 次 Tool:
  从 Runtime 读取 role
  权限通过后返回结构化天气数据

第 3 轮 Model:
  根据工具结果生成出行建议
  按 WeatherAnswer Schema 返回 structured_response
在这条链路中:
| 代码元素 | 对应组件 |
|---|---|
init_chat_model() |
Model 统一接口 |
@tool 函数 |
Tools |
WeatherAnswer |
response format |
UserContext |
runtime context |
InMemorySaver() |
checkpointer |
thread_id |
会话状态标识 |
create_agent() |
组装 Harness 并编译执行图 |
agent.invoke() |
启动一次运行 |
这就是使用 LangChain 的价值:不需要手写 StateGraph,也能获得一个标准 ReAct Agent。
严格来说,这个示例里的 resolve_city 和 get_weather 是 Tools,不是独立 SKILL。Tool 是模型可以直接调用的函数;SKILL 更像一套可复用的任务说明、步骤、参考资料和脚本。如果要把它升级成"天气查询 SKILL",可以在 SKILL 中规定城市标准化、数据源选择、异常处理和输出格式,再把这两个 Tools 作为执行能力交给 Agent。
十一、什么时候应该把它改写成 LangGraph
上面的天气 Agent 没有必要直接手写 LangGraph,因为它的流程非常标准:Model 判断、调用 Tool、拿到结果、继续判断,直到输出答案。
但如果需求变成下面这样,LangGraph 的价值会明显增加:
复杂天气服务:
  1. 先判断用户所在租户和数据权限
  2. 国内城市走供应商 A,海外城市走供应商 B
  3. 查询失败时最多重试两次
  4. 极端天气进入风险评估节点
  5. 高风险预警必须经过人工确认
  6. 确认后同时发送短信和企业消息
  7. 任一步失败都能从检查点恢复
这时,应该把关键业务路径显式建模:
State:
  city、country、weather、risk_level、approved、retry_count

Nodes:
  resolve_city、route_provider、query_weather、assess_risk
  human_approval、send_alert、handle_failure

Edges:
  普通边连接固定步骤
  条件边根据 country、risk_level、retry_count 选择路径
  interrupt 在高风险通知前暂停
选择标准不是代码行数,而是业务流程是否需要显式控制。
能用
create_agent + middleware清楚表达,就先用 LangChain;当状态、分支、循环和人工介入成为业务核心,再直接设计 LangGraph。
十二、生产环境最容易踩的六个坑
12.1 Tool description 写得太宽泛
"查询信息"几乎没有决策价值。应该说明输入前提、调用时机、能力边界和不能做什么。
12.2 把所有控制逻辑塞进 Prompt
权限、超时、重试、预算和审计属于确定性控制,应该进入 middleware、Tool Gateway 或图节点,不应只靠模型自觉遵守。
12.3 混淆 context、state 和 store
context 是本次运行注入的业务依赖;state 是流程中不断更新的数据;store 是跨会话长期保存的数据。混用会导致权限信息被模型修改,或者不同会话互相串数据。
12.4 使用 checkpointer 却忘记 thread_id
Checkpointer 需要通过 thread_id 确定保存和恢复哪条会话。首次执行和恢复执行必须使用同一个 ID。
12.5 interrupt 前执行不可重复的副作用
恢复时节点会从开头重新运行。interrupt 前的扣款、发送消息或数据库写入必须幂等,最好拆到审批后的独立节点。
12.6 无限制地让 Model ↔ Tools 循环
生产 Agent 应限制最大步数、总时长、Token、成本和工具重试次数,并监控重复 tool call。否则一个参数错误就可能演变成高成本死循环。
写在最后
理解 LangChain 和 LangGraph,关键不是记住更多 API,而是分清两个层次:
LangChain:
  Model + Tools + Prompt + Middleware
  + Structured Output + Runtime + Memory
  快速搭建一套标准 Agent Harness

LangGraph:
  State + Node + Edge
  + Branch + Loop + Interrupt + Persistence
  精确描述 Agent 如何流转和恢复
create_agent 帮我们快速得到一套成熟的 Model ↔ Tools 循环;middleware 把路由、权限、重试和观测放进执行控制面;runtime 把用户、租户和会话信息带入本次运行;response format 保证结果能被程序可靠消费。
当流程出现复杂分支、长时间运行、人工审批和失败恢复时,再把 Agent 展开为 LangGraph:让 State 携带数据,让 Node 执行步骤,让 Edge 决定路径。
最终,两者不是竞争关系,而是同一套 Agent 工程的不同抽象层。
参考资料
-
LangChain Agents 官方文档
-
LangChain Models 官方文档
-
LangChain Tools 官方文档
-
LangChain Middleware 官方文档
-
LangChain Runtime 官方文档
-
LangChain Structured Output 官方文档
-
LangGraph Persistence 官方文档
-
LangGraph Interrupts 官方文档