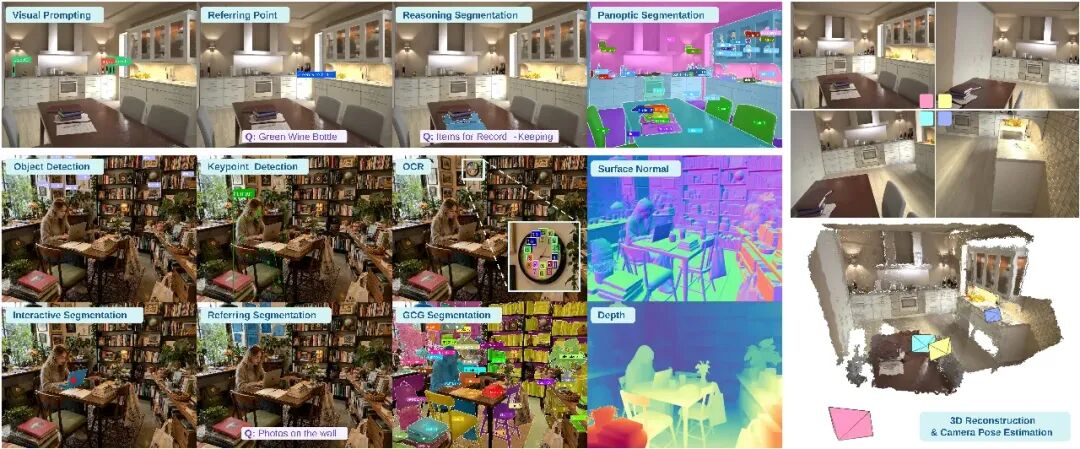
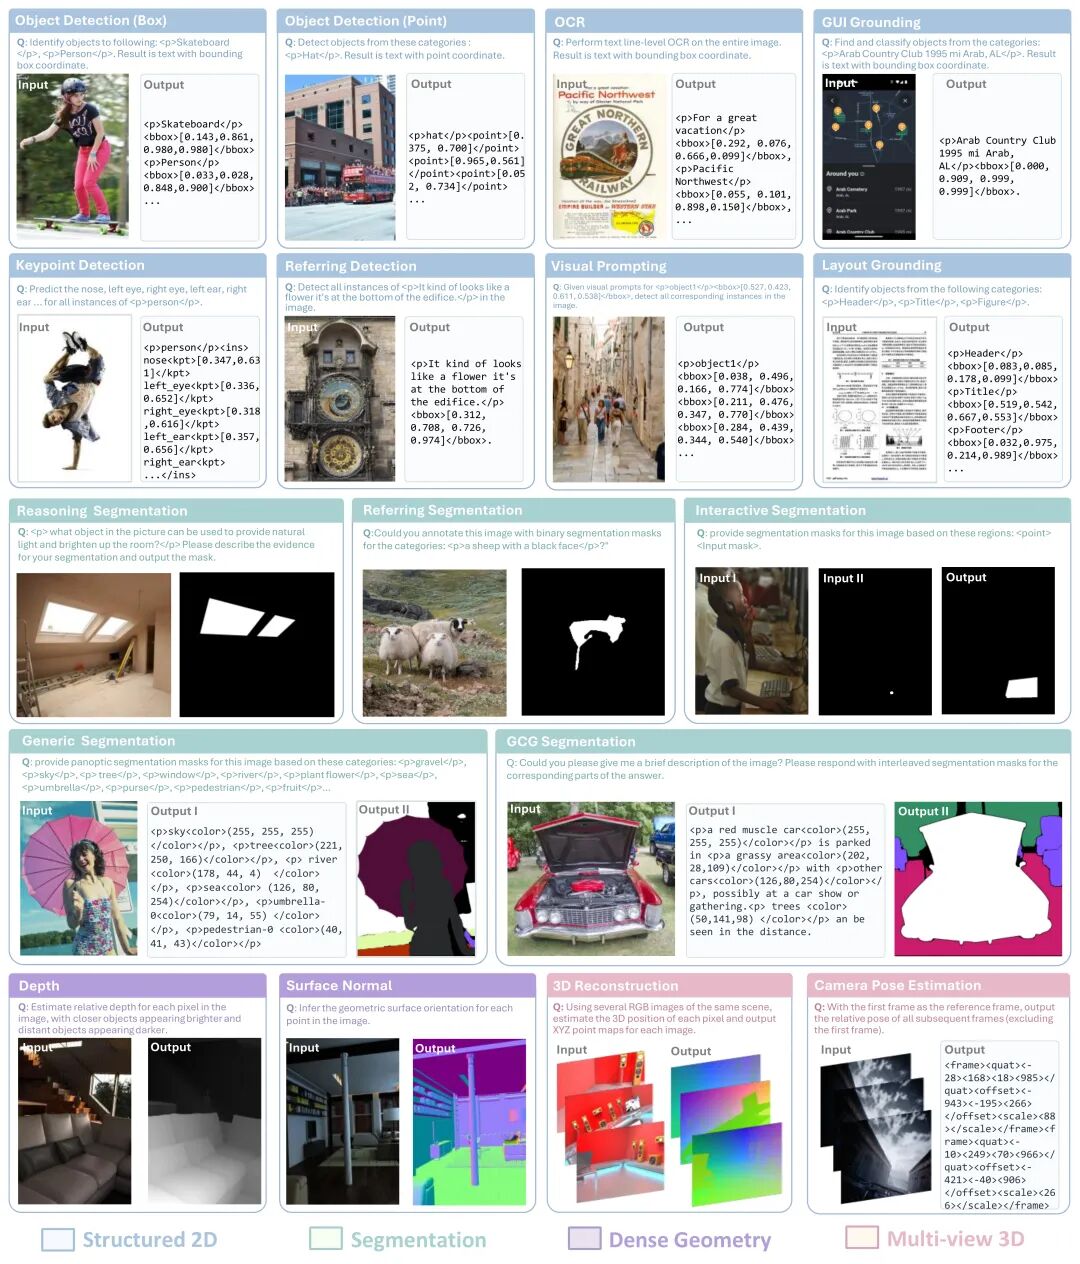
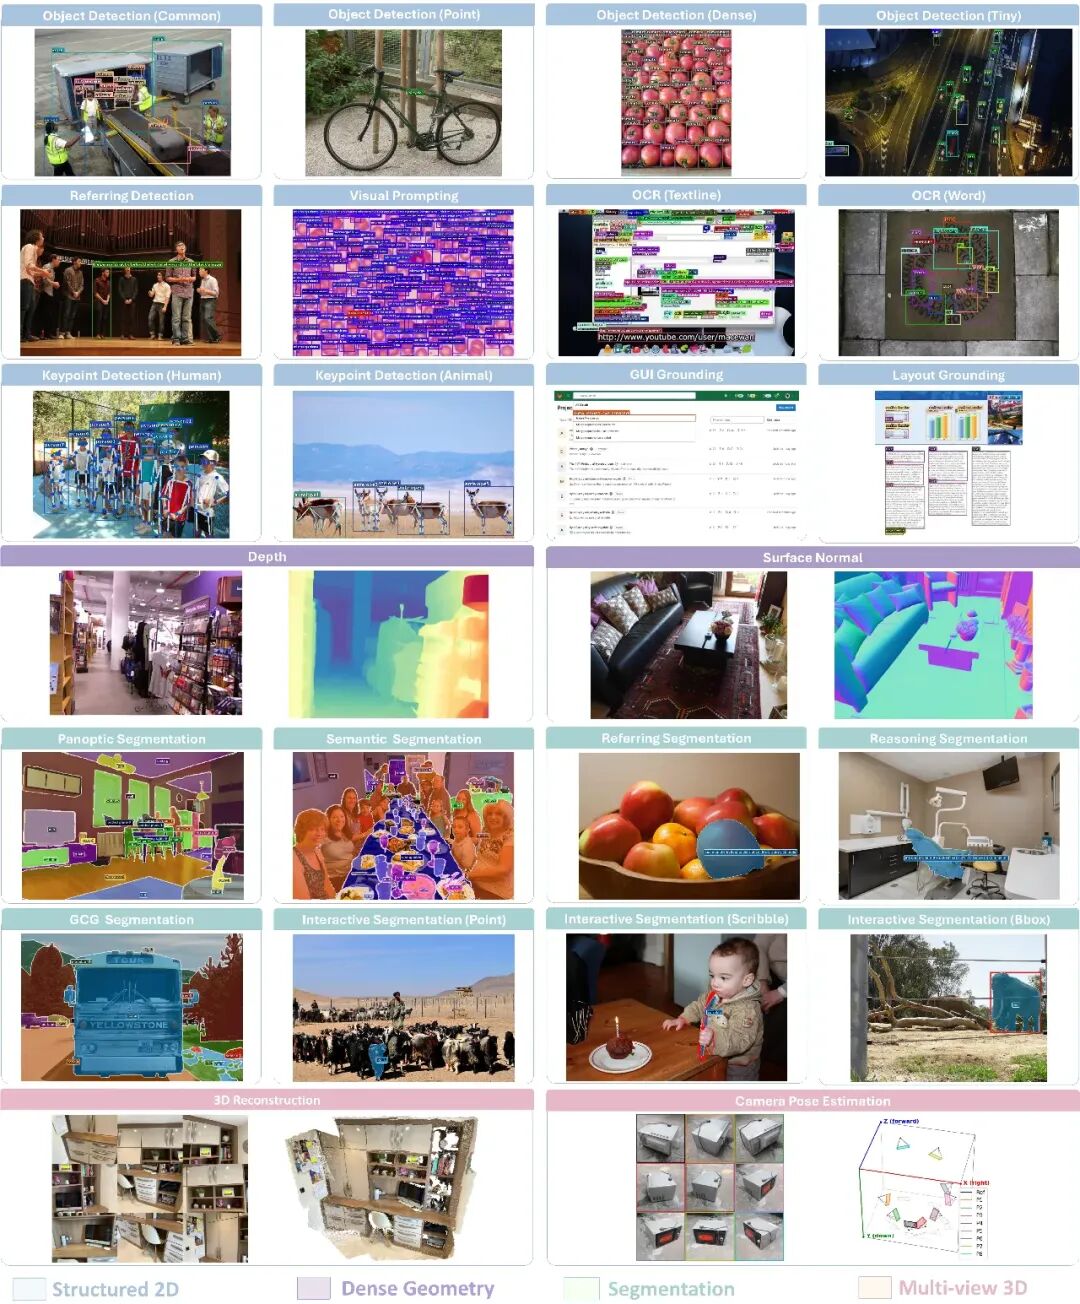
导读 ------ 商汤联合 NTU / CUHK / 北大 / 上交 / 浙大在 2026 年 7 月放出了目前"覆盖面最广"的开源统一视觉模型 SenseNova-Vision:检测、OCR、关键点、分割、深度、法线、多视角重建、相机位姿,全部塞进一个 7B 统一多模态模型的"文本生成 + 图像生成"接口里,没有任务特定 head,权重 + 5000 万训练样本 + 全套代码 Apache 2.0 开源。本文不转述新闻稿,而是做三件事:用公式讲清它如何把异构视觉任务翻译成生成目标;逐项解剖成绩单里"真赢、惜败、口径游戏"的部分;最后讨论全面统一的代价账单与历史坐标。
0. 引子:一个机器人需要多少双眼睛?
想象你要给一台机器人装上"视觉"。传统做法是一张购物清单:
- 检测,买一个模型(YOLO / DINO / Grounding DINO);
- 分割,买一个(SAM / Mask2Former);
- 深度,买一个(Depth Anything / MoGe);
- 位姿估计与三维重建,再买一套(DUSt3R / VGGT)。
每个模型有自己的架构、权重、解码规则、部署依赖。系统集成者的日常,是在四个 GPU 进程之间搬运张量、对齐坐标系、祈祷误差不要级联放大。
NLP 在 2020 年已经经历过一次"接口革命":翻译、摘要、问答、情感分析,所有任务被 GPT 统一为同一个动作------给定上下文,生成下一个 token。任务之间的区别从"模型结构"变成了"提示词"。
为什么计算机视觉迟迟没有发生同样的接口统一?答案藏在输出的数学形态里:检测框是符号 (几个浮点数),深度图是连续场 (逐像素的物理量),掩码是二值几何 ,相机位姿是刚体变换群 SO(3) ⋉ R³ 上的元素。这些对象异构到不存在一个天然的共同接口。
SenseNova-Vision(arXiv 2607.06560)的核心命题只有一句话:
异构是表象。生成空间只有两种------离散的文本和连续的图像。符号记录走文本生成,像素对齐的稠密图走图像生成,复合任务走二者混合。任务之间的区别不再是架构,而是指令。
这句话听上去像口号,但它背后是整套精心设计的编码协议 、训练配方 和5000 万样本的数据引擎。而且作者把权重、数据、代码全部开源了------这在追求全面统一的论文里极为罕见,也使得本文的每一个论断都可以被读者亲手验证。
下面进入解剖。
1. 统一的数学形式:一切视觉任务都是条件生成
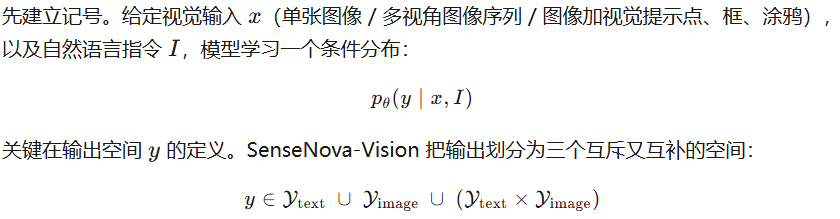
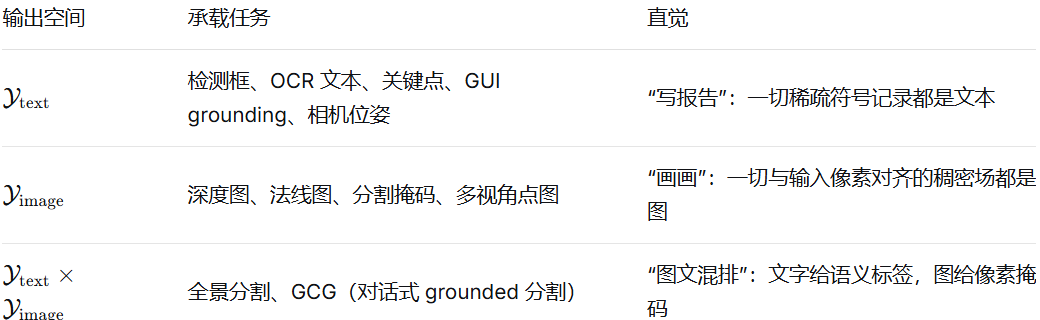
这个划分的优雅之处在于:它不是把所有任务硬塞进一个模态,而是让输出模态回归信号的物理本质。符号是离散的、组合性的------文本天生如此;稠密场是连续的、空间对齐的------图像天生如此。
一旦接口统一,"定义一个新任务"就变成了"写一条新指令"。论文展示了用语言组合类别、颜色、区域等线索构造训练集里从未出现过的任务变体,模型可以 zero-shot 跟随------这是任务特定 head 架构永远给不了的"可编程性"。
对非专业读者打个比方:过去的 CV 系统是"每个工种一台专用机床",SenseNova-Vision 把它变成了"一台数控机床加一份图纸(指令)"。机床没变,换图纸就能加工新零件。
2. 底座解剖:为什么是 Bagel,而不是 Qwen-VL
统一生成的前提是底座模型原生拥有两个生成空间。这正是统一多模态模型(UMM)在 2024--2026 年快速演进的成果:
- Chameleon / Emu3(2024):把图像离散化成 token,文本图像共用一个词表,统一但图像保真度受损;
- Janus(2024):解耦理解编码器与生成编码器,各走各的路,最后统一进 LLM;
- Bagel(2025,字节 Seed):理解通道用 SigLIP2 做语义嵌入,生成通道用 VAE latent隐变量 + rectified flow矫正流 做图像生成,主干是 MoT(Mixture-of-Transformers,理解/生成两组 expert 共享注意力但保留独立通路)。
SenseNova-Vision 选择 Bagel-7B-MoT 作为起点,是一个深思熟虑的工程决策,值得展开。
为什么不选纯 MLLM (如 Qwen-VL 系列)?因为 MLLM 只有文本生成头。要让 MLLM 输出掩码或深度图,必须外挂 SAM 解码器、深度解码器(LISA、G2VLM、VisionLLM v2 走的就是这条路)------这等于在接口层面重新引入任务特定模块,"无 head 统一"的命题当场瓦解。稠密输出需要的是连续空间生成,扩散模型是唯一成熟的选项。
为什么不选纯扩散模型(如 DICEPTION、Vision Banana)?因为它们以图像生成为中心:深度、法线、分割掩码这类稠密输出是它的主场,检测框、OCR 字符串、相机参数这类符号记录只有很有限的处理能力------把框画成图再 OCR 回来既荒谬又损失精度。符号侧的统一,恰是这条路线至今的短板。
Bagel 的双通道恰好补全了拼图:SigLIP2 语义通道负责"读懂指令、定位目标",VAE + flow 生成通道负责"画出稠密输出"。SenseNova-Vision 本质上是在给 Bagel 这双"左右手"重新编排一套覆盖全部 CV 任务的动作库。
3. 编码的艺术:每种标注如何变成可生成的目标
这是全文最硬核的部分,也是真正体现工程深度的地方。统一口号谁都会喊,把度量深度、单位法线、SE(3) 位姿这些数学对象一一翻译成"文本能写、扩散能画"的目标,每一题都有讲究的取舍。
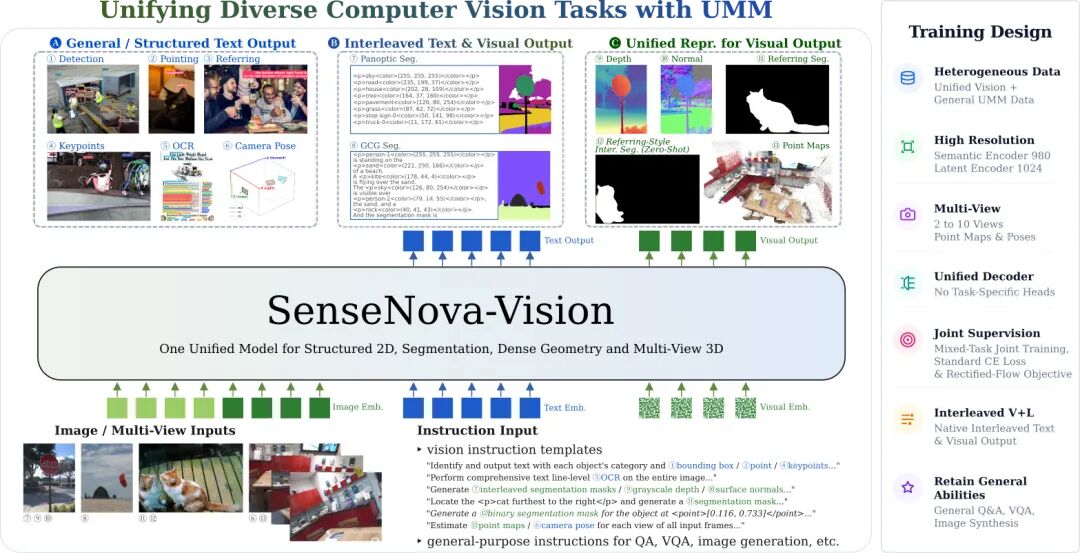
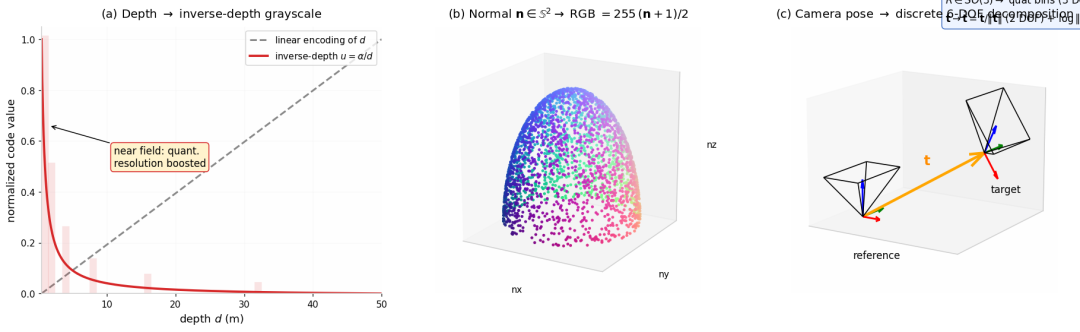
而这三种编码方案的数学原理,可以浓缩为一张图:
3.1 符号任务 → 文本序列:坐标序列化
检测输出被写成:
<p>skateboard</p><bbox>[0.143, 0.800, 0.848, 0.900]</bbox><p>person</p><bbox>[0.803, 0.028, 0.848, 0.900]</bbox>坐标归一化到 0,10,1,用轻量标记 <p>、<bbox>、<point>、<kpt> 分隔短语与数值字段。OCR、关键点、GUI grounding、版面分析共享同一套文本空间,任务差异只体现在指令和 schema 上。
但这里埋着一个鲜少被讨论的天花板:BPE tokenizer 对数值的切割。 字符串 "0.800" 在词表里不是原子 token,而是 "0"、"."、"80"、"0" 的组合。模型生成坐标本质上是"组合多个离散 token 逼近一个连续量",其有效精度受词表覆盖与组合概率的乘积限制。坐标写得越长越精确,序列越长越容易在十几二十个物体的长列表上漂移。论文自己的收敛分析印证了这一点:密集检测(crowded scene 长序列)是所有任务里收敛最慢的(详见第 7 节)。文本路线的结构化输出,上限不在模型聪明程度,而在数值的离散化表示------这是该范式与生俱来的税。
3.2 深度 → 逆深度灰度图
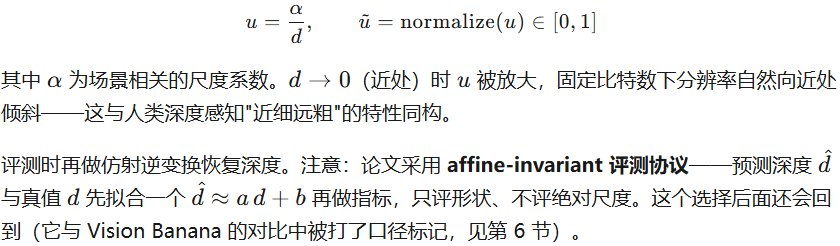
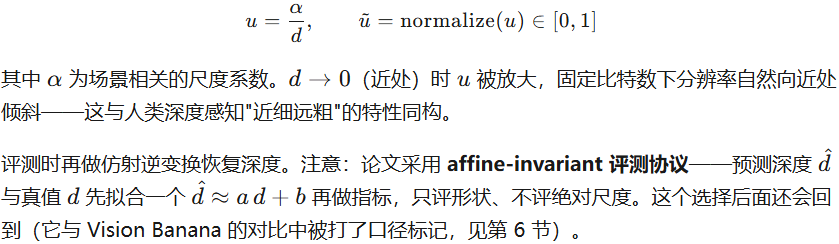
度量深度 dd 的动态范围极不均衡:室内 0.5--10 米,室外轻松跨两个数量级,且感知上近处精度远比远处重要。直接把 dd 线性归一化渲染成灰度图,会把量化精度浪费在远处背景上。
SenseNova 的方案是逆深度编码:
3.3 法线 → RGB 线性球面映射
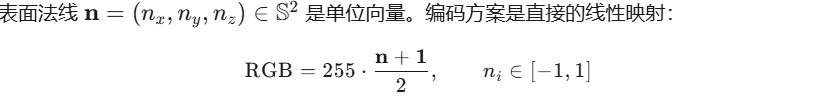
为什么不用球坐标 (θ,ϕ) 或八面体映射?因为线性映射的三个通道独立编码三个分量,与 VAE 的自然图像先验完全兼容------扩散模型在亿级 RGB 图上预训练过,"线性编码的流形"比"角度参数化的流形"离它的先验更近,优化更稳。
代价有二:其一,模长信息被(单位向量假设)丢弃;其二,物体边界两侧法线方向突变,RGB 上出现剧烈跳变,模型必须学会"画出正确的不连续",而不是抹平它------这解释了为什么法线收敛快(接近预训练的图到图翻译模式)但在边界质量上长期不如专用几何网络。
3.4 点图 → XYZ 三通道图:把 3D 降维成 2D
多视角重建输出逐视图稠密点图(per-view dense point map):每个像素的 3D 坐标 (X,Y,Z)直接存入 RGB 三通道。处理约定:
- 所有视角对齐到第一视角的坐标系;
- 点集做中心归一化(减均值、缩放到单位尺度);
- 无效像素映射到一个远离场景的"天空盒"常量。
这个设计的妙处是把多视角 3D 几何学习降维成 2D 图像翻译------输入是多张图,输出是同等数量的"坐标图",完整复用扩散模型的全部空间归纳偏置,无需任何点云特定的算子(没有 kNN、没有体素 voxel、没有 transformer 跨点注意力)。
代价同样清晰:中心归一化抹掉了绝对平移,尺度归一化抹掉了绝对大小,模型只能恢复相对几何------这对"重建房间结构"够用,对"测量房间尺寸"不够。
3.5 相机位姿 → 发明一门"几何语言"
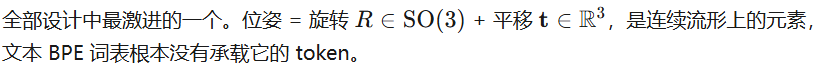
SenseNova 的方案:占用基模型词表末尾的 2009 个 token,改造成专属几何语言 。其中 2001 个承载量化参数,8 个做结构占位符(<frame>、<quat>、<offset>、<scale>)。编码分解:
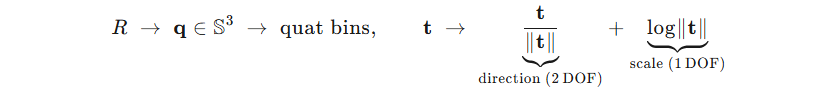
旋转 3 自由度 + 平移方向 2 自由度 + 尺度 1 自由度 = 6,恰好等于 SE(3) 的维度------这不是巧合,而是对刚体运动最小参数化的刻意遵循。
这个设计把"连续几何回归"问题转化为"离散 token 分类"问题,收益是与文本输出共享同一套自回归解码、同一套指令接口;代价是三重的:
- 量化误差:桶的粒度决定角度分辨率,词表预算(2001)在精度和可学习性之间取舍;
- 嵌入冷启动:这 2009 个嵌入在 Bagel 预训练里从未出现过,全部要从零学习;
- 更根本的,是流形离散化本身:把连续的 SE(3) 刚体运动群压成有限词表上的分类问题,是一个高度非凸的优化难题------量化误差与嵌入冷启动只是它的两个具体症状。论文收敛分析中位姿估计收敛显著偏慢,根因在此。
给专家的一个观察:这与 DUSt3R/VGGT 的连续回归路线、与 NeoFeat 的特征空间路线形成鲜明对照,是"几何问题语言化"这条少有人走的路目前最大规模的公开实验。
4. 训练:两个损失函数的婚姻
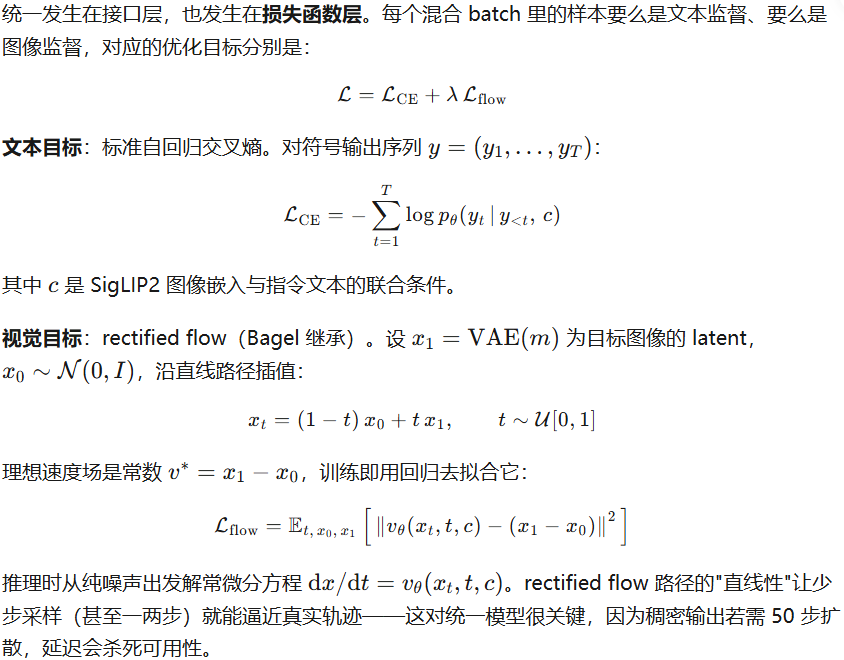
工程配方细节,每一条都有明确动机:
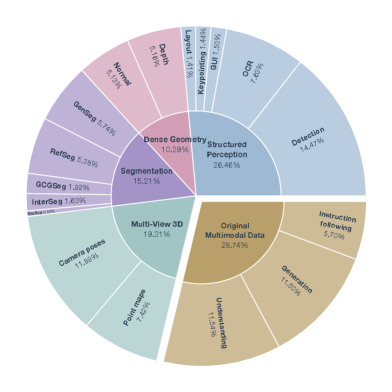
- 联合采样:mini-batch 内 CV 任务样本与通用多模态样本(VQA、文生图、图生图)混合抽取,防止灾难性遗忘;
- SigLIP2 条件分辨率提到 980px:Bagel 生成侧原始条件分辨率更低,而分割等任务需要细粒度空间条件,这一改动直接服务掩码质量;
- 多视角训练:每个样本随机采至多 10 个视角,对齐首视角、中心归一化;
- 冻结 VAE 编码器,其余全量可训;AdamW,lr 2.5×10−52.5\times10^{-5},无权重衰减,50K steps,warmup 500 步,EMA 0.995(评测用 EMA 权重);32K--36K token/rank 的 packing,单样本最大上下文 32K;
- 输入 token dropout:文本 0.05、ViT 0.1、VAE 0.1------对多任务混合训练的正则化。
能力保持的账要单独记:混合训练只部分奏效------训练后 MMVP(多模态理解基准)从 Bagel 的 83.3 降到 79.0(-4.3),GenEval(文生图基准)从 0.82 微升到 0.85。理解能力为统一视觉任务付了真实的遗忘税,只是被控制在可接受范围。
5. 数据引擎:5000 万样本如何炼成,以及一个值得追问的循环
统一的另一半是数据。SN-VC(SenseNova-Vision Corpus)把异构标注统一转换为"指令 + 可解码响应"的样本,两部分来源:
- 公开数据集直转:COCO、LVIS、RefCOCO 系、ScanNet、KITTI、ETH3D、7Scenes、RealEstate10K、CO3Dv2 等的已有标注,按协议机械转换;
- 生成/整理子集(SN-VC-50M,5000 万样本):公开监督缺失或不完整的部分,用模型生成伪标签补齐。
第二个来源的老师值得逐一点名:
- MoGe-2:生成深度与法线伪标签,补全不完整监督;
- LingBot-Depth:补全多视角稀疏深度;
- Rex-Omni 的数据构造 pipeline:构造检测与 OCR 数据。
这里存在一个论文没有正面回应的同源循环问题 :MoGe-2 和 Rex-Omni 的核心作者(Haiwen Diao 等)就在本文作者名单里,均属商汤研究圈。用自家老师的伪标签训练学生,再与自家老师同台对比------必须坦白,现有证据无法排除 这一质疑,甚至现状与同源蒸馏的典型模式吻合:学生在多数指标上贴身逼近老师、却几乎没有实现超越(见第 6.2 节。当然,教师模型更强也可以有完全正当的解释------伪标签质量高而学生容量与优化受限------这与"同源亲和性"从结果上难以区分,恰恰是需要消融的原因)。它意味着"接近老师"的这部分性能里,真实跨数据泛化与伪标签分布同源的亲和性各占多少,论文没有给出回答,读者也无从分辨。
这是本文最值得追问的实验缺失:如果深度伪标签改由完全第三方的 VGGT 生成、检测伪标签改由 Grounding DINO 生成,重训后的数字掉不掉?掉 1 个点以内,统一路线的可信度大增;掉 3 个点以上,"50M 语料"的真实含金量就要重新估价。
6. 成绩单解剖:哪里是真赢,哪里是口径游戏
论文措辞相当克制,原文只说"leads structured understanding, remains close on dense and segmentation, approaches on multi-view"(结构化理解领先,密集任务和分割接近,多视图逼近);商汤通稿却称"比肩甚至超越专家模型"。
6.1 结构化理解:唯一可以谈"赢"的族
| 任务 | SenseNova-Vision | 最强基线 | 判定 |
|---|---|---|---|
| COCO-Common(F1@mIoU) | 56.6 | Grounding DINO-T 56.6 | 持平 |
| LVIS | 54.8 | LocateAnything 50.7 | 胜 |
| Dense200 | 66.8 | LocateAnything 58.7 | 胜 |
| VisDrone(bbox / point) | 43.3 / 62.9 | LocateAnything 39.9 / 60.4 | 胜 |
| HierText | 31.2 | LocateAnything 29.1 | 胜 |
| ICDAR15 | 49.5 | Rex-Omni 28.1 | 大胜 |
| ScreenSpot-V2 | 85.9 | Qwen3.5-9B 92.2 | 负 |
| COCO-Kpt | 34.6 | Rex-Omni 32.6 | 胜 |
检测、OCR、关键点全面压制 grounding 类模型,ICDAR15 上接近翻倍的优势尤其惊人。但注意口径:这里用的是 F1@mIoU(匹配后的 IoU 阈值 F1),而 COCO 检测主流榜单用 mAP。两者不可直接换算,与 CenterNet / Co-DETR 一类纯检测器的"50+ mAP"不是一个赛道。GUI grounding 输给 Qwen3.5-9B 近 7 个点,也说明通用 MLLM 在其原生强项上仍有壁垒。
6.2 密集几何:惜败 MoGe-2,胜其余生成式方法
深度(AbsRel ↓ / δ₁ ↑):
| 数据集 | MoGe-2(*重评) | SenseNova-Vision |
|---|---|---|
| NYUv2 | 3.5 / 98.0 | 4.0 / 98.1 |
| KITTI | 5.5 / 97.7 | 5.9 / 95.9 |
| ETH3D | 3.4 / 98.8 | 4.3 / 97.4 |
| ScanNet | 3.4 / 98.3 | 3.9 / 98.0 |
| DIODE | 23.0 / 82.3 | 20.6 / 76.4 |
五个深度数据集上 MoGe-2 赢了四个(AbsRel 与 δ₁ 双指标),仅 DIODE 的 AbsRel 例外;法线互有胜负,整体与 MoGe-2 贴身。一个值得玩味的细节:MoGe-2 恰好是训练伪标签的教师模型之一------学生贴身逼近老师,却几乎未能在任何数据集上同时拿下 AbsRel 与 δ₁ 双指标。这与蒸馏的统计特性一致,但也正是同源蒸馏的典型形态:它既不能证明有问题,也不能排除有问题,唯一能裁决的是换第三方教师模型重训的消融(见第 5 节)。
6.3 分割:语言驱动任务赢,掩码先验任务输
| 任务 | SenseNova-Vision | 最强基线 | 判定 |
|---|---|---|---|
| 全景分割 PQ | 48.8 | PSALM 55.9 / X-SAM 54.7 | 明显负 |
| 语义分割 mIoU | 64.0 | PSALM 66.6 | 负 |
| Referring cIoU 组 | 81.3 / 76.0 / 80.3 | X-SAM 85.1 / 78.0 / 83.8 | 负 |
| Reasoning gIoU | 63.2 / 60.7 | LENS 62.1 / X-SAM 57.8 | 胜 |
| GCG mIoU | 65.7 / 66.2 | X-SAM 69.4 / 69.0 | 负 |
| 交互式 point / box | 60.9 / 73.9 | X-SAM 65.4 / 70.0 | 负 / 胜 |
模式非常清晰:凡是语言推理驱动的开放任务,比如推理分割(reasoning segmentation),统一模型占优;凡是掩码先验驱动的经典任务,比如全景分割、指代分割(referring segmentation)、GCG,带 SAM/Mask2Former 先验的专用系统占优。这不是巧合------扩散生成的掩码要从零学"物体性",而 SAM 系模型把物体性烙进了十亿级掩码预训练里。归纳偏置的债,这条路线还在分期偿还。
6.4 多视角几何:通稿不会强调的差距
| 任务 | SenseNova-Vision | VGGT | DepthAnything3 |
|---|---|---|---|
| 7Scenes 重建 F1 ↑ | 87.9 | 88.4 | 90.5 |
| ETH3D 重建 F1 ↑ | 72.2 | 80.9 | 76.6 |
| Re10K 位姿 AUC@30 ↑ | 77.3 | 79.3 | 89.6 |
| CO3Dv2 位姿 AUC@30 ↑ | 80.1 | 89.2 | 91.8 |
论文诚实承认了与 VGGT、DA3 的差距。值得注意的是位姿分解指标(RRA@30 / RTA@30) SenseNova 有竞争力(99.8 / 94.2)------粗对可以、精对不行,量化 token 的分辨率天花板在 AUC 这种对误差积分敏感的指标上显形了。
6.5 口径小结
三处口径差异需要读者注意:
- 检测:F1@mIoU 不是 COCO mAP,不能和纯检测 SOTA 直接比;
- 深度:affine-invariant 协议下,Vision Banana 的 absolute-depth 数字已标注为不可直接比较;
- 通用模型对比:与 Youtu-VL、Vision Banana 用的是各自原论文报告的指标,并非统一重评。
7. 收敛的分层宇宙:一张曲线图里藏着的谱系
论文 Figure 6 的归一化收敛曲线是被低估的贡献。它第一次实证展示了统一模型内部的任务难易谱系:
- 最快:深度、法线 ------ 目标与输入空间对齐,模式接近预训练里的图生图/编辑任务,先验距离最近;
- 中等:检测、全景分割、多视角重建 ------ 需要语义识别与空间对齐的组合;
- 偏慢:referring 分割 ------ 语言条件 grounding 提出更高要求;
- 最慢:相机位姿、密集检测 ------ 前者的根本困难在于把连续 SE(3) 流形离散成 token 分类的非凸优化(嵌入冷启动与量化误差是其症状),再叠加跨视角跨模态对齐;后者要在长符号序列上维持 crowded scene 的坐标精度。
这个谱系的本质,是任务与预训练先验的"距离"决定收敛速度------与课程学习、持续学习文献中"先验可迁移性"的结论一致。它也提示了统一的隐形成本:训练早期是"集体蹭先验",后期变成"互相拖后腿"的梯度博弈,混合采样权重(Fig. 5b 的实现配比)本质上是人为调停这场博弈的参数。
8. 统一的代价账单
把前面的分析汇总成一张账单,这是任何考虑采用该范式的人应该带走的:
| 税种 | 金额 | 证据 |
|---|---|---|
| 绝对精度税 | 多数任务距专用 SOTA 有缺口,检测族例外 | 第 6 节全表 |
| 数值表示税 | BPE 坐标切割、位姿量化桶、模长丢弃 | 3.1 / 3.5 节 |
| 遗忘税 | MMVP -4.3 | 第 4 节 |
| 绝对几何税 | 深度仿射对齐、点图中心归一化、尺度丢失 | 3.2 / 3.4 节 |
| 算力税 | 推理 80G 级(实测峰值约 38G 显存),训练推荐 32×8×80G | 仓库 README |
| 口径税 | F1@mIoU、affine-invariant 与主流榜单不直通 | 6.5 节 |
| 复现税 | 权重可验、训练不可复现(个人算力不可达) | 同上 |
这张表不为了唱衰,而是为了给出决策边界:这条路线的甜蜜点,是"任务多、单任务精度容忍度 95% 左右、需要语言可编程性"的场景;它的禁区,是"单一任务榨取最后 1--2 个点"的场景。
9. 历史坐标:五条统一路线,SenseNova 站在哪里
把 SenseNova-Vision 放进"统一 CV"二十年的脉络,才能看清它的增量:
- 序列统一:Pix2Seq(检测即序列)→ OFA → Unified-IO → Florence-2。一切 token 化,接口统一了,但稠密图序列化后空间结构别扭;
- 表示统一:MAE / DINOv2 → SAM → Painter / SegGPT。in-context 图像类比指定任务,无语言控制,无统一输出空间;
- 生成先验:Marigold → DICEPTION → Vision Banana。扩散先验吃稠密预测,符号任务能力面窄,统一性主要停留在图像空间;
- MLLM + 外挂 head:Shikra / Ferret → LISA → X-SAM / VisionLLM v2。语言最强,但任务模块破坏了接口统一;
- UMM 原生统一 (2025--2026 新路线):Janus / Bagel 提供双生成空间底座,SenseNova-Vision 是目前在这条路线上覆盖面最广、开放度最高的公开样本。
与第 1 条路线的关键区别:稠密输出走图像空间而非 token 序列,保住空间分辨率;与第 3 条的区别:符号输出走文本,获得组合性与推理能力;与第 4 条的区别:零 head。
同期竞争坐标:Vision Banana(生成导向,图像空间统一强、符号面窄)、Youtu-VL(以视觉-语言统一自回归监督覆盖视觉任务,语言接口覆盖面广,但稠密图像空间输出非其主场)、X-SAM(语言强但有 SAM head)、LocateAnything / Rex-Omni(结构化理解专门统一)。SenseNova-Vision 的差异定位:用单一模型 + 纯生成接口同时进入四个任务族------这是它在拥挤的 2026 年"统一感知"赛道里的立身之本。
10. 对具身智能:感知层的可编程化意味着什么
跳出 benchmark,看机器人/agent 场景。传统具身视觉栈是多模型串联:检测 → 分割 → 深度 → 位姿,误差级联、部署复杂、每加一个任务加一条流水线。统一生成接口的吸引力在于:
- 感知变成写提示词:「标出所有红色且可抓取的物体」一次前向即可,无需为组合条件重新训练;
- 与规划器同构:VLM 规划器和统一感知模型是同一类接口(文本条件生成),系统架构从"异构拼接"变成"同构堆叠";
- 开放词汇与推理内置:推理上的领先(63.2 gIoU)正是 agent 需要的"按意图找东西"能力。
但也要泼冷水:7B-MoT、80G 级推理、扩散多步解码的延迟,离端侧机器人大脑还很远。对关心端侧部署的人,真正的启示在于架构而非权重------统一接口 + 图像生成式稠密输出能否蒸馏进 1--3B 模型、rectified flow 能否压到 1--2 步、坐标序列化能否换成更高效的数值编码,才是这条路线通向端侧的关卡。
11. 结语:统一的地图,而非统一的加冕
SenseNova-Vision 最有价值的产出,其实不是任何一个分数,而是第一张完整的"统一可行性地图":检测与 OCR 已被证明可以统一且不输专用系统;深度法线可统一但还贴不过最强几何模型;分割的可统一性呈现清晰的"语言驱动 vs 掩码先验"分界;相机位姿的可统一性存在量化分辨率的天花板。
它同时回答了"为什么要统一"中常被忽略的一半问题:统一的价值不在单个 benchmark,而在接口的可编程性------任务变体 zero-shot 跟随、感知与规划同构、新任务零新增架构。对于正在构建 agent 系统的人,这种接口价值是真实的;对于追逐单任务 SOTA 的人,这张账单(第 8 节)同样真实。
2026 年下半年,"视觉即生成"已经从口号进入工程验证期。SenseNova-Vision 以罕见的开放姿态(权重 + 5000 万数据 + 全套代码)把这个范式的能力边界和代价边界同时标了出来。接下来需要回答的问题,是统一的广度与专用的深度如何合流------无论是统一模型做编排、专用模型做工具的混合架构,还是把掩码先验与几何偏置蒸回统一底座的端到端路线。这张地图已经画好,接下来是照着它走路的人。
参考与资源
- 论文:Vision as Unified Multimodal Generation, arXiv:2607.06560(v1,2026-07-07)
- 代码与权重:https://github.com/OpenSenseNova/SenseNova-Vision(Apache 2.0)
- 模型:HuggingFace
sensenova/SenseNova-Vision-7B-MoT;数据:sensenova/SenseNova-Vision-Corpus-50M - 底座:Bagel-7B-MoT(字节 Seed,UMM);伪标签教师模型 teacher:MoGe-2、LingBot-Depth、Rex-Omni pipeline
创作不易,禁止抄袭,转载请附上原文标题及其链接