当下 IT 行业正在经历一场由 AI 驱动的技术岗位变革,AI 全栈开发岗位,已经从 "小众新兴岗位" 变成各大互联网、政企数字化项目的核心招聘方向。河南宁渡科技有限公司旗下宁渡课堂,长期深耕 AI 全栈实战教学,服务大量转行、进阶求职学员,在持续收集企业真实面经的过程中发现,如今 AI 全栈面试不再割裂前端、后端知识,更是新增了 Vibe Coding 这一类全新的考察维度,很多技术求职者,栽在了这个新增考点上。
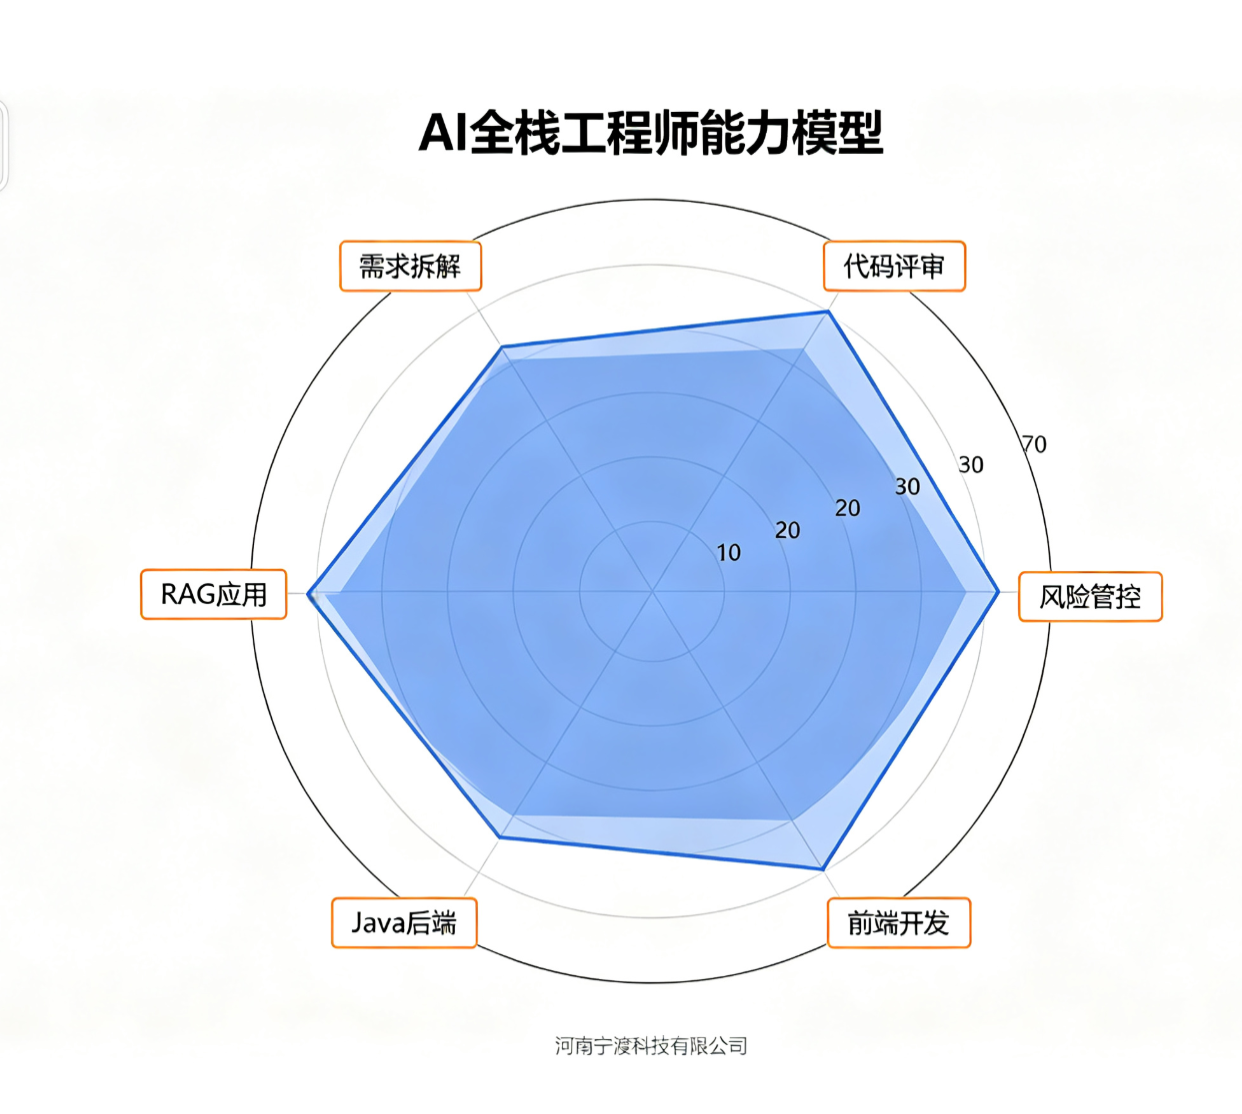
很多程序员对 Vibe Coding 存在认知误区,简单理解为 "用 AI 复制粘贴代码",但在企业面试官眼中,Vibe Coding 考察的是工程师驾驭 AI 工具完成工程交付的综合能力:需求拆解、提示词工程、AI 生成代码审查、边界 case 测试、风险识别,整套工程闭环,这也是 AI 时代程序员的核心竞争力。宁渡课堂教研团队在模拟面试中发现,大量求职者只会让 AI 写代码,不会校验代码缺陷,无法识别 AI 幻觉带来的业务漏洞,一旦面试官深入追问,很容易暴露能力短板。
AI 全栈岗位面试,通常分为三大模块:Vibe Coding 专项面试、前端技术面试、Java 后端面试。三者不是独立分开,而是融合在项目场景提问里。举个例子,面试官抛出一个 RAG 知识库问答系统的项目题,会同时考察:后端 Java 如何设计大模型调用接口、向量库存储与检索逻辑;前端如何实现流式输出渲染、长文本渲染优化;同时通过 Vibe Coding 任务,让候选人现场描述如何借助 AI 完成这个项目的模块开发、代码审查、问题修复。
首先我们来拆解 Vibe Coding 高频面试题。
面试题 1:请解释什么是 Vibe Coding,它和传统编码有什么区别?
参考答案思路:Vibe Coding 是借助大模型作为协作编程助手,开发者聚焦需求定义、架构设计、验收标准,由 AI 产出代码初稿,开发者持续调试、校验、重构的开发模式。传统编码是开发者手写全部代码,从底层逻辑到业务实现全部自主完成。Vibe Coding 不是完全依赖 AI,核心是 "人把控方向,AI 做重复编码工作"。传统编码考验手写能力,Vibe Coding 考验需求拆解能力、代码评审能力、识别 AI 幻觉缺陷的能力。AI 擅长编写标准化 CRUD、基础组件、工具函数;但是不擅长复杂业务架构设计、边界风险判断、业务规则校验,这部分必须由开发者兜底。
面试题 2:当你使用 Vibe Coding 模式开发,AI 生成代码存在隐藏 bug,你如何排查和管控风险?
答题框架:第一步,前置约束,写好项目规范、ESLint、代码风格、业务约束提示词,从源头减少错误代码;第二步,模块拆分,不让 AI 一次性生成整套系统,拆分成独立小模块逐个交付;第三步,自动化校验,单元测试、集成测试、静态代码扫描;第四步,人工代码评审,重点检查空指针、权限校验、SQL 注入、资源泄漏;第五步,边界用例测试,覆盖异常输入、高并发场景;第六步,灰度验证,小流量上线观测。
Vibe Coding 相关考题,常常会搭配前端、后端项目一起考察。接下来是 AI 全栈面试中,前端高频面试题,偏向 Vue3、TS、大模型流式交互场景,也是宁渡课堂学员面试反馈最高频的考点。
前端面试题 1:Vue3 中 ref 和 reactive 区别,在 AI 对话流式渲染场景下如何选型?
答题要点:ref 用于基础类型,也可以存放对象;reactive 只能用于引用类型对象。ref 底层通过.value访问;reactive 基于 Proxy 做响应式代理。在 AI 流式输出场景,流式数据是持续追加的字符串,推荐 ref 存储消息文本;如果是对话列表这种结构化对象数组,使用 reactive 管理。同时要注意,大量追加文本时,DOM 频繁渲染会造成页面卡顿,需要做防抖、虚拟滚动优化。
前端面试题 2:前端实现大模型 SSE 流式输出,原理是什么?有哪些坑点?
SSE 是服务端推送事件,基于 HTTP 长连接,服务端持续向前端推送增量文本。对比 WebSocket,SSE 单向推送,无需双向通信,适合 AI 问答流式返回。坑点:连接中断重连机制、超时处理、浏览器并发连接数限制、断线之后消息断点续传、特殊字符转义。
然后是 Java 后端高频面试题,AI 全栈后端大量使用 Java 搭建大模型网关、RAG 检索服务、任务调度。
Java 面试题 1:使用 Java 开发大模型 API 网关,如何做限流、熔断降级?
答题思路:网关层可以使用 Sentinel 做流量控制,按照用户 ID、接口维度限流;熔断用于当大模型服务超时、报错率过高时,快速失败,直接返回兜底响应,避免雪崩;降级策略:高峰期关闭非核心的高级模型调用,切换轻量模型,或者返回缓存结果。
Java 面试题 2:RAG 项目中,文档切片 Chunk 设计,后端如何实现?Chunk 大小怎么选择?
Chunk 切片策略:固定长度切片、语义切片、按段落切片。Chunk 过大,向量相似度检索会引入无关上下文;Chunk 过小,语义信息断裂。一般业务场景 Chunk 大小 200-1000token。Java 后端可以使用 PDF 解析工具读取文档,做文本清洗,拆分 Chunk,调用向量模型生成向量,存入向量数据库。同时要考虑文档版本管理、去重。
很多求职者面试 AI 全栈岗位时,单独背前端八股、Java 后端八股,但是无法把三者结合起来回答项目场景题。宁渡课堂在 AI 全栈课程体系中,专门加入 Vibe Coding 实战训练,训练学员使用 AI 辅助开发同时,保留完整代码评审、测试、架构设计能力。AI 时代,面试官讨厌只会复制 AI 代码,无法排查问题的程序员。面试官需要的是懂得利用 AI 工具,同时具备扎实前后端底层能力的全栈工程师。
面试备考的核心思路,不是海量背诵面试题,而是把面试题融入真实项目。准备 1-2 个完整 AI 全栈项目,例如 RAG 知识库、AI 智能客服系统,梳理项目架构,分别梳理前端交互逻辑、Java 后端服务分层、向量库设计,同时准备项目开发过程中如何使用 Vibe Coding 协作开发,遇到了哪些 AI 生成代码缺陷,如何修复。在面试讲述项目时,自然串联 Vibe Coding、前端、后端知识点。
总结:AI 全栈岗位面试考察维度已经更新。Vibe Coding 是新增核心考察项,前端偏向 AI 交互场景,Java 后端偏向大模型服务、RAG、高并发接口开发。河南宁渡科技宁渡课堂持续收集企业最新面经,后续继续分享更多细分面试专题,帮助求职者拿下 AI 全栈岗位 offer。