✨作者主页 :IT毕设梦工厂✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、PHP、.NET、Node.js、GO、微信小程序、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
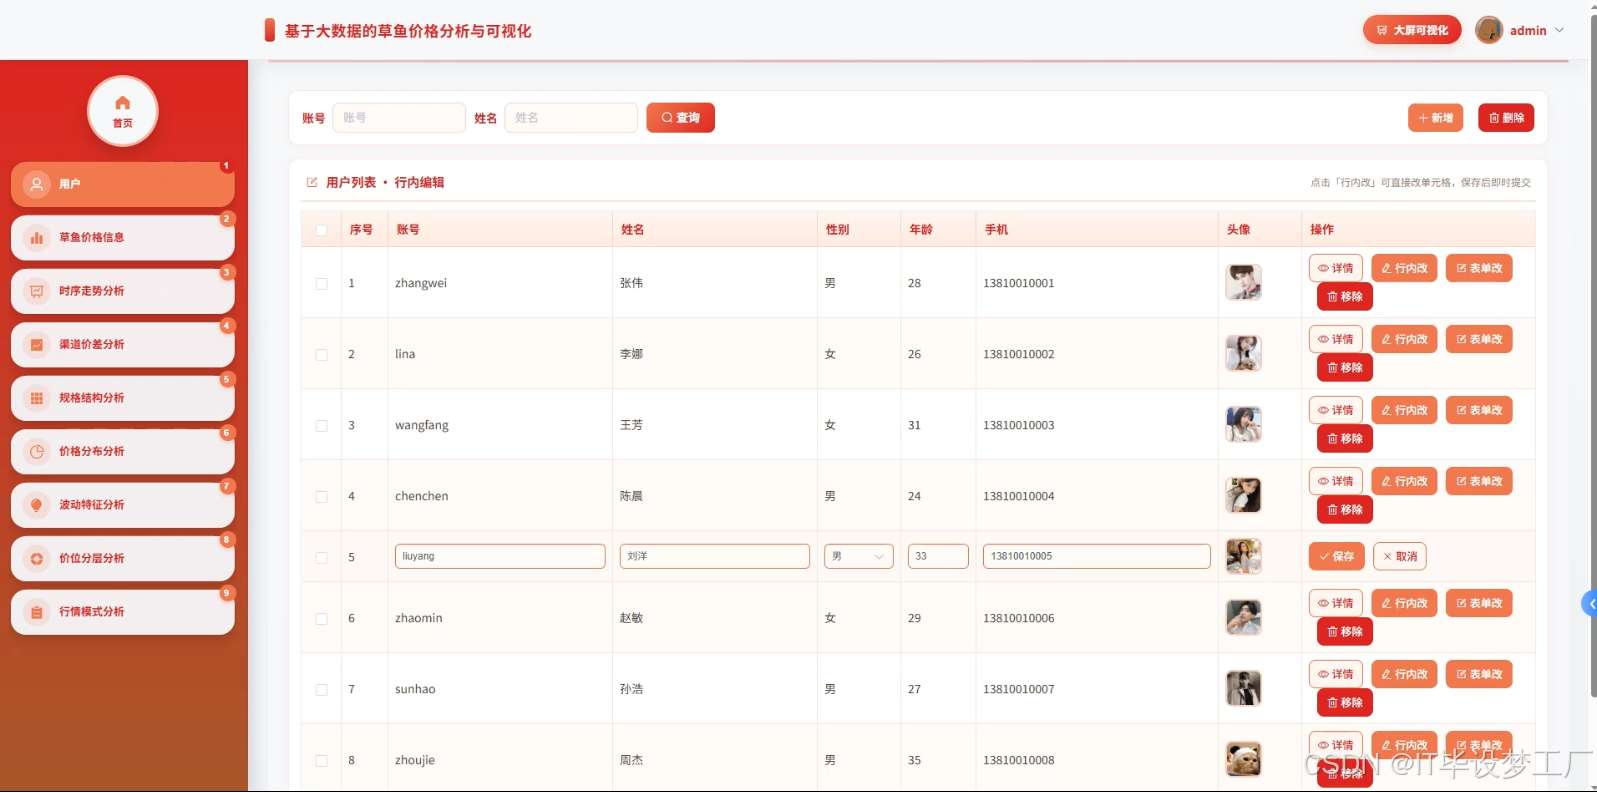
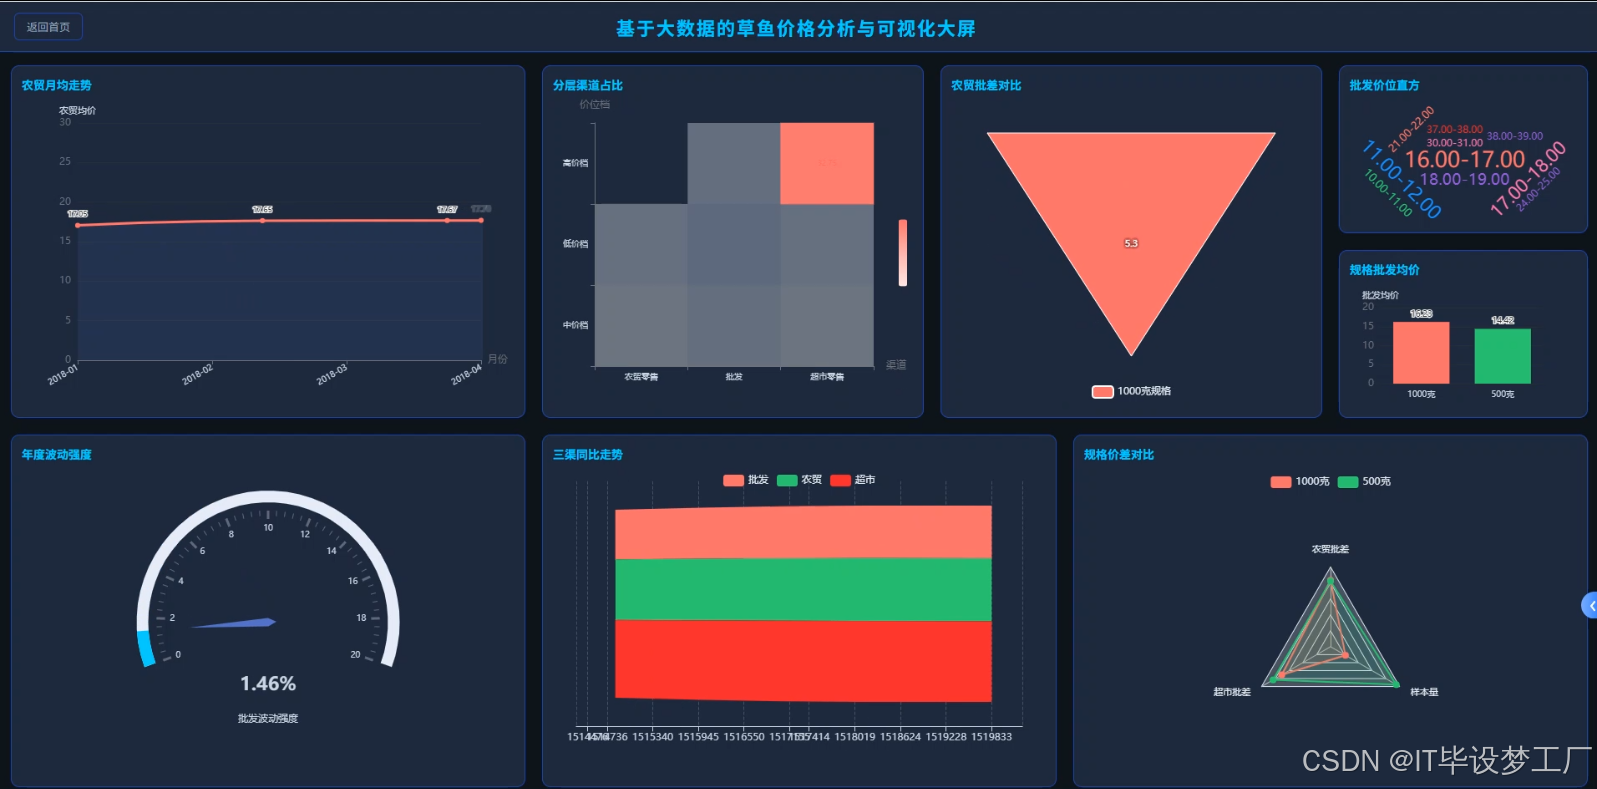
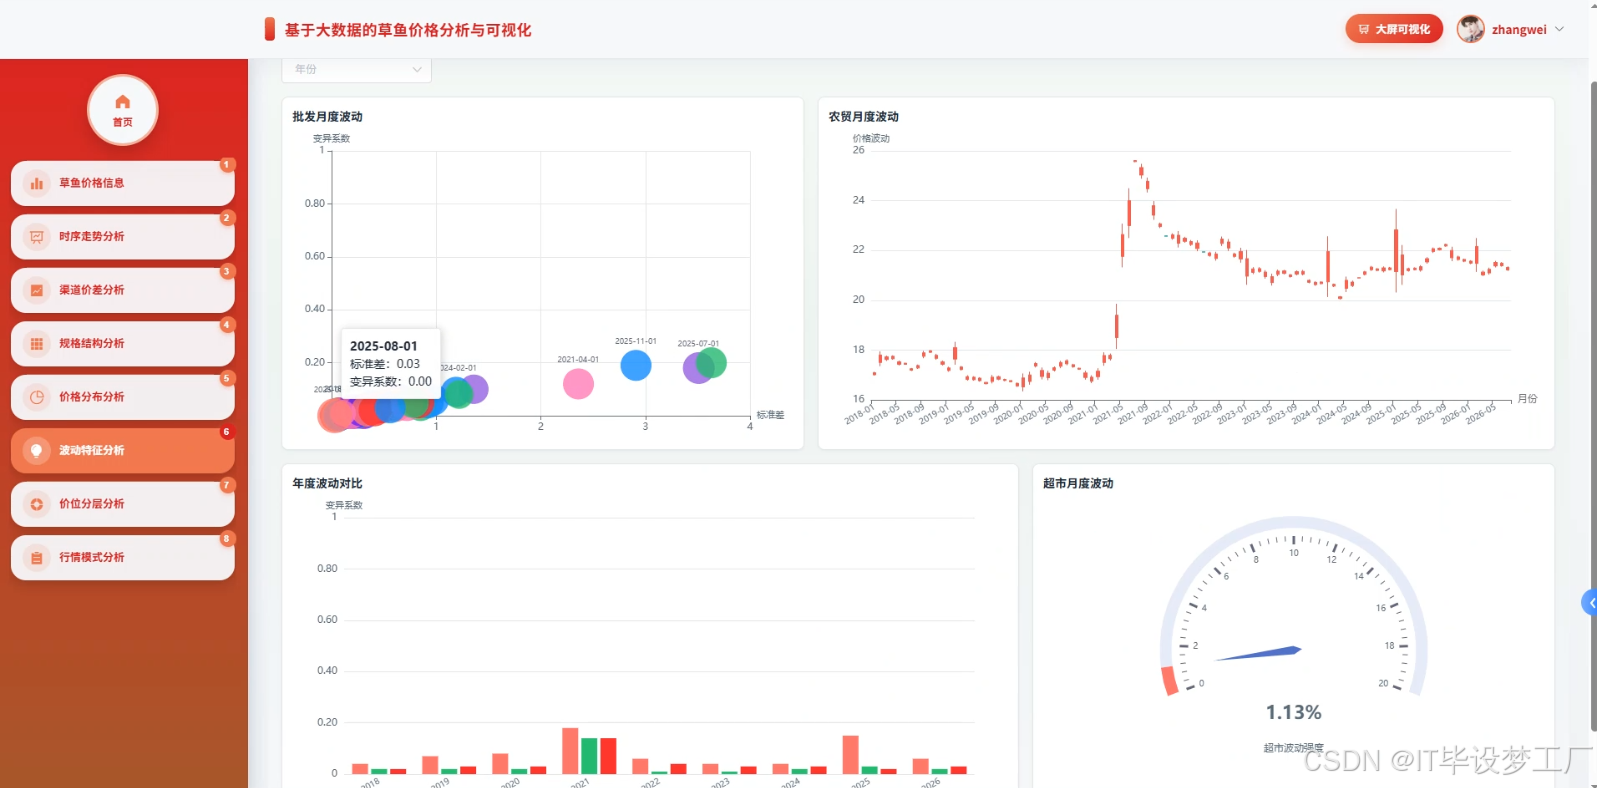
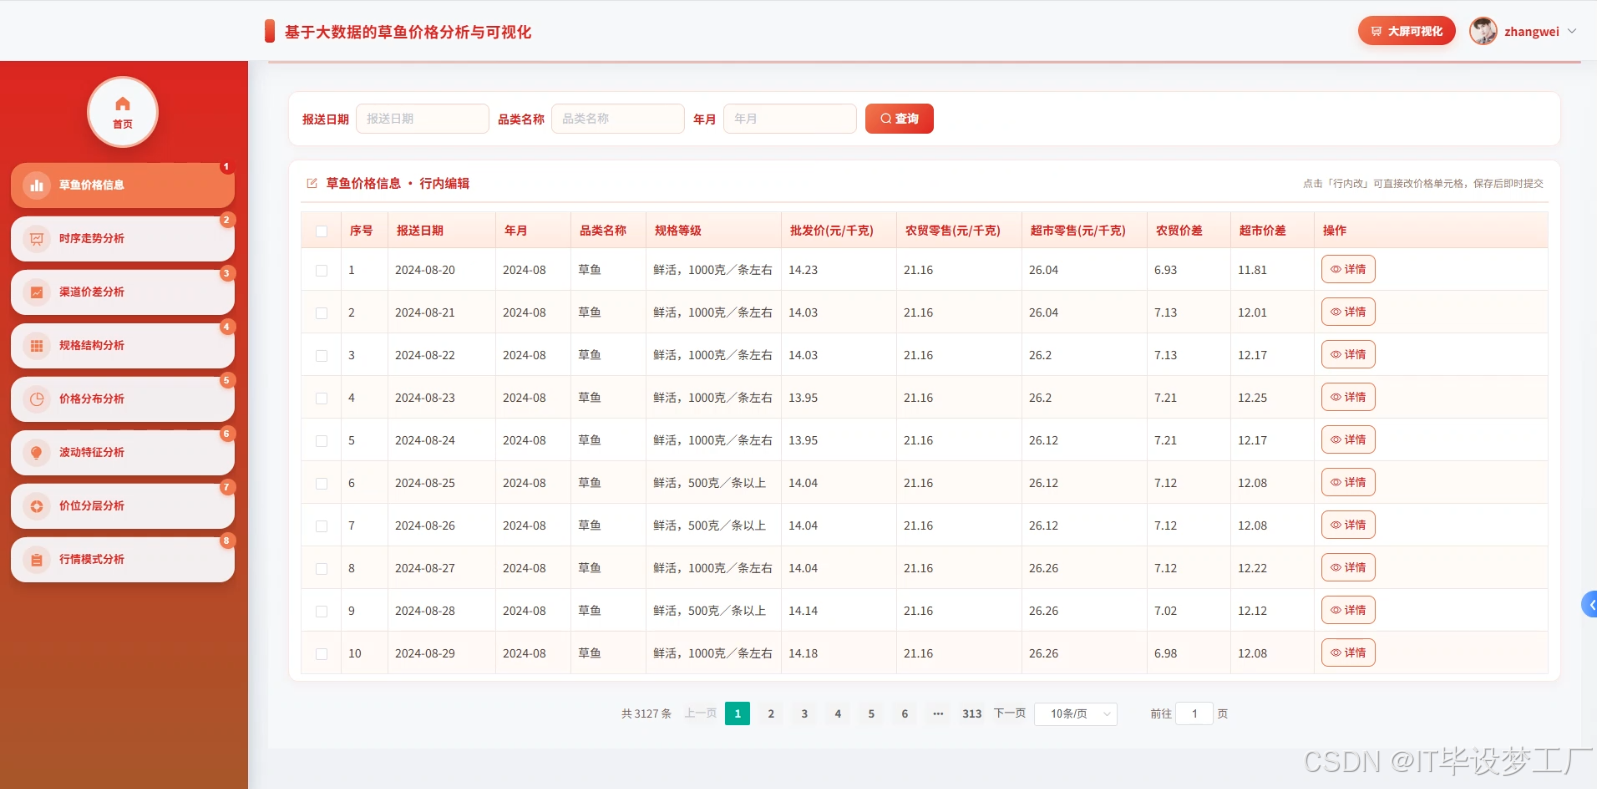
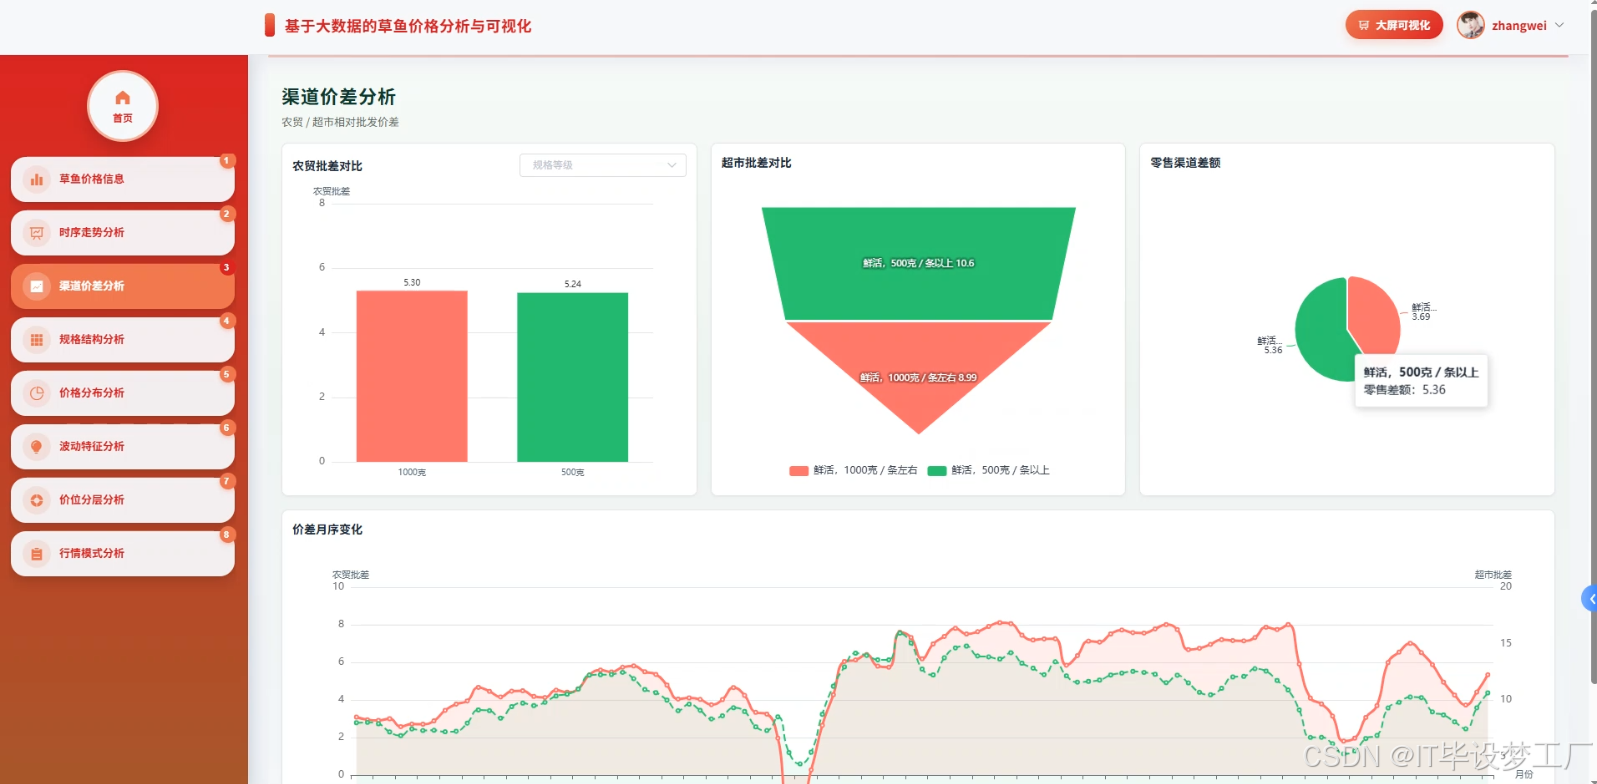
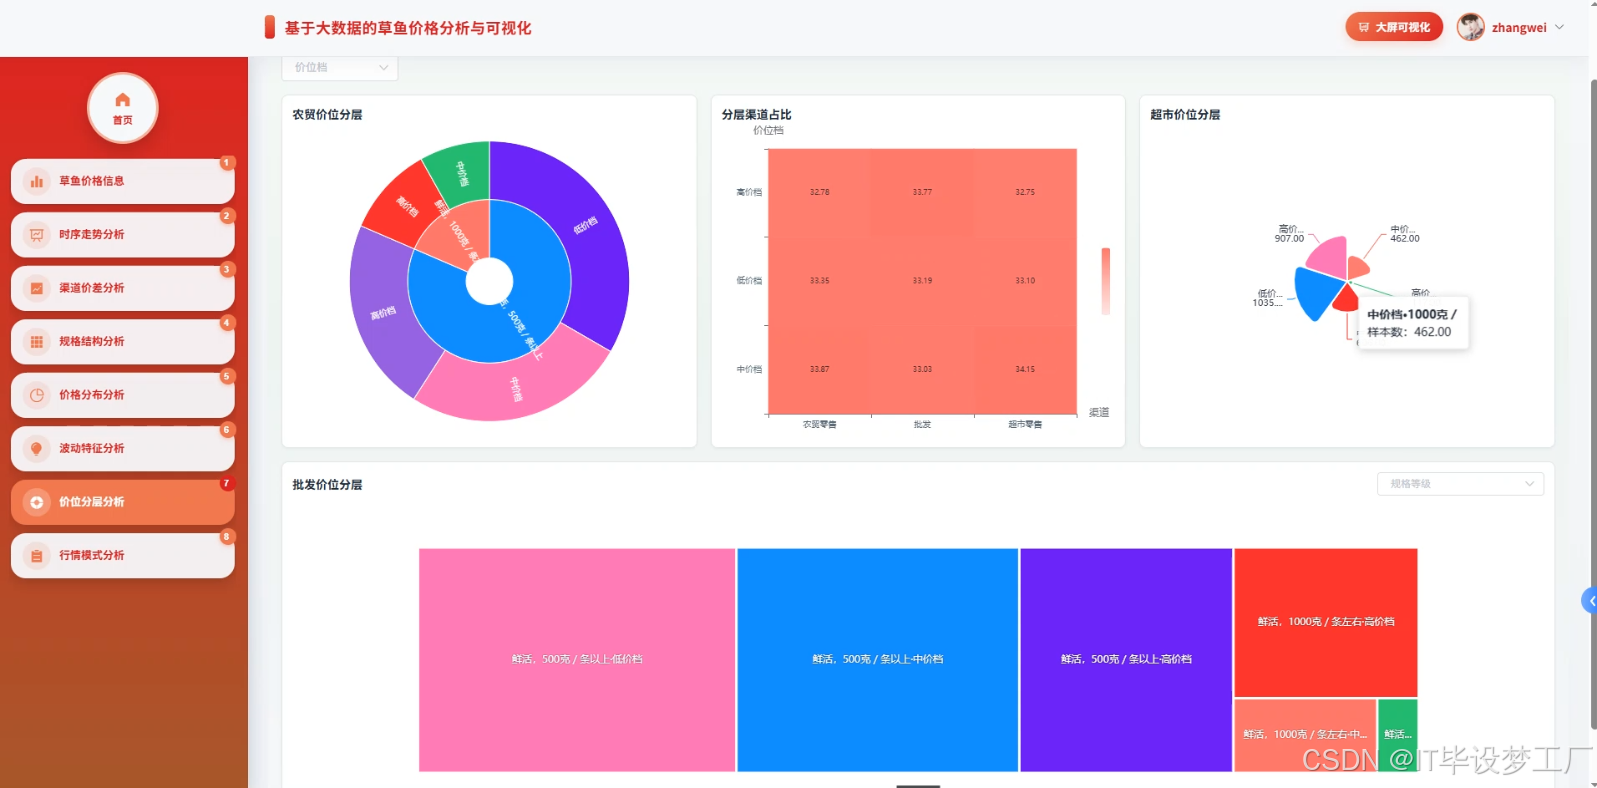
基于大数据的草鱼价格分析与可视化系统是一套面向草鱼价格行情研究的毕业设计项目,整体围绕草鱼价格数据的采集、存储、分析与可视化展示来展开。系统后端采用Python语言结合Django框架进行业务开发,同时支持Java语言结合Spring Boot框架的实现方式,底层借助Hadoop与HDFS完成草鱼价格数据的分布式存储,并通过Spark与Spark SQL对草鱼价格数据进行清洗、统计与多维分析,分析过程中还用到了Pandas与NumPy来做数据处理和数值计算,数据库方面使用MySQL存放用户信息与草鱼价格基础数据。前端部分采用Vue配合ElementUI搭建页面结构,并结合ECharts、HTML、CSS、JavaScript与jQuery完成图表的渲染和交互展示。功能上,系统包含系统首页、大屏可视化、用户管理、草鱼价格信息管理、时序走势分析、渠道价差分析、规格结构分析、价格分布分析、波动特征分析、价位分层分析、行情模式分析、个人信息以及修改密码等模块,能够把草鱼价格在不同时间、不同渠道、不同规格下的变化情况用图表直观呈现出来,帮助使用者较为清晰地了解草鱼价格的走势特征与行情规律,也让整个毕设项目在大数据处理与可视化展示方面形成较为完整的闭环。
二、开发环境
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
数据库:MySQL
三、系统界面展示
- 基于大数据的草鱼价格分析与可视化系统界面展示:
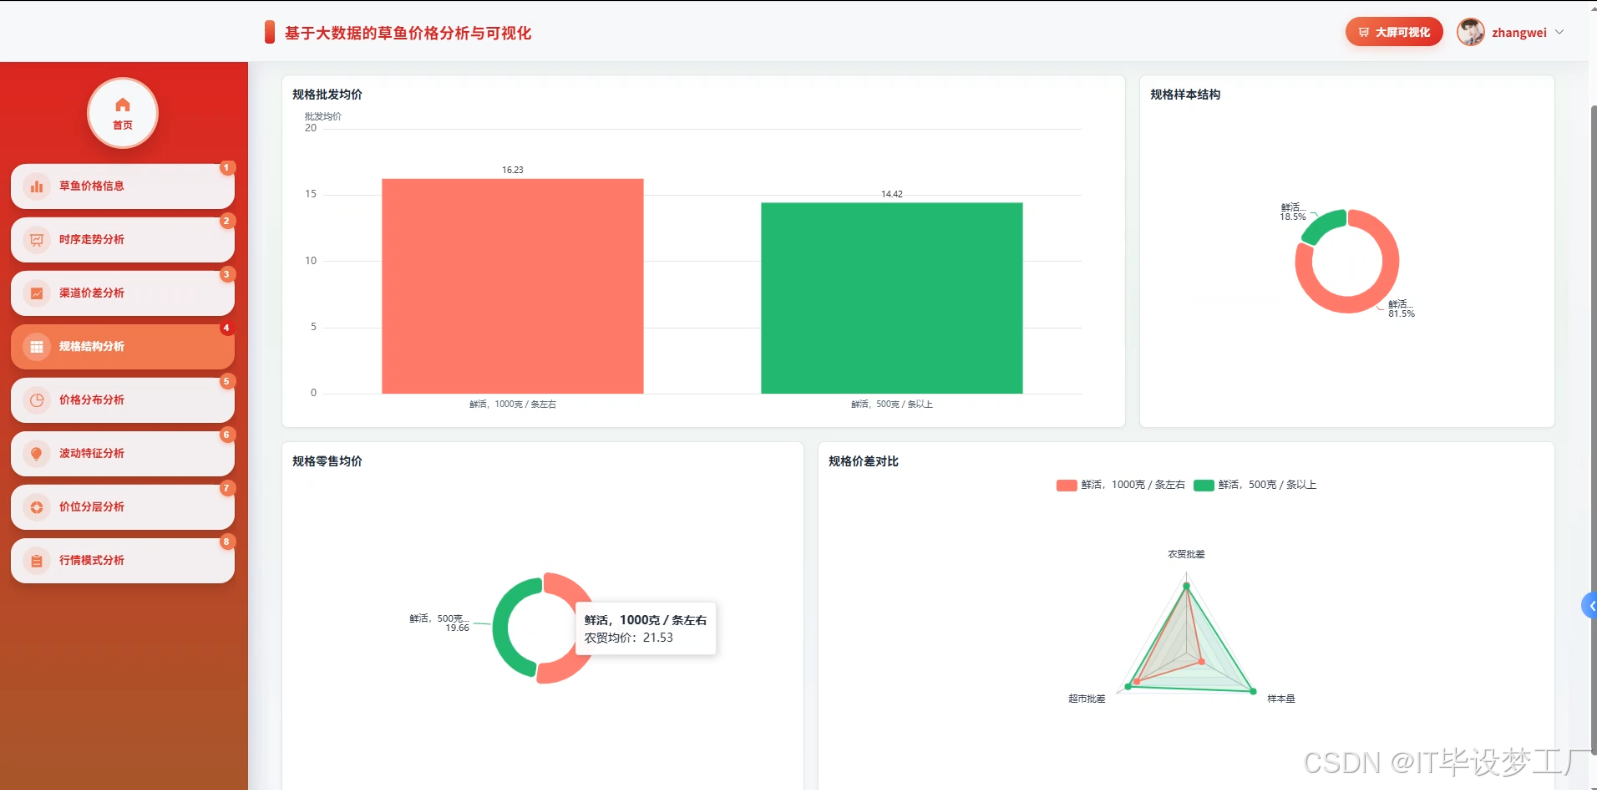
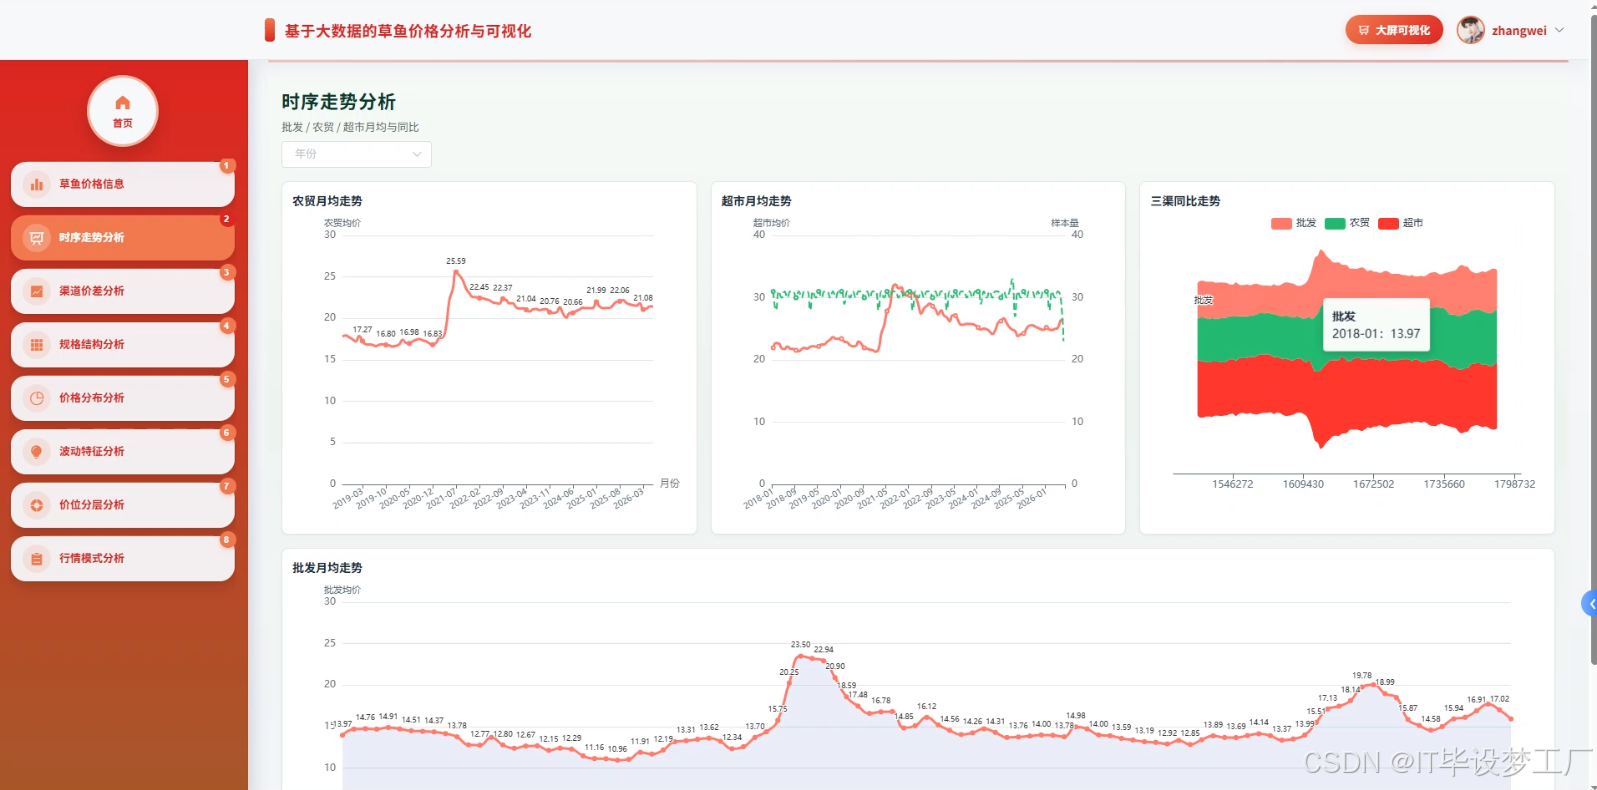
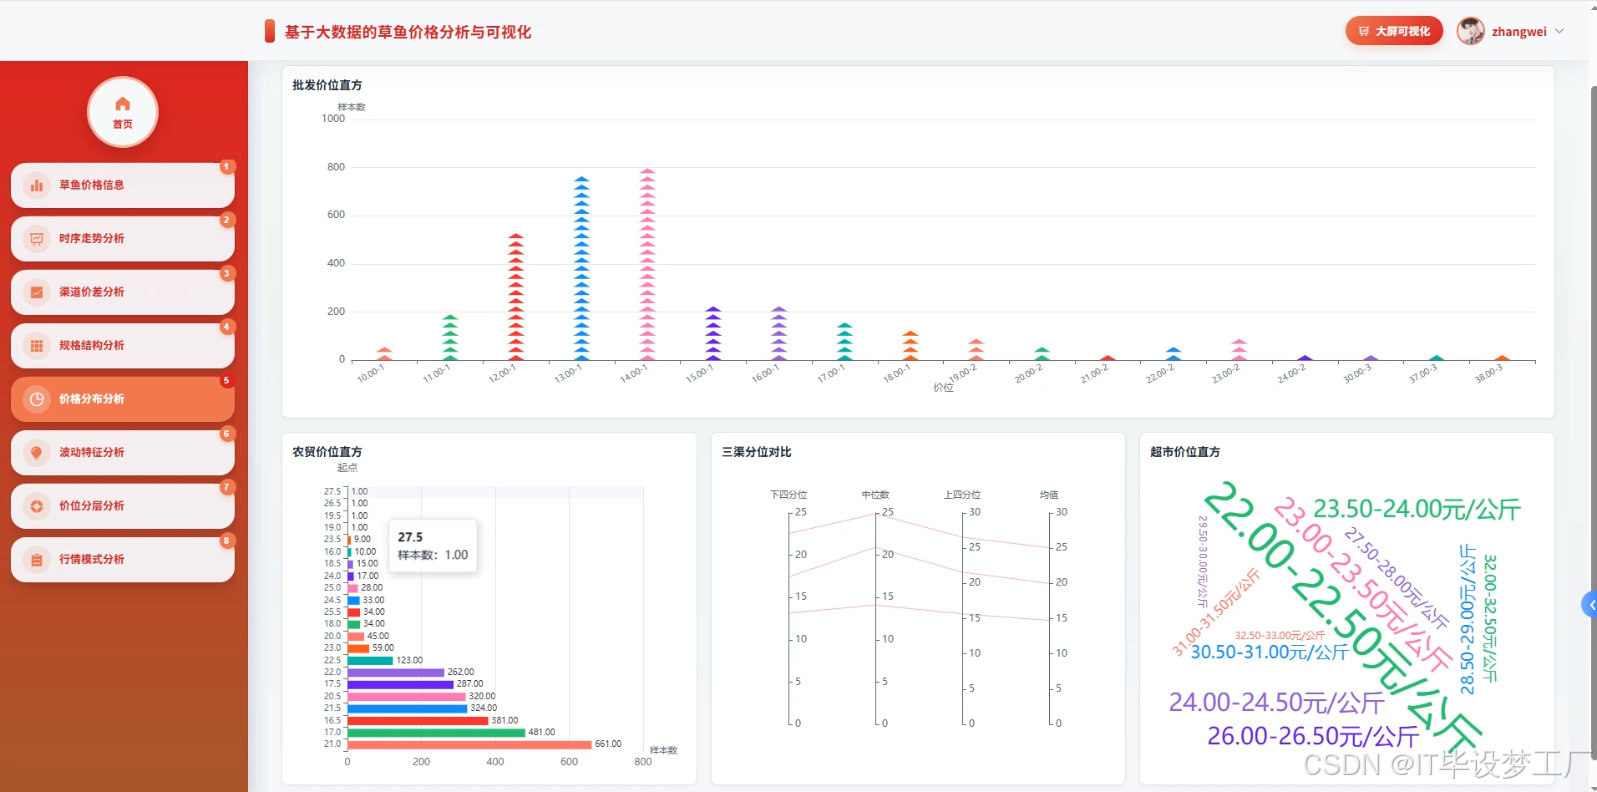
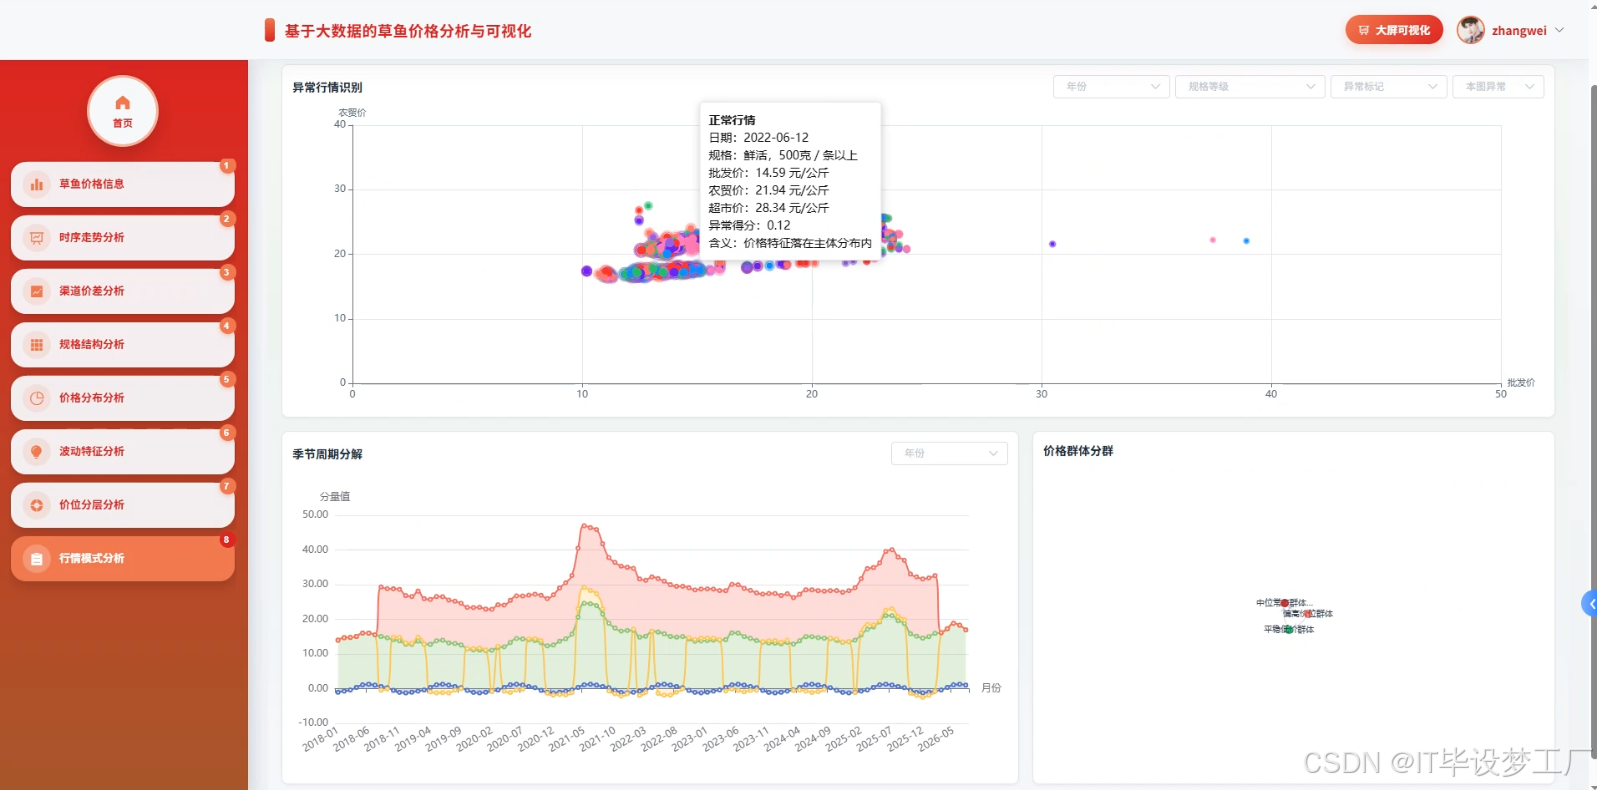
四、部分代码设计
- 项目实战-代码参考:
python
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, avg, max, min, stddev, count, sum, when, lag, round
from pyspark.sql.window import Window
from django.db.models import Q
from .models import GrassCarpPrice, UserInfo
from .serializers import GrassCarpPriceSerializer
import numpy as np
import pandas as pd

spark = SparkSession.builder.appName("GrassCarpPriceAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()

def time_series_trend_analysis(request):
    channel = request.GET.get("channel", "")
    start_date = request.GET.get("start_date", "")
    end_date = request.GET.get("end_date", "")
    queryset = GrassCarpPrice.objects.all()
    if channel:
        queryset = queryset.filter(channel=channel)
    if start_date and end_date:
        queryset = queryset.filter(price_date__range=[start_date, end_date])
    data_list = list(queryset.values("price_date", "price", "channel", "spec"))
    if not data_list:
        return {"code": 400, "msg": "暂无草鱼价格数据", "data": []}
    pdf = pd.DataFrame(data_list)
    pdf["price_date"] = pd.to_datetime(pdf["price_date"])
    sdf = spark.createDataFrame(pdf)
    sdf.createOrReplaceTempView("grass_carp_price")
    trend_df = spark.sql("SELECT price_date, ROUND(AVG(price), 2) AS avg_price, ROUND(MAX(price), 2) AS max_price, ROUND(MIN(price), 2) AS min_price, COUNT(1) AS record_count FROM grass_carp_price GROUP BY price_date ORDER BY price_date ASC")
    window_spec = Window.orderBy("price_date")
    trend_df = trend_df.withColumn("prev_avg", lag("avg_price", 1).over(window_spec))
    trend_df = trend_df.withColumn("change_rate", round((col("avg_price") - col("prev_avg")) / col("prev_avg") * 100, 2))
    trend_df = trend_df.withColumn("trend_flag", when(col("change_rate") > 3, "上涨").when(col("change_rate") < -3, "下跌").otherwise("平稳"))
    result = trend_df.collect()
    return {"code": 200, "msg": "时序走势分析完成", "data": [row.asDict() for row in result]}

def channel_price_gap_analysis(request):
    start_date = request.GET.get("start_date", "")
    end_date = request.GET.get("end_date", "")
    queryset = GrassCarpPrice.objects.all()
    if start_date and end_date:
        queryset = queryset.filter(price_date__range=[start_date, end_date])
    data_list = list(queryset.values("channel", "price", "price_date", "spec"))
    if not data_list:
        return {"code": 400, "msg": "暂无渠道价格数据", "data": []}
    pdf = pd.DataFrame(data_list)
    sdf = spark.createDataFrame(pdf)
    sdf.createOrReplaceTempView("channel_price")
    channel_df = spark.sql("SELECT channel, ROUND(AVG(price), 2) AS avg_price, ROUND(MAX(price), 2) AS max_price, ROUND(MIN(price), 2) AS min_price, ROUND(STDDEV(price), 2) AS std_price, COUNT(1) AS record_count FROM channel_price GROUP BY channel ORDER BY avg_price DESC")
    channel_df = channel_df.withColumn("price_range", round(col("max_price") - col("min_price"), 2))
    avg_price_all = channel_df.agg(avg("avg_price")).collect()[0][0]
    channel_df = channel_df.withColumn("gap_with_avg", round(col("avg_price") - avg_price_all, 2))
    channel_df = channel_df.withColumn("gap_level", when(col("gap_with_avg") > 1, "高于均价").when(col("gap_with_avg") < -1, "低于均价").otherwise("接近均价"))
    result = channel_df.collect()
    return {"code": 200, "msg": "渠道价差分析完成", "data": [row.asDict() for row in result]}

def price_volatility_analysis(request):
    spec = request.GET.get("spec", "")
    channel = request.GET.get("channel", "")
    queryset = GrassCarpPrice.objects.all()
    if spec:
        queryset = queryset.filter(spec=spec)
    if channel:
        queryset = queryset.filter(channel=channel)
    data_list = list(queryset.values("price_date", "price", "spec", "channel"))
    if not data_list:
        return {"code": 400, "msg": "暂无波动特征数据", "data": []}
    pdf = pd.DataFrame(data_list)
    pdf["price_date"] = pd.to_datetime(pdf["price_date"])
    sdf = spark.createDataFrame(pdf)
    sdf.createOrReplaceTempView("price_volatility")
    volatility_df = spark.sql("SELECT spec, channel, ROUND(AVG(price), 2) AS avg_price, ROUND(STDDEV(price), 2) AS std_price, ROUND((STDDEV(price) / AVG(price)) * 100, 2) AS cv_rate, COUNT(1) AS record_count FROM price_volatility GROUP BY spec, channel")
    volatility_df = volatility_df.withColumn("volatility_level", when(col("cv_rate") > 15, "高波动").when(col("cv_rate") > 8, "中等波动").otherwise("低波动"))
    volatility_df = volatility_df.withColumn("price_confidence", round(1 - (col("std_price") / col("avg_price")), 4))
    result = volatility_df.orderBy(col("cv_rate").desc()).collect()
    return {"code": 200, "msg": "波动特征分析完成", "data": [row.asDict() for row in result]}
五、论文参考
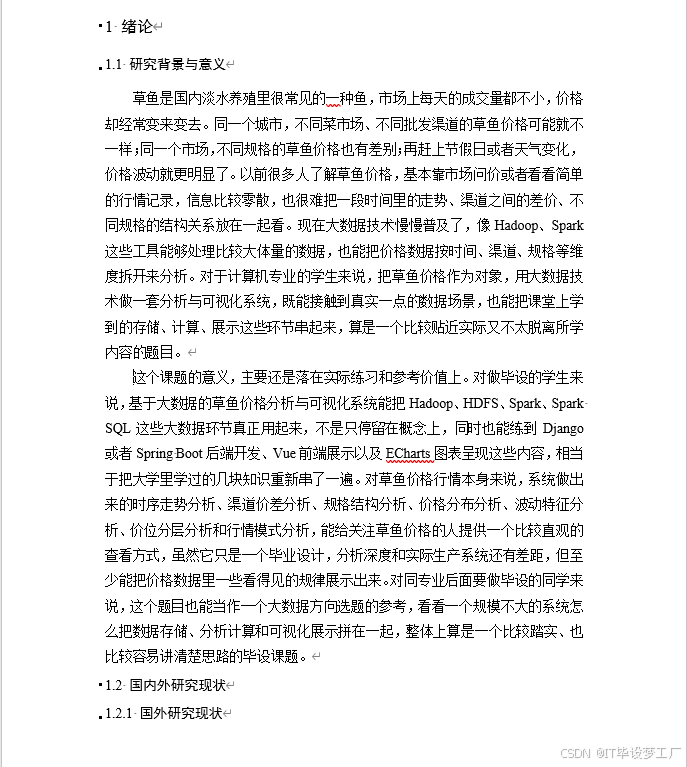
- 计算机毕业设计选题推荐-基于大数据的草鱼价格分析与可视化系统-论文参考:
六、系统视频
- 基于大数据的草鱼价格分析与可视化系统-项目视频:
项目演示视频
结语
计算机毕业设计选题推荐:基于大数据的草鱼价格分析与可视化|毕业设计选题|计算机毕设|选题推荐|毕设指导|项目定制|源码|高质量项目
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇