文章目录
-
- [1. 先说结论](#1. 先说结论)
- [2. 三个端点与取数代码](#2. 三个端点与取数代码)
- [3. 发现一:同一个门户,两个端点差 10.29 倍](#3. 发现一:同一个门户,两个端点差 10.29 倍)
- [4. 全量枚举的代价:约 14.7 分钟](#4. 全量枚举的代价:约 14.7 分钟)
- [5. 发现二:能回答「新不新」的字段,覆盖率是 0% 和 9.3%](#5. 发现二:能回答「新不新」的字段,覆盖率是 0% 和 9.3%)
- [6. 发现三:唯一 100% 覆盖的时间戳,测的是「门户重采」](#6. 发现三:唯一 100% 覆盖的时间戳,测的是「门户重采」)
- [7. 发现四:`datePublished` 不等于 `dateModified`](#7. 发现四:
datePublished不等于dateModified) - [8. 发现五:`update_frequency` 有 31 种写法](#8. 发现五:
update_frequency有 31 种写法) - [9. 发现六:零方差字段与三个口径陷阱](#9. 发现六:零方差字段与三个口径陷阱)
- [10. 踩坑清单与结论](#10. 踩坑清单与结论)
- [11. 参考链接](#11. 参考链接)
1. 先说结论
香港开放数据门户的目录层有一套 action API(CKAN 风格)。我用它把整个目录拉下来做了一次元数据审计,跑出三个数:
| 问题 | 数字 |
|---|---|
| 这个门户有多少个数据集? | 取决于你问哪个端点 :检索端点说 371 ,清单端点说 3,816 ,差 10.29 倍 |
| 有多少资源标了「最后修改时间」? | 4,100 个资源里 380 个 = 9.3% ;另一个同义字段 last_modified 是 0 个 |
| 唯一 100% 覆盖的时间戳是什么? | metadata_modified------但它记的是门户重新采集元数据的时刻,不是数据更新时间 |
一句话概括这次的发现:这份目录的元数据能回答「有什么」,基本不能回答「新不新」。
下面把三个端点、取数代码、六个发现,以及「哪些字段能用」的判据完整拆开。
2. 三个端点与取数代码
目录层只有三个入口需要记:
| action | 作用 | 返回 |
|---|---|---|
package_search |
关键词检索 | 命中数 + 数据集列表(rows 控制条数) |
package_list |
全量清单 | 只有名字的字符串数组 |
package_show |
单条详情 | 一个数据集的完整元数据 |
三个都走同一个入口,封装成一个函数就够:
python
import json, subprocess, urllib.parse

API = "https://data.gov.hk/en-data/api/3/action/"

def action(name, **params):
    """目录层 action API:search / list / show 都走这一个入口。"""
    url = API + name
    if params:
        url += "?" + urllib.parse.urlencode(params)
    raw = subprocess.run(["curl", "-sL", "-m", "60", url],
                         capture_output=True, text=True).stdout
    d = json.loads(raw.lstrip("\ufeff"))
    if not d.get("success"):
        raise RuntimeError(f"{name} success=false")
    return d["result"]

def search_index(rows=400):
    r = action("package_search", rows=rows)   # 一次取回索引里的全部
    return r["count"], r["results"]

def full_name_list():
    return action("package_list")             # 只有名字,一次取回

def show(name):
    return action("package_show", id=name)    # 按名字取完整元数据
这段取数代码可以直接拿去用,收藏备用 ------换成任何 CKAN 风格的开放数据门户,只要改 API 这一个常量。
环境:Python 3.13.12(macOS),仅标准库。
3. 发现一:同一个门户,两个端点差 10.29 倍
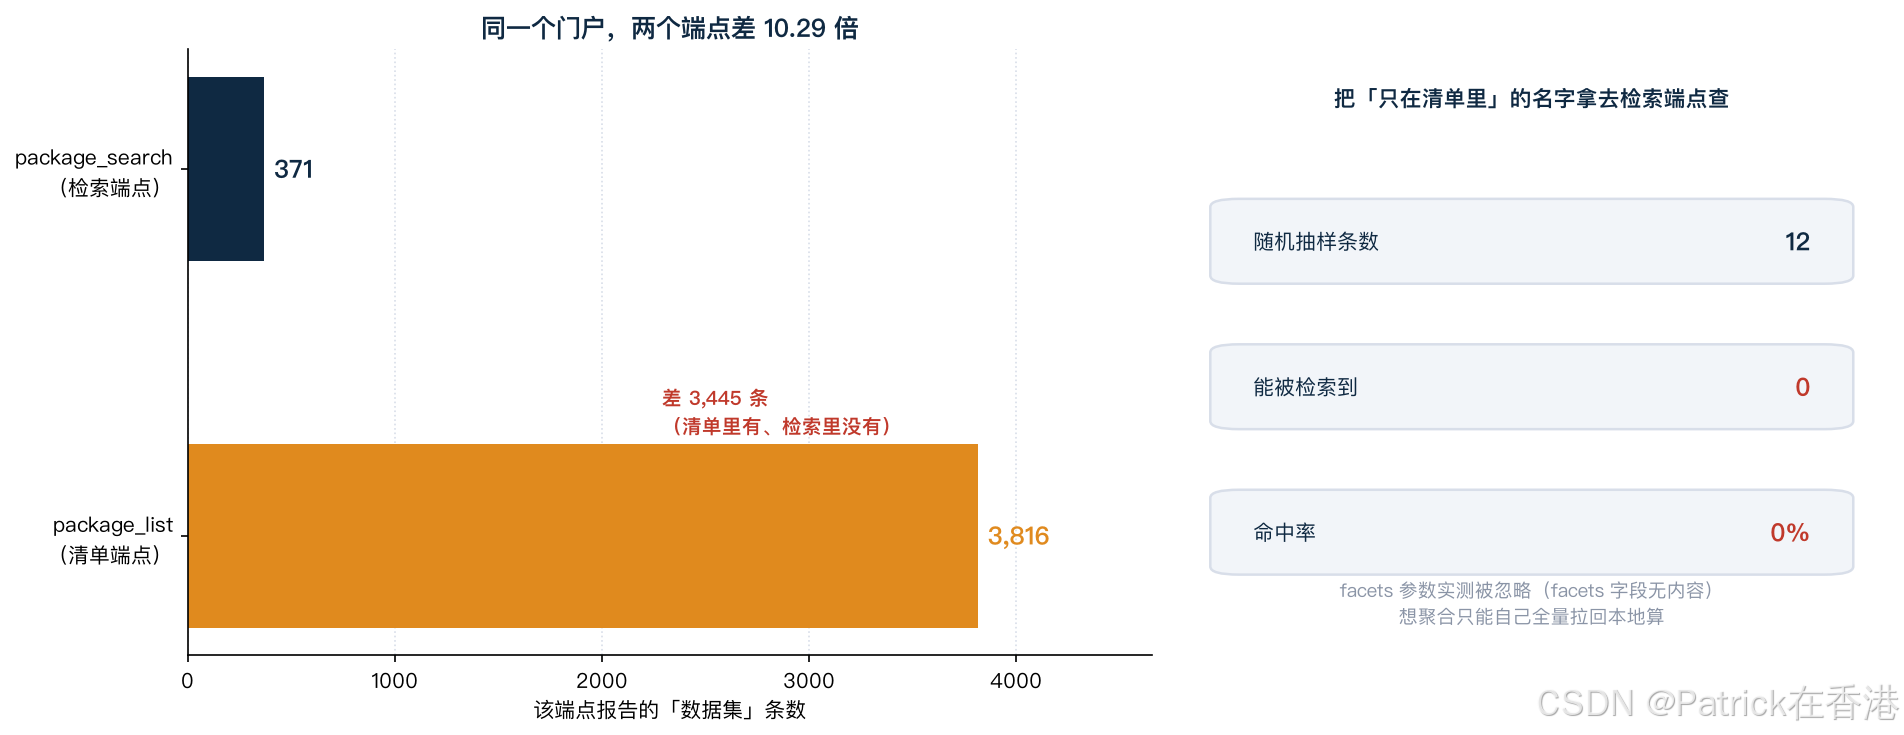
package_search  count = 371
package_list    条数 = 3,816
差             = 3,445 条
这个差还不算完。我从「只在清单里」的 3,445 条中随机抽 12 条,把名字拼成查询拿去检索端点------全部 0 命中 。也就是说这批数据集不是"排位靠后搜不到",而是根本不在索引里。
顺手排掉一个容易走岔的猜测:我原以为差异来自"政府部门 vs 私营机构"。抽样 24 条查发布机构------统计处 6 条、保险业监管局 4 条、金管局 3 条 ,其余也都是政府或公共机构。type / state / private 三个字段在两组之间也完全一致(都是 dataset / active / false)。所以差异不在某个可过滤的字段上,而在索引覆盖面:清单里有 3,816 条,能被检索到的只有 371 条。
实践含义 :要"全量枚举",只能用 package_list;要"按关键词找",只能用 package_search。两个端点不能互相替代,也不能用一个的 count 去代表数据集总数。
4. 全量枚举的代价:约 14.7 分钟
既然检索端点只覆盖 9.7%,要拿全量元数据就只能拿 3,816 个名字逐条 package_show。实测单次中位 0.231 秒 ,3,816 条估算 约 14.7 分钟------串行跑,且没算任何重试。
这个量级决定了必须抽样:371 条可检索的全部取回(一次请求),再从 3,445 条隐藏的里随机抽 60 条逐条取详情,两组对照。
抽样结果:60 条全部取回、共 242 个资源,dateModified 覆盖率 6/242 = 2.5% ------低于可检索组的 9.3%。隐藏那批的元数据质量更差。
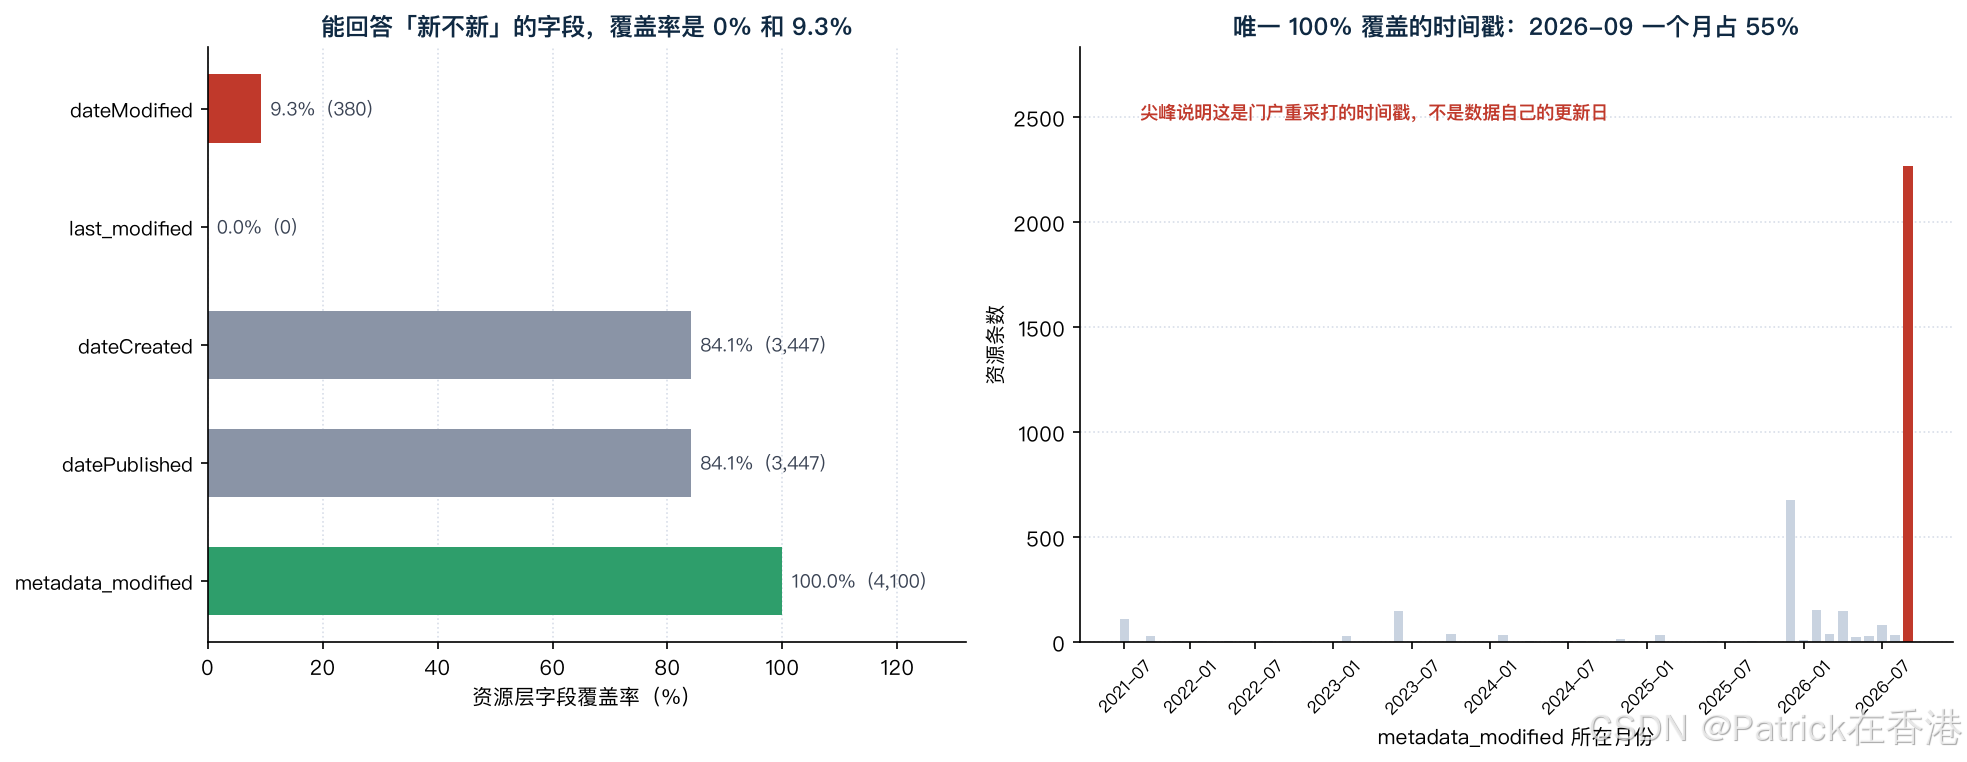
5. 发现二:能回答「新不新」的字段,覆盖率是 0% 和 9.3%
| 字段 | 有值 | 覆盖率 | 它到底表示什么 |
|---|---|---|---|
dateModified |
380 / 4,100 | 9.3% | 资源最后修改日(唯一像"新鲜度"的字段) |
last_modified |
0 / 4,100 | 0.0% | 字段存在,实测从未被填过 |
dateCreated |
3,447 / 4,100 | 84.1% | 资源创建日 |
datePublished |
3,447 / 4,100 | 84.1% | 资源发布日 |
metadata_modified |
4,100 / 4,100 | 100% | 元数据记录被改动的时刻 |
判断一个数据集"是不是很久没更新",逻辑上该看第一行。它只有 9.3% 的覆盖率,而唯一的同义替代字段覆盖率是 0%。
这就是这份目录最关键的短板:你想问的那个问题,正好落在覆盖率最低的那一列上。
6. 发现三:唯一 100% 覆盖的时间戳,测的是「门户重采」
metadata_modified 是唯一 100% 都有的时间戳,看起来是救星。但把它按月份铺开,形状不对:
2026-09   2,267 条   ← 占全部资源的 55.3%
2025-12     676 条
2026-02     152 条
一半以上的资源,其"元数据修改时间"集中在最近这一个月。 真实更新不可能在全港所有部门同步发生,这只能是门户批量重采时统一打的戳。
对照组也能佐证:数据集层的 metadata_modified 371 条全部落在 365 天以内。如果拿它当新鲜度指标,结论会是"这个门户非常活跃"------而这个结论与数据本身有没有更新无关。
一句话记法:metadata_modified 是"门户动过",不是"数据动过";尖峰就是批量重采的指纹。
7. 发现四:datePublished 不等于 dateModified
datePublished 有 84.1% 覆盖,那用它估算"最近一次发布"行不行?
实测对照 3,447 条同时有这两个字段的资源,1,657 条(48.1%)两者完全同值。而不同值的那些,差距大得不像"发布后发现要改一处":
dateCreated 2019-06-27 -> datePublished 2026-09-11 (format=JSON)一条 2019 年创建的资源,"发布日"是 2026 年 9 月------这更像门户重采时把戳一起刷了,而不是真的 2026 年才发布。用 datePublished 当"最后发布"会得到和 metadata_modified 类似的失真。
8. 发现五:update_frequency 有 31 种写法
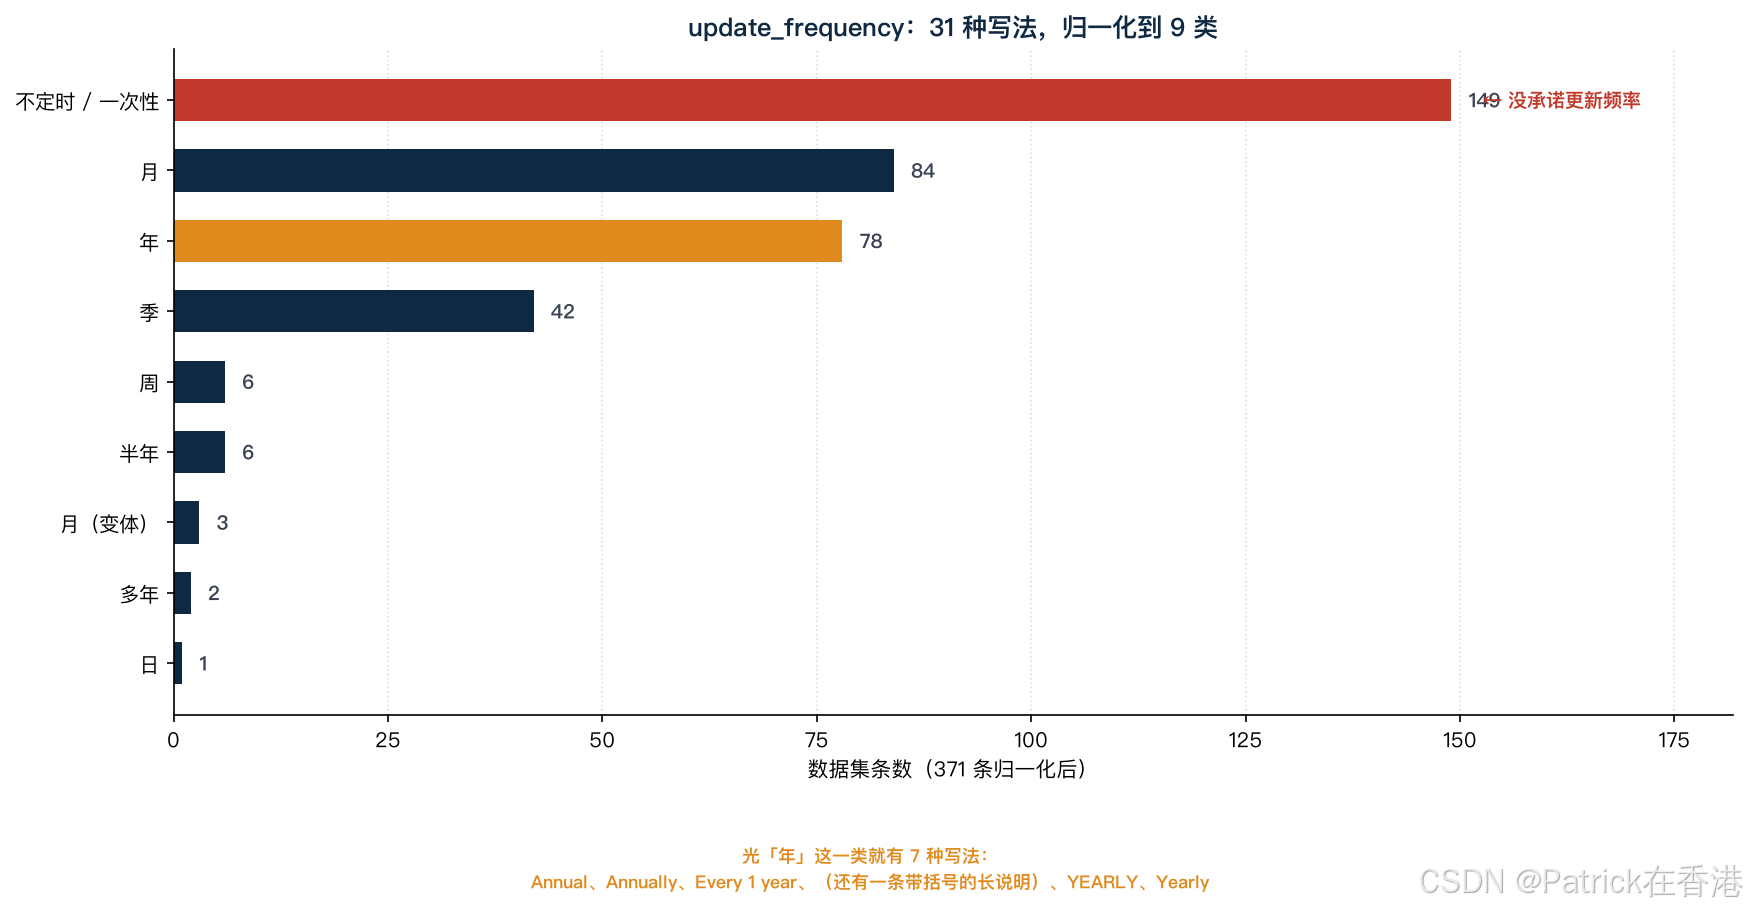
目录里有一列 update_frequency,是发布方自己声明的更新频率 ------有了它就能对照"承诺"与"实际"。但原始值有 31 种不同写法,同一含义散成多种拼法:
Annual / Annually / Every 1 year / Every year / YEARLY / Yearly
/ To be updated yearly along with the publication of the Beach Water Quality
  Annual Report (Usually in April)
光「年」这一档就有 7 种写法,最后一种还带着一句括号说明。不归一化,你连"有多少数据集承诺按年更新"都数不出来。
归一化需要一个映射函数:
python
def canon_freq(s):
    """把 update_frequency 的自由文本归一到有限类别。
    实测原始写法 31 种,同一含义散成多种拼法,不归一化就没法比较。
    """
    t = (s or "").strip().lower()
    if not t:
        return "未声明"
    if any(k in t for k in ("as and when", "when necessary", "when there",
                            "one-off", "new entries", "auction result")):
        return "不定时 / 一次性"
    if "48 hours" in t:
        return "日"
    if "week" in t or "friday" in t:
        return "周"
    if "twice a month" in t or "mid of month" in t or "first day of month" in t:
        return "月(变体)"
    if "month" in t:
        return "月"
    if "quarter" in t:
        return "季"
    if "half" in t:
        return "半年"
    if "biennial" in t or "triennial" in t:
        return "多年"
    if any(k in t for k in ("annual", "yearly", "every 1 year", "every year")):
        return "年"
    return "其他"
归一化后是 9 类,分布本身就说明问题:149 / 371 = 40.2% 的数据集根本没承诺更新频率 ("As and when needed" 这类),承诺按月的 84 条、按年的 78 条、按季的 42 条,而承诺按天更新的只有 1 条。
这个映射函数建议收藏,任何带自由文本字段的目录都能套这个思路:先数一遍不同写法,再定归一化规则。
9. 发现六:零方差字段与三个口径陷阱
最后一组是元数据本身的毛病,攒在一起说更清楚。
① 字段存在,但全表只有一种值。 数据集层的 isopen,371 条全部 是 false------只有一个取值。这种"零方差字段"对筛选和聚合都没有区分度,但结构上看起来很正常,容易被当成可用维度。
字段覆盖率审计里我把这种情况单独标出来:
python
TIME_FIELDS = ["dateModified", "last_modified", "dateCreated", "datePublished"]

def field_coverage(resources):
    """逐字段统计覆盖率。零方差字段单独标出------字段存在不等于有信息。"""
    n = len(resources) or 1
    out = {}
    for f in TIME_FIELDS + ["metadata_modified", "is_api", "format"]:
        have = [r.get(f) for r in resources if r.get(f) not in (None, "", [])]
        vals = set(have)
        out[f] = {"have": len(have), "pct": round(len(have) / n * 100, 1),
                  "distinct": len(vals),
                  "zero_variance": len(vals) == 1 and bool(vals)}
    return out
② 同一个问题,两个字段给出差 10 倍的答案。 资源层里有 is_api(标记 Y/N)和 format(格式名)。数"有多少资源提供 API":
is_api == "Y"        ->  479
format   == "API"    ->   48
差 10 倍。抽查 431 条 "标了 Y 但格式不是 API" 的记录,它们的 format 都是 JSON。所以**"提供 API"这个统计量取哪个口径必须先讲清楚**,否则两个人都没错,数字却对不上。
③ 想要分面聚合,得自己算。 我试了 facet.field 参数,返回体里的 facets 是空的------参数被忽略了。所以"各部门各有多少数据集"这种统计,只能把 371 条全量拉回本地聚合。
顺带把本地聚合的结果记一下:283 / 371 = 76.3% 的数据集来自统计处 ;发布机构一共 33 个,其中 13 个机构只有 1 个数据集 。格式分布上 CSV 2,494 条、XLSX 562 条、JSON 526 条、XLS 323 条、XML 127 条、API 48 条------表格类(CSV/XLS/XLSX)合计 3,379 条,占 82.4%。
10. 踩坑清单与结论
| 坑 | 现象 | 处理 |
|---|---|---|
用检索端点的 count 当总数 |
说 371,实际清单里 3,816 条 | 总数用 package_list;检索只用 package_search |
| 以为搜不到是"排位靠后" | 随机 12 条隐藏数据集 0 命中 | 先做一次召回抽检,确认索引覆盖面 |
拿 metadata_modified 判断新鲜度 |
55.3% 资源戳在最近一个月 | 它是门户重采时间;只在同批资源之间比相对先后 |
拿 datePublished 当"最后发布" |
48.1% 与 dateCreated 同值,跨期异常 |
只在明确语义后使用;默认不当新鲜度指标 |
直接用 update_frequency 分组 |
31 种写法把统计切碎 | 先归一化,再聚合 |
拿 is_api 数"有多少 API" |
479 vs format=API 的 48 |
先定口径并写明,再引用数字 |
| 把零方差字段当维度 | isopen 全为 false |
覆盖率审计里加 distinct 检查 |
值得记住的三条:
- 元数据审计的第一步不是算统计,是数覆盖率。 一个字段有没有值、有几个不同取值,比它的分布更重要------本次三个最关键的坑(
dateModified只有 9.3%、last_modified为 0、isopen零方差)全都是覆盖率问题,不是统计问题。 - 同一个门户的不同端点可以有完全不同的覆盖面。 371 与 3,816 都在同一个域名下,都返回
success: true------没有任何一个会告诉你"我这里只覆盖了一部分"。跨端点核对是唯一办法。 - "什么时候动的"要区分记录主体:元数据动过、数据动过是两件事。判据是看时间分布有没有尖峰------有尖峰说明它记的是批量作业。
可复用的三块:三端点封装 action() 、自由文本归一化 canon_freq() 、覆盖率与零方差审计 field_coverage() 。如果这篇对你有用,收藏 + 点赞------下次接手任何开放数据门户或自建目录,按这三块先体检一遍。
这类香港开放数据的实测会继续更新,关注不迷路。
11. 参考链接
- https://data.gov.hk/en-data/api/3/action/help_show?name=package_search
- https://data.gov.hk/en-data/api/3/action/help_show?name=package_show
- https://data.gov.hk/
原创声明:本文为原创技术实践。目录数据采集于 2026-09-13,来自 data.gov.hk 目录层公开接口;可检索组为全量 371 条,隐藏组为随机抽样 60 条(随机种子 23)。文中所有比例均基于该次采集快照,接口行为与目录内容可能随官方调整而变化,请以自测数据为准。