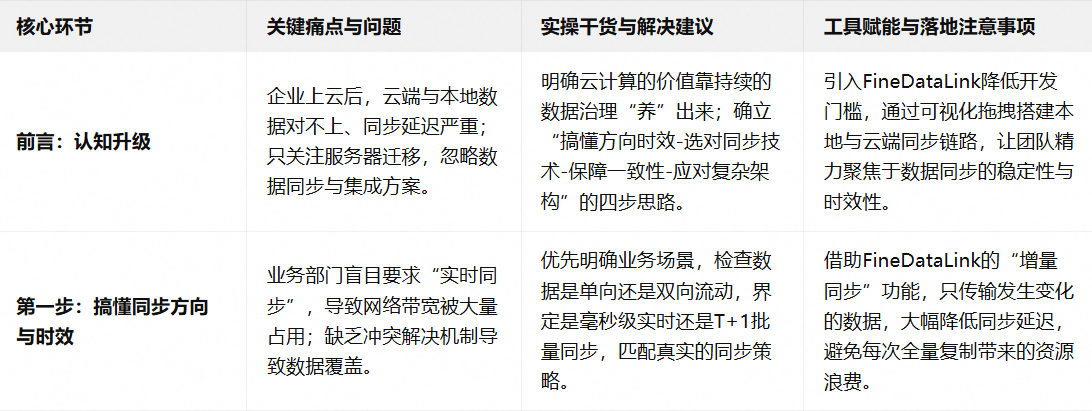
做过企业IT架构或者数据治理的朋友,肯定对这种场景不陌生:公司决定上云计算 ,把核心业务系统搬到了公有云,但财务系统、人事系统还在本地机房。结果到了月底要出合并报表的时候,发现云计算 上的数据和本地的数据根本对不上,或者同步延迟严重,业务部门拿着滞后的数据来抱怨。听着是不是很熟?你懂我意思吗?其实,这真不是谁在故意刁难谁,而是很多企业在拥抱云计算时,只关注了"把服务器搬上去",却忽略了最核心的"云计算环境数据怎么同步"和"云计算集成方案怎么选"。
说白了,云计算 环境建好了,只是万里长征走完了第一步。如果缺乏配套的云计算 数据集成与同步体系,云计算 就会变成一个"数据孤岛",上面的应用跑得快,但底下的数据跟不上,最终导致业务决策滞后。用过来人的经验告诉你,云计算 环境的价值,不是靠买几台云服务器就能释放的,而是靠持续的云计算数据治理、同步和协同,一步步"养"出来的。
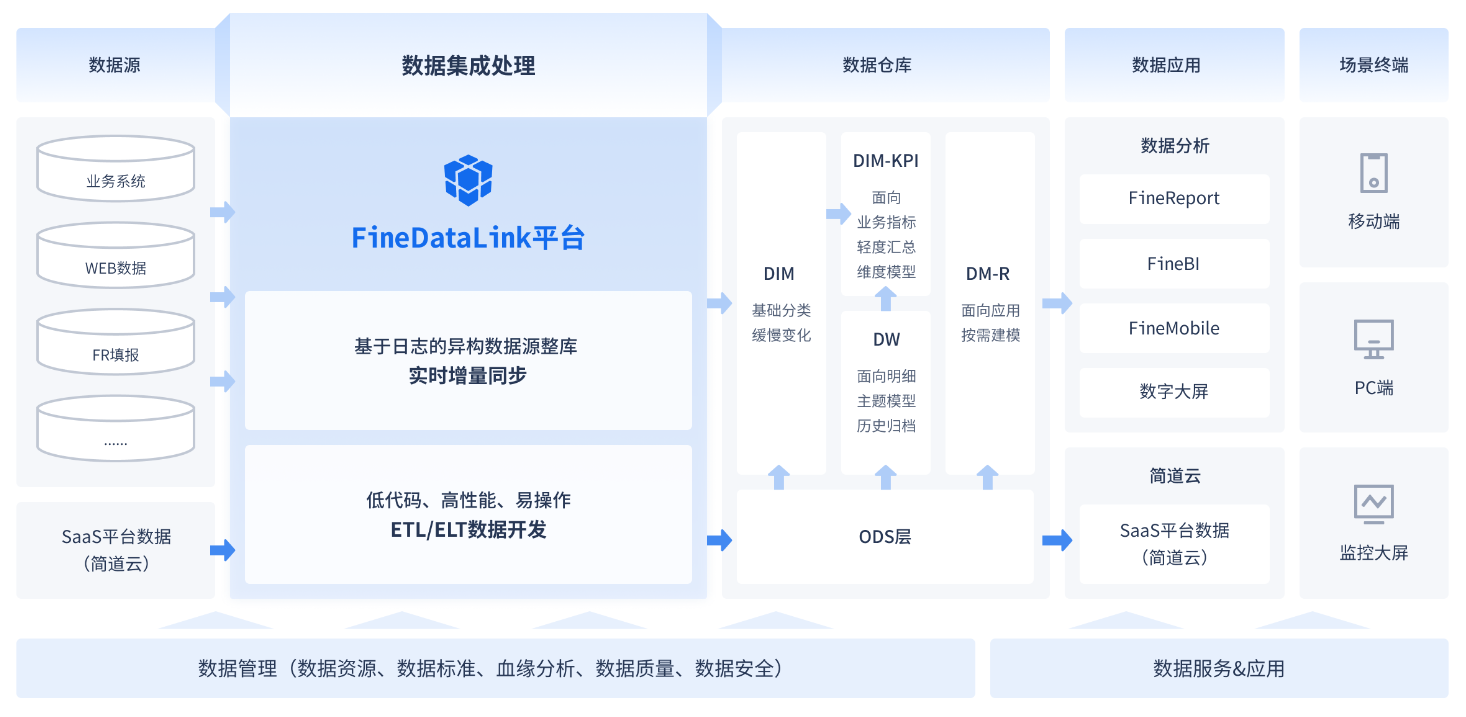
我刚开始负责企业上云计算 项目的时候,也踩过不少坑。总觉得把数据库迁移到云计算上,数据自然就通了。后来慢慢发现,选对工具真的能少走很多弯路。比如FineDataLink这样的数据集成平台,最大的好处就是不需要复杂的底层代码开发,IT人员通过可视化拖拽就能搭建起本地机房与云计算 数据库之间的数据同步链路。这种低门槛、高效率的设计,让数据团队能把精力从繁琐的接口对接中解放出来,真正聚焦于云计算数据同步的稳定性与时效性,而不是天天写代码调接口。
有了这个认知,我们再来看看,云计算环境的数据到底该怎么同步,集成方案又有哪些。
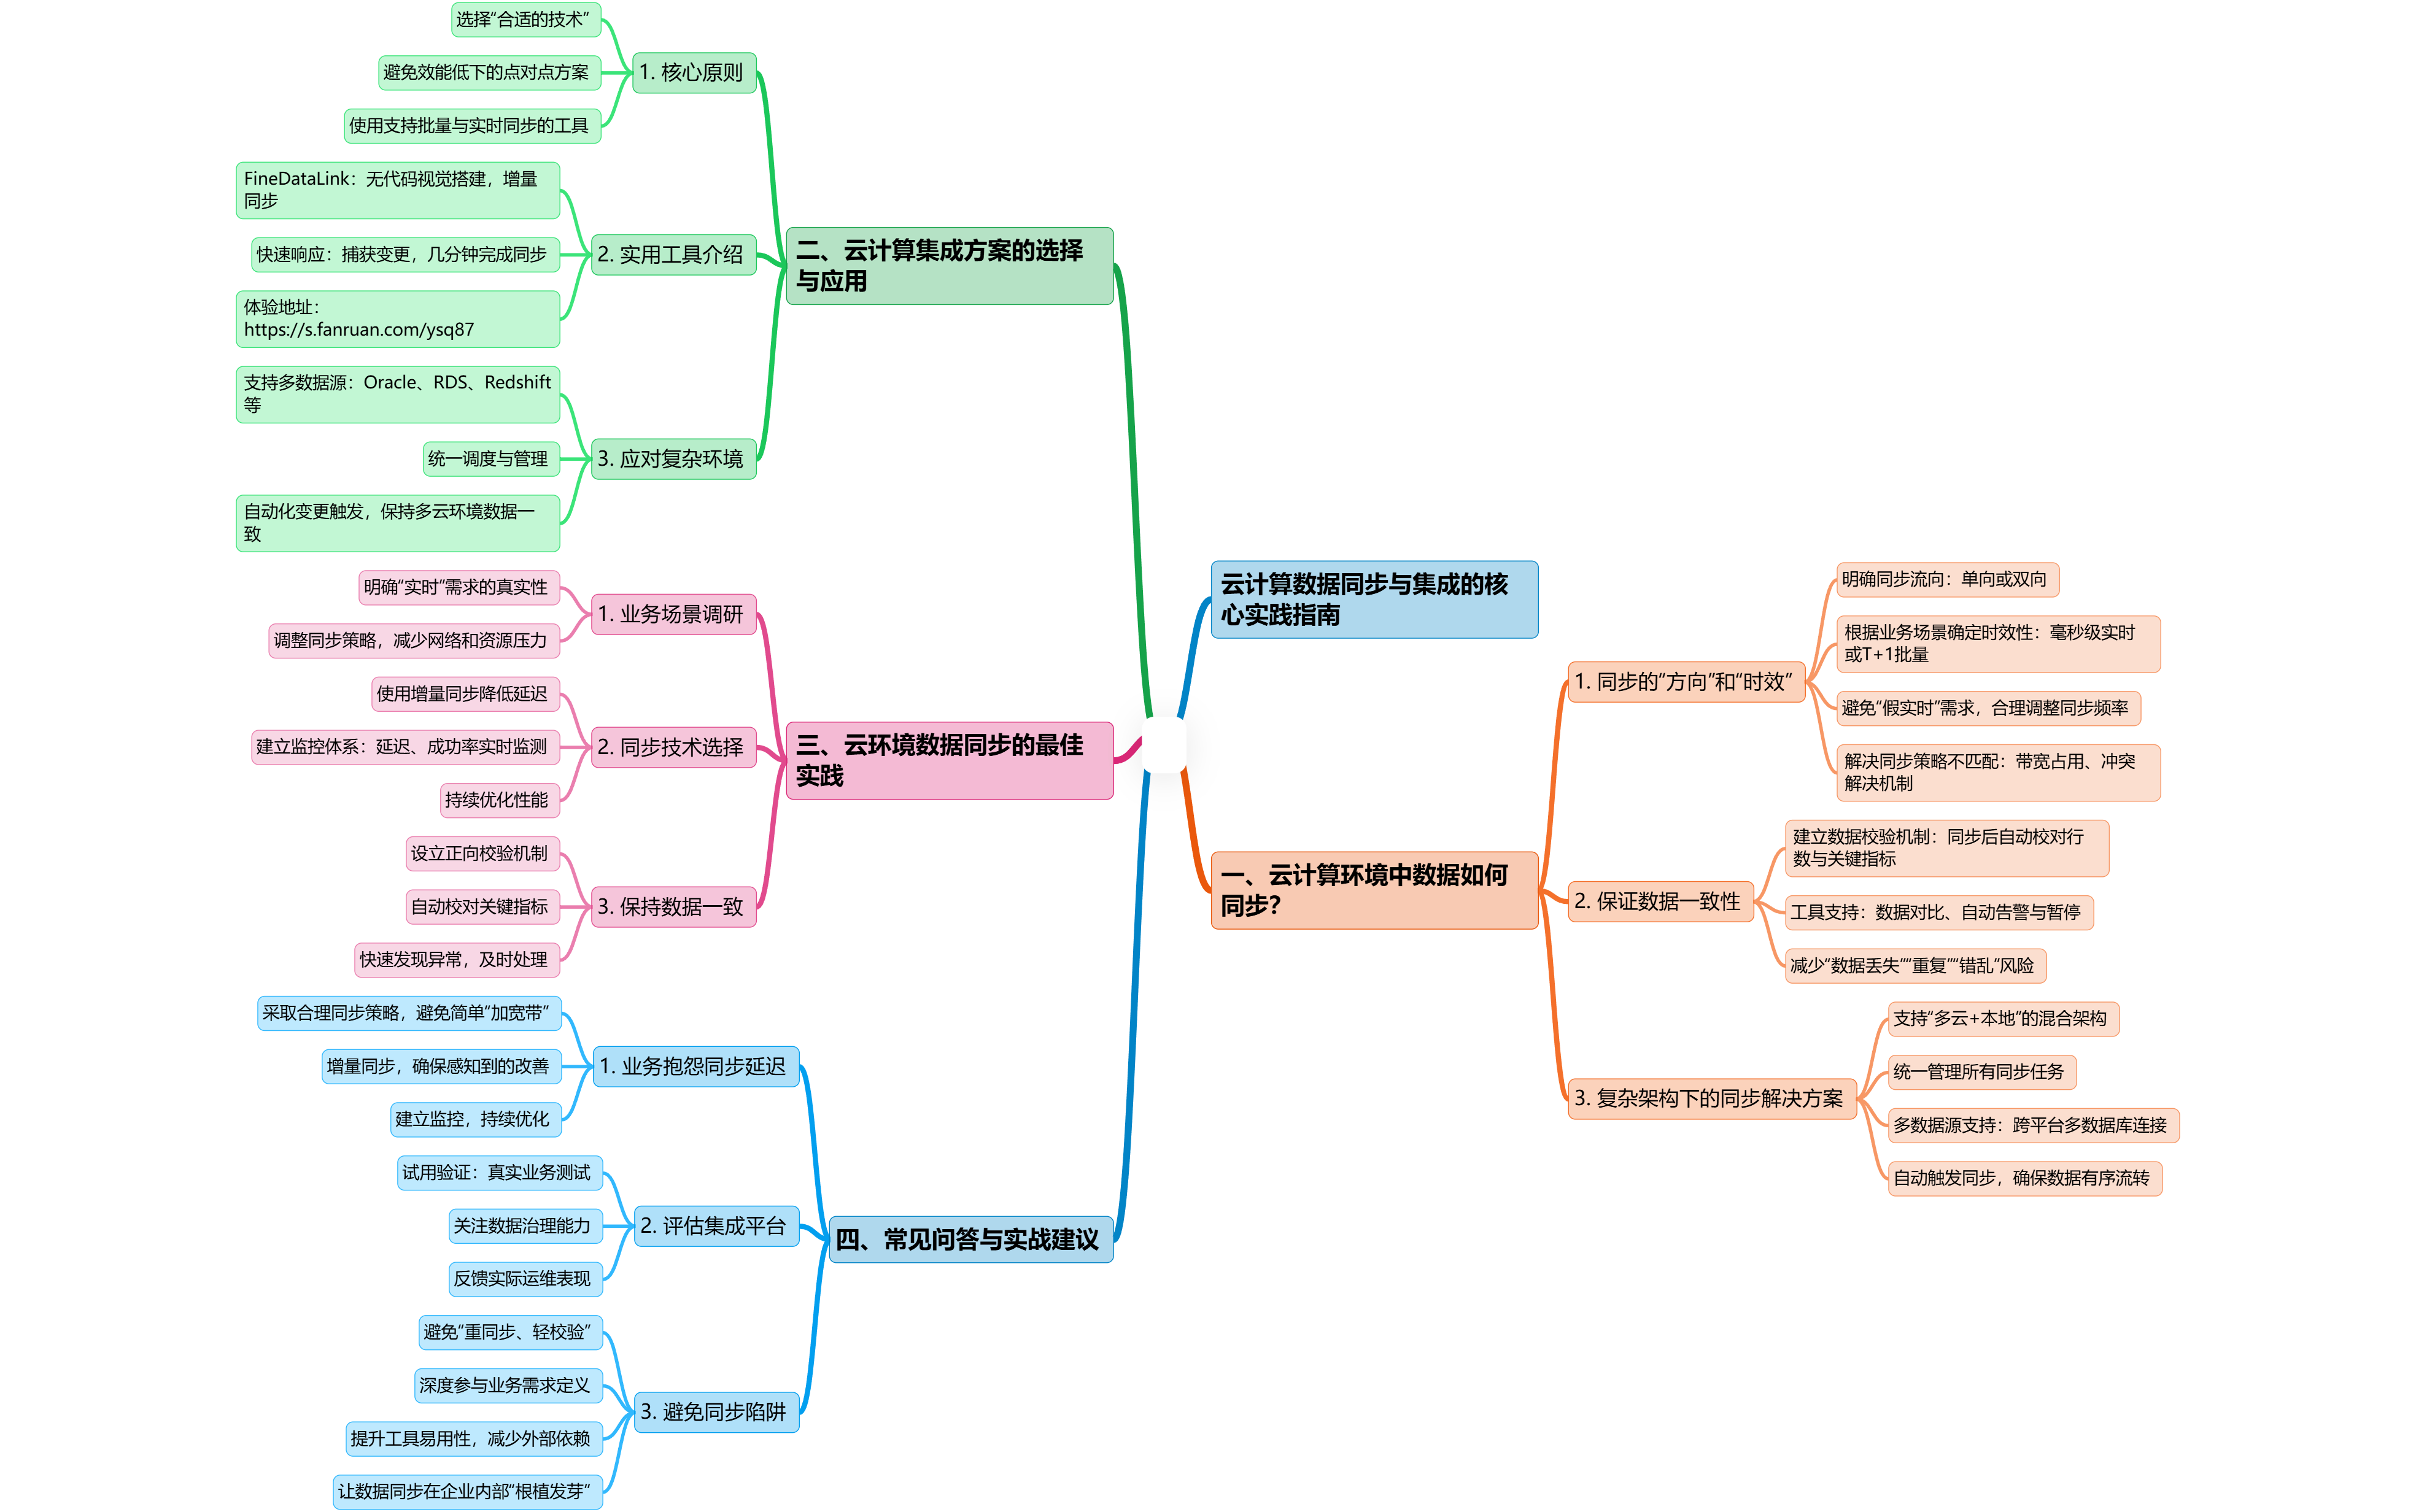
一、云计算环境数据怎么同步?先搞懂同步的"方向"和"时效"
我一直强调,云计算环境数据同步的第一步,是确认"同步的方向"和"时效"。很多时候,业务部门要求的"实时同步",其实是"假实时"。
简单来说,就是要先明确业务场景。你需要检查数据是单向流动还是双向流动,是要求毫秒级实时还是T+1的批量同步。比如,你会发现某个关键报表只需要每天凌晨更新一次,但业务部门却要求实时同步,导致网络带宽被大量占用。或者,业务部门需要在云端和本地同时修改同一张表的数据,但缺乏冲突解决机制,导致数据覆盖。这种"同步策略不匹配"的问题,就是排查要解决的核心。只有把同步策略理顺了,云计算环境的数据才能真正流动起来。
二、云计算集成方案有哪些?如何选择合适的同步技术?
用过来人的经验告诉你,如果确认了同步需求,云计算集成方案的核心,就是"选择合适的技术"。如果缺乏合适的技术,数据同步就像"小马拉大车",效率极低。
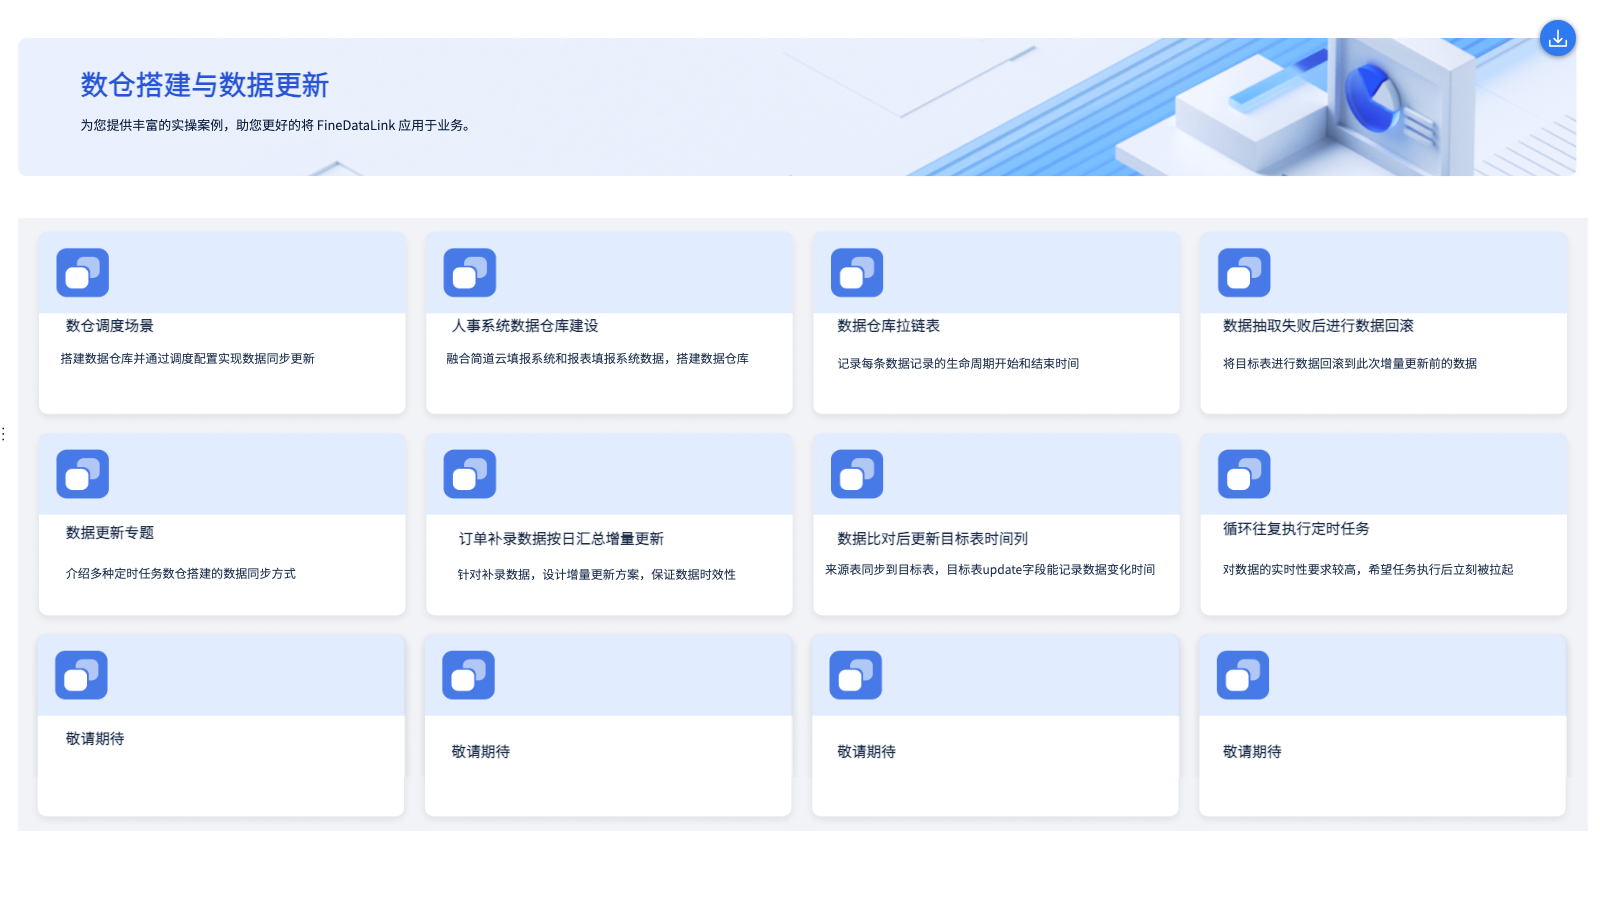
简单来说,集成方案主要分为批量同步和实时同步。批量同步适合数据量大、时效性要求不高的场景,比如每天凌晨把本地ERP的订单数据同步到云端数据仓库。实时同步则适合时效性要求高的场景,比如用户注册后,需要立刻在云端的风控系统中看到。我一直强调,工具选对了,同步效率能翻倍。比如FineDataLink的"增量同步"功能,只传输发生变化的数据,而不是每次都全量复制。当本地数据库新增了一条记录,FineDataLink会立刻捕获这个变更并推送到云端,几分钟就能完成同步,再也不用每次都把几千万条数据重新传一遍了。
三、云计算环境数据怎么同步?如何保障跨云环境的数据一致性?
我一直强调,云计算环境数据同步,不是把数据传过去就完事了,而是需要保障"数据一致性"。如果缺乏一致性保障,同步就会出现"数据丢失""数据重复""数据错乱"等问题。
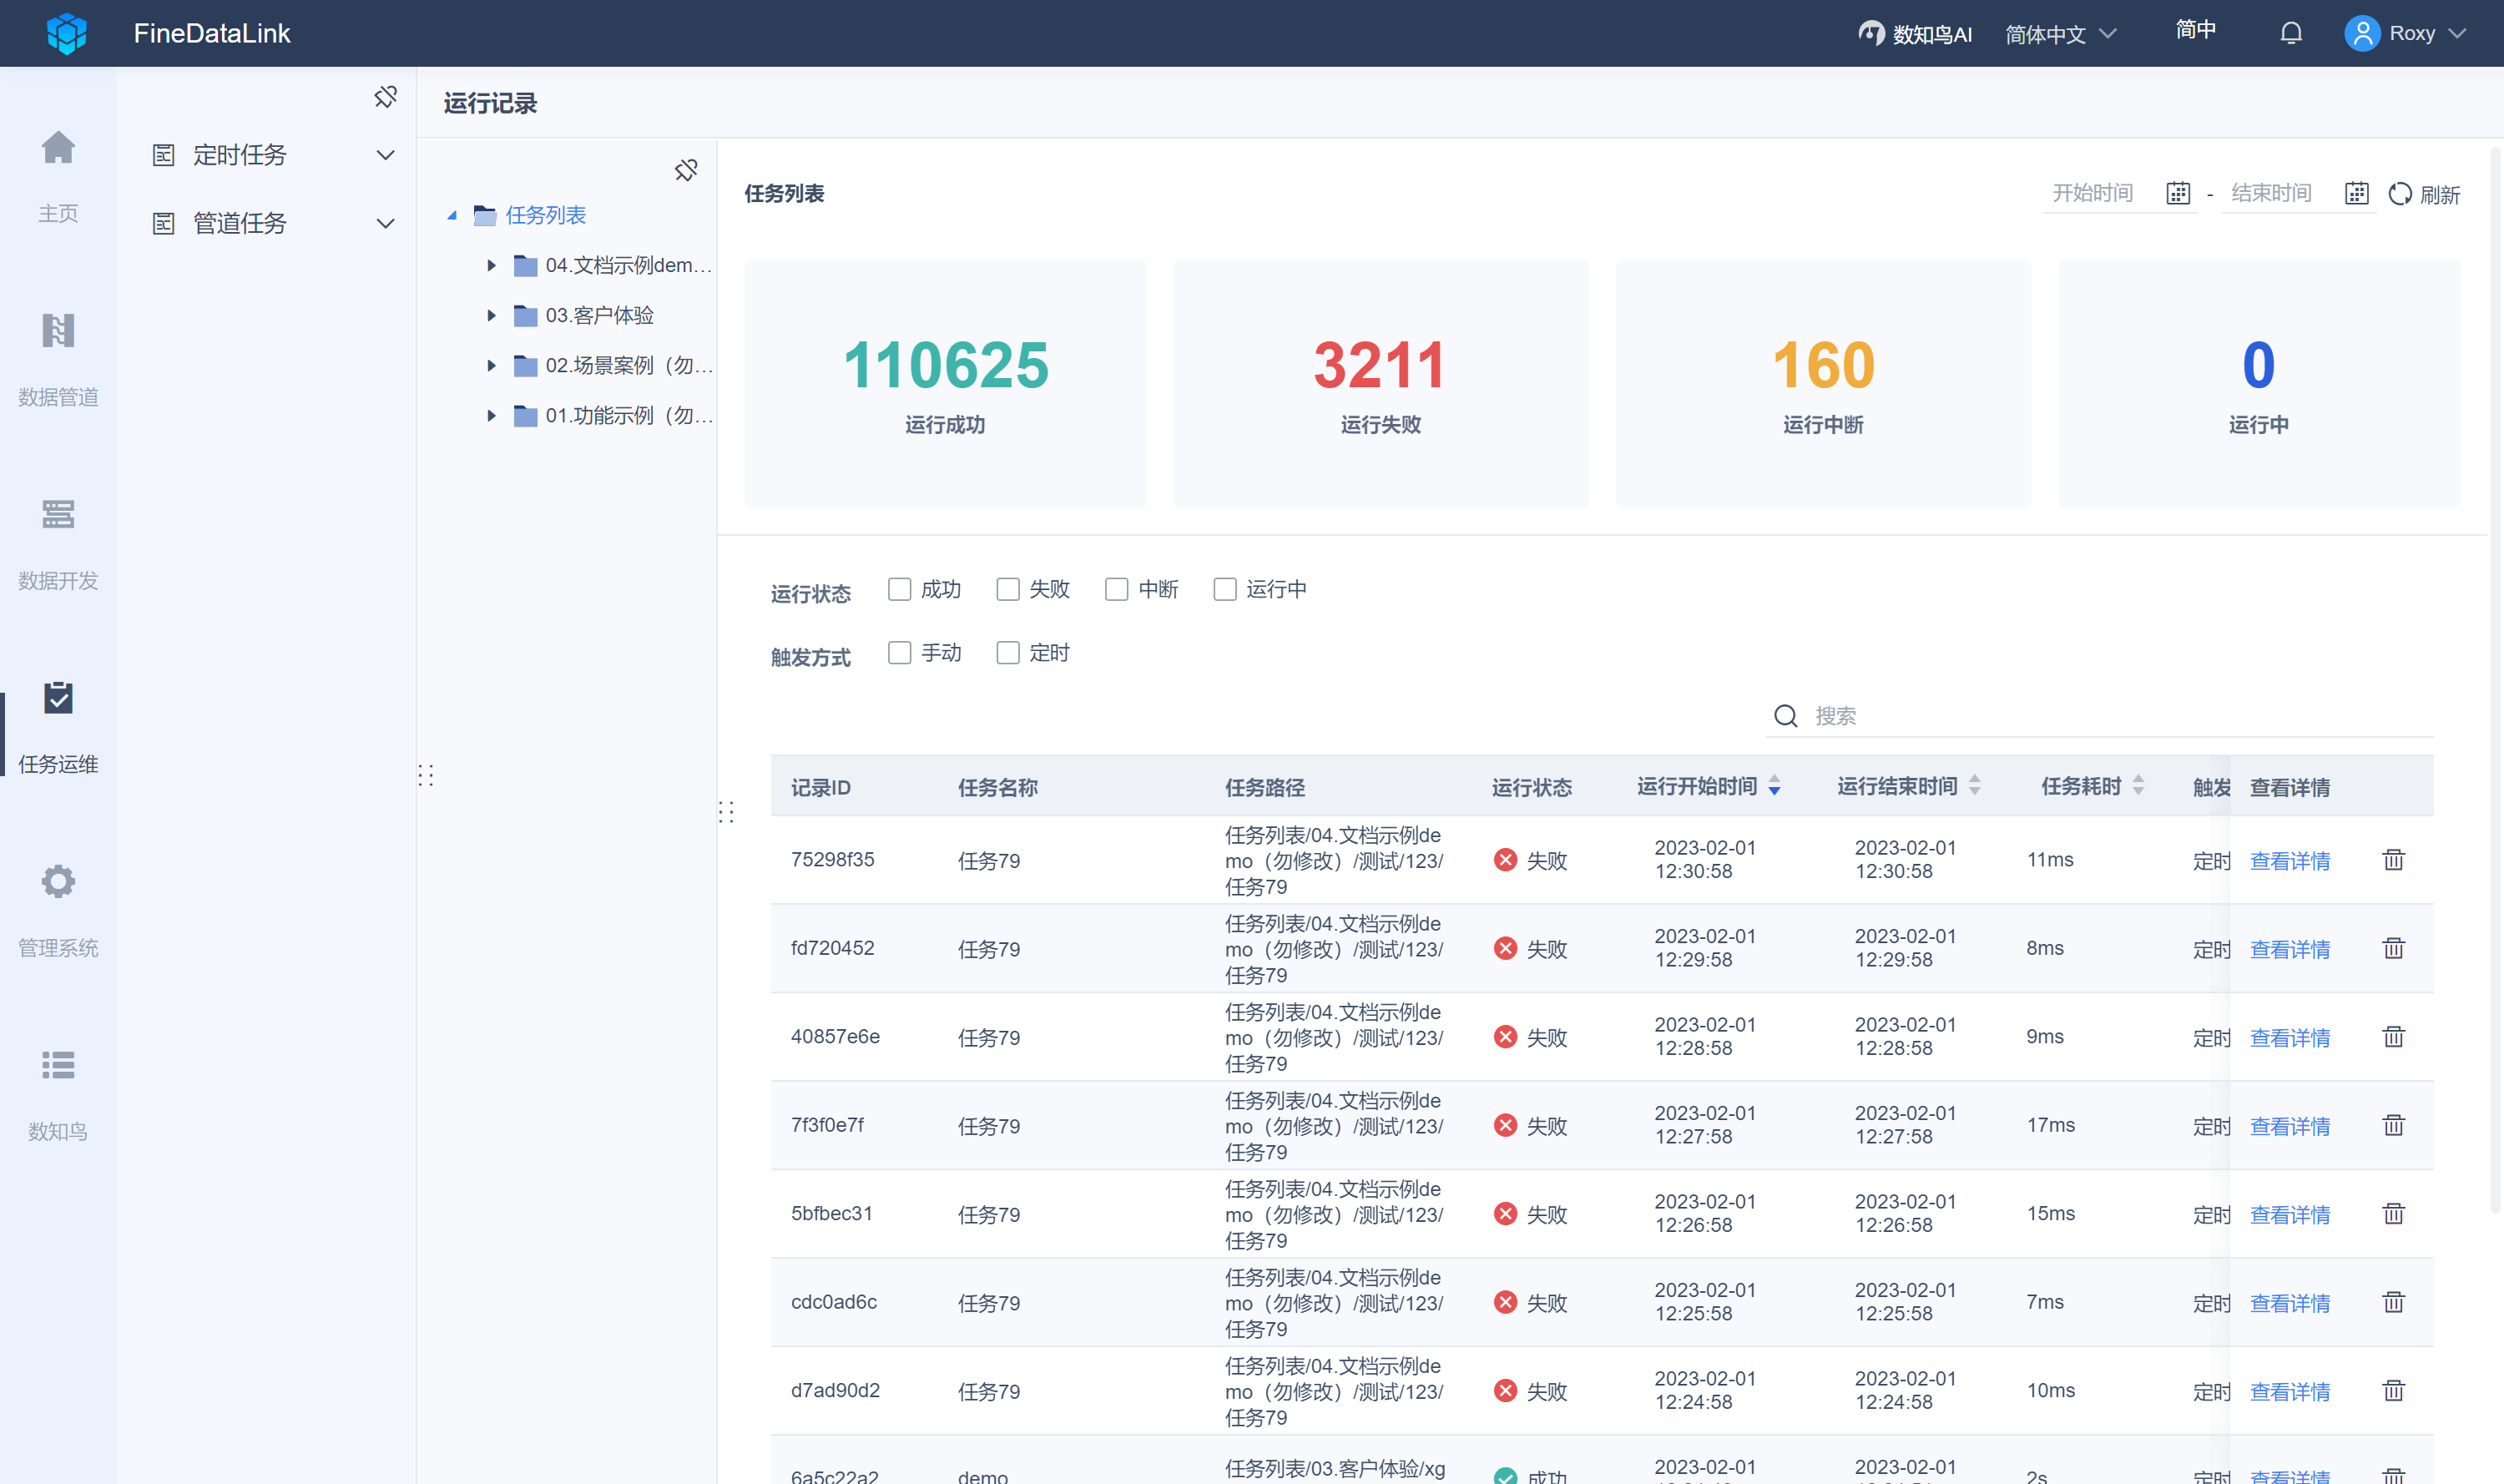
简单来说,就是要建立数据校验机制。你需要在同步完成后,自动对比源端和目标端的数据行数、金额汇总等关键指标。比如,你会发现本地数据库有1000条订单,但云端只有998条,说明有2条数据在同步过程中丢失了。这种"数据校验"的能力,就是保障一致性的核心。用过来人的经验告诉你,一致性保障要落地,离不开工具的支撑。比如数据对比功能,可以在同步任务结束后自动执行数据校验,如果发现数据不一致,会立刻告警并暂停任务,防止错误数据继续扩散。这样一来,业务部门在云端看到的数据,永远是和源端保持一致的,从源头上减少了因为"数据不准"导致的业务风险。
四、云计算集成方案有哪些?如何应对复杂的混合云架构?
我一直强调,云计算集成方案的价值,不仅体现在"同步数据",更体现在"应对复杂架构"。如果集成方案只能处理简单的点对点同步,而不能应对混合云、多云的复杂场景,那它的价值就大打折扣。
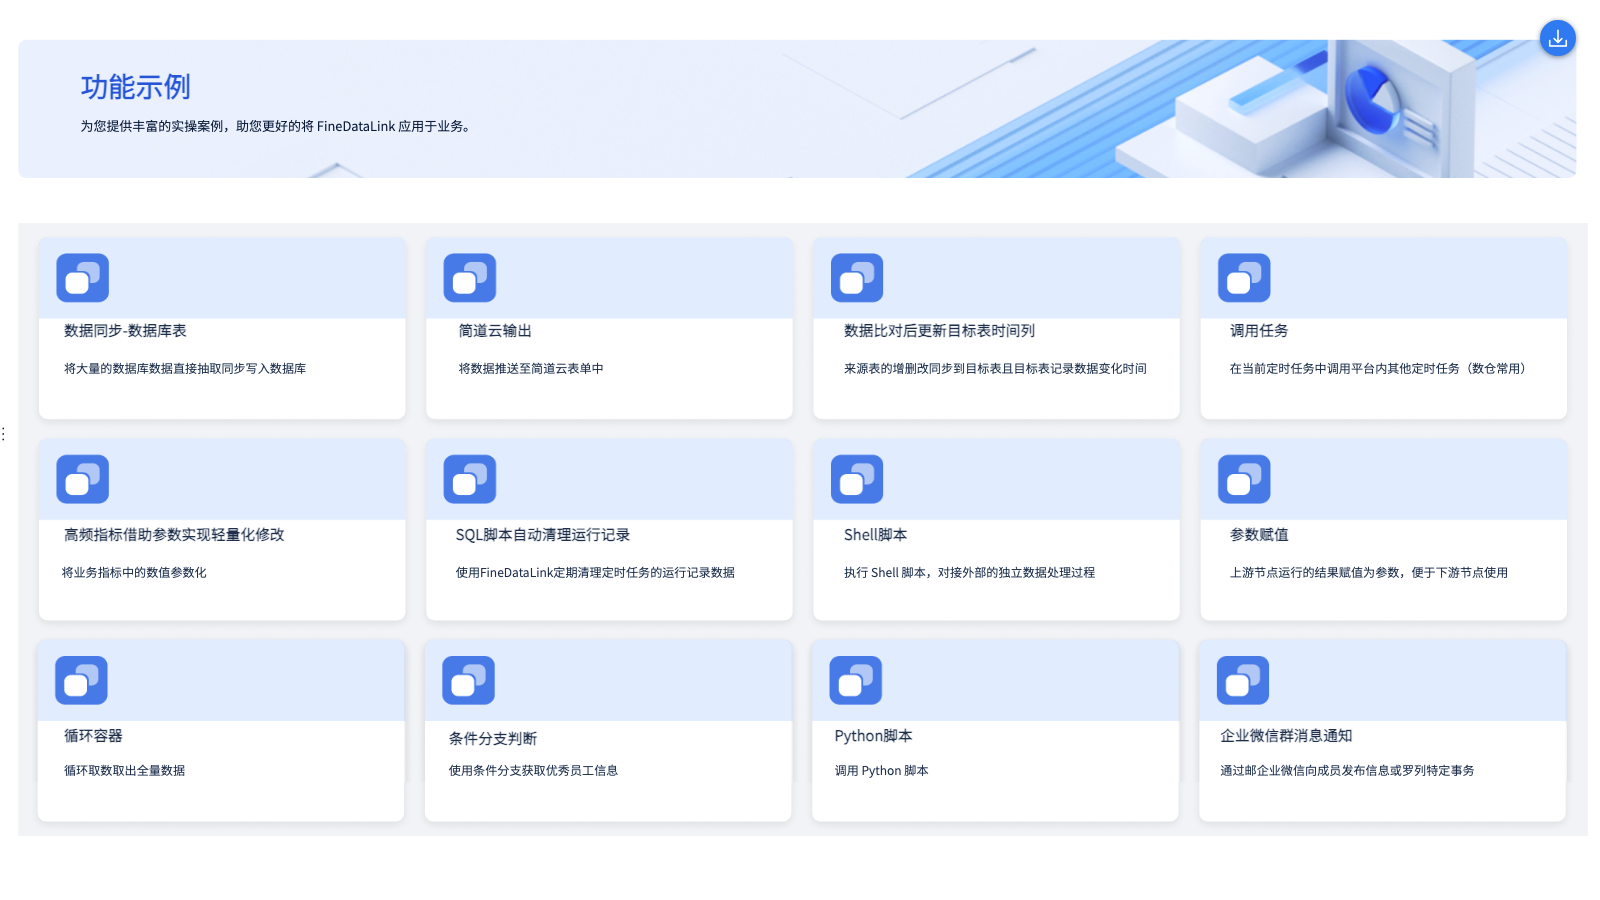
简单来说,现在的企业往往不是单一云,而是"本地+阿里云+AWS"的混合架构。这时候,你需要一个能够统一管理所有同步任务的集成平台。我一直强调,要把集成方案从"点对点"升级为"统一管控"。比如多数据源支持功能,可以同时连接本地Oracle、阿里云RDS、AWS Redshift等多种数据源,在一个界面上统一管理所有的同步任务。当某个云平台的数据库发生变更时,你可以通过统一的任务调度,自动触发下游所有相关数据的同步,确保整个混合云架构的数据流转是有序的、可控的。
Q&A常见问答
Q1:云计算环境数据同步,业务部门抱怨延迟高怎么办?
A1:说实话,这事儿真不是靠"加带宽"就能解决的。我的建议是,先让业务部门明确"真实的时效需求"。比如,通过FineDataLink的"增量同步"能力,只同步变化的数据,大幅降低同步延迟。当业务部门真正感受到数据同步的时效性提升时,他们自然会理解同步策略的重要性。另外,要建立配套的监控机制,比如把"同步延迟""同步成功率"纳入运维考核,让数据团队有动力持续优化同步性能。
Q2:云计算集成方案,如何判断一个平台是否真的好用?
A2:这其实是很多企业的通病。关键在于"试用"和"场景验证"。首先,一定要让数据团队亲自试用,而不是只听厂商的演示。其次,要用真实的业务场景去验证,比如拿一个最复杂的跨云同步任务,看平台能不能稳定、准确地完成同步。另外,要重点关注平台的"数据治理能力",比如FineDataLink的端到端数据血缘追溯能力,能让数据团队快速定位同步链路中的问题节点,这种"贴合实际运维需求"的能力,才是判断平台好不好用的核心标准。
Q3:云计算环境数据同步,最怕踩什么坑?
A3:最怕的坑就是"重同步、轻校验"和"脱离业务"。选集成方案和做同步,一定要跟着业务痛点走。核心建议是:一定要让业务部门深度参与。比如,在定义同步策略时,必须让业务部门、IT部门、数据部门一起开会确认,不能只由IT闭门造车。另外,工具的选择很重要,要让数据团队能轻松上手,而不是事事依赖外部厂商,这样云计算环境的数据同步才能真正在企业内部"生根发芽"。