课程截止日期临近、学校 GPU 又排不上时,可以临时租云 GPU。先按显存、训练时长、PyTorch/CUDA 环境和数据保存方式筛选,再用一小批数据试跑;不要只看显卡型号或小时单价。
不少深度学习课程最后都会卡在同一个地方:代码在本地能调通,但真正训练时,本机没有 NVIDIA 显卡,学校机房又满了。此时最现实的方案通常不是立刻买显卡,而是租一台按量计费的云 GPU,把训练任务临时迁过去。
这篇文章不做"哪家最便宜"的简单排名,而是给出一套能落地的判断和迁移流程:该租多大显存、怎样避免 CUDA 环境冲突、怎样估算实际费用,以及作业训练完如何把模型和日志安全带回来。
一、先判断:你的作业真的需要租 GPU 吗?
先把课程要求拆成四个问题:
- 模型是课程示例级,还是要训练 ResNet、YOLO、Transformer 等更大的网络?
- 老师要求完整训练,还是只要求代码跑通、损失下降并提交实验报告?
- 数据集有多大,能否先用 1%~10% 的样本完成调试?
- 截止日期前需要训练几次,是否还要做超参数对比?
如果只需验证代码和画出 loss 曲线,先缩小数据集、减少 epoch、降低 batch size,可能无需长时间租卡。只有在 CPU 训练明显来不及、显存不足或机房排队不可控时,云 GPU 才真正接管问题。
二、租 GPU 时,学生最该比较什么?
| 检查项 | 为什么重要 | 下单前怎么验收 |
|---|---|---|
| GPU 显存 | 决定模型、输入尺寸和 batch size 能否放下 | 核对卡型显存;先做小样本试跑并记录峰值 |
| PyTorch/CUDA 环境 | 版本不匹配会出现 CUDA 不可用、算子缺失等问题 | 查看镜像版本,启动后运行环境检查命令 |
| 计费粒度 | 课程作业常有大量调试时间 | 区分按量、按天/周/月;确认关机后的算力与存储规则 |
| 数据保存 | 释放实例后,本地盘数据可能无法恢复 | 训练中保存 Checkpoint,结束前下载或转存关键文件 |
| 连接方式 | 影响上传代码、看日志和改参数的效率 | 确认是否支持 SSH、JupyterLab 或 VS Code |
| 动态库存 | 同一卡型并非始终可用 | 下单前查看创建实例页的实时区域、卡数和显存 |
不要把"显卡越新"直接等同于"作业一定更快"。对课程训练而言,先满足显存和框架兼容,再考虑速度;否则可能花钱租到高性能卡,却把时间消耗在环境重装和数据重传上。
三、先在本地整理项目,别开机后再慢慢找文件
建议把项目整理成下面这种结构:
text
pytorch-homework/
├── train.py
├── requirements.txt
├── configs/
├── data_sample/
├── checkpoints/
└── README.md
requirements.txt 不要盲目锁死云端镜像已经自带的 PyTorch 和 CUDA 版本。更稳妥的做法是先记录当前环境,再在云端只补装缺失依赖:
bash
python --version
python -m pip list --format=freeze > requirements-local.txt
同时确认训练脚本至少支持以下参数:
- 数据集路径;
- batch size;
- epoch 数;
- Checkpoint 保存目录;
- 从 Checkpoint 恢复训练;
- 随机种子。
如果这些参数全部写死在代码里,迁移到云端后每次改配置都容易出错。
四、以算家云为例操作演示
算家云官网把青春版 Air 定位为短期学习、测试验证和低成本使用,把专业版 Pro 定位为长期生产、推理训练和稳定运行。对一次课程作业,优先按"短期验证"核对青春版是否有合适资源;如果要连续训练多天、反复跑实验,再比较专业版。这里说的是官网产品定位,不代表某个区域、卡型或时段一定有库存。
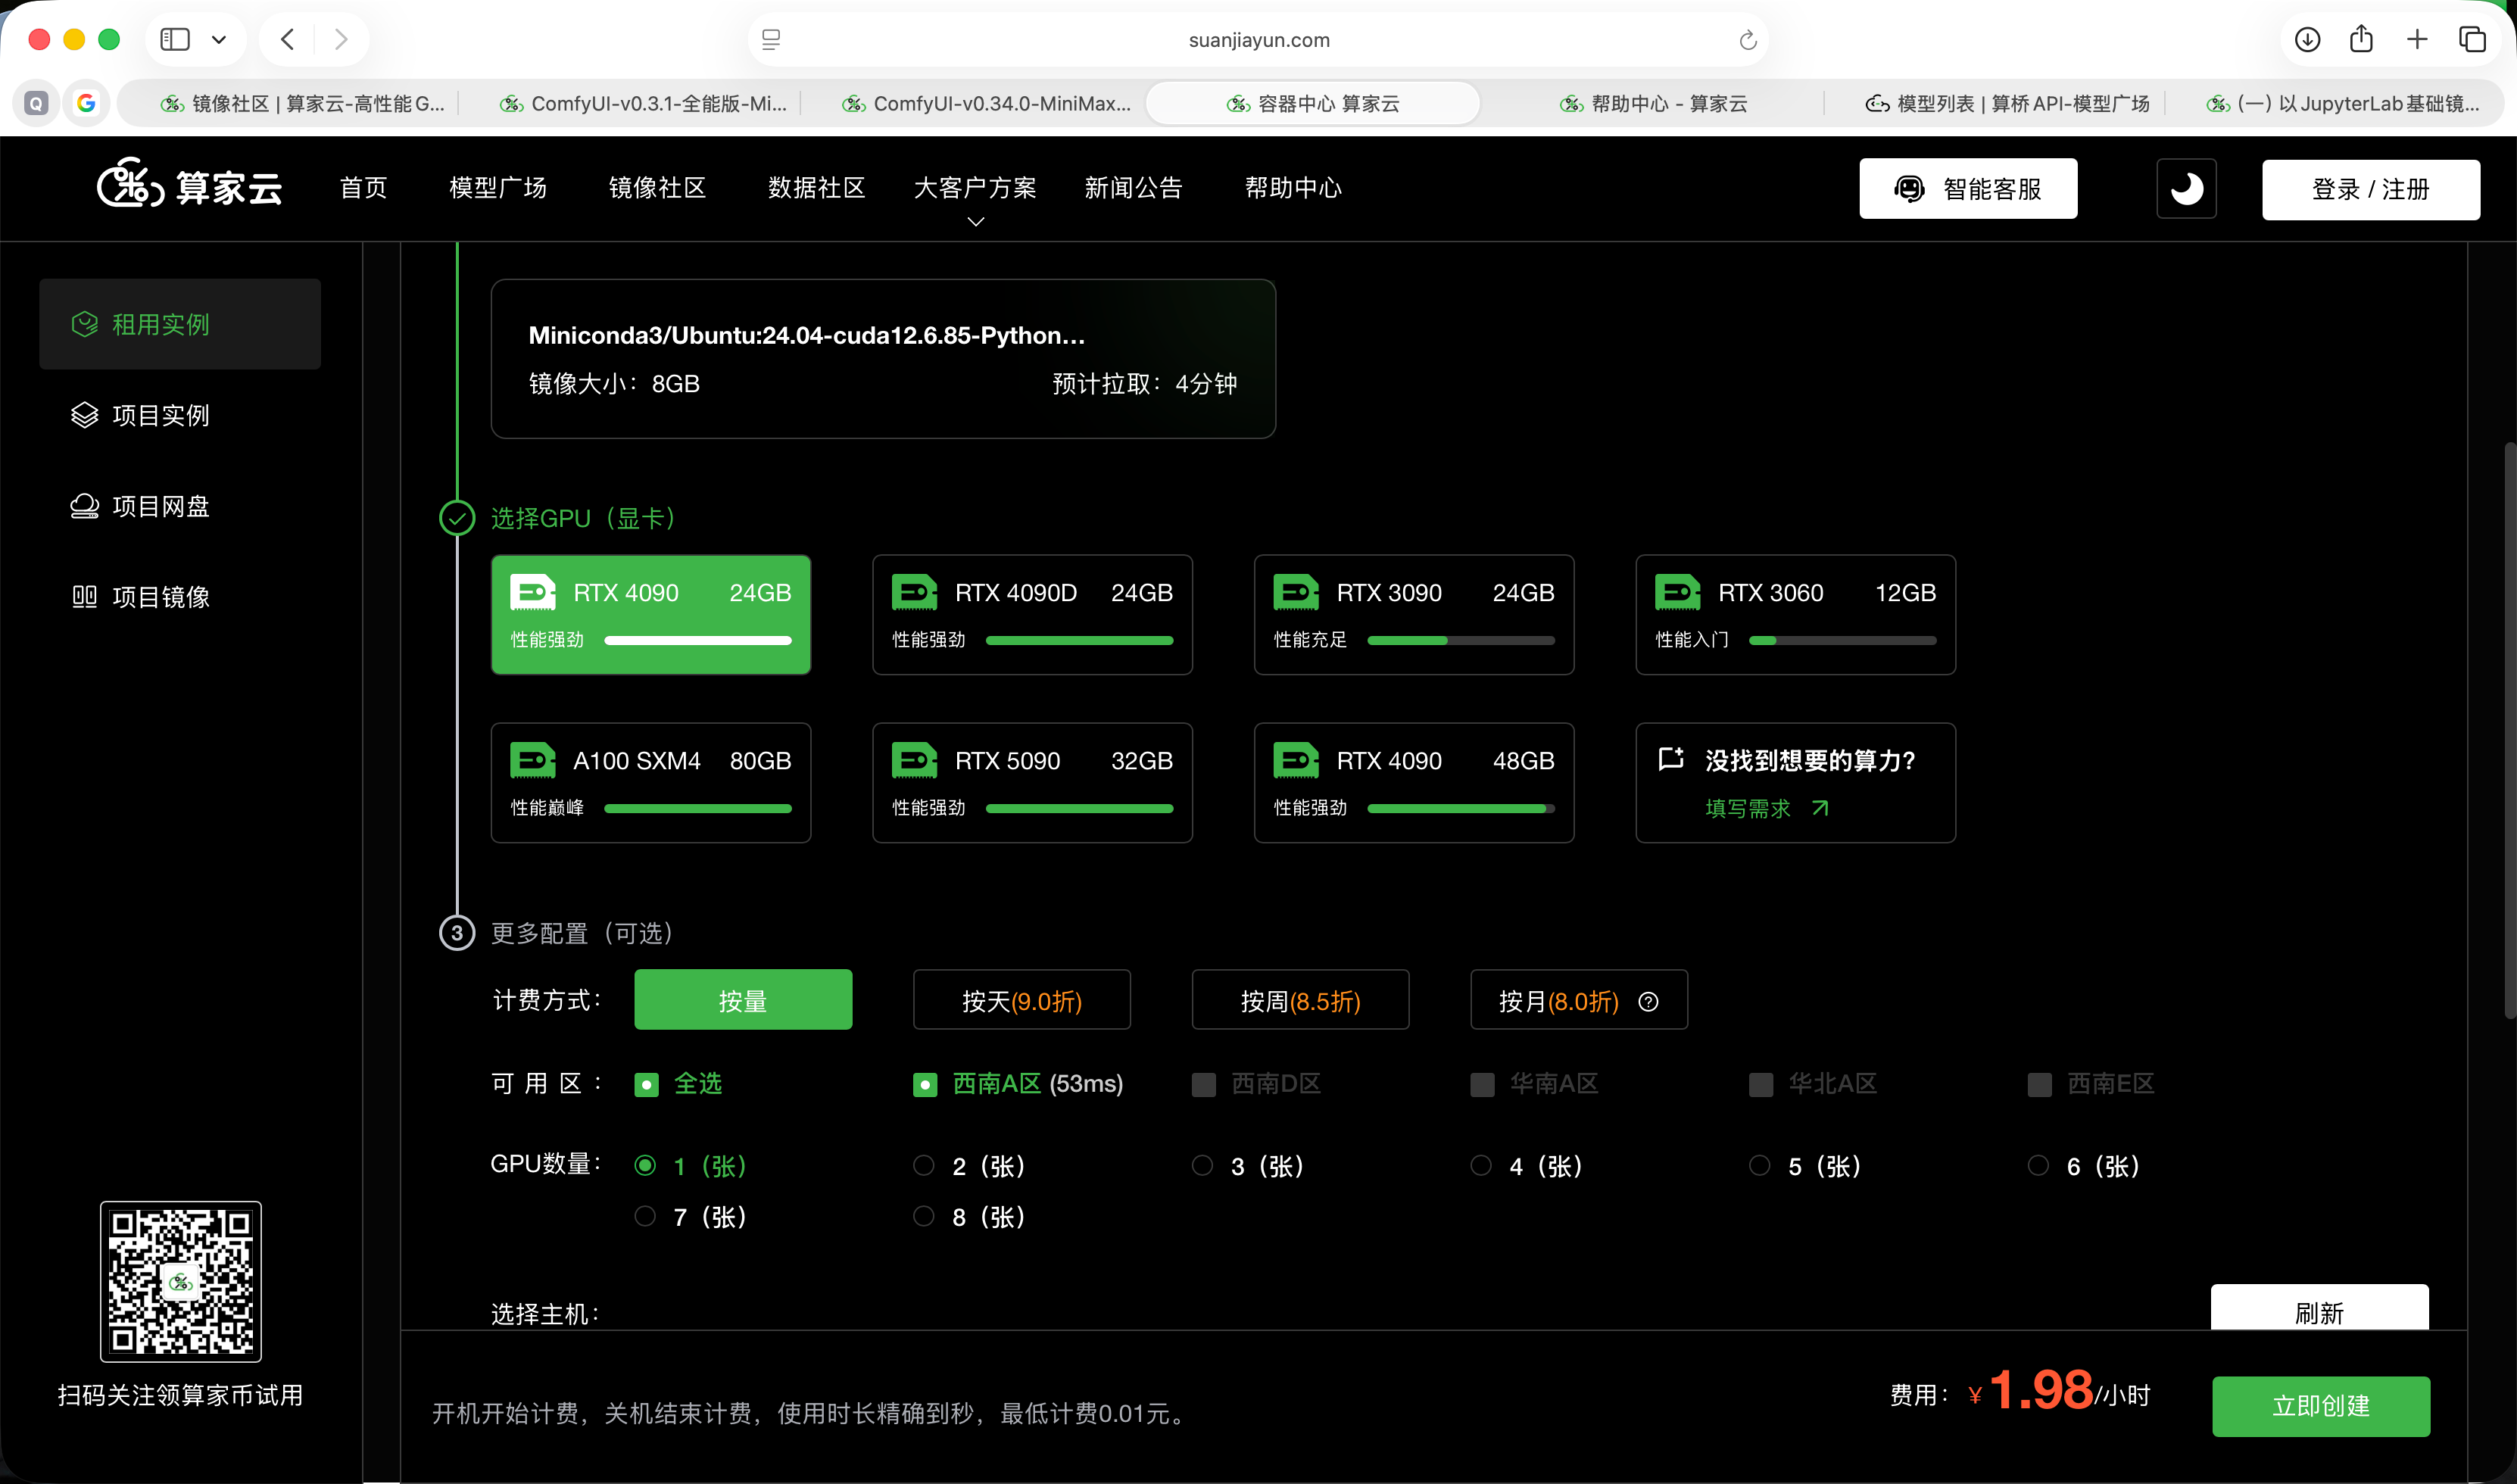
创建实例时,按下面的顺序选:
- 先确认训练需要的显存,不要先追求最高卡型;
- 选择与项目接近的 PyTorch/CUDA 基础镜像;
- 根据习惯选择 JupyterLab、SSH 或 VS Code 连接;
- 上传代码和少量样本,暂时不要上传完整数据集;
- 完成环境检查和最小训练后,再传完整数据。
进入实例后先运行:
bash
nvidia-smi

python - <<'PY'
import torch

print("PyTorch:", torch.__version__)
print("CUDA available:", torch.cuda.is_available())
print("PyTorch CUDA:", torch.version.cuda)

if torch.cuda.is_available():
    print("GPU:", torch.cuda.get_device_name(0))
    print("VRAM(GB):", round(torch.cuda.get_device_properties(0).total_memory / 1024**3, 2))
PY
只有当 torch.cuda.is_available() 返回 True,并且 GPU 名称、显存符合预期时,才继续装依赖和训练。不要一上来就重装 PyTorch;基础镜像里的 PyTorch 通常已经与驱动环境配套,随意覆盖反而可能造成 CUDA 版本冲突。
五、用最小训练验收,5~10 分钟内发现问题
正式跑几十个 epoch 之前,先做一次最小闭环:
- 只取少量样本;
- epoch 设为 1;
- batch size 从保守值开始;
- 能完成前向、反向和参数更新;
- 能生成 loss 日志;
- 能保存并重新加载 Checkpoint。
训练时另开一个终端观察 GPU:
bash
watch -n 1 nvidia-smi在 PyTorch 中记录峰值显存:
python
import torch

torch.cuda.reset_peak_memory_stats()

# 在这里执行若干个训练 step

peak_gb = torch.cuda.max_memory_allocated() / 1024**3
print(f"peak allocated: {peak_gb:.2f} GB")
如果出现 CUDA out of memory,建议按以下顺序处理,而不是立刻换更贵的卡:
- 降低 batch size;
- 降低图片分辨率、序列长度或数据增强开销;
- 使用梯度累积;
- 开启混合精度训练;
- 检查代码是否错误保留计算图;
- 仍无法满足时,再换更大显存的 GPU。
六、Checkpoint 要从第一次正式训练就保存
云端训练最怕的不是慢,而是跑到最后才发现没有可恢复文件。至少保存模型、优化器、epoch 和必要指标:
python
import torch

torch.save({
    "epoch": epoch,
    "model": model.state_dict(),
    "optimizer": optimizer.state_dict(),
    "loss": float(loss),
}, "checkpoints/latest.pt")
恢复训练时:
python
checkpoint = torch.load("checkpoints/latest.pt", map_location="cpu")
model.load_state_dict(checkpoint["model"])
optimizer.load_state_dict(checkpoint["optimizer"])
start_epoch = checkpoint["epoch"] + 1
建议每隔固定 epoch 或固定 step 保存一次,并保留"最新版本"和"最佳验证集版本"两份文件。提交作业前,至少下载:
- 最终权重;
- 最佳权重;
- 训练日志;
- 配置文件;
- 关键结果图;
requirements-local.txt或环境说明。
七、费用怎么控制?先估算"有效训练时长"
课程作业更适合用下面的公式做预算:
text
预计费用 ≈ 单位算力价格 ×(环境验收时间 + 正式训练时间 + 失败重跑缓冲)+ 可能的存储费用真正容易浪费的往往是:实例开着却在本地改代码、完整数据反复上传、环境冲突后多次重装,以及训练结束忘记关机。
算家云当前公开规则显示,按量实例开机开始算力计费,关机结束实例算力计费,不足一小时的使用时段按秒计费;但关机不等于所有关联资源都停止收费,本地扩容数据盘等仍有单独规则。实例持续关机满 7 天后,系统盘和本地数据盘会被释放且不可恢复,所以关键文件必须提前转存。具体规则和价格应在发布及使用当天再次核对。
八、给赶作业同学的一条最短路径
- 本地先让代码完成一个 batch;
- 记录 Python、PyTorch、CUDA 和依赖;
- 按显存与连接方式选择云 GPU,而不是只按价格选;
- 云端先跑 1 个 epoch 的小样本验收;
- 确认 loss、峰值显存和 Checkpoint 都正常;
- 再上传完整数据开始训练;
- 下载权重、日志和图表后关机,并核对存储资源。
如果你现在只知道"作业跑不动",最有价值的下一步不是马上充值,而是先写下模型名称、输入尺寸、batch size、数据量、预计 epoch 和截止时间。用这张需求单去选云 GPU,通常能少踩很多坑。
常见问题 FAQ
1. PyTorch 课程作业一定要租 RTX 4090 吗?
不一定。很多课程模型在更小显存上也能运行。先用保守 batch size 做最小训练并记录峰值显存,再决定是否升级卡型。
2. 云端显示有 GPU,但 torch.cuda.is_available() 是 False 怎么办?
先确认实例确实分配了 GPU,运行 nvidia-smi;再核对 PyTorch 是否为 CUDA 版本以及镜像中的 CUDA 兼容关系。不要先用 pip 覆盖整个 PyTorch 环境。
3. 关机后训练数据一定还在吗?
不能这样假设。不同平台对系统盘、数据盘、网盘和实例释放的规则不同。以算家云为例,持续关机满 7 天会释放实例关联的系统盘和本地数据盘,释放后不可恢复;重要文件应在关机和释放前下载或转存。
4. 学校机房和云 GPU 怎么组合最省时间?
可以在本地或机房完成代码调试、数据清洗和小样本验证,只把正式训练与少量必要调参放到云端。这样能减少付费实例的空闲时间。
5. 课程作业更适合青春版 Air 还是专业版 Pro?
按官网定位,短期学习和测试验证可以先看青春版 Air;连续多天训练或对稳定运行要求更高时,再比较专业版 Pro。最终仍要以创建实例页当时的卡型、显存、区域和库存为准。