《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)
目录
本文要点
(1)Marigold V2是华为Bayer Lab、EPFL和博洛尼亚大学2026年9月放出的单目深度估计模型,骨干是图像编辑DiT模型Qwen-Image-Edit-2509。
(2)同量级数据下KITTI的AbsRel为5.4 ,ETH3D为2.8 ,摘要称相对上一名改进16%到26%。
(3)做法是4-bit QLoRA加两阶段微调,第一阶段用真值深度上的iREPA,第二阶段用SinkLoss并解开VAE解码器。
(4)短板是1024分辨率下比InfiniDepth慢将近十倍,反光、运动模糊和失焦区域论文自己也承认仍含糊。
(5)文末附官方README的推理命令。GitHub清单里Diffusers接入尚未完成。
华为Bayer Lab、EPFL和博洛尼亚大学在2026年9月8日把Marigold V2挂上arXiv,编号2609.08084。论文将收入ACM TOG第45卷第6期,并在同年12月的SIGGRAPH Asia上报告。
我把HTML版从头对过一遍,也对照了GitHub README和Hugging Face模型卡。代码和权重同一天开源。
事情本身很具体。作者把开源图像编辑模型Qwen-Image-Edit-2509收成一个单步单目深度估计器,微调用4-bit QLoRA,只在一张32GB显卡上做。同量级数据里,KITTI的AbsRel从FE2E的6.5落到5.4 ,ETH3D从3.8落到2.8。摘要把这两项相对改进写成16%到26%。
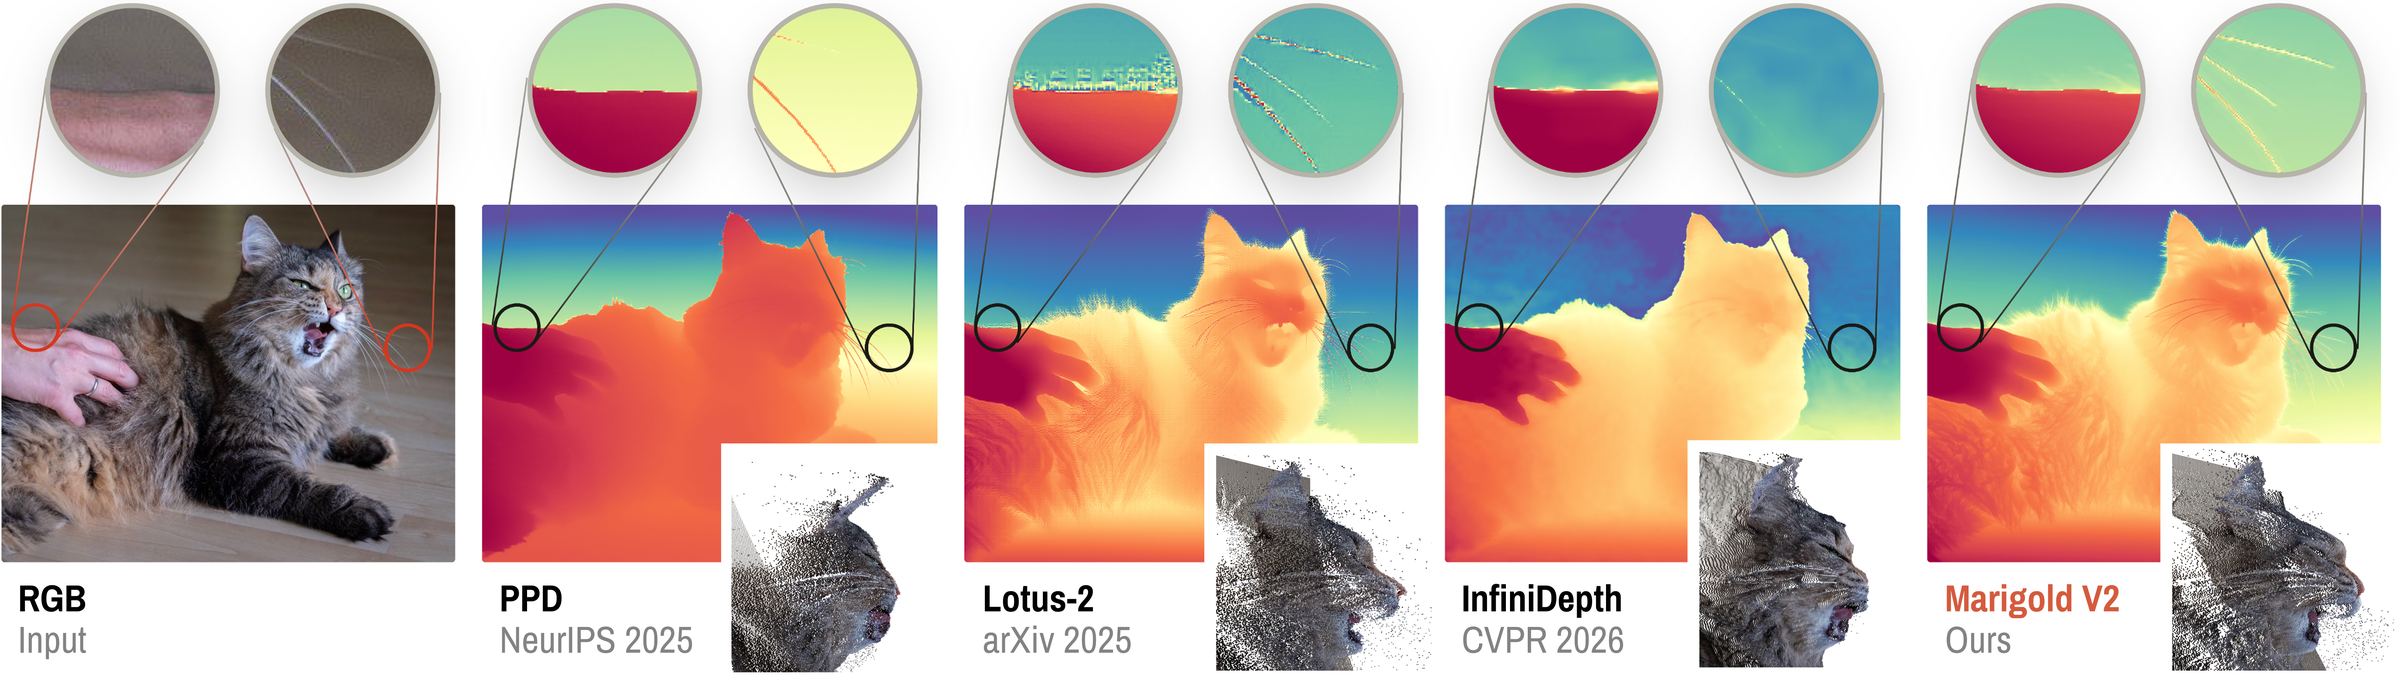
生成模型当感知器,到DiT还成立吗
单目深度估计是从一张RGB图恢复每个像素的远近。一张图对应无数种三维解释,模型必须靠对场景的常识来填空。
2024年的Marigold V1证明过一条便宜的路。把已经在海量图上训好的扩散生成模型拿来微调,合成深度数据只要7.4万张,就能得到能跨数据集零样本用的深度图。那一代骨干是Stable Diffusion的U-Net。
骨干换成Diffusion Transformer之后,这条路变贵了。论文相关工作写,从零训DiT要几十张GPU,DICEPTION花掉96个GPU日,Lotus-2用8张卡。个人和小组很难跟。
V2要回答的就是这件事。图像编辑模型本来就是图到图,潜空间里从RGB走到另一种图,比文生图更接近深度估计。
再把多步flow matching的时间步钉在0.5,一次前向直接回归,预训练权重压成4 bit,只训秩128的适配器。数据配比仍跟V1一样,HyperSim和Virtual KITTI 2,抽样概率90%对10%。
这样,生成模型当感知器的逻辑还在,账单回到单卡。
两阶段怎么训
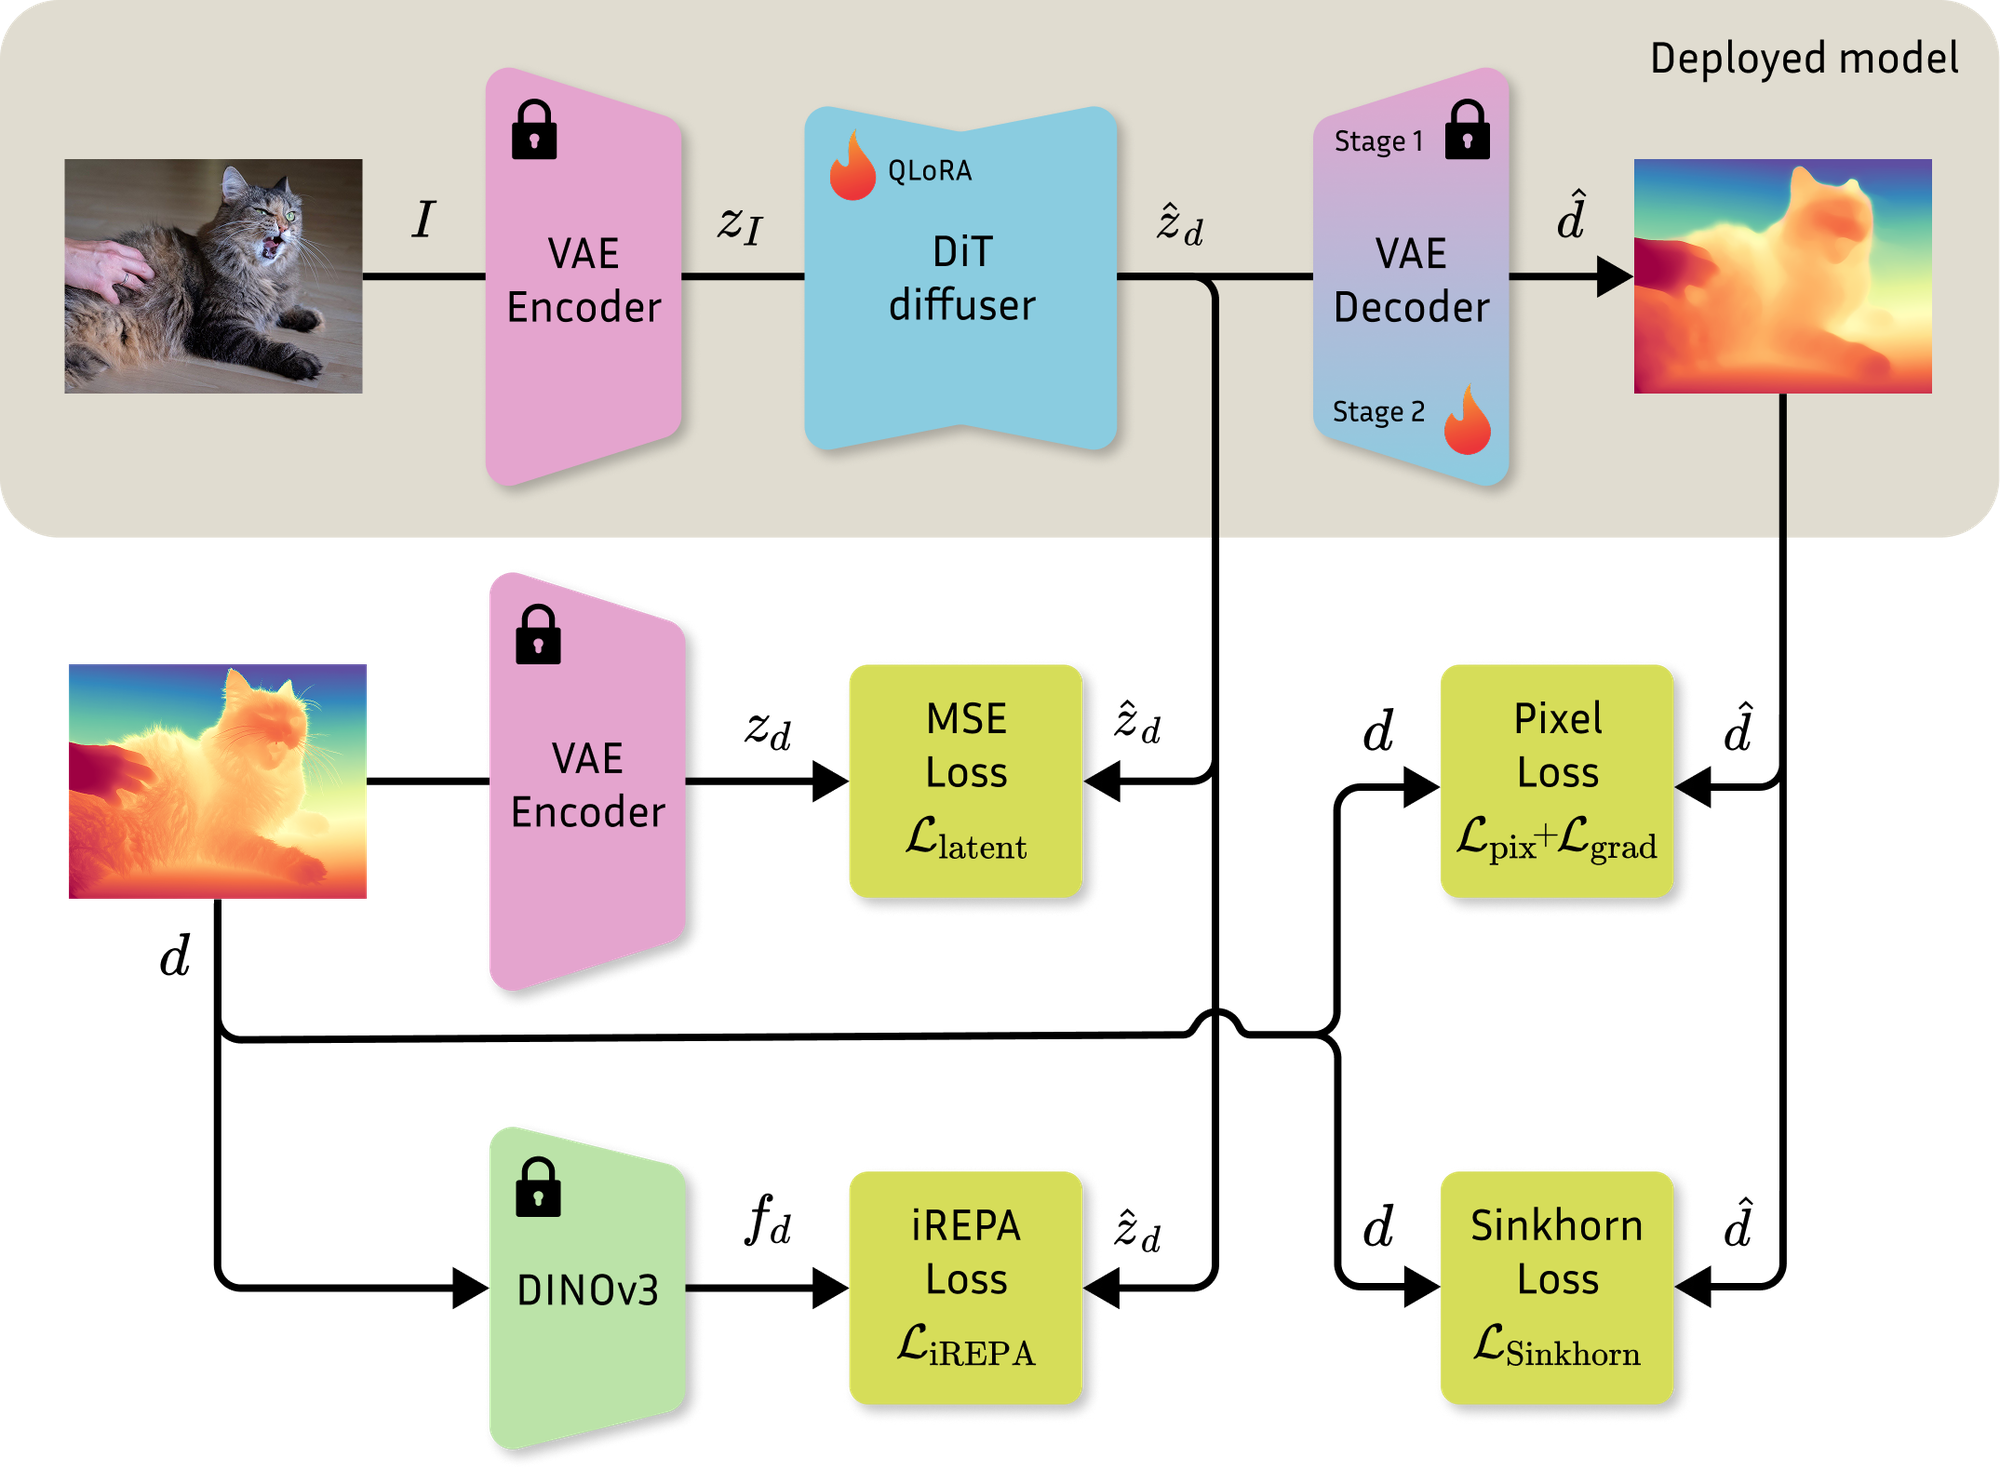
部署时路径很短。VAE编码RGB,DiT走一次,VAE解码出深度图。训练分两段。
第一段只训QLoRA,VAE冻住。损失有四项,潜空间MSE、像素L1、空间梯度L1,再加一项叫iREPA-depth的特征正则。梯度项权重5.0,iREPA权重0.2。最终第一段跑16万步,论文写同一张32GB卡上略超过五天。
深度先变成仿射不变的对数深度,按有效像素的2%和98%分位数裁到负一到一,再复制成三通道灰度图,才能塞进本来吃RGB的VAE。
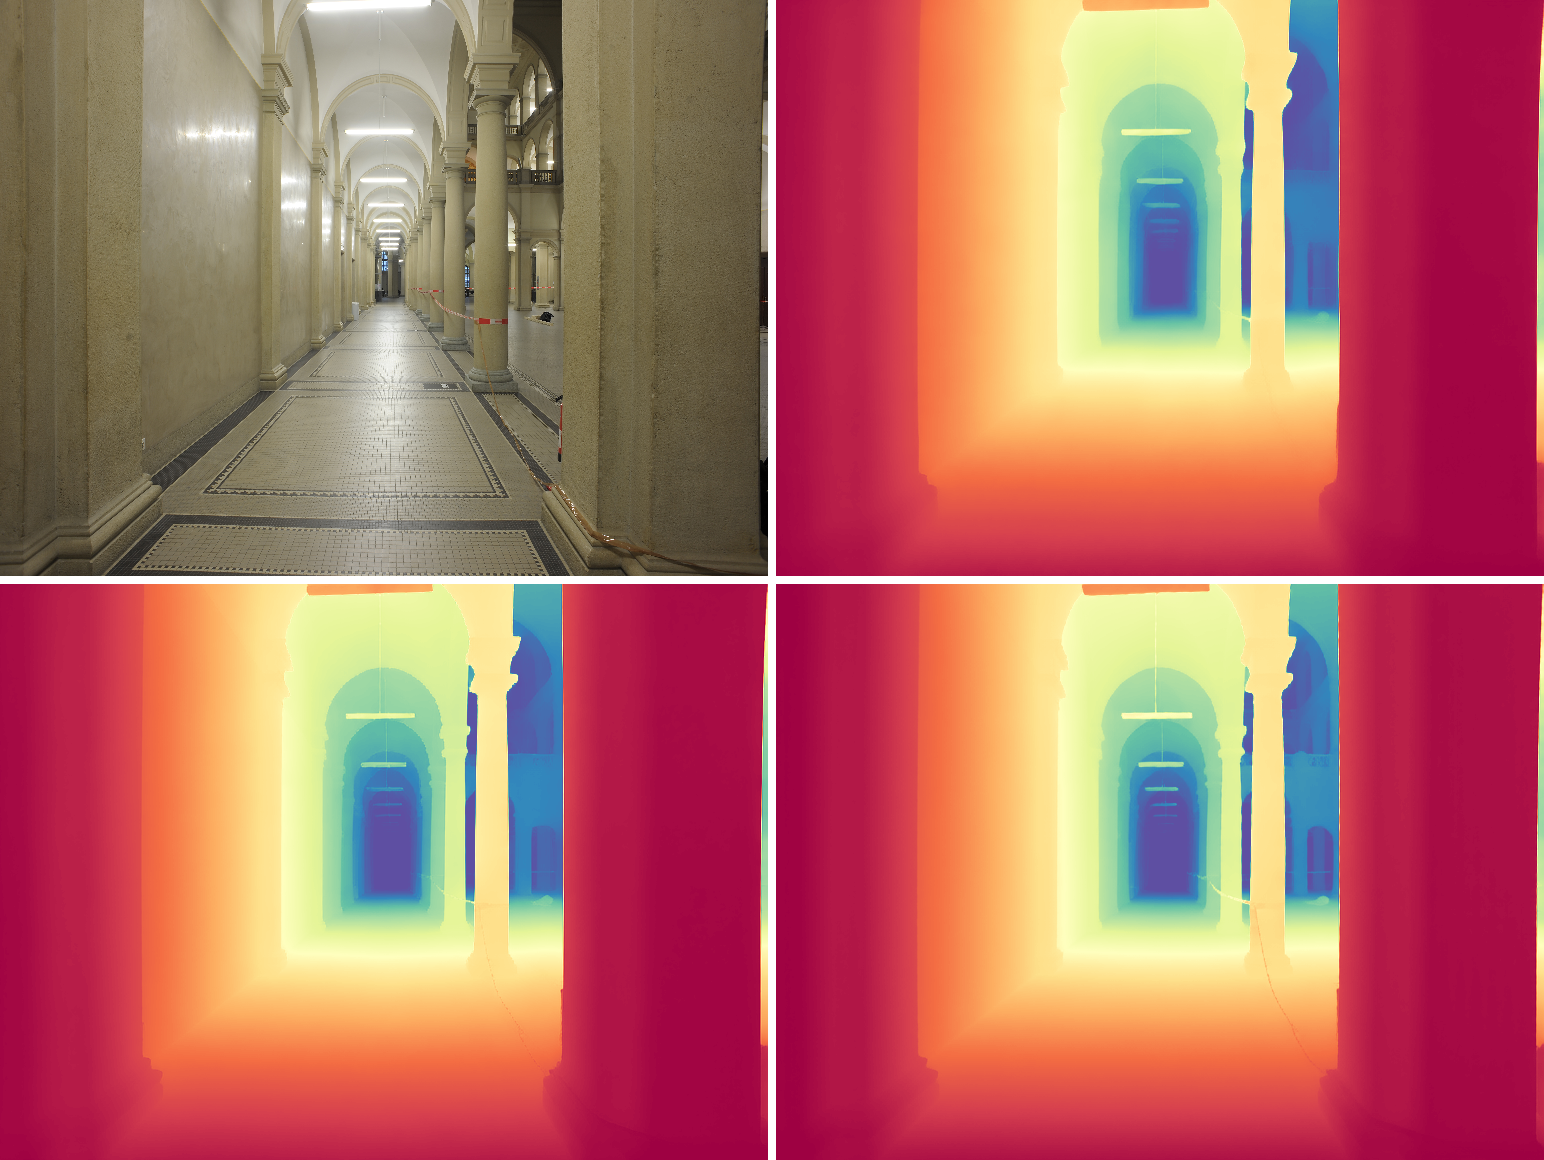
iREPA原本用来把扩散模型的内部特征拉向视觉编码器。DepthMaster、Pixel-Perfect Depth都从输入RGB抽特征。V2改成对真值深度图跑冻结的DINOv3。论文给的理由是几何监督更直接,推理时也不用额外挂一个编码器。
消融要分开看。3万步的对照里,对着深度做iREPA,五个测试集的AbsRel都好于对着RGB做的版本。
拉到16万步以后,数字差距缩小,NYUv2上去掉这项的AbsRel是3.62,加上是3.68。论文自己说,长训之后这项对视觉质量仍有帮助,对排行榜数字的贡献变弱。
第二段从第一段检查点接着训3万步,大约再花一天。VAE解码器解开,并加上SinkLoss。
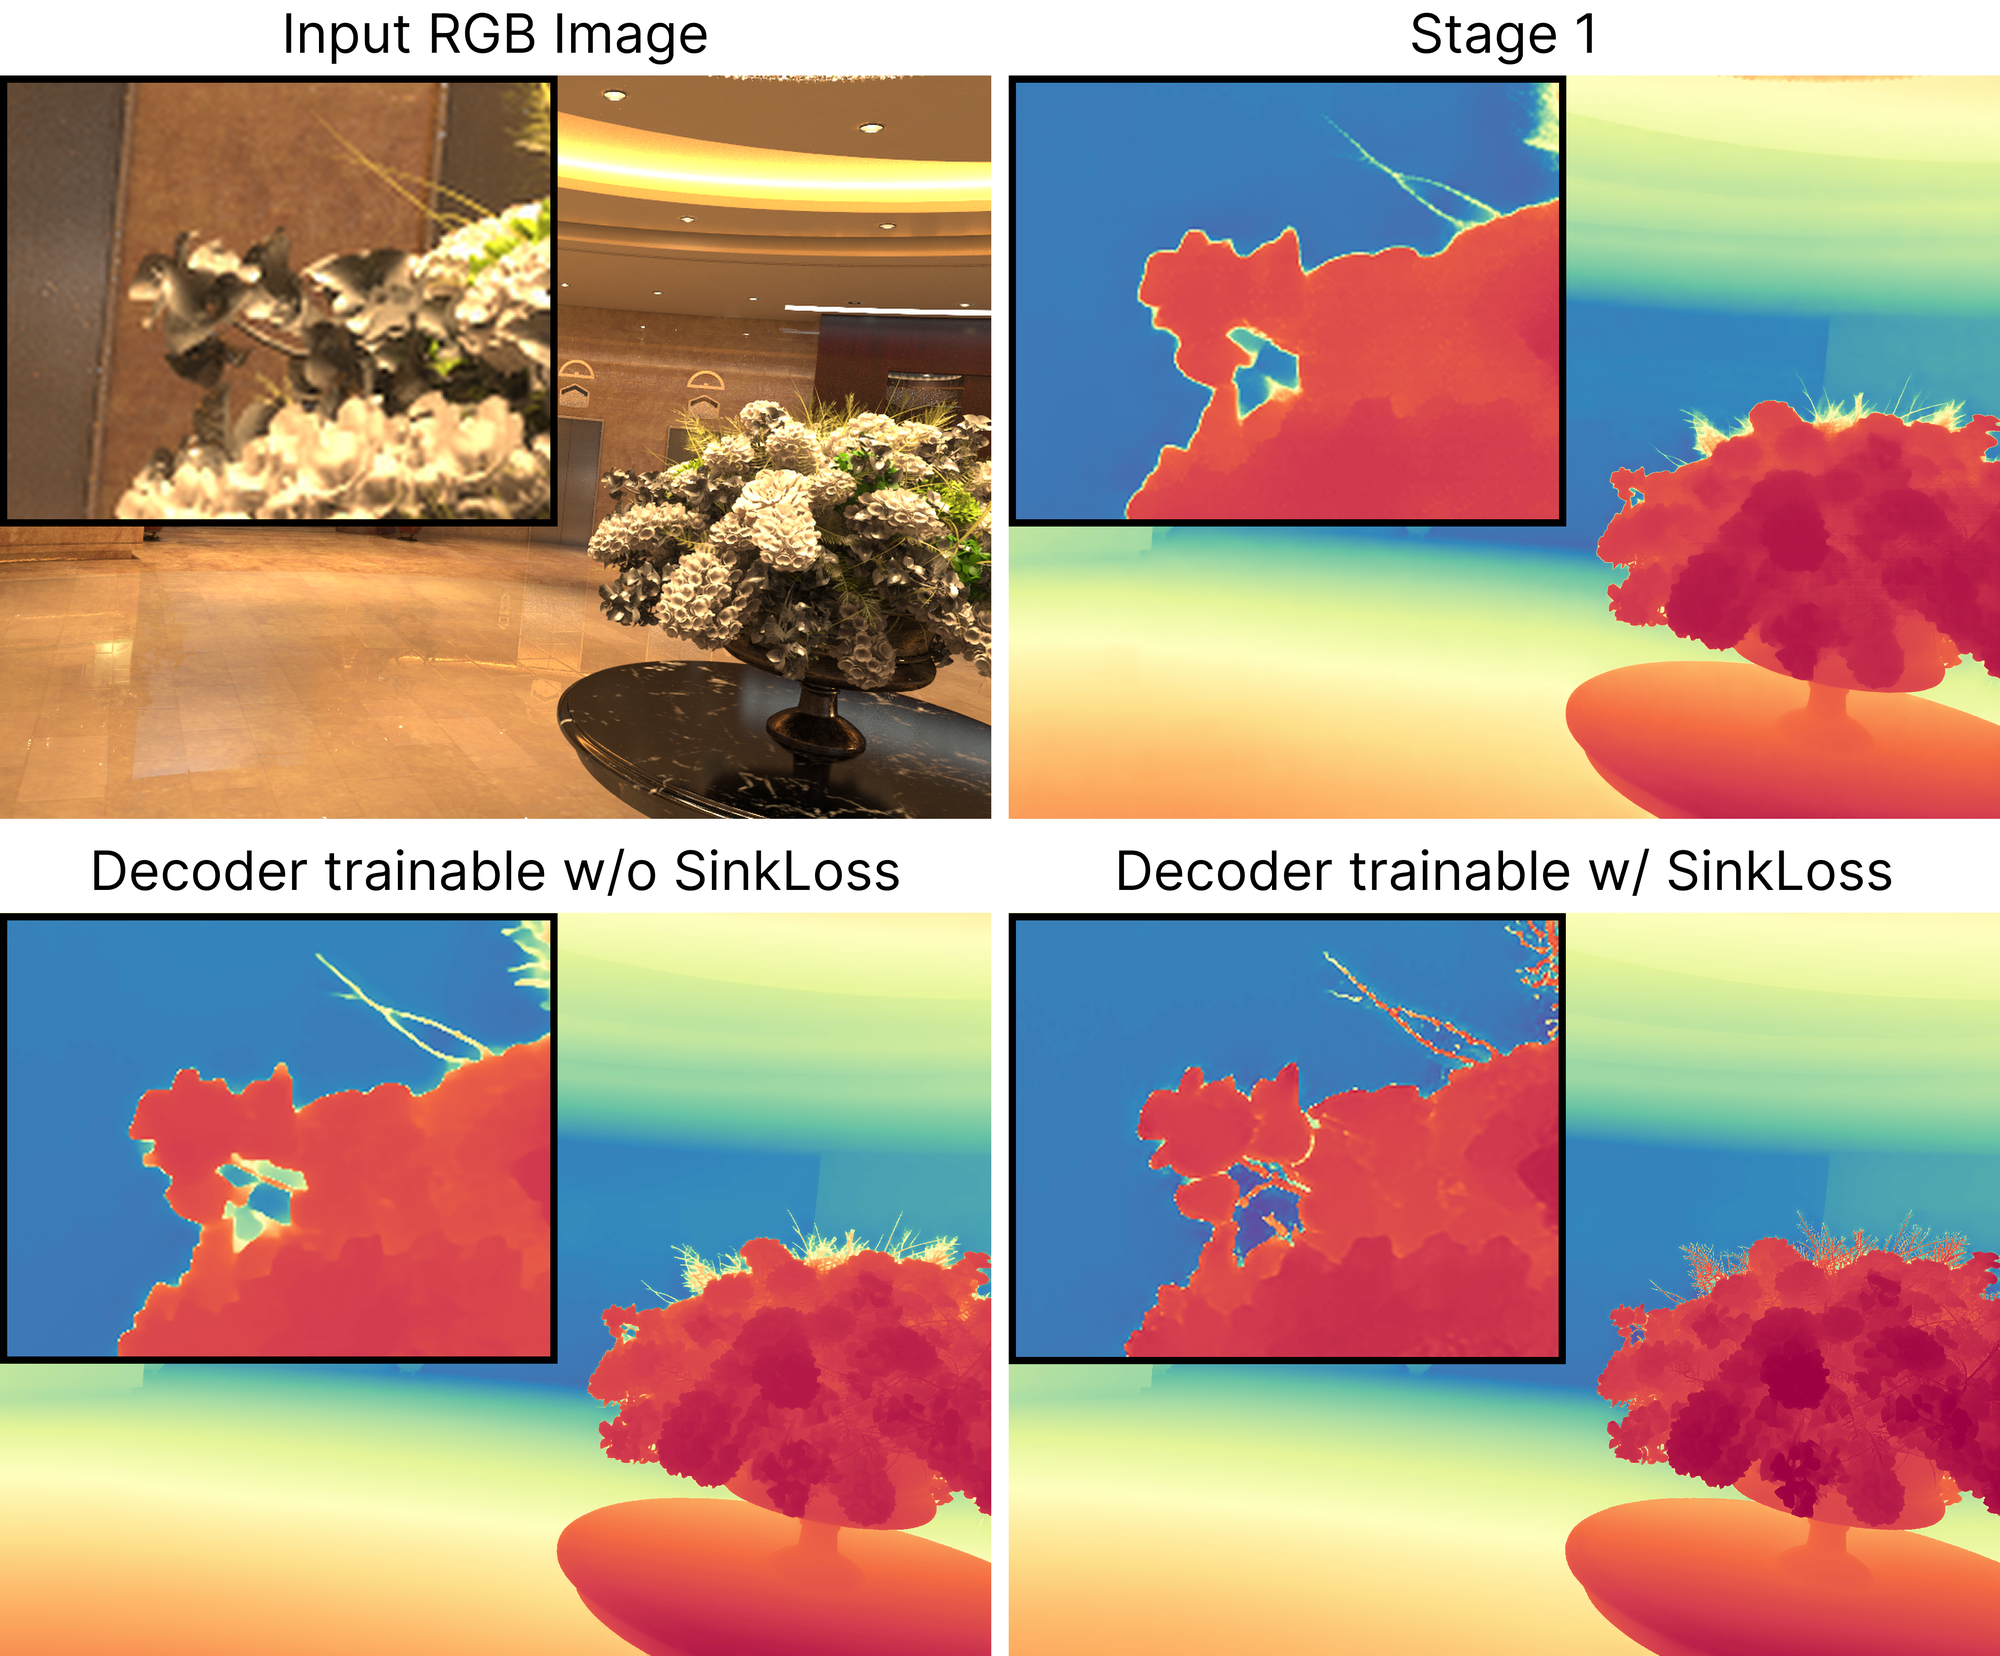
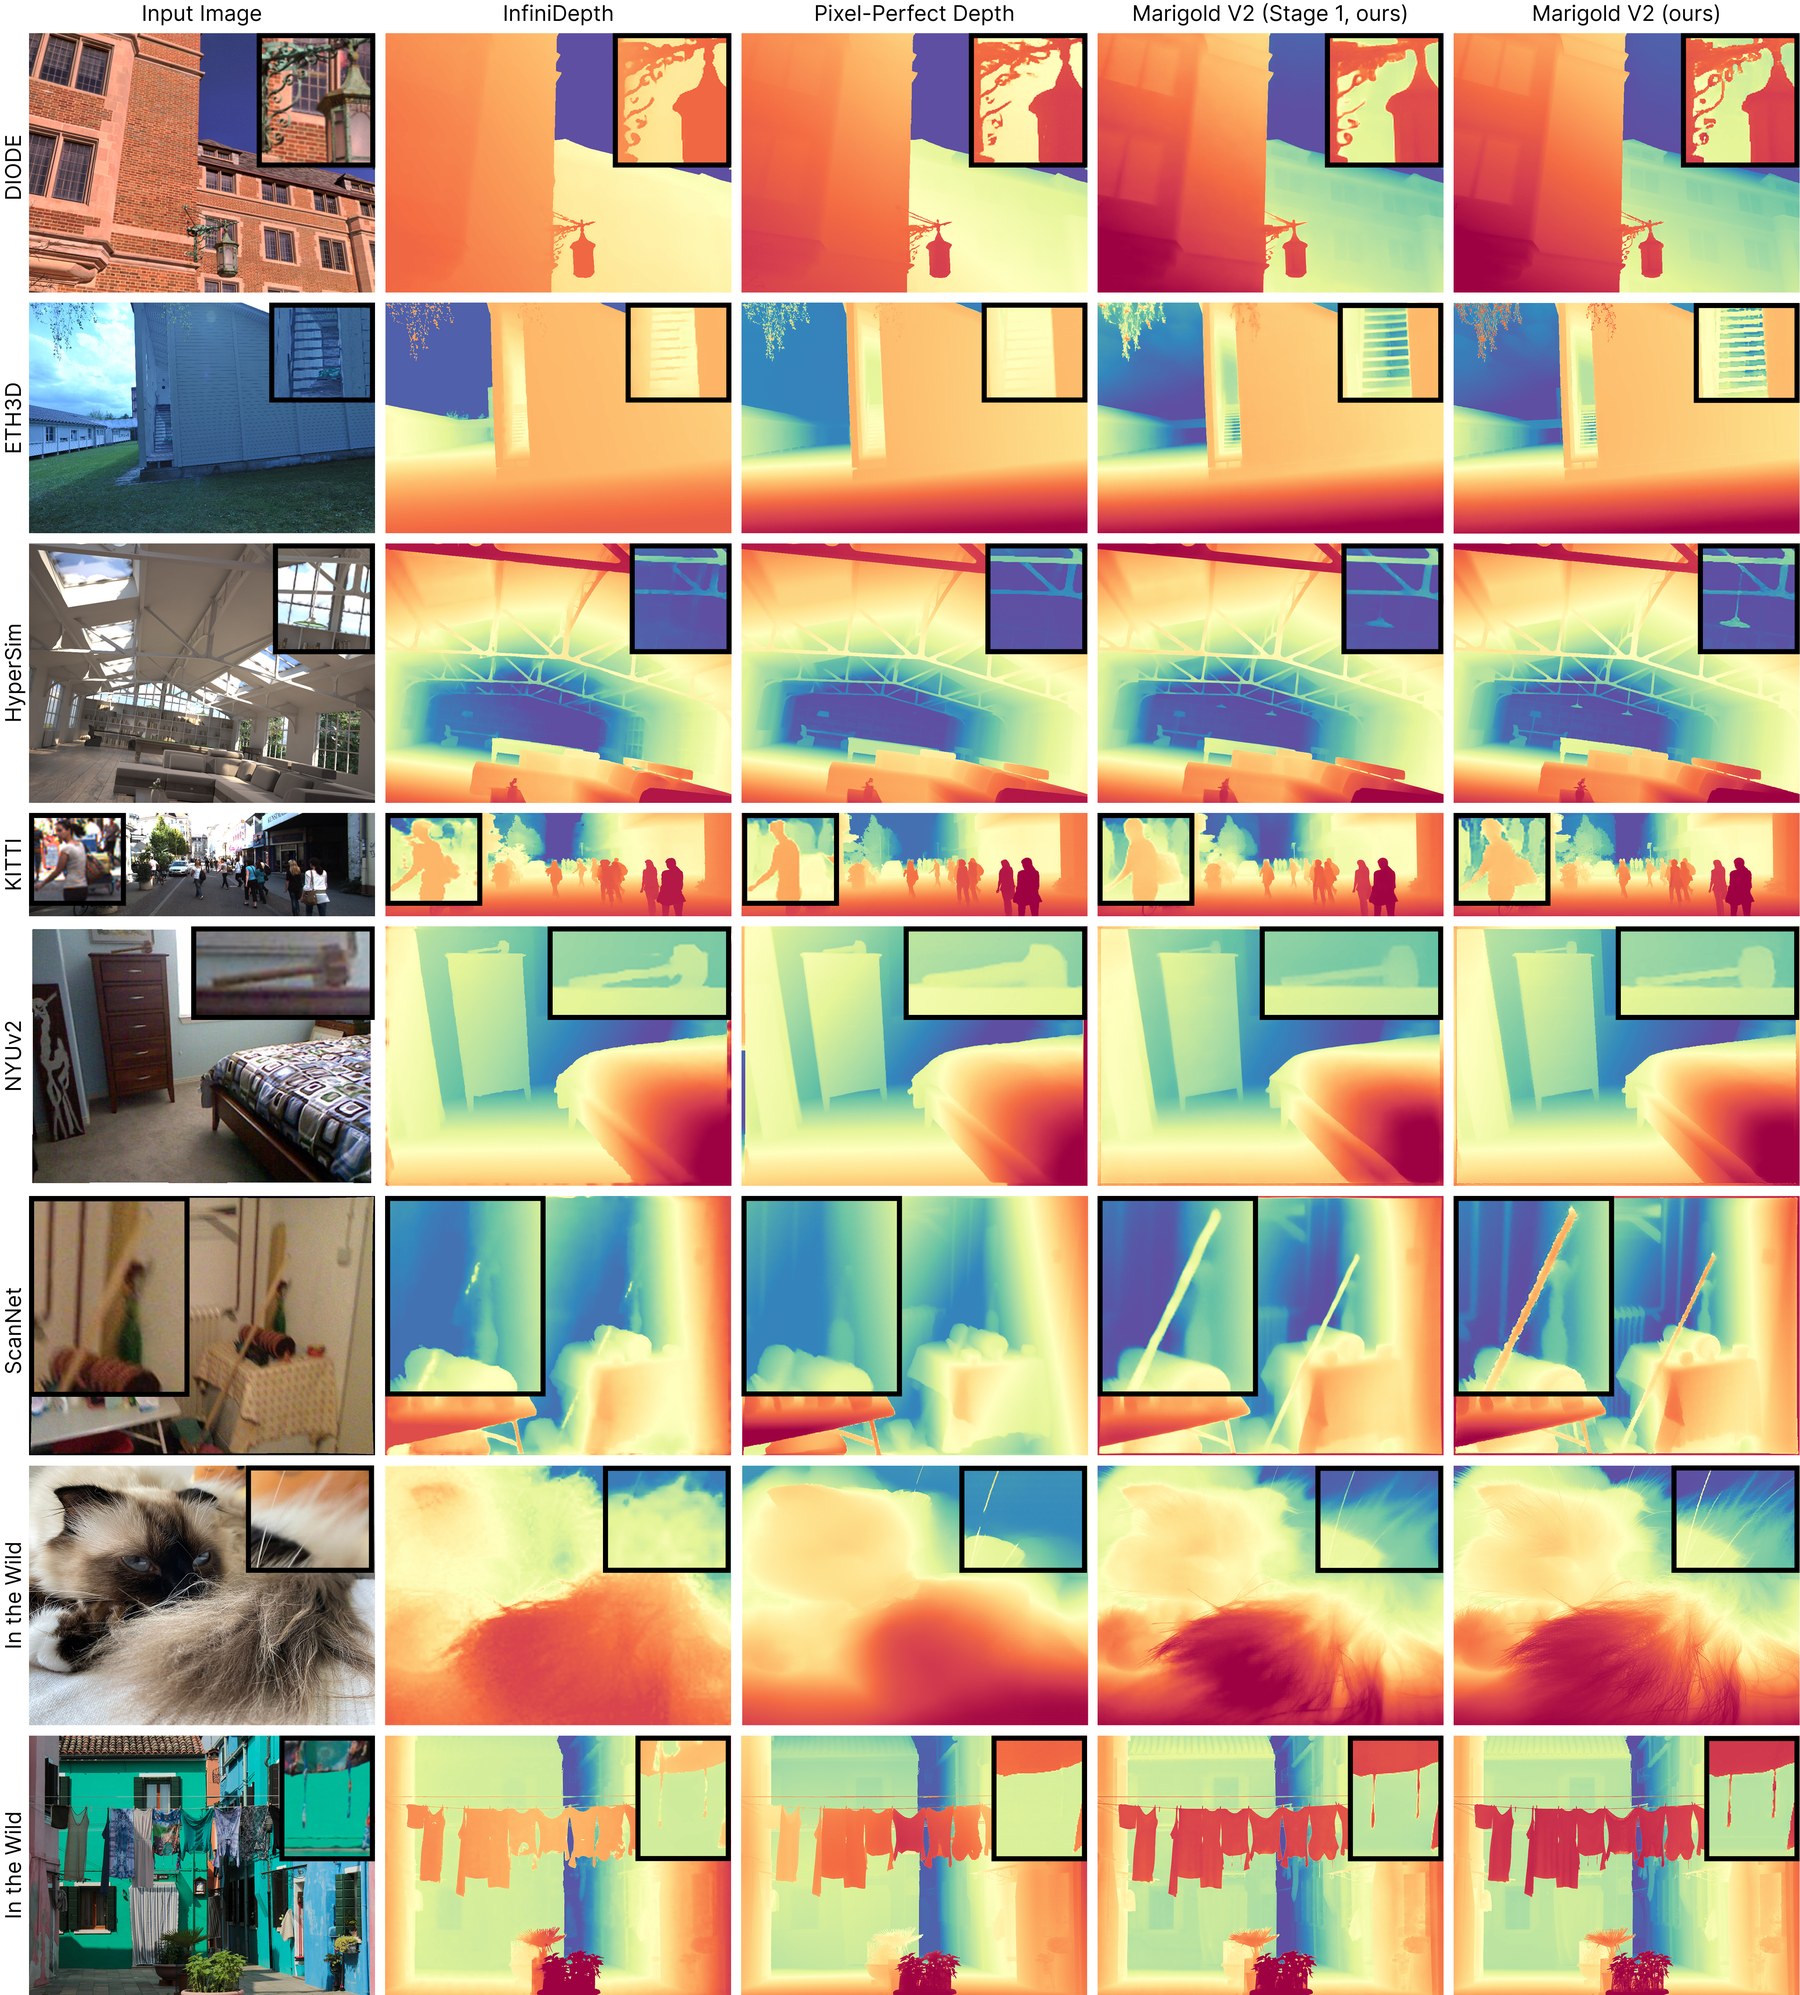
SinkLoss针对的是真值本身的脏。HyperSim里细杆、纱帘这类半透明结构,渲染器用准蒙特卡洛采样,前景还是背景深度几乎是随机的。逐像素死盯真值,模型会学会复现这份噪声,点云里就飞像素。
做法是把图切成互不重叠的5乘5块。块内预测值和真值做熵正则的最优传输,只要求这25个深度值作为集合对得上,允许块内换位置。参数写死为温度0.1、5次Sinkhorn迭代。无效像素用大代价挡掉,不参与监督。
换到Stable Diffusion 1.5和FLUX.2 klein上,SinkLoss同样压低HyperSim上的Soft Edge Error。Qwen骨干上平均AbsRel从4.10微升到4.12,SEE3从0.449降到0.352。它几乎不刷AbsRel,主攻边界和细结构。
参数化也做了对照。同样配方下,对数深度平均AbsRel 4.72,线性深度5.04,视差5.28。最终论文模型用对数。
成绩单
评测跟Pixel-Perfect Depth同一套协议。预测先用RANSAC配到真值的尺度和平移,再算AbsRel和δ1。
AbsRel是平均相对误差,δ1是预测落在真值1.25倍以内的像素比例。除ETH3D按1008×672推理再上采样到2048×1360之外,其余数据集用原生分辨率。
表里训练数据超过500万的方法原文标灰,不参与同量级排名。下面只摘常被拿来比的几个,单元格是AbsRel ↓ / δ1 ↑,AbsRel按论文写成百分数。
| 模型 | 训练数据 | NYUv2 | KITTI | ETH3D | ScanNet | DIODE |
|---|---|---|---|---|---|---|
| Marigold V2 | 74K | 3.6 / 98.0 | 5.4 / 97.4 | 2.8 / 99.2 | 3.7 / 97.9 | 5.2 / 97.1 |
| FE2E | 71K | 3.8 / 97.6 | 6.5 / 96.0 | 3.8 / 98.7 | 4.3 / 97.1 | 5.6 / 96.4 |
| Lotus-2 | 59K | 3.7 / 97.6 | 6.7 / 94.1 | 4.1 / 98.6 | 4.0 / 97.2 | 6.5 / 95.5 |
| PPD (1024) | 125K | 4.1 / 97.7 | 7.0 / 95.5 | 4.3 / 98.0 | 4.6 / 97.2 | 6.8 / 95.9 |
| InfiniDepth | 3.1M | 4.3 / 97.6 | 8.7 / 92.3 | 6.1 / 95.4 | 4.7 / 96.9 | 6.4 / 95.8 |
| Marigold V1 | 74K | 5.5 / 96.4 | 9.9 / 91.6 | 6.5 / 96.0 | 6.4 / 95.1 | 10.0 / 90.7 |
| Depth Anything V2 | 62.6M | 4.5 / 97.9 | 7.4 / 94.6 | 13.1 / 86.5 | 6.5 / 97.2 | 6.6 / 95.2 |
最后一行数据量不在同档,原文不参与排名。百万级判别模型里,MoGe在NYUv2上AbsRel是3.1,π³是2.9,都优于V2的3.6 。V2打的是数据量相当的生成式对手,外加ETH3D上从3.8到2.8这一档跨域。
HyperSim测试集上的Soft Edge Error专门看边界。SEE3、SEE5、SEE7,V2是0.352、0.333、0.320,PPD是0.404、0.385、0.371,InfiniDepth是0.470、0.451、0.436。
一张消费级卡上的账
论文在同一张32GB卡上测了延迟和峰值显存。
| 模型 | 1024×1024延迟 | 1024×1024显存 | 2048×2048延迟 | 2048×2048显存 |
|---|---|---|---|---|
| InfiniDepth | 0.2 s | 1.9 GB | 1.2 s | 3.4 GB |
| PPD | 1.4 s | 5.6 GB | OOM | OOM |
| Lotus-2 | 8.9 s | 26.1 GB | OOM | OOM |
| FE2E | 3.9 s | 27.5 GB | OOM | OOM |
| Marigold V2 | 1.9 s | 16.9 GB | 9.6 s | 29.3 GB |
1024分辨率下它比InfiniDepth慢将近十倍,显存也高得多。关掉锐化器的Lotus-2只要1.1秒,仍比它快。
优势在2048。PPD、Lotus-2、FE2E直接爆显存,它还能跑,峰值29.3 GB。模型卡写24GB卡覆盖1024,2048要32GB档。
量化的意义主要在训练和部署都能把大DiT塞进单卡。推理已经是单步,省掉的是多步采样。GitHub清单里Diffusers接入和ComfyUI插件都还没勾。
配方还能干别的
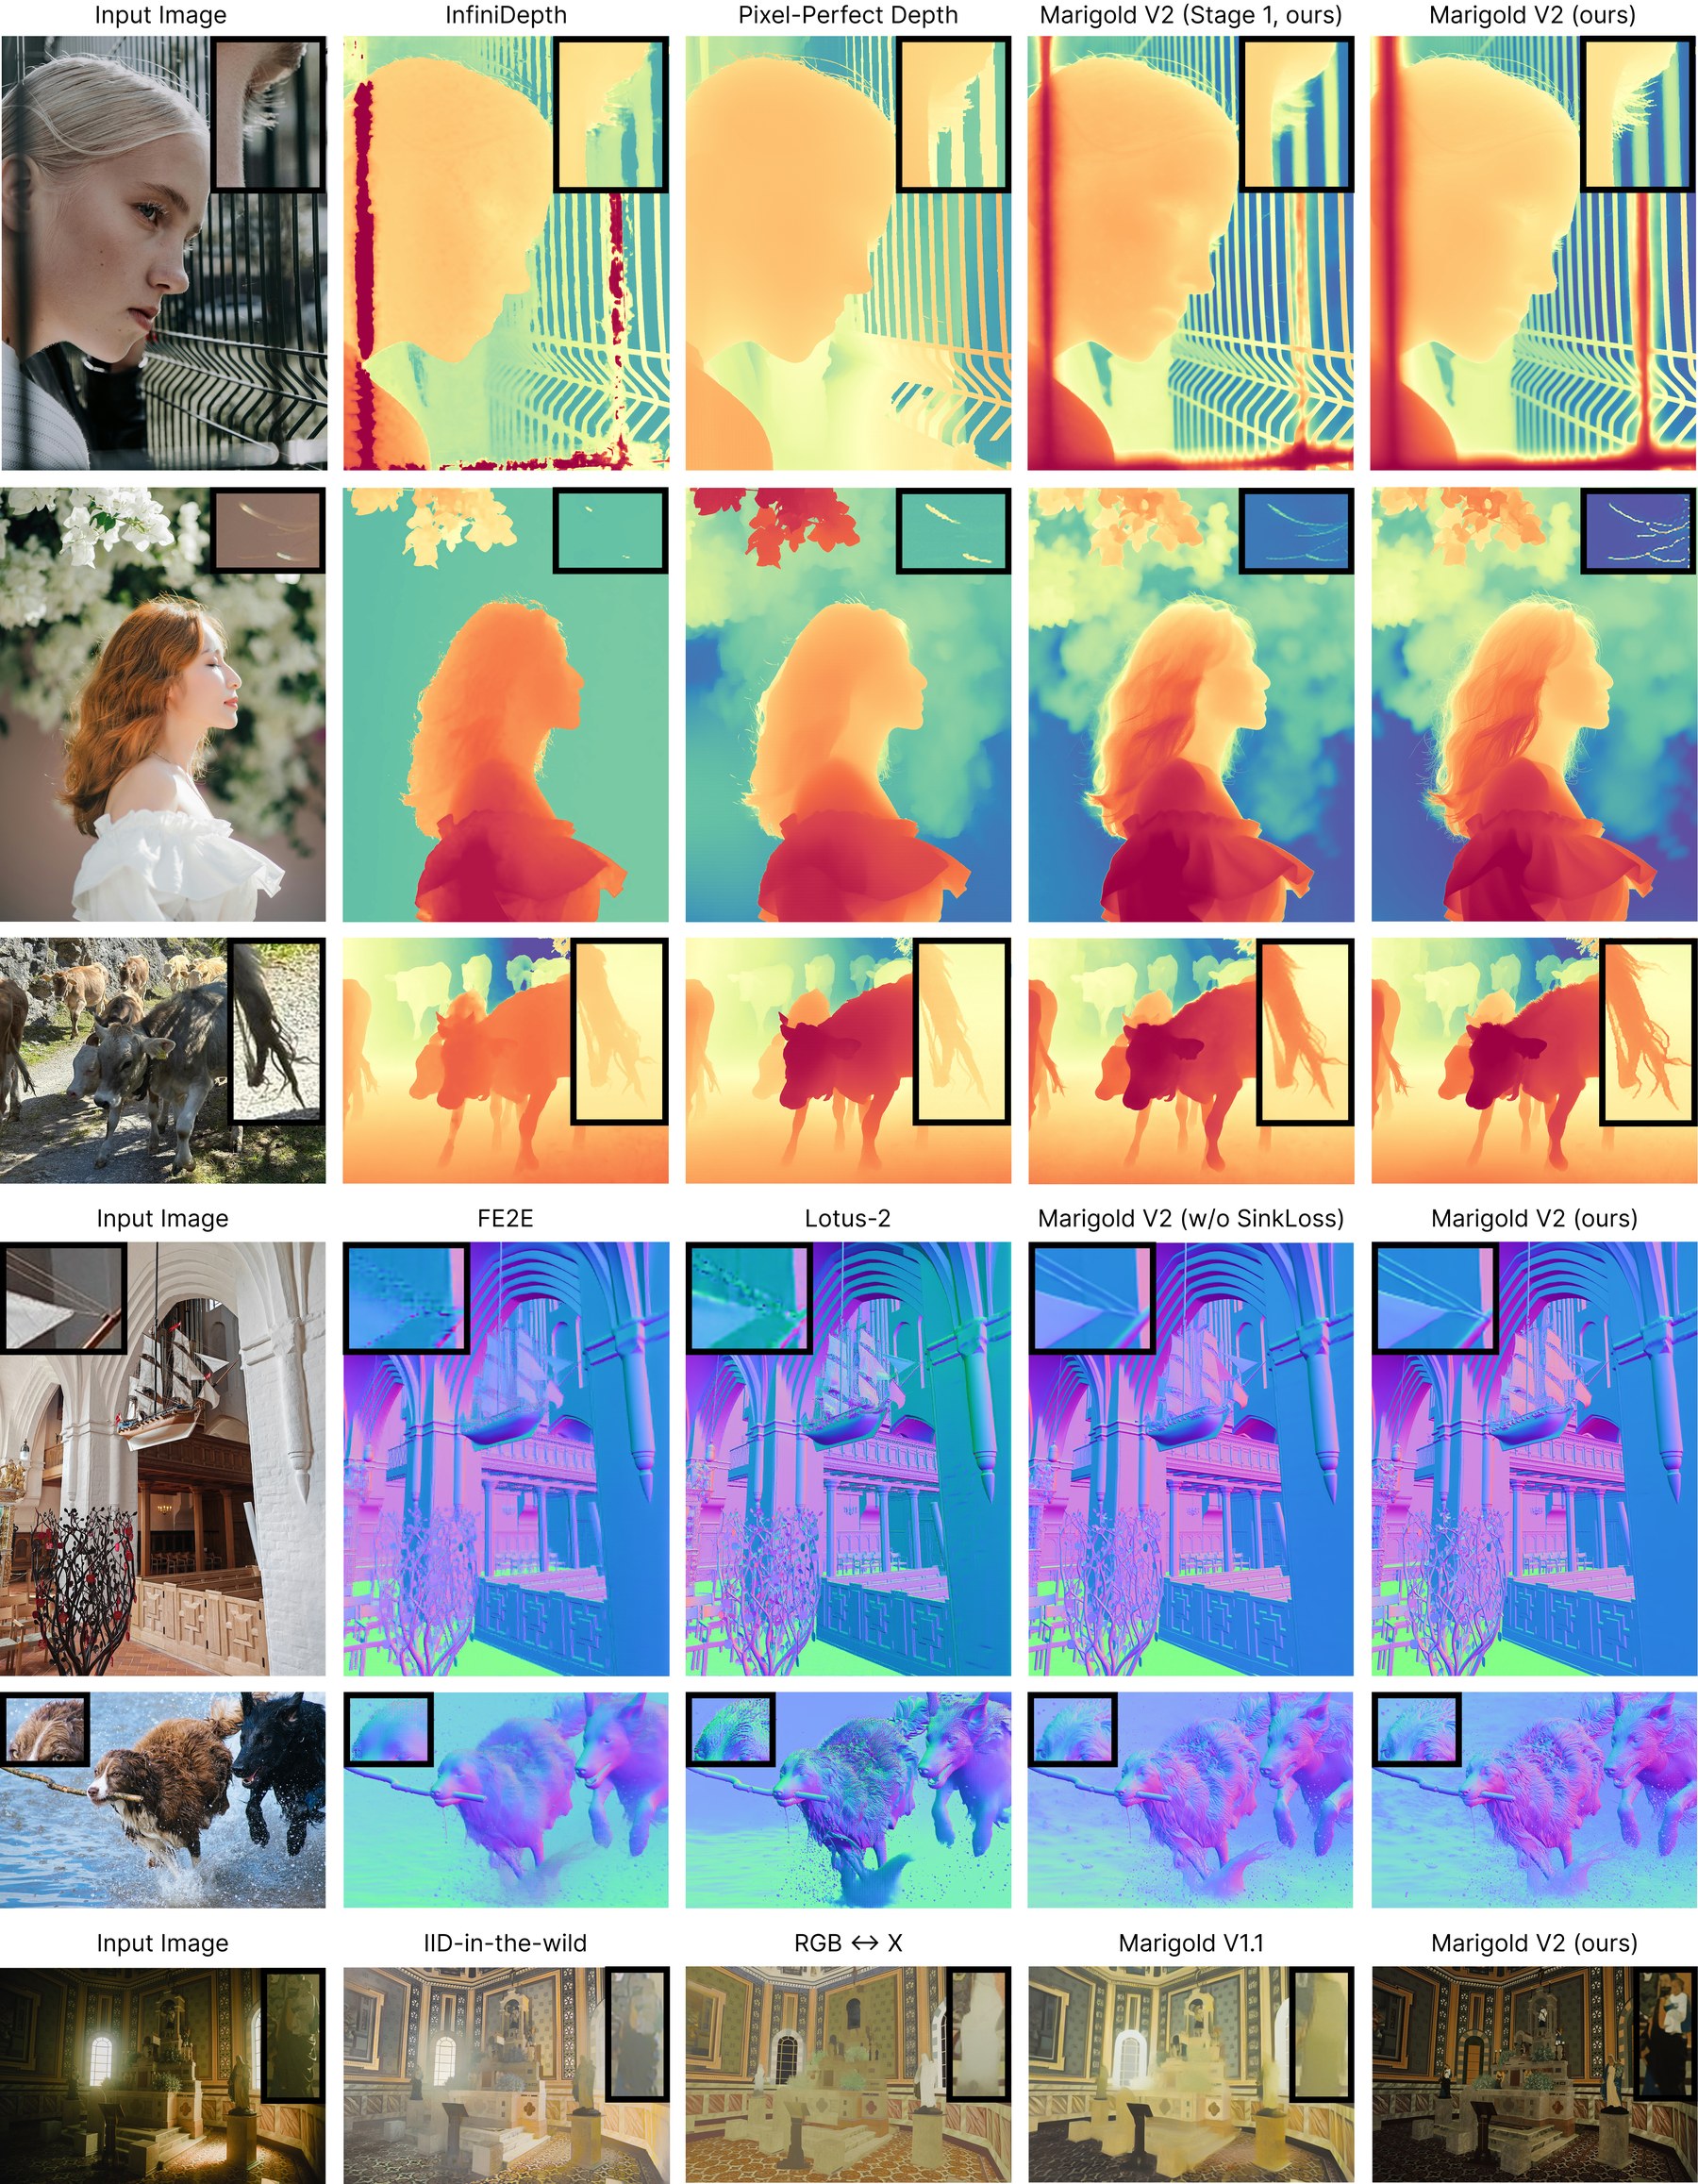
同一套损失换任务头,论文还训了法向、反照率,以及透过玻璃看后面几何的see-through深度。
法向在Sintel上平均角误差28.7,室内NYUv2是16.6,比Lotus-D的16.2和Marigold Normals V1.1的16.1都差一截。室外赢,室内并不全面领先。
反照率在HyperSim测试集上PSNR 20.78、LPIPS 0.195,两项是表里最好。SSIM 0.811,低于IID-in-the-wild的0.819。
see-through用LayeredDepth-Syn的第8层再微调3万步。验证集AbsRel从13.66降到8.17,δ1从83.96升到92.65。基础模型会把玻璃标成近处表面,这是HyperSim标注习惯带来的偏置。
深度补全那张表很长,NYUv2、iBims、KITTI-DC、DDAD上都报了数。它用测试时再挂一个秩16的LoRA去拟合稀疏点,代码仓库清单里Depth completion code仍未勾选。这篇不展开。
本地跑一遍
我没有在本机跑通权重。下面抄的是2026年9月8日仓库README的Quick start,模型卡上的命令与之一致。
bash
git clone https://github.com/huawei-bayerlab/marigold-v2.git
cd marigold-v2
bash setup/setup_env.sh
conda activate marigold-v2

python scripts/download_assets.py --skip-datasets
python scripts/infer.py --image_dir assets/examples --output_dir output/examplessetup_env.sh默认装CUDA 12.8的包,可改成cu126等。--skip-datasets只拉Qwen-Image-Edit-2509和各检查点,评测集要另下。
默认检查点是depth/Log-stage2,也就是论文主模型。指定玻璃后几何可以用--checkpoint指向depth/Log-layered。--modality可选depth、normals、albedo。
README写,1024边长大约17GB显存,2048大约29GB,与论文表6的16.9和29.3对得上。
DiT第一次加载会做4-bit量化,要等几分钟。VAE编码器有采样,同一张图两次结果可能略有差别,--seed默认2025。
文本编码器不用加载。仓库提供了预计算的prompt嵌入。输出是每张图未知尺度和平移的仿射不变深度,不能直接当米来用。
在线可以看Hugging Face Space huawei-bayerlab/marigold-v2-web。
几点看法
V1那套小合成数据加生成先验,在DiT上仍然成立,前提是编辑模型和单步回归把账单砍下来。4-bit QLoRA让32GB单卡训得动。模型卡认为24GB卡推1024分辨率也够。
我更想抄的是SinkLoss的问题定义。细结构上真值不可信时,还用逐像素L1去逼,模型只能学会往点云里飞像素。允许块内置换以后,排行榜数字几乎不动,毛发和叶片反而清楚了。
做深度、法向这种边界敏感任务的人,可以把SEE这类指标和AbsRel放在一起看。
短板论文写得很直。骨干太大,做不到实时。InfiniDepth在1024上0.2 秒、1.9 GB,速度和显存差了一截。
反光、运动、失焦仍然含糊。室内法向也没有全面超过上一代。
想用于机器人实时控制,先要另找更快的模型。这篇留下的是画质和可复现配方。
参考链接
- 论文原文 arXiv 2609.08084 v1,2026年9月
- 代码 huawei-bayerlab/marigold-v2
- 权重 huawei-bayerlab/marigold-v2-0
- 在线演示 marigold-v2-web
- 骨干模型 Qwen-Image-Edit-2509
- 前作 Marigold V1,CVPR 2024
- 对比方案 Lotus-2、Pixel-Perfect Depth代码、FE2E、InfiniDepth,数据见论文表1、表2、表6