论文:Paraformer: Fast and Accurate Parallel Transformer for Non-autoregressive End-to-End Speech Recognition(Gao et al., Interspeech 2022) · arxiv:2206.08317
一句话 :Paraformer 是完整的端到端非自回归(NAR)中文 ASR 系统 (非流式 · 详见 §四)------一次 forward 直接并行出全序列 N 个字。两个关键模块:CIF predictor 累积权重预测 token 数 N 并抽 acoustic embedding · GLM sampler 训练时混合 acoustic 和 target embedding 送 decoder · 让 NAR 学到 token 间依赖。AISHELL-1 test CER 5.2% 打平 AR · 推理 12× 加速 ;工业 20 000 h 中文相对 AR 差 2%-3% · 约 10× 加速。
一、问题与动机
1.1 Paraformer 在整条端到端 ASR 主线上的位置
关键区分:Paraformer 跟 Conformer 不在同一抽象层级 · 别放一起比。前面几篇模型分三层:
| 抽象层级 | 代表 | 说明 |
|---|---|---|
| 预训练主干 | wav2vec / HuBERT / w2v-BERT | 自监督 encoder · 只出 hidden state · 需接下游 CTC head / decoder / transducer 等任务头才是完整 ASR |
| 编码器骨干 | Conformer | encoder block · 堆叠后可接入 CTC / RNN-T / AR AED / NAR AED 任一系统 |
| 完整 ASR 系统 | DeepSpeech2(RNN+CTC)· LAS(AR AED)· Paraformer(NAR AED) | encoder / 声学模型 + 预测头或解码模块 + 训练目标/推理规则全套 · 训完直接部署 |
一句话类比:Conformer 是发动机 · Paraformer 是整台卡车 ------同一台 encoder 可以塞进 AR 系统也可以塞进 NAR。"Conformer 是 AR"指的是 Conformer 论文那个 encoder + AR decoder 组合 · 不是 encoder 本身;Paraformer 用同一层 encoder + CIF predictor + GLM sampler + 并行 NAR decoder(encoder 也可换成阿里自家的 SAN-M)。
1.2 三条主路的分野
端到端 ASR 到 2022 年三条主路:
| 路线 | 全称 | 代表 | 优点 | 核心缺陷 |
|---|---|---|---|---|
| CTC | Connectionist Temporal Classification | Jasper / DS2 | 训练/推理都快 · 帧级条件独立假设 | token 间无显式 LM · 中文同音字歧义严重 · 需要外部 LM 救 |
| AED(AR decoder) | Attention-based Encoder-Decoder(注意力编解码器) | LAS / Transformer / Conformer AED | 精度最高 · decoder 隐式建 LM | 逐字生成、推理慢 · 长句 RTF 线性增长 · 生产延迟难 |
| RNN-T(label-history AR) | RNN Transducer(循环神经网络转换器) | 各种 Transducer | 流式友好 · 精度接近 AED | prediction network 对 label history 自回归 · 每帧 beam 展开 · GPU 上并行度差 |
NAR 想快但精度打不过 AR ------把 AR decoder 换成并行 NAR decoder · 推理快 10-100× · 但精度掉一档 、尤其在大规模工业数据上。原因:vanilla single-step NAR P(y|x) = ∏ P(y_n|x) 假设 token 条件独立 · 没建模 token 间依赖 · 中文同音字("是/事/世")分不开 · substitution 错误暴增。此前 NAR 分 iterative(A-FMLM / Mask-CTC · 多轮慢)和 single-step(LASO / CASS-NAT / CTC-enhanced · 一步出但工业大数据显著差 AR)· 都没解决。
Paraformer 的答卷 ------ CIF predictor 累积 encoder 权重预测 N 并抽 acoustic embedding(修 token 数预测和 hidden 抽取)· GLM sampler(从 NMT borrow)训练时把 target embedding 部分替换 acoustic embedding · 强制 decoder 学"从半个真序列推另半个"、隐式建 LM(修 token 间无依赖)。
二、Paraformer 的构成
2.1 系统位置:端到端 NAR 中文 ASR
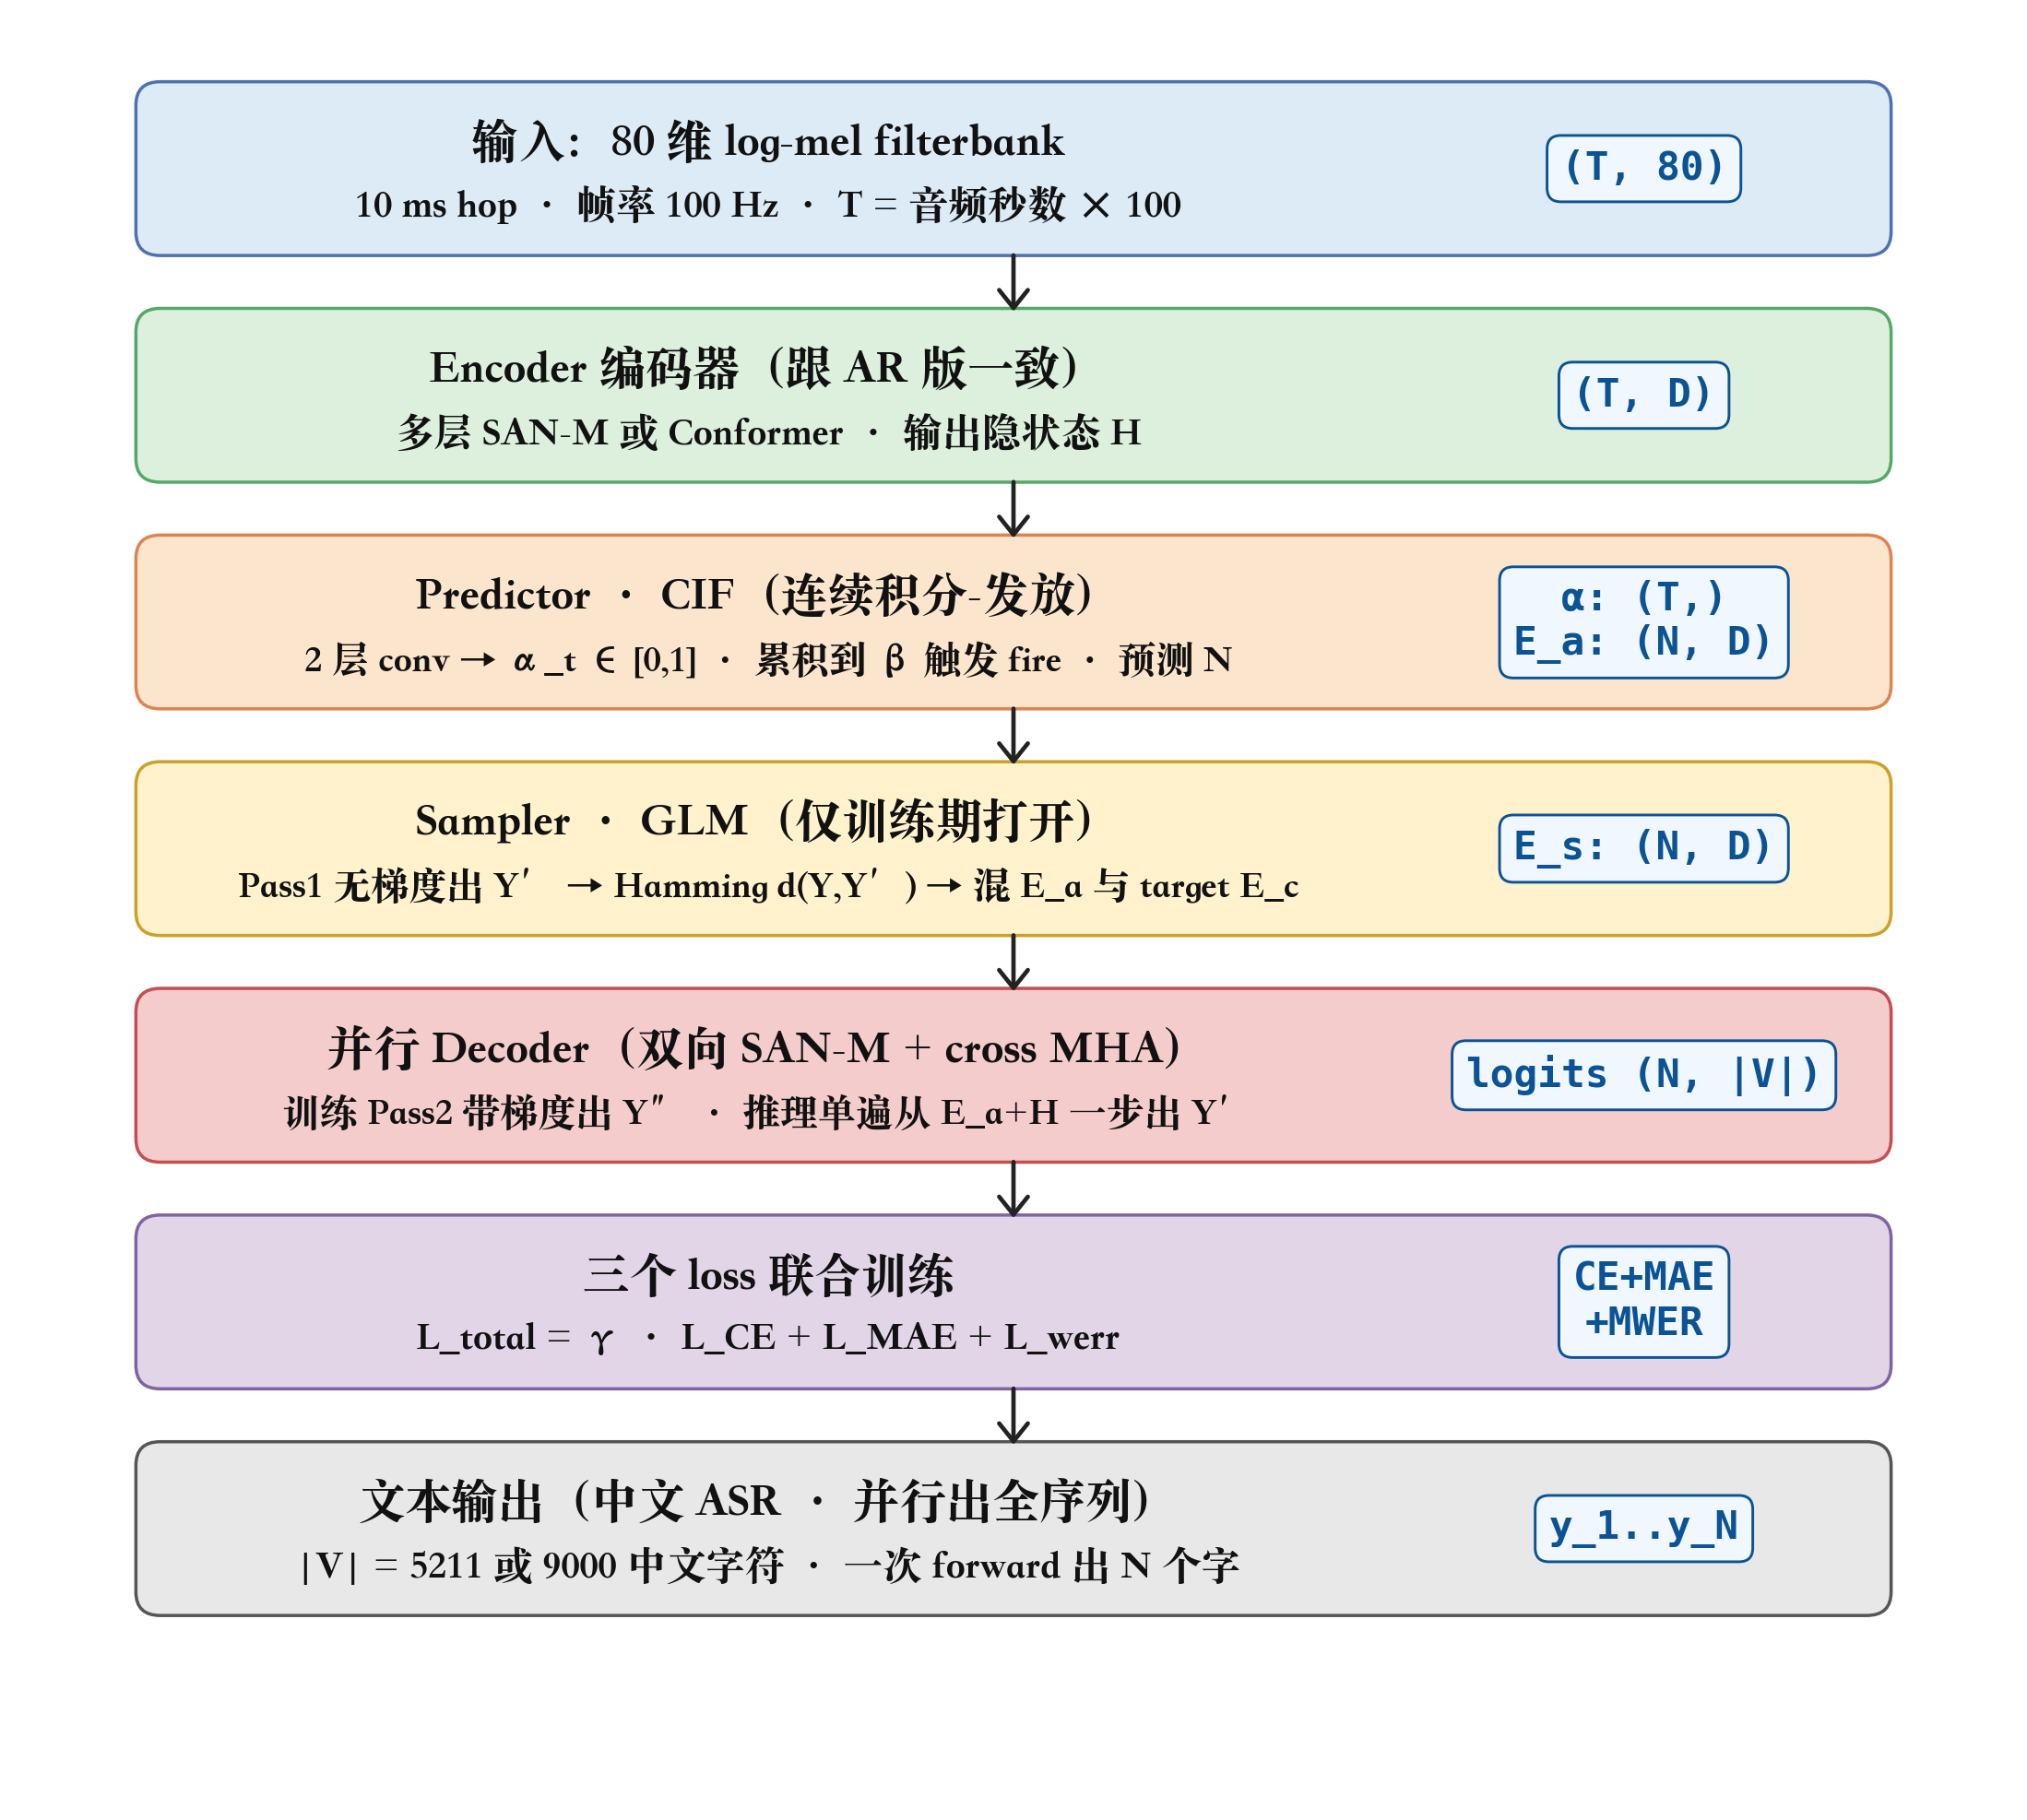
图 1:Paraformer 完整数据流 · encoder 跟 AR 版一样(多层 SAN-M 或 Conformer)· predictor(CIF) 累积权重预测 token 数 N、抽出 acoustic embedding 序列 E_a · 训练期 sampler 混合 acoustic embedding 和 target embedding 得 semantic embedding E_s → 送 decoder; 推理期 sampler 关闭 · decoder 直接以 E_a 为输入单步出 Y'。三个 loss 联合训 · CE + MAE(对齐 N) + MWER(负采样 minimum WER)。
shape 一目了然 :Filterbank (T, 80) → Encoder (T, D)(D=256/320) → Predictor 出每帧权重 α_t ∈ 0,1 + 累积得 acoustic embedding (N, D) → Decoder (N, |V|)。关键 shape 转变 :encoder T 帧 · decoder N 个 token 位置 · N << T(10 秒中文约 1000 帧 vs ~30-50 字)· 这一步压缩靠 CIF 完成。
2.2 整体结构:五段流水线
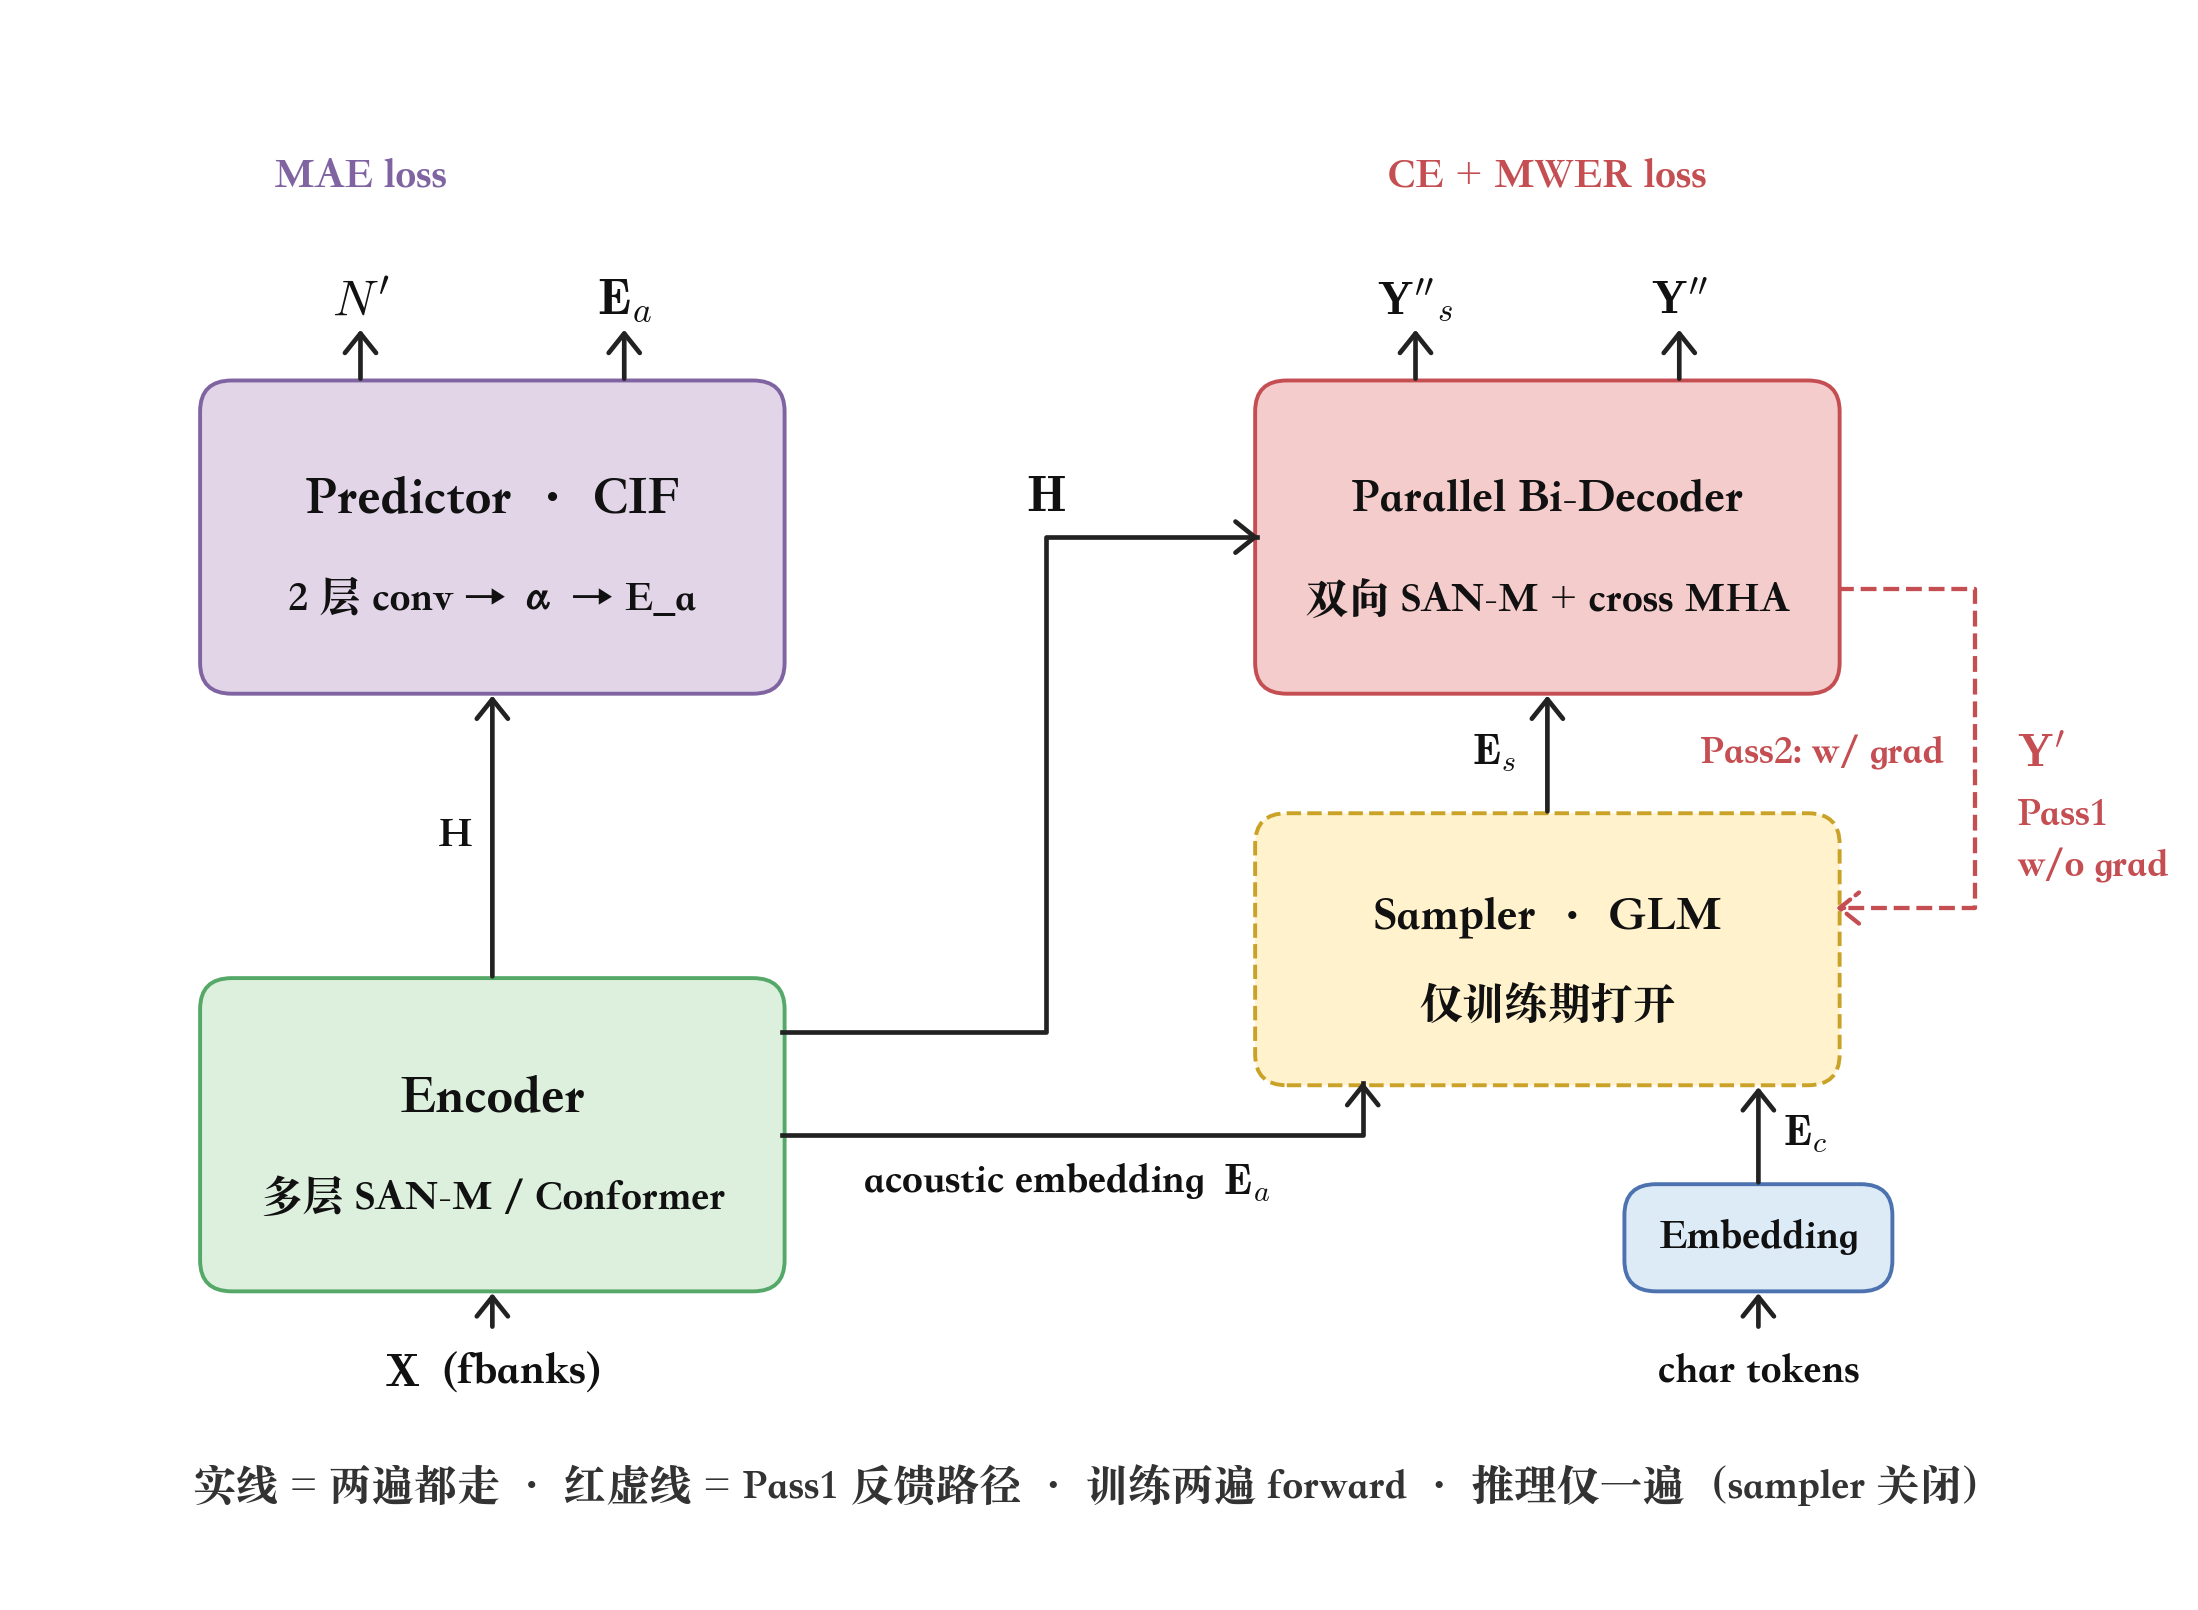
图 2:Paraformer 架构 · 五段:Encoder → Predictor(CIF)→ Sampler(GLM · 训练期)→ Decoder(双向并行)→ Loss(CE + MAE + MWER)。 训练期 decoder 前向两遍 :第一遍无梯度出 Y'(红虚线 · 拿去跟 target 比 Hamming 距离决定 sampler 采样率)· 第二遍带梯度出 Y'' 算 CE loss。 推理期 :sampler 关掉、decoder 只前向一遍、直接从 E_a + H 出 Y'。
下面按 CIF / GLM / bi-decoder / loss 展开。
2.3 CIF predictor:怎么把 T 帧压到 N token
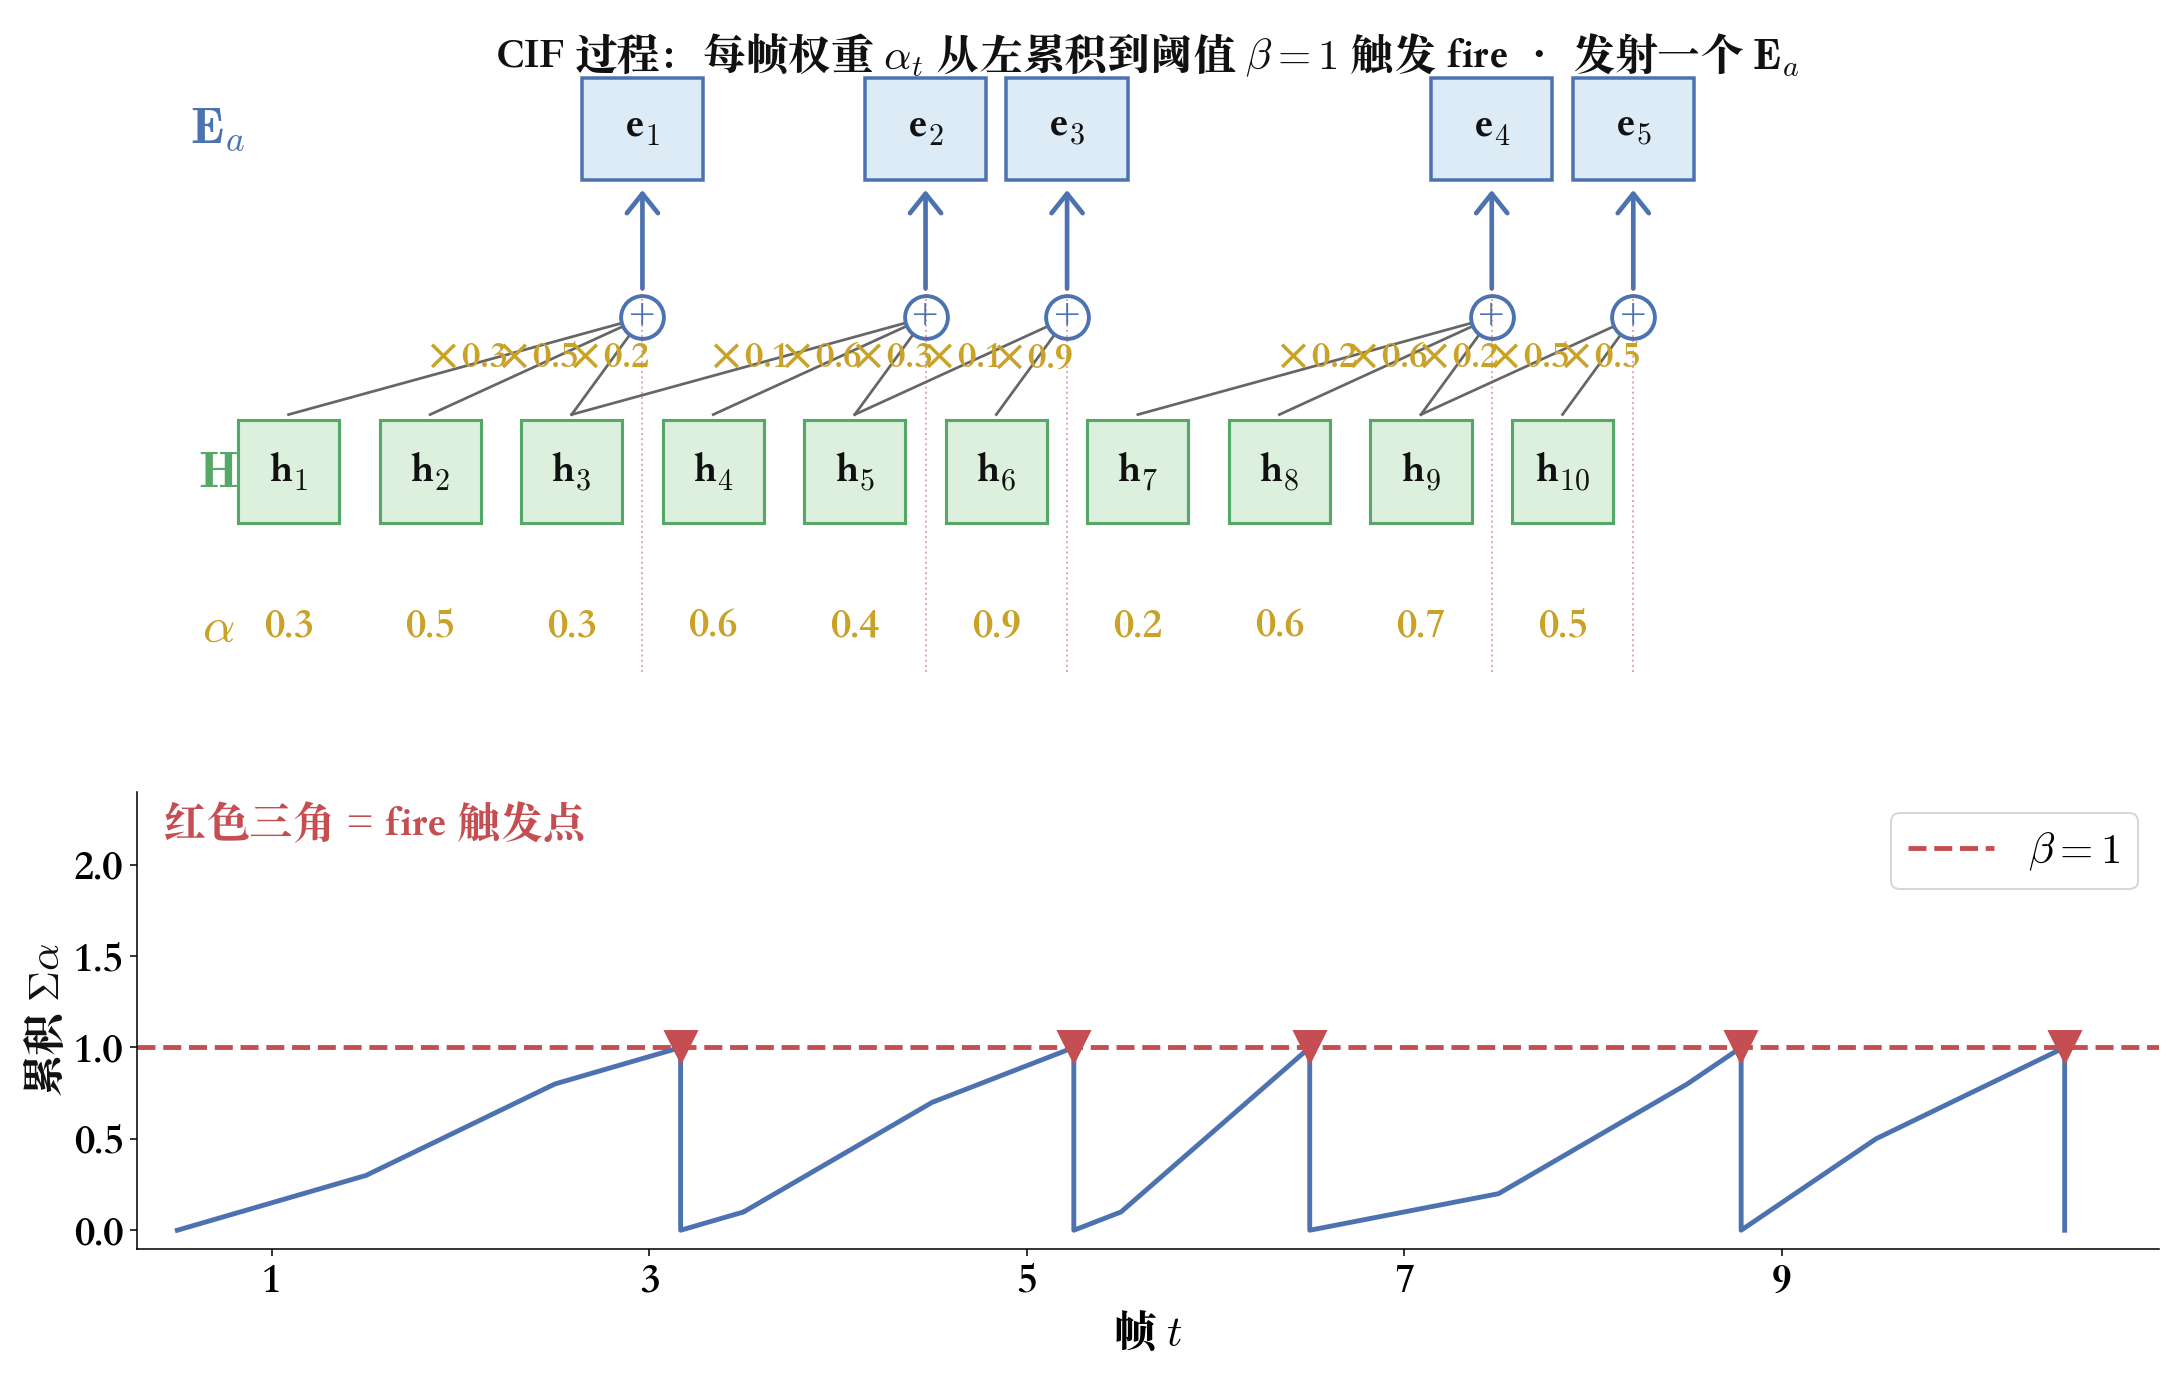
图 3:CIF(Continuous Integrate-and-Fire)过程 · 本图为固定 β=1 的 10 帧玩具示意 · fire 5 次 (Paraformer 正式训练/推理走下面的动态 β · 图里取 1 只为画图方便)。 上 panel :每帧 encoder 隐状态 h_t 配一个权重 α_t(0 到 1 之间)· 从左到右累积 · 一达到阈值 β 就 fire 发射一个 acoustic embedding e_k(e_k 是覆盖到的 h_t 按跨帧权重加权求和)· 触发帧若 α 未用完 · 剩余部分 carry 到下一次累积。 下 panel :累积和随帧数锯齿状上升 · 每次触顶 β 就跌回触发帧未用完的余量(普遍近似为 0)· 红三角标 fire 位置。真实 10 秒语音约 1000 帧 · 累积总和约 30 · fire 30 次 · 对应 30 个字------CIF 做的就是同一种压缩。
ASR 输入是 T 帧、输出 N 字 · NAR decoder 一次并行出 N 个位置 · 必须先知道 N + 给每个位置准备对齐输入向量------这就是 CIF 全部工作。
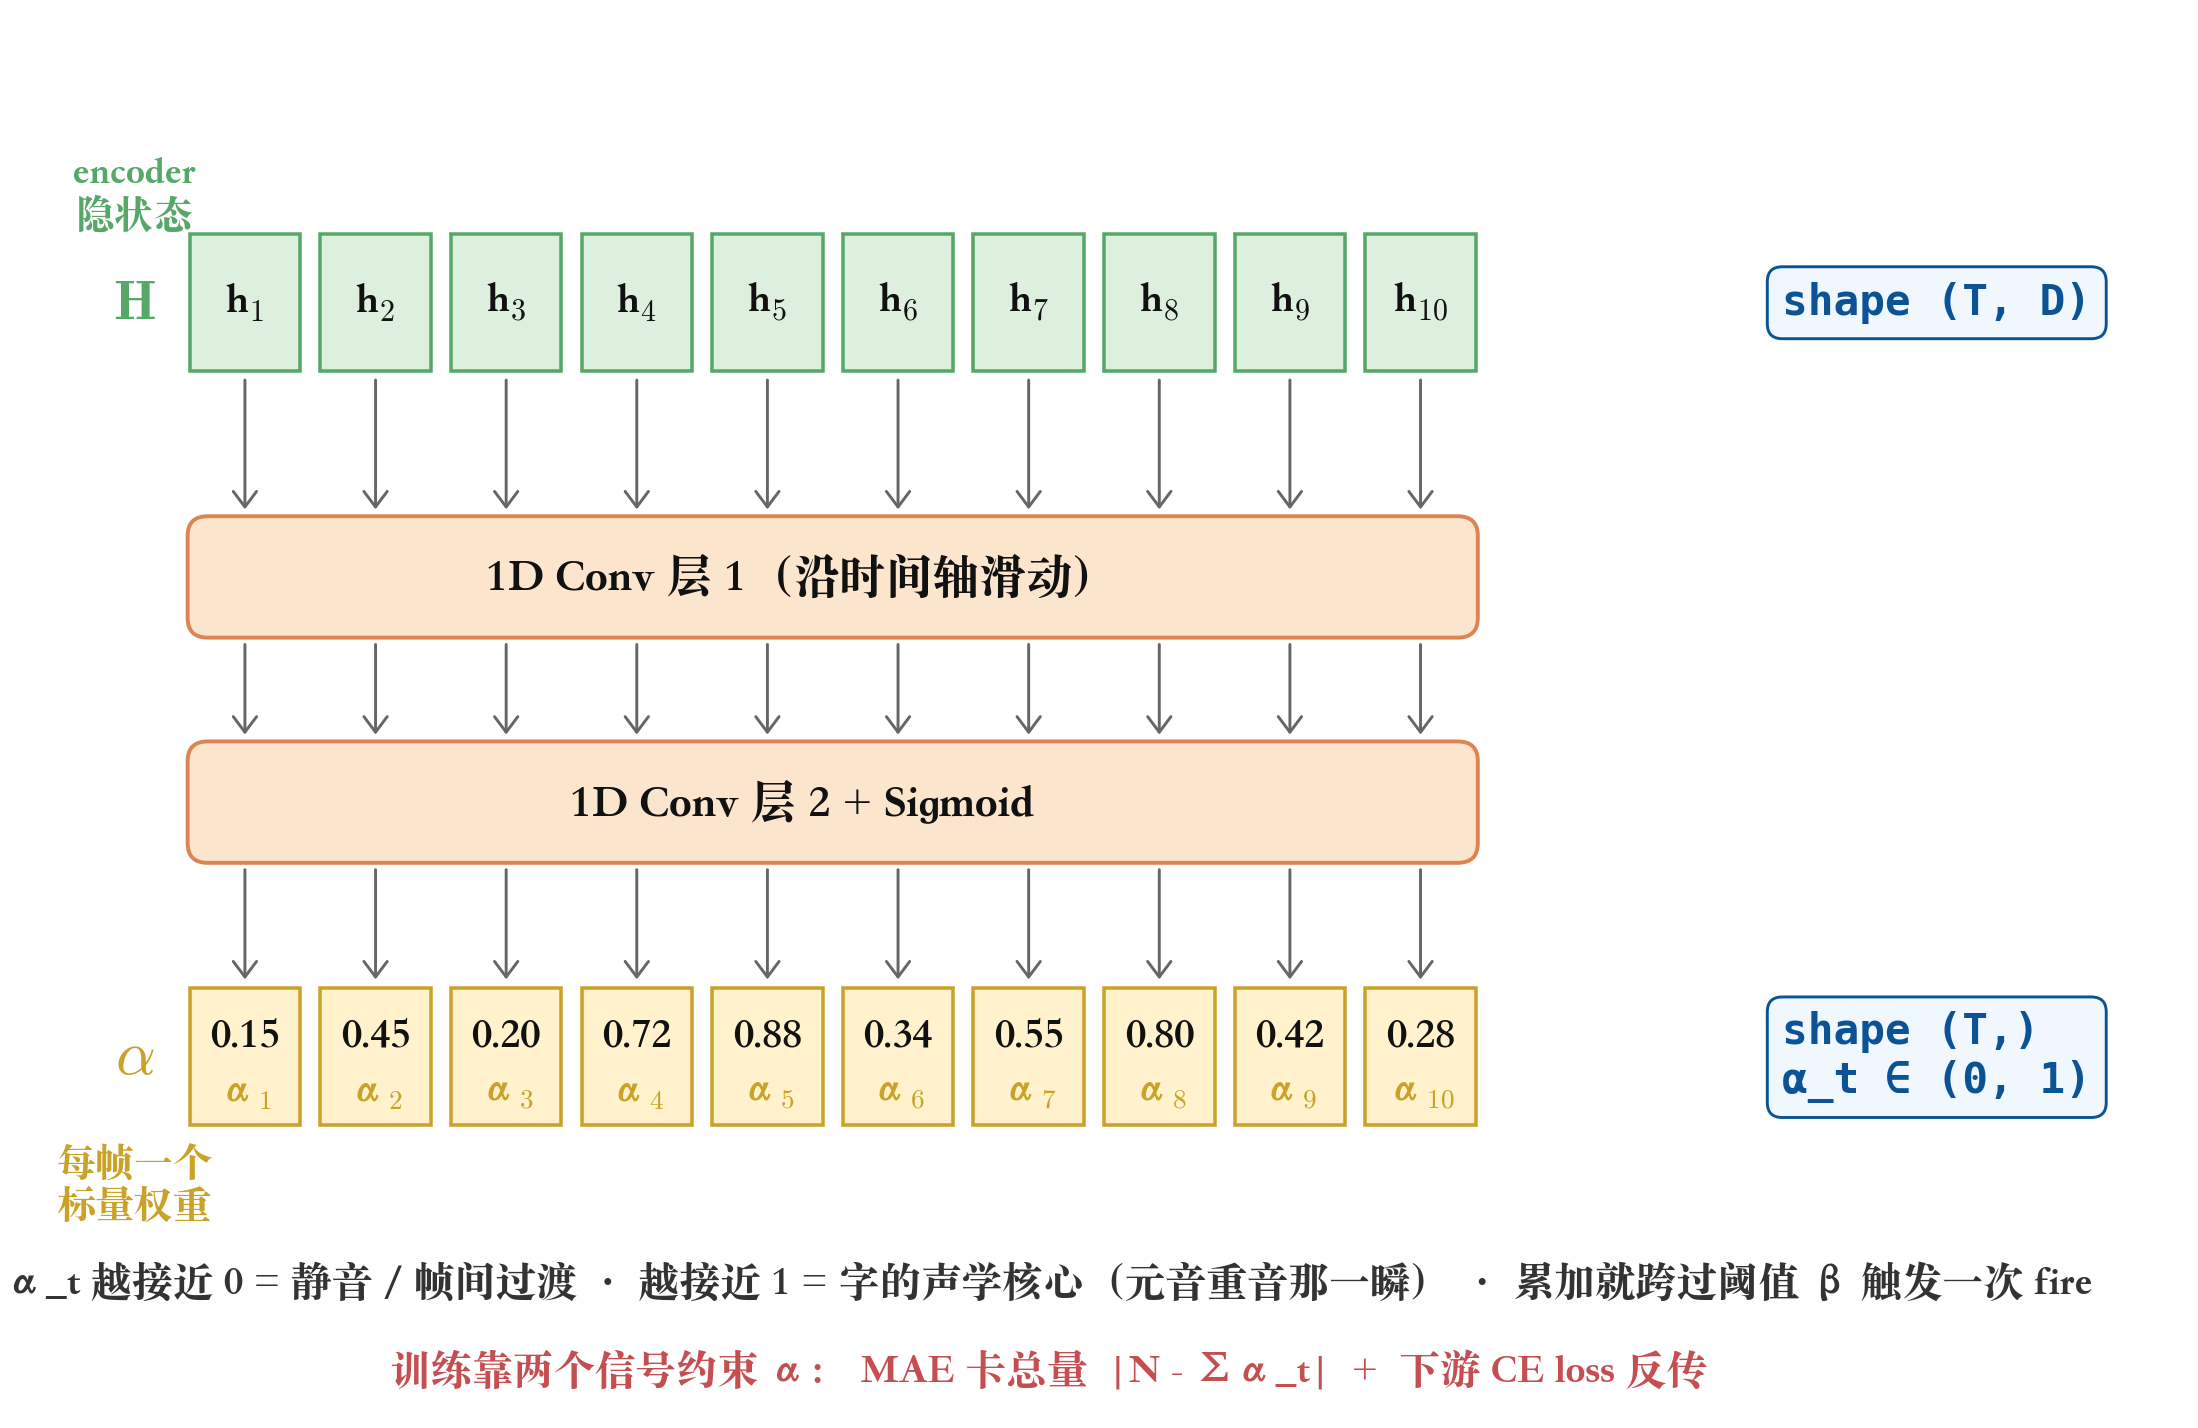
图 4:α_t 计算流程 · encoder 隐状态 H (T, D) → 2 层 1D 卷积(沿时间轴滑)→ 最后一层 sigmoid · 输出每帧一个标量 α_t ∈ (0, 1)。α_t 越大 · 说明这一帧对当前/下一个 token 的 acoustic embedding 贡献越多 · 模型倾向在字/音节的稳定声学片段附近给较高权重。
没帧级监督 · α 靠两个信号约束:(1) MAE loss 卡总量 L_MAE = |N - Σ α_t| 强制 Σα_t ≈ target N;(2) 下游 CE loss 反传 · α 分布不合理时 acoustic embedding 糊、CE loss 变大 · 反传逼 α 重新分配。predictor 由此学到"什么样的声学模式对应字边界即将到来"。
Paraformer 的动态阈值 β ------ 原 CIF(Dong & Xu 2020 · 给流式 AED 用)训练 α 按 target N 缩放 + 固定 β=1 · 推理 α 不缩放 · 训练/推理 mismatch;接 AR decoder 时不显 · Paraformer 完全靠 predictor 定 N 就伤精度。修法:训练/推理都不缩放 α · 都用
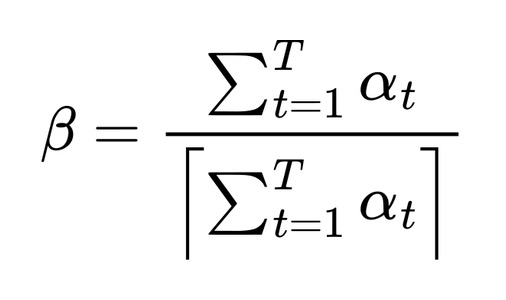
天然让"累积总量 ÷ β = 整数" · 一句正好 fire ⌈Σα_t⌉ 次 · 训练学到的 fire 时机推理直接可用。累积期间参与的 h_t 按贡献权重加权求和为 acoustic embedding · 触发帧未用完的余量 carry 到下次;MAE 拉齐让 N' ≈ target N。
为什么用 CIF · 不直接预测 N ------ NMT 从源句 token 数可直接预测目标句 token 数;ASR 输入是连续声学帧 · 语速/静音/噪声让"帧数 → 字数"极不稳定(10 秒可以 20 字也可以 60 字)。CIF 把"预测 N"分解成"每帧发射多少 token"的连续累积 · 让 α 自己在时序上找字边界。
2.4 GLM sampler:怎么让 NAR decoder 学到 token 依赖
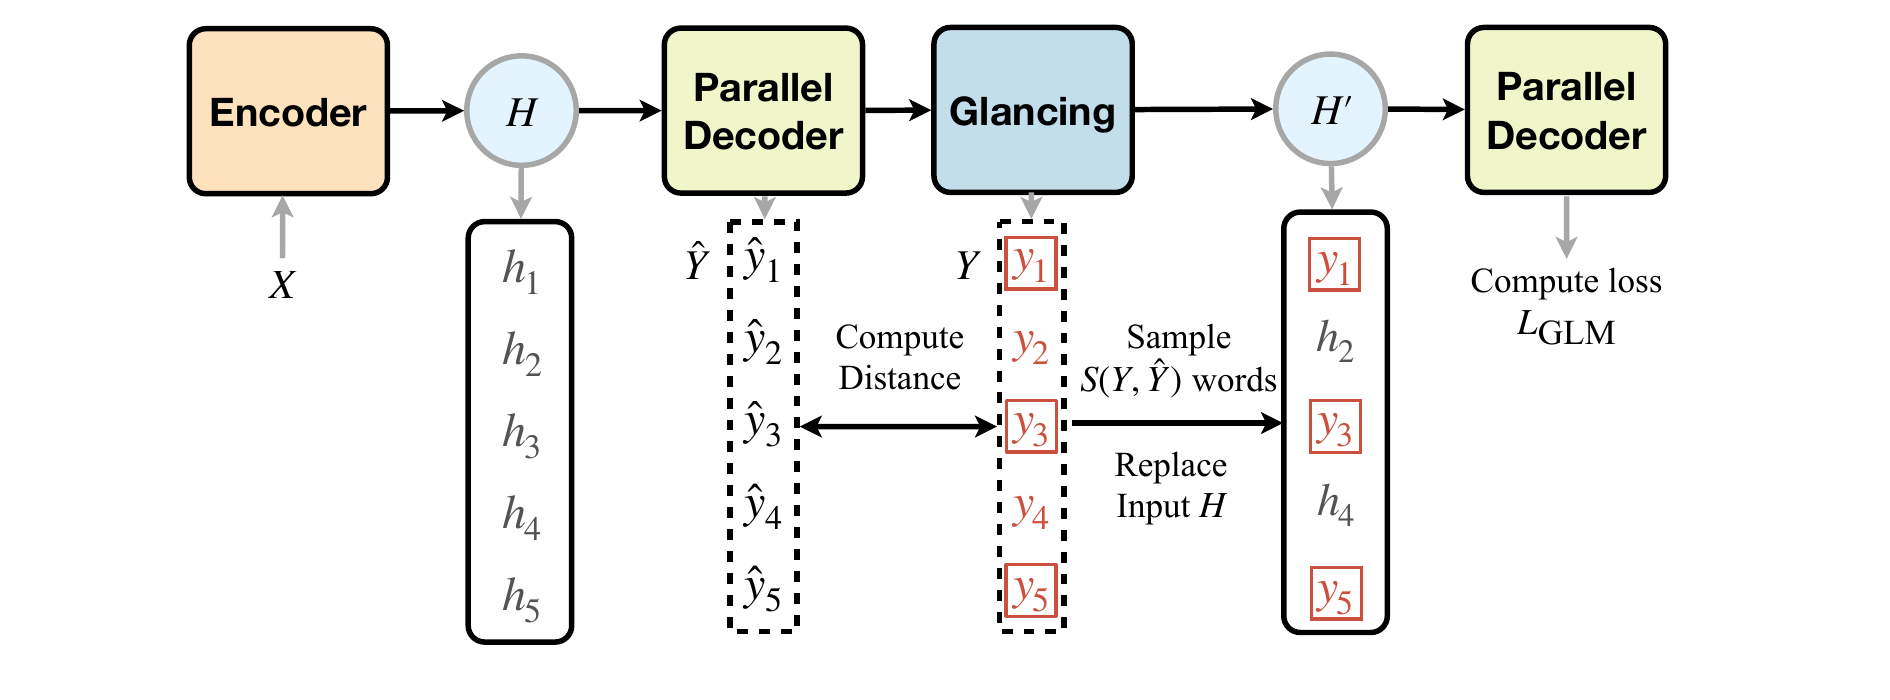
图 5:GLM sampler 训练流程(借用 GLAT 原论文 Fig 2 · Qian et al., 2020 · arXiv:2008.07905)· Paraformer 沿用 GLAT 的 glancing 训练思路 · 把替换对象从 NMT 的 hidden 换成 ASR 里的 E_a / E_c。 流程 :Encoder 出 encoder memory → Parallel Decoder 一遍出 Ŷ = ŷ_1..ŷ_5(无梯度)→ Glancing 模块跟 target Y 算 distance · 采 S(Y, Ŷ) 个位置(红框标出的 y_1 · y_3 · y_5)→ 采中位置放 target embedding · 其余位置保留原 h_i · 得到 H' → Parallel Decoder 二遍从 H' 出结果 · 只在未采位置算 L_GLM。Paraformer 里的对应项:图中 H(decoder 输入)↔ Paraformer 的 E_a · H' ↔ E_s · S(Y, Ŷ) = ⌈λ · d(Y, Ŷ)⌉。(图注中的 H 是 GLAT 原图记号 · 指 decoder 侧输入 · 跟正文里 encoder 输出 H_enc 不是一回事 · 别混。)
先讲清两种 embedding:E_a vs E_c------GLM 全部操作都在混合这两种。
| 名称 | 来源 | 代表什么 | 符号身份是否唯一 |
|---|---|---|---|
acoustic embedding E_a |
encoder + CIF fire 出来 · 每次前向重算 | 一段声学经 encoder 编码后的向量 · "听到什么" | 不唯一 ------shì 的声学向量在符号层面对应"是 / 事 / 世 / 市"都可能 |
target embedding E_c |
nn.Embedding(V, d) 词表查表 · 训练时用 target Y 查表 |
词表里某个字符号的学得表示 · "标准答案是什么" | 唯一------给定字 ID · 查表结果确定(符号身份唯一 · 不代表跟其它字向量在空间里完全可分) |
在本文讨论的 GLM sampler 训练机制里 · E_c 依赖 target Y · 只在训练期 用于替换 · 标准推理路径没有 target · decoder 输入直接来自 E_a(迭代式 NAR / rescoring 等变体不在讨论范围)。GLM 采样一句话 :训练时把 target 里随机若干位置的 E_c 直接塞进 decoder 的输入序列(其余位置照常放 E_a)· 输入长度不变(还是 N)· decoder 通过 self-attention 蹭到这些真 token 的信息、隐式学到 token 之间的依赖。
vanilla NAR 为什么不够 · 同音字场景 ------ 朴素 NAR 目标 L_NAT = Σ log P(y_n | X) 让每个 y_n 只条件于整段声学 X · 不条件于其它 token · token 侧条件独立。中文同音字直接吃亏:"我 是 学 生"位置 2 发音 shì · 候选"是/事/世/市"声学几乎一样 · 没 GLM 时邻居也都是声学向量 · 只能靠模型学到的先验硬猜。GLM 训练把某些位置替换成明确的真 token(下文例子)· decoder 通过 self-attention 学到"看邻居 token 消歧"这条能力。推理时虽拿不到真 token · 训练诱导出的 self-attention 依赖仍能借力------弱于训练期真 token · 但分布上更靠得住。
具体例子 · 一次前向到底做了什么 ------ target Y = "我 是 学 生"(N=4)· 采样因子 λ = 0.75。decoder 两套输入 embedding:
| 位置 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
E_a(CIF 出的声学向量) |
e_a1 |
e_a2 |
e_a3 |
e_a4 |
E_c(target 查表) |
emb(我) |
emb(是) |
emb(学) |
emb(生) |
Pass 1(无梯度 · 只估错误数) :decoder 以 E_a 作输入 · 对 encoder 输出 H_enc 做 cross-attention · 出预测 Y'。假设模型把位置 2 的"是"预测成"事"------Y' = 我 事 学 生 · Hamming 距离 d(Y, Y') = 1。sampler 采 ⌈λ · d⌉ = ⌈0.75⌉ = 1 个位置------从全部 N=4 个位置里随机采 · 跟 Pass 1 对错无关 (GLAT 默认均匀采样)。假设采到位置 3------注意采中的可能是 Pass 1 已经对的位置 ------sampler 只用 d 决定采样量、不限定具体采哪个。
构造 pass 2 的输入 E_s------位置 3 填 E_c = emb(学)、其余保持 E_a。Pass 2(带梯度) :decoder 以 E_s 作输入 + cross-attention 到 H_enc · 位置 2 self-attention 看到位置 3 的硬答案 emb(学) · 梯度把"是"概率推高、把同音字"事/世/市"压低。
CE loss 只在"没被采中的位置"上算------本例是位置 1、2、4;位置 3 已把真答案塞进输入 · 输出复读没信息量。论文定义:
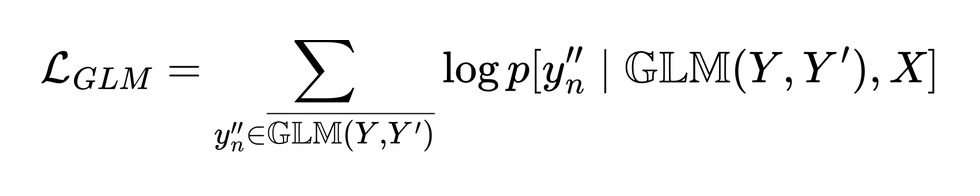
课程学习 ------ 采样量 ⌈λ · d⌉ 里的 d 是当前 Hamming 错误数:模型烂时 d 大 · 采样多(多提示 · 好学);模型好时 d 小 · 采样少(逼 decoder 靠自己 · 向推理分布靠近)。λ = 0.75 是本文示例口径 · 论文显示 λ 在一定范围内较稳;太大训练暴露过多 target · 训练/推理分布差距变大伤精度。
推理时怎么办 ------ sampler 关闭 · E_s = E_a · decoder 一遍前向从 E_a + H_enc 出 Y'。不喂预测 token(跟 iterative NAR 不同)· 只留下训练诱导的 self-attention 依赖 · 比训练期真 token 提示弱。
2.5 Parallel Bi-Decoder:并行 decoder 的内部结构
论文没画 decoder 内部图;差异只在两处 mask + 输入 · 见图 6。
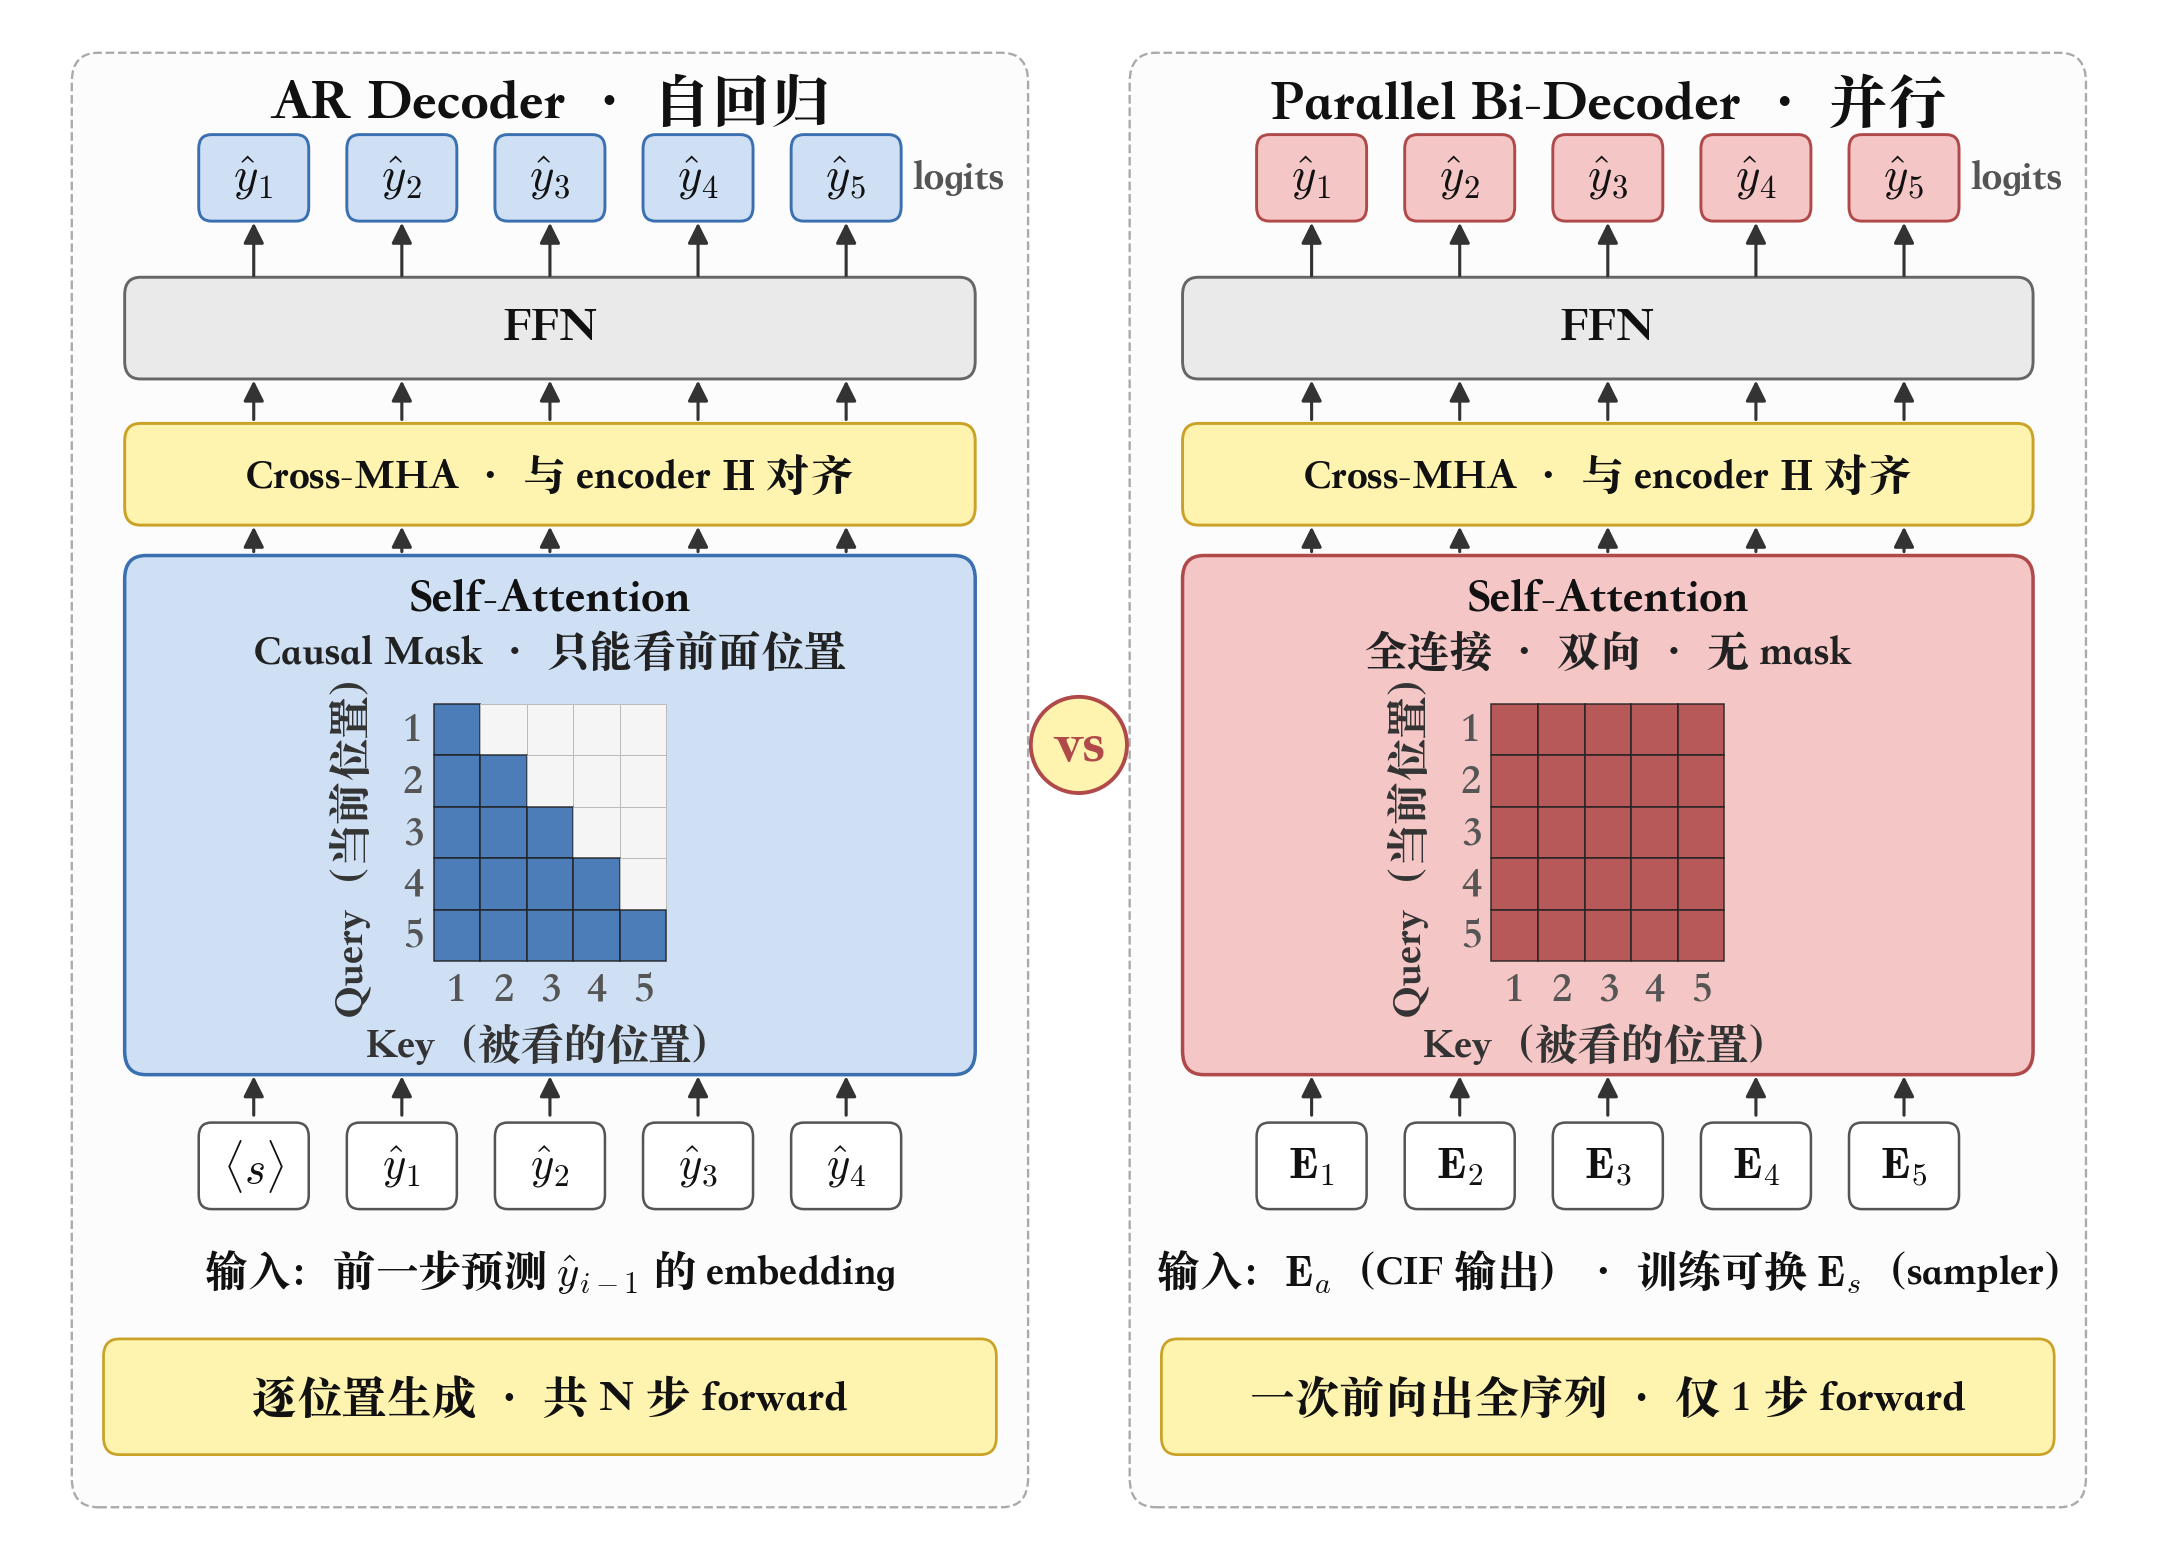
图 6:AR Decoder(蓝,左)vs Parallel Bi-Decoder(红,右)内部对比。 两处差异 :(1)self-attention mask ------AR 是下三角 causal mask(位置 i 只能看 1..i-1)· Bi-Decoder 全连接双向(每个位置能看所有位置);(2) 输入 ------AR 推理时 每步接收前一步预测 ŷ_{i-1} 的 embedding · 所以 N 步 forward(训练可用 teacher forcing 并行算 loss · 但 causal mask 保持单向)· Bi-Decoder 每个位置接收 CIF 输出的 E_a(训练期 sampler 可换成 E_s)· 一次前向出全序列 N 个位置的 logits。SAN-M / Cross-MHA / FFN 块结构两侧一样。
2.6 三个 loss 联合训练
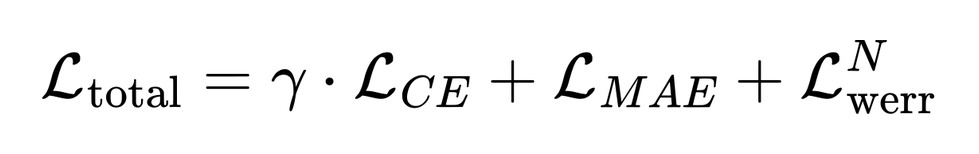
L_CE------ decoder 第二遍 forward Y'' 的 cross-entropy(只在没被 sampler 选中的位置算 · 也就是 E_s 里还是 E_a 的那些位置)L_MAE------ predictor 的 N 预测 loss ·|N - Σ α_t|L_werr------ MWER(Minimum Word Error Rate)loss · NAR greedy 只有一路 · 论文用随机 mask top-1 token 造多条负样本候选路径 · 跟 target 比 WER · 期望值作 loss(路径数是 sample 出来的负例数目 · 跟 token 数 N 无关)
三、实验
数据 & 配方 :AISHELL-1(178 h)· AISHELL-2(1000 h)· 20 000 h 内部工业中文 (多域)· Paraformer / AR / Vanilla NAR 对照无外部 LM · 无预训;工业 CTC baseline 例外是带 LM 的传统 DFSMN-CTC-sMBR。
主结果 · AISHELL 学术(CER · 无 LM):
| Method | AR/NAR | AISHELL-1 dev/test | AISHELL-2 test_ios | RTF |
|---|---|---|---|---|
| CTC-Enhanced NAR | NAR | 5.3 / 5.9 | 7.1 | 0.0037 |
| Improved CASS-NAT | NAR | 4.9 / 5.4 | --- | 0.0230 |
| Paraformer(Ours) | NAR | 4.6 / 5.2 | 6.19 | 0.0168 / 0.0026 |
| Ours · AR baseline | AR | 4.7 / 5.2 | 6.18 | 0.2100 |
读数 :Paraformer test CER 5.2 打平 AR baseline · 推理 12× 加速(0.0168 vs 0.2100);batch=8 时 RTF 0.0026(batch 内均摊 · 非同 batch 严格对照)。
主结果 · 工业 20 k h(CER · Far-field / Common):
| Method | Params | RTF | Far-field | Common |
|---|---|---|---|---|
| CTC baseline | --- | --- | 17.71 | 9.93 |
| AR SAN-M | 41 M | 0.067 | 13.76 | 7.75 |
| Vanilla NAR | 41 M | 0.007 | 16.39 | 9.35 |
| Paraformer(GLM) | 41 M | 0.007 | 14.17 | 7.98 |
| Paraformer(GLM + MWER) | 41 M | 0.007 | 14.07 | 7.86 |
| AR SAN-M-large | 63 M | 0.094 | 12.57 | 7.55 |
| Paraformer-large(GLM + MWER) | 63 M | 0.009 | 12.93 | 7.71 |
读数 : - 41 M · vanilla NAR 相对 AR 差 19% (16.39 vs 13.76 · Far-field) - 加 GLM · 相对 vanilla NAR 提升 13.5% · 加 MWER 再提 0.7% → 14.07 · 跟 AR 13.76 差 2.2% 、推理 10× 加速 (0.067 → 0.007) - 63 M :Paraformer 12.93 相对 AR 12.57 差 2.9% · 10× 加速;跟 41 M AR 比 · 相对提升 6% + 加速 7×
消融 :λ ∈ {0.2, 0.5, 0.75, 1.0, 1.5} 扫过 · λ=0.75 最优;动态 β 相对固定 β · Far-field 从 14.39 降到 14.17。
四、流式支持:Paraformer 本身不流式 · FunASR 里另有流式变体
Paraformer 原版非流式 ------设计上的硬约束、不是没跑通。两条原因:(1) 双向 decoder 一次前向 attend 到全部 N 个位置 · 结构上不允许"只看前 k 个 E_a";(2) 原版按整句用 CIF · 训练/推理都在 utterance 级累积 α · 结合双向 decoder 把系统钉在非流式(CIF 机制本身流式友好 · 原论文就是为流式 AED 提出的 · 但要流式化得走 chunk 内累积重设计)。
FunASR 里的流式变体 :阿里另做了 Paraformer-Streaming (或走 SCAMA )· 把 encoder / CIF 都改成 chunk-aware(chunk 内自注意力 + 有限右向 lookahead · CIF 在 chunk 内 fire)· 换来 chunk-level 延迟。跟原版是两个模型------本文只讨论原版。
五、局限与分析
- 只跑中文(AISHELL + 内部)· 英文 / 多语种没验证
- 训练期 decoder forward 两遍 · 训练比 AR 慢一档(论文没报官方数字)
- λ 采样因子和动态 β 都是经验值 · 迁到新语料需重扫
- GLM 从 NMT 借来 · 迁到 ASR 后是否受语音重复 / 同音字 / 字符级建模影响 · 论文没展开
- 非流式(见 §四)· 流式版本是独立训练的另一个模型
架构意义 · 在本文中文场景里 · GLM sampler 让 single-step NAR 接近 AR;跨语种和大规模多语仍待验证。