论文:w2v-BERT: Combining Contrastive Learning and Masked Language Modeling for Self-Supervised Speech Pre-Training(Chung et al., ASRU 2021) · arxiv:2108.06209
一句话 :w2v-BERT 是端到端语音 SSL 预训框架 ------把 wav2vec 2.0 的 contrastive 和 BERT 的 MLM 合成一条 Conformer 管线同时训 。前段学 codebook 把连续帧离散成 token · 后段用被 mask 位置的 context 预测 token ID · 输出每帧 1024 维上下文化表征、下游接 LSTM + RNN-T 做 ASR。LibriSpeech test-other 无 LM 2.8 · 带 LM + self-training 2.5 、比同参数 HuBERT / wav2vec 2.0 都低。核心洞察:contrastive 不是可有可无------去掉它 codebook 会塌缩到全打同一个 code、MLM 退化成 trivial solution。
一、问题与动机
1.0 预备:什么是"语音自监督预训"
自监督预训 (Self-Supervised Pre-training · SSL)核心是用无标签数据训一个通用 encoder ------训练时不需要人工转录、只用波形本身;训练目标是从波形里挖出内生的监督信号、让模型自己给自己出题。
语音场景的"自出题"三条思路:
| 思路 | 出题方式 | 类比 |
|---|---|---|
| contrastive | 从波形抽一帧当"锚点"、再抽另几帧当"干扰项"·让模型把锚点认出来 | 从一堆照片里认出朋友 |
| masked prediction(MLM) | 遮住一段波形、让模型从上下文猜遮住的内容 | BERT 完形填空 |
| generative | 让模型逐帧预测下一帧波形 | GPT 语言模型 |
为什么值得做 · 语音 ASR 长期被标注瓶颈限制------1 小时英文录音要 15-20 人工小时才能转出高质量文字。SSL 承诺:用 10 万小时无标签波形预训一次 · 下游 10 分钟标注就能拉出能用的 ASR------这个 promise 从 2019 wav2vec 1.0 起就在验证、到 2021 w2v-BERT / HuBERT 时已经落地。
跟"从零训 ASR"的分工:
| 阶段 | 需要数据 | 学什么 | 迁移到下游 |
|---|---|---|---|
| 预训(SSL) | 只要波形(几万到几十万小时) | 通用每帧向量表征 | 冻结主干、抽 feature 用;或整体 fine-tune |
| fine-tune(有监督) | 波形 + 转录(几十到几千小时) | 波形 → 文字的映射 | 直接部署 |
这篇论文(w2v-BERT)只做预训阶段 ------fine-tune 只是验证预训质量的手段(LibriSpeech 960h + RNN-T decoder);本质创新在如何用无标签数据学出更好的通用表征。
1.1 语音 SSL 的发展脉络(2019-2021)
这篇论文出现前 · 语音自监督预训已经跑了两年多、四代方法演进出两条主线(contrastive 派 和 MLM 派)· 各自走到了瓶颈:
| 时间 | 代表 | 输入/前端 + 上层主干 | 关键机制 | 遗留问题 |
|---|---|---|---|---|
| 2019 | wav2vec 1.0 | raw waveform + CNN | future-frame contrastive prediction | 表征弱、下游 fine-tune WER 高 |
| 2019 | vq-wav2vec + DiscreteBERT | raw waveform + CNN + Transformer | 先训 VQ 离散化 · 再冻结 · 上层 BERT MLM | 两阶段分离 · quantizer 冻结后无法回补错误 |
| 2020 | wav2vec 2.0 | raw waveform + CNN frontend + Transformer | quantizer + contrastive 端到端联合训 | 只有 contrastive · 没享受 MLM 的"从上下文推 target"能力 |
| 2021-06 | HuBERT(part7) | raw waveform + CNN + Transformer | 外部 offline k-means teacher · 只在 masked 位置算预测 loss · iterative refinement | 多阶段管线 · 每轮跑 k-means · 启发式设计多(cluster 数、抽哪层) |
| 2021-06 | w2v-Conformer | raw waveform + CNN + Conformer | wav2vec 2.0 换 Conformer 主干 | 仍只 contrastive · 没 MLM |
| 2021-08 | w2v-BERT(本文) | 80-mel filterbank + conv subsampling + Conformer × 2 | contrastive + MLM 同时端到端 | ------ |
两个观察 : - 主干在换 :CNN → Transformer → Conformer(part6 的产物),端侧和 SOTA 都跟着 Conformer 走了一波 - 代理任务的组合方式没定 :contrastive 单独跑、MLM 单独跑、还是同时跑?两阶段分离、iterative refinement、还是完全端到端?------这才是核心分歧
1.2 两条主线各有痛点
把上面 6 篇按代理任务组织方式重新分组、看核心缺陷:
| 路线 | 代表 | 优点 | 核心缺陷 |
|---|---|---|---|
| 两阶段分离 | vq-wav2vec + DiscreteBERT | 简单直接 · quantizer 单独训 | quantizer 冻结后 MLM 无法回补错误 · 差 token ID 拖垮下游 |
| iterative refinement | HuBERT | 简单 k-means teacher + BERT 主干 | 训练分多轮 offline clustering + 预训、每轮要跑 k-means · 工程管线复杂 · 启发式设计多(每轮 cluster 数、抽哪层特征) |
| 端到端 contrastive(无 MLM) | wav2vec 2.0 / w2v-Conformer | 一条端到端管线 · 表征质量好 | 只有 contrastive、没享受 MLM 的"从上下文推 target"能力 |
卡在哪儿 :能不能把 wav2vec 2.0 的 contrastive (学 codebook)+ BERT 风格 MLM (学表征)合成一条端到端管线?两个 loss 同时训、避免 HuBERT 那种多阶段 offline k-means 循环、也避免 vq-wav2vec 那种冻结分离。
1.3 w2v-BERT 的答卷
contrastive module 学 codebook + MLM module 学表征 ------两个 module 都是 Conformer 栈、串联在一起、两个 loss 同时反传。关键洞察 :contrastive loss 不是可有可无 ------去掉它、MLM 会退化到"quantizer 给所有 mask 位置发同一个 code · MLM 无脑预测那个 code · loss 归零 · 表征全崩"(论文 §5.2 消融实测)。contrastive 的角色是让 codebook 保持 discriminative、防止 MLM 找 trivial solution。
跟同期 HuBERT 的关系 :两篇几乎同时发(HuBERT 2021-06 · w2v-BERT 2021-08 · 分属 Meta / Google)· 不是继承而是并行 ------都在回答"MLM 需要一个稳的 target"这个共同问题、但一个走外部 offline k-means teacher · 一个走内部可训 quantizer + contrastive 挡塌缩。§四会展开这两条路线的分工。
二、w2v-BERT 的构成
2.1 系统位置:端到端 SSL 预训主干
w2v-BERT 是端到端 ASR 系统里的预训主干 ------预训阶段以海量无标签音频为输入、输出高质量表征;fine-tune 阶段接一个 LSTM decoder(RNN-T transducer 架构)做 ASR。
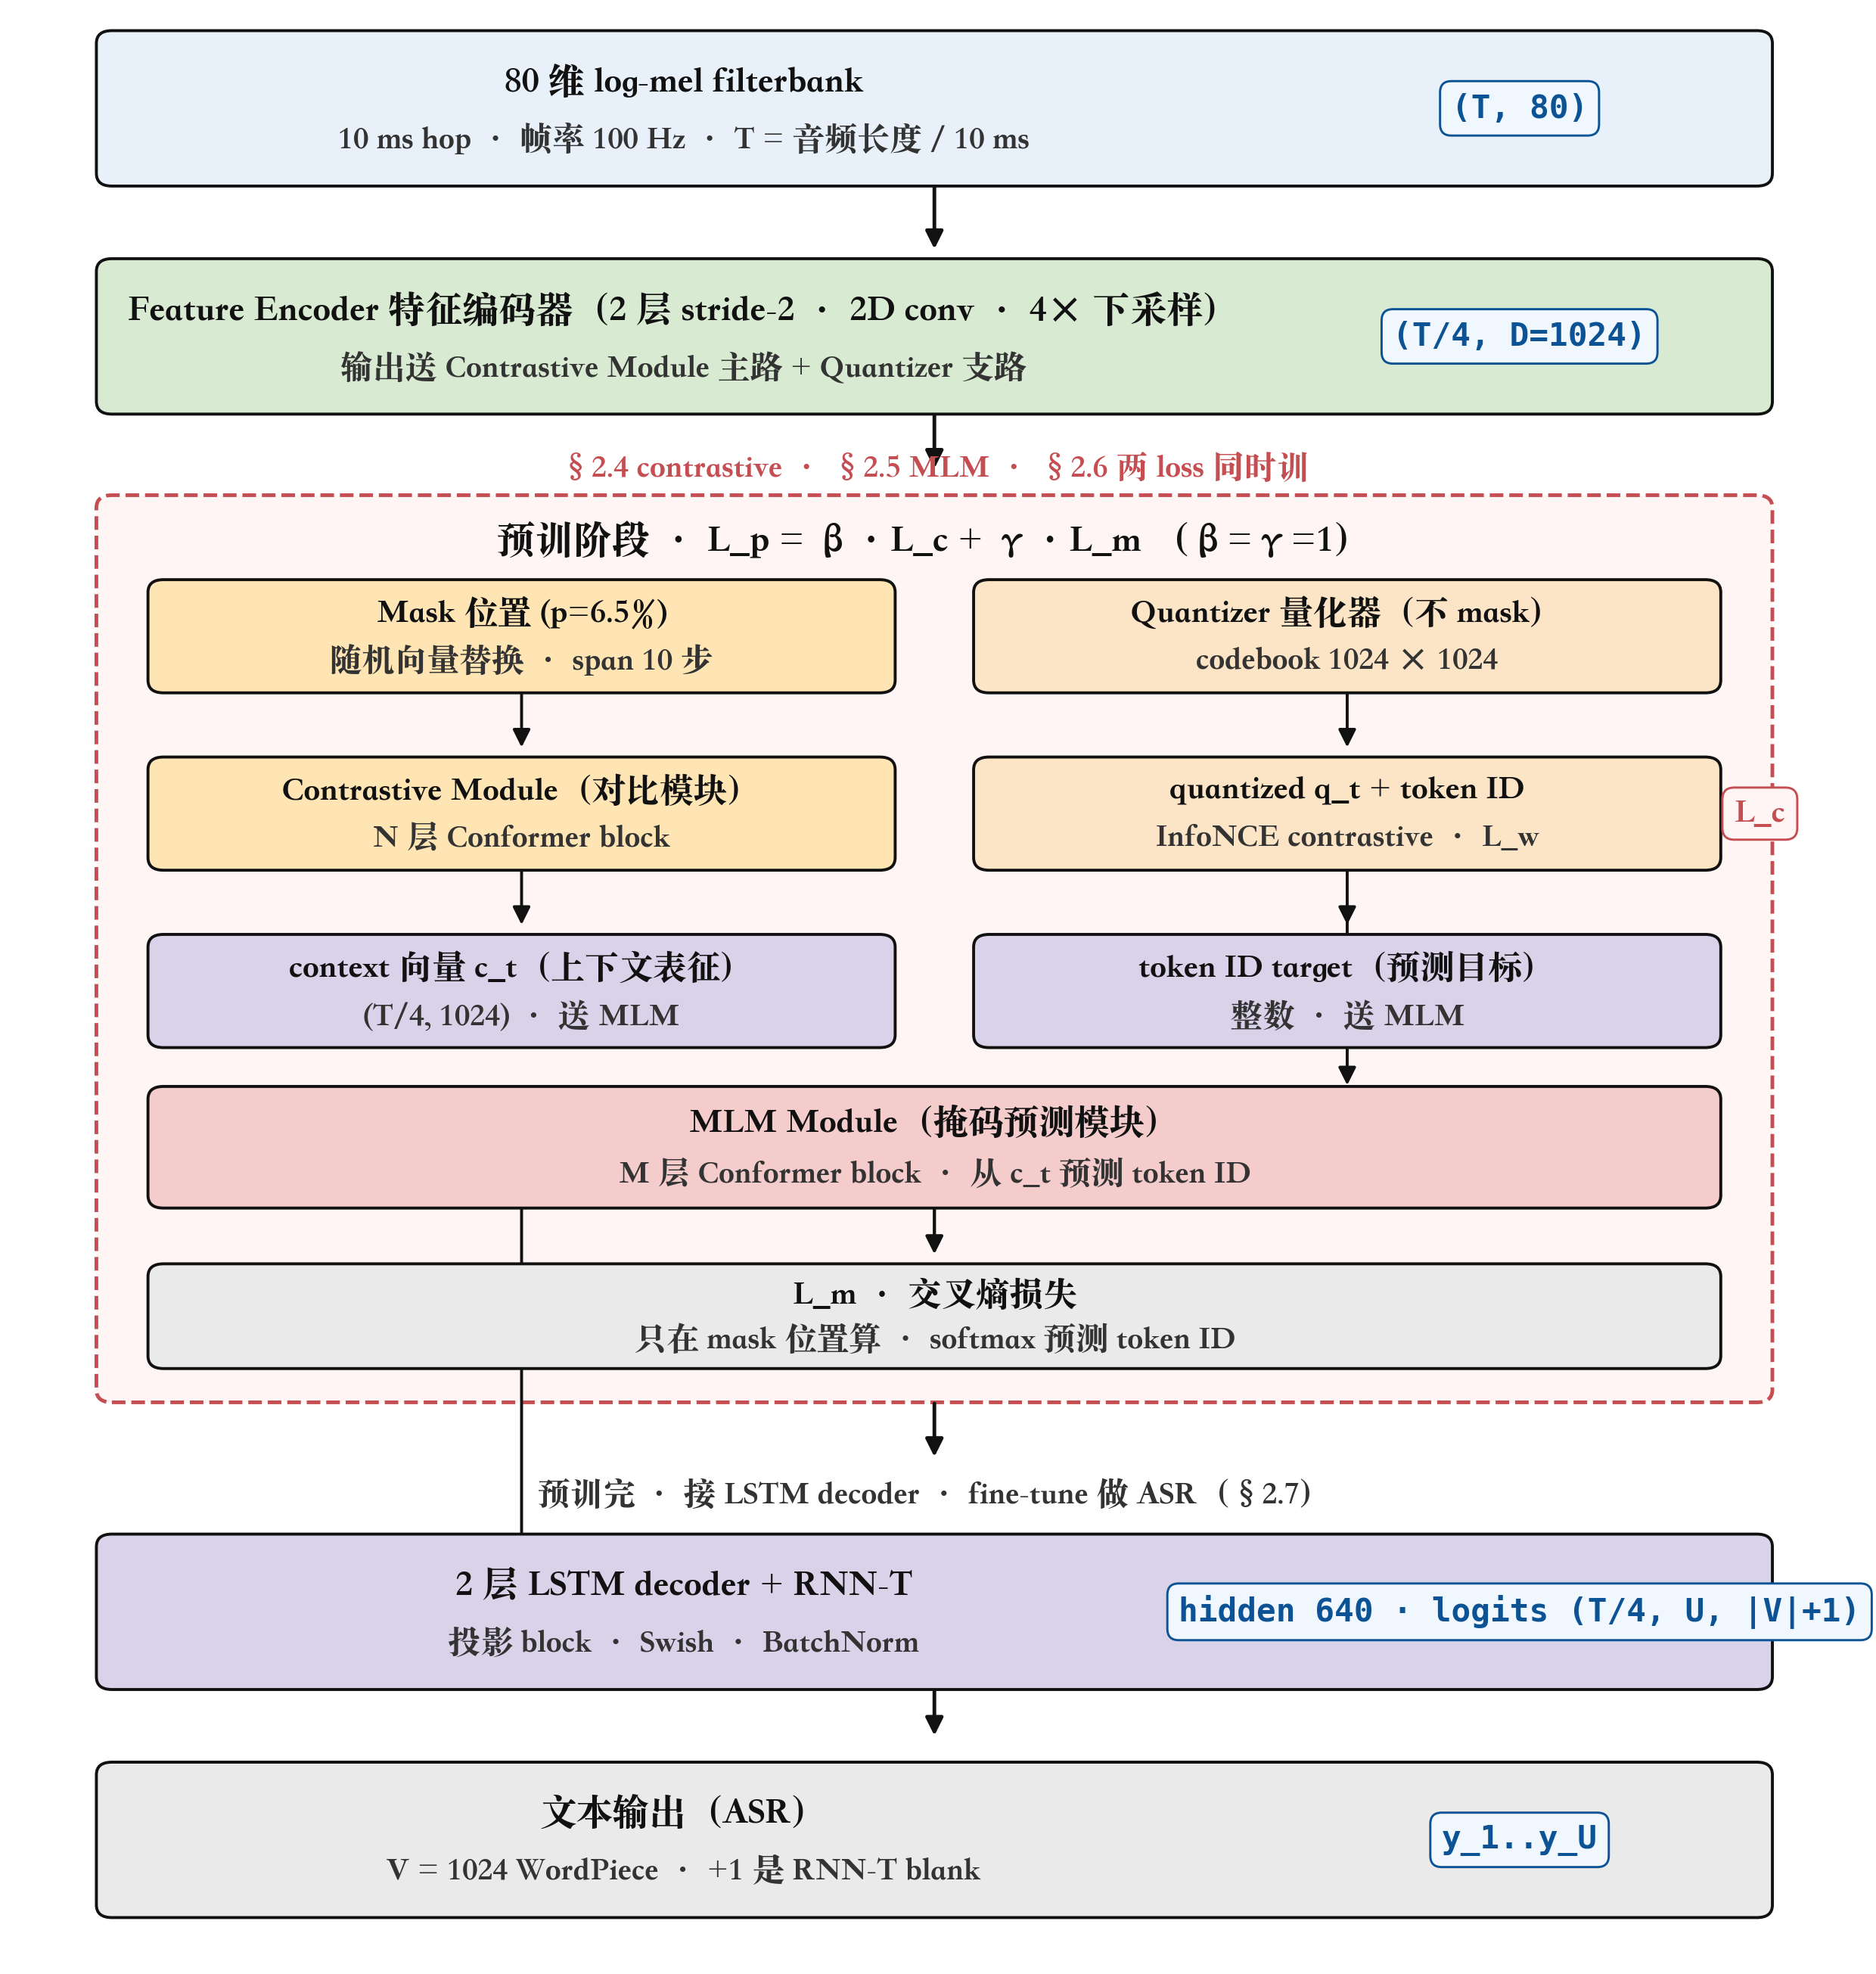
图 1:w2v-BERT 完整数据流 · 预训阶段 (红色虚线大框)里 Contrastive Module + MLM Module 串联 · quantizer 产出的 token ID 同时服务 contrastive target 和 MLM label(MLM label 路径不回传到 quantizer)· 两个 loss L_c + L_m 一起反传 · fine-tune 阶段 顶上接一个 LSTM decoder 组成 RNN-T · 用少量标注数据训成 ASR。
⚠️ 关键设计 · 为什么 contrastive 不能去掉
如果把 Contrastive Module 整个拿掉、让 MLM Module 直接吃 Feature Encoder 的输出 · quantizer 就失去"每个 code 要能被辨认出真伪"的约束------此时 quantizer 最省力的策略是把所有 mask 帧都编到同一个 code · MLM 只要永远输出那个 code 就能"完美预测"------loss 归零、accuracy 100%、但 encoder 什么都没学到。这就是 codebook collapse / trivial solution。
补充机制 :注意 collapse 不是靠
L_m通过 token ID 反传到 quantizer 造成的(label 路径不可微)· 而是因为 quantizer 和 feature encoder 共享输入 + quantizer 每步动态重算 target ------没有 contrastive 的判别约束时 · 整个系统收敛到低熵 target 的退化平衡。L_m本身只优化预测端、不直接驱动 quantizer;contrastive 的角色是外部约束、给 codebook 施加"每个 code 必须有辨识度"的压力。论文 §5.2 的消融实验在 α ∈ {0.1, 0.3, 0.5, 0.7} 四种 diversity loss 权重下都观察到这个塌缩 · 说明 contrastive 不是"辅助加分项"而是"挡住 MLM 退化的必要组件"。
shape 一目了然 :输入 80 维 log-mel filterbank (T, 80)(10 ms hop · 帧率 100 Hz)→ Conv Subsampling(两层 stride-2 · 4× 下采样)压到 (T/4, D) · D=1024 → Contrastive Module 输出 context 向量 (T/4, D) + quantizer 输出离散 token ID (T/4,) ∈ [0, |codebook|) · codebook 大小 1024 → MLM Module 拿 context 向量继续 forward · softmax 头预测 token ID · shape (T/4, 1024)。fine-tune 阶段 · 上面加 2 层 LSTM decoder(hidden 640)+ RNN-T joint · 词表 1024 WordPiece + blank。
2.2 整体结构:Feature Encoder + 两个 Conformer 栈
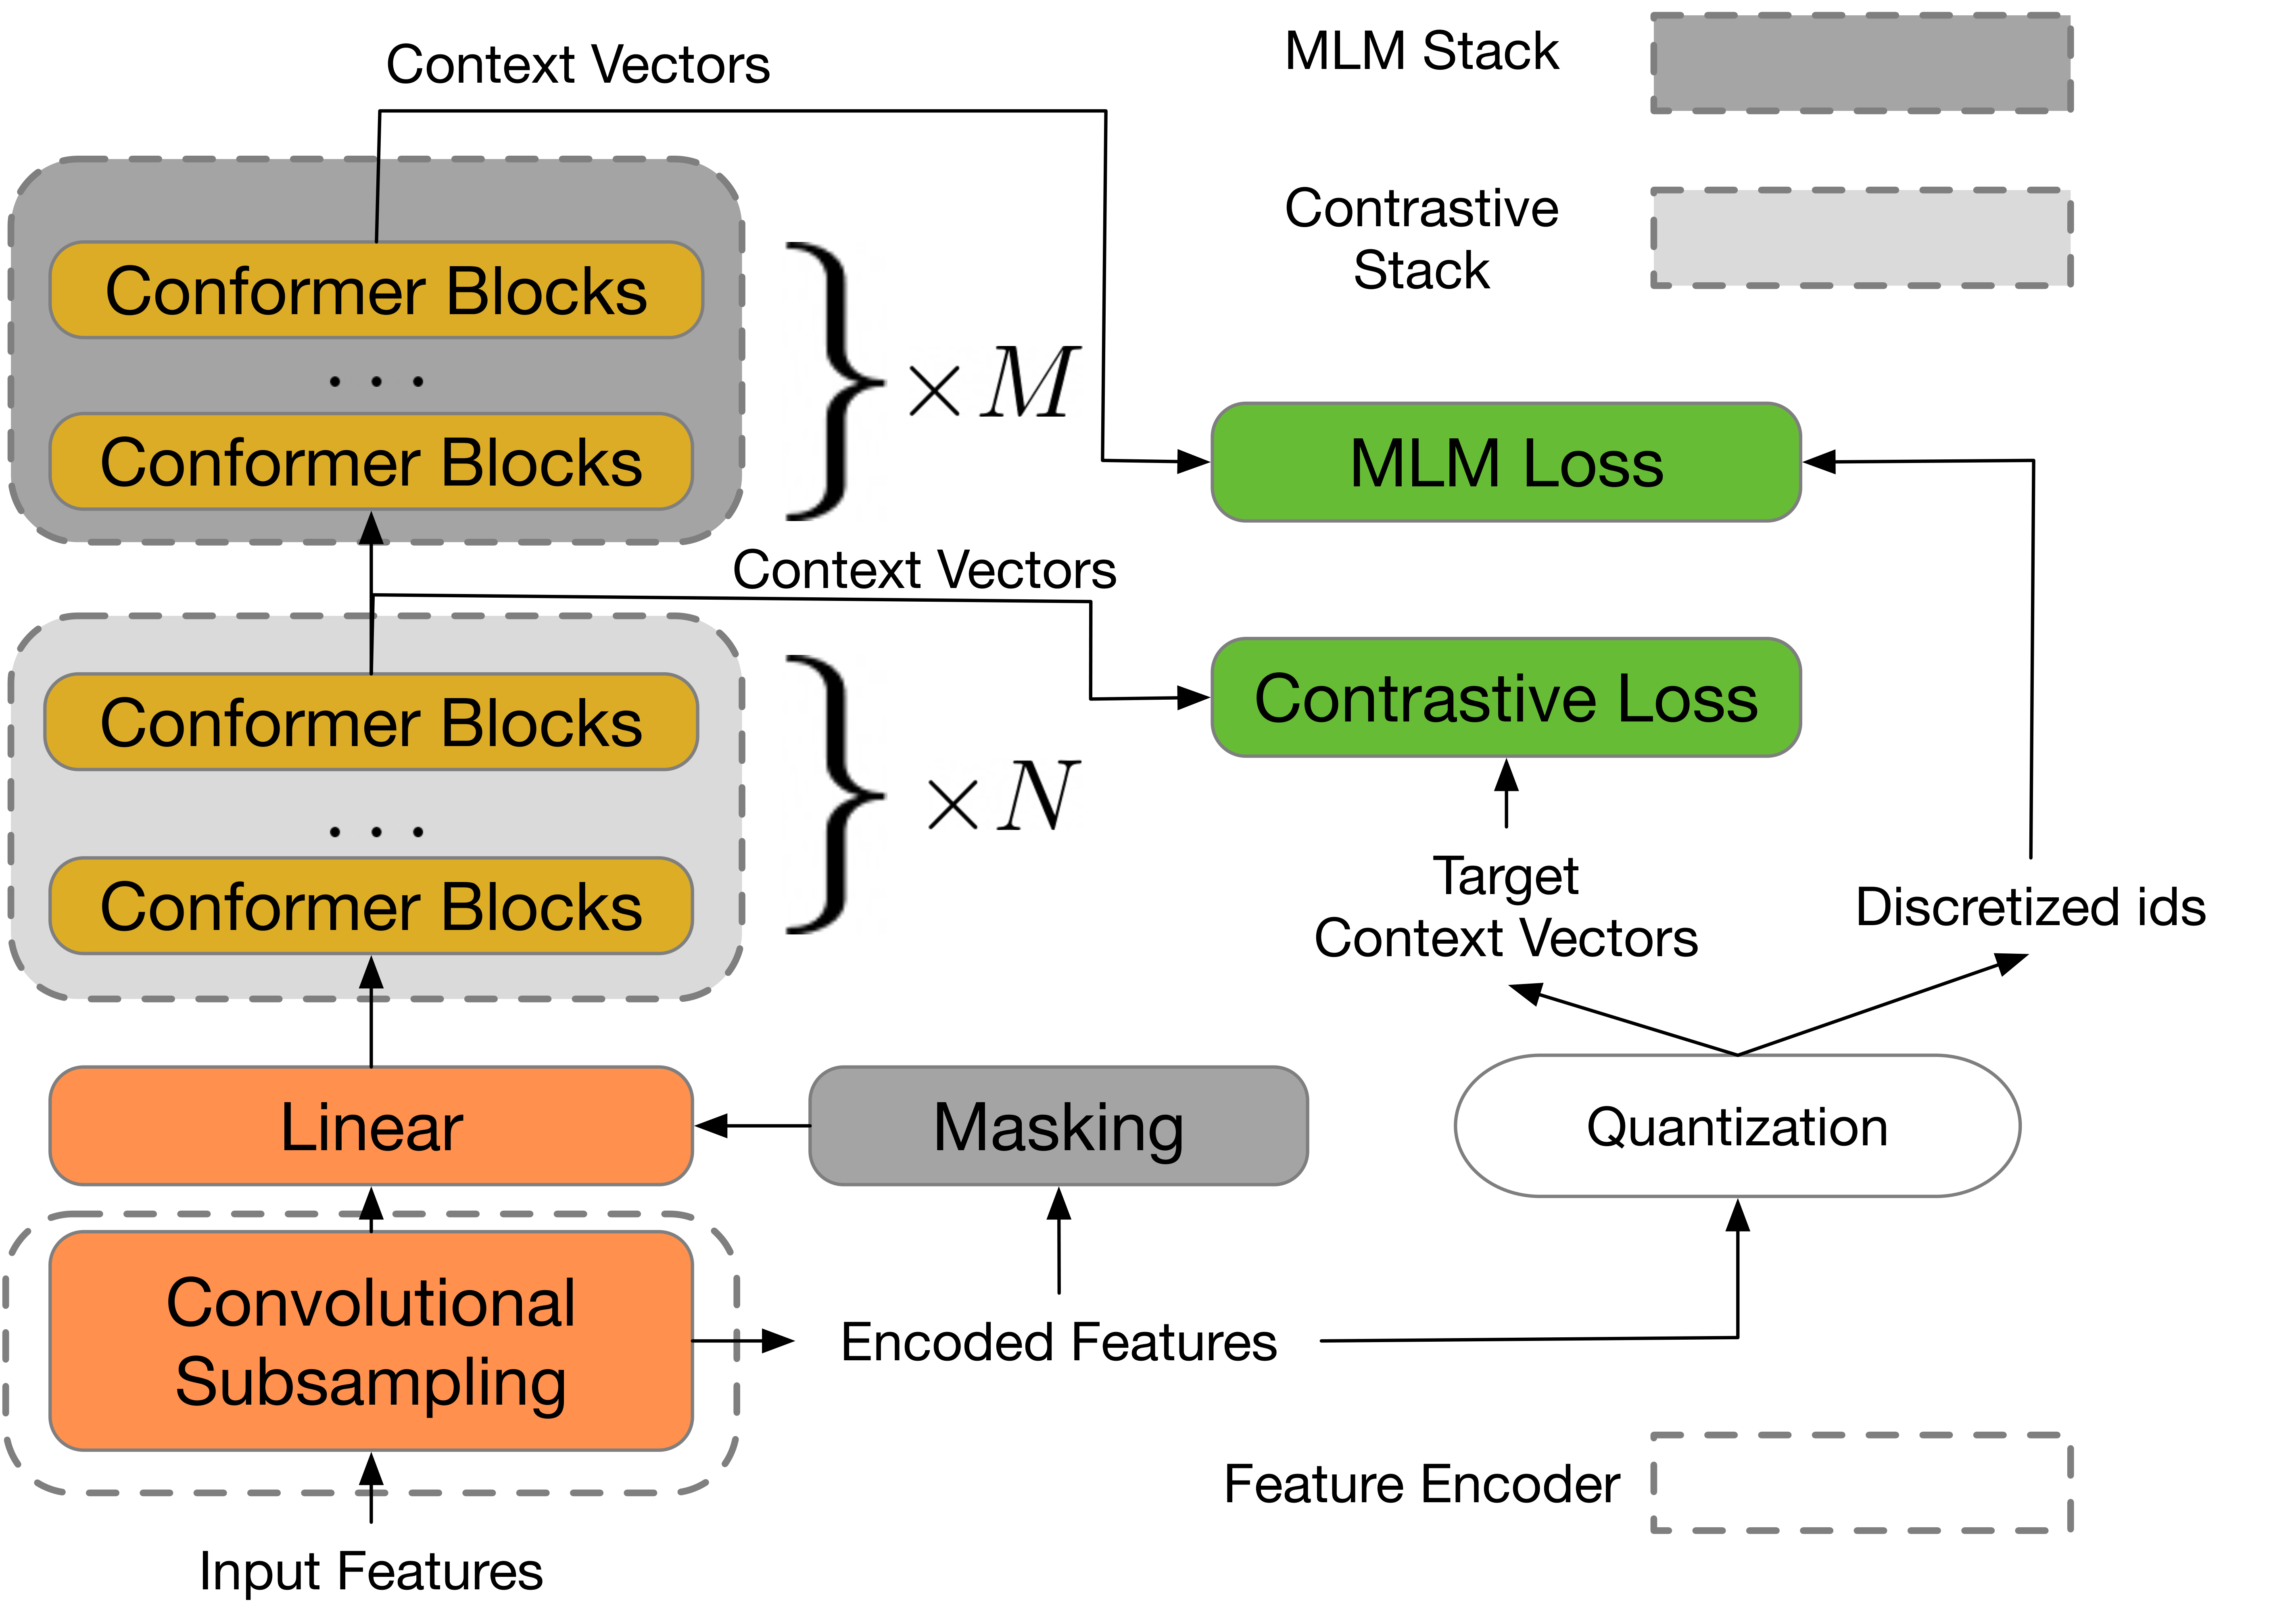
图 2:w2v-BERT 架构 · 三段组件 · Feature Encoder (2 层 stride-2 conv · 4× 下采样)+ Contrastive Module (N 个 Conformer block · 输出 context + 走 quantizer 输出离散 token)+ MLM Module (M 个 Conformer block · 用 mask 位置的 context 预测 token)· N 和 M 是两个栈的层数。
三段组件 + 一个 quantizer:
- Feature Encoder ------ 两层 stride-2 的 2D conv · 4× 下采样 (这里输入已是 10 ms hop 的 log-mel filterbank · 2 层 stride-2 后是 40 ms 一步 · 帧率从 100 Hz 降到 25 Hz;wav2vec 2.0 的 320× 是在原始波形上按 sample 数算的 · 单位不同、不要直接对比倍数)
- Contrastive Module ------ N 层 Conformer block(part6 那种 conformer)+ 一个 quantizer · 输出 context 向量 给下游 MLM · 输出 离散 token ID 给下游 MLM 当 target
- MLM Module ------ M 层 Conformer block · 用被 mask 位置的 context 预测 token ID · softmax head 输出 codebook 大小的 logits
三条主设计线 :contrastive loss 学 codebook (2.4)· MLM loss 学表征 (2.5)· 两个 loss 同时优化 (2.6)· 用 Conformer 而不是 Transformer(承接 part6)。
2.3 术语速查
问题 · 论文全篇在 context 向量 c_t / quantized 向量 q_t / token ID / codebook / distractor 之间来回切、每个都是一个具体 shape 的东西、混一起读会卡。先花一节把它们拆清楚 · 后面就能不再解释直接用。
| 术语 | shape / 类型 | 是什么 | 举个例子 |
|---|---|---|---|
| codebook | (1024, 1024) 矩阵 |
一张可学的查找表 · 有 1024 行、每行是个 1024 维向量 · 训练时不断更新 | 类似 word embedding 表 · 但每行不是"某个词的向量"、是"某类声学 pattern 的向量" |
| codebook token / token ID | 一个整数 ∈ [0, 1024) | codebook 里的行号 · 没有语义 · 就是 "这一帧被分到了第几号 cluster" | 类似 k-means 的 cluster ID · 跟"音素""字符"无关 |
| quantizer | 一个可训模块 | 输入一帧连续向量 · 输出"最像 codebook 哪一行"------同时给出 ① 行号(token ID · 整数)② 那一行的 codebook 向量本身(quantized 向量) | 类似"把连续温度值 → 分到 5 个 bin"、但 bin 中心可训 |
| quantized 向量 q_t | (1024,) 向量 |
quantizer 输出的第二样东西------把连续输入"硬对齐"到 codebook 里最近那一行、拿那一行的向量 | 用来算 InfoNCE 对比 loss · 是可微的(Gumbel straight-through) |
| context 向量 c_t | (1024,) 向量 |
Contrastive Module(N 层 Conformer)输出的第 t 帧向量 · 已经消化了周围上下文 | 类似 BERT 的 last hidden state · 每帧一个 · 送到 MLM Module 继续 forward |
| mask | bool 向量 (T/4,) |
沿用 wav2vec 2.0 · 随机选 6.5% 起点 · 每个起点往后 mask 10 帧 · span 可重叠 · 被 mask 的位置的输入替换成随机向量 | 语音版 BERT "MASK"、但语音没词、就直接遮向量 |
| distractor | K 个 (1024,) 向量 |
InfoNCE 的干扰项 ------从同 utterance 其它 mask 位置均匀采样 K 个 quantized 向量 · 让模型从 1 个真 q_t + K 个 distractor 里认出真 q_t | 类似"从同一张合影里挑出朋友"、干扰项都是同批人、不容易蒙对 |
一张图串起来(数据流):
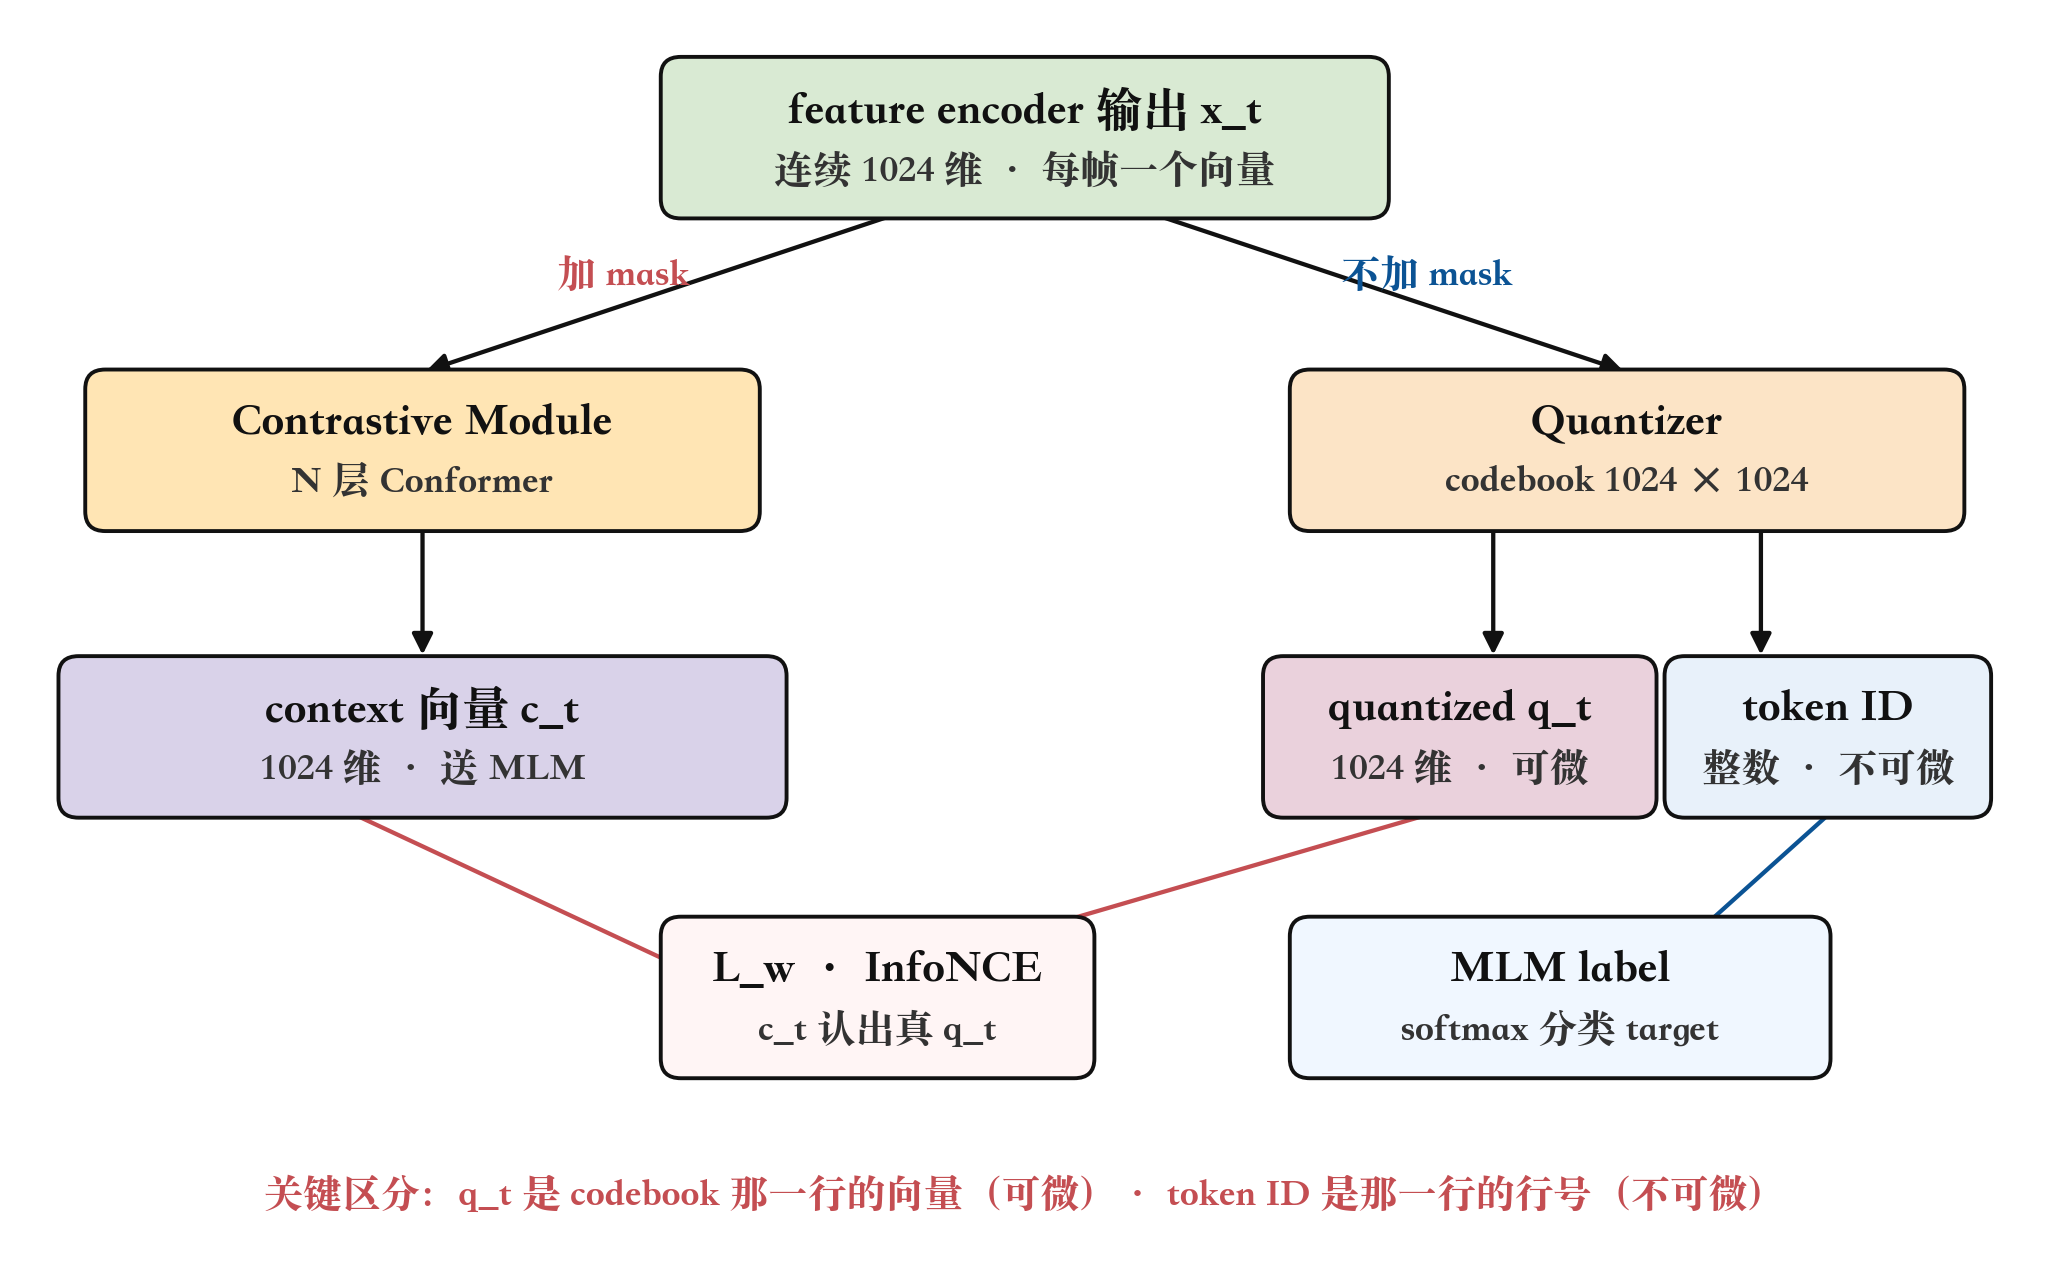
术语速查图 · 关键区分 :q_t 是 codebook 那一行的 向量内容 (1024 维 · 可微)· token ID 是那一行的 行号 (整数 · 不可微)------同一个 quantizer 输出的两样东西、走两条不同的 loss。
用一个具体例子跑一遍 · 假设一段 2 秒音频: - 输入:(200, 80) filterbank · 200 帧(2 s × 100 Hz) - Feature Encoder 后:(50, 1024) · 每帧对应 40 ms - 随机 mask ≈ 20-25 帧(6.5% × 50 ≈ 3 个起点 · 每个 span 10 帧 · span 可重叠 · 最终覆盖取决于重叠程度) - Contrastive Module 输出:(50, 1024) context 向量 · 每一帧一个 c_t - Quantizer 输出:(50, 1024) q_t + (50,) token ID · 每一帧一个 quantized 向量 + 一个整数 - Contrastive loss:只在 ~20 个 mask 位置 · c_t 要在 1 个真 q_t + K 个 distractor 的候选集里认出真 q_t - MLM loss:只在 ~20 个 mask 位置 · MLM Module 输出经 softmax 预测那个整数 token ID(1024 类分类)
读到 §2.4 时反复回来对照这张表------所有术语后面直接用、不再解释。
2.4 Contrastive Module:怎么把连续帧离散成 token
mask 生成 (沿用 wav2vec 2.0)------ 从 T/4 帧里随机选 p=6.5% 的起点 · 每个 span 长 10 步 · span 可重叠。跟 wav2vec 2.0 唯一不同 :mask 位置的 latent 向量替换成随机向量(不是共享 mask embedding)。
两路平行 : - 一路 · mask 后进 Conformer 栈 → 输出 context 向量 c_t - 一路 · 不 mask 直接进 Quantizer (Gumbel softmax + 可微 codebook · codebook size 1024 · code dim 1024)→ 输出 quantized 向量 q_t + token ID
contrastive loss ------ 每个 mask 位置 t 的 context 向量 c_t 要在 K 个 distractor 里认出真的 quantized 向量 q_t(distractor 是同 utterance 其它 mask 位置的 q):
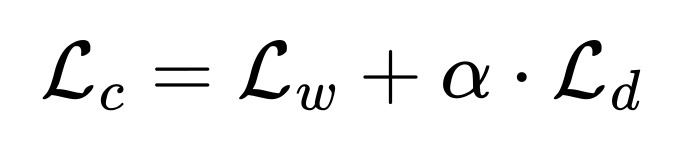
其中 L_w 是 InfoNCE 对比 loss · L_d 是 diversity loss (鼓励 codebook 均匀使用 · 防止 code collapse)· α=0.1 沿用 wav2vec 2.0。
2.5 MLM Module:从 context 预测 token
MLM Module 直接接收 Contrastive Module 的 context 向量 c_t (不做二次 mask)· forward 到最后一层 · softmax head 在 mask 位置预测 quantizer 之前给出的 token ID:
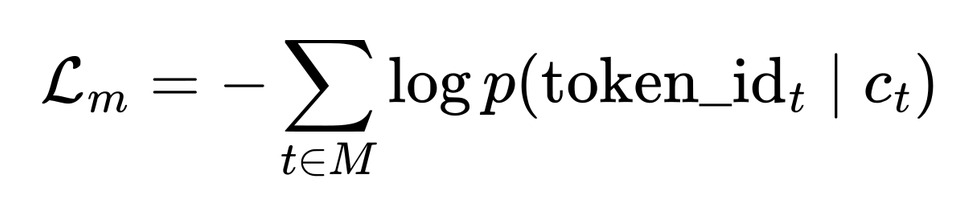
关键 ------token ID target 来自 §2.4 quantizer 、不是外部 k-means teacher;两个 loss 一起反传 · quantizer 主要由 contrastive loss + diversity loss 训 · MLM 只消费 quantizer 输出的整数 ID 当 label(label 路径不可微、无法通过 token ID 反传训 quantizer)。梯度分工 :L_c 训 Contrastive Module + Feature Encoder + quantizer(Gumbel straight-through 走 quantized 向量路径)· L_m 训 MLM Module + Contrastive Module + Feature Encoder(沿 context 向量路径)。
2.6 两个 loss 同时优化:一根管子端到端
总 loss:
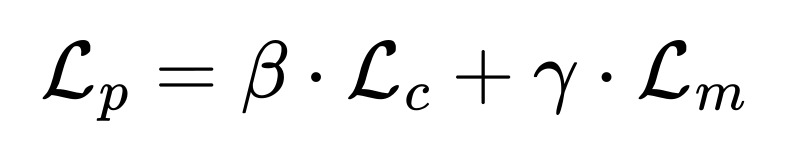
论文简单设 β=γ=1 (没超参搜索)。这是 w2v-BERT 相对 HuBERT 的核心区别------不需要 offline k-means 迭代、两个 module 从头到尾一起训。
为什么 contrastive 是必需的 (§三 §5.2 消融证实)------去掉 contrastive module、只留 MLM module 直接接收 feature encoder 输出: - MLM loss 在几千步内快速降到 0 - MLM accuracy 快速升到 100% - diversity loss 也升到 ≈1 · 说明 codebook 塌缩:所有 mask 位置的 quantizer 都发同一个 code - 预训目标退化到 trivial solution · 论文未报此变体的 ASR fine-tune 数字(因预训曲线已表明学不到有用表征)
contrastive loss 的作用:强制 codebook 里的每个 code 都被"辨认出真伪"、防止塌缩 · 这样 MLM 才有一个多样化的 target 空间可预测。
2.7 Fine-tune:接 LSTM decoder 走 RNN-T
⚠️ 预训 vs fine-tune · 标签需求(跟 HuBERT / wav2vec 2.0 完全一致)
阶段 数据规模 需要标签吗 用什么监督 预训 Libri-light 60 k 小时 不需要 contrastive + MLM 两个 loss · target 都是 quantizer 现场生成的整数 ID · 完全自监督 fine-tune LibriSpeech 960 h(或 100 h) 需要文字转录 RNN-T loss · 对齐波形和 1024-token WordPiece 序列 关键:MLM 的 target ID 不是人标的、是同一次 forward 里 quantizer 现场给的;整个预训阶段"模型自己出题自己答"。
预训完 · 加 decoder 做 ASR : - 保留整个 w2v-BERT 主干 (Feature Encoder + Contrastive Module + MLM Module 三段全用) - 主干输出接一个 投影 block (Linear + Swish + BatchNorm)· 再接 2 层 LSTM decoder (hidden=640) - Loss 是 RNN-T loss (sequence transducer · part2 那套) - 词表:1024-token WordPiece(用 LibriSpeech 训 · fine-tune 100h 时用 100h 子集的 tokenizer)
优化 :预训主干和 decoder 用不同 optimizer + 不同学习率------主干已经预训过 · 用小 LR(3e-4 warm-up 5k);decoder 从零训 · 用大 LR(1e-3 warm-up 1.5k)。
2.8 两档模型配置
| 配置 | Params | Contrastive Layers (N) | MLM Layers (M) | Model Dim | Heads | Conv Kernel | Codebook Size |
|---|---|---|---|---|---|---|---|
| XL | 0.6 B | 12 | 12 | 1024 | 8 | 5 | 1024 |
| XXL | 1.0 B | 12 | 30 | 1024 | 8 | 5 | 1024 |
两档共同点 :Feature encoder 相同 · Contrastive Module 都是 12 层 · Model Dim 1024 · Heads 8 · Conformer kernel 5(不是 part6 Conformer 论文里的 32------这里更保守)· codebook 1024。唯一差异 :XXL 把 MLM Module 从 12 层扩到 30 层 · 强化"从 context 推 target"这一步的容量。
三、实验结论
论文在 LibriSpeech(Libri-light 60k 预训 + 960h fine-tune) 和 Google Voice Search(内部 34.3k h · 1k h fine-tune) 上跑了实验、这里拆成四个结论(完整数字见原论文 Table 2-4):
① 主结果 · w2v-BERT 优于同代竞品 ------ matched-size 对照下、w2v-BERT XL 优于 w2v-Conformer XL;跨尺寸看、w2v-BERT XL (0.6B) 在 test-other 无 LM 就已持平 HuBERT X-Large (1B) 带 LM 的成绩。结论:在同为端到端 Conformer 主干的对照里、多加一个 masked prediction module 是主要增益来源;说明 contrastive 之外再加 MLM 确实有帮助、不是 wav2vec 2.0 换 Conformer 那种"换主干"红利。
② 消融 · contrastive module 是必需的 (§5.2)------ 去掉整个 contrastive module、让 MLM module 直接吃 feature encoder 输出、扫 4 个 diversity loss 权重 α 都训不动:MLM loss 塌到 0、accuracy 冲 100%、diversity loss 冲 1(codebook collapse)。结论 :contrastive 不是辅助项、而是挡住 MLM 走 trivial solution 的必要组件;这是全篇最重要的实证发现。
③ 消融 · 甜蜜点在 Contrastive Module 8-12 层 (§5.2 · 固定总层数 24)------ 太薄 codebook 学不好、太厚 MLM 没容量、两模块完全合并(C_24)反而变差。结论 :contrastive 和 MLM 需要分开的容量预算、不能塞进同一个栈里共用。
④ Voice Search 场景 · MLM 缓解 easy negatives ------ 短音频(<5.5s)+ 大量静音 + 噪声下 · contrastive 容易在 easy negatives / 非语音 context 上走捷径;w2v-BERT 相对 tuned w2v-Conformer-XL 有明显提升。结论:真实流量数据比朗读音频更能暴露纯 contrastive 的弱点、MLM 提供的额外训练信号有兜底价值。
四、局限与分析
只跑英语 · 无低资源验证 ------ LibriSpeech + Google Voice Search 都是英语;中文、多语种、10 min / 1 h 低资源 fine-tune 论文自己列在 future work。
超参照搬 w2v-Conformer ------ β=γ=1 未搜索、MLM Module 深度只在 100h 上扫过、960h 下最优点未知。
contrastive 挡塌缩的边界没扫全 ------ 只验证"去掉整个 module"会 collapse、没扫 α 很小 / 弱化 loss 但保留 module 等中间状态;contrastive module 是否充分没证。
架构意义与路线全景 ------ w2v-BERT 把语音 SSL 推到"稳定离散 target + masked prediction "这条线:比 HuBERT iterative refinement 管线简单、比 wav2vec 2.0 纯 contrastive 表征更强。后续 USM / BEST-RQ 仍围绕这条骨架展开、但 BEST-RQ 用随机投影量化替代 contrastive 学 codebook、说明 target 稳定性不只靠 contrastive 实现。
不管 wav2vec 2.0 / HuBERT / w2v-BERT / BEST-RQ 表面代理任务多不同 · 目标只有一个------用海量无标签波形学出可迁移的每帧 encoder 表征 、让下游 fine-tune 更省标注、更快收敛、WER 更低。代理任务是手段、不是目的 ------loss 数字本身不等于表征质量(w2v-BERT MLM loss 塌到 0 对应 collapse)· 最终验收仍是表征能否迁移到 ASR。分歧只在"怎么出题":
| 方法 | 代理任务 | Target 从哪来 | 稳定性靠什么 |
|---|---|---|---|
| wav2vec 2.0 | contrastive | quantizer 内部生成(联合训) | diversity loss + K distractor |
| HuBERT | masked cross-entropy | 外部 offline k-means(不联合训) | 一致性 + 迭代 refinement |
| w2v-BERT | contrastive + MLM 同时 | 内部 quantizer 现场生成(联合训) | contrastive 挡住 codebook collapse |
| BEST-RQ(后续) | masked cross-entropy | 随机投影 quantizer(不训) | 随机性本身够多样 |
真正的分歧不是哪个 loss 更好、而是 target 如何保持多样、稳定、可预测------w2v-BERT 用 contrastive 挡塌缩、HuBERT 用 offline k-means、BEST-RQ 用 random projection、殊途同归。