一种提升 Claude 复杂问题解决能力的新工具
自首次发布以来,Extended thinking 能力已经得到改进,大多情况建议用这功能,而不是专门的 think 工具。Extended thinking 能提供类似优势:
- 为 Claude 提供处理复杂问题的思考空间
- 同时拥有更好的集成度和性能
随不断提升 Claude 解决复杂问题的能力,发现一种特别有效方法:使用一个"think"工具,在复杂任务中为 Claude 创建专门的结构化思考空间。
这种简单却强大的技术,与 Claude 新推出的"Extended thinking"能力有所不同------显著提升了 Claude 的 Agent 式工具调用能力。这些提升包括更好地遵循策略、做出更加一致的决策,以及处理多步骤问题,而且实现成本非常低。
本文探讨如何在不同应用中实现"think"工具,并根据经过验证的基准测试结果,为开发者分享实用建议。
1 啥是"think"工具?
通过"think"工具,赋予 Claude 在得出最终答案的过程中增加一个额外思考步骤的能力,并为这一步提供专门的思考空间。
与 Extended thinking 类似,但是不同概念:
- Extended thinking 关注 Claude 在开始生成响应之前所做的事情。借助 Extended thinking,Claude 会在采取行动之前深入思考并反复迭代自己的计划
- "think"工具则是在 Claude 已经开始生成响应之后,让它能够增加一个步骤,停下来思考自己是否已经掌握继续执行所需的全部信息。当 Claude 需要进行很长的一连串工具调用,或者与用户进行漫长的多步骤对话时,这一点尤其有帮助。
2 适用场景
"think"工具适合Claude 无法仅凭用户的问题就获得形成回答所需的全部信息,而须处理外部信息(如工具调用返回的结果)。Claude 通过"think"工具进行的推理,其全面程度不如 Extended thinking,但更专注模型新发现的信息。
非顺序工具调用或直接的指令执行等较简单的工具使用场景,建议用 Extended thinking。Extended thinking 也适用于编程、数学和物理等不需要 Claude 调用工具的场景。
当 Claude 需要调用复杂工具、在长串工具调用中仔细分析工具输出、在具有大量策略和详细指南的环境中执行任务,或者需要进行每一步都建立在前一步基础上的连续决策且错误代价较高时,"think"工具则更加适合。
用 τ-Bench 所采用的标准工具规范格式实现的示例:
json
 {
   "name": "think",
   "description": "使用此工具进行思考。它不会获取新信息,也不会修改数据库,只会将思考内容追加到日志中。当需要复杂推理或某些缓存记忆时使用它。",
   "input_schema": {
     "type": "object",
     "properties": {
       "thought": {
         "type": "string",
         "description": "需要思考的内容。"
       }
     },
     "required": ["thought"]
   }
 }
3 在 τ-Bench 上的表现
用 τ-Bench(tau-bench)对"think"工具评估。这是一项综合性基准测试,旨在测试模型在真实客户服务场景中使用工具的能力,其中"think"工具是评测标准环境的一部分。
τ-Bench 评估 Claude 以下方面的能力:
- 与模拟用户进行真实感的对话
- 持续遵循复杂的客户服务 Agent 策略指南
- 使用各种工具访问和操作环境数据库
τ-Bench 采用的主要评估指标是 pass^k ,它衡量的是对于某项任务,k 次独立试验全部成功的概率,并对所有任务进行平均。与其他 LLM 评估中常见的 pass@k 指标不同(后者衡量 k 次试验中至少有一次成功),pass^k 更关注一致性和可靠性------对于客户服务应用而言,这是至关重要的,因为此类应用必须始终遵守相关策略。
性能分析
我们的评估比较了以下几种不同配置:
- 基线(不使用"think"工具,也不使用 Extended thinking 模式)
- 仅用 Extended thinking 模式
- 仅用"think"工具
- 使用"think"工具,并针对航空领域优化提示词
结果显示,在基准测试的"航空"和"零售"客户服务领域中,当 Claude 3.7 有效使用"think"工具时,性能都有显著提升:
- 航空领域:"think"工具配合优化后的提示词,在 pass^1 指标上达到 0.570,而基线仅为 0.370,相对提升 54%;
- 零售领域:仅使用"think"工具就达到 0.812,而基线为 0.783。
一张展示 Claude 3.7 Sonnet 在 Tau-Bench "航空"领域评测中表现的折线图:
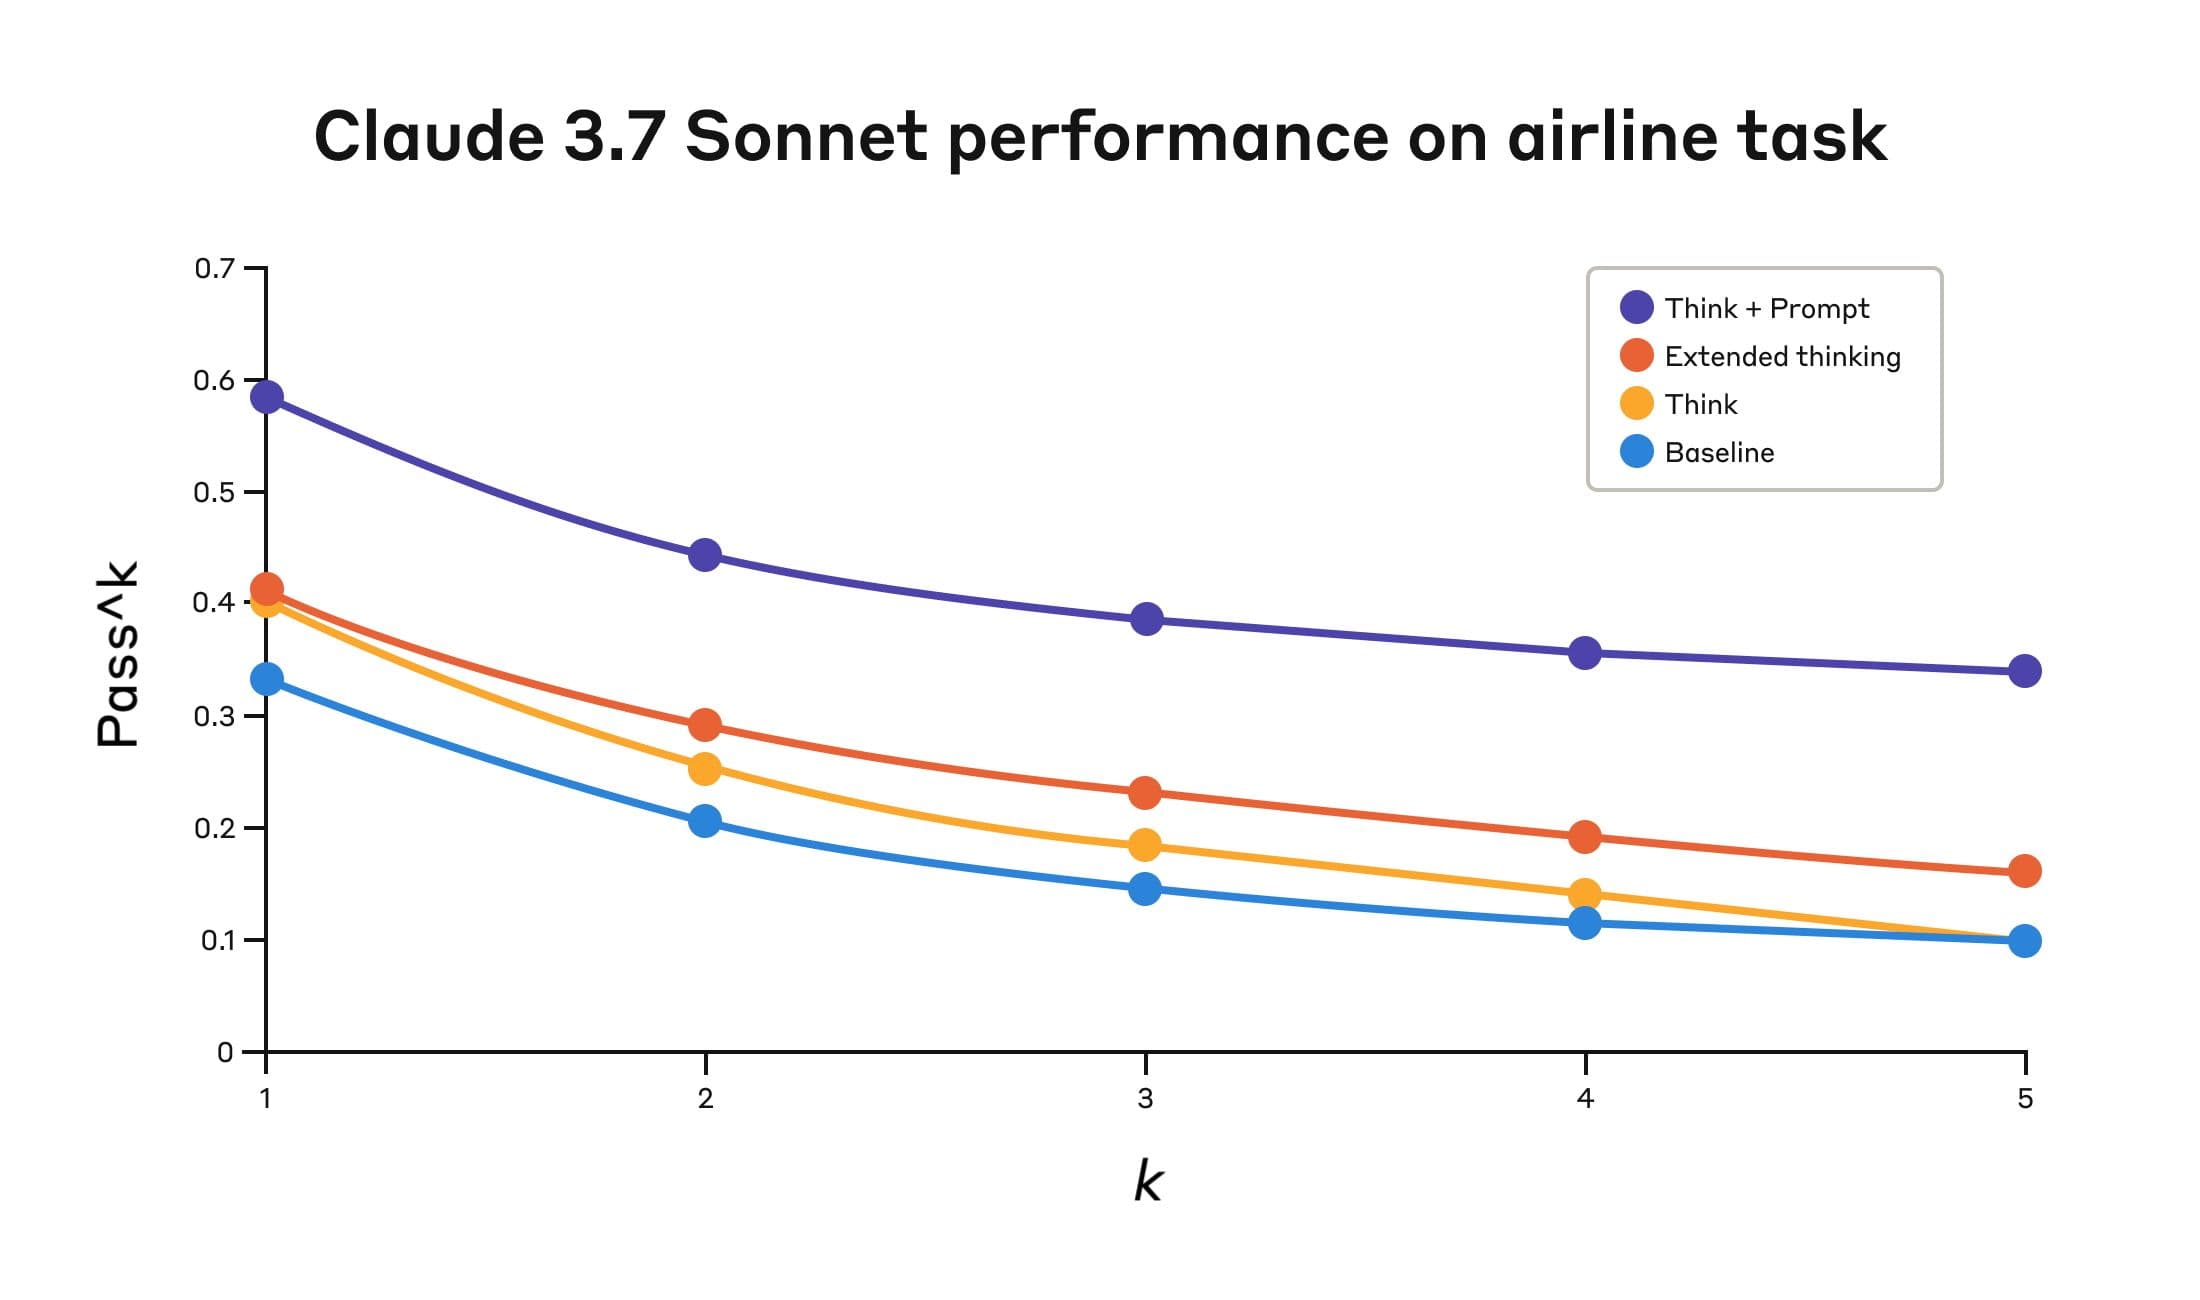
Claude 3.7 Sonnet 在 Tau-Bench 评测"航空"领域四种不同配置下的表现。
Claude 3.7 Sonnet 在 Tau-Bench 评测"航空"领域的表现
| Configuration | k=1 | k=2 | k=3 | k=4 | k=5 |
|---|---|---|---|---|---|
| "Think" + Prompt | 0.584 | 0.444 | 0.384 | 0.356 | 0.340 |
| "Think" | 0.404 | 0.254 | 0.186 | 0.140 | 0.100 |
| Extended thinking | 0.412 | 0.290 | 0.232 | 0.192 | 0.160 |
| Baseline | 0.332 | 0.206 | 0.148 | 0.116 | 0.100 |
四种不同配置下的评估结果。分数均为比例值。
航空领域的最佳表现来自将"think"工具与优化后的提示词结合使用。该提示词提供了分析客户请求时可采用的推理方法示例。下面是优化后提示词的一个示例:
 ## 使用 think 工具

 在收到工具结果后,在采取任何行动或回复用户之前,使用 think 工具作为草稿空间来:
 - 列出适用于当前请求的具体规则
 - 检查是否已经收集了所有必需信息
 - 验证计划执行的操作是否符合所有策略
 - 反复检查工具结果的正确性

 下面是一些可以在 think 工具中进行迭代思考的示例:
 <think_tool_example_1>
 用户想要取消航班 ABC123
 - 需要验证:用户 ID、预订 ID、原因
 - 检查取消规则:
   * 是否在预订后的 24 小时内?
   * 如果不是,则检查机票等级和保险
 - 验证是否没有航段已经飞行,且没有航段处于过去时间
 - 计划:收集缺失信息、验证规则、获取确认
 </think_tool_example_1>

 <think_tool_example_2>
 用户想要预订 3 张前往纽约的机票,每人托运行李 2 件
 - 需要用户 ID,以检查:
   * 会员等级及其行李额度
   * 用户资料中有哪些支付方式
 - 行李计算:
   * 经济舱 × 3 名乘客
   * 如果是普通会员:每人 1 件免费行李 → 3 件额外行李 = 150 美元
   * 如果是银卡会员:每人 2 件免费行李 → 0 件额外行李 = 0 美元
   * 如果是金卡会员:每人 3 件免费行李 → 0 件额外行李 = 0 美元
 - 需要验证的支付规则:
   * 最多 1 张旅行证书、1 张信用卡、3 张礼品卡
   * 所有支付方式都必须存在于用户资料中
   * 所使用的支付方式组合必须符合规定
   * 旅行证书的剩余金额将作废
 - 计划:
 1. 获取用户 ID
 2. 验证会员等级,以确定行李费用
 3. 检查用户资料中的支付方式,以及这些方式的组合是否允许
 4. 计算总价:机票价格 + 可能产生的行李费用
 5. 获取用户对预订的明确确认
 </think_tool_example_2>
不同方法之间存在明显差异:
- 使用"think"工具并配合优化后的提示词,取得的结果明显优于 Extended thinking 模式
- 后者的表现与未经过提示词优化的"think"工具相近
- 单独使用"think"工具(不额外提供提示词)虽然比基线有所提升,但仍明显不如优化后的方案
"think"工具与优化提示词的组合取得明显最强表现,这可能是因为基准测试中的航空公司政策非常复杂。在这种情况下,模型从"应该如何思考"的示例中获益最多。
零售领域
一张展示 Claude 3.7 Sonnet 在 Tau-Bench "零售"领域评测中表现的折线图:
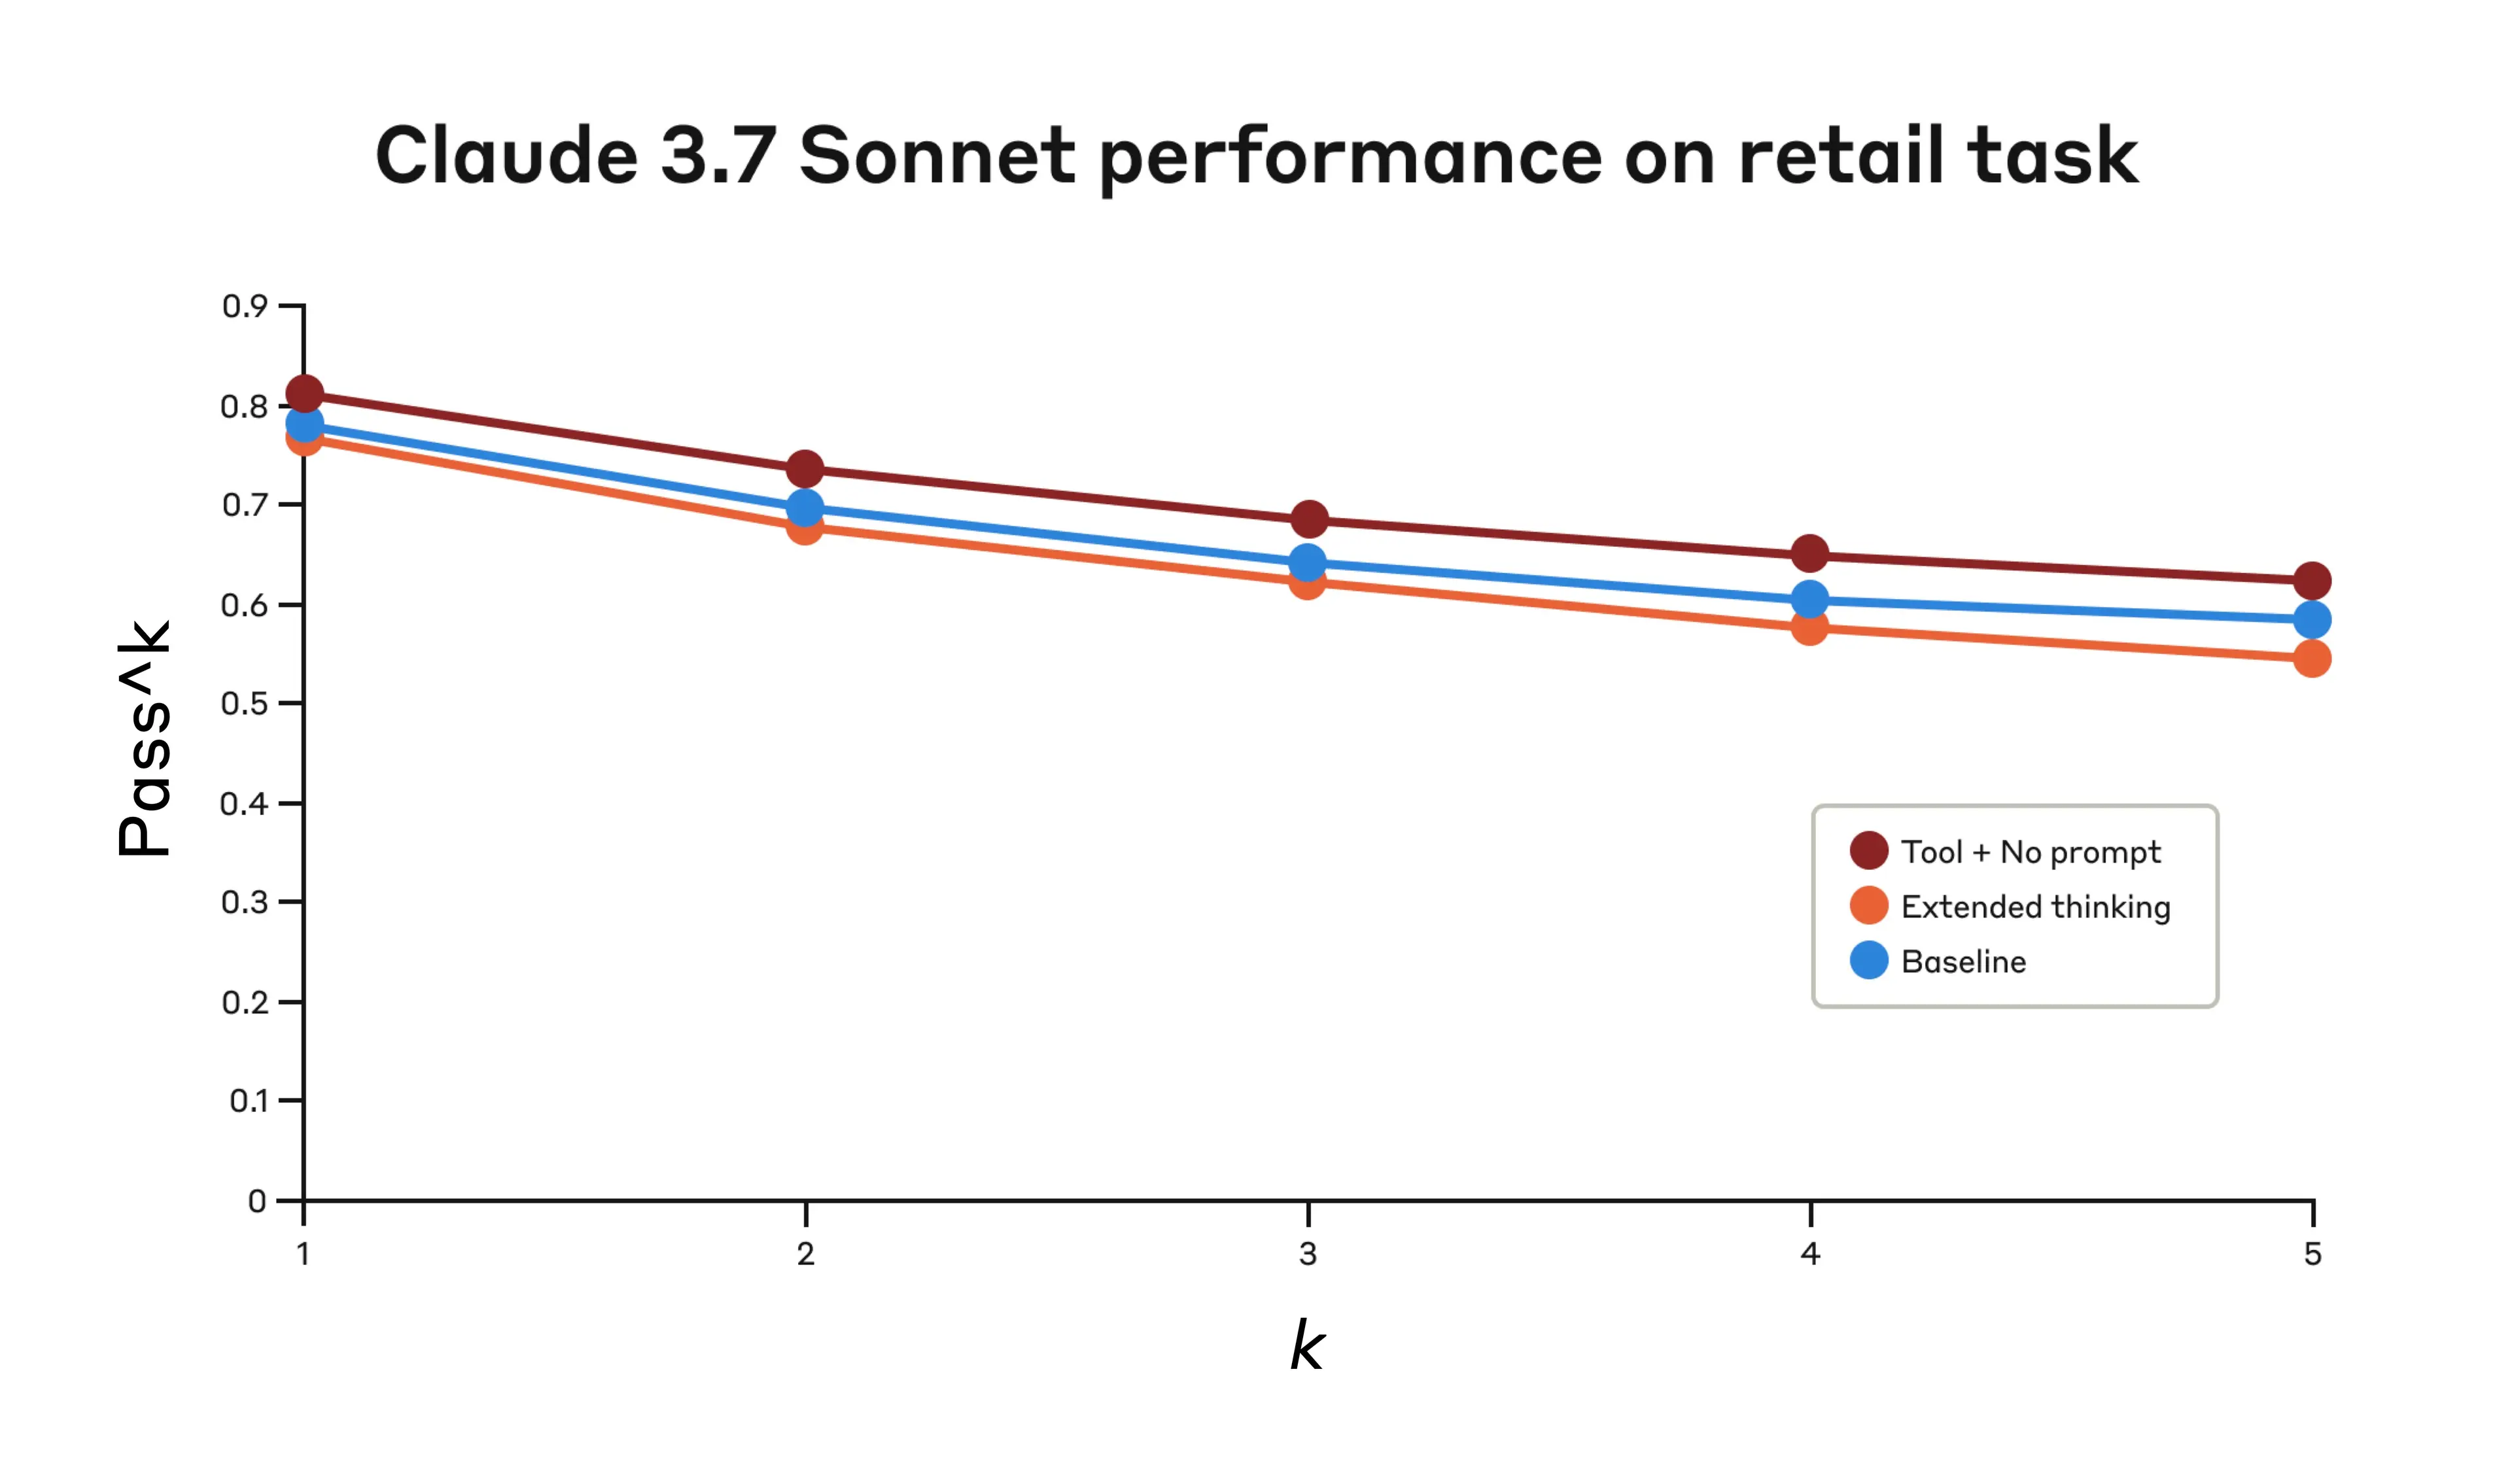
Claude 3.7 Sonnet 在 Tau-Bench 评测"零售"领域三种不同配置下的表现。
Claude 3.7 Sonnet 在 Tau-Bench 评测"零售"领域的表现
| Configuration | k=1 | k=2 | k=3 | k=4 | k=5 |
|---|---|---|---|---|---|
| "Think" + no prompt | 0.812 | 0.735 | 0.685 | 0.650 | 0.626 |
| Extended thinking | 0.770 | 0.681 | 0.623 | 0.581 | 0.548 |
| Baseline | 0.783 | 0.695 | 0.643 | 0.607 | 0.583 |
三种不同配置下的评估结果。分数均为比例值。
即使没有额外提示,"think"工具的 pass^1 分数仍然最高,达到 0.812。零售策略相比航空领域明显更容易理解和执行,因此 Claude 仅仅通过获得一个可以思考的空间,就能够在没有进一步指导的情况下取得提升。
τ-Bench 分析的关键发现
更有效实现"think"工具:
- 在困难领域,提示词非常重要。仅仅提供"think"工具可能会在一定程度上改善性能,但将其与优化后的提示词结合起来,可以在困难领域取得显著更好的结果。不过,对于较简单的领域,仅仅提供"think"访问能力也可能已经足够。
- 在多次试验中保持更高的一致性。使用"think"带来的性能提升一直保持到 pass^k 的 k=5,这表明该工具能够帮助 Claude 更有效地处理边界情况和不寻常的场景。
4 SWE-Bench表现
在评估 Claude 3.7 Sonnet 时,我们也在 SWE-bench 环境中加入了类似的"think"工具,这帮助模型取得了当时最先进的 0.623 分。调整后的"think"工具定义如下:
 {
   "name": "think",
   "description": "使用此工具进行思考。它不会获取新信息,也不会对代码仓库做出任何修改,只会记录思考内容。当需要复杂推理或头脑风暴时使用它。例如,如果你探索代码仓库后发现了 bug 的根源,可以调用此工具,头脑风暴几种独特的修复方法,并评估哪些修改可能最简单、最有效。或者,如果你收到了一些测试结果,可以调用此工具,头脑风暴解决失败测试的方法。",
   "input_schema": {
     "type": "object",
     "properties": {
       "thought": {
         "type": "string",
         "description": "你的思考内容。"
       }
    },
     "required": ["thought"]
   }
 }
我们的实验(使用"think"工具的样本数 n =30,不使用的样本数 n =144)显示,单独加入这一工具后,性能平均提升了 1.6%(Welch's t -test:t (38.89) = 6.71,p < .001,d = 1.47)。
5 啥时该用"think"工具
Claude 最能从"think"工具中受益的几种场景:
- 分析工具输出。当 Claude 需要仔细处理此前工具调用的输出后再采取行动,并且可能需要回溯此前的处理思路时;
- 策略密集型环境。当 Claude 需要遵循详细指南并验证是否符合相关要求时;以及
- 连续决策。当每个行动都建立在此前行动的基础上,而且犯错代价较高时(这种情况通常出现在多步骤任务中)。
6 实现最佳实践
为了让 Claude 充分发挥"think"工具的作用,我们根据 τ-bench 实验总结了以下实现建议。
使用领域特定示例进行策略性提示
最有效的方法是明确告诉 Claude 应该在什么时候、以什么方式使用"think"工具,例如 τ-bench 航空领域中所采用的方式。提供针对具体使用场景定制的示例,可以显著提升模型使用"think"工具的效果:
- 推理过程中应该达到的详细程度;
- 如何将复杂指令拆解成可执行的步骤;
- 处理常见场景时使用的决策树;以及
- 如何检查是否已经收集了所有必要信息。
将复杂指导放入系统提示词
当"think"工具相关的指令较长和/或较复杂时,将这些指令放入系统提示词中,比直接写入工具描述更加有效。这种方式能够提供更广泛的上下文,也有助于模型将思考过程更好地融入整体行为。
7 啥时不该用"think"工具
虽然"think"工具能带来显著提升,但它并不适用于所有工具调用场景,而且会增加提示词长度和输出 token 数量。具体来说,我们发现,在以下使用场景中,"think"工具并不会带来任何提升:
- 非顺序工具调用。如果 Claude 只需要进行一次工具调用,或者进行多次并行调用就能完成任务,那么加入"think"通常不会带来明显改善。
- 简单的指令遵循。如果 Claude 需要遵守的约束并不多,而它默认的行为已经足够好,那么额外进行"think"通常也不会带来收益。
8 开始使用
将"think"工具加入 Claude 的实现:
- 从 Agent 式工具调用场景开始测试。优选具有挑战性的使用场景------如 Claude 目前在遵守策略或处理长串工具调用中的复杂推理时表现不佳的场景。
- 加入工具定义。根据你的领域定制一个"think"工具。它所需的代码非常少,却能够提供更加结构化的推理能力。同时,也可以考虑在系统提示词中加入关于何时以及如何使用该工具的说明,并提供与你所在领域相关的示例。
- 持续监控和优化。观察 Claude 在实际使用中的工具调用方式,并调整提示词,以鼓励更加有效的思考模式。
从性能结果来看,添加这一工具的潜在缺点非常有限。除非 Claude 自己决定使用它,否则它不会改变外部行为,也不会干扰现有的工具或工作流程。
9 结论
对需要遵循策略、并在长串工具调用中进行推理的复杂任务,"think"工具能够显著提升 Claude 3.7 Sonnet 的表现。"Think"并不是适用于所有场景的万能方案,但对于正确的使用场景,它能够带来 substantial 的收益,同时实现复杂度非常低。
Claude 3.5 Sonnet (New) 在与 3.7 Sonnet 相同的配置下同样能够获得性能提升,这说明这种改进也可以推广到其他 Claude 模型。