论文:Deep Speech 2: End-to-End Speech Recognition in English and Mandarin · arxiv:1512.02595
一份来自 Baidu 硅谷 AI Lab 的端到端 ASR 系统报告:CNN + 深度 BiRNN + BN + CTC + n-gram LM,11940 小时英语 / 9400 小时中文语料训练,在多个基准上接近或超过人类转写员。全文骨架分三块------模型架构做深 、数据做大 、训练/部署系统做快。
一、问题与动机
前一代 Deep Speech 1(Hannun et al. 2014)已经把 ASR 从"MFCC + HMM + WFST 三段接力"拍成"一个 RNN 直接吐字母 + CTC",端到端跑通。接下来的问题不再是能不能端到端,而是能不能把端到端做到 production 级:
- 能不能同时打英语和中文?工业 ASR 里换个语言常要重做发音词典、音素集、tone 建模------DS1 只做了英语,中文能不能沿用同一套架构直接换字符输出?
- 能不能承载万小时级数据 + 上亿参数模型 ?DS1 是 5 层、只有 1 层是 recurrent(循环层,即 RNN 那种把上一步隐状态 h_{t-1} 反馈进本步的层)、大约 7000 小时语料。再想涨点,模型和数据都得扩,但扩了训练时间会爆------单机 3-6 周训一个模型没法迭代。
- 能不能部署到线上?深度 BiRNN 反向那半必须等整段音频说完,天然不流式;beam search 在 6000 字符表的中文里每 40ms 要查一百万次 n-gram,也慢。
DS2 一次性摆出对这三个问题的完整答案。这不是一篇提出一个新算法的论文,而是一份系统工程报告:给你看清"想把 ASR 从 paper 推到 production 到底要动多少东西"。
二、核心思想:架构 · 数据 · 算力 三件套
一句话:沿用 CTC 端到端骨架,靠深度 + BN + 更多数据把 WER 打下来,靠 HPC 训练栈 + Row Convolution + Batch Dispatch 让训练和部署都可承受(这些点下面 §三-§九 逐个展开)。
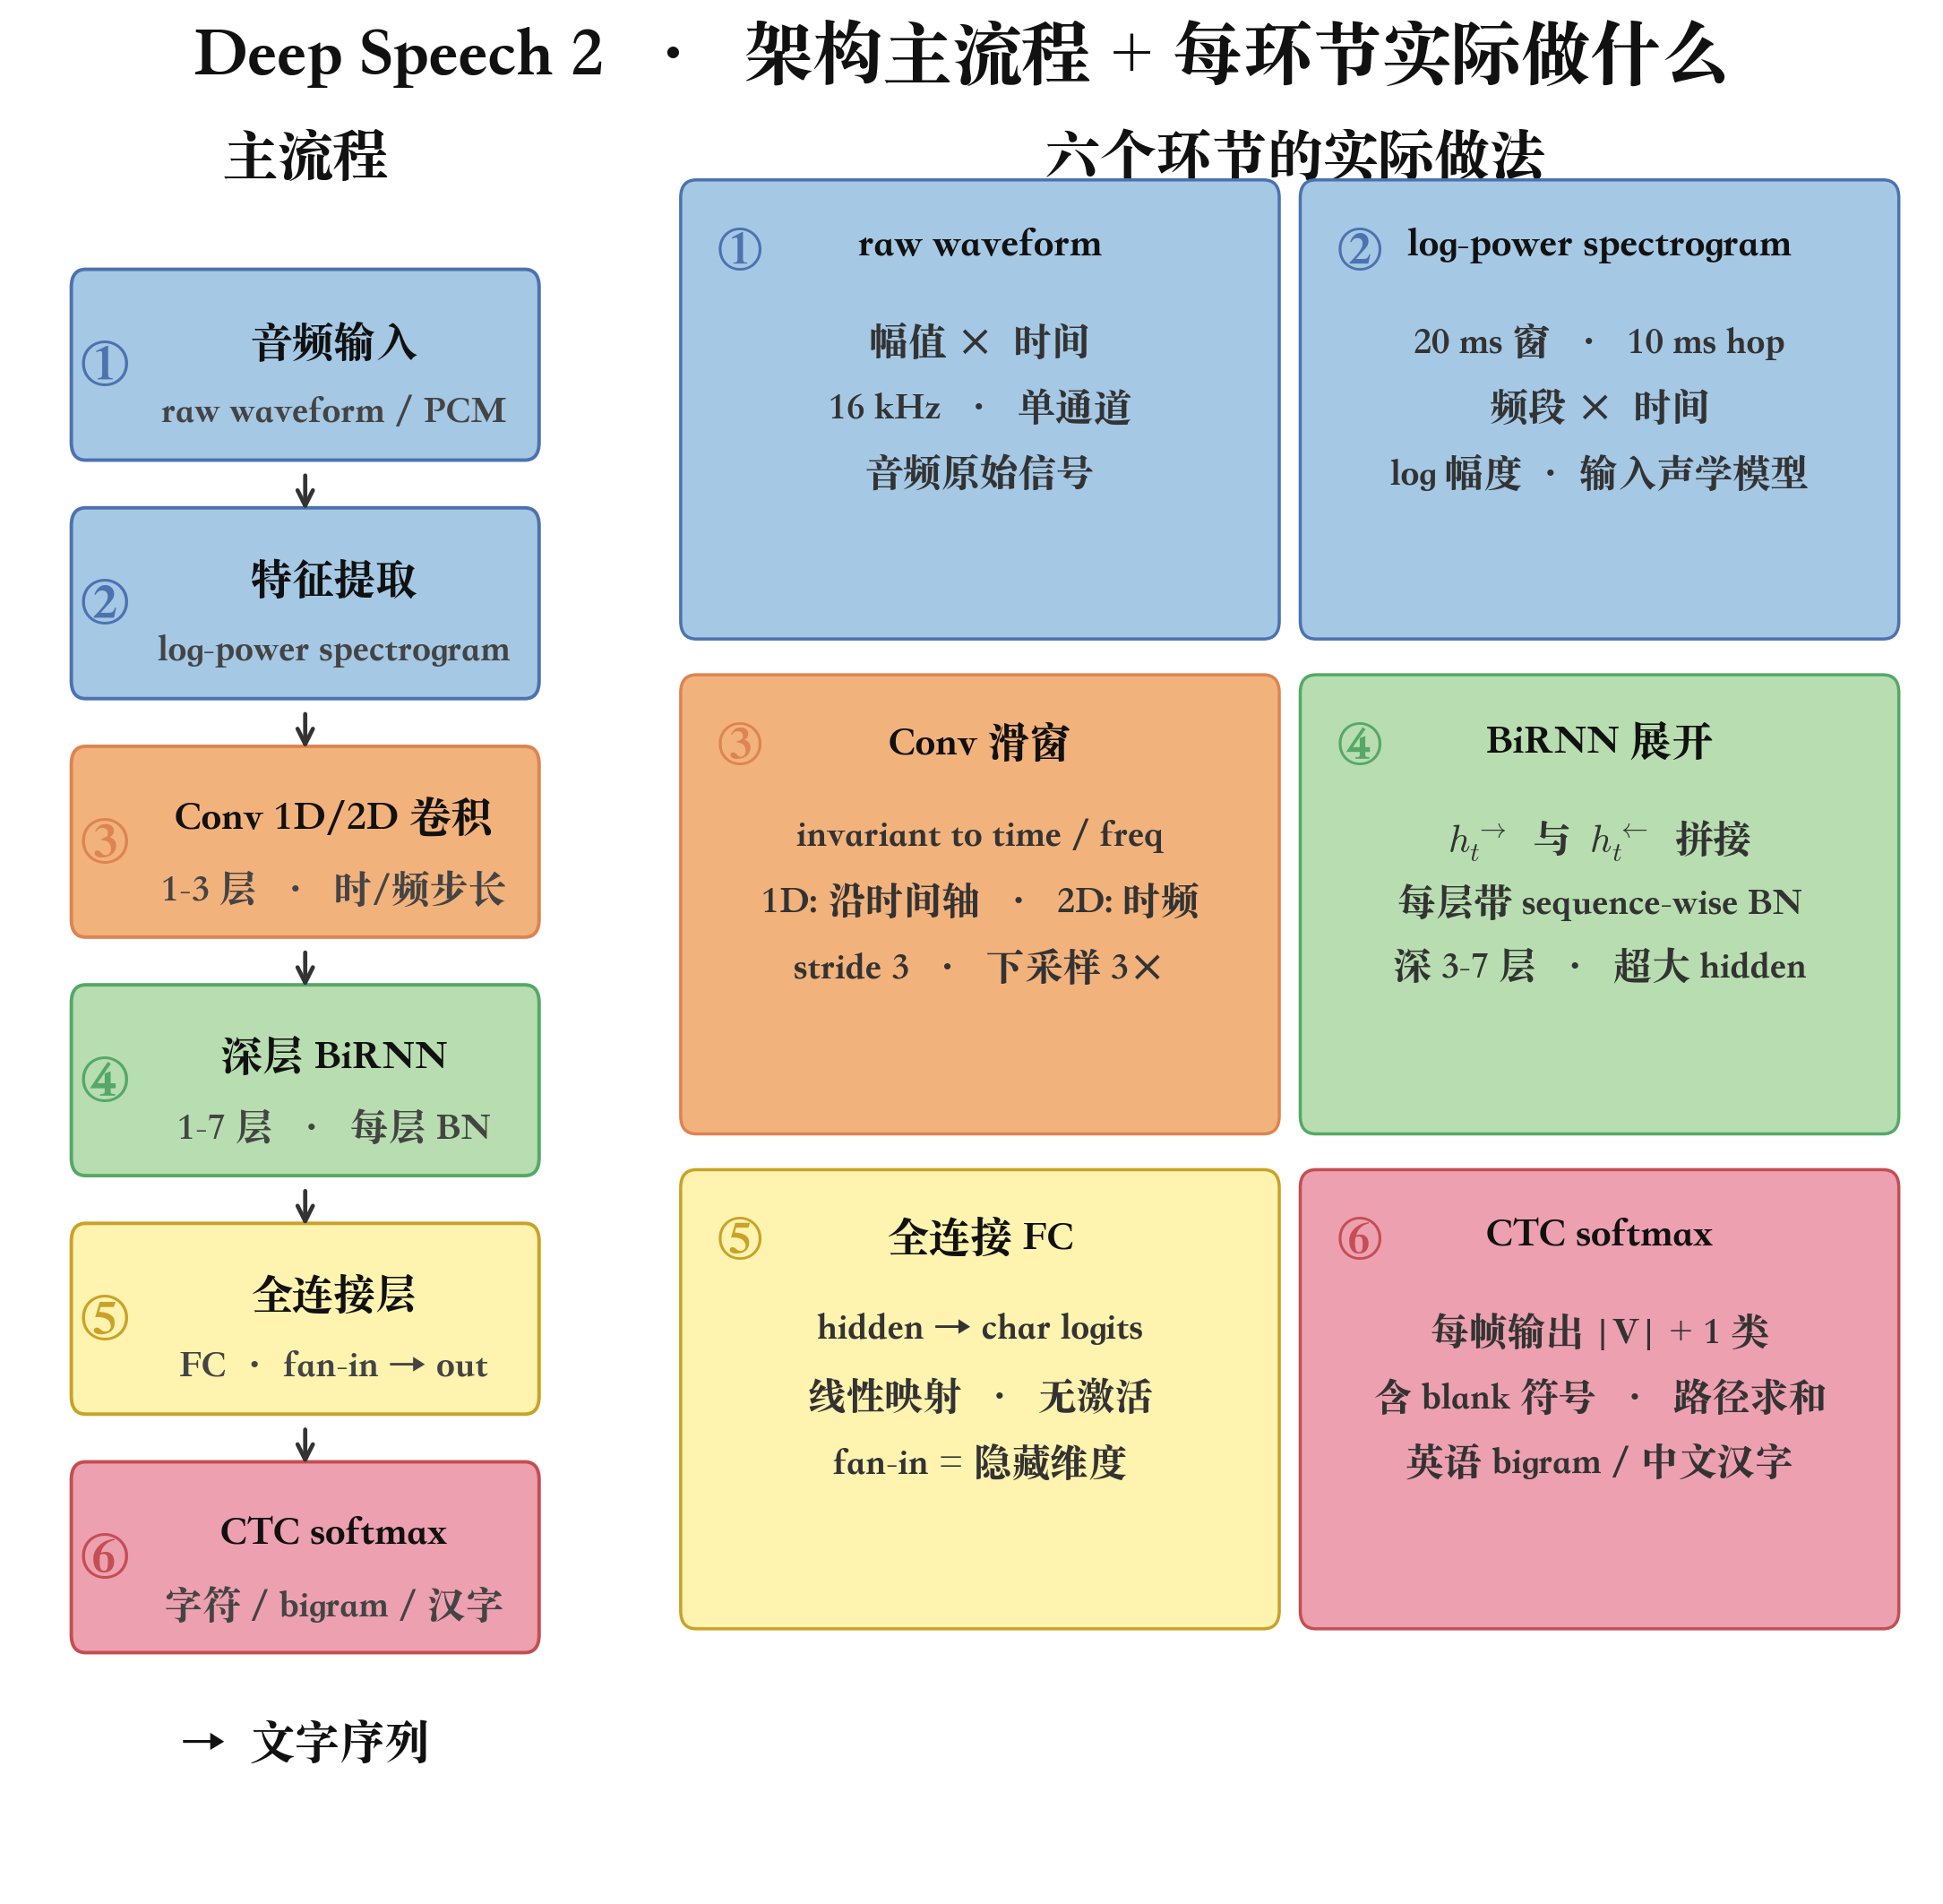
从底向上:Spectrogram 输入 → 1D 或 2D 卷积(1-3 层)→ 双向 RNN 或 GRU(1-7 层,每层带 BN)→ 全连接层 → CTC 输出。最深的英语模型是 11 层、100M 参数,输出可以是 unigram 或非重叠 bigram(最佳英语 DS2 结果用 bigram + stride 3);中文输出简体汉字(约 6000 类)。
架构本身不新------RNN 有人用过、CNN 有人用过、CTC 是 Graves 2006 的。DS2 的贡献是在这个骨架上把每个环节的工程细节都调到能大规模跑起来,然后给出对比数据说服你每一步都值得。
三、让 BiRNN 变深:Sequence-wise BatchNorm
DS1 只有 1 层 recurrent;DS2 想加到 7 层。加深马上遇到优化问题------梯度爆炸、收敛慢。BN 是标配思路,但 RNN 用 BN 有个 subtle 的坑:跨哪个维度算统计量?
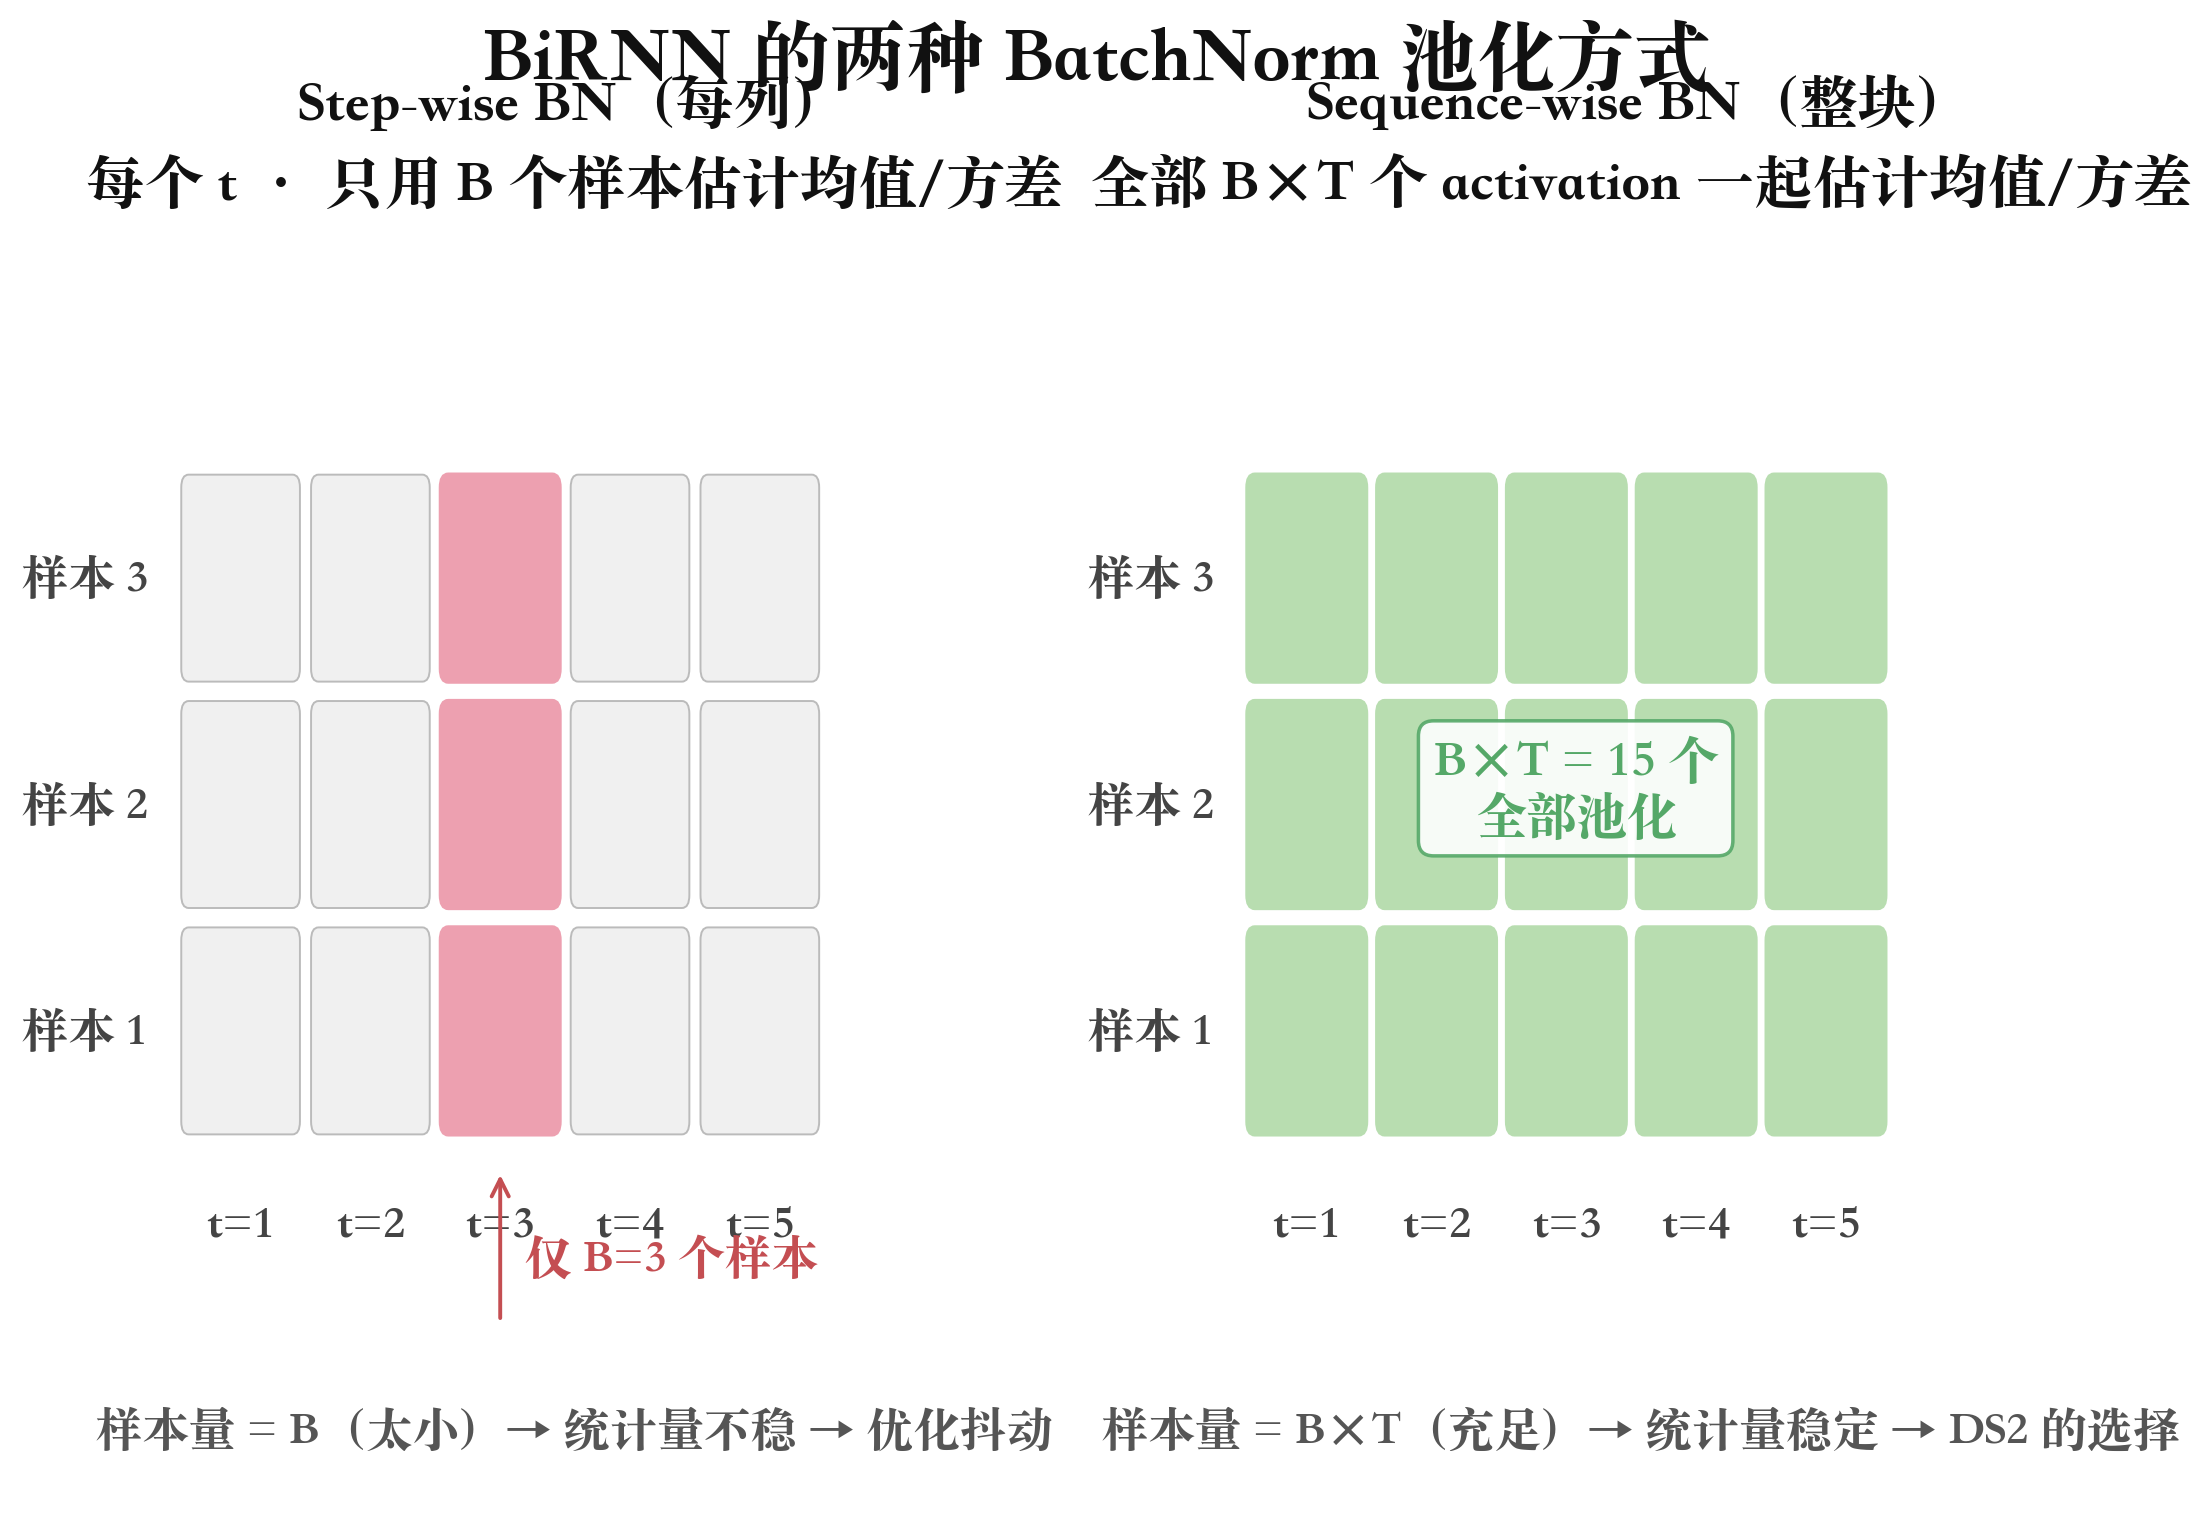
- step-wise :每个 time step 内、跨 batch 的 B 个样本算均值方差。DS2 在这组深层 RNN 实验里没看到优化改善------因为 RNN 有序列依赖,同一个 t 的 activation 只能拿 B 个样本平均,样本量太小 → 统计量抖 → 优化不稳。想把不同 t 也平均进来,backprop 会变得非常麻烦。
- sequence-wise(DS2 选择):整段序列 B × T 个 activation 一起池化,得到一个均值 + 一个方差,用它归一化整段。统计量稳定、backprop 简单。
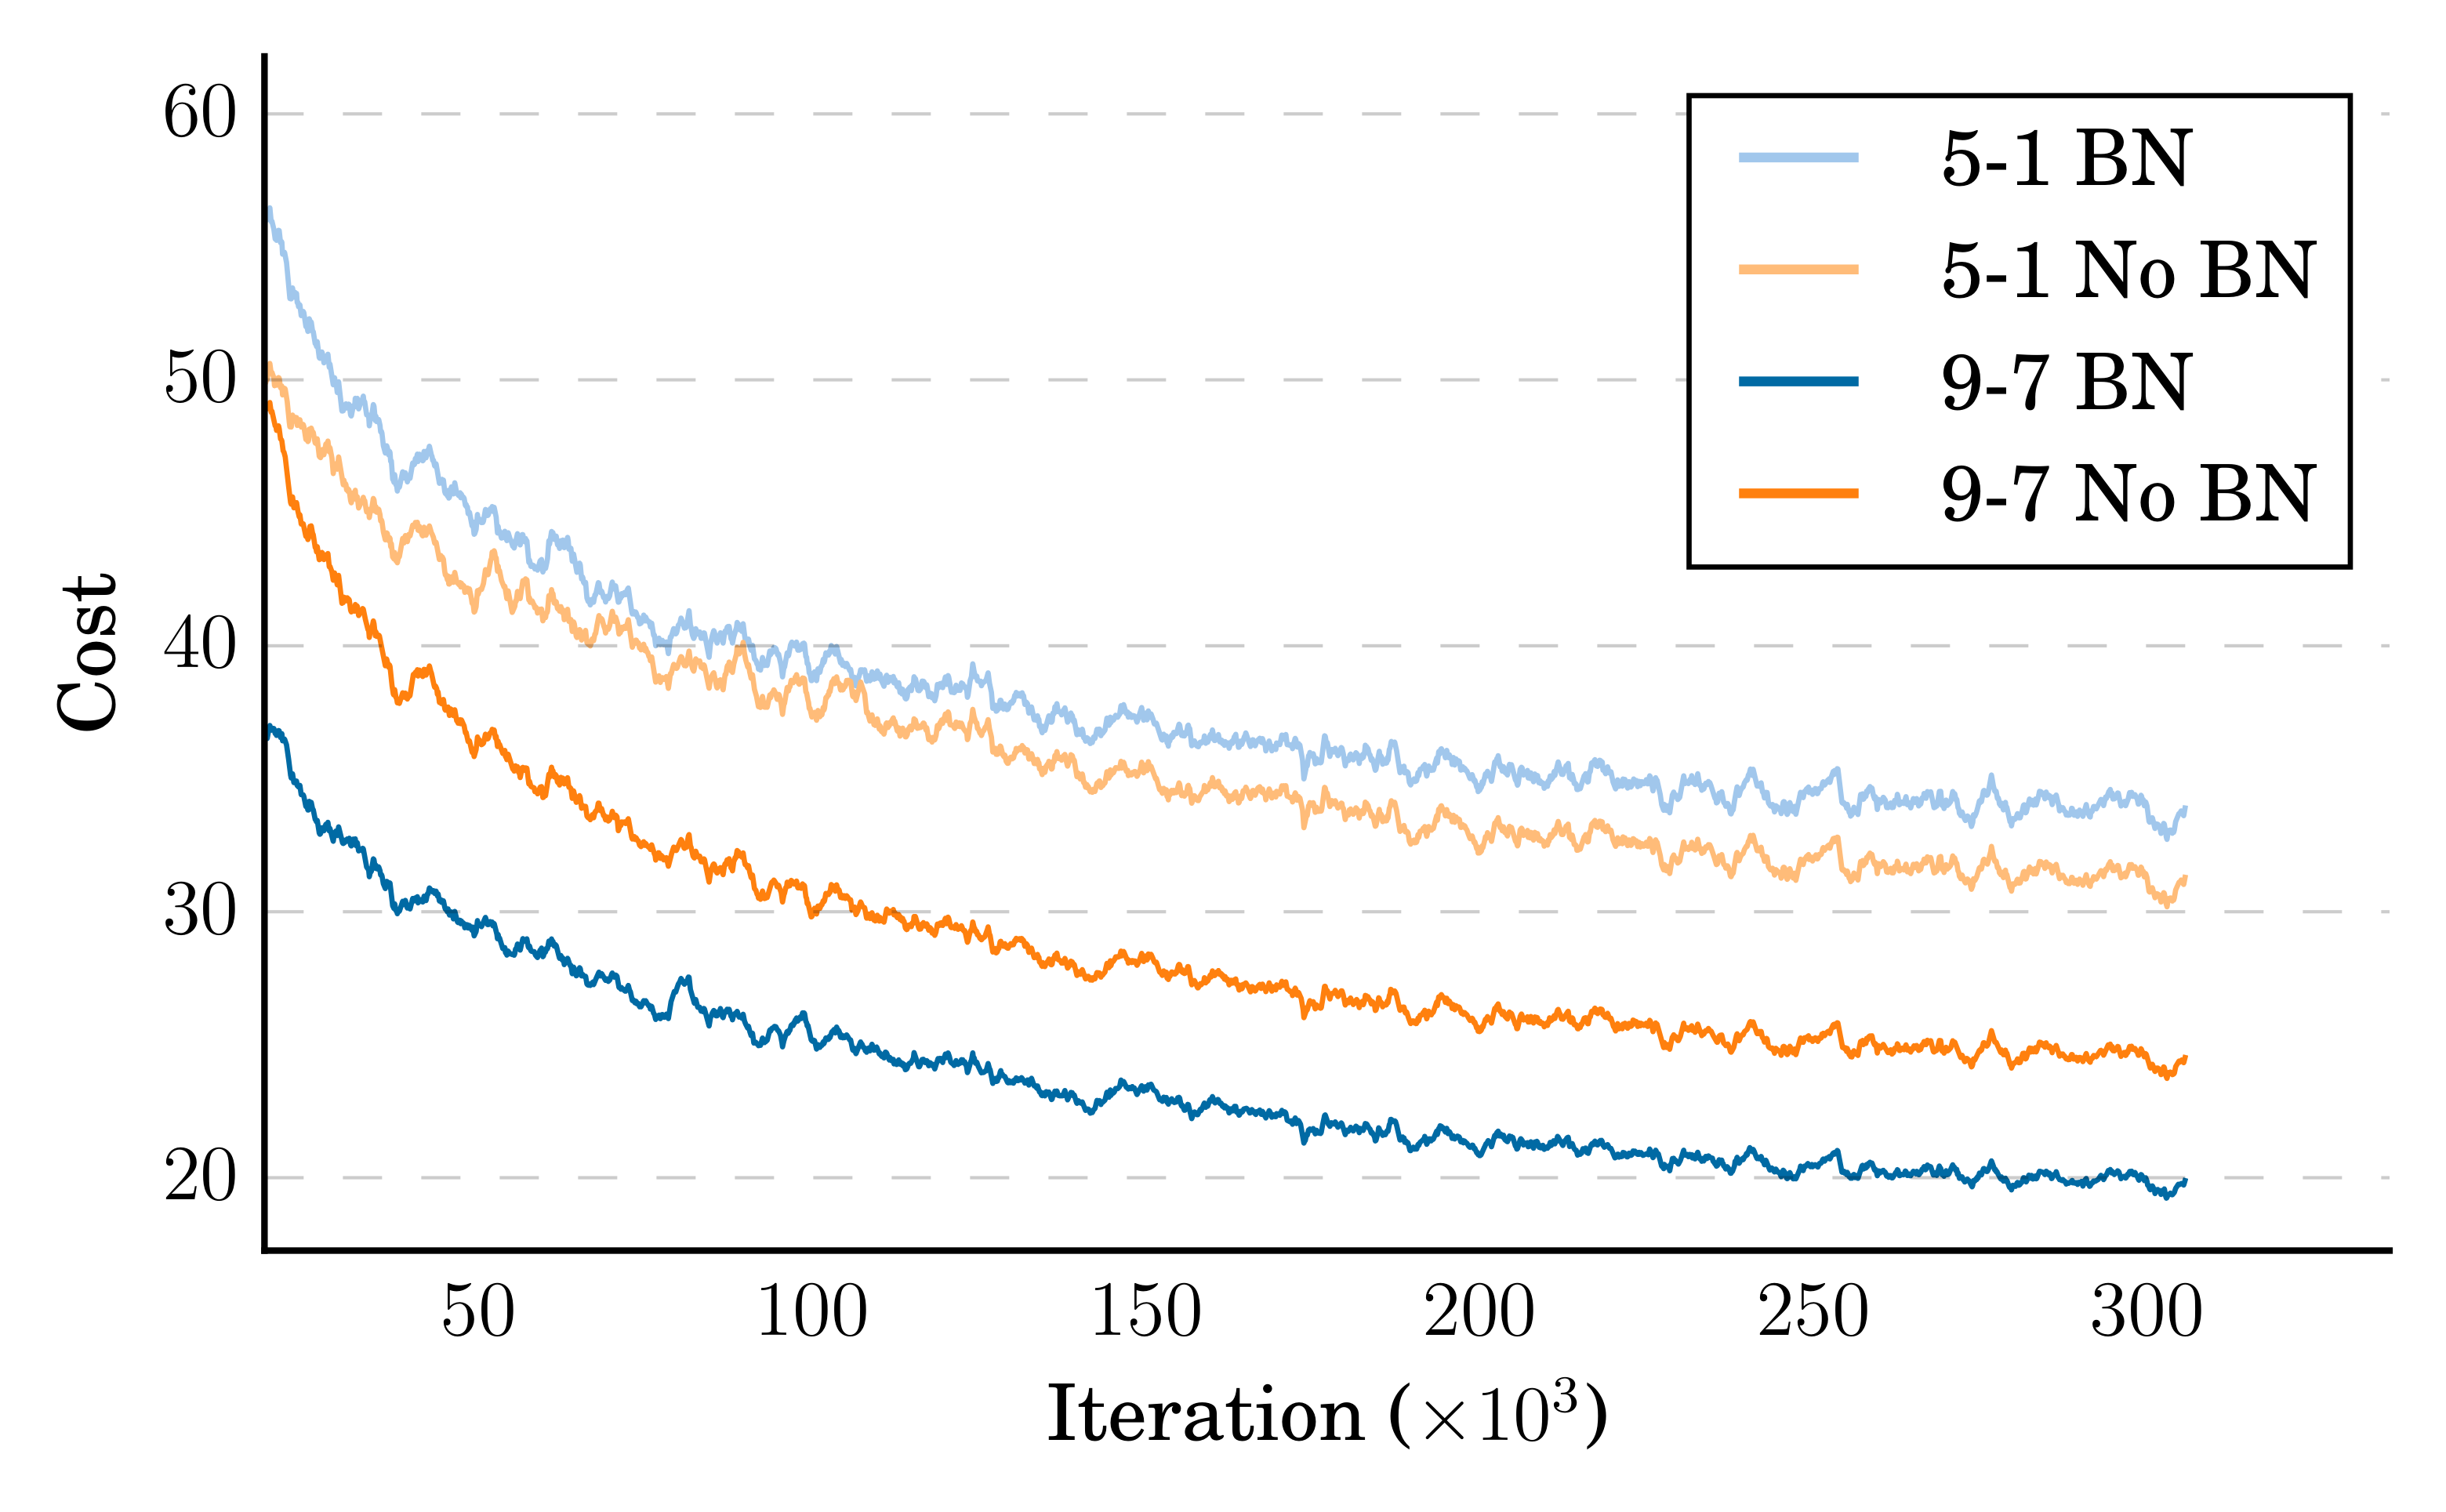
实验结果 :sequence-wise BN 越深收益越大 ------1 层 recurrent 时 BN 反而伤(13.55 → 14.40 dev WER),3 层起 BN 涨点,9 层深网 dev WER 从 10.83 → 9.52(相对 12%)。BN 对深网收益大、对浅网无益甚至有害(跟 CV 里的观察一致)。完整层数消融见原论文 Table 1。
部署侧的坑:BN 训练靠 minibatch 统计量,但部署时一次只来一条 utterance,B=1 → 统计量退化。DS2 沿用 CV 里的做法------训练时维护一个 running average 的均值方差,部署时用它。
四、SortaGrad:一次课程学习
DS2 的另一个"看似很小、实际很有用"的技巧。动机:CTC 损失是每帧概率的乘积
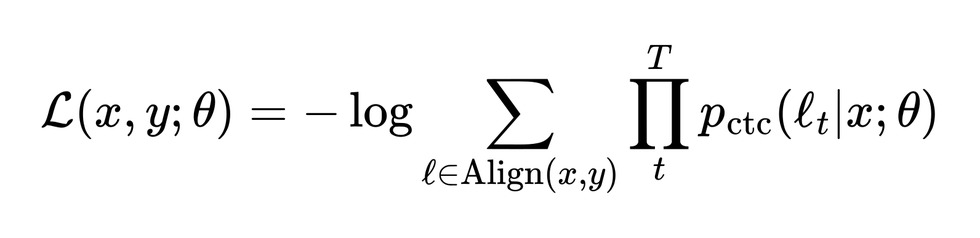
序列越长、这个乘积越接近 0、log 出来 loss 越大。长 utterance 通常 loss 更高,论文怀疑(原文 "we suspect")固定学习率下对应梯度也更大、更容易在训练早期触发 RNN internal state 爆炸。用固定学习率一开始就上长句,训练很脆。
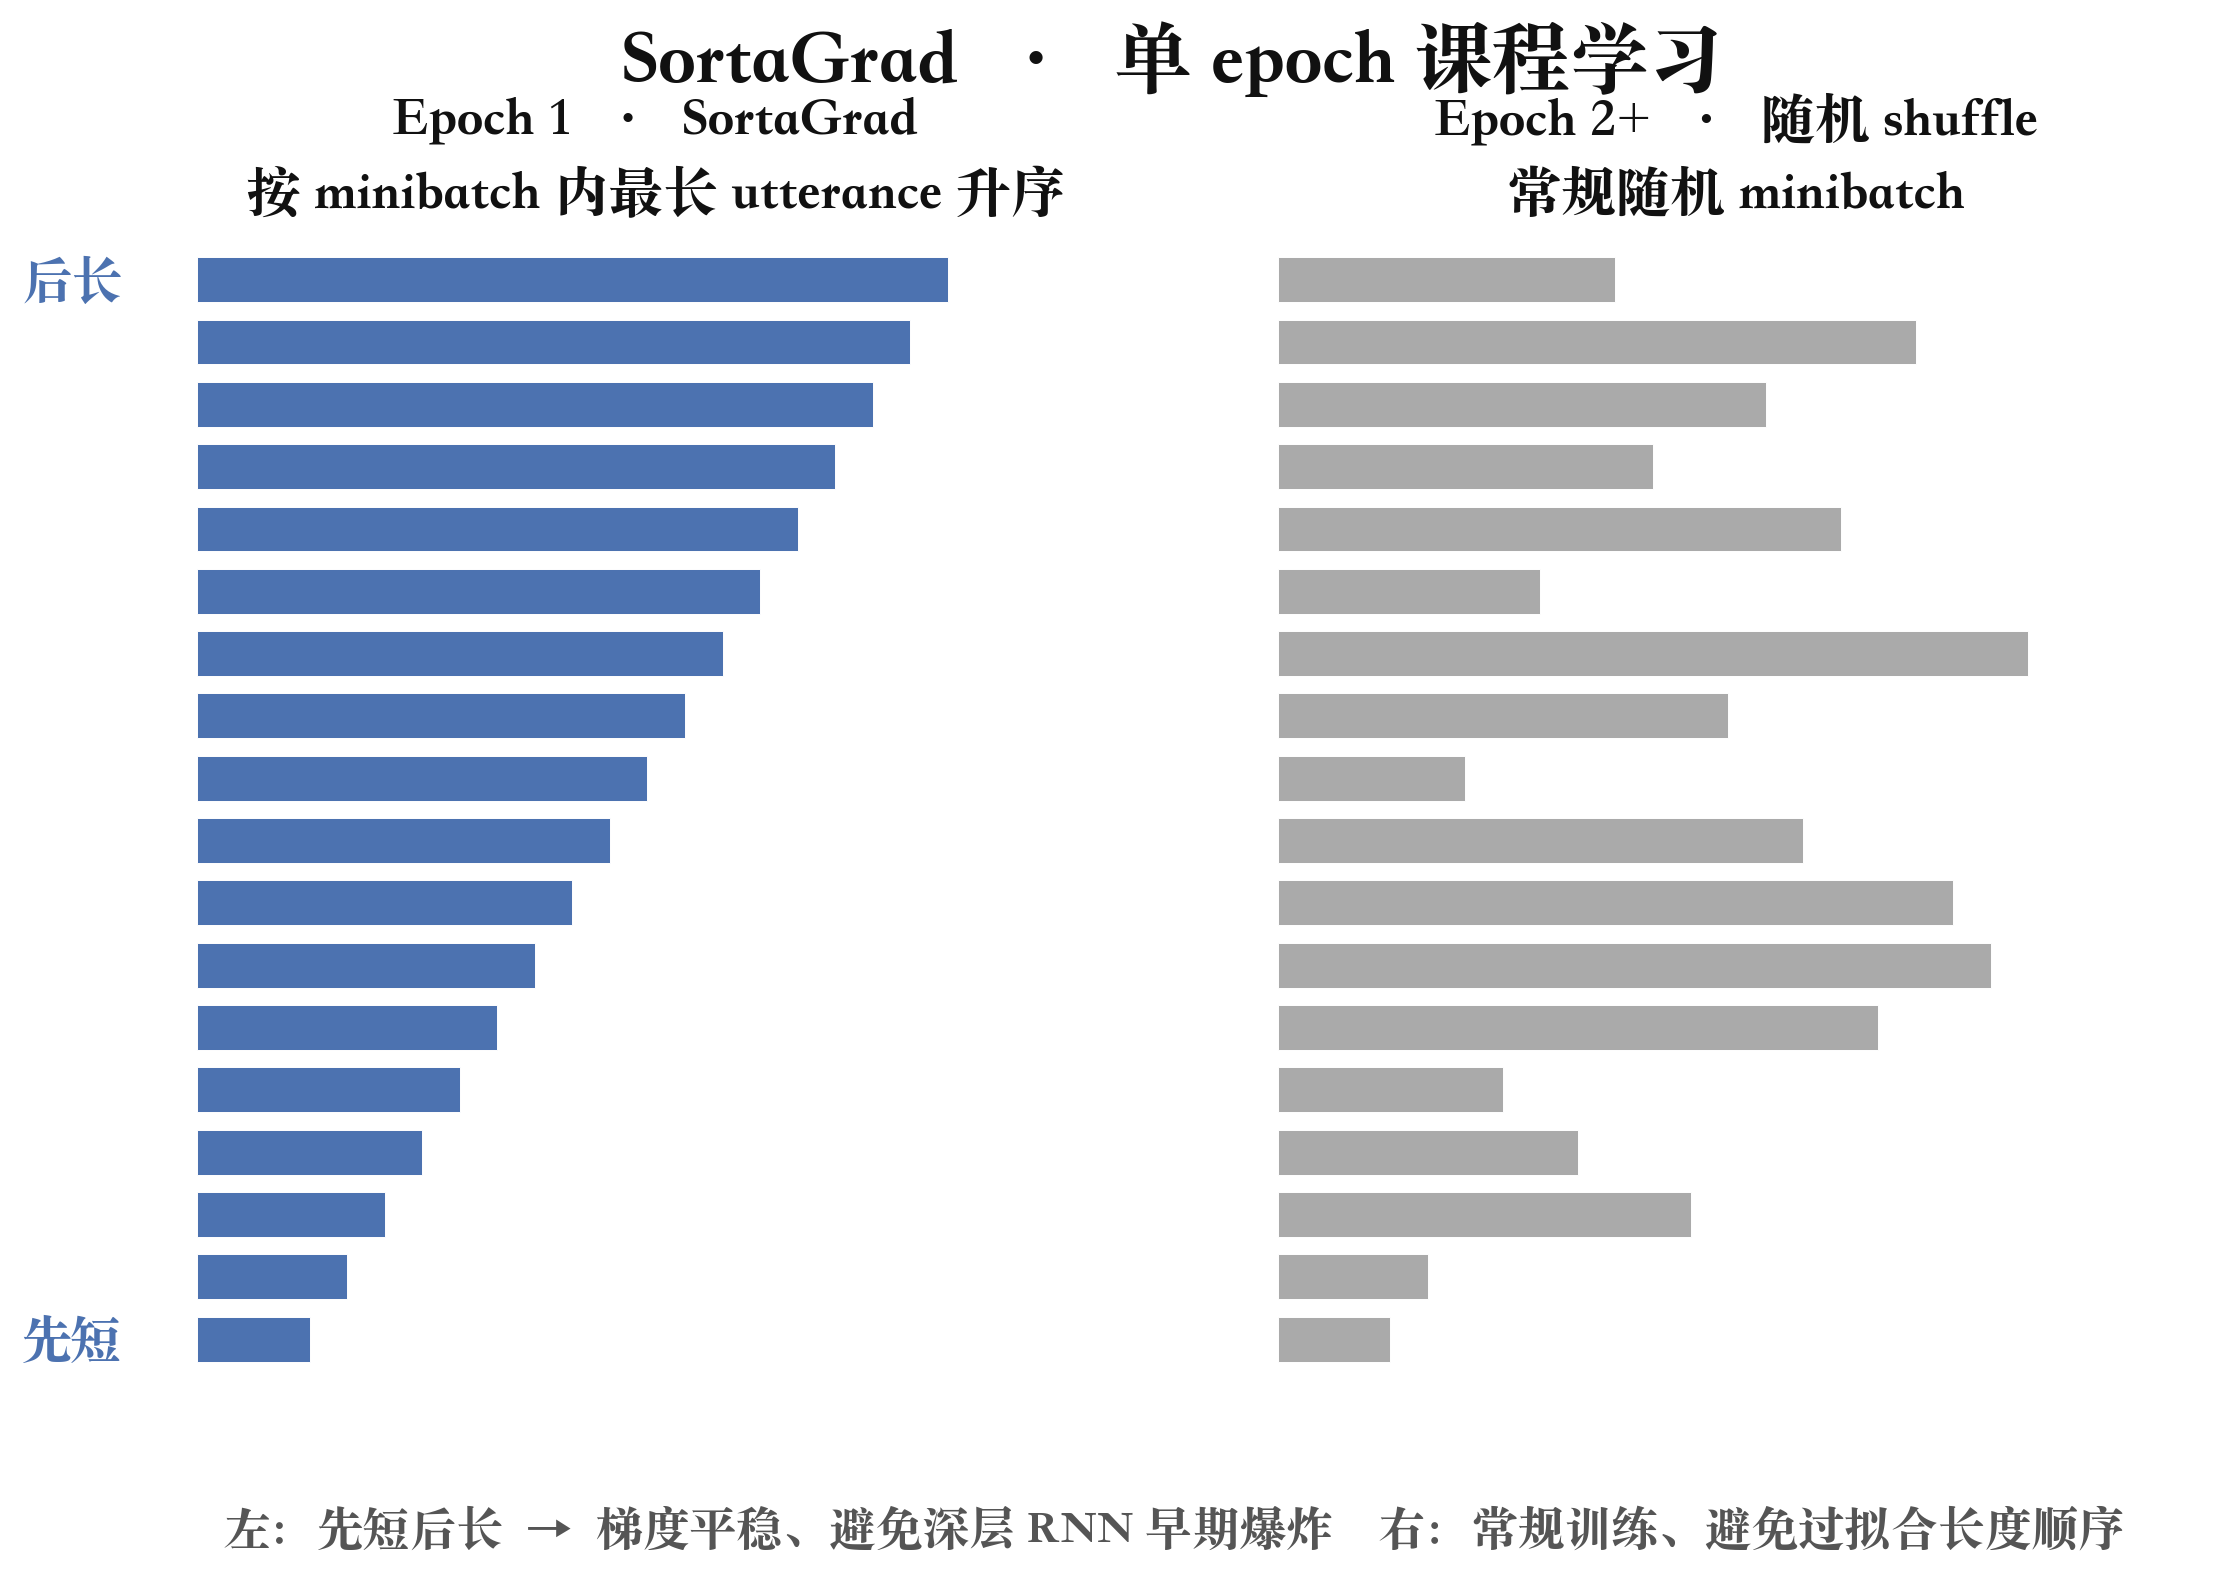
做法极其简单 :第 1 个 epoch 按 minibatch 内最长 utterance 的长度升序遍历,第 2 个 epoch 起随机 shuffle。就这------不引入额外模型或难度标注,主要只依赖 utterance 长度排序、跟具体数据集无关。
效果 :不加 BN 时 SortaGrad 把 Dev WER 从 11.96 拉到 10.83;加 BN 再叠 SortaGrad 还能再涨一小点。SortaGrad 和 BN 一定程度上互相替代(都在解决"深 RNN 前期数值不稳"这件事),但配合有增益。完整对比见原论文 Table 2。
五、2D 频谱卷积:噪声环境的救命稻草
底层的 1D 时间卷积(沿 time 卷)DS1 就有,作用是压 stride 减 time-step 数。DS2 尝试把卷积同时铺到频率维度------2D invariant conv,用 41×11 的核在 (freq, time) 两维卷。
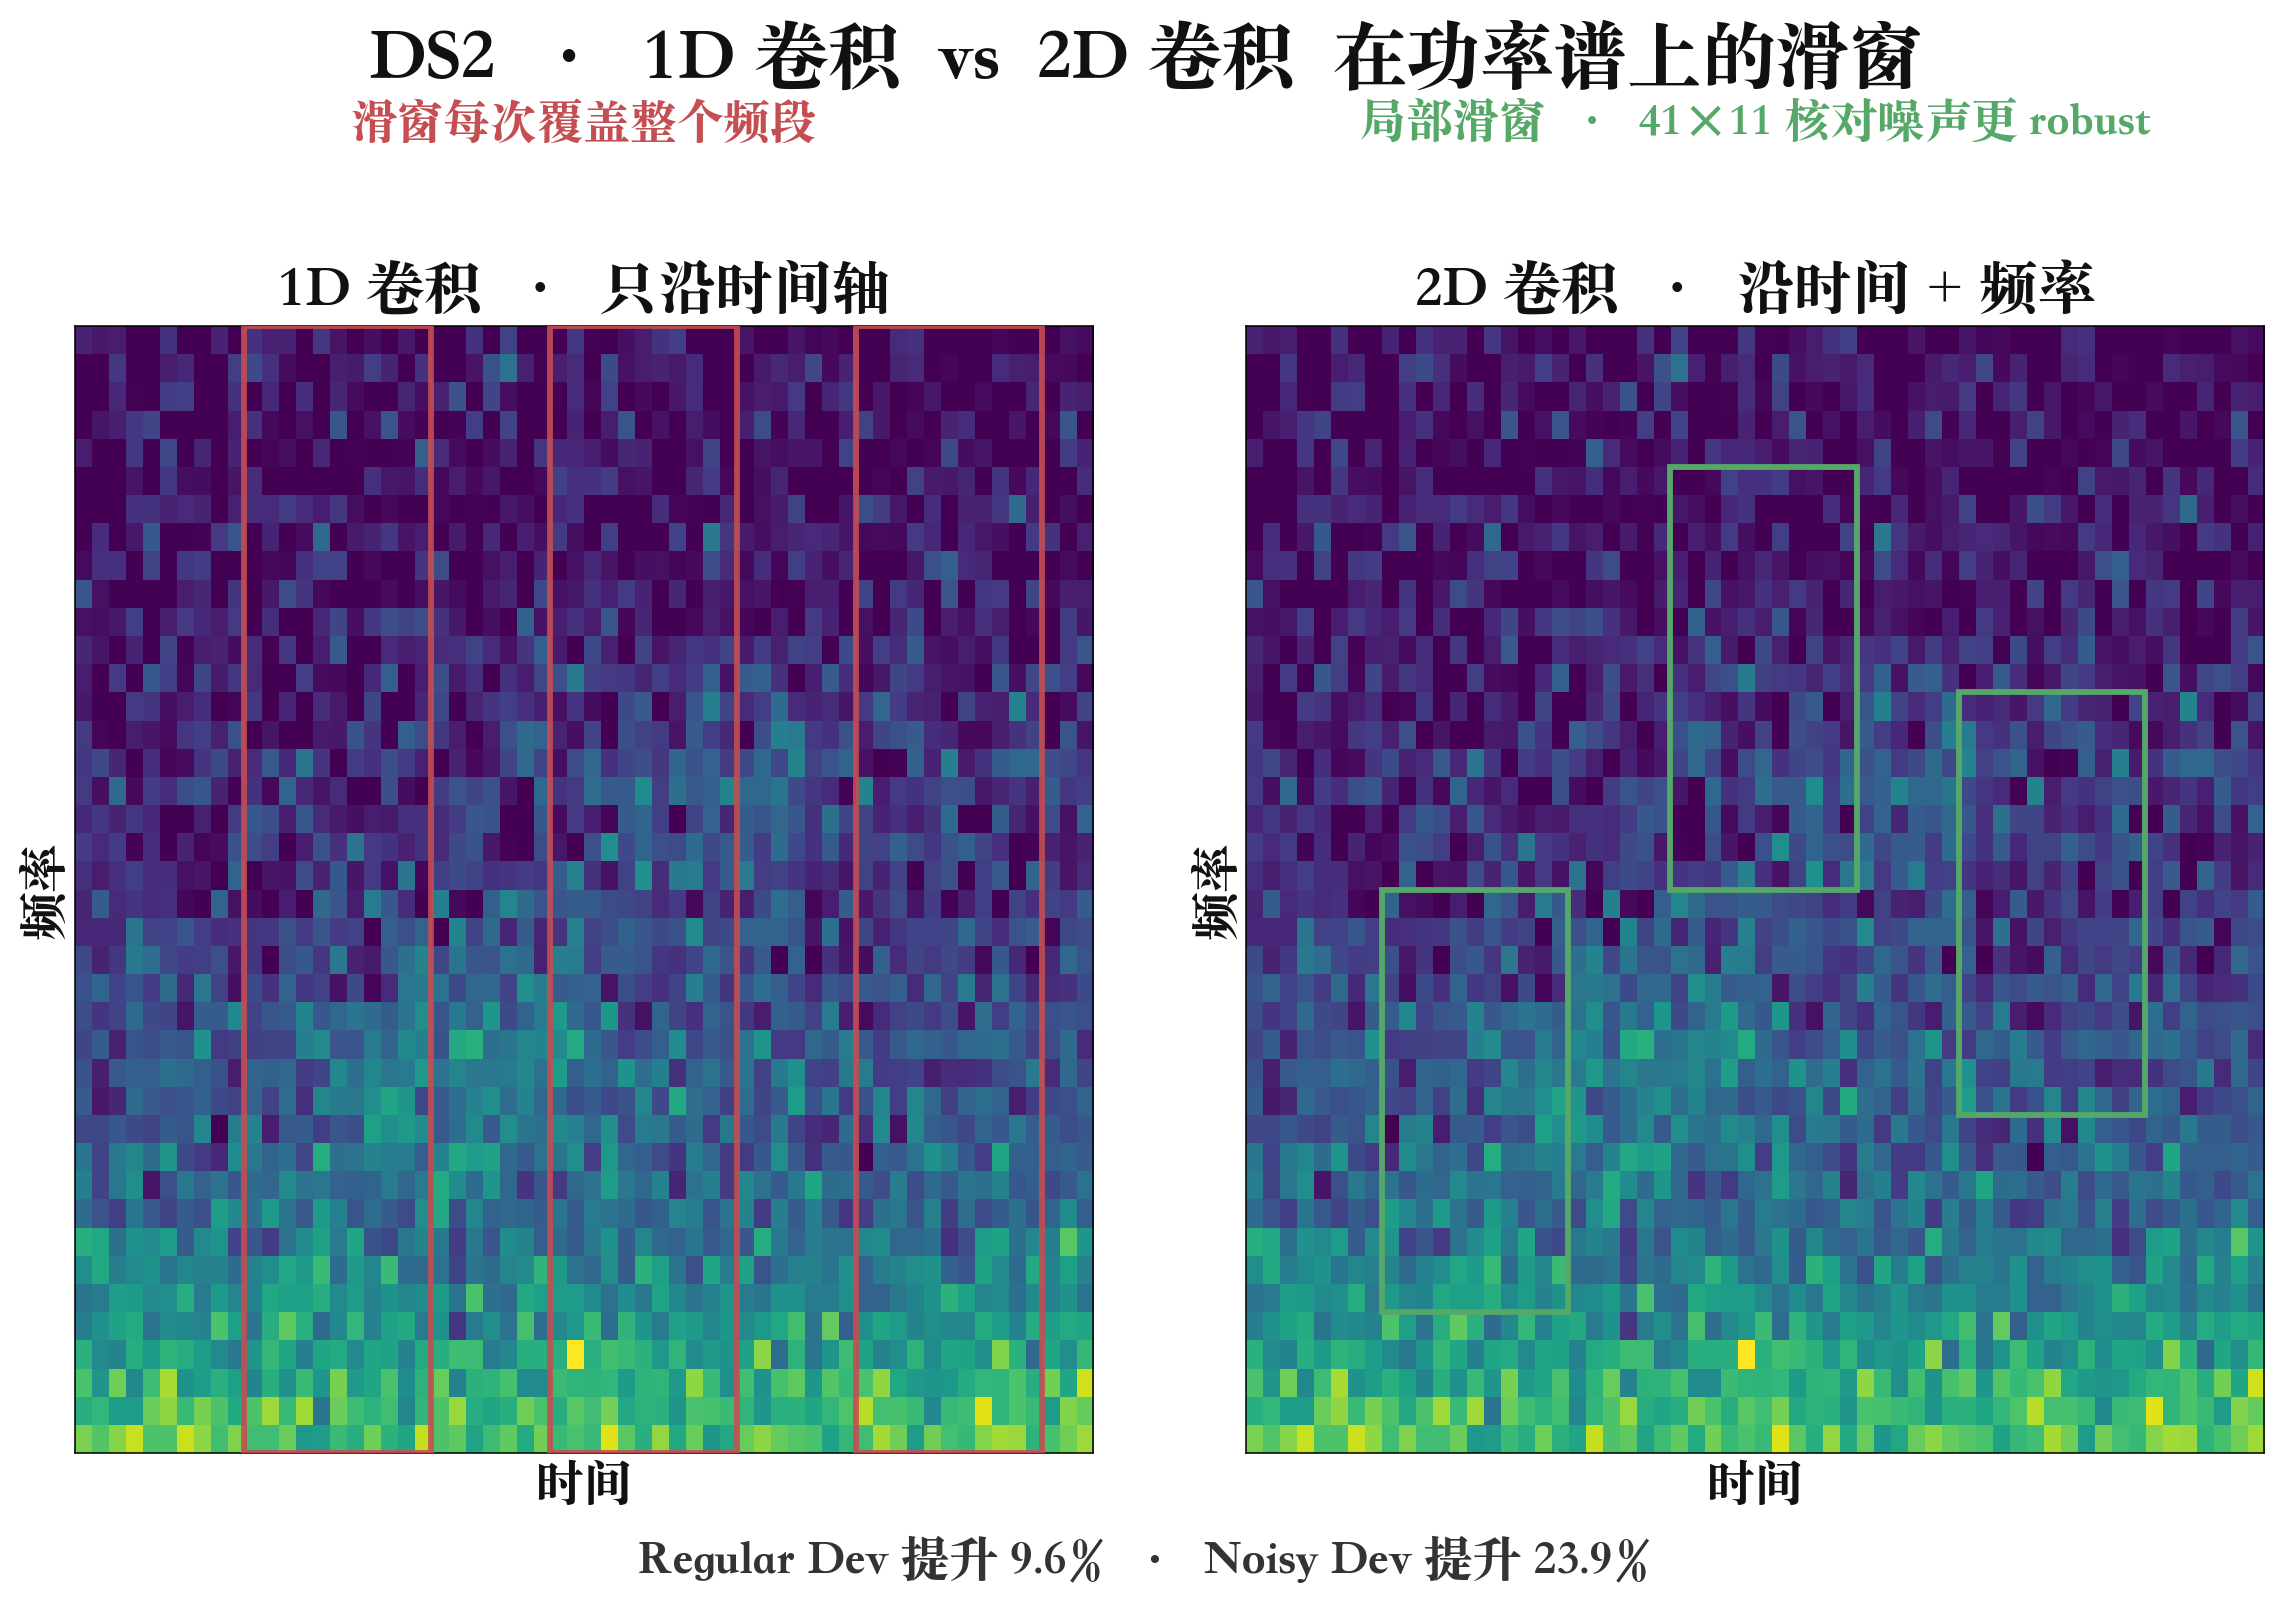
实验对比(35M 参数、7 层 RNN、其他不变;Regular Dev 是内部 2048 条朗读 dev,Noisy Dev 是 CHiME 2015 dev 抽样 2048 条)------ 保留关键 3 行:
| 架构 | Regular Dev | Noisy Dev |
|---|---|---|
| 1-layer 1D(DS1 风格) | 9.52 | 19.36 |
| 3-layer 2D(DS2 最佳) | 8.61 | 14.74 |
| 相对提升 | ↓ 9.6% | ↓ 23.9% |
噪声集从 19.36 到 14.74,相对提升 23.9%;干净集只提升一点。一个可能的解释是------频域卷积保留并利用局部频谱结构,对说话人 / 通道 / 噪声导致的频谱变化更鲁棒。别把收益单独归因于 formant drift,论文本身只报告了噪声集提升更大、没做机制层面的归因。完整消融见原论文 Table 4。
六、Striding + Bigram:解决英语的字符密度问题
DS2 想在 stride=3 而不是 stride=2 上跑(stride 越大,RNN 展开越少、更快)。但英语字符密度是 14.1 char/s,中文只有 3.3 char/s------stride 大到一定程度后 RNN 一帧对不上一个字符,CTC 要求 T ≥ 输出长度就崩。
DS2 的解药:把字母表扩到 bigram(非重叠 2-gram) 。句子 the cat sat 原本 unigram 展开是 t,h,e,_,c,a,t,_,s,a,t 共 11 个 token;bigram 版本 [th, e, _, ca, t, _, sa, t] 是 8 个 token(每个偶字符长度词减半 + 奇字符词剩一个单字符 unigram + 空格单独一个 token)。这个例子 11→8 缩短约 27%(论文只说 "shorten the length"、没给全语料平均比例)------足够让 unrolled RNN 时间步下来一个档次。
| Stride | Unigram no LM | Bigram no LM | Unigram +LM | Bigram +LM |
|---|---|---|---|---|
| 2 | 14.93 | 14.56 | 9.52 | 9.66 |
| 3 | 15.01 | 15.60 | 9.65 | 10.06 |
| 4 | 18.86 | 14.84 | 11.92 | 9.93 |
stride 2 上 unigram/bigram 打平;stride 3 上 unigram 反而略优于 bigram(15.01 vs 15.60、9.65 vs 10.06);stride 4 上 unigram 崩到 18.86 而 bigram 稳在 14.84。bigram 的主要价值体现在 stride=4 时避免 unigram 明显崩掉------stride 3 上还没到必需。中文因为字符密度低,直接单字符 + stride 就行,不用 bigram。
解码口径 :CTC 声学分支给出的是每帧字符(或 bigram / blank)概率,但DS2 报的 WER 是"CTC 输出 + n-gram LM + word-count 惩罚"三项 log 线性组合后的 beam search 结果:
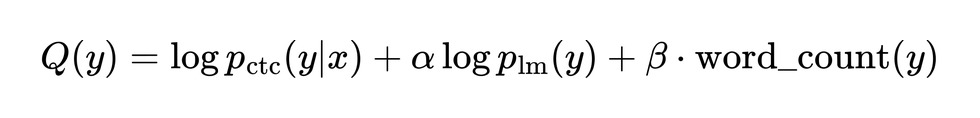
英语 beam=500、中文 beam=200;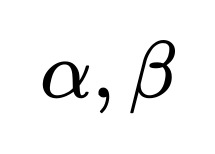 在 dev 上调。表 5/6 中 "no LM" 和 "+LM" 就是这个 LM 加不加的区别(中英不加 LM 时英语网络自己也能拼对大部分词,加了 5-gram LM 相对再涨 36-48%)。原论文 §3.8 是完整定义。
七、数据缩放:power law 稳定
DS2 收集了 11940 小时英语和 9400 小时中文语料,比公开数据集大一到两个数量级。做这么大数据的价值有多少?
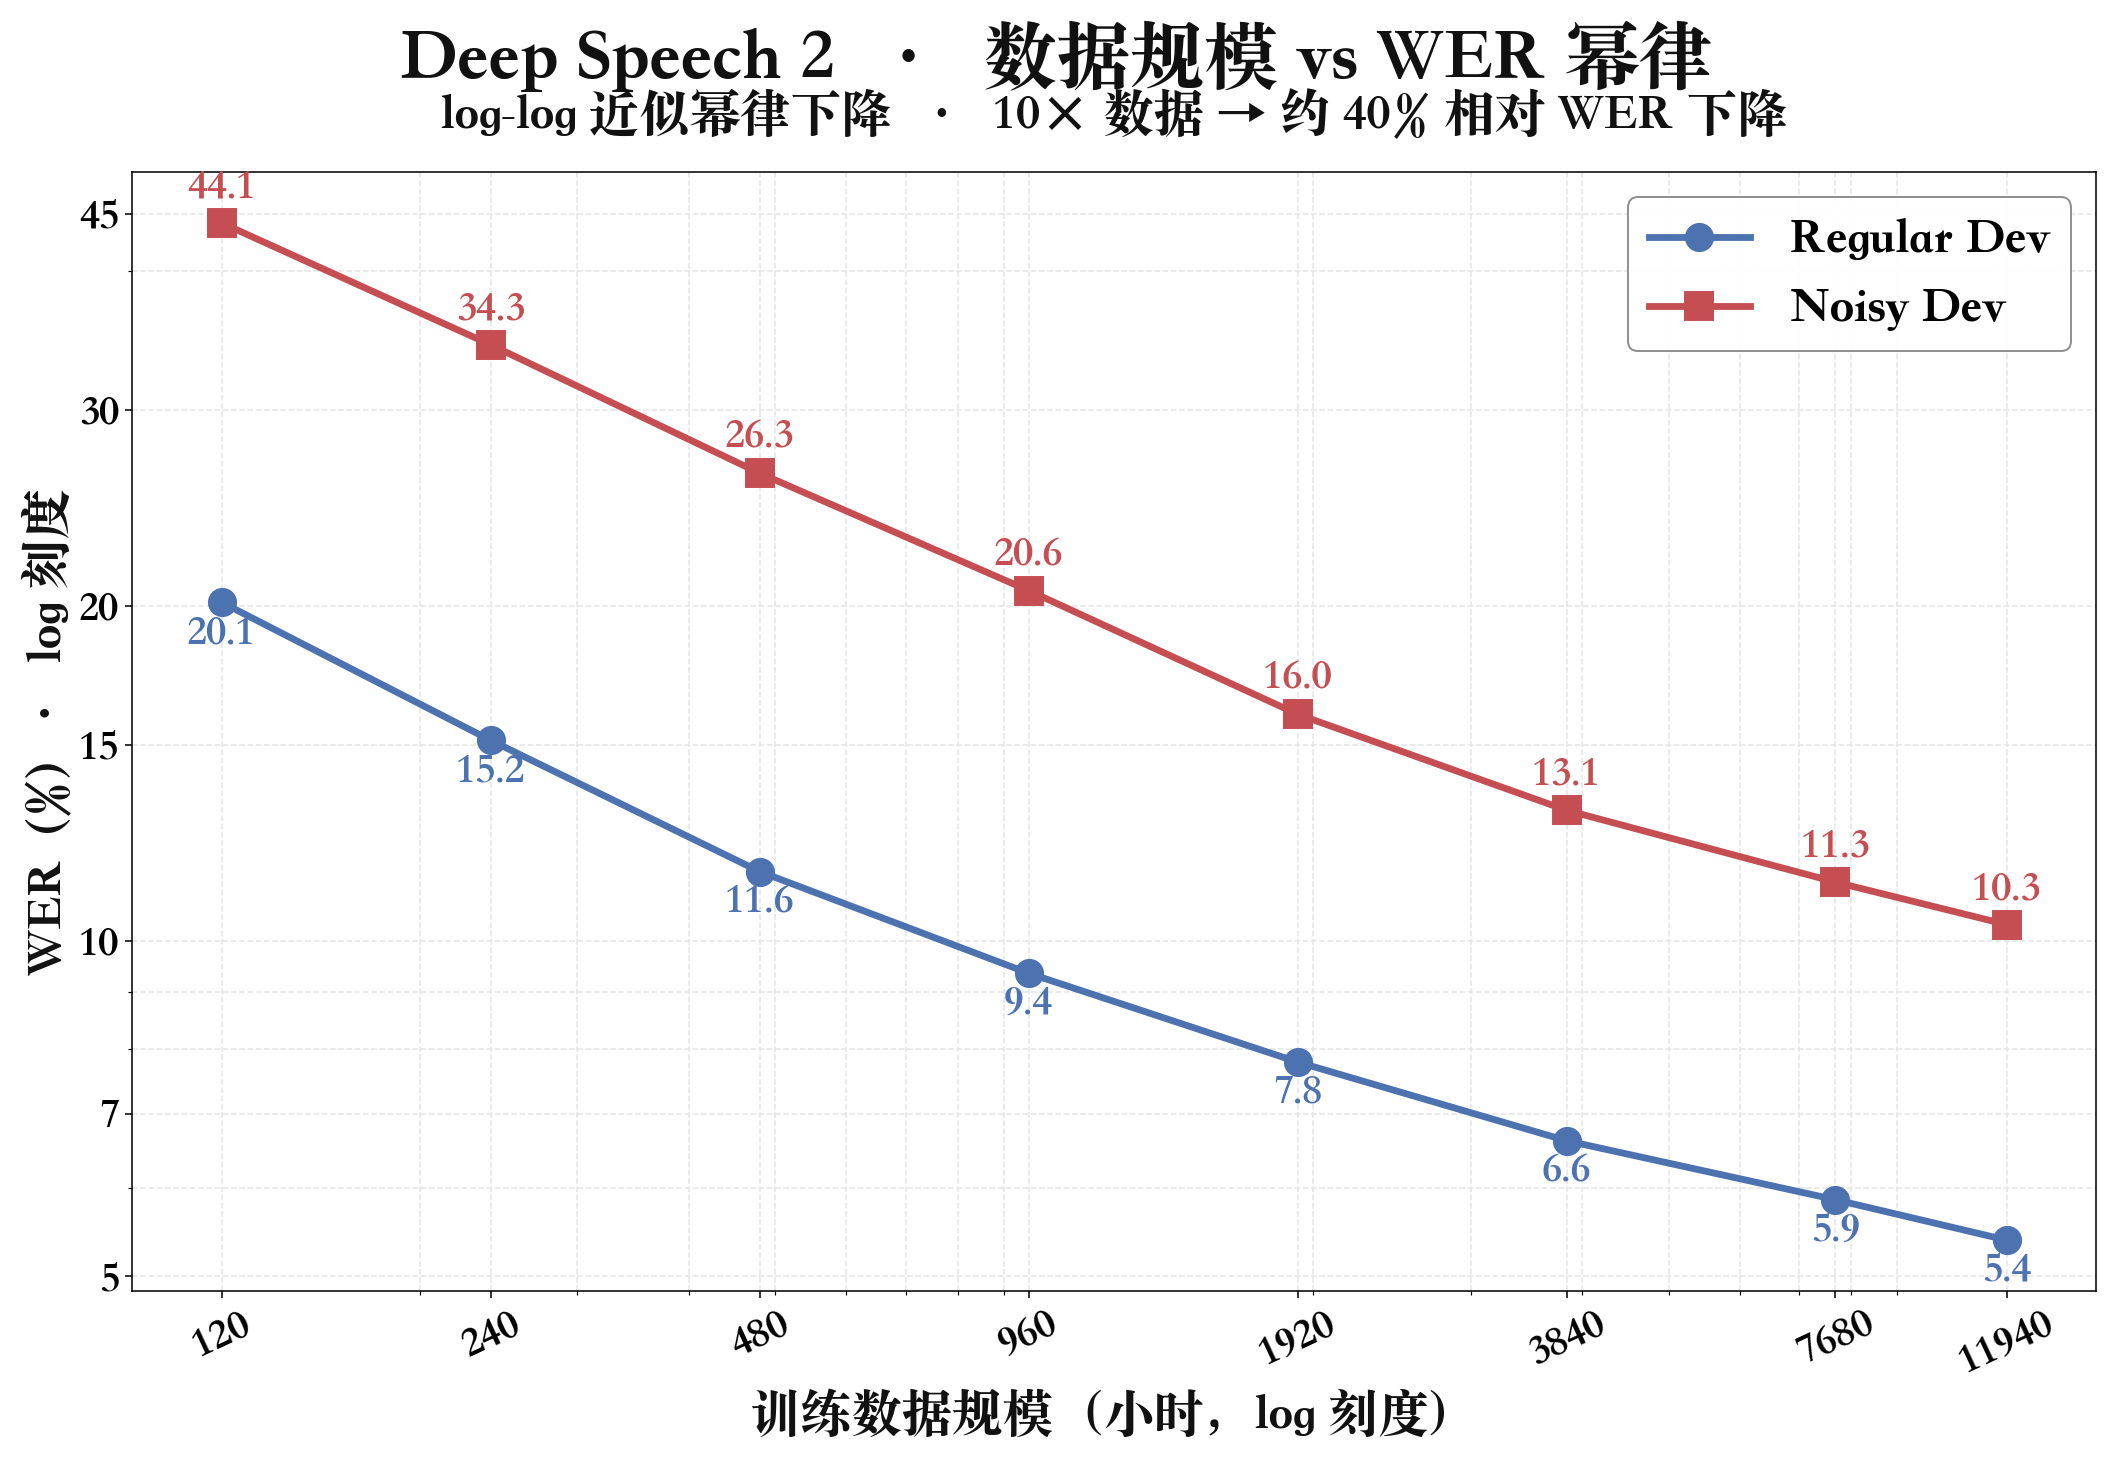
log-log 图上近似幂律下降:论文概括为每 10× 数据约 40% 相对 WER 下降 (按图中 120→12000 端点粗算 Regular 约 46%、Noisy 约 48%,局部区间波动更大)。Noisy 与 Regular 的相对 gap 大体维持在同一量级(60%-75% 之间)------这提示光靠随机扩大全量数据不足以专门缩小噪声环境的差距,需要针对性加噪声语料。
DS2 也用了简单的 data augmentation:40% 的 utterance 随机叠加噪声。论文没做"随数据规模变大 augmentation 收益如何变"的消融,我这里不外推结论。
八、部署:Row Convolution 让单向 RNN 追上双向
BiRNN 上线的死结 :反向那半必须等整段 utterance 看完才能算 h_t^{backward}。流式首字延迟 = 整段时长,用户说 10 秒等 10 秒才能看到第一个字。改成纯单向前向 RNN 又掉点太多。
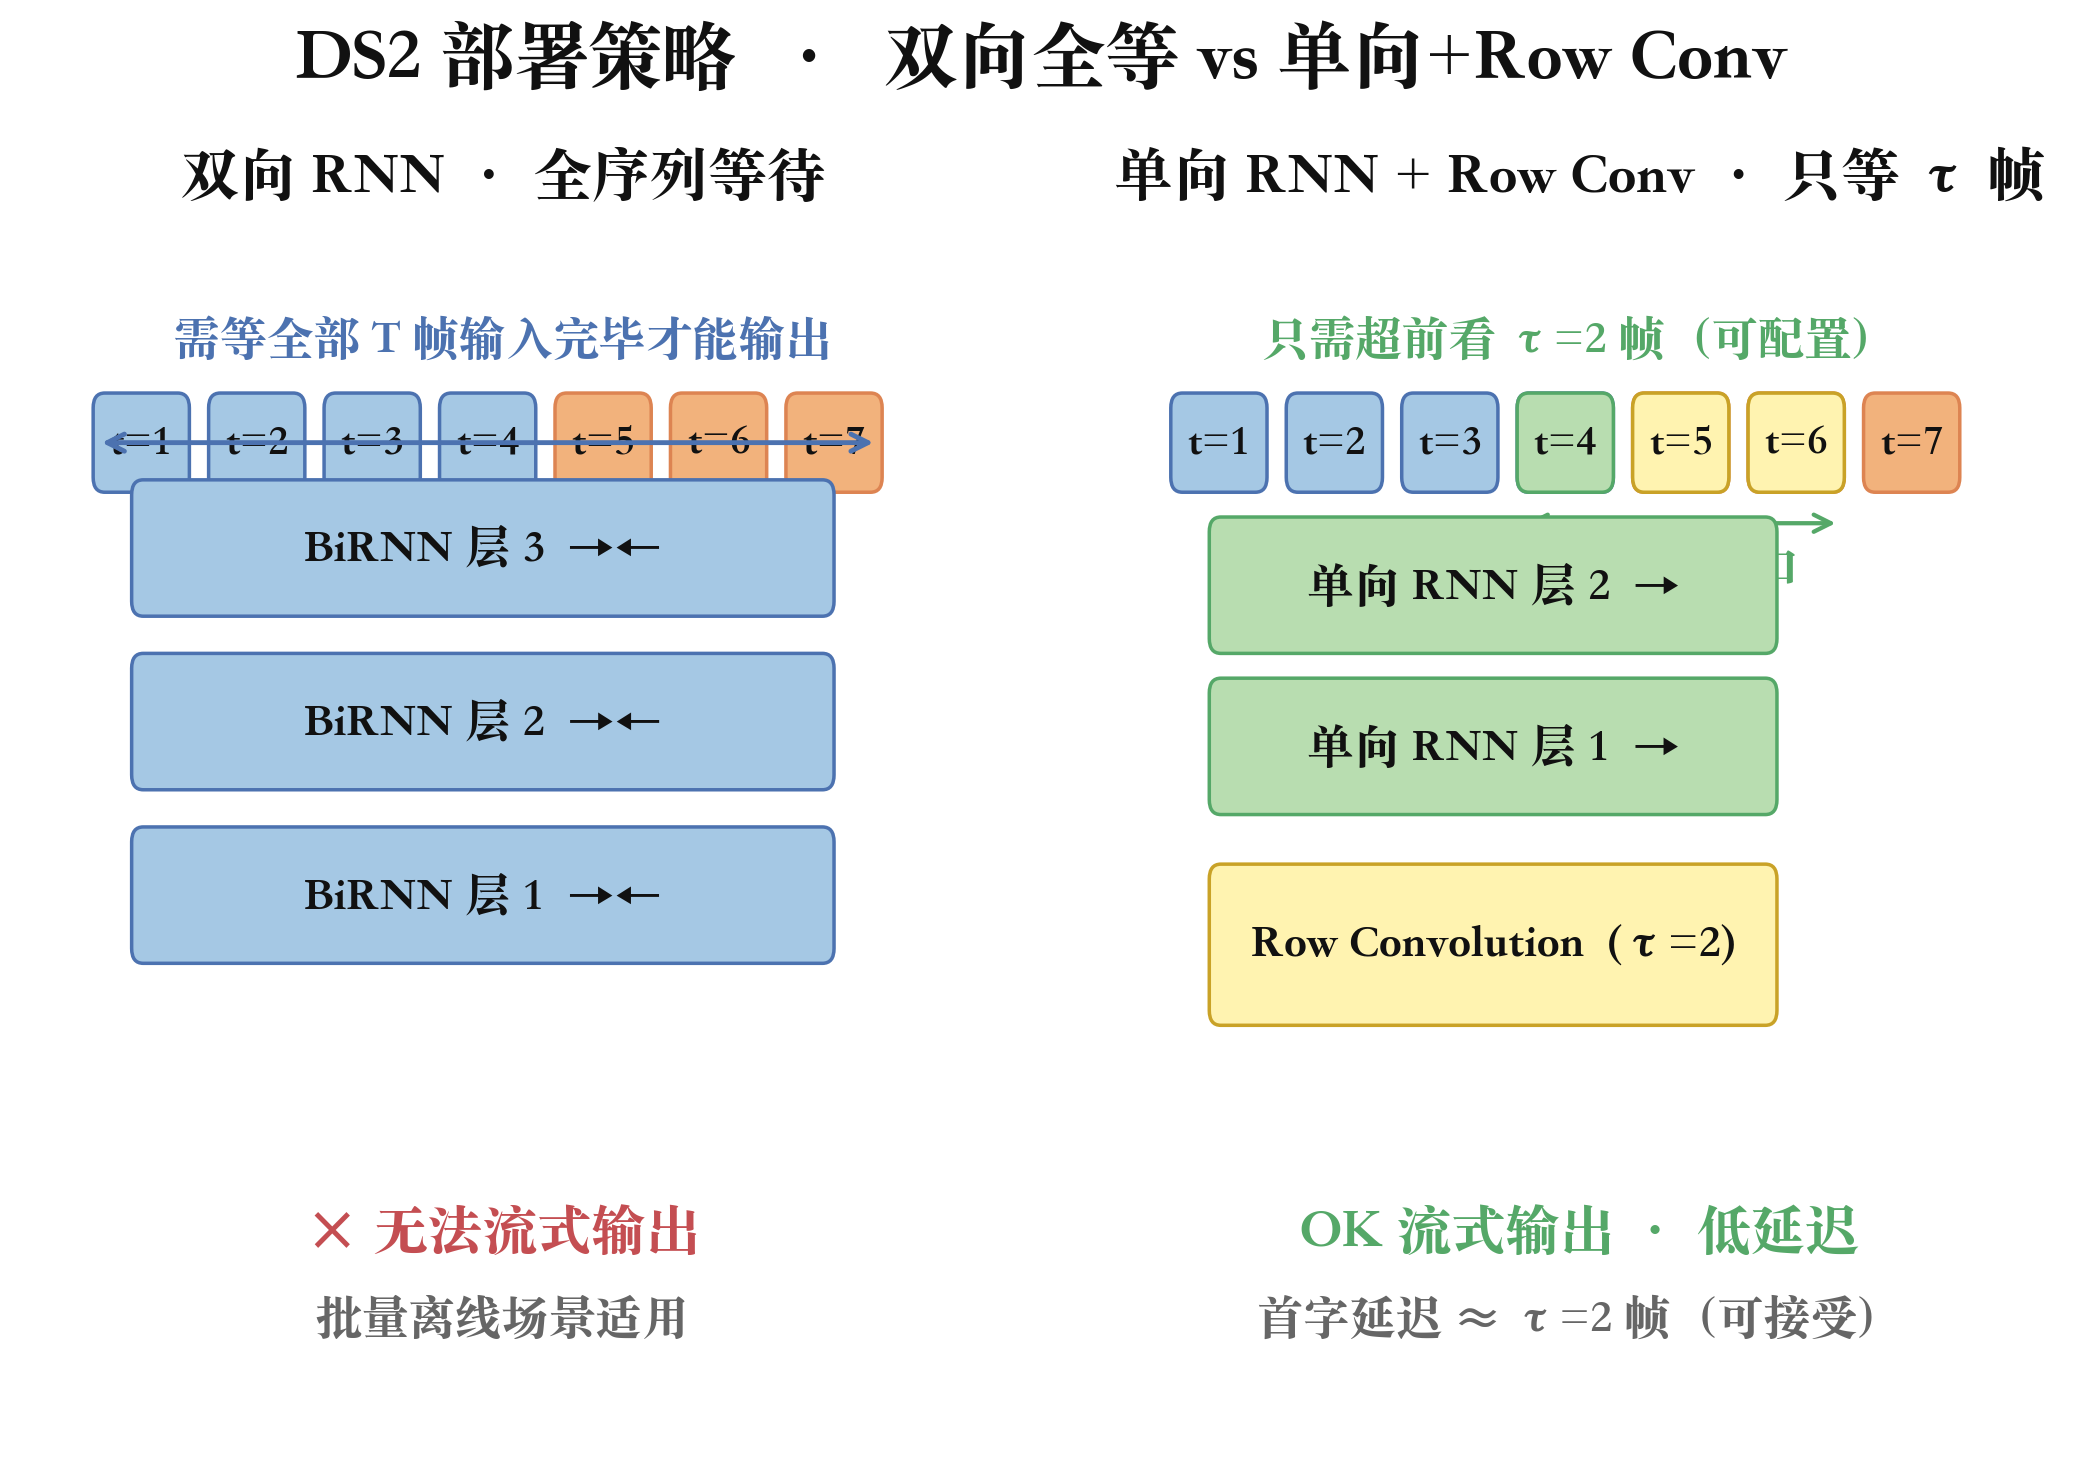
Row Convolution:在所有 recurrent 层的最上面加一层,公式是
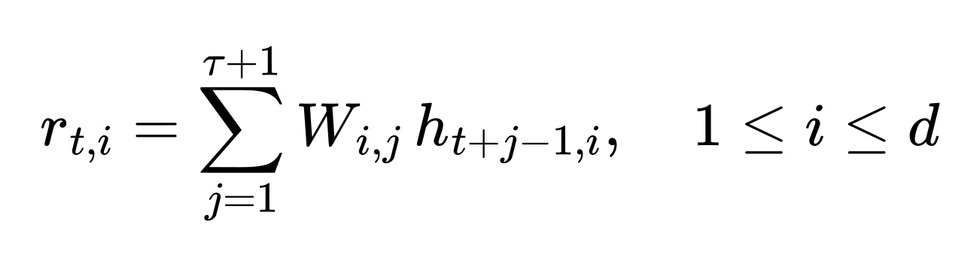
对第 t 帧的第 i 维 activation,用一个 d × (τ+1) 的权重矩阵只沿时间维卷 τ+1 帧未来。参数矩阵按维度 i 独立("row"-oriented),所以叫 row convolution。
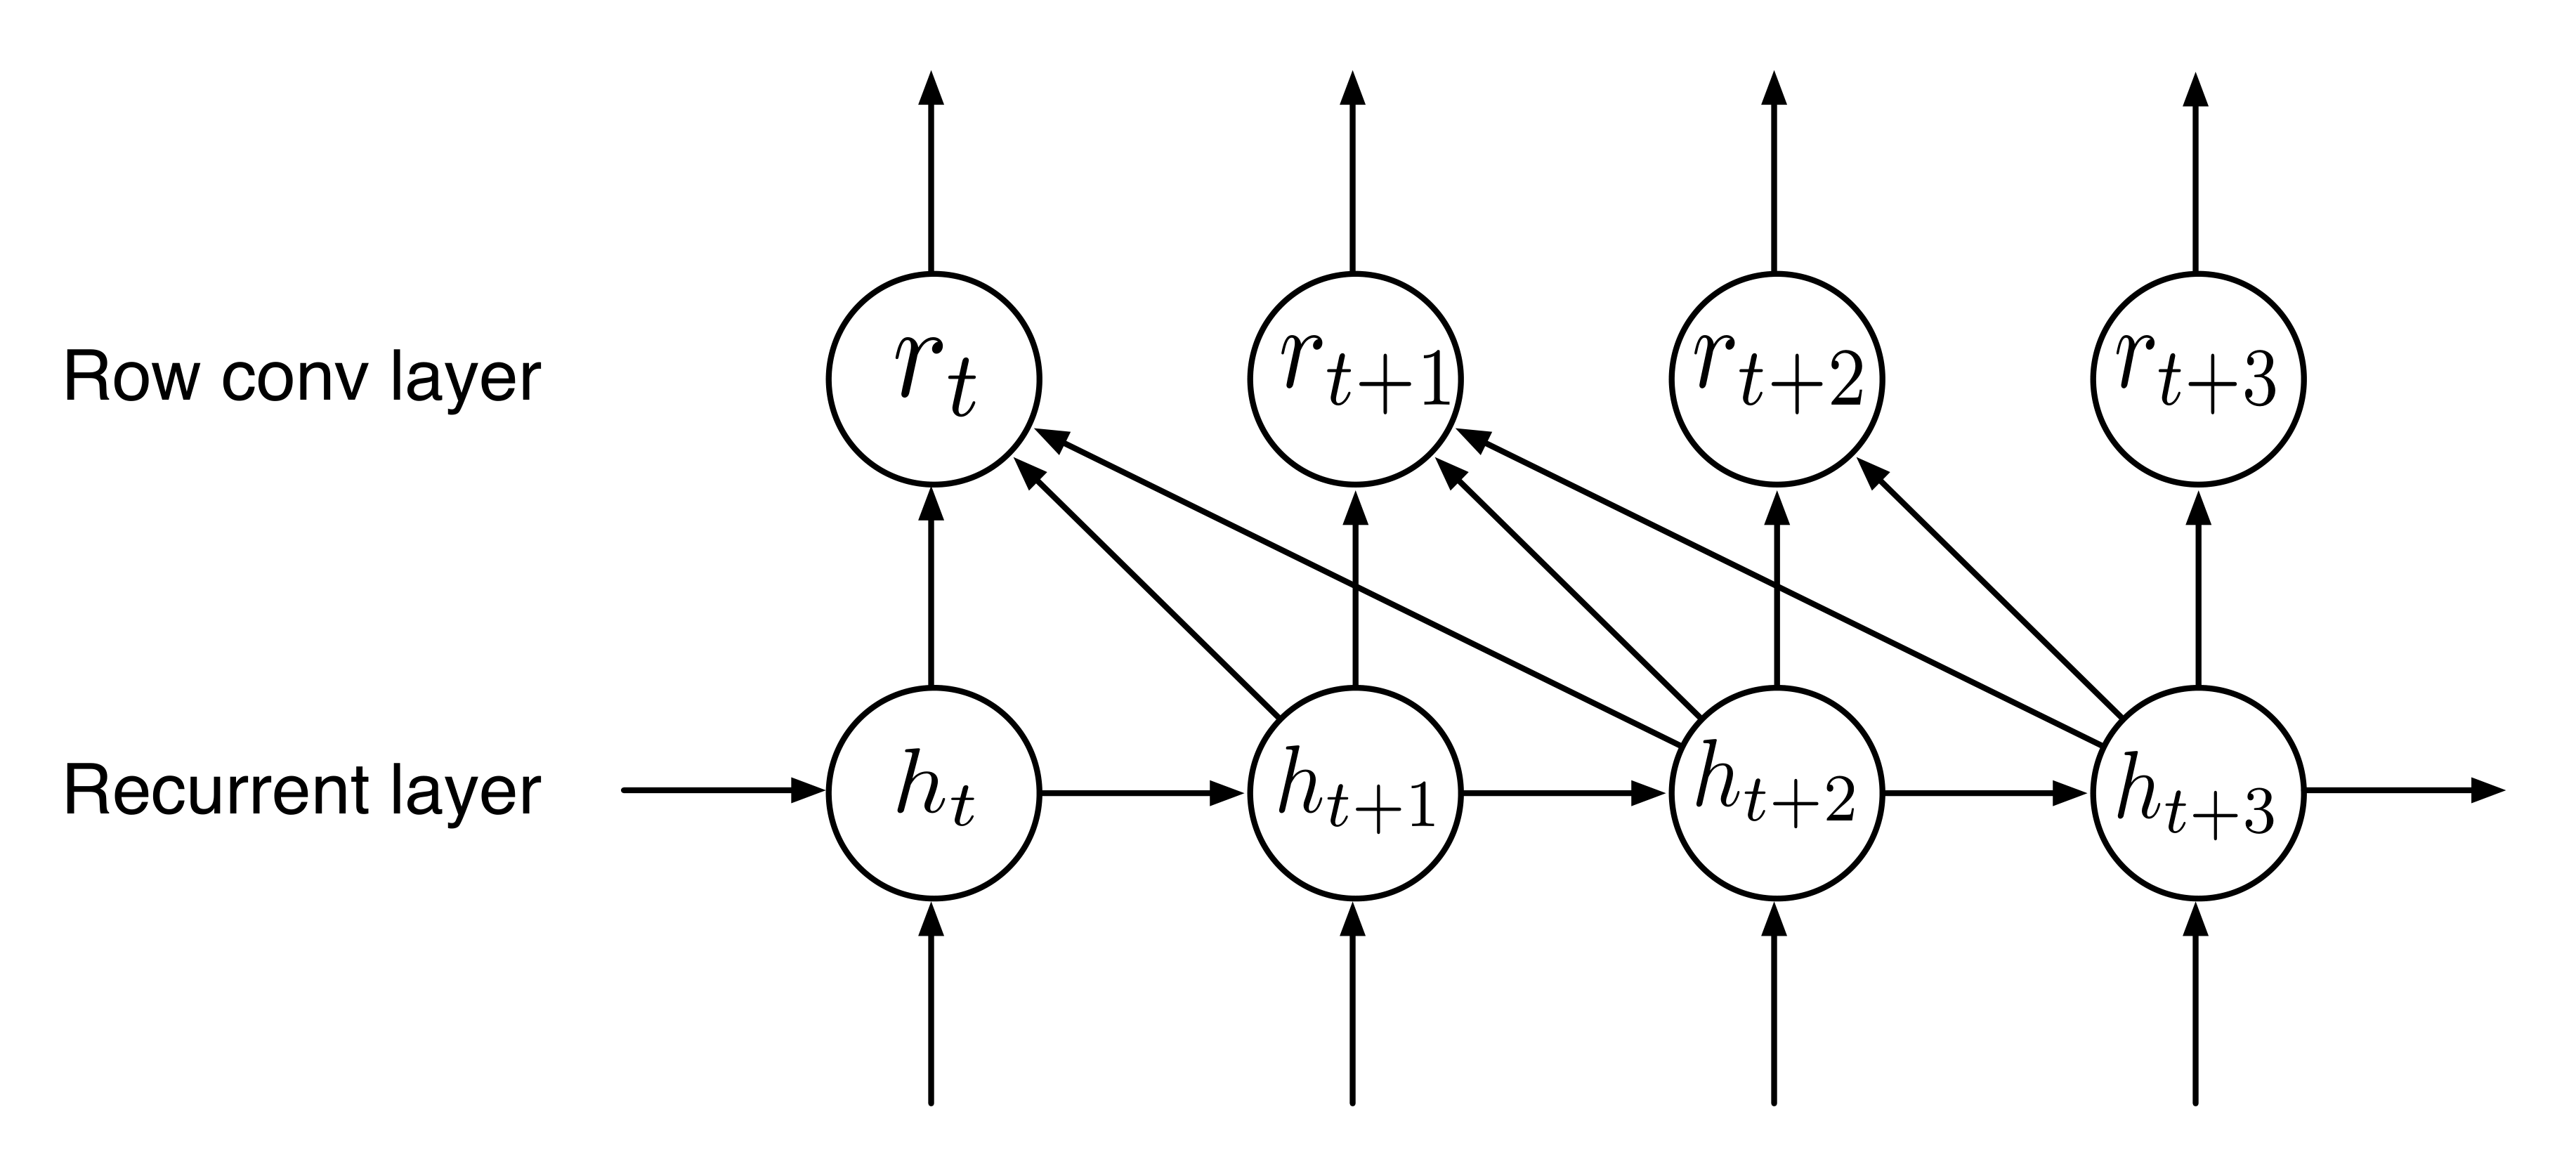
为什么放在所有 RNN 上面 ?两个原因:① 下面的 recurrent 层可以在逐帧 stream 状态下算,不用等未来;只有最上面这层才需要"等 τ 帧",流式首字延迟被压到 τ 帧的时长(DS2 用 τ=19,大约 380ms)。② 论文观察 recurrent 层已经学到了不错的时间特征,row conv 只是在最上面"选一小段未来聚合"给分类器。
结果 :把整套 recurrent 都换成单向 forward-only、加 row conv 之后,中文部署模型 CER = 6.10%,研究模型(双向)5.81%,相对退化只有 5%。注意 :论文在 §7 报告的 latency 是 utterance 结束后的计算延迟,不是从开始说话到首字出现的延迟------Row Conv 主要解决的是"能否流式首字"这个约束,"计算延迟"由 Batch Dispatch + 半精度 GEMM 一起压。
九、训练/部署系统:把几周训练压到几天
工程侧(论文 §4 训练 + §7 部署)------ 3-6 周 → 3-5 天,前面所有架构对比才成立:
- 同步 SGD + ring all-reduce:Fig 4 弱扩展近线性;自制 all-reduce 完整训练加速 2.5×
- GPU CTC:英语 28.9× / 中文 12.5×,总训练省 10-20%
- buddy 内存分配器 :预分配显存自切,避开
cudaMalloc大块开销 - Batch Dispatch:eager batching,10 并发 98th percentile 约 70ms
- 半精度 GEMM:fp16 无明显退化;N ≤ 4 达 90% peak 带宽
十、结果:接近或超越人类
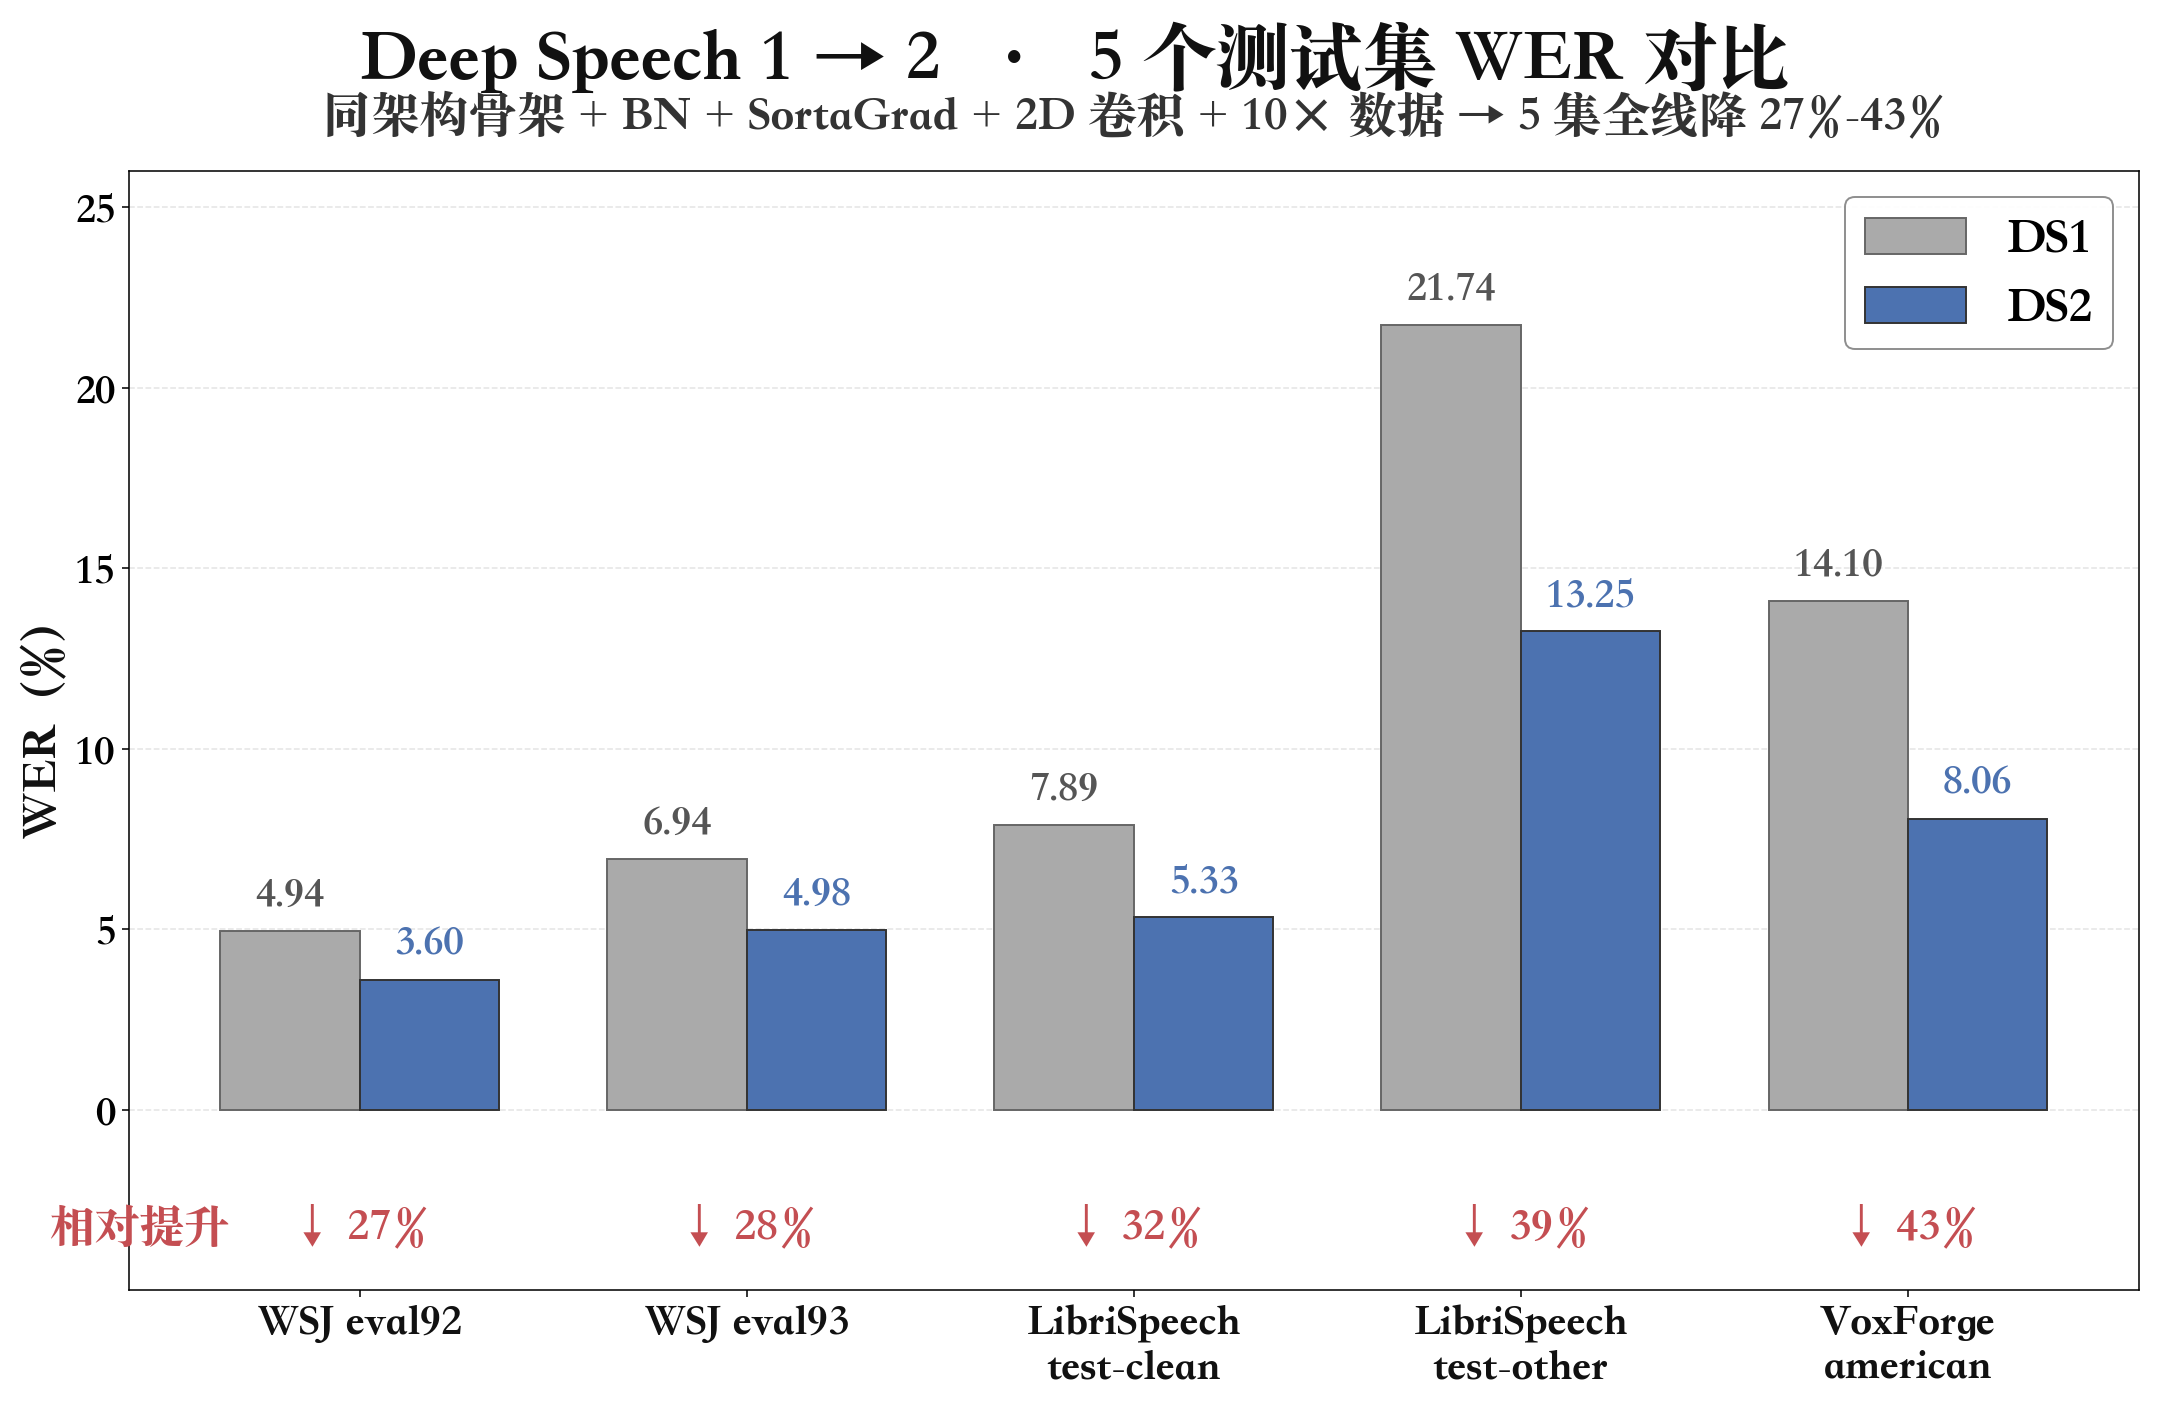
先看 DS1 → DS2 的迭代收益。同架构骨架(CTC 端到端)下,同时叠加 sequence-wise BN、SortaGrad、2D 卷积、10× 数据、100M 参数、更好的解码超参之后,在 5 个测试集上 WER 全线下降 27% 到 43%(论文没做逐项消融,是综合改进):
跟人类比呢? 论文测了朗读 / 口音 / 噪声三类英语场景,人类基线来自 Amazon Mechanical Turk 两人取优。结论一句话 :朗读打平(三档超越 human)· 口音整体仍落后(Indian 最接近 · 差 0.29 WER;American-Canadian DS2 7.55 vs human 4.85 差距明显)· 真实噪声仍差约 1.8×(CHiME real DS2 21.79 vs human 11.84):
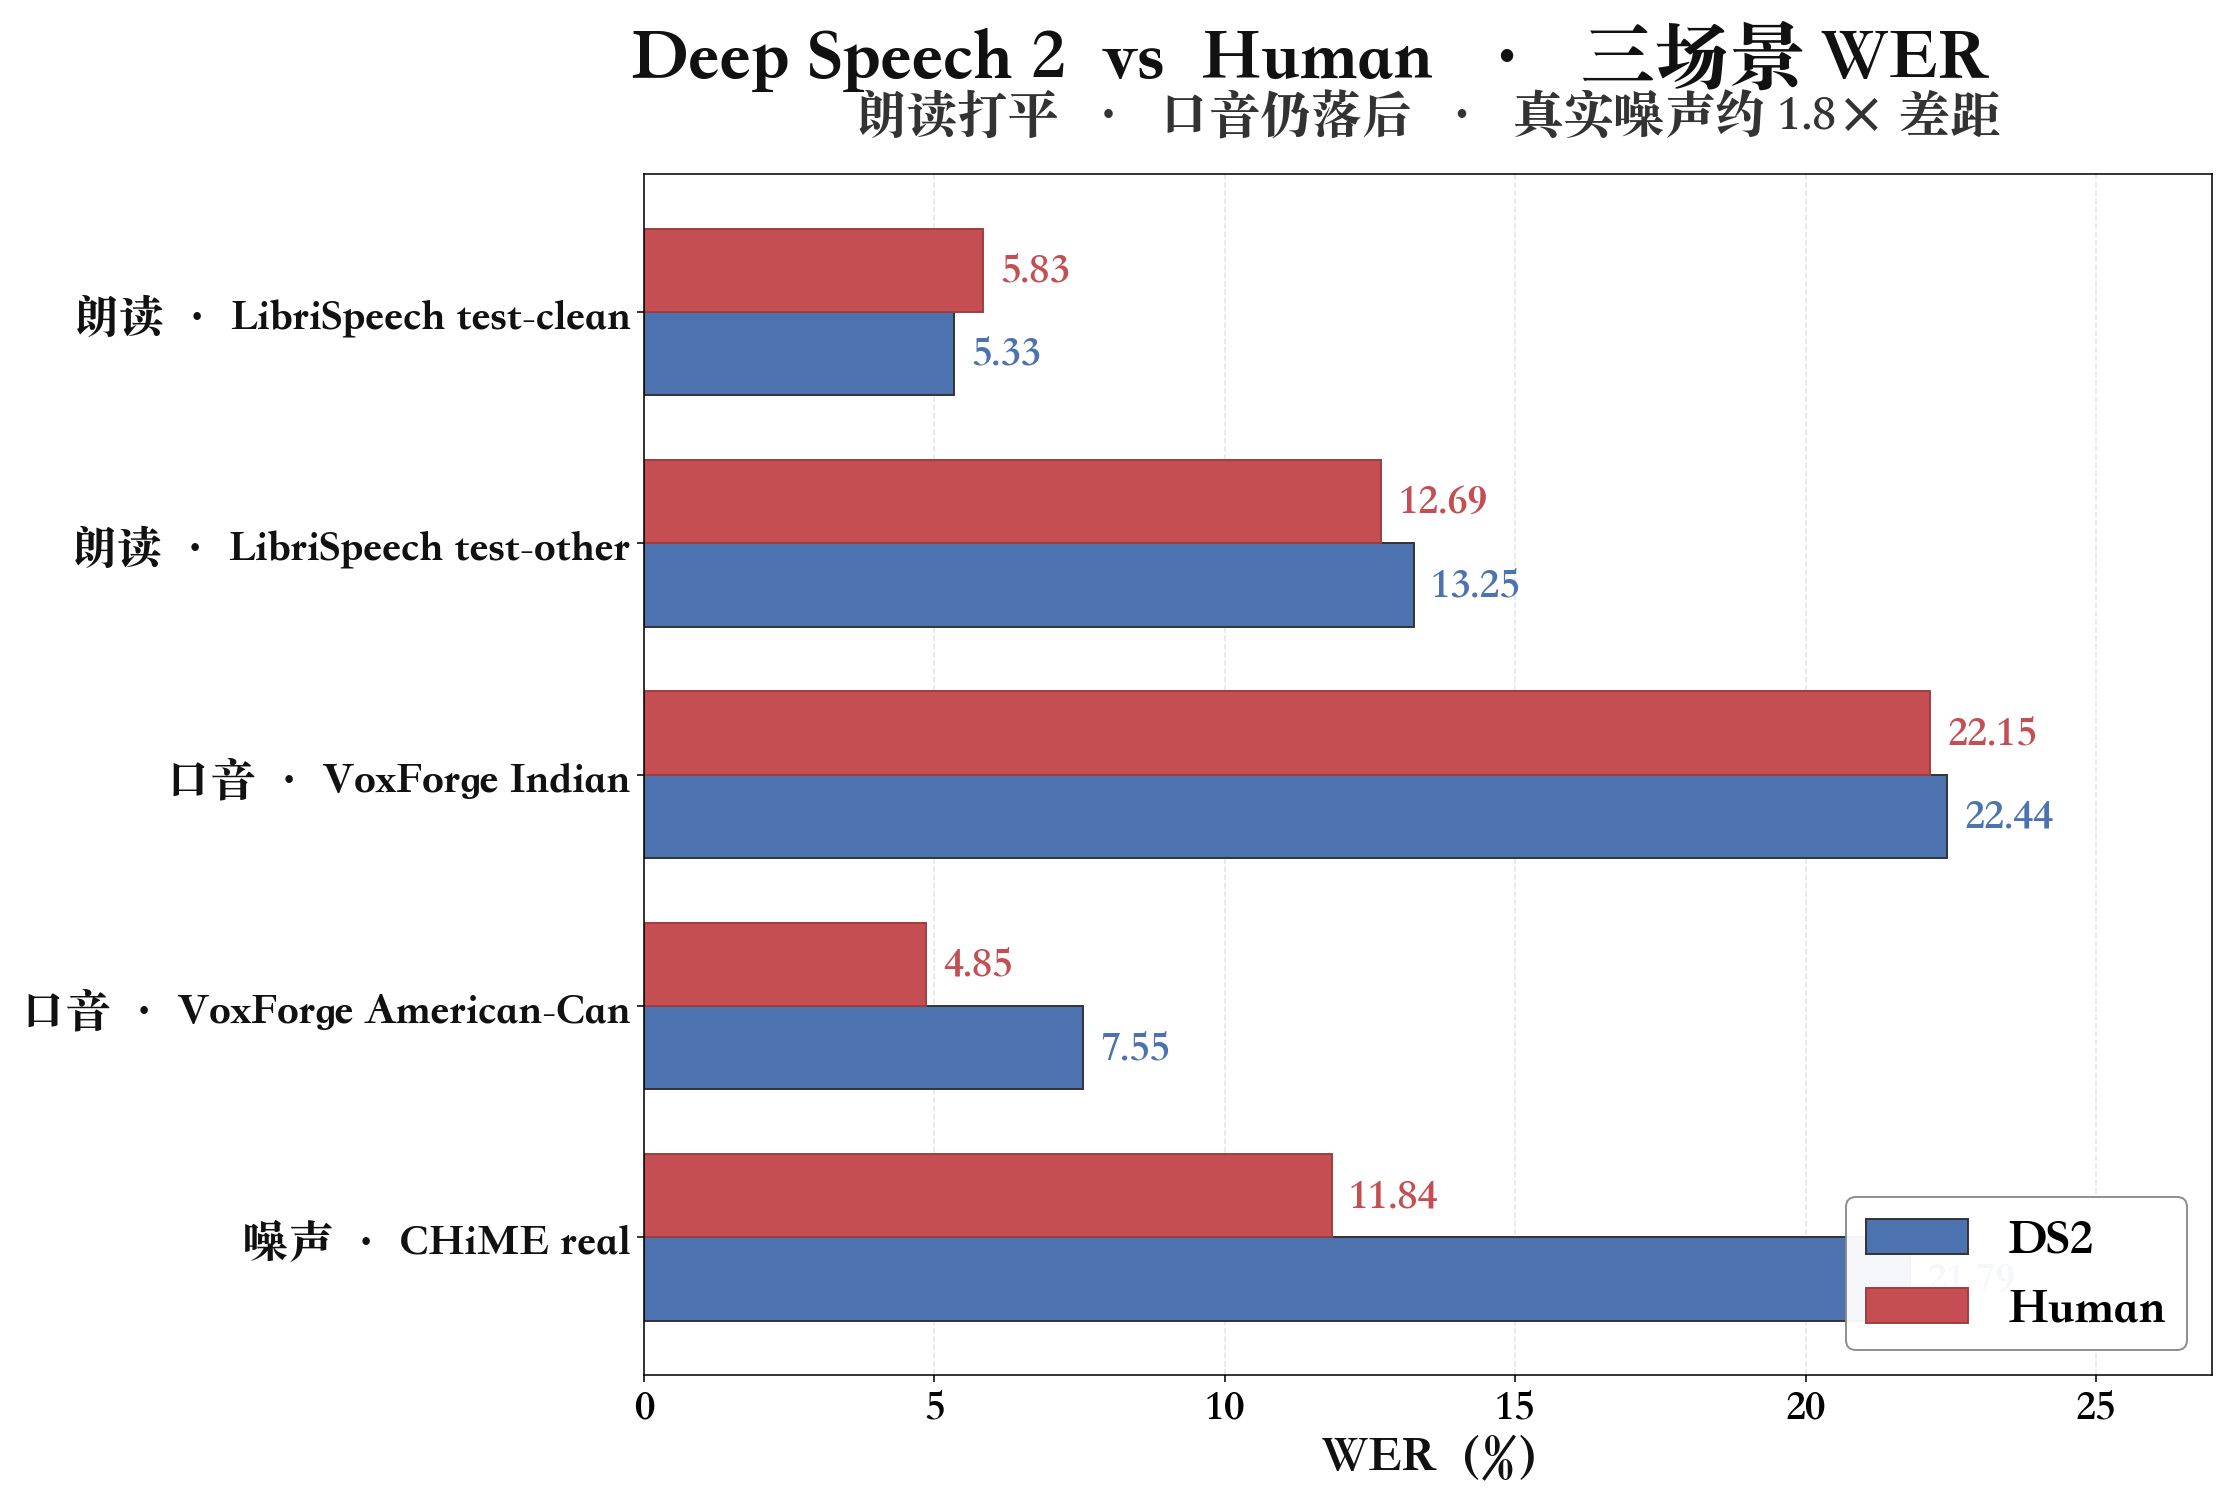
一个相关 caveat:CHiME 提供 6 通道,DS2 只报单通道结果;多通道系统在该任务上可进一步改善yoshioka2015,但 DS2 论文内部没做单/多通道消融。完整分场景数字看原论文 Table 13/14/15。
中文侧类似结论:短语查询级别的 utterance 已经好过普通说话人;论文报出 100 条随机选样上模型 3.7% vs 5 人合议 4.0%。
十一、局限与分析
- 一份工程报告 :CNN、BiRNN、CTC、BN、beam search LM 重打分都不是首次提出的,DS2 的价值在把它们拼齐并调到规模化能用------工业级 ASR 的价值恰恰在此。
- CTC 的天花板:DS2 靠外挂 n-gram LM 打分,不像 RNN-Transducer 那样在网络内部建输出依赖;CTC 的条件独立假设让某些相邻字符错误无法自纠------RNN-T(Graves 2012)在这个方向更彻底,但工业化在 DS2 之后几年才广泛发生。
- 数据缩放不闭合噪声 gap:图 6 里 noisy/regular 相对 gap 60%-75% 大体维持,不随数据量闭合;缩差距需要针对性噪声/远场数据、多通道、前端改造。
- Row Conv 是"够用就好"的 hack:不是理论上更优,只是承认 BiRNN 反向不能上线的现实、拿最小改动把损失压到 5%。工程里这种"看得清 tradeoff 的妥协"比架构创新更常见。
- sequence-wise BN 只在这组设置里有效 :DS2 深层 simple RNN 上 sequence-wise 优于 step-wise;别外推------后来 Transformer 声学模型主流用 LayerNorm/RMSNorm,机制和适用场景不同。