树:把一个大问题拆成"当前节点"+"左子树"+"右子树"
而 DFS,本质上就是:
沿着一条路先走到底,再回来处理其他分支。
先建立这个条件反射:
树结构 + 深度 / 路径 / 子树 / 递归定义 → DFS。
某个节点的答案依赖左右子树答案 → 很可能用递归。
昨日复习
给定:
bash
nums = [3,2,1,5,6,4]
k = 2
要求返回数组中第 k 大的元素。
先回答:
python
最直接的方案是什么?
更适合 Top K 的结构是什么?
为什么求"第 K 大"反而维护小顶堆?
时间、空间复杂度?
答案
最直接:
python
nums.sort(reverse=True)
return nums[k - 1]
时间:
python
O(n log n)更适合的是:
大小固定为 k 的小顶堆。
python
import heapq

def findKthLargest(nums, k):
    heap = []

    for x in nums:
        heapq.heappush(heap, x)

        if len(heap) > k:
            heapq.heappop(heap)

    return heap[0]
因为最终 Heap 中留下:
最大的 K 个元素。
而小顶堆的顶部:
是这 K 个中最小的。
所以正好是:
整体第 K 大。
复杂度:
python
时间 O(n log k)
空间 O(k)
如果这里你已经能自然说出:
"最大 K 个 → 小顶堆"
说明昨天那一块基本建立起条件反射了。
Part A|树和二叉树
1. 树是什么?
数组:
python
1 2 3 4 5是一种线性结构。
链表:
python
1 → 2 → 3 → 4也是线性的。
树则是:
python
        1
      /   \
     2     3
    / \
   4   5
一个节点可以连接多个下一层节点。
常见术语:
python
root      根节点
parent    父节点
child     子节点
leaf      叶子节点
subtree   子树
depth     深度
height    高度
2. 二叉树是什么?
python
二叉树:

每个节点最多有两个子节点。
通常叫:
python
left
right
Python / LeetCode:
python
class TreeNode:
    def __init__(self, val=0, left=None, right=None):
        self.val = val
        self.left = left
        self.right = right
例如:
5/
3 8
对应:
python
root.val
root.left
root.right
3. 树最重要的思维:递归定义
假设我们求一棵树节点数量。
你可以说:
ruby
整棵树节点数
=
左子树节点数
+
右子树节点数
+
当前节点
于是代码:
python
def countNodes(root):
    if root is None:
        return 0

    left = countNodes(root.left)
    right = countNodes(root.right)

    return left + right + 1
注意这里发生了什么。
函数:
python
countNodes(root)不会自己把整棵树算出来。
它只是说:
"左边你自己算。"
"右边你自己算。"
"算完告诉我,我再 +1。"
这就是树递归最核心的思想。
4. Base Case 为什么特别重要?
任何递归都必须有停止条件。
树最常见:
python
if root is None:
    return ...
比如节点数:
python
if root is None:
    return 0
最大深度:
python
if root is None:
    return 0
判断:
python
if root is None:
    return True
到底返回什么,要根据问题定义决定。
没有 Base Case:
无限递归。
5. 树的遍历
二叉树最经典三种 DFS 遍历:
python
前序 preorder
中序 inorder
后序 postorder
区别只是:
什么时候处理当前节点。
假设:
python
    1
   / \
  2   3
 / \
4   5
前序
python
当前 → 左 → 右结果:
python
1 2 4 5 3代码:
python
def preorder(root):
    if not root:
        return

    print(root.val)
    preorder(root.left)
    preorder(root.right)
中序
python
左 → 当前 → 右结果:
python
4 2 5 1 3代码:
python
def inorder(root):
    if not root:
        return

    inorder(root.left)
    print(root.val)
    inorder(root.right)
后序
python
左 → 右 → 当前结果:
python
4 5 2 3 1代码:
python
def postorder(root):
    if not root:
        return

    postorder(root.left)
    postorder(root.right)
    print(root.val)
6. 前中后序不要死背名字
更重要的是理解:
前序
先处理当前节点:
python
current
↓
children
适合:
python
复制树
记录路径
从根向下传播信息
后序
先拿到子树结果:
python
children
↓
current
适合:
python
高度
子树大小
判断平衡
树形 DP
因为当前节点的答案:
依赖孩子算完以后才能得到。
7. 时间和空间复杂度
通常遍历整棵树:
python
O(n)因为每个节点访问一次。
递归空间主要取决于:
树的高度 h。
所以:
python
O(h)
python
平衡树:

h ≈ log n
python
最坏链状树:

h = n
python
所以递归空间最坏:

O(n)
完整例题 1|LeetCode 104. 二叉树的最大深度
输入:
python
    3
   / \
  9  20
     / \
    15  7
最大深度:
python
3最直观的思考
根节点深度是多少?
取决于:
python
左子树深度
右子树深度
例如:
python
left_depth = 1
right_depth = 2
那么:
python
root depth = max(1, 2) + 1
           = 3
因此递推关系:
python
depth(root)
=
1 + max(
    depth(root.left),
    depth(root.right)
)
Base Case
空树:
python
None深度:
python
0完整代码
python
def maxDepth(root):
    if root is None:
        return 0

    left_depth = maxDepth(root.left)
    right_depth = maxDepth(root.right)

    return max(left_depth, right_depth) + 1
甚至可以写:
python
def maxDepth(root):
    if not root:
        return 0

    return 1 + max(
        maxDepth(root.left),
        maxDepth(root.right)
    )
这为什么属于后序思想?
因为:
当前节点深度必须等左右子树深度算完之后才能确定。
流程:
python
左
↓
右
↓
当前节点
虽然代码没打印东西,但逻辑属于:
Postorder。
这个判断很重要。
复杂度
每个节点访问一次:
python
O(n)递归栈:
python
O(h)Part B|DFS
1. DFS 是什么?
DFS:
Depth First Search,深度优先搜索。
想象迷宫:
python
先选一条路
↓
一直走
↓
走不动
↓
退回来
↓
走另一条
树里:
A/
B C
/
D E
一种 DFS:
python
A → B → D
        ↓
       回来
        ↓
        E
        ↓
       回来
        ↓
        C
核心:
python
先走深,再回退。2. DFS 和递归是什么关系?
python
DFS 是:

搜索策略。

递归是:

实现方式。
DFS 可以:
递归实现
也可以:
显式 Stack 实现
不要混成:
DFS = 递归。
更准确:
递归非常自然地利用系统调用栈实现 DFS。
3. DFS 什么时候出现?
识别信号:
python
树
路径
所有可能路径
连通区域
岛屿
从一个节点深入
子树
深度
递归结构
以及后面回溯题中的:
python
所有组合
所有排列
本质上也经常采用 DFS。
4. DFS 的树模板
最基础:
python
def dfs(node):
    if node is None:
        return

    # 当前节点

    dfs(node.left)
    dfs(node.right)
但真正做题时,更重要的是问:
dfs(node) 这个函数到底表示什么?
例如:
python
dfs(node)
=
以 node 为根的树的最大深度
或者:
python
dfs(node)
=
以 node 为根的子树中是否存在目标
或者:
python
dfs(node, current_sum)
=
从 root 走到 node 时的当前路径和
先定义函数含义,递归就会简单很多。
完整例题 2|LeetCode 112. 路径总和
给一棵树和:
python
targetSum判断是否存在:
python
从根节点到叶子节点

路径之和等于 target。
例如:
python
        5
       / \
      4   8
     /
    11
   /  \
  7    2
target:
python
22路径:
5 → 4 → 11 → 2
和:
python
22返回 True。
暴力应该怎么想?
其实树上的 DFS 本身就是:
把所有根到叶子的路径探索一遍。
对于每个节点:
python
当前剩余目标
=
target - node.val
继续交给孩子。
一个关键点:必须是叶子节点
假设:
python
5 → 4已经满足目标。
但是:
python
4还有孩子。
题目要求:
python
root-to-leaf。所以不能只判断:
python
targetSum == root.val还必须:
python
not root.left and not root.right递归定义
我们定义:
hasPathSum(root, targetSum)
表示:从当前 root 出发,是否存在一条到叶子的路径,其节点和为 targetSum。
Base Case:
python
if not root:
    return False
叶子节点:
python
if not root.left and not root.right:
    return targetSum == root.val
否则:
python
问题交给左右子树剩余:
python
remaining = targetSum - root.val完整代码
python
# Definition for a binary tree node.
# class TreeNode:
#     def __init__(self, val=0, left=None, right=None):
#         self.val = val
#         self.left = left
#         self.right = right
class Solution:
    def hasPathSum(self, root: TreeNode | None, targetSum: int) -> bool:

        if not root :
            return False
        if not root.left and not root.right : # 左右孩子都为空 → 当前节点是叶子
            return targetSum == root.val

        remaining = targetSum - root.val

        return (self.hasPathSum(root.left , remaining ) # 只要左子树或右子树有一条路径能走通,就返回 True
                or
                self.hasPathSum(root.right , remaining))

# 递减的好处:不需要额外参数传递累加值,直接改 target 就行,代码更简洁。

# 从根到叶子,每走一步减去当前节点的值,到叶子时看剩余目标值是否刚好等于叶子节点的值。
复杂度
python
最坏访问所有节点:

O(n)
python
递归空间:

O(h)
今天必须理解的一件事:参数代表"状态"
在路径总和里:
python
targetSum随着我们向下走:
python
22
↓ 减5
17
↓ 减4
13
↓ 减11
2
↓ 减2
0
这个:
python
剩余 target就是 DFS 沿路径携带的状态。
后面回溯会疯狂用这种思想:
python
当前位置
当前路径
当前总和
已经使用的元素
练习
226 翻转二叉树
python
# Definition for a binary tree node.
# class TreeNode:
#     def __init__(self, val=0, left=None, right=None):
#         self.val = val
#         self.left = left
#         self.right = right
# 遍历每个节点,把它的左右孩子互换,一路递归下去,整棵树就翻转了。
class Solution:
    def invertTree(self, root: Optional[TreeNode]) -> Optional[TreeNode]:
        if not root :
            return None
        root.left , root.right = root.right , root.left
        # Python 的元组解包,一行完成左右孩子交换

        self.invertTree(root.left)
        self.invertTree(root.right)

return root # 题目要求返回翻转后的整棵树的根 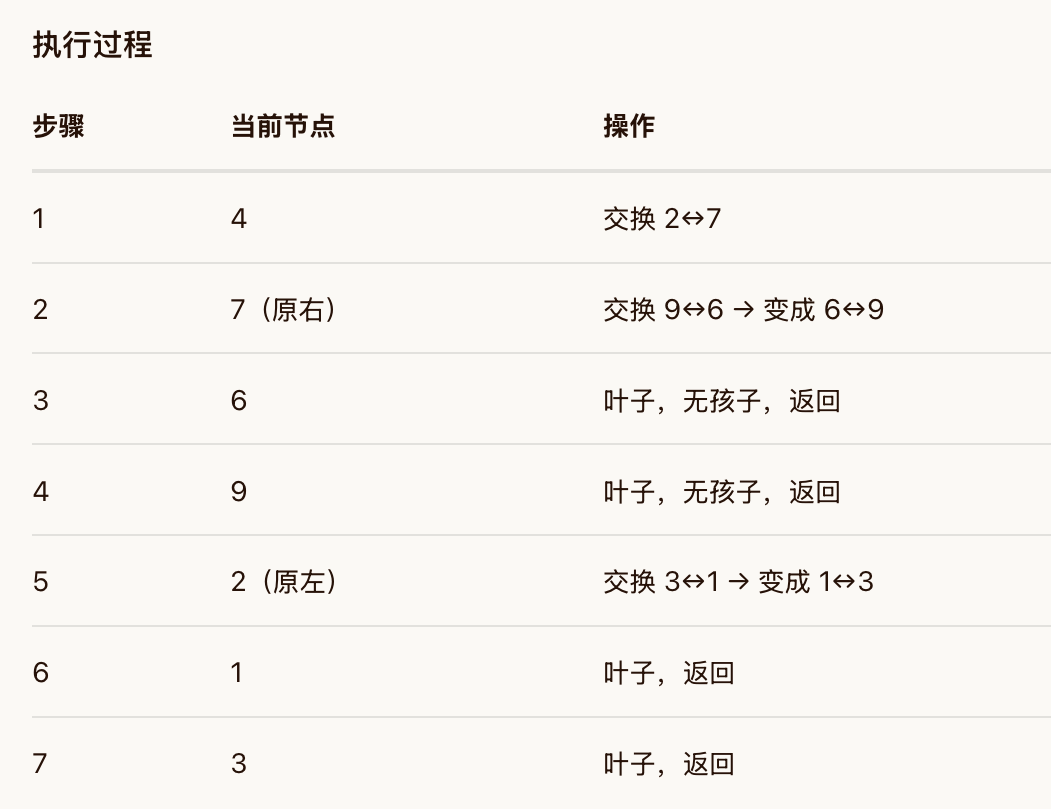
也可以先递归:
python
def invertTree(root):
    if not root:
        return None

    left = invertTree(root.left)
    right = invertTree(root.right)

    root.left = right
    root.right = left

    return root
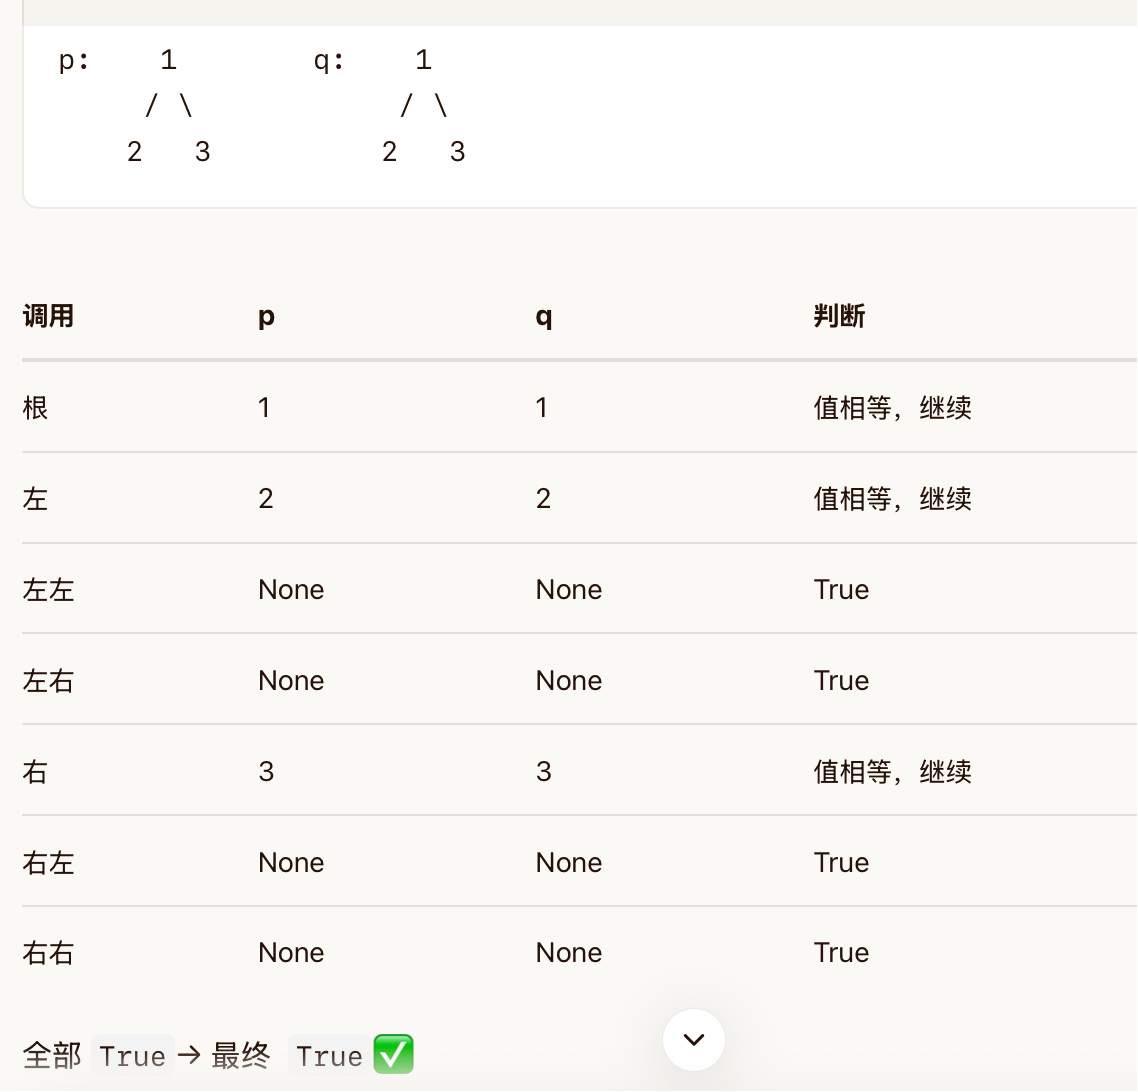
100 相同的树
python
# Definition for a binary tree node.
# class TreeNode:
#     def __init__(self, val=0, left=None, right=None):
#         self.val = val
#         self.left = left
#         self.right = right
# 同时遍历两棵树,结构一样、每个对应节点的值也一样,就是相同的树。
class Solution:
    def isSameTree(self, p: TreeNode | None, q: TreeNode | None) -> bool:
        if not p and not q : # 两个都为空 → 相同
            return True

        if not p or not q: # 一个为空、一个不为空 → 不同
            return False
        if p.val != q.val : # 值不相等 → 不同
            return False

        return (self.isSameTree(p.left , q.left)
               and
               self.isSameTree(p.right , q.right )

               )
453 二叉树的直径
关于不经过根节点的情况下取得最大值的例子:
python
          1
         /
        2
       / \
      3   4
     /     \
    5       6
   /         \
  7           8
整棵树的根是 1。
但最长路径其实是:
python
7 → 5 → 3 → 2 → 4 → 6 → 8它压根没经过 1。
所以直径是:
python
6 条边如果你强制经过根节点 1,反而找不到真正的最大值。
python
# Definition for a binary tree node.
# class TreeNode:
#     def __init__(self, val=0, left=None, right=None):
#         self.val = val
#         self.left = left
#         self.right = right
class Solution:
    def diameterOfBinaryTree(self, root: Optional[TreeNode]) -> int:
        ans = 0  # ans记录遍历过程中遇到的最大直径

        def depth(node):
            nonlocal ans  # nonlocal ans允许内部函数修改外层的 ans

            if not node :
                return 0

            left = depth(node.left)
            right = depth (node.right)

            ans = max(ans , left + right ) # left + right= 经过当前节点的最长路径的边数
            # 某个节点的左子树最大深度 + 右子树最大深度
            # 如果我把当前 node 当成路径最高点,那么经过我的最长路径是多少?

            return max(left , right) +1 # 告诉上层:"我从当前节点往下最深能走 max(left, right) + 1步"

            # depth() 的返回值解决的是"父节点能从我这里得到多长的一条向下路径";而 left + right 解决的是"以当前节点为最高点的最长路径"。遍历所有节点并取 left + right 的最大值,就得到了整棵树的直径。

        depth(root)
        return ans
98 验证二叉搜索树
python
# Definition for a binary tree node.
# class TreeNode:
#     def __init__(self, val=0, left=None, right=None):
#         self.val = val
#         self.left = left
#         self.right = right
# BST 的定义:每个节点的值必须在 (low, high)范围内,左子树上限变成当前节点值,右子树下限变成当前节点值。
class Solution:
    def isValidBST(self, root: TreeNode | None) -> bool:

        def dfs(node , low,high ):
            if not node:
                return True
            if not (low < node.val <high ): # 检查当前节点值是否在合法区间内
                return False

            return (
                dfs(node.left , low, node.val ) # 更新边界值,然后比较
                and
                dfs(node.right , node.val , high ))

        return dfs(root , float('-inf') , float('inf')) # 根节点没有上下界限制
Day 5 Cheat Sheet
二叉树识别信号
python
节点
左右子树
高度 / 深度
路径
子树
祖先
叶子
树结构
第一反应:
能不能把问题写成"当前节点 + 左子树 + 右子树"?
树递归三问
每道树题先强迫自己回答:
① dfs(node) 表示什么?
例如:
python
以 node 为根的最大深度② Base Case 是什么?
通常:
python
if not node:
    return ...
③ 当前节点如何利用子树答案?
例如:
python
left = dfs(node.left)
right = dfs(node.right)

return ...
这三问比背模板重要得多。
前中后序
前序:
当前 → 左 → 右
中序:
左 → 当前 → 右
后序:
左 → 右 → 当前
如果:
当前答案依赖子树结果
特别考虑:
后序
例如:
python
深度
高度
直径
平衡树
子树统计
DFS
识别:
python
深入一条路径
递归
路径
连通块
岛屿
子树
所有节点
基础模板:
python
def dfs(node):
    if not node:
        return

    dfs(node.left)
    dfs(node.right)
真正重要的是:
给 DFS 一个清楚的函数定义。
网格 DFS
典型:
python
def dfs(r, c):
    if 越界 or 已访问:
        return

    标记访问

    dfs(r + 1, c)
    dfs(r - 1, c)
    dfs(r, c + 1)
    dfs(r, c - 1)
看到:
python
岛屿
连通区域
区域数量
染色
立刻想到:
python
DFS / BFS今天最容易犯的错误
- 递归函数写起来了,却根本没定义清楚 dfs(node) 的含义。
- 忘记 None 的 Base Case。
- 把深度和直径混在一起,误以为 DFS 返回值必须等于最终答案。
- 判断 BST 时只比较节点和直接孩子,忘记祖先留下的上下界限制。
- 路径题只判断 target == node.val,却忘了题目要求必须到叶子。
- 认为所有树题都必须前中后序三选一;很多题更重要的是"信息向下传还是向上返回"。
- 看到 DFS 就只知道递归,却不知道显式 Stack 也能实现 DFS。
- 网格 DFS 忘记先标记 visited,导致同一格子来回递归,甚至无限循环。
树题先定义 dfs(node) 到底代表什么。
当前答案依赖左右子树答案 → 后序 DFS 很常见。
沿路径需要携带的信息 → 放进 DFS 参数;子树算出来的信息 → 用 DFS 返回值往上送。
这最后一句尤其重要。今天的路径总和是"状态向下传",最大深度和直径是"信息向上返"。一旦这两种信息流向看明白,很多看起来乱七八糟的树题就会突然变得很规整。
训练 DFS 网格题
ACM 题|统计连通区域数量
输入一个 n × m 的 0/1 网格。
python
1 表示陆地,四方向相邻的 1 属于同一个区域。例如:
bash
4 5
1 1 0 0 0
1 1 0 0 1
0 0 1 0 1
0 0 0 1 1
要求输出:
python
3思路
遍历所有格子。
遇到:
1
说明发现一个新区域:
python
ans += 1然后 DFS:
把与它相连的所有 1 全部标记为访问过。
参考:
python
n ,m = map(int , input().split()) # n行 m列
grid = [
list(map(int , input().split())) # grid就是那个 0/1 矩阵
for _ in range (n) # 重复执行 n 次
]
def dfs(r ,c ): # 传进来的 r, c是当前格子的坐标。
if (r <0 or r >= n # 走到网格上面去了/下面
or c < 0 or c >= m # 走到网格左边去了/右边
or grid[r][c] ==0 # 这是海,不是陆地
) :
return
grid[r][c] = 0 # 把陆地变成海。 这一步是关键------标记"我来过了",防止后面重复数。
dfs(r+1,c)
dfs(r-1,c)
dfs(r,c+1)
dfs(r,c-1)
# 从当前格子出发,上下左右四个方向继续递归。每个方向都会重复上面的判断------是海就停,是陆地就踩平再继续往外扩。
# 直到整座岛所有格子全变成 0,递归才一层层返回。
ans = 0
for r in range(n):
for c in range(m):
if grid[r][c]==1:
ans += 1
dfs(r,c)
print(ans)
# 遇到陆地就计数 +1,然后顺手把这座岛"炸平"------
# 把所有连着的陆地全变成海(0),这样后面就不会重复数了。这个思想非常重要:
python
发现一个未访问节点
↓
答案 +1
↓
DFS 把整个连通块吃掉
后面 BFS 也可以做一模一样的事情。
面试手撕训练: LeetCode 543 二叉树的直径
你应该练习这样口述:
① 暴力思路
可以对每个节点分别计算左右子树深度,把两者相加作为经过这个节点的路径长度,再取最大值。
但是如果:
每个节点都重新计算深度
可能产生大量重复计算,最坏接近:
python
O(n²)② 瓶颈
很多子树深度:
被重复计算。
③ DFS 优化
我可以做一次后序 DFS。对于每个节点,递归先返回左右子树的最大深度,因此当前节点可以用 left_depth + right_depth 更新全局直径;然后向父节点返回 max(left_depth, right_depth) + 1。
这里有两个不同概念:
python
DFS返回值
=
向下的最大深度
但:
python
全局答案
=
任意节点 left_depth + right_depth 的最大值
这点非常关键。
④ 为什么不能直接 return 左深度 + 右深度?
因为父节点需要知道的是:
从当前节点向下,只能选择一条路径。
不能同时:
python
左边
+
右边
一起带给父节点。
所以返回:
python
max(left, right) + 1而直径只用来:
python
ans = max(ans, left + right)更新答案。
⑤ 复杂度
每个节点只处理一次:
python
O(n)递归栈:
python
O(h)