文章目录
-
- [1. 先说结论](#1. 先说结论)
- [2. 一个绝对时间,一堆相对时间](#2. 一个绝对时间,一堆相对时间)
- [3. 发现一:日期以汉字为主,朴素正则会漏 92.6%](#3. 发现一:日期以汉字为主,朴素正则会漏 92.6%)
- [4. 发现二:「今日」在这批数据里有 6 种所指](#4. 发现二:「今日」在这批数据里有 6 种所指)
- [5. 发现三:锚点不统一,2.3% 的样本会翻车](#5. 发现三:锚点不统一,2.3% 的样本会翻车)
- [6. 发现四:汉字时刻的边界比日期更绕](#6. 发现四:汉字时刻的边界比日期更绕)
- [7. Prompt 契约:把锚点变成可校验的后置条件](#7. Prompt 契约:把锚点变成可校验的后置条件)
- [8. 踩坑清单与结论](#8. 踩坑清单与结论)
- [9. 参考链接](#9. 参考链接)
1. 先说结论
香港政府新闻公报每天发布,正文里到处是「今日」「明日」「翌日」这种相对时间。我把最新 100 条抓下来逐条扫了一遍:
| 问题 | 实测结果 |
|---|---|
| 「今日」能被正确解释吗? | 不能一次解释完 。100 条里有 73 条 含「今日」,它们落在 6 个不同的日历日上------同一个词,6 种所指 |
| 日期都是阿拉伯数字吧? | 反了 。汉字日期出现 189 次 ,9月16日 这种写法只有 15 次 。用 \d{1,2}月\d{1,2}日 干活,会静默漏掉 92.6% 的日期 |
| 把相对词锚定到发布时刻就行了吗? | 97.7% 行,剩下 2.3% 会错 。而错的那 2 条是「翌日」------它指的是文本里前一个日期的次日 ,锚到发布日会差 5 天 |
这篇不讲怎么让模型「更聪明」,讲的是喂给模型之前先把时间锚定住。而锚点这件事,比看上去多一个坑。
2. 一个绝对时间,一堆相对时间
政府新闻公报的 RSS 里,每条都有一个 pubDate,这是绝对时间戳;而正文里全是汉字写的相对时间。两者在同一个 item 里,却是两种东西:
pubDate:  Mon, 14 Sep 2026 19:40:00 +0800      ← 绝对,机器可读
正文: 他於九月九日出現...,翌日(九月十日)到衞生署...就醫 ← 汉字 + 相对所以真正要做的事只有一件:把正文里的相对时间,用 pubDate 折算成绝对时间。先把汉字数字和汉字时间解析出来:
python
import re

ZH = {"一": 1, "二": 2, "兩": 2, "三": 3, "四": 4, "五": 5,
      "六": 6, "七": 7, "八": 8, "九": 9, "十": 10}

def zh_num(s):
    """中文数字 → 整数。覆盖 一...十、十一...十九、二十...三十一。"""
    s = s.strip()
    if not s or not all(c in ZH for c in s):
        return None
    if s == "十":
        return 10
    if "十" in s:
        a, _, b = s.partition("十")
        return (ZH.get(a, 1) if a else 1) * 10 + (ZH.get(b, 0) if b else 0)
    return ZH[s]

def parse_zh_md(s):
    """「九月十六日」→ (9, 16)。阿拉伯写法不走这个函数。"""
    m = re.fullmatch(r"([一二三四五六七八九十]{1,3})月([一二三四五六七八九十]{1,3})日", s)
    if not m:
        return None
    mo, dy = zh_num(m.group(1)), zh_num(m.group(2))
return (mo, dy) if mo and dy and 1 <= mo <= 12 and 1 <= dy <= 31 else None这段解析可以直接拿走用,建议收藏备用------港澳台和内地公文的中文数字写法基本通用,改一下正则字符集就能复用。
3. 发现一:日期以汉字为主,朴素正则会漏 92.6%
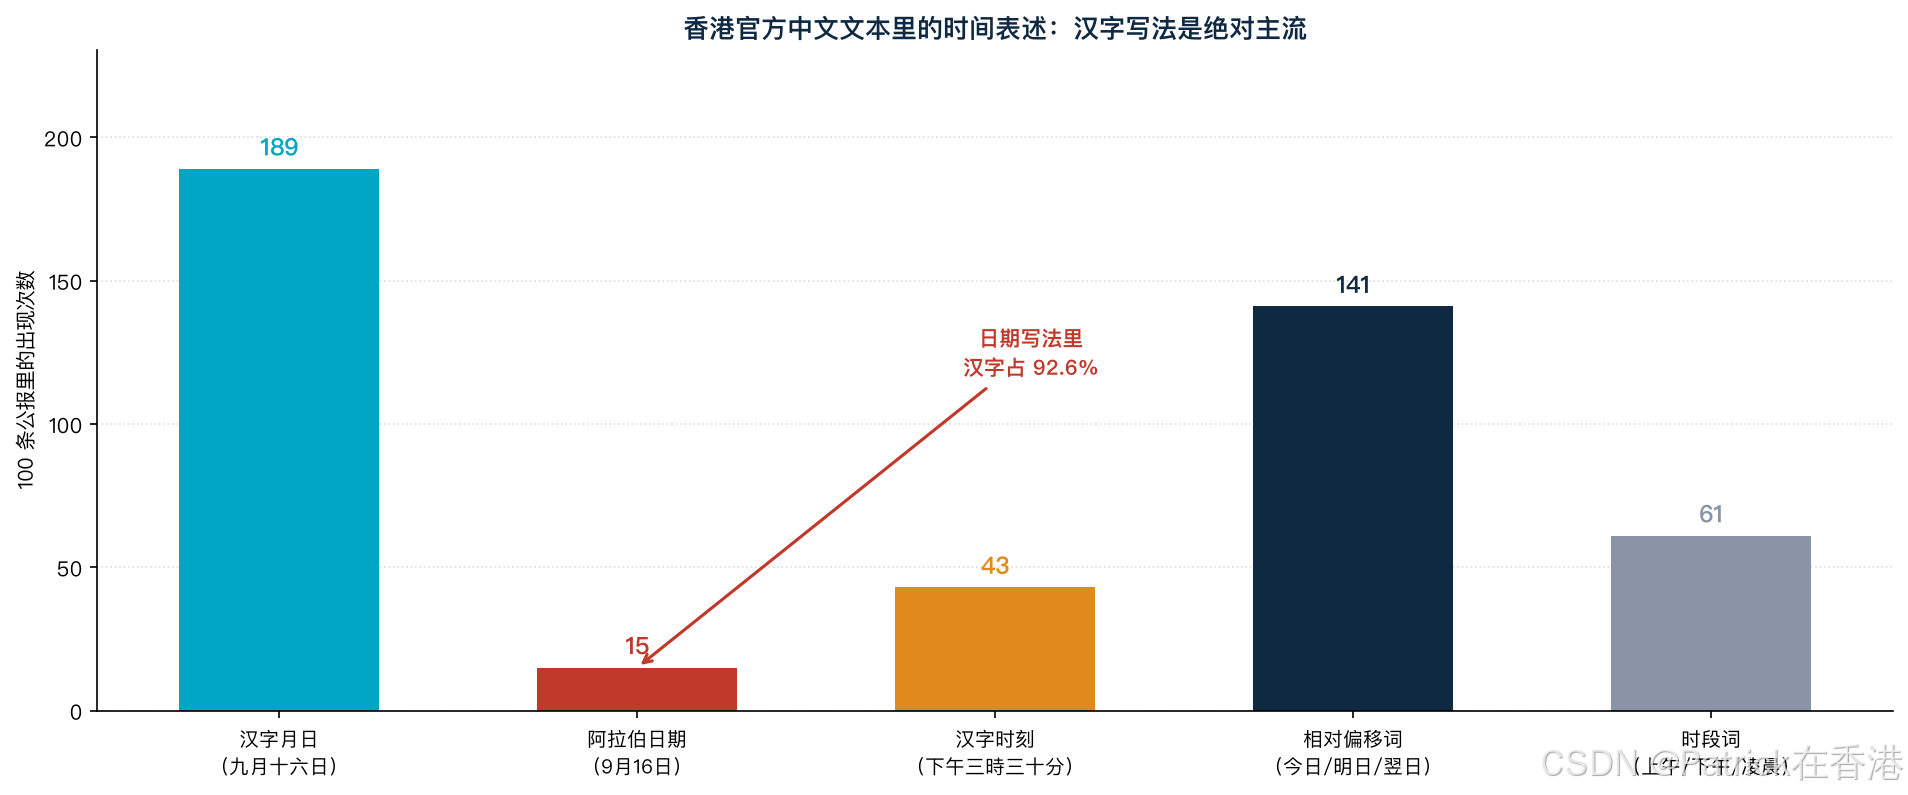
100 条公报全文扫下来,五类时间表述的出现次数是这样的:
| 形态 | 例子 | 次数 |
|---|---|---|
| 汉字月日 | 九月十六日 | 189 |
| 阿拉伯日期 | 9月16日 | 15 |
| 汉字时刻 | 下午三時三十分 | 43 |
| 相对偏移词 | 今日 / 明日 / 翌日 | 141 |
| 时段词 | 上午 / 下午 / 凌晨 | 61 |
日期写法里汉字占 92.6%。 而最顺手的那条正则------\d{1,2}月\d{1,2}日------只能命中 15 个,剩下 189 个日期它一个都看不见。
麻烦的地方在于它是静默漏掉:脚本不报错、不告警,只是结果的「日期」字段大部分是空的。你如果拿它统计「这些公报涉及多少个日期」,会得到一个只有真实值 7% 的数字,而且看起来完全正常。
189 个汉字日期里有 45 个不同值 ,不是同一句套话在重复------最高频的 九月十四日 出现 25 次,最低的一批只出现 1 次。所以这是真实的日期分布,不是模板。
4. 发现二:「今日」在这批数据里有 6 种所指
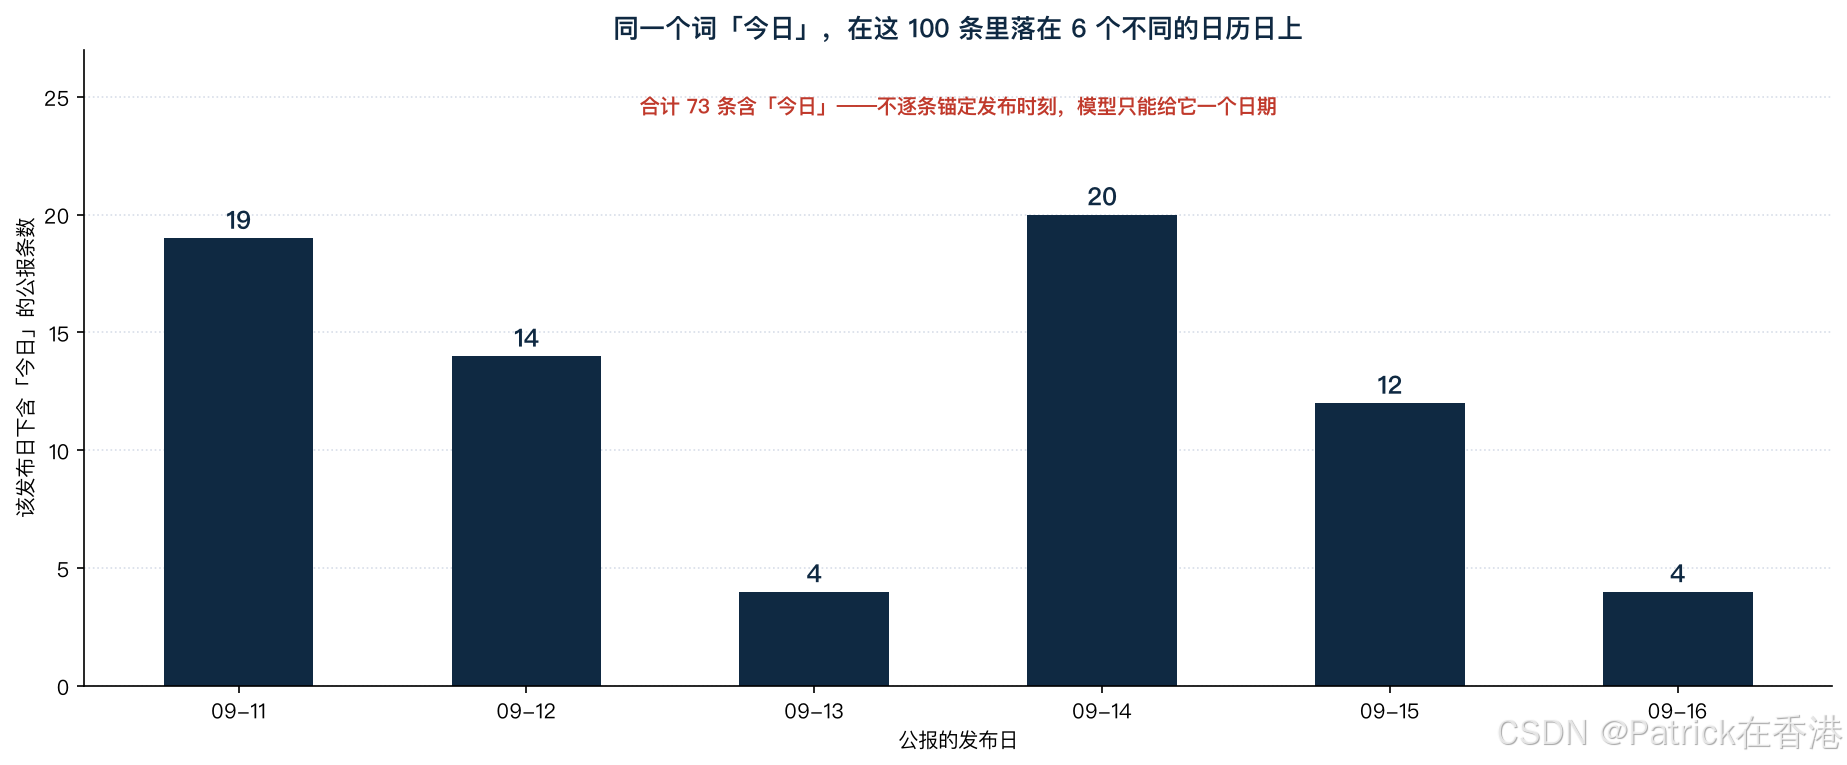
100 条公报跨 6 个发布日(09-11 到 09-16)。含「今日」的 73 条,逐日分布是:
09-11 → 19 条    09-12 → 14 条    09-13 → 4 条
09-14 → 20 条    09-15 → 12 条    09-16 → 4 条
同一个词,6 个含义。 如果你把这 100 条一次性丢给模型,问「哪些事发生在今日」,模型手上只有一个「今日」------它必须猜,或者编一个。
正确的做法不是让模型更努力,而是在数据进入上下文之前,把每一条的 pubDate 和它绑在一起 。这也是 Prompt 契约里 published_at 必须逐条传、不能只传一个「当前时间」的原因。
5. 发现三:锚点不统一,2.3% 的样本会翻车
香港公文有个很好的习惯:在相对时间后面用括号再把绝对日期写一遍。
明日(九月十六日)
翌日(九月十日)
这批数据里一共有 86 条 这样的写法。它等于文本自己给出的标注------可以直接拿来验证「锚点选得对不对」,而且是免费的回归测试集。
我把每条都按「锚到发布日」算了一遍:
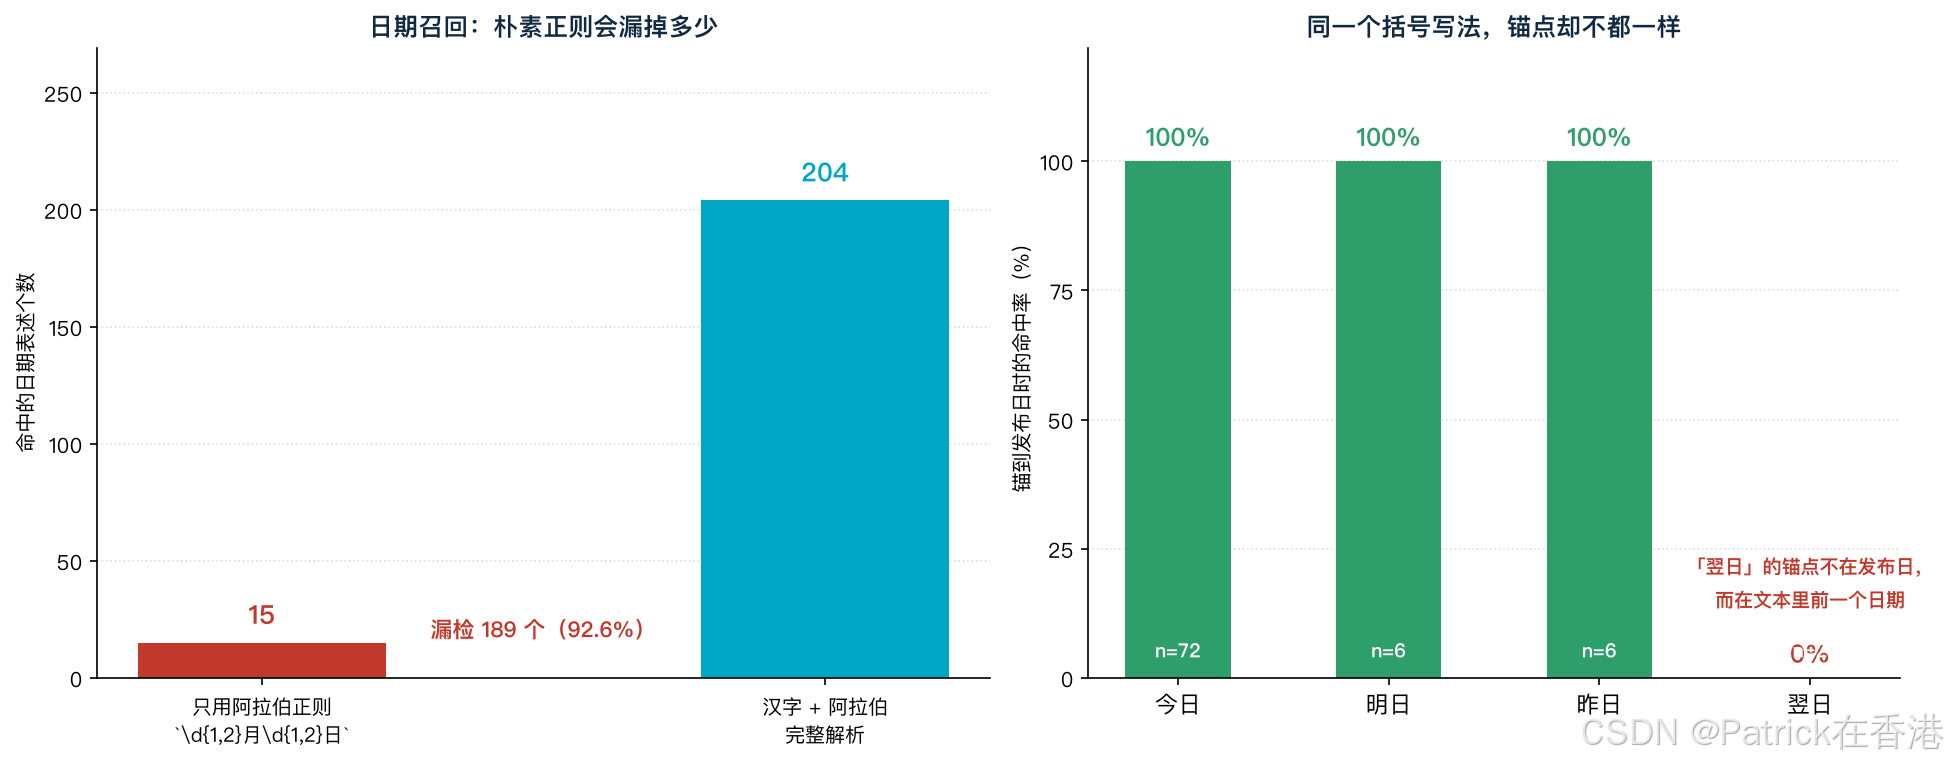
| 偏移词 | 样本数 | 锚到发布日命中 |
|---|---|---|
| 今日 | 72 | 100.0% |
| 明日 | 6 | 100.0% |
| 昨日 | 6 | 100.0% |
| 翌日 | 2 | 0.0% |
今日 / 明日 / 昨日 全部命中------因为公报基本是当天事当天发。但「翌日」两条全错,而且错法一模一样:
①  个案涉及一名 31 岁男子,他于九月九日出现...皮疹,
    翌日(九月十日)到衞生署...求医
    发布日 09-14 → 按发布日算得 09-15,实际 09-10,差 5 天

②  他于九月十一日开始出现发烧...,
    翌日(九月十二日)到伊利沙伯医院急症室求诊
    发布日 09-14 → 按发布日算得 09-15,实际 09-12,差 3 天
「翌日」的锚点不是发布日,而是文本里最近出现的那个日期。 这是句内指代,不是文档级偏移。把它当成「发布日 +1 天」,得到的是一个合法日期------格式对、范围合理、不报错,只有对着原文看才知道错了。
python
OFFSET = {"今日": 0, "本日": 0, "是日": 0, "即日": 0, "當日": 0, "同日": 0,
          "明日": 1, "翌日": 1, "後日": 2, "昨日": -1, "前日": -1}

def anchor(pubdate, word):
    """把相对词锚定到绝对日期------只对文档级偏移词成立。"""
    import datetime as dt
    return (pubdate + dt.timedelta(days=OFFSET[word])).date()

def pair_offset_absolute(text):
    """抽「翌日(九月十日)」这类自带绝对日期的写法。

    这是文本自己给出的标注,可以拿来当回归测试集。
    """
    pat = re.compile(r"(" + "|".join(OFFSET) + r")[((]"
                     r"([一二三四五六七八九十]{1,3}月[一二三四五六七八九十]{1,3}日)[))]")
    return [(m.group(1), m.group(2), m.group(0)) for m in pat.finditer(text)]
这两段建议收藏 :先用 pair_offset_absolute() 在真实语料上把所有自带对照抽出来,你会免费得到一批标注样本。用它们跑一遍 anchor(),哪些词能用文档级偏移、哪些词不能,一次就看清了------比手写测试用例可靠得多。
6. 发现四:汉字时刻的边界比日期更绕
43 处汉字时刻全用中文数字写,而「几点」这件事有三个必须写死的规则:
python
PERIOD = {"上午": 0, "早上": 0, "凌晨": 0, "中午": 12,
          "下午": 12, "傍晚": 12, "黃昏": 12, "晚上": 12, "深夜": 0}

def parse_zh_hm(period, hh, mm):
    """「下午 十二時 三十分」→ (12, 30)。"""
    h = zh_num(hh)
    if h is None or not (1 <= h <= 12):
        return None
    m = zh_num(mm) if mm else 0
    if m is None or not (0 <= m <= 59):
        return None
    if period in ("上午", "早上", "凌晨", "深夜") and h == 12:
        h = 0                      # 🔴 上午十二時 = 00:xx
    elif period in ("下午", "中午", "傍晚", "黃昏", "晚上") and h != 12:
        h += 12                    # 🔴 下午一時 = 13:xx,但下午十二時 保持 12
    return h, m
三个容易写错的点:
- 「下午十二時三十分」= 12:30,不是 00:30。中文的「下午十二時」指中午,不是午夜;
- 「上午十二時」= 00:xx,同一时刻换个时段词,结果差 12 小时;
- 「下午十一時二十四分」= 23:24,加 12 是对的------但前提是「十二」这一格已经被特殊处理掉。
语料里真实出现过 上午十一時至晚上七時及 这种跨时段范围表述。范围比单点更麻烦,因为两个时刻各自要按各自的时段词换算。
7. Prompt 契约:把锚点变成可校验的后置条件
上面四条发现合起来,指向同一个设计:别指望模型自己搞对时间,把这活儿拆成「模型抽取 + 代码校验」两段。
Prompt 里要传进去的(逐条,不是全局):
python
PROMPT_CONTRACT = {
    "role": "user",
    "content": (
        "下面每一条新闻公报都带有 published_at。\n"
        "请抽取其中的时间信息,输出严格的 JSON 数组,每个元素包含:\n"
        "  event_date ------ 事件发生的日期,ISO 8601(YYYY-MM-DD)\n"
        "  anchor     ------ 你是根据哪个锚点推算出来的,"
        "只能填 published_at / in_text / unknown 三者之一\n"
        "  quote      ------ 原文中支撑这个日期的最短片段(原样抄写,不要改写)\n"
        "规则:\n"
        "  1) 文中的「今日」以 published_at 为准;\n"
        "  2) 若某个相对词指向的是文内前文提到的日期,anchor 必须填 in_text;\n"
        "  3) 无法确定日期时,event_date 填 null、anchor 填 unknown,"
        "不允许猜测;\n"
        "  4) 汉字日期必须规范化成阿拉伯数字的 ISO 格式。"
    ),
}然后在本地把模型说得出处的东西验一遍:
python
def validate_times(items, rows):
    """逐条校验模型输出的时间抽取结果。"""
    problems = []
    for r in rows:
        it = items[r["source_id"]]
        d, anchor_kind, quote = r["event_date"], r["anchor"], r["quote"]
        # ① 出处必须在原文里逐字存在
        if quote and quote not in (it["title"] + " " + it["body"]):
            problems.append(("quote_not_found", r["source_id"], quote))
        # ② 声明用发布日锚定,就必须落在发布日 ±2 天内
        if anchor_kind == "published_at" and d:
            gap = abs((dt.date.fromisoformat(d) - it["pubdate"].date()).days)
            if gap > 2:
                problems.append(("anchor_out_of_range", r["source_id"], gap))
        # ③ 说 unknown 就不许同时给出日期
        if anchor_kind == "unknown" and d is not None:
            problems.append(("guessed_date", r["source_id"], d))
    return problems
三条规则各自拦一类错:
quote必须逐字命中:挡住模型改写原文、或者把「看起来像时间」的东西编进去;anchor=published_at时日期必须落在发布日附近 :这正是那两条「翌日」会触发的地方------它算出来的 09-15 距发布日只有 1 天,这条规则拦不住它。所以还有第三条;anchor=unknown不许带日期:把「我不确定」和「我猜的」在结构上分开。
而「翌日」这种真正需要句内指代的,校验器拦不住------只能靠 anchor 字段主动申报。 这也是为什么强制模型填 anchor 比让它填日期更重要:日期是结果,锚点才是推理依据,二者不一致时你只看得见前者。
8. 踩坑清单与结论
| 坑 | 现象 | 处理 |
|---|---|---|
| 只用阿拉伯日期正则 | 189 个汉字日期一个都抓不到,静默漏 92.6% | 先统计写法分布,再写正则 |
| 把「今日」当成一个时间 | 100 条里它落在 6 个日历日上 | 逐条绑定 published_at |
| 假定所有相对词都以发布日为锚 | 「翌日」2 条全错,差 3--5 天 | 强制输出 anchor 字段 |
| 只校验日期格式 | 错锚点算出来的是合法日期 | 校验必须带原文出处 |
| 「下午十二時」按 +12 处理 | 变成 00:30,差 12 小时 | 十二点单列规则 |
| 让模型输出改写过的引文 | 无法回溯验证 | quote 必须逐字命中原文 |
| 不确定就让模型给个日期 | 幻觉日期看起来和真的一样 | anchor=unknown 时日期必须为 null |
三条:
- 在数据进上下文之前锚定时间,比让模型「注意一下时间」有效得多。 模型没有能力知道你手上那份数据是几号发的------那不在它的输入里。
- 锚点会因词而异。
今日/明日/昨日用文档级偏移就够(本语料里 84/86 全对),翌日要用句内指代。差异只有 2.3%,抽样根本抽不到。 - 免费标注样本藏在文本里。 香港公文「相对词 + 括号绝对日期」的写法给出了 86 个自带答案的样本------用它当回归集,比拍脑袋写测试用例靠谱。
这套方法不挑语料:换任何一个官方中文文本源,先跑一遍 pair_offset_absolute() 看有多少自带对照,再用它验 anchor() ------如果这篇对你有用,收藏 + 点赞,下次处理中文公文时间时可以直接套。
香港公开数据的实测会继续更新,关注不迷路。
9. 参考链接
- https://www.info.gov.hk/gia/rss/general_zh.xml
- https://www.info.gov.hk/gia/general/today.htm
- https://data.weather.gov.hk/weatherAPI/opendata/weather.php?dataType=fnd\&lang=tc
原创声明:本文为原创技术实践。全部数字来自 2026-09-16 对香港特区政府新闻公报 RSS 最新 100 条的真实采集(跨 6 个发布日,09-11 至 09-16)。文中「锚到发布日的命中率」以文本自带的括号绝对日期为对照标准;「翌日」样本仅 2 条,属于小样本观察,结论限于本批语料,请以自测数据为准。接口字段与发布节奏可能随官方调整而变化。