告别部署繁琐:LlamaPi 一键搭建本地 Agent 推理底座
一、端侧大模型落地的三道门槛
端侧 AI 与本地 Agent 正在快速落地,各类端侧硬件的 NPU 推理算力也得到大幅提升。但不少开发者在实际落地时依旧要面对重重门槛,整个流程耗时长、上手门槛高,阻碍了端侧大模型与 Agent 项目的快速验证。
| 常见门槛 | 具体表现 | LlamaPi 的对应能力 |
|---|---|---|
| 模型获取与转换 | 手动下载权重、反复调试模型转换、转换后精度受损 | 模型库一键下载,按平台提供已适配的模型格式 |
| 推理环境搭建 | 手写 NPU 推理代码、依赖冲突、硬件算力无法充分释放 | 单条命令拉起推理服务,运行时自动对接 NPU |
| 长期运行与调度 | 部署不稳定、启停靠手工、重启后需重新加载 | 服务调度 + 持久化部署(开机自动加载) |
LlamaPi 的思路是把复杂的部署流程封装简化,为开发者提供一套开箱即用的离线私有 Agent 推理底座。
二、一条命令跑起本地模型
以往端侧部署大模型,需要手动完成模型下载、格式转换、推理环境配置等一连串操作。LlamaPi 把这套流程收敛为单条命令:
bash
# 以 Qwen3.5-4B 为例:自动拉取模型 + 启动本地推理服务
llamapi run qwen3.5-4b
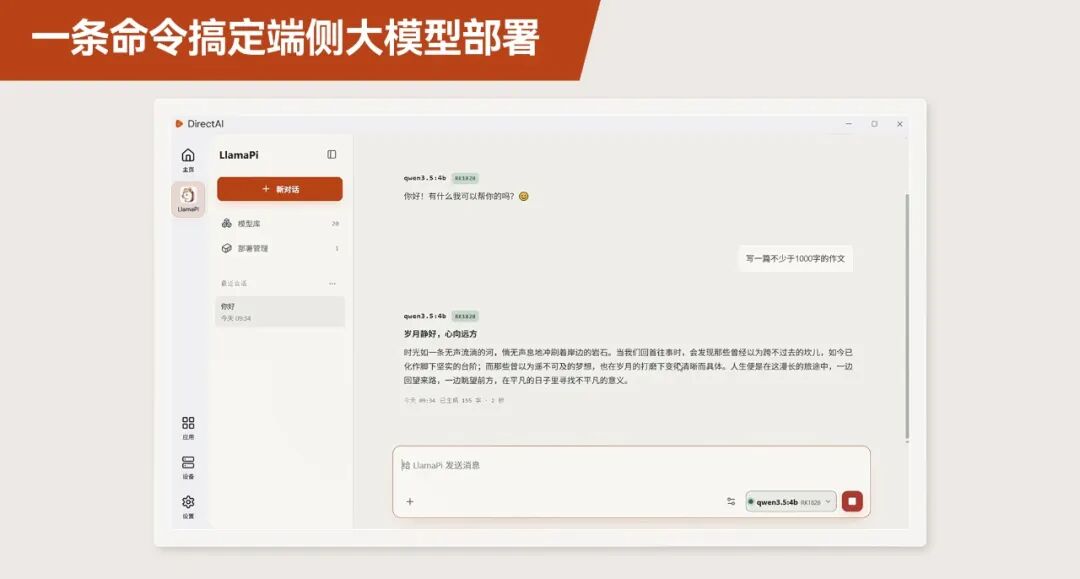
执行命令后,LlamaPi 会自动把模型拉取至本地,并依托端侧 NPU 硬件加速,快速提供高性能的本地大模型推理服务。对于不希望使用命令行的用户,它还配套了桌面客户端应用,提供可视化图形界面,点选操作即可完成模型运行与对话交互,降低上手门槛。
三、整体架构:三层结构
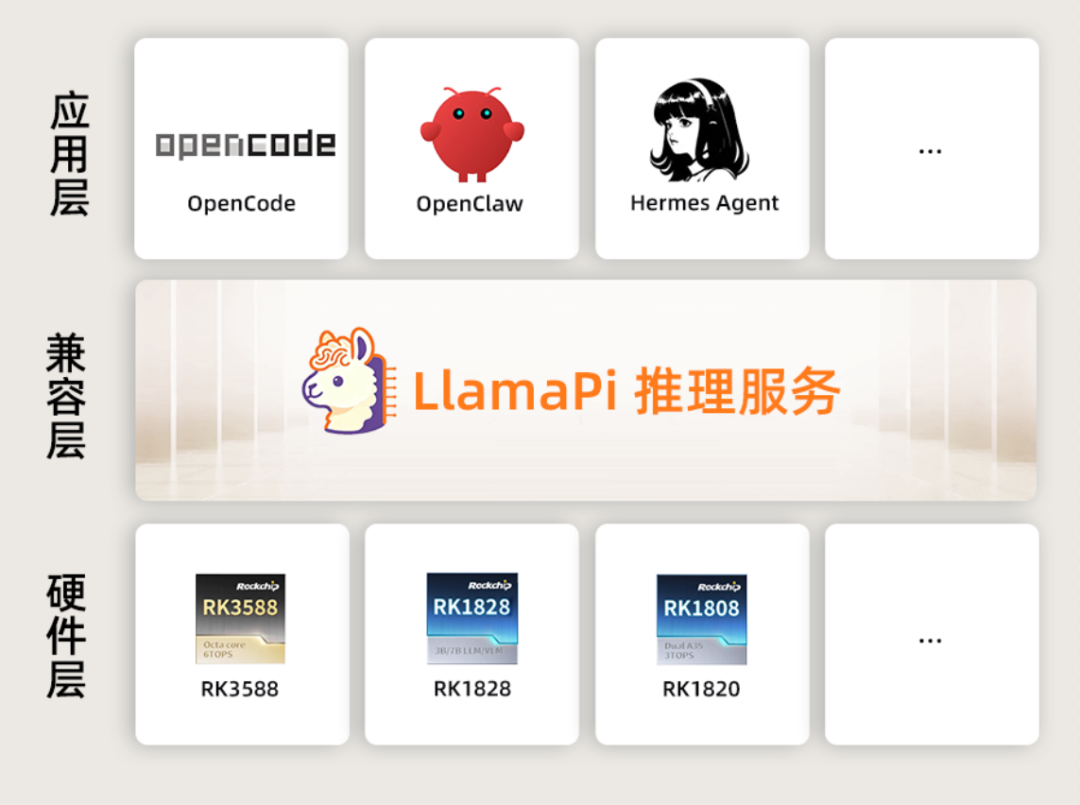
| 分层 | 组件 | 说明 |
|---|---|---|
| 应用层 | OpenCode / OpenClaw / Hermes Agent / 其他 OpenAI 兼容应用 | 通过 OpenAI 兼容 API 把推理请求发给 LlamaPi |
| 兼容层 | LlamaPi 推理服务 | 对内统一完成模型管理与服务调度,对外提供 OpenAI 兼容 API |
| 硬件层 | RK3588 / RK1828 / RK1820 等 | NPU 硬件加速,按平台加载对应格式的模型 |
上层各类第三方应用通过 OpenAI 兼容 API 将推理请求发送给 LlamaPi;LlamaPi 对内统一完成模型管理、服务调度,把推理任务交付给设备的 NPU 完成加速计算,推理结果再原路返回给上层应用。
四、模型库管理:查询 / 下载 / 清理
在端侧开发过程中,往往会同时测试多款不同的大模型。LlamaPi 具备完整的模型管理能力,帮助开发者完成模型的查询、下载与清理,不必手动维护零散的权重文件。
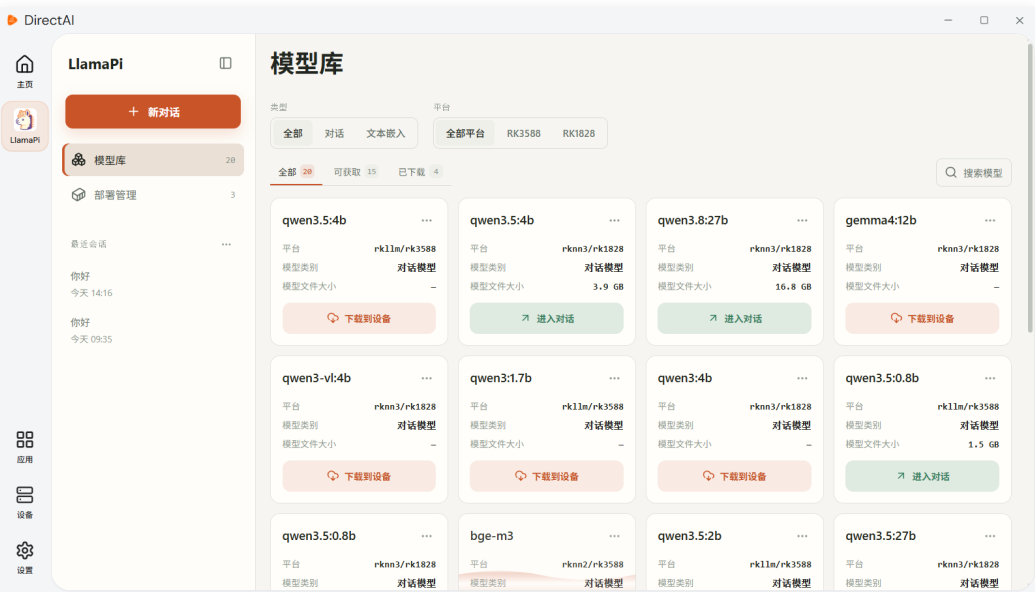
| 命令 | 作用 |
|---|---|
llamapi list |
列出本地已下载的所有模型 |
llamapi list --online |
查看适配当前设备的全部可用模型,包含尚未下载的模型 |
llamapi pull <model_name> |
下载指定模型至设备本地 |
llamapi rm <model_name> |
从设备上删除指定模型 |
llamapi list --online 会同时给出模型对应的推理平台与体积,便于评估是否适配当前硬件:
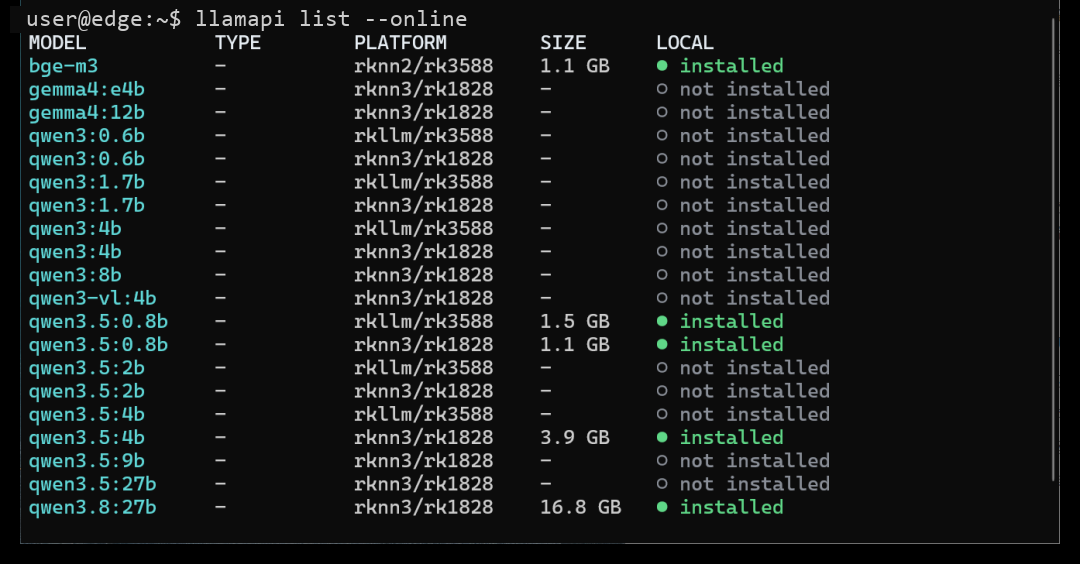
实测设备上可用的模型清单如下(PLATFORM 列表示该条目对应的推理后端与芯片组合):
| MODEL | PLATFORM | SIZE | LOCAL |
|---|---|---|---|
| bge-m3 | rknn2/rk3588 | 1.1 GB | installed |
| gemma4:e4b | rknn3/rk1828 | -- | not installed |
| gemma4:12b | rknn3/rk1828 | -- | not installed |
| qwen3:0.6b | rkllm/rk3588 | -- | not installed |
| qwen3:0.6b | rknn3/rk1828 | -- | not installed |
| qwen3:1.7b | rkllm/rk3588 | -- | not installed |
| qwen3:1.7b | rknn3/rk1828 | -- | not installed |
| qwen3:4b | rkllm/rk3588 | -- | not installed |
| qwen3:4b | rknn3/rk1828 | -- | not installed |
| qwen3:8b | rknn3/rk1828 | -- | not installed |
| qwen3-vl:4b | rknn3/rk1828 | -- | not installed |
| qwen3.5:0.8b | rkllm/rk3588 | 1.5 GB | installed |
| qwen3.5:0.8b | rknn3/rk1828 | 1.1 GB | installed |
| qwen3.5:2b | rkllm/rk3588 | -- | not installed |
| qwen3.5:2b | rknn3/rk1828 | -- | not installed |
| qwen3.5:4b | rkllm/rk3588 | -- | not installed |
| qwen3.5:4b | rknn3/rk1828 | 3.9 GB | installed |
| qwen3.5:9b | rknn3/rk1828 | -- | not installed |
| qwen3.5:27b | rknn3/rk1828 | -- | not installed |
| qwen3.8:27b | rknn3/rk1828 | 16.8 GB | installed |
从清单可以看出两条典型路线:
| 平台 | 承载硬件 | 覆盖规模 | 适用场景 |
|---|---|---|---|
| rkllm/rk3588 | 主控 NPU | 0.6B ~ 4B | 轻量对话、低功耗常驻任务 |
| rknn2/rk3588 | 主控 NPU(v2 运行时) | 向量/嵌入类模型 | 语义检索、知识库 embedding |
| rknn3/rk1828 | M.2 NPU 加速卡 | 0.6B ~ 27B | 大模型对话、多模态、代码 Agent |
同一模型往往会在不同平台上分别提供条目,便于按实际硬件选择对应的版本。
五、服务调度:加载 / 卸载 / 开机自启
完成模型下载之后,还需要灵活管控模型的运行状态:包括加载启动、停止释放、查看当前正在运行的模型,或是配置设备开机自动加载模型。在桌面客户端中可以直接对已下载模型执行加载、卸载、设置开机自启,并直观查看当前运行状态。
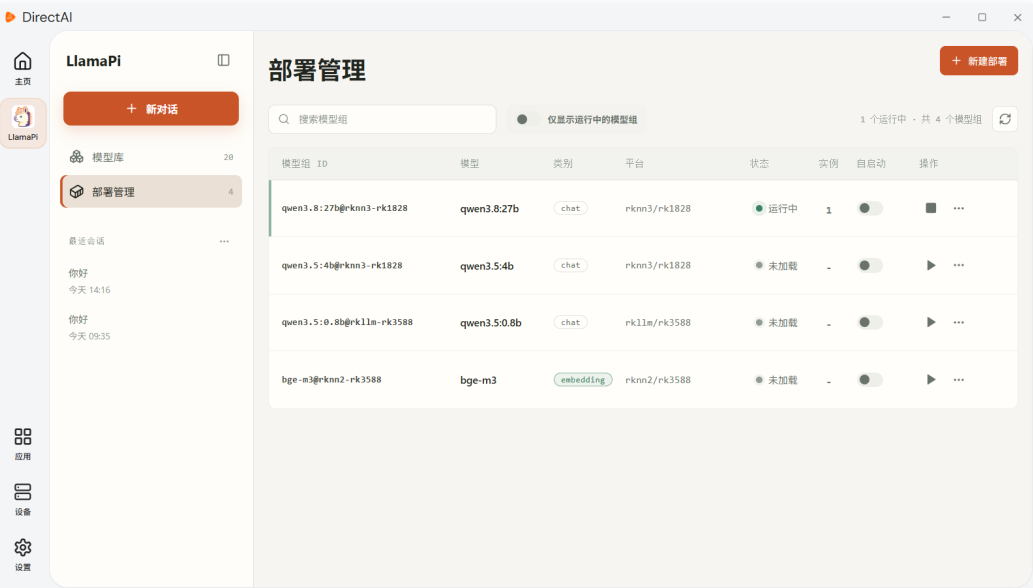
客户端「部署管理」页面中的模型组信息如下(1 个运行中 · 共 4 个模型组):
| 模型组 ID | MODEL | TYPE | PLATFORM | STATUS | 实例 |
|---|---|---|---|---|---|
| qwen3.8:27b@rknn3-rk1828 | qwen3.8:27b | chat | rknn3/rk1828 | 运行中 | 1 |
| qwen3.5:4b@rknn3-rk1828 | qwen3.5:4b | chat | rknn3/rk1828 | 未加载 | -- |
| qwen3.5:0.8b@rkllm-rk3588 | qwen3.5:0.8b | chat | rkllm/rk3588 | 未加载 | -- |
| bge-m3@rknn2-rk3588 | bge-m3 | embedding | rknn2/rk3588 | 未加载 | -- |
命令行同样覆盖全部调度能力,适合快速调试与脚本化运维:
| 命令 | 作用 |
|---|---|
llamapi ps |
查看设备上当前已经部署运行的模型状态 |
llamapi load <model_name> |
加载并启动本地已下载的指定模型 |
llamapi unload <model_name> |
卸载正在运行的模型,释放硬件资源 |
llamapi enable <model_name> |
设置模型持久化部署,设备重启后自动加载该模型 |
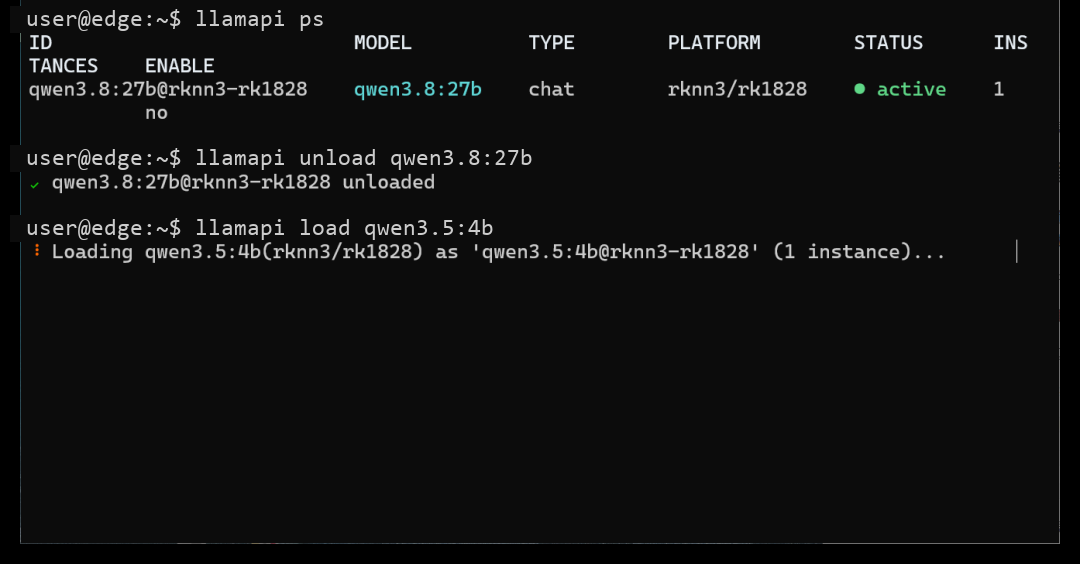
llamapi ps 的输出包含模型 ID、MODEL、TYPE、PLATFORM、STATUS 与实例数,另有一列 ENABLE 表示是否已设为开机自启。上述实测中,27B 模型处于 active 状态、1 个实例;unload 后立即释放,随后可用 load 拉起另一个模型。
六、接入第三方应用:OpenAI 兼容 API
当模型在设备内部署完成后,LlamaPi 会自动输出 OpenAI 兼容 API,无需额外开发,就可以将本地端侧推理能力对接各类第三方 AI 应用,快速搭建完整的离线私有 AI 工作流。
| 配置项 | 填写内容 |
|---|---|
| 服务提供方 | OpenAI 或 OpenAI-compatible |
| 自定义服务地址(Base URL / API Endpoint) | http://<设备 IP>:9265/v1 |
| 模型 ID | 通过 llamapi ps 命令或客户端「部署管理」页查看 |
第三方应用配置流程:
| 步骤 | 操作 |
|---|---|
| 1 | 在第三方应用中选择 OpenAI 或 OpenAI-compatible 服务提供方 |
| 2 | 找到自定义服务地址(Base URL / API Endpoint)配置项,填入 http://<设备 IP>:9265/v1 |
| 3 | 填写对应的模型 ID,模型 ID 可通过 llamapi ps 命令或在客户端部署管理页面中查看 |
| 4 | 保存后即可在应用内调用本地模型,构建离线私有 AI 工作流 |
七、命令速查表
| 分类 | 命令 | 说明 |
|---|---|---|
| 快速启动 | llamapi run <model> |
拉取模型并直接运行 |
| 模型查询 | llamapi list |
列出本地已下载的模型 |
| 模型查询 | llamapi list --online |
查看当前设备全部可用模型 |
| 模型管理 | llamapi pull <model> |
下载指定模型 |
| 模型管理 | llamapi rm <model> |
删除指定模型 |
| 服务调度 | llamapi ps |
查看运行中的模型状态 |
| 服务调度 | llamapi load <model> |
加载并启动模型 |
| 服务调度 | llamapi unload <model> |
卸载模型、释放资源 |
| 持久化 | llamapi enable <model> |
设备重启后自动加载 |
| 应用接入 | OpenAI 兼容 API | http://<设备 IP>:9265/v1 |
八、小结
LlamaPi 把端侧大模型部署中「模型下载 → 格式转换 → NPU 推理 → 服务接口」这几段最耗时的流程做了封装:单条命令即可拉起本地推理服务;模型库与部署管理覆盖查询、下载、清理、加载、卸载与开机自启;对外通过 OpenAI 兼容 API 直接对接 OpenCode、OpenClaw、Hermes Agent 等第三方应用。对于需要离线、私有化、低门槛验证端侧大模型与本地 Agent 的场景,这是一条值得尝试的路径。