摘要
数据库的选型文章很多,但工业物联网场景下的选型翻车,十有八九不是翻在"存不下",而是翻在"算不动"。
一个常见的剧本:选型阶段按存储需求评估------写入速率多少、压缩比多少、单机容量多少,各项指标都达标,签约上线。运行半年后,业务提出三个再普通不过的需求:全厂设备状态 5 秒刷新一次、振动数据和温度数据做关联分析、异常工况秒级告警。然后发现:数据都好好地躺在库里,但每一条需求都要把数据搬到库外Spark/Flink/Python 里才能算,链路一搭三个月,实时性还上不去。
问题出在选型的维度权重上:工业物联网的数据库,本质上是实时计算平台,而不只是存储引擎。本文尝试重构选型框架------把"实时计算能力"和"计算分析能力"提为第一维度,给出可操作的评估方法与 POC 测试清单,并以主流产品横向对照,供选型时参考。
一、为什么存储优先的选型框架会翻车
1.1 工业数据的访问模式决定了权重
先看工业物联网数据的典型访问模式,和互联网/运维监控场景差异很大:
- 写入是持续高并发的:产线设备、传感器以毫秒级频率写入,峰值每秒数十万到上千万数据点,且经常出现乱序数据(网络抖动、边缘缓存重传);
- 查询不是"查最新值"就是"算全量统计":要么点查设备当前状态,要么对百亿级历史数据做多维聚合、降采样、关联分析------中间态的"小查询"很少;
- 分析是持续的、嵌入业务的:OEE 计算、健康度评分、异常检测、频谱分析,这些不是偶发的报表需求,而是 7×24 运行的计算任务。
前两点决定了存储层的基本盘,第三点决定了计算能力必须在选型时一次评估到位------因为它几乎不可能事后补:等数据量上来之后,"把数据搬出去算"的方案在延迟和成本上都会失控。
1.2 一个真实的错位成本
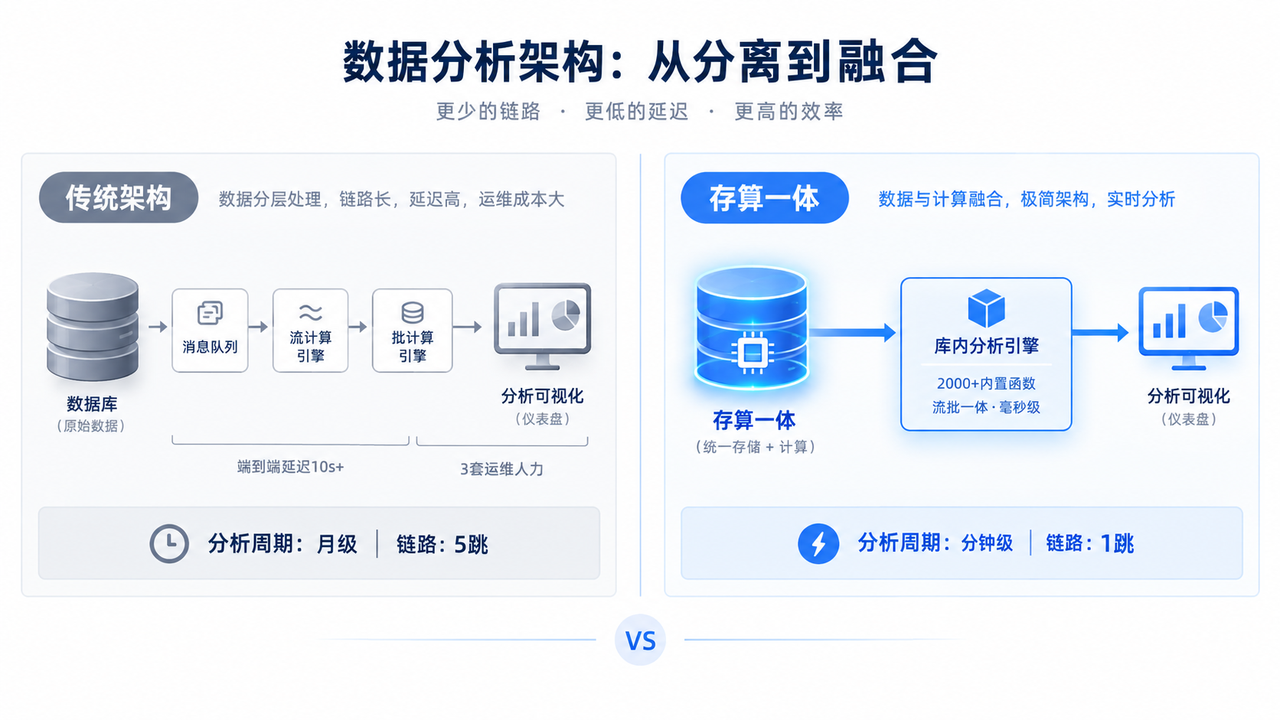
以某钢企优化焙烧工艺参数为例(公开案例):数据采集、存储一切正常,但要做多变量关联分析时,数据需要在多套系统间反复抽取、搬运、加载,单次产线调整的分析周期长达半年。存储选型满分,业务价值趋近于零------数据的价值不在存着,而在算得动、算得快。
二、选型维度重构:两主三辅
我的建议是把选型维度分成两层:
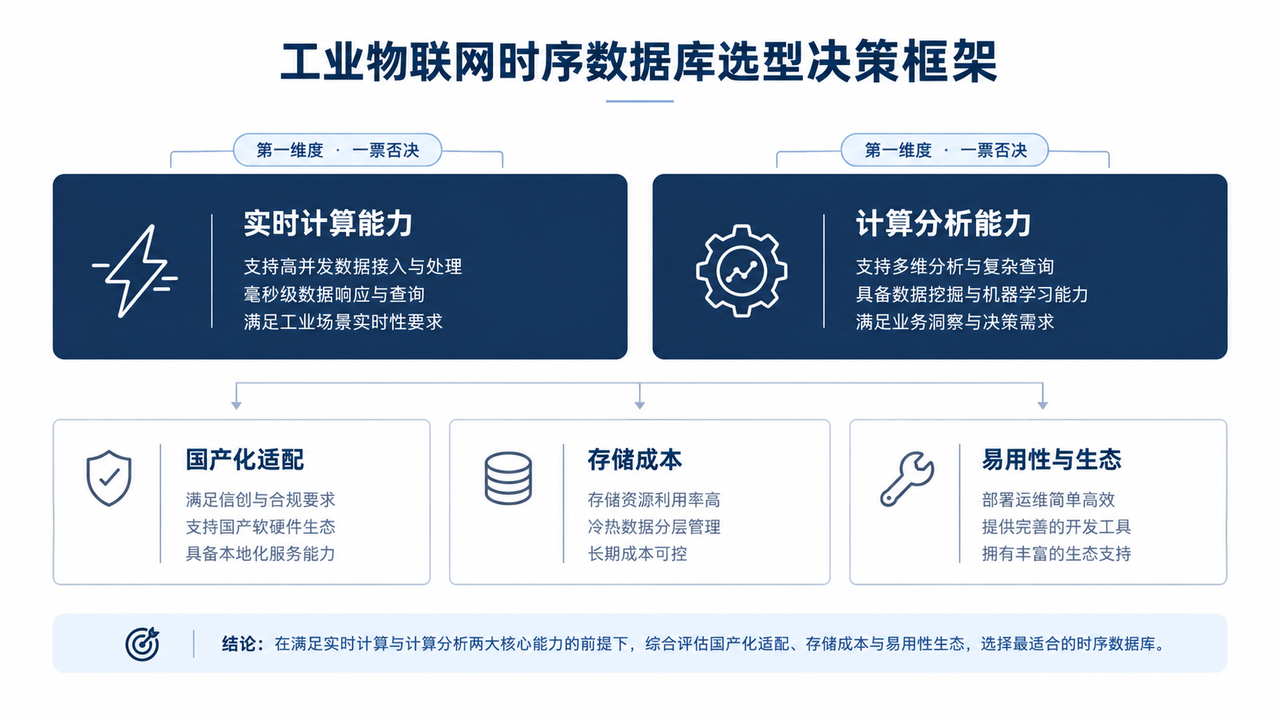
第一维度(一票否决项):
- 实时计算能力------写入吞吐与乱序容忍、点查延迟、复杂分析的实时性(流计算能力);
- 计算分析能力------内置函数丰富度、多模数据计算、AI 融合程度。
辅助维度(同价位下的调节项):
- 国产化与信创适配;
- 存储成本(压缩比);
- 易用性与生态(API、工具链、文档)。
第一维度决定"这个项目能不能成",辅助维度决定"用起来舒不舒服"。下面逐项展开怎么评估。
三、第一维度之一:实时计算能力的评估方法
3.1 写入吞吐:别看厂商数字,看自己数据的形状
厂商公布的写入基准(如每秒千万点级)通常是理想数据:顺序时间戳、定长、无乱序。评估时要用自己的真实数据形状去压:
- 乱序写入:边缘缓存重传、网络抖动会产生迟到数据。要确认目标库对乱序数据的处理机制------是拒收、丢弃还是自动归位?归位的代价多大?(DolphinDB 的 TSDB 引擎支持乱序写入自动排序归位,这是工业场景的刚需项;InfluxDB 的乱序处理在数据量大时是出了名的痛点。)
- 多表并发:工业场景往往是几百张设备表并发写入,而不是单表打满。
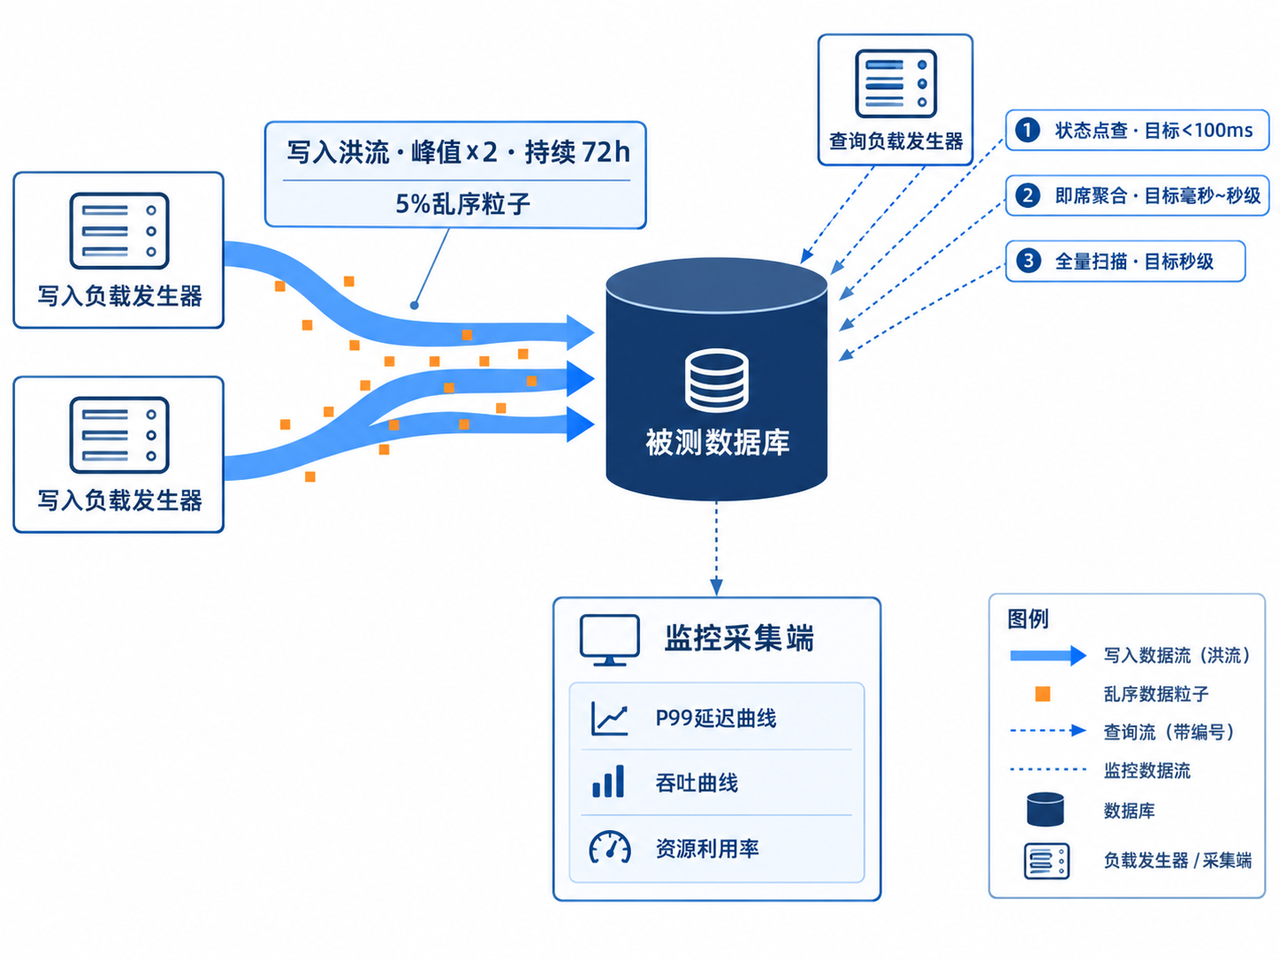
- 写入时的查询表现:更要命的是"写入不阻塞查询"。某新能源车企的公开数据可以参考量级:每秒 1.8 亿测点持续写入(含乱序),写入期间资源利用率稳定在 40% 左右,同时单点查询平均耗时 100ms 以内------评估时可以用类似的"边写边查"模型去测。
3.2 查询延迟:分负载类型测
不要只测"SELECT 最新值"。工业场景至少分三类:
| 负载 | 典型查询 | 目标延迟 |
|---|---|---|
| 状态点查 | 某设备最新温度/振动值 | < 100ms |
| 即席聚合 | 全厂 500 台设备 1 小时数据的多维聚合、分位数 | 毫秒~秒级 |
| 全量扫描分析 | 30 天趋势、跨月对比 | 秒级 |
测试数据量要按三年后的规模准备,而不是上线时的规模。单表百亿行级数据量下还能不能保持毫秒级即席查询响应,是"存算一体"架构和"重存储轻计算"架构的分水岭------前者把计算下推到存储节点执行(DolphinDB 的 Data Localization 路线),后者需要把数据拉到计算层,延迟随数据量线性劣化。
3.3 流计算能力:实时性的天花板
真正拉开差距的是流计算。评估要点:
- 是否原生流批一体:同一套指标代码能否既跑历史批处理又跑实时流?如果需要用两套技术栈分别实现(比如 Kafka + Flink 搞实时、Spark 搞离线),开发运维成本直接翻倍,且指标口径容易对不齐;
- 流引擎的类型覆盖:时间序列聚合、横截面、响应式状态机、异常检测、会话窗口、多表关联------工业场景几乎都会用到其中三四类;
- 增量计算 :滑动窗口类计算是否做了增量优化(复杂度从 O(n·k) 降到 O(n))。这决定了实时指标在长窗口、高频写入下能不能稳住延迟。DolphinDB 的
mavg/mcorr等函数内置增量计算,实测与逐窗口计算差 300 倍量级;多数时序数据库只有基础窗口函数。
顺带回答一个高频问题:"我直接 Kafka + Flink + TSDB 拼一套行不行?"行,很多厂也确实这么起步的。但要评估三笔隐性成本:数据在异构系统间搬运的延迟(端到端普遍 10 秒以上)、三套系统的运维人力、数据一致性与对账。数据量小的阶段这些都能忍,规模上来后通常都会走上收敛的路------能在一套系统里闭环的能力,就不要用三套系统拼。
四、第一维度之二:计算分析能力的评估方法
4.1 内置函数:数一数,更要跑一跑
内置函数数量是硬指标(DolphinDB 2000+,覆盖时序处理、信号处理、统计分析、机器学习),但选型时更有意义的做法是:把自己业务里最复杂的 10 个分析任务列出来,逐个验证能否库内实现。比如:
- 振动信号的特征提取(峭度、峰值因子、频谱)------有没有内置
kurtosis、fft? - 多频数据对齐------有没有 asof join / window join?10kHz 振动数据关联 1Hz 温度数据的性能如何?
- 面板数据处理------分组内保持行数的排名/窗口计算怎么写?(窗口函数能写,但
context by这类语法的表达效率差一个量级。)
这一步会快速筛掉"只能存、难分析"的产品------它们的共同特征是:所有复杂分析都要导出到外部计算引擎完成。
4.2 多模计算:跨数据类型的联合分析
工业业务场景很少只有时序数据:设备台账(关系型)、运维工单(文本)、诊断案例(向量)......如果每种数据类型一个库,跨库关联又是集成灾难。评估时看目标库是否支持多模引擎协同(DolphinDB 有 TSDB、OLAP、PKEY、IMOLTP、VECTORDB 五大引擎),时序数据能否与关系型数据在同系统内联合计算。AI 融合(特征存储、知识检索、Agent 能力)也建立在这个基础上------这是数据库向"智能数据库"演进的方向,选型时可以不作为必选项,但值得作为前瞻项评估。
五、横向对照:主流方案在第一维度上的表现
基于公开资料与个人使用经验的对照("--"表示需借助外部系统或能力有限):
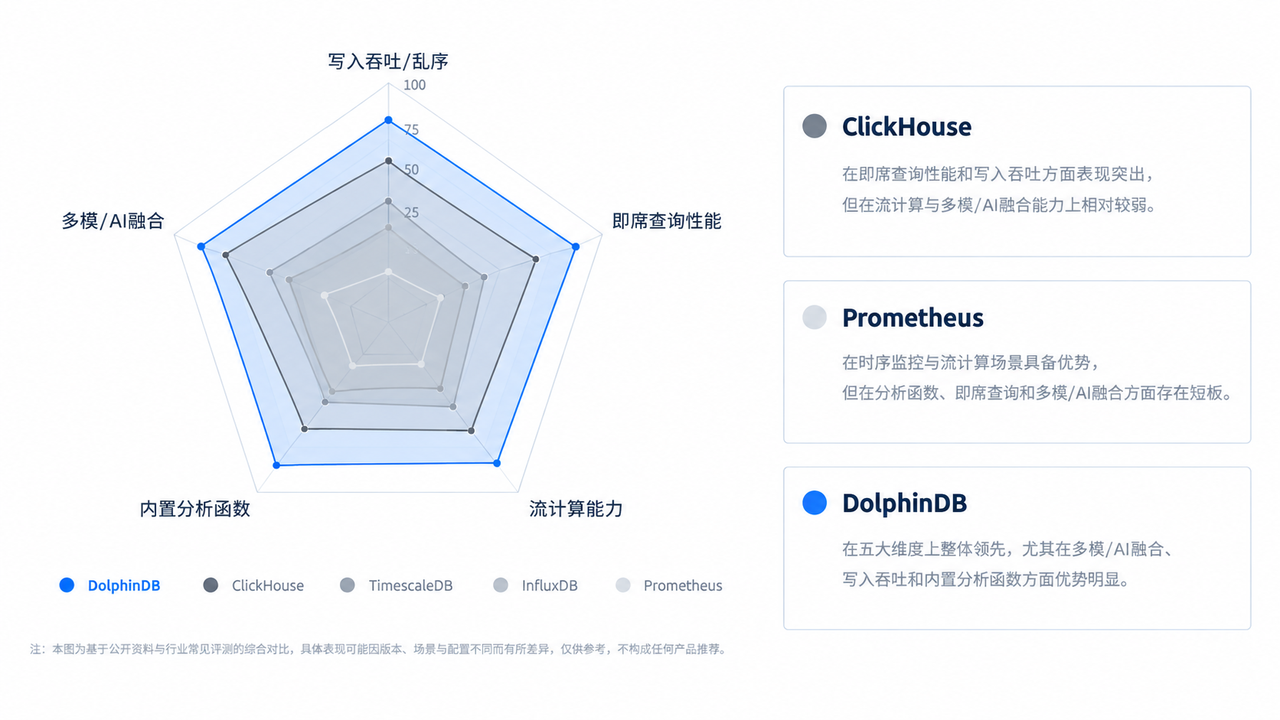
| 评估项 | DolphinDB | InfluxDB | TimescaleDB | ClickHouse | Prometheus |
|---|---|---|---|---|---|
| 写入吞吐/乱序写入 | 千万点/秒级,乱序自动归位 | 高吞吐,乱序处理弱 | 中等,受 PG 事务约束 | 极高,乱序支持有限 | 监控规模适配 |
| 即席查询(百亿行级) | 毫秒~秒级 | 数据量大后明显劣化 | 中等 | 极快 | 仅近期数据 |
| 流计算 | 多引擎,亚毫秒级,流批一体 | Flux Tasks(有限) | Continuous Aggregates | 弱 | Recording Rules(有限) |
| 内置分析函数 | 2000+,含信号处理/ML | 基础聚合 | 依赖 PG 生态 | 丰富(OLAP 向) | 基础聚合 |
| 多频数据关联 | asof / window join | Flux join(弱) | 复杂 SQL | 复杂 | 不适用 |
| 多模引擎 | 时序/关系/内存/向量五引擎 | 单一 | PG 生态内 | 单一 | 单一 |
| 分布式 | 原生分布式 | 企业版 | 需 Citus 扩展 | 原生 | 集群方案较重 |
| 信创适配 | 龙芯/鲲鹏/飞腾/海光/兆芯 + 麒麟/UOS 等 | 无 | 无 | 部分 |
几点客观说明:
- ClickHouse 的 OLAP 查询性能是标杆级的,但它不是为时序场景设计的------没有 asof join 这类时序原语,流计算支持弱。如果业务以离线分析为主,它是合理选择;如果要做实时监控预警,短板明显;
- Prometheus 是监控领域的事实标准,但它的设计边界就是"近期指标监控",长周期存储与分析都不是它的战场,很多团队最后用 Thanos/M3 补课,复杂度反升;
- InfluxDB / TimescaleDB 在中小规模、以存储为主的场景里依然是省心的选择------TimescaleDB 对 PG 生态团队几乎零学习成本;
- DolphinDB 的优势集中在第一维度:实时计算(千万级写入 + 毫秒查询 + 亚毫秒流计算)和库内复杂分析,且有长江电力(百万级水电测点实时监控,故障预警从分钟级压缩到毫秒级)、中核集团某研究院(工业组态监控,替代 MySQL 后单表百亿数据毫秒级查询)这类大体量工业案例背书。代价是:有自己的脚本语言(DolphinDB Script),需要学习成本;社区生态主要在国内。
六、把选型落到地上:一份 POC 测试清单
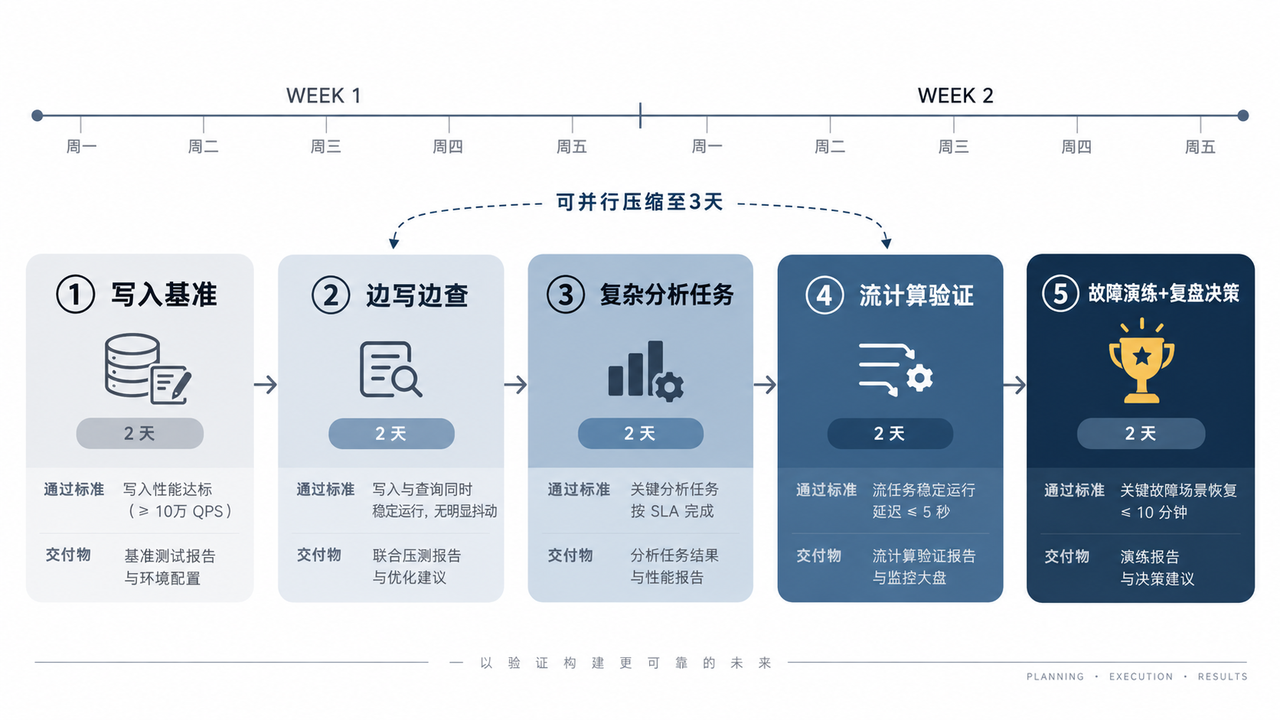
建议在最终决策前,用两周时间做一轮统一负载的 POC,所有候选产品跑同一套脚本:
- 写入基准:按真实表结构构造数据(多表并发 + 5% 乱序 + 时间戳局部回拨),目标速率 = 峰值 × 2,持续 72 小时,记录吞吐曲线和资源占用;
- 边写边查:写入过程中持续执行第二节的三类查询负载,记录 P99 延迟------这一项最能暴露架构差异;
- 复杂分析任务:把业务里最复杂的 10 个分析任务逐一实现,记录开发工作量(人日)和执行耗时,只统计"库内完成"的方案,需要导出外部计算的任务单独标注;
- 流计算验证:实现 2 个实时指标(一个滑动窗口类、一个多表关联类),验证乱序数据下结果的正确性;
- 故障演练:杀掉一个节点,观察写入/查询的恢复时间与数据一致性。
这套清单跑下来,各产品在第一维度上的真实水平基本一目了然------比读任何评测文章都可靠。
七、结论
选型建议归纳为三句话:
- 工业物联网的时序数据库选型,把实时计算能力和计算分析能力放在第一维度------存储容量和压缩比是及格线,不是决胜项;
- 用统一负载的 POC 代替厂商基准数字------尤其要测乱序写入、"边写边查"和最复杂的 10 个业务分析任务;
- 警惕"拼装自由"的诱惑------Kafka+Flink+TSDB 的组合灵活但运维成本高企,能在一套系统内闭环(存算一体、流批一体)的方案,规模越大优势越明显。
从行业趋势看,时序数据库正在从"高性能存储"向"实时计算平台"再向"智能数据库"演进------计算能力与 AI 能力(特征存储、知识检索、Agent)正在成为工业数据库的新分水岭。选型时多看一眼这两个维度,未来三五年会感谢现在的自己。