用 AI 把PCB制前工程CAM无人值守输出系统做出来
副标题:一套带权限、审计与自愈的生产系统,以及我总结的 7 条 AI 协作纪律
作者 :集团 CAM 系统维护与开发负责人(及 DeepSeek Harness桌面版)
数据 :文中数字都取自系统数据驾驶舱和生产库的实测,可复核
脱敏:料号、人员、内网地址、口令与令牌都做过处理
本文配图
正文里有 8 张图,每张图下面都带一个交互版的链接:能切明暗主题、滚轮缩放、按名字搜节点,点一个节点还能看它上下游的关系。图里是静态快照,链接里是完整版。
| 图 | 位置 | 看什么 |
|---|---|---|
| 图 1 整体架构与数据流 | 第 1 节 | 从上游判定到资料产出,一条主线怎么走 |
| 图 2 任务的一生 | 第 2 节 | 任务从排队到成功,中间经过哪些状态 |
| 图 3 卡死还是只是慢 | 第 2 节 | 三路判据,怎么区分"真卡死"和"只是慢" |
| 图 4 权限与鉴权 | 第 2 节 | 一次操作要过几道关;"没登录"和"没权限"为什么分开 |
| 图 5 AI 协作的 7 条纪律 | 第 3 节 | 人机分工 + 7 条纪律,配我踩过的例子 |
| 图 6 库体积治理 | 第 2 节 | 数据库从 4.68 GB 瘦下来的过程 |
| 图 7 三级监控 | 第 4 节 | 从"系统活着"到"真把事做成了",分三层看 |
| 图 8 一次派活的完整往返 | 第 1 节 | 派活、干活、交结果、兜底、通知的时序 |
0. 我交付了什么
我在厂里做 CAM 系统的维护和开发,顺带带一个小团队。说白了就是:产线上跟 CAM 有关的那套系统,坏了修,要新功能就写。
过去这一段时间,我用 AI 作为主要开发手段,交付了一套无人值守系统 :上游系统说"这个料号可以出",它自己去判断该出哪几种资料,派活给执行引擎,驱动专业设计软件把资料导出来、自检、回报,再通知该负责的人。它不是演示,是在产线上天天跑的系统。
先看数据驾驶舱里的真实数字:
| 指标 | 实测值 |
|---|---|
| 累计业务任务 | 2,397 |
| 成功输出 | 2,034 |
| 成功率(驾驶舱口径) | 97.5% |
| 覆盖料号 | 251 个 |
| 覆盖资料类型 | 25 种 |
| 平均单任务执行时长 | 9.5 分钟 |
| 平均端到端(含排队) | 23.5 分钟 |
| 资料输出量覆盖(业务口径) | 60% 以上 |
| 累计替代人工工时 | 约 508.5 小时 ≈ 63.6 个工作日(按人工最快 15 分钟/次保守估算) |
| 运行方式 | 7×24 无人值守 |
撑起这些数字的工程面:两个独立服务、21 个对外接口、四档权限体系 + 全量写操作审计 、三级监控 (服务存活 / 任务活性 / 产出与库体积)、三份可查文档、执行端累计 10 万+ 条执行记录。
上面这些都是我自己跑出来的数字。这套系统到底长什么样、是不是真在无人值守地干活,看实机演示最直接------录的是生产服务器上真在跑的那套,不是搭出来的演示环境:
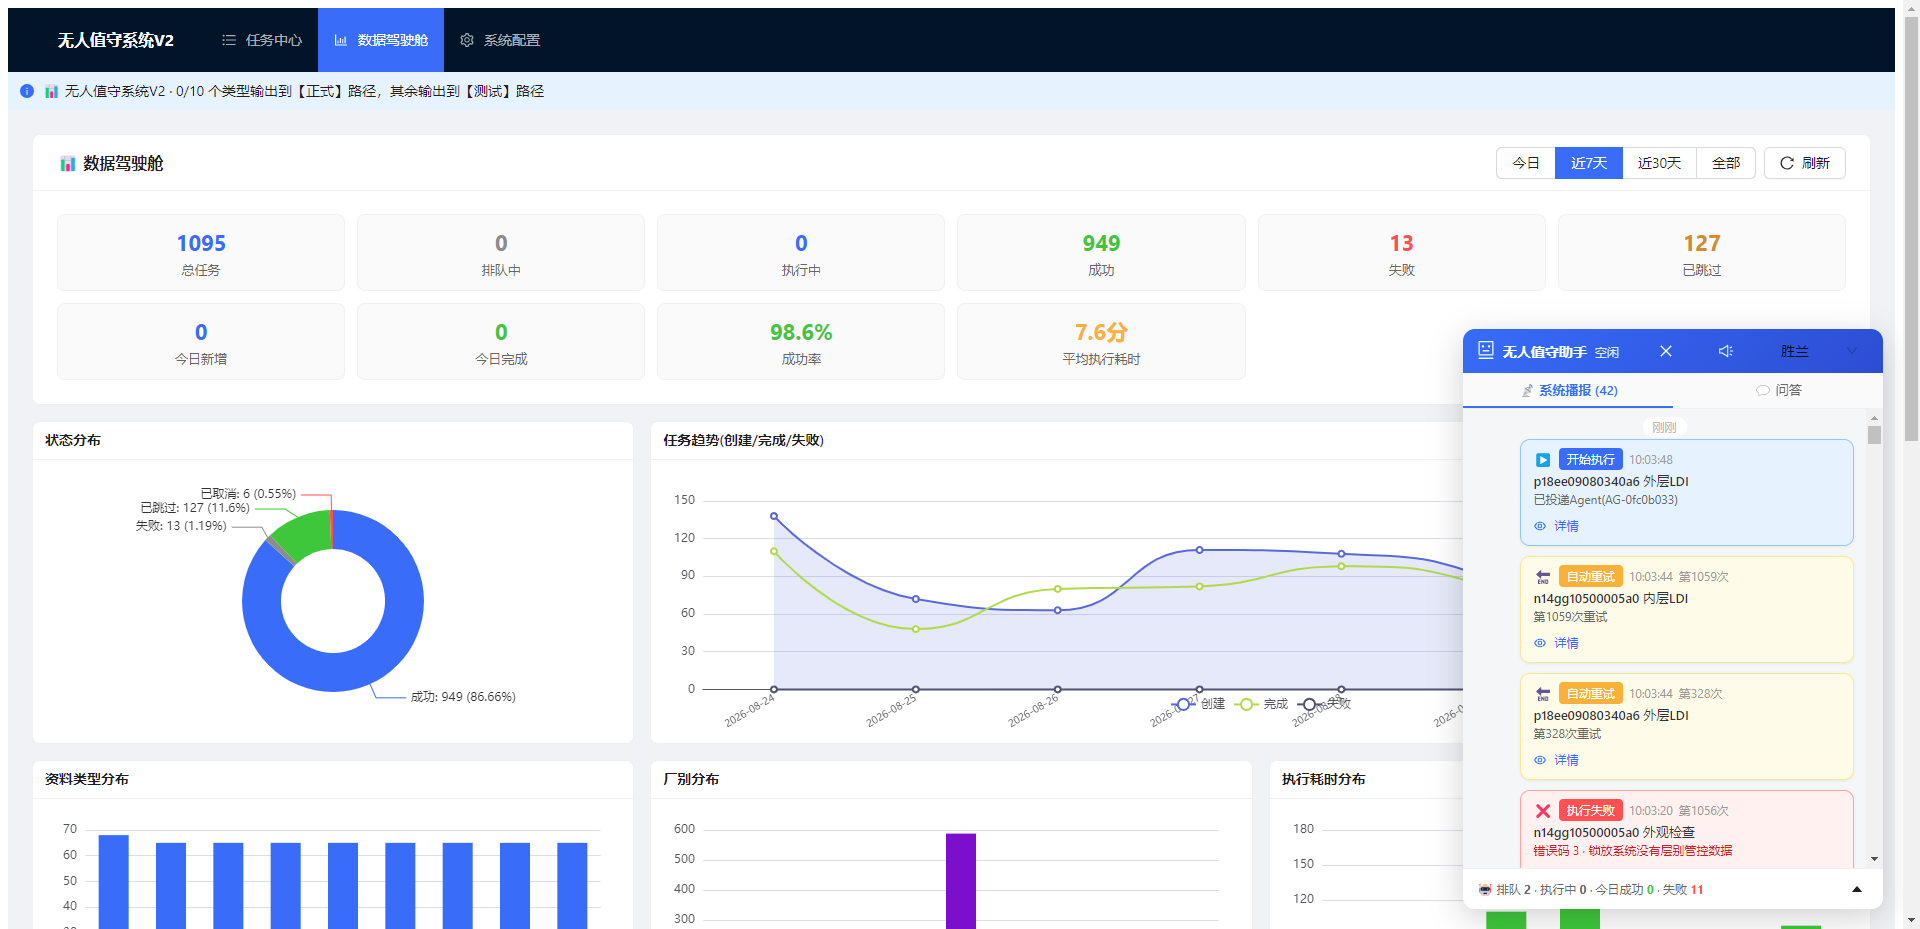
▶ 看 5 分 09 秒实机演示 ------ 自动拉单、自动登录 InCAMPro 出资料、MD5 完整性校验、失败自动重排、企微卡片推送、语音播报,一次跑完。
(视频是外链,建议点开全屏看;支持拖动进度条。)
这篇文章讲两件事:这套系统里的技术是怎么设计的,以及我是怎么用 AI 把它做出来的。
说白了,AI 把我一个人,变成了一支能交付生产系统的队伍。
1. 系统全景:技术与架构
1.1 它解决的是什么问题
工厂做电路板,前面有一道准备资料的活:照着客户的设计文件,把生产要用的资料一批批导出来。内层要一份、外层要一份、检验要一份、电测要一份......每种资料对应一道工序,少一样,后面工序就得等。
这活以前是人干的:打开 InCAMPro,一个类型一个类型导出来,复制到对应工序的共享目录,再通知下工序的人。慢是肯定的,更要命的是没人守夜班------半夜来的料号,只能等第二天上班。
系统要解决的就是这两件事。用工厂角色对照:
| 工厂角色 | 系统角色 | 职责 |
|---|---|---|
| 下单方 | 上游 MES 系统 | 判定"这个料号审核完成、可以输出" |
| 车间主任 | 调度系统(V2) | 拉单、按规则生成任务、派活、盯进度、审计、通知 |
| 机台/操作工 | 执行引擎(Agent) | 接活、驱动软件执行、自检、回传 |
| 机床 | 专业设计软件(InCAMPro) | 真正的产出环节 |
| 车间看板 | 企业微信 | 结果按负责人推送 |
上游 MES → 调度系统(拉单/生成任务) → 执行引擎(驱动软件执行/自检 7 项)
→ 结果回传 → 状态更新 → 企微通知 → 数据驾驶舱统计上面这条链里,执行引擎 是最容易让人好奇的一环:它怎么被叫起来、凭什么能同时干几个活、失败了怎么办。这块我另外写了一份不需要技术背景也能读的说明,分两篇------上篇讲人话,下篇给要动手的人:
📄 《任务执行 Agent · 人人看得懂》 ------ 18 节:统一协议、任务状态机与错误码、白名单与权限、并发隔离、可靠性机制、排障对照表。
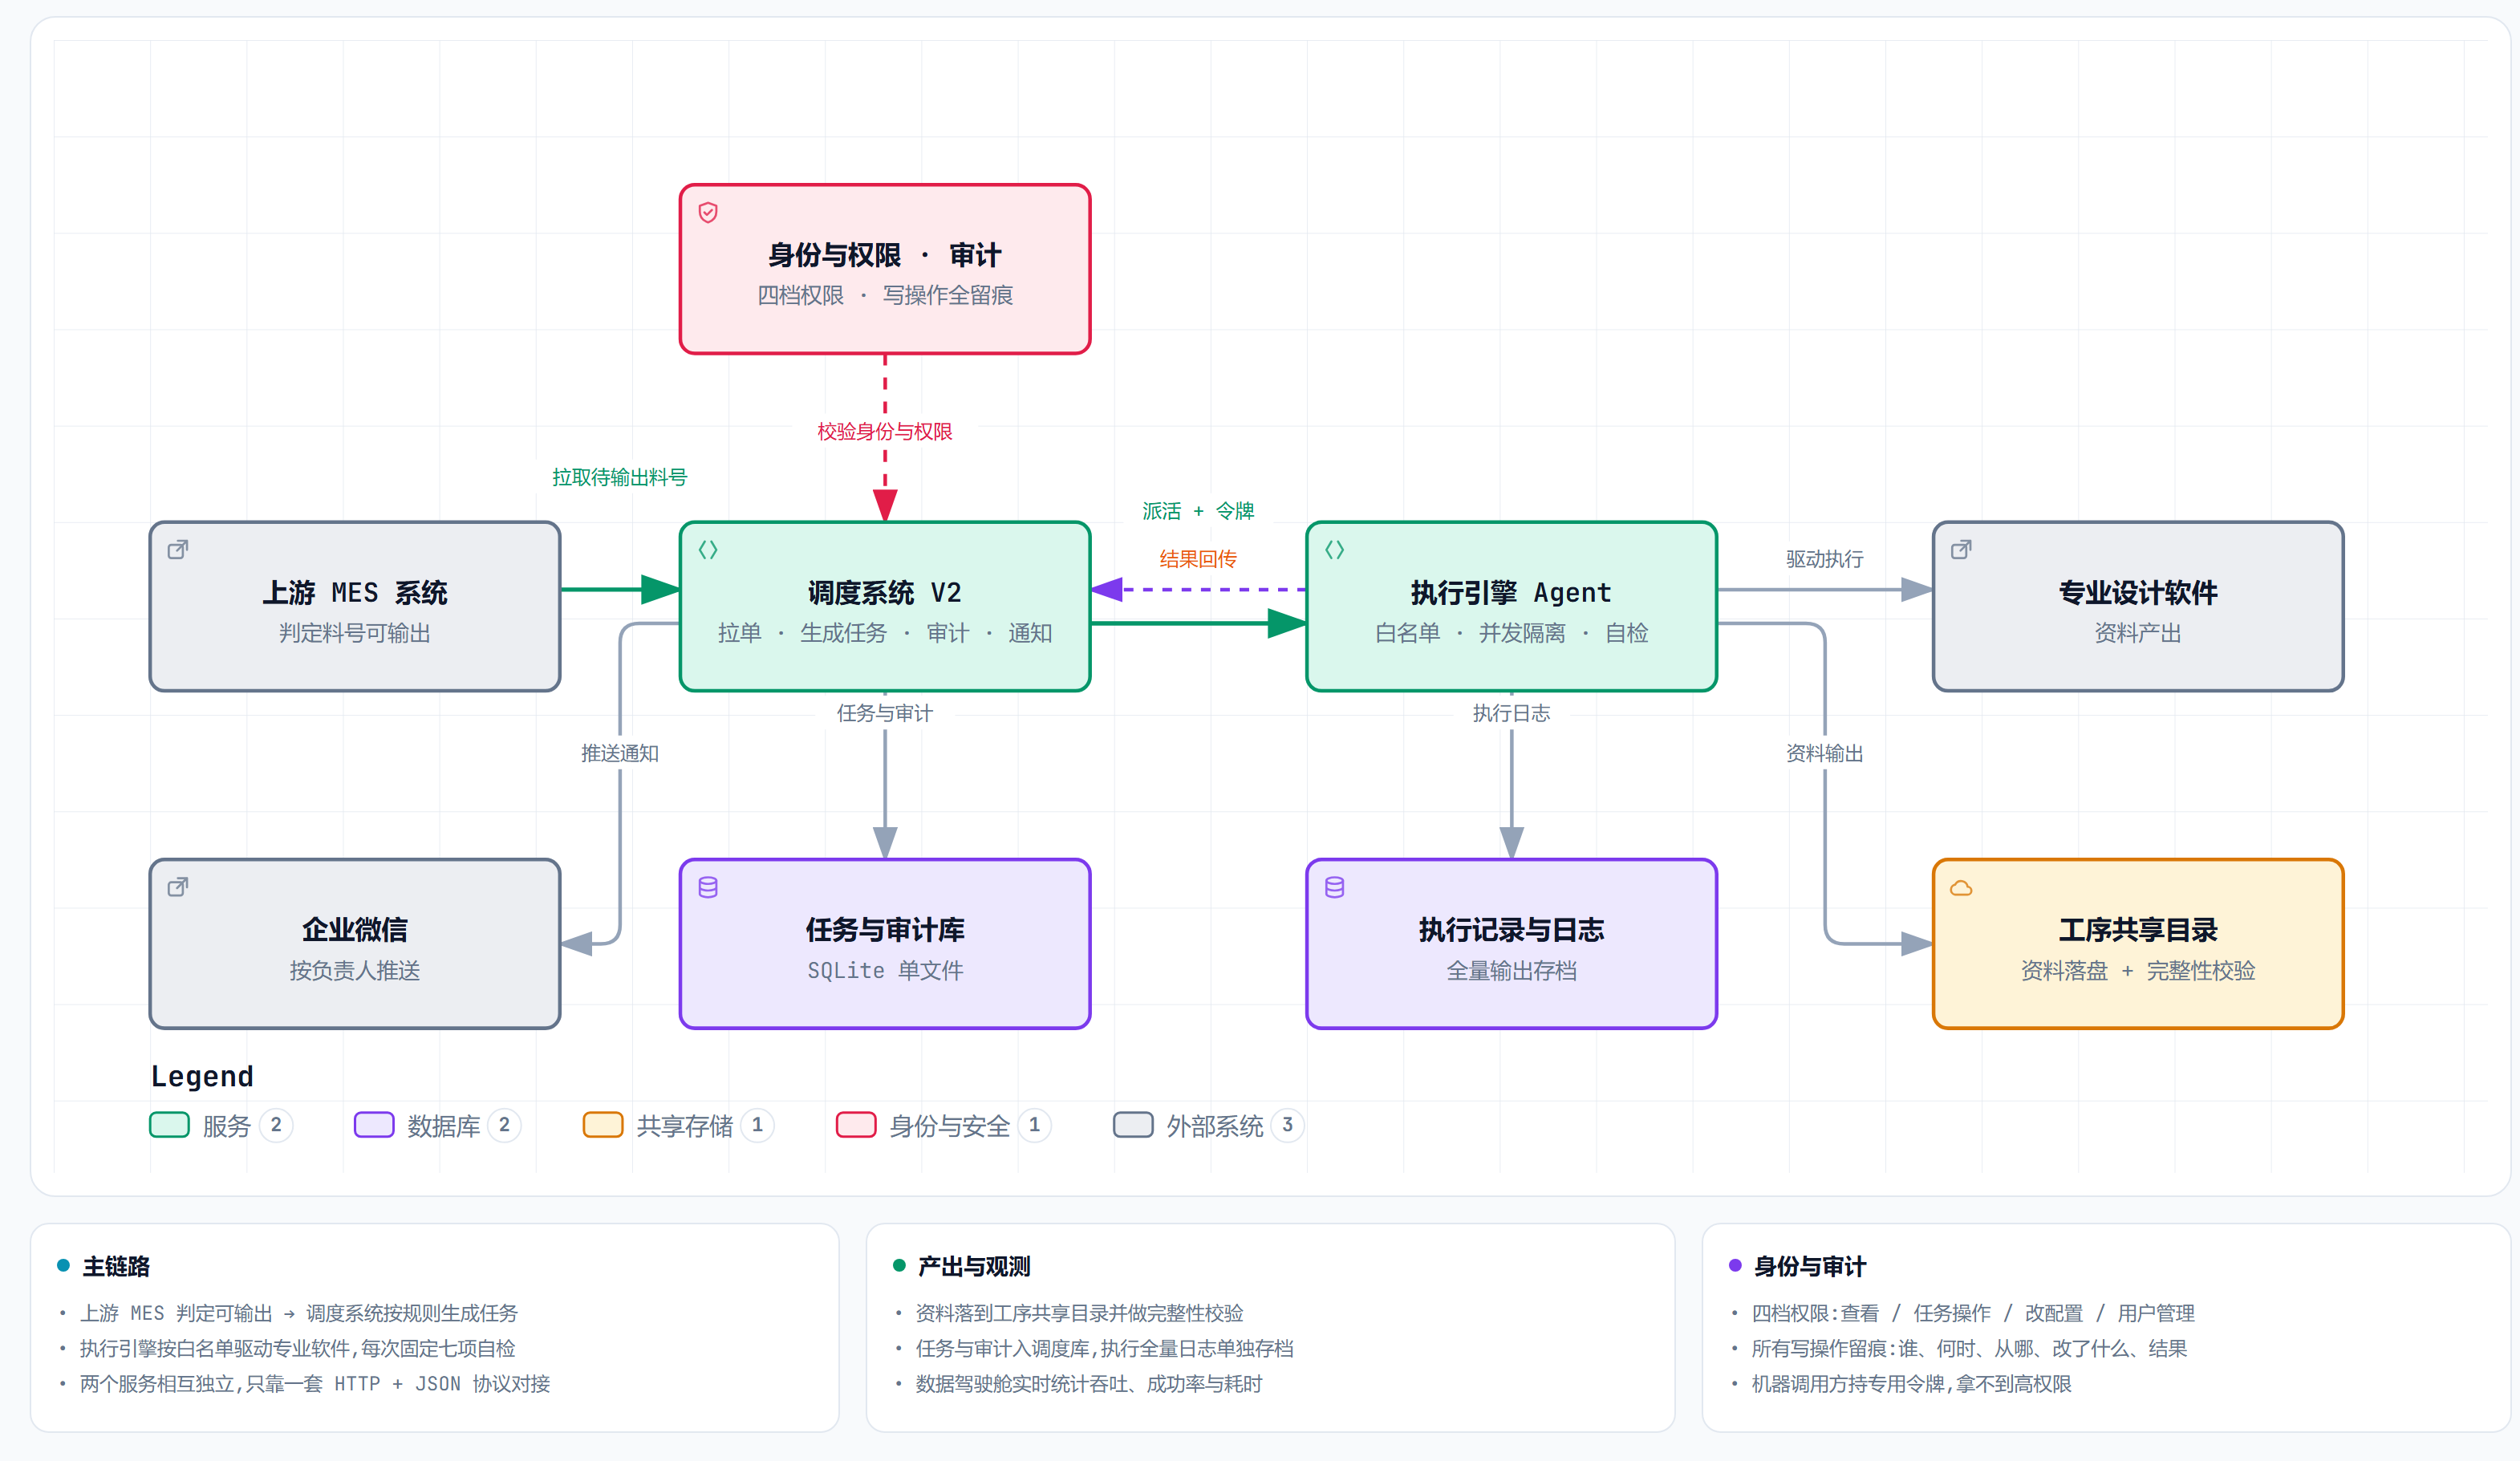
图 1:整体架构与数据流 ------ 从上游判定到资料产出,一条主线怎么走
1.2 技术栈与选型理由(以及它们的边界)
这里我不罗列技术名词,重点说清为什么这么选、边界在哪:
| 选型 | 为什么 | 边界(什么情况下要换) |
|---|---|---|
| FastAPI + SQLite 单文件库 | 单机规模、写入量不大(日均百级任务),SQLite 零运维、备份就是拷文件、查询统计都在本机完成 | 上多实例或高频并发写就得换 PostgreSQL;跨基地集中统计时还要考虑汇总库 |
| HTTP + JSON 标准化协议 | 执行引擎不认识任何外部系统,只认一套派活/回参协议 ------ 今天给这个系统用,明天给那个系统用,引擎不用改 | 需要强实时或大体量文件传输时,得考虑消息队列或对象存储 |
| 配置文件热加载 | 改配置不用重启服务,产线不受影响 | 需要"多环境配置管理"时,要引入配置中心 |
| systemd + cron | 两个服务加几个定时任务,运维成本极低;宕机自动重启 | 多基地部署时,需要统一编排 |
| 按任务隔离会话 | 每个任务独立 HOME 与显示会话,同时干几个也不会互相踩;许可证排队控制并发占用 | 并发上限受上游软件许可证约束,这是硬边界 |
【给工程师】一条设计原则
这套系统的每个"外部边界"(派活、参数、执行、回传)都是标准化的,所以每个边界都能单独替换而不影响其它部分。这是它能从"单基地试跑"走向"多基地复制"的前提。
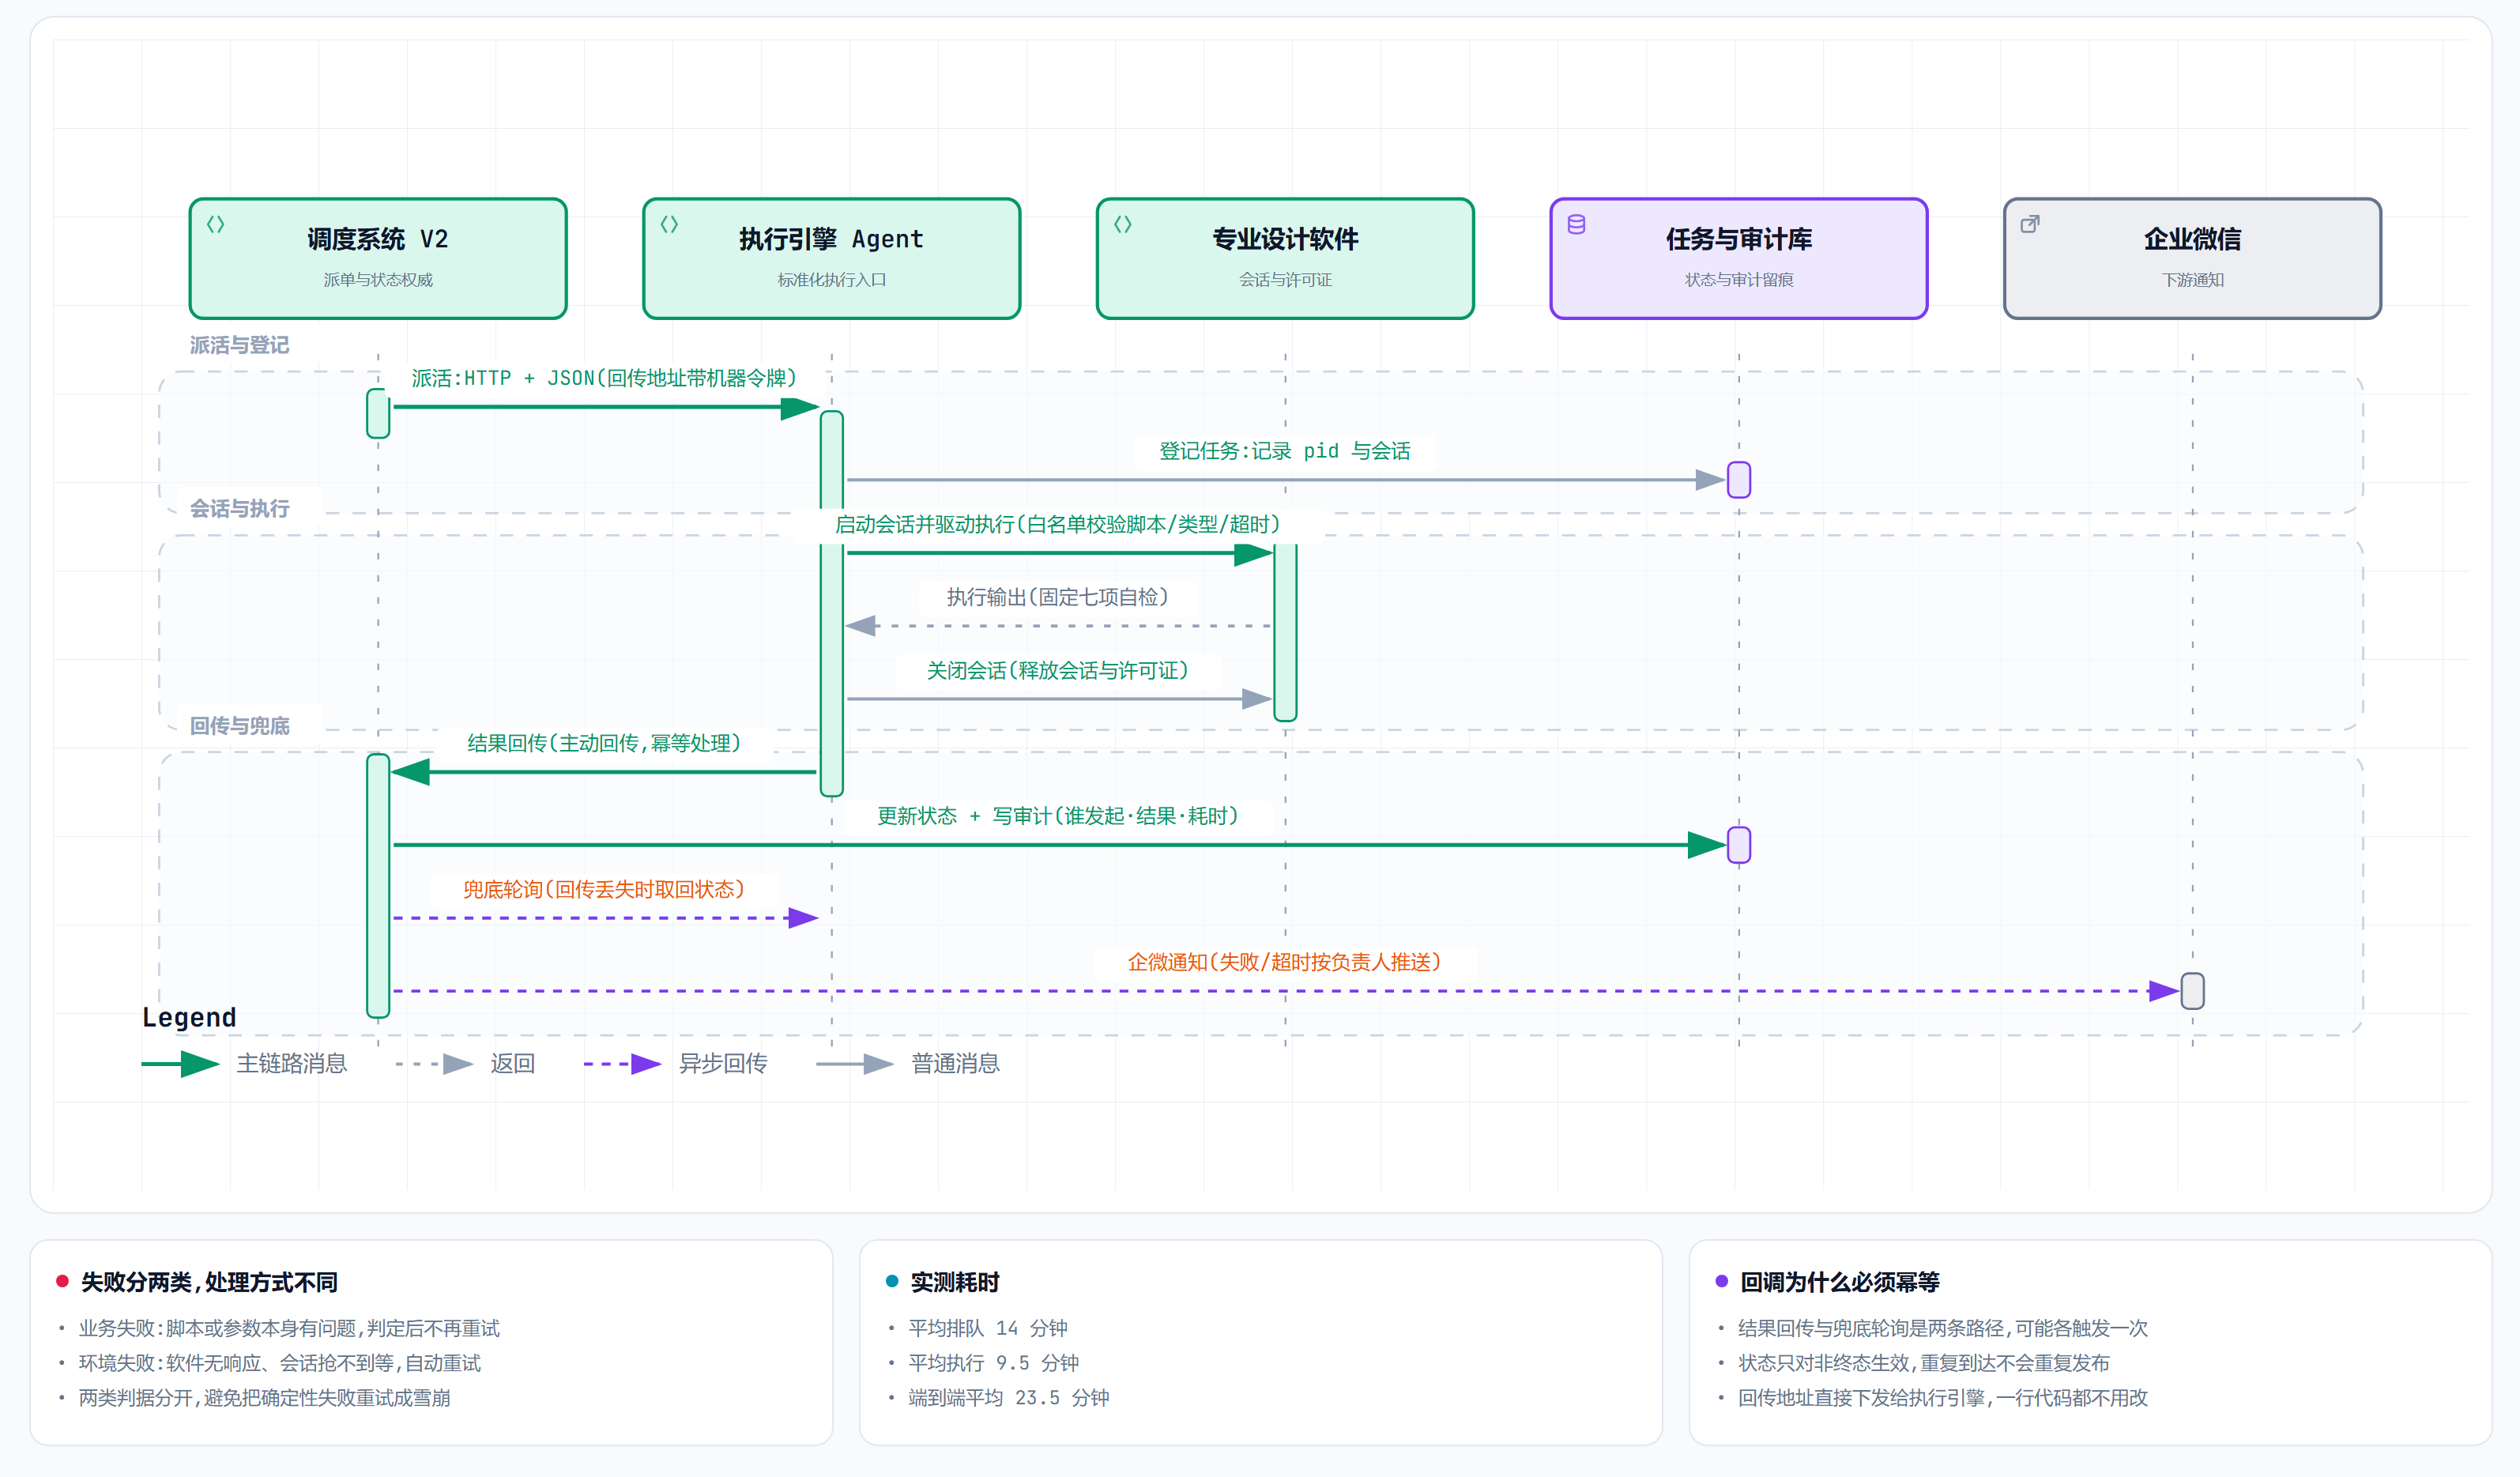
图 8:一次派活的完整往返 ------ 派活、干活、交结果、兜底、通知的时序
▶ 交互版(切明暗主题 / 滚轮缩放 / 按名字搜节点)
说白了,架构的价值不在用了什么技术,而在每个边界都能单独替换、单独验证。
2. 技术设计里的五个取舍
下面五个设计点,都是"看着有更简单的做法,我选了更麻烦的那条"。每个都写清问题、方案、为什么不选另一条、代价。
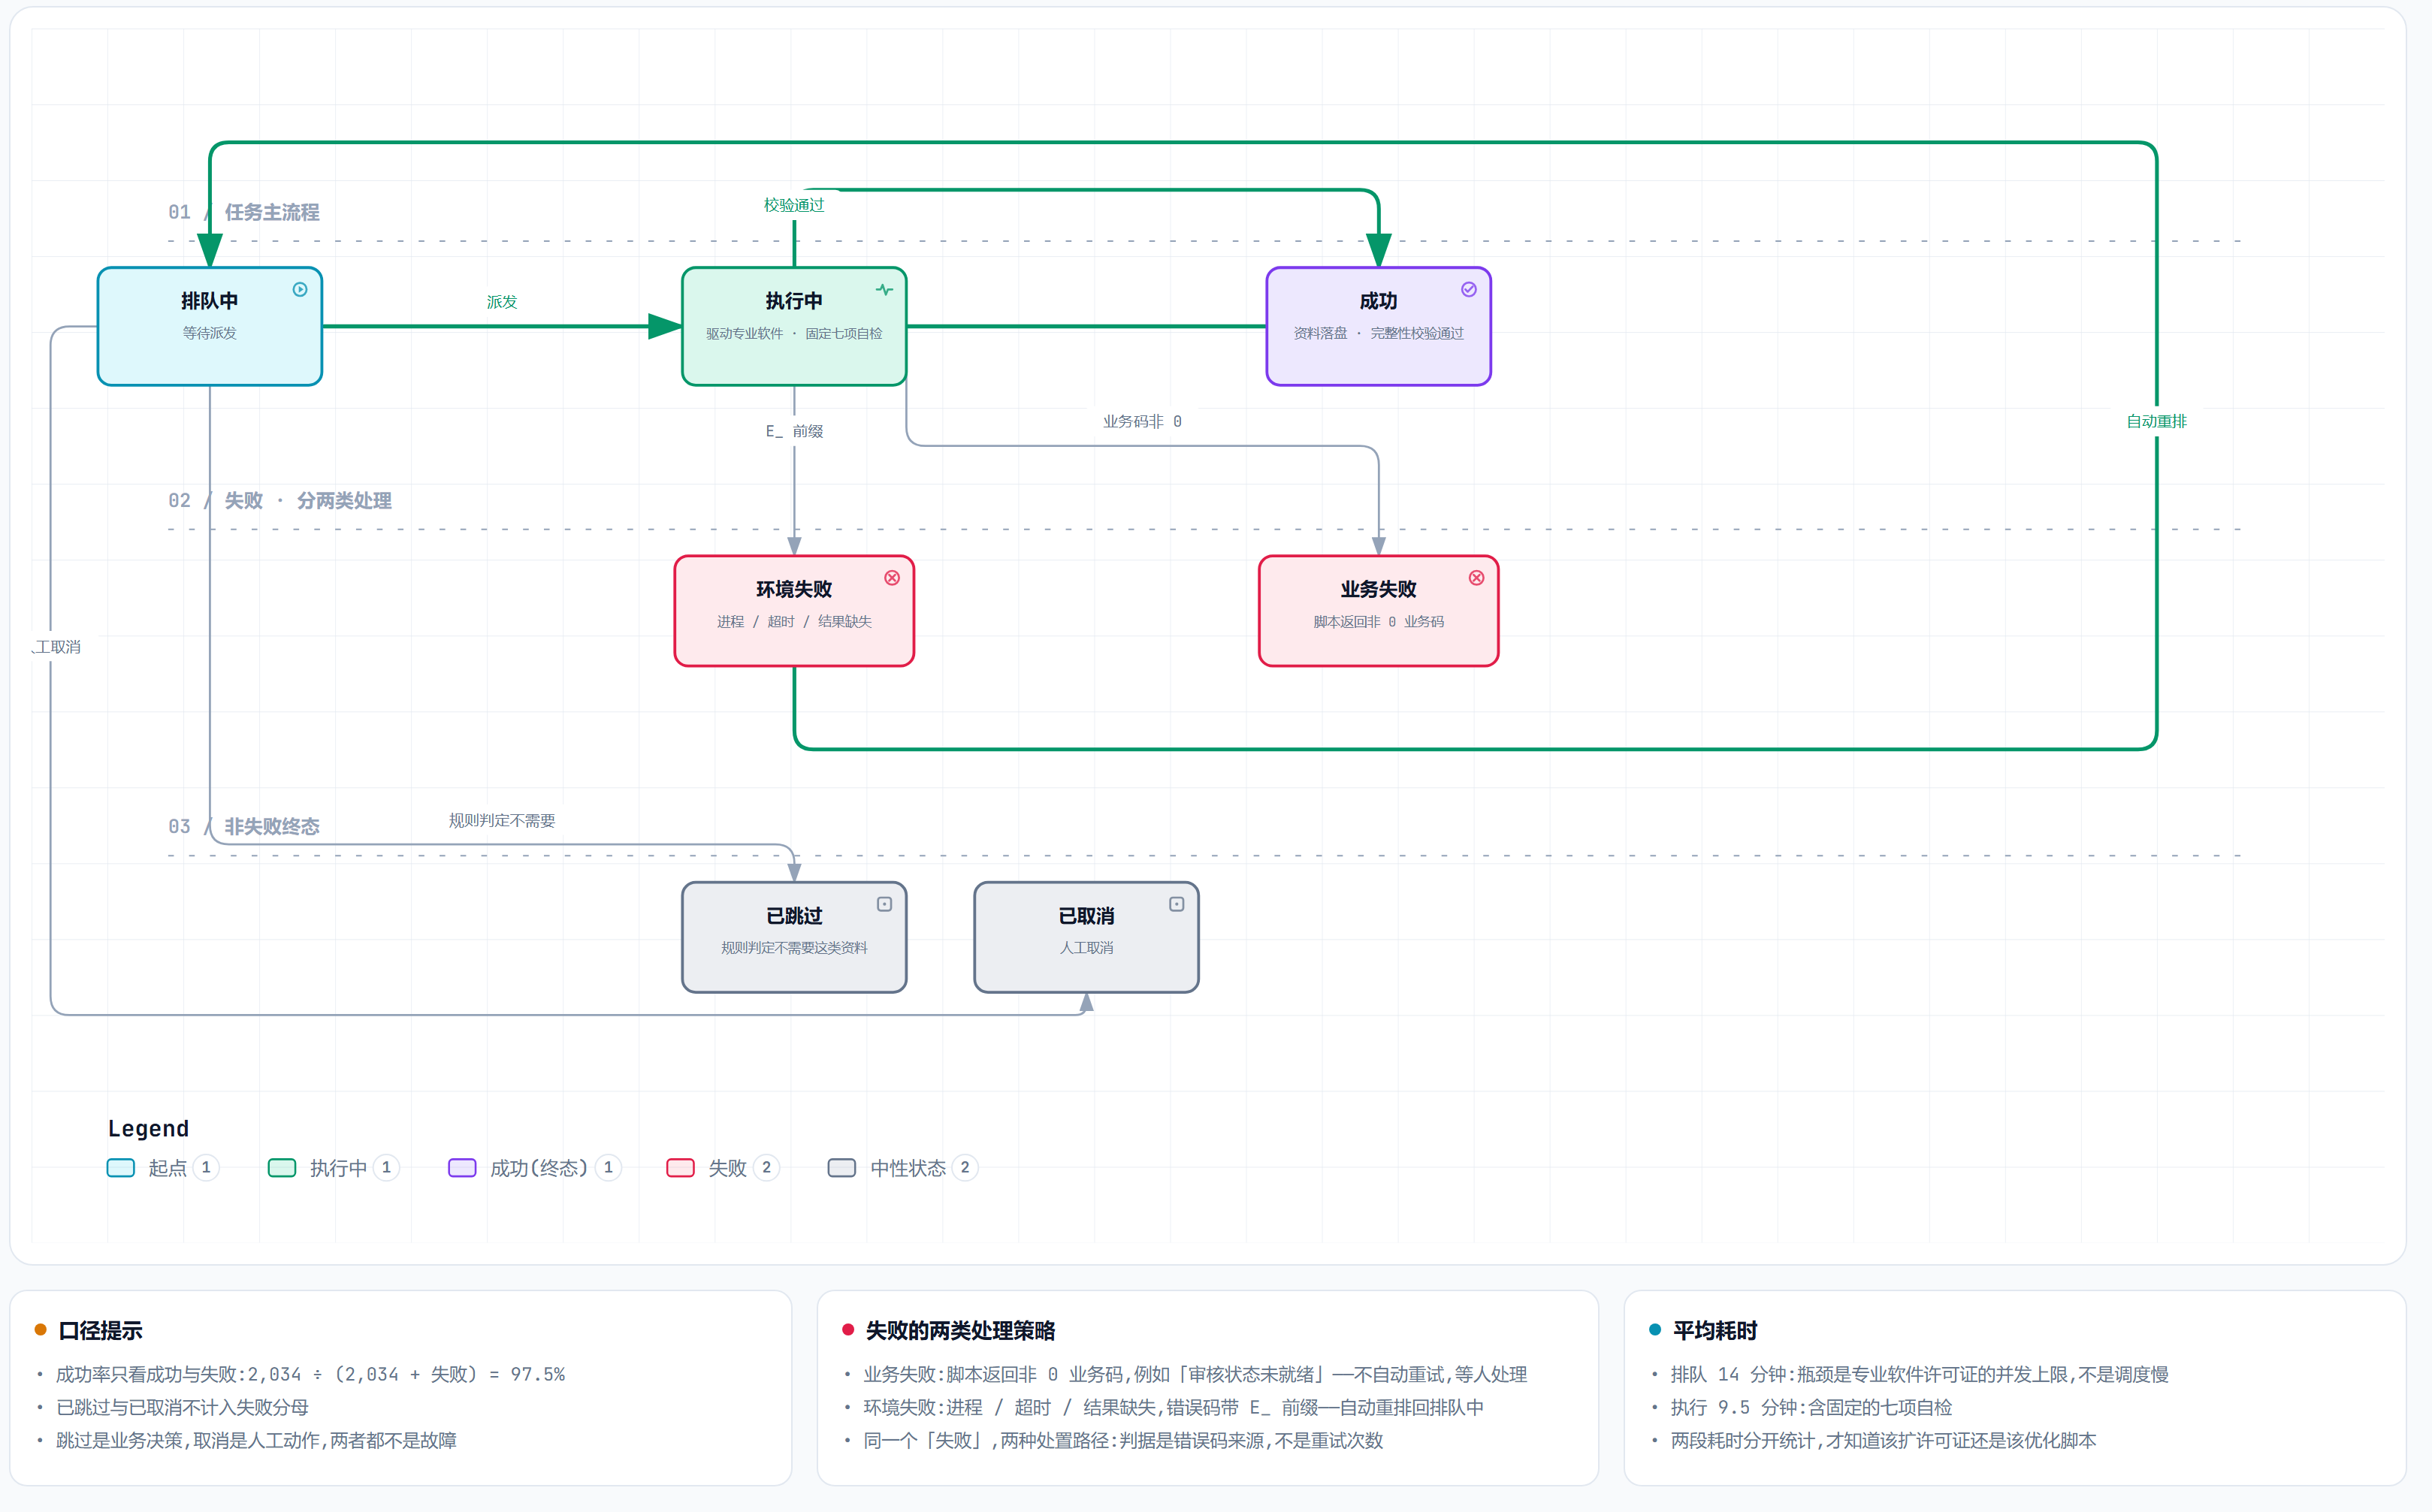
图 2:任务的一生 ------ 任务从排队到成功,中间经过哪些状态
取舍一:怎么判断"真卡死"和"只是算得慢"
问题 :执行引擎驱动的是桌面软件,会话可能真卡死(在等锁),也可能只是步骤多、算得慢。只按"多久没输出"判断,必然误杀慢任务。
方案:三路判据一起看------
- 心跳:调度循环每轮打点(哪怕闲着),回答"进程还在运行吗";
- 进展 :只在真有推进时更新(领到任务、有输出、子进程退出、写终态),回答"任务在动吗";
- 活动性证据:读这个任务进程树的 CPU 时间 + 会话日志文件的修改时间。
判定规则:心跳新鲜但进展陈旧,就先怀疑卡死;再看活动性证据,只要有一路在动,就判定"在算",继续等;两路都静止,才判卡死并清理。
为什么不选简单的 :单靠超时,会误杀慢任务;单靠心跳,抓不到"假死"。这一点我是实测过的:卡死的时候心跳一直新鲜,8 个任务挂了两个半小时,而巡检全绿。
代价 :每次判定多读几次 /proc 和一次文件 stat。换来的是生产环境 0 次误杀。
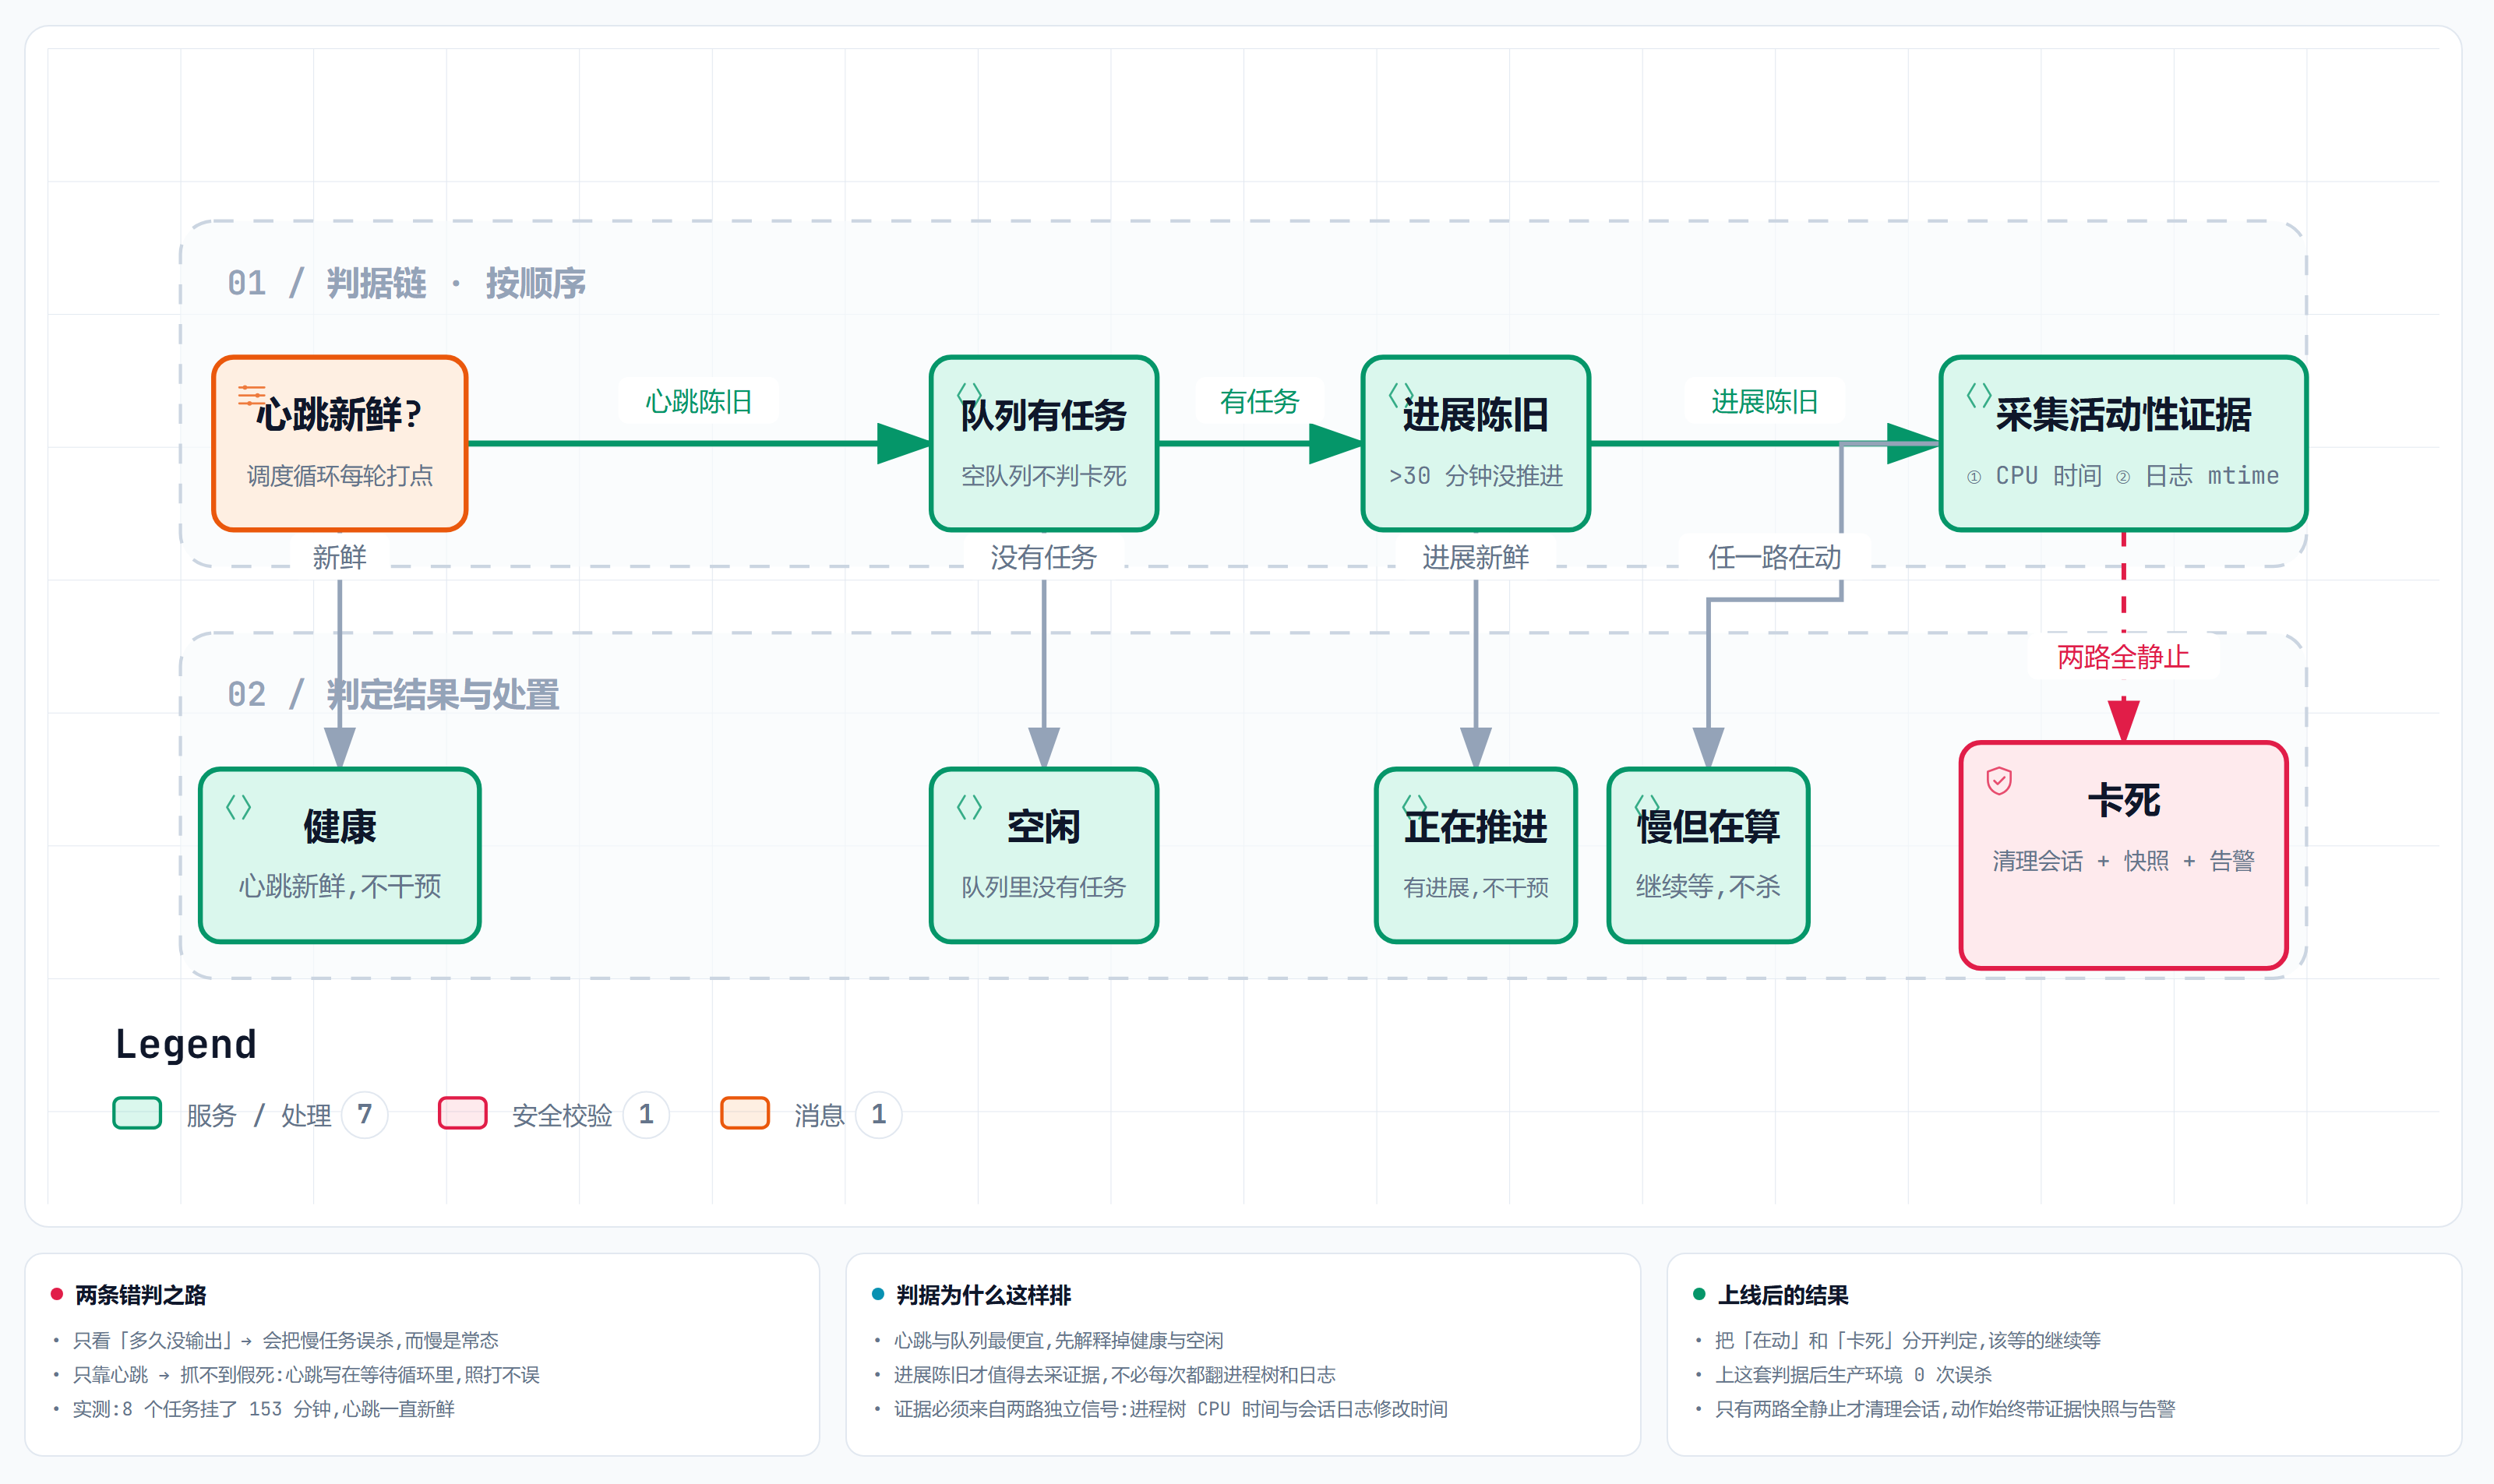
图 3:卡死还是只是慢 ------ 三路判据,怎么区分"真卡死"和"只是慢"
取舍二:权限为什么不写进令牌
问题:加了身份验证之后,权限放哪?
常见做法 是把权限写进令牌(无状态、校验快)。我没这么做 :权限每次请求都去账号文件现查。
原因 :权限写进令牌,就意味着撤销要等令牌过期才生效 (常规 12 小时)------实际上等于"撤不掉"。而现查的代价只是每次请求读一次小文件(带缓存)。撤权立即生效、停用账号立刻作废旧令牌,这两条对"能管住系统"的价值,远大于那点开销。
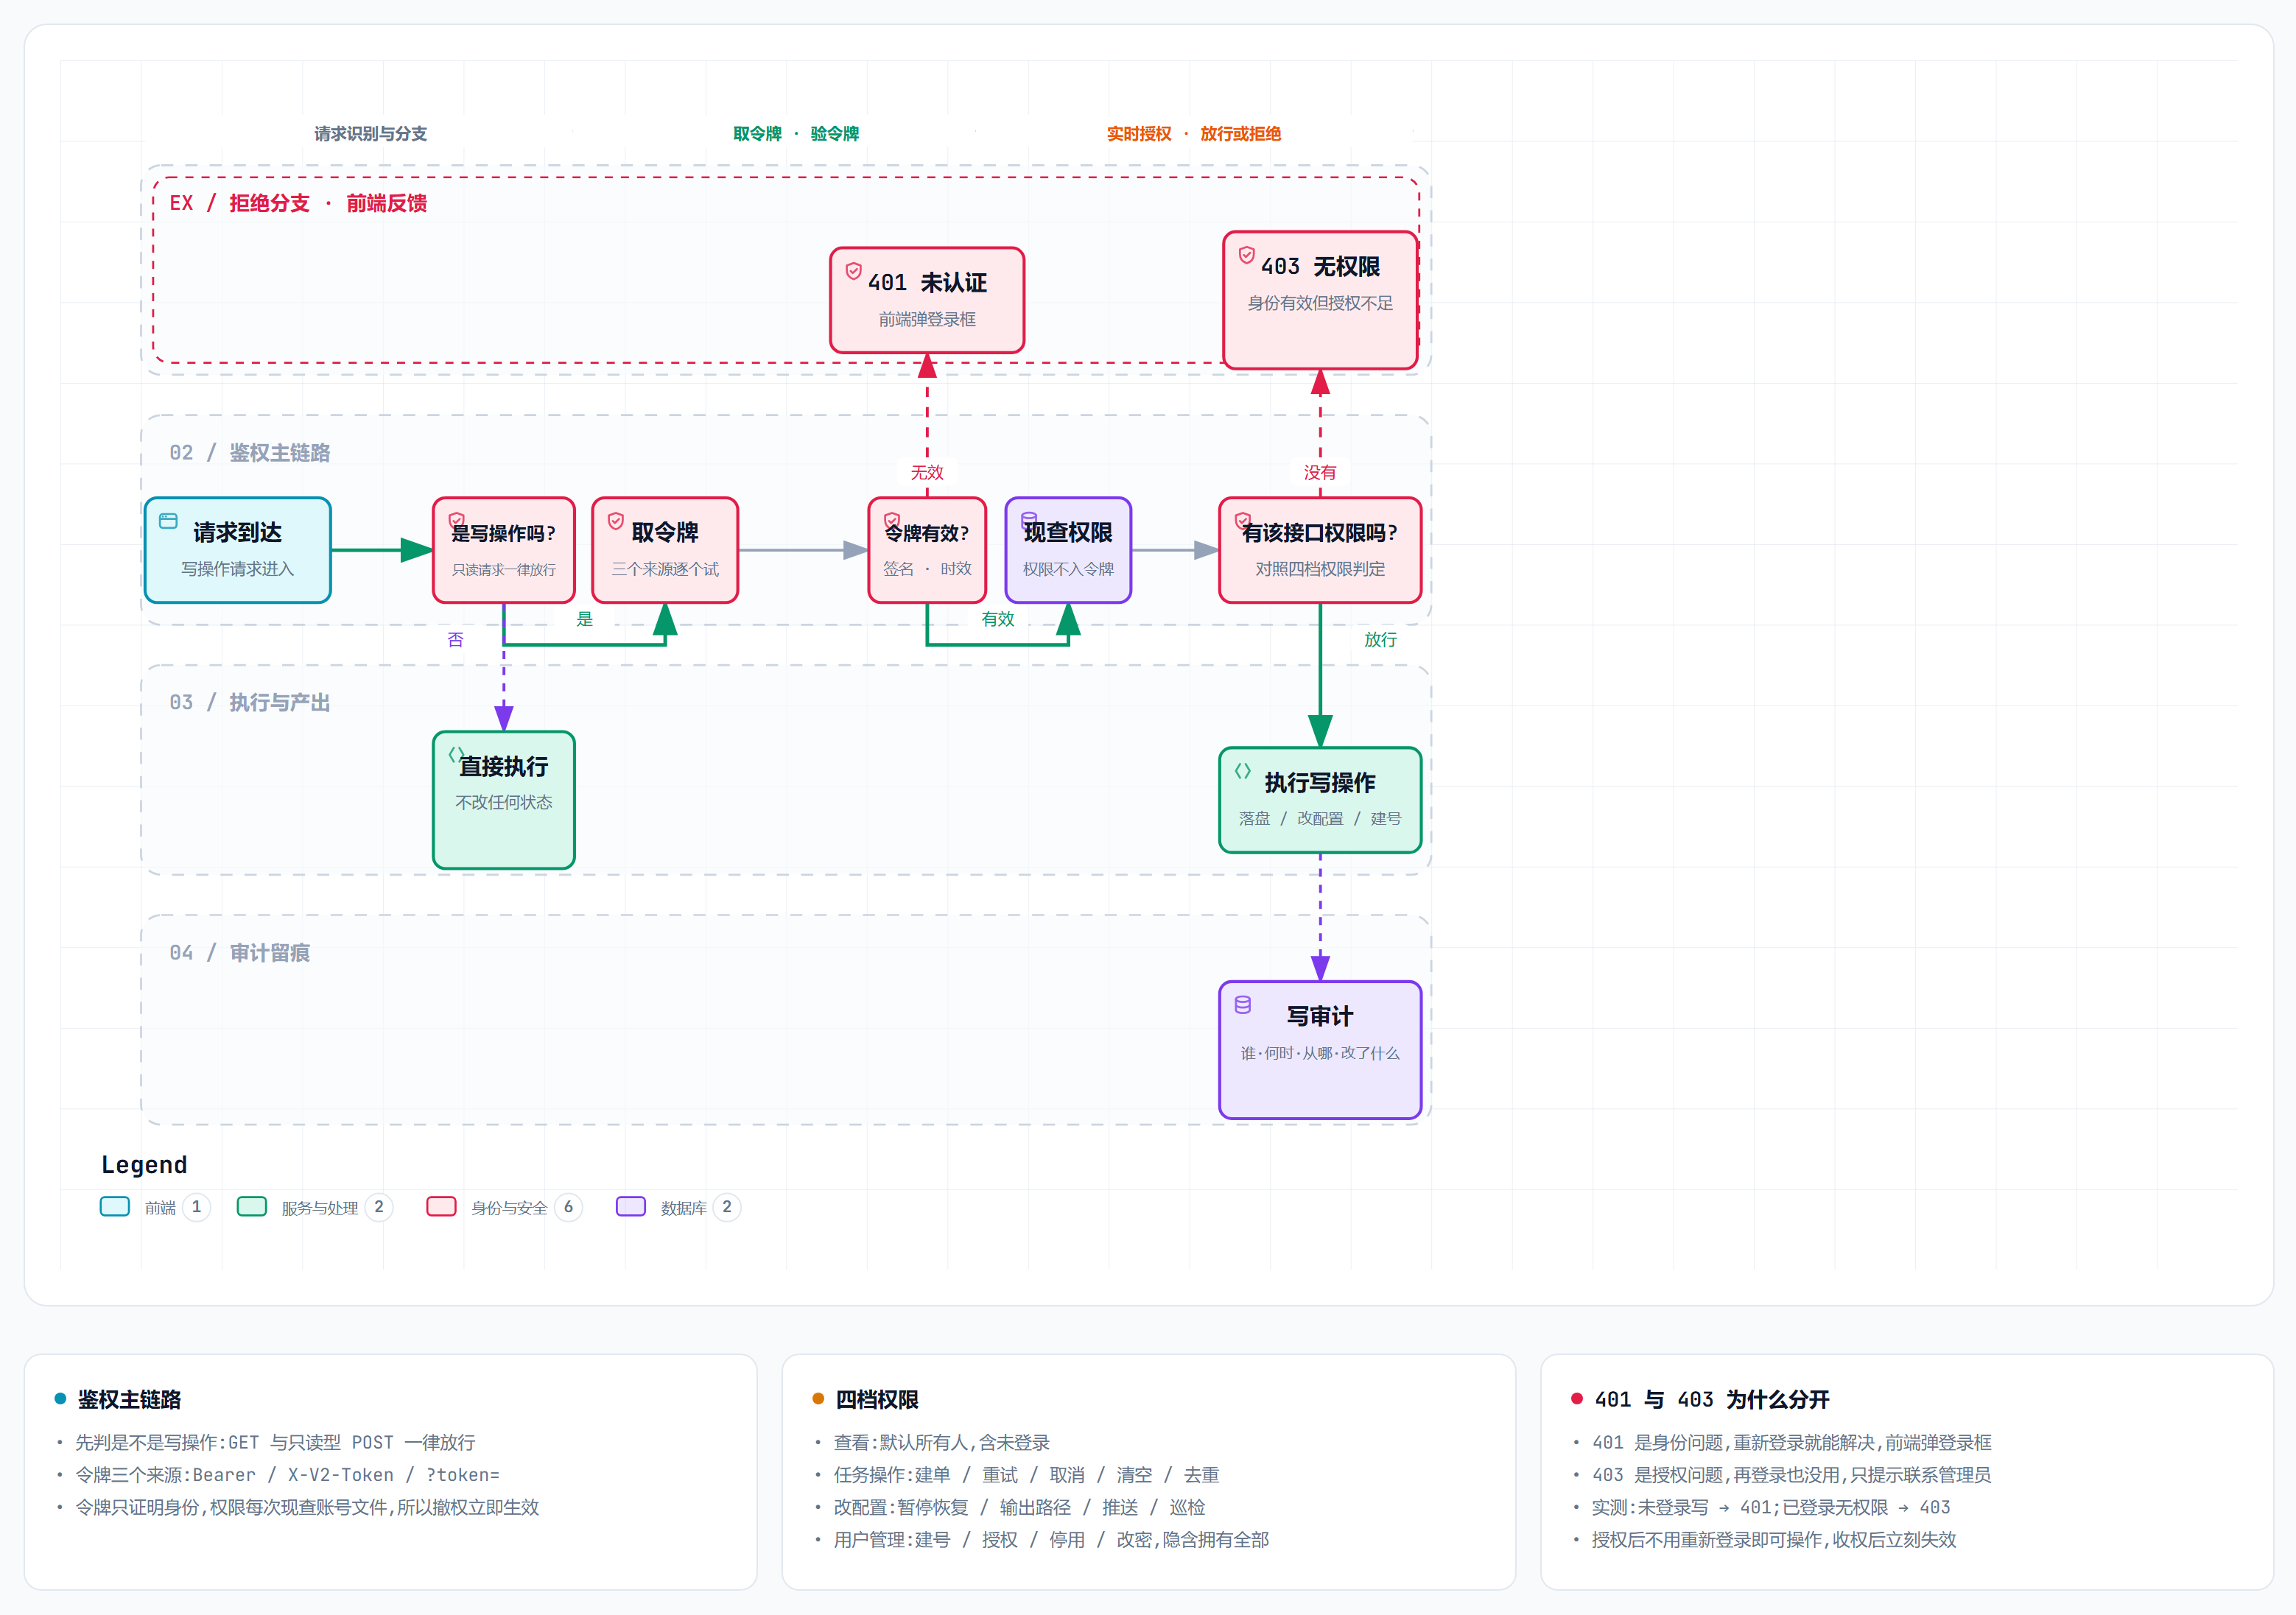
图 4:权限与鉴权 ------ 一次操作要过几道关;"没登录"和"没权限"为什么分开
取舍三:审计为什么要记"改前→改后"
问题:出了事,要能回答"谁把什么改成了什么"。
方案 :中间件统一拦截所有写操作;对配置类写操作,请求前后各取一次配置快照,逐项比对,把变了哪几项、前后各是什么值存进审计。
为什么不选"记一句描述":写"改了配置"等于没记。实测记出来是这样:
config-change  操作人=张工  人类身份  已校验  /api/executor/pause
detail = 配置被改动: executor.paused: False → True
代价 :写操作多两次小文件读取。收益:事故定位从"猜"变成"查"。
取舍四:库体积治理,先量化再动手
问题 :数据库涨到 4.68 GB ,而且它在系统盘 上(当时只剩 25 GB)。很多人第一反应是"数据盘还有几十 TB,不怕"------可这个库根本不在数据盘上。
先量化再动手。实测:库体积的 99.2% 来自一个字段------脚本的输出日志,同一份内容既写数据库又写日志文件,库里那份纯属重复。
处置:库里只存首尾各 8KB 的摘要 (全量仍在日志文件);存量数据归档(先归档、逐字节验证、才清字段,绝不删行);再加四项看护(体积、日增速、机制是不是被关了、摘要是不是真在生效)。
结果:全库投影 −77% ,日增从 178 MB 降到 41 MB/天。
一个反直觉的地方 :清空字段以后,库文件不会立刻变小 (空闲页会被后面的写入复用)。正确预期是"先停止增长,再找机会收缩"。
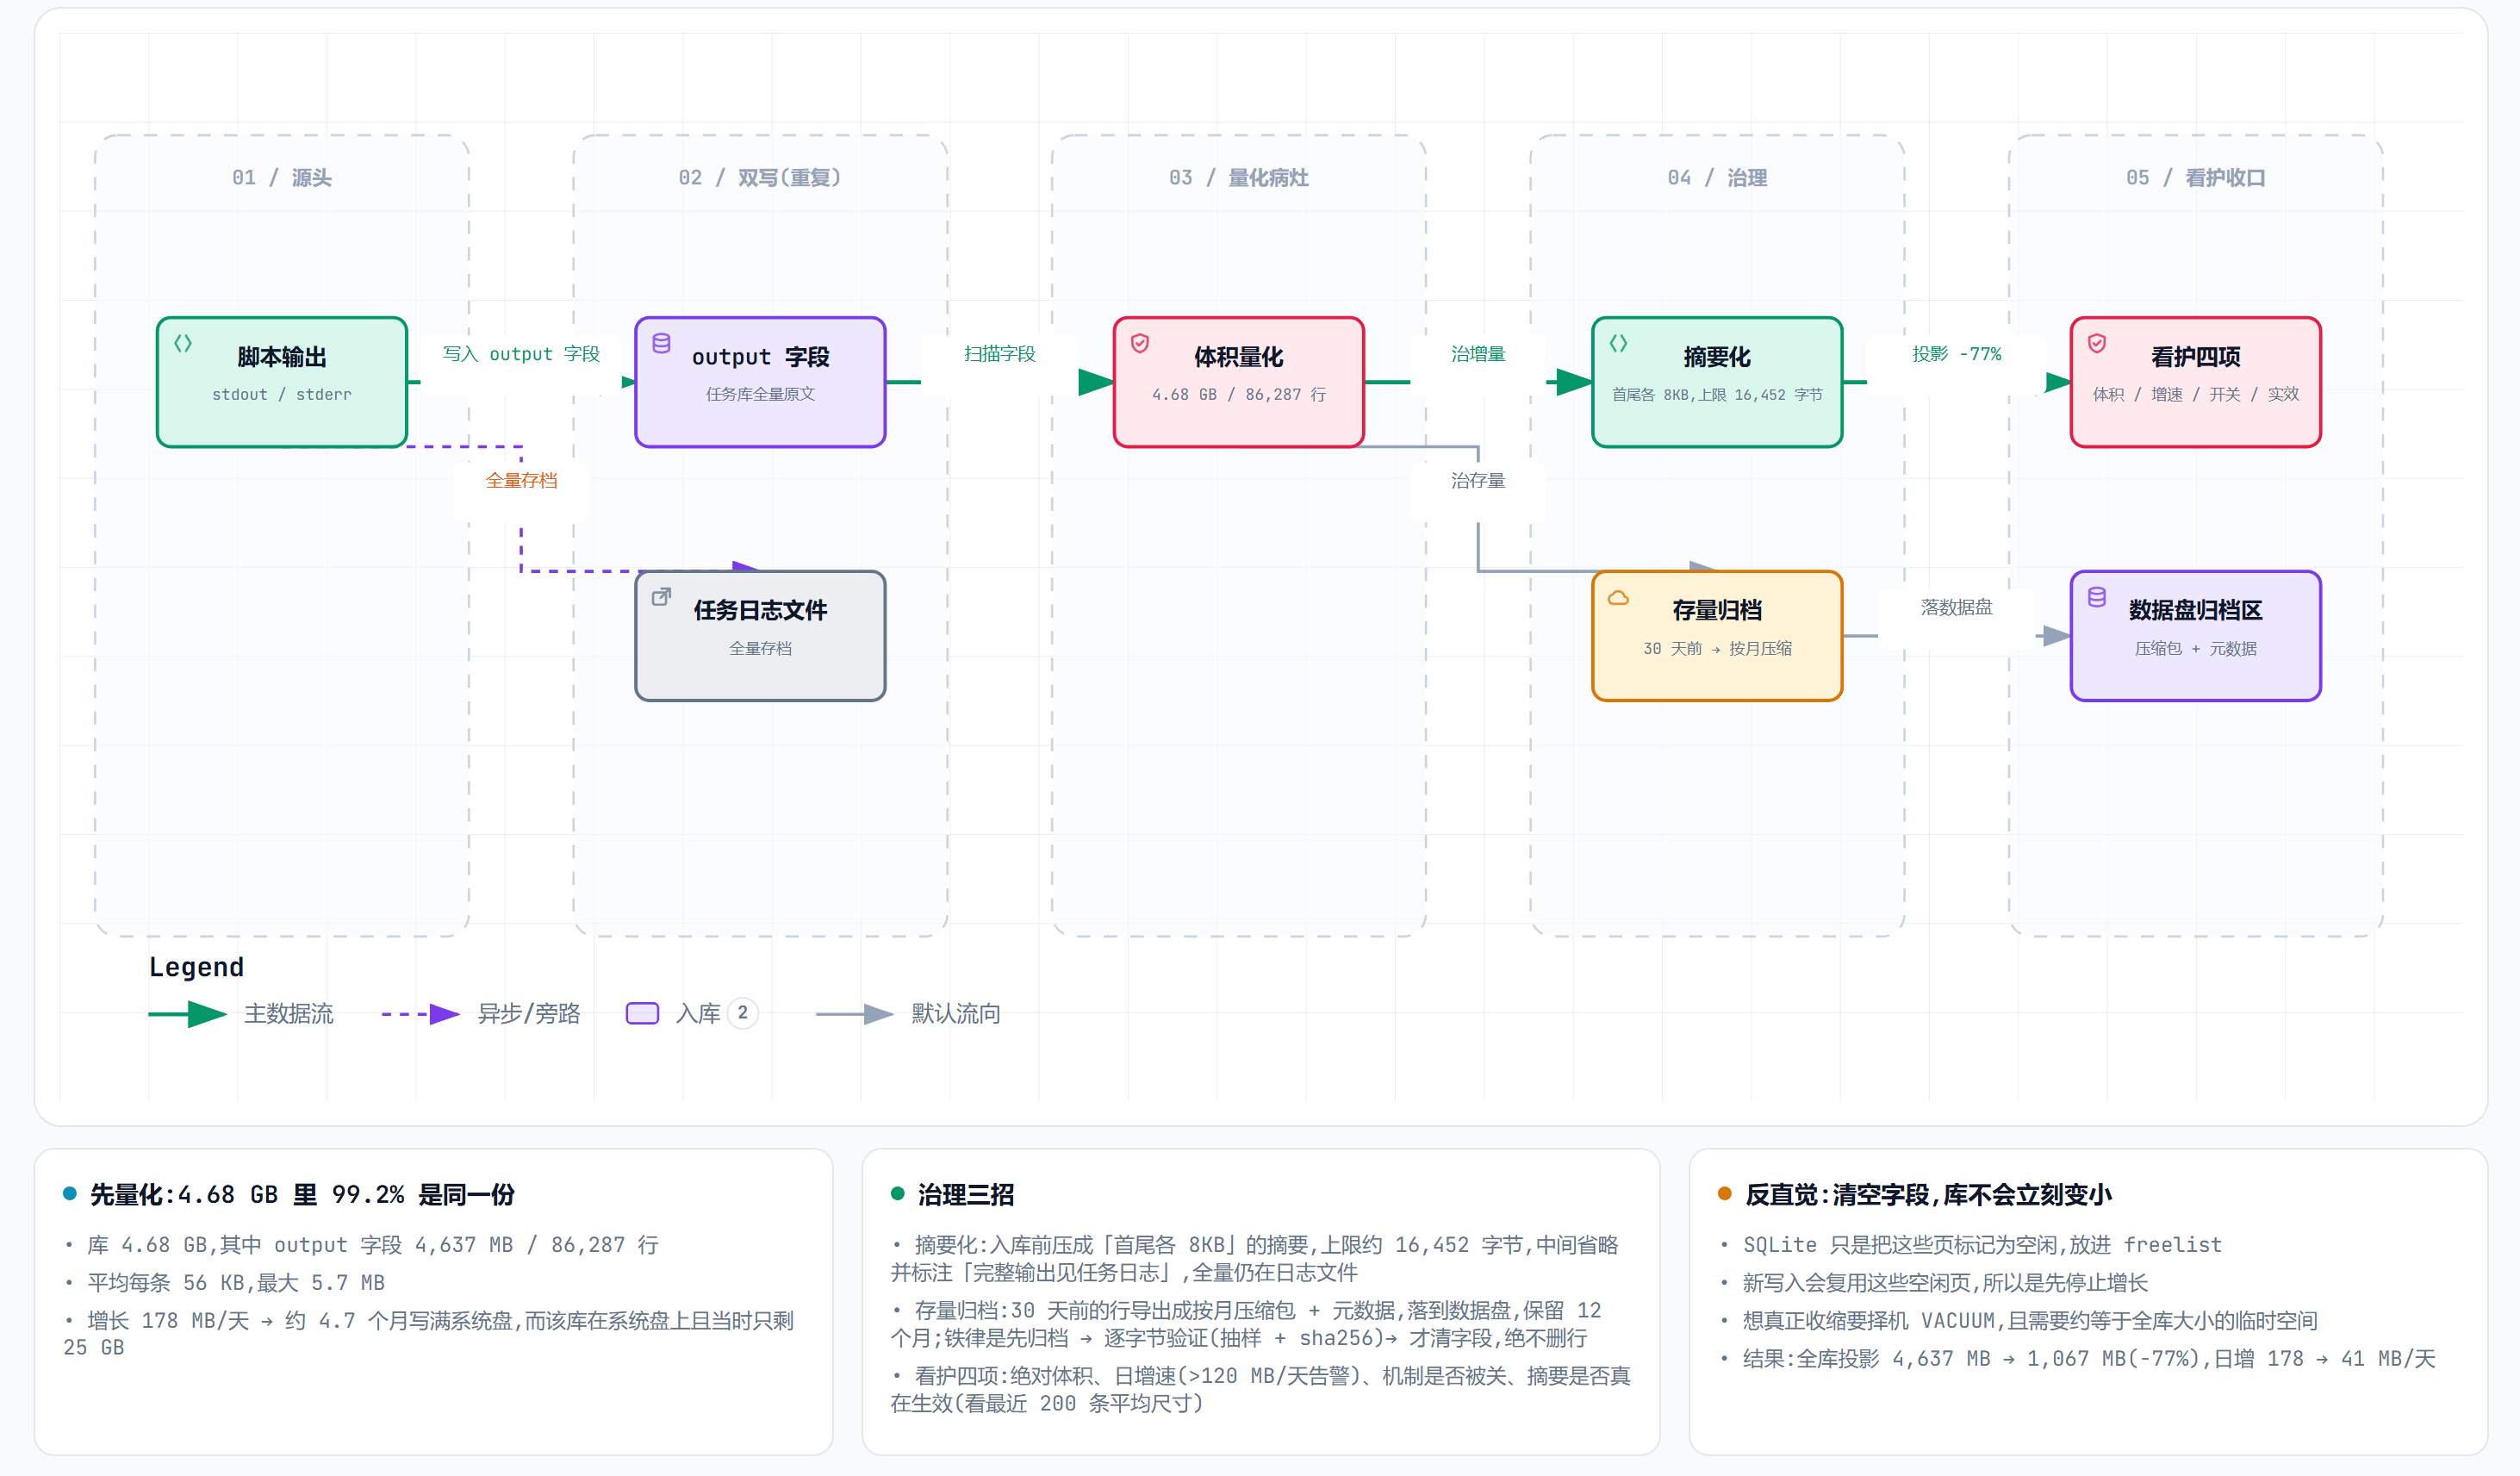
图 6:库体积治理 ------ 数据库从 4.68 GB 瘦下来的过程
取舍五:上线为什么要"开关灰度 + 热加载回退"
问题:给生产系统加鉴权,怎么保证不打断产线?
方案:分三步走------
- 先发身份,不拦请求:代码上线,但强制开关关着,只记录不拦截;
- 接通机器调用方 :执行引擎的结果回传接口每天被调用上万次,它必须持专用令牌(这把令牌拼在派单时下发的回调地址里 ,执行引擎一行代码都不用改);
- 最后才打开强制开关:确认机器那条链路没断,再开拦截。
回退 :强制开关放在配置里、热加载生效------改回 false 秒级生效,不用重启服务。
说白了,我敢改产线,是因为我每次都给产线留了"一秒退回去"的路。
3. AI 应用能力:我怎么用它
这一节是全文的重心。
3.1 分工原则
| 我负责 | AI 负责 |
|---|---|
| 定义问题、说清"要什么"和"为什么" | 把需求变成能跑的东西 |
| 定业务规则(什么情况该干、什么该跳过、什么是失败) | 查清现状、指出风险、给出方案与顺序 |
| 判断对错(结果符不符合现场实际) | 写完自己跑验证,拿输出说话 |
| 决定能不能动产线、什么时候动 | 查线上故障、翻日志和数据库找根因 |
| 决定哪些数据和信息能对外说 | 改完留备份、给回退命令、写文档、部署 |
我一行代码没写过,但我也从不"提完需求就等结果"。业务规则错了它看不出来;哪条数据能公开、哪个改动敢上产线,只有我能定。
3.2 完整案例:一句话需求,到上线的权限与审计体系
事情的起点很小。 有一天系统莫名其妙停了三个多小时,我想查是谁停的,结果翻遍日志只查到一个 IP 地址,查不到人。于是我的要求特别朴素,就一句话:
"我需要所有人为操作都可查明白。"
AI 的第一步不是写代码,是查现状。 它把所有能改状态的接口列了一遍(21 个),发现一个都没有身份验证 ;又发现"操作人"只是浏览器里一个可填可不填、还能乱填的输入框。基于这两条,它才告诉我:要实现"可查明白",得先解决"身份由谁定义"。
第二步是给方案分档。 它给了三档让我挑:轻量的靠大家自己填名字,只能防误操作;中等的后台建账号、发登录凭证,由服务端认人;最重的对接公司统一身份。我选了中间那档------对当前场景够用,也不引入额外依赖。
第三步是风险前置和上线顺序。 这一步我印象最深:它主动指出不能直接开强制验证,因为有一个每天被调用上万次的机器接口(执行引擎回传结果用的),先开会当场打断这条链路。于是给了顺序:
① 先发身份,不拦请求
② 给机器发专用令牌
③ 确认机器链路没断
④ 最后才打开强制拦它说"先给机器发钥匙"的做法,我印象更深:干活那个程序的回传地址,本来就是派活的时候发给它的。钥匙直接拼在这个地址上就行,那个程序一行代码都不用改。这比"去改一个独立服务、重启、回归测试"省太多事了。
第四步是动手,每一步都留退路。 每个被改的文件旁边都留了带日期的备份;改完立刻做语法校验;改完一处就重启服务、拿真实接口跑一遍,把返回值贴出来。到今天,我仍然可以一条命令把系统退回改动之前。
第五步是它自己纠错。 整个过程它至少错了三次:一次是做了个"一键清理临时脚本"的功能,写完忘了接到主流程上,跑起来像"什么都没干"------它是靠核对结果 发现的,不是觉得"应该好了";另外两次是改一份文档,连续两次没改进去(锚点找错了)。但它把这段逻辑做成"全部成功才落盘 ",所以每次失败,那份文档一个字都没动,不存在"改了一半"这种最难查的状态。第三次才成。
第六步是自动收尾。 上线之后,它把新增的能力写成文档的一整章(带实测数据);把三份文档同步到三个地方,还核对了校验值;顺手给界面加了个"文档"入口。这些事它一件都没问我要不要做,是当成"事情该收尾了"自己做完的。
最后我做了验收,用的都是最直接的动作:
| 验收动作 | 结果 |
|---|---|
| 用未登录状态执行"暂停系统" | 被拒绝 |
| 用已登录但没授权的账号执行同类操作 | 被拒绝,并明确提示"请联系管理员授权" |
| 管理员给该账号勾上权限后(不重新登录) | 下一次操作就能执行 |
| 管理员再把权限取消(同一登录状态) | 立刻又不行了 |
| 查审计记录 | 能看到"谁、何时、从哪、把哪个配置从什么改成了什么" |
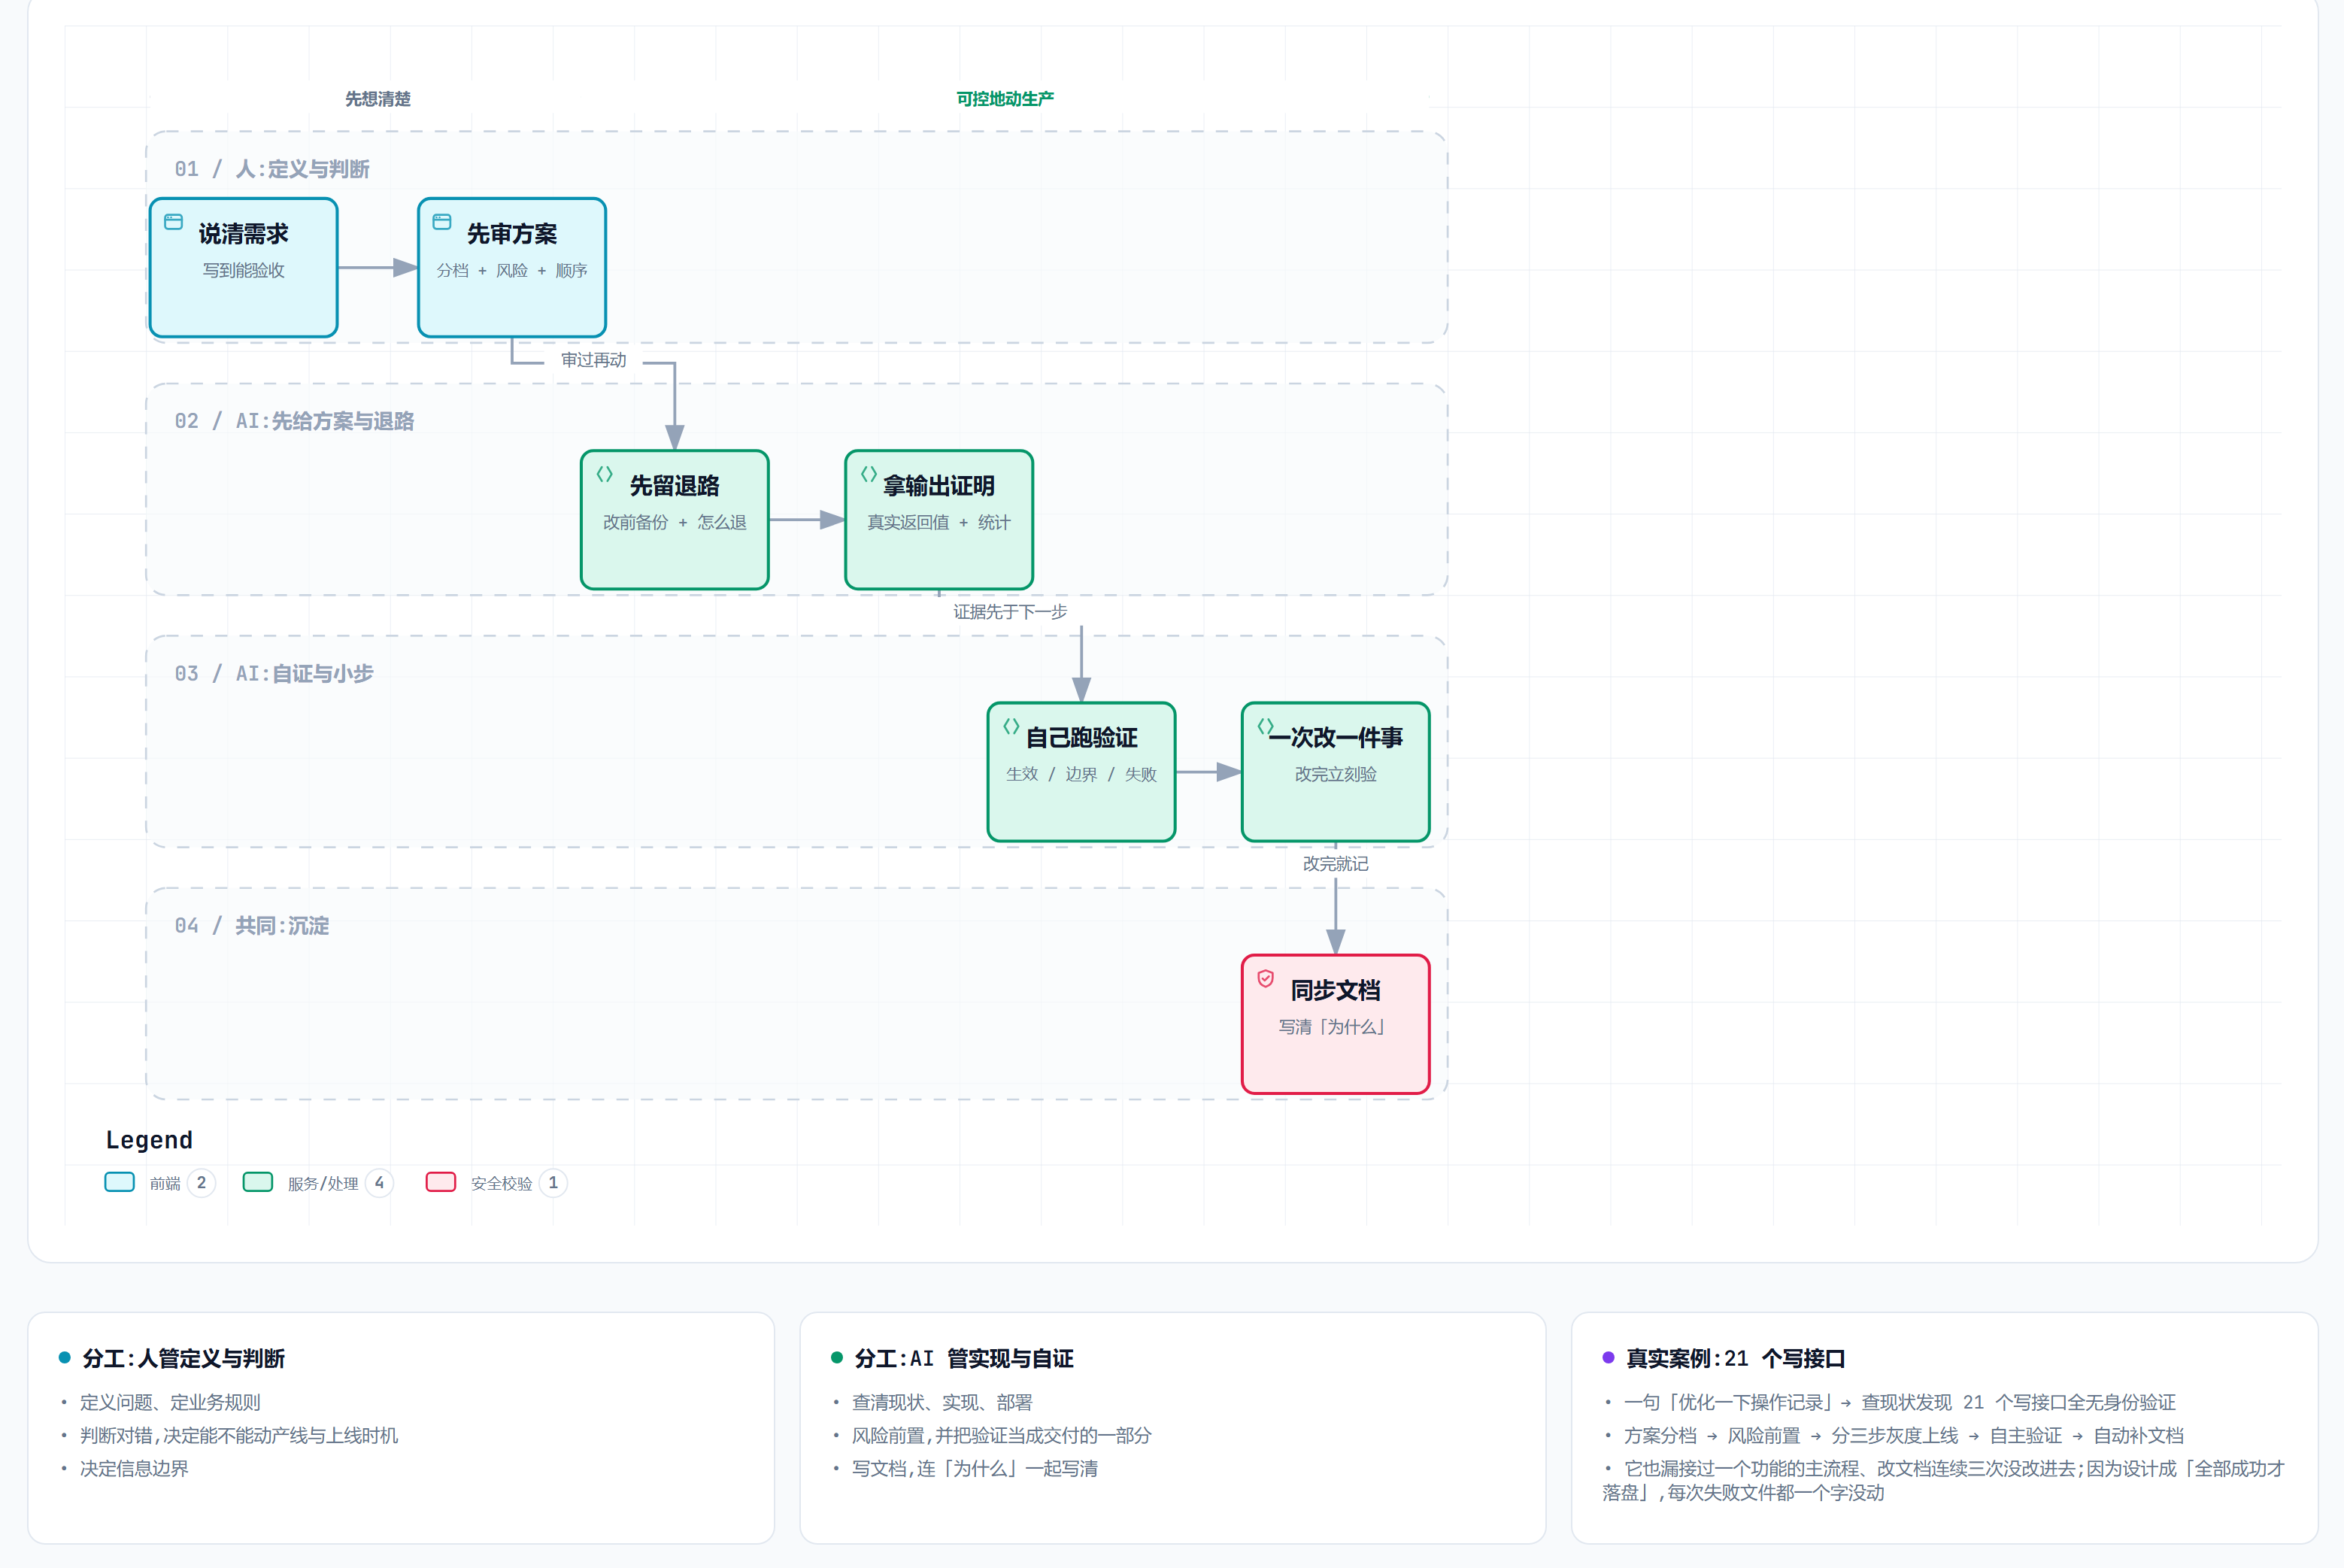
图 5:AI 协作的 7 条纪律 ------ 人机分工 + 7 条纪律,配我踩过的例子
3.3 我立的 7 条纪律
这是我最想让同行看到的部分------AI 的产出质量,取决于你给它立了什么规矩:
-
要求要说到"能验收"的程度。
别写"优化一下操作记录",要写"所有人为操作都要能查到人,还要能查到改了哪个配置、从什么改成什么"。前者它只能猜,后者它知道做到什么算完。
-
先要方案和顺序,我点了头再动手。
让它先给"现状 + 方案分档 + 风险 + 上线顺序",我审完再执行。跳过这一步,很容易得到一个"技术上没错、但会把产线搞停"的改动。
-
一律要求"能退回去"。
改前备份,还要明确告诉我"怎么退"。我现在能把系统里任何一处改动一条命令退回去------这是我敢让它动生产系统的唯一理由。
-
只认"拿输出证明",不认"应该没问题"。
改完必须跑真实接口、贴出返回值、给出数据统计。"我觉得改好了"在我这儿不算完成。
-
让它自己跑验证,而不是只交代码。
我会明确问:这个改动你怎么证明生效了?边界情况怎么验?失败路径怎么验?它会自己造不同的输入去试(包括故意制造失败),再把结果贴给我。
-
一次只改一件事,改完立刻验。
改一处、验一处。同时改五处,出了问题你不知道是哪一处的锅。
-
让它写文档,而且要写"为什么",不只写"是什么"。
不写的话,知识就留在对话里,对话一关就丢了。现在我的三份文档(学习手册/速查手册/引擎文档)都是它在维护,每处改动都会同步校验。
其中一份就是整个系统的知识图谱 :从整体架构、每个模块的机制,到身份权限、故障复盘,一共 40 页、9 个板块 ,页内能搜、能跳。《无人值守系统V2 · 知识图谱》
说白了,我是把 AI 当"执行工程师"用,不是当"查询工具"用。差别就在上面这 7 条。
4. 工程纪律:为什么 AI 的产出敢上产线
很多人对 AI 写代码的顾虑是"看着对,不敢用"。我的办法是用工程纪律把这个风险压下去。这套纪律对人工开发同样适用,只是有了 AI 之后更容易走形式,所以更要立死。
| 纪律 | 具体做法 | 我为什么坚持 |
|---|---|---|
| 改前必留备份 | 每个被改文件留带日期的备份,改动清单可查 | 出事时不用靠记忆还原 |
| 落盘前必过校验 | 语法/结构校验通过才写盘,不通过直接中止 | 宁可不动,不要改坏 |
| 失败不留残渣 | 多处改动设计成"全部成功才落盘",一处失败整体不动 | 避免"改了一半"这种最难查的状态 |
| 可观测 | 关键路径都有审计与统计(谁做了什么、成功失败、耗时) | 没有观测,等于把命运交给运气 |
| 可回退 | 关键开关走配置热加载,秒级回退;数据只归档不删除 | 生产系统的第一原则 |
| 可交接 | 每次改动同步文档,文档与代码同步校验 | 系统不是我一个人的私产,要能交给组里其他人 |
| 分层验收 | 语法校验 → 单元/边界验证 → 真实接口验证 → 业务口径核对 | 逐层收紧,不让问题穿透到产线 |
【给工程师】举个具体例子:审计的"中间件统一记录"
早期做法是"每个接口自己记得写审计",结果 21 个写接口里有 4 个漏了 。改成"中间件统一拦截记录"之后,覆盖全部写操作,以后新增接口自动带上;已经自己记过日志的接口用标记去重,不会重复记两条。凡是靠人自觉的规范,最后都会漏。
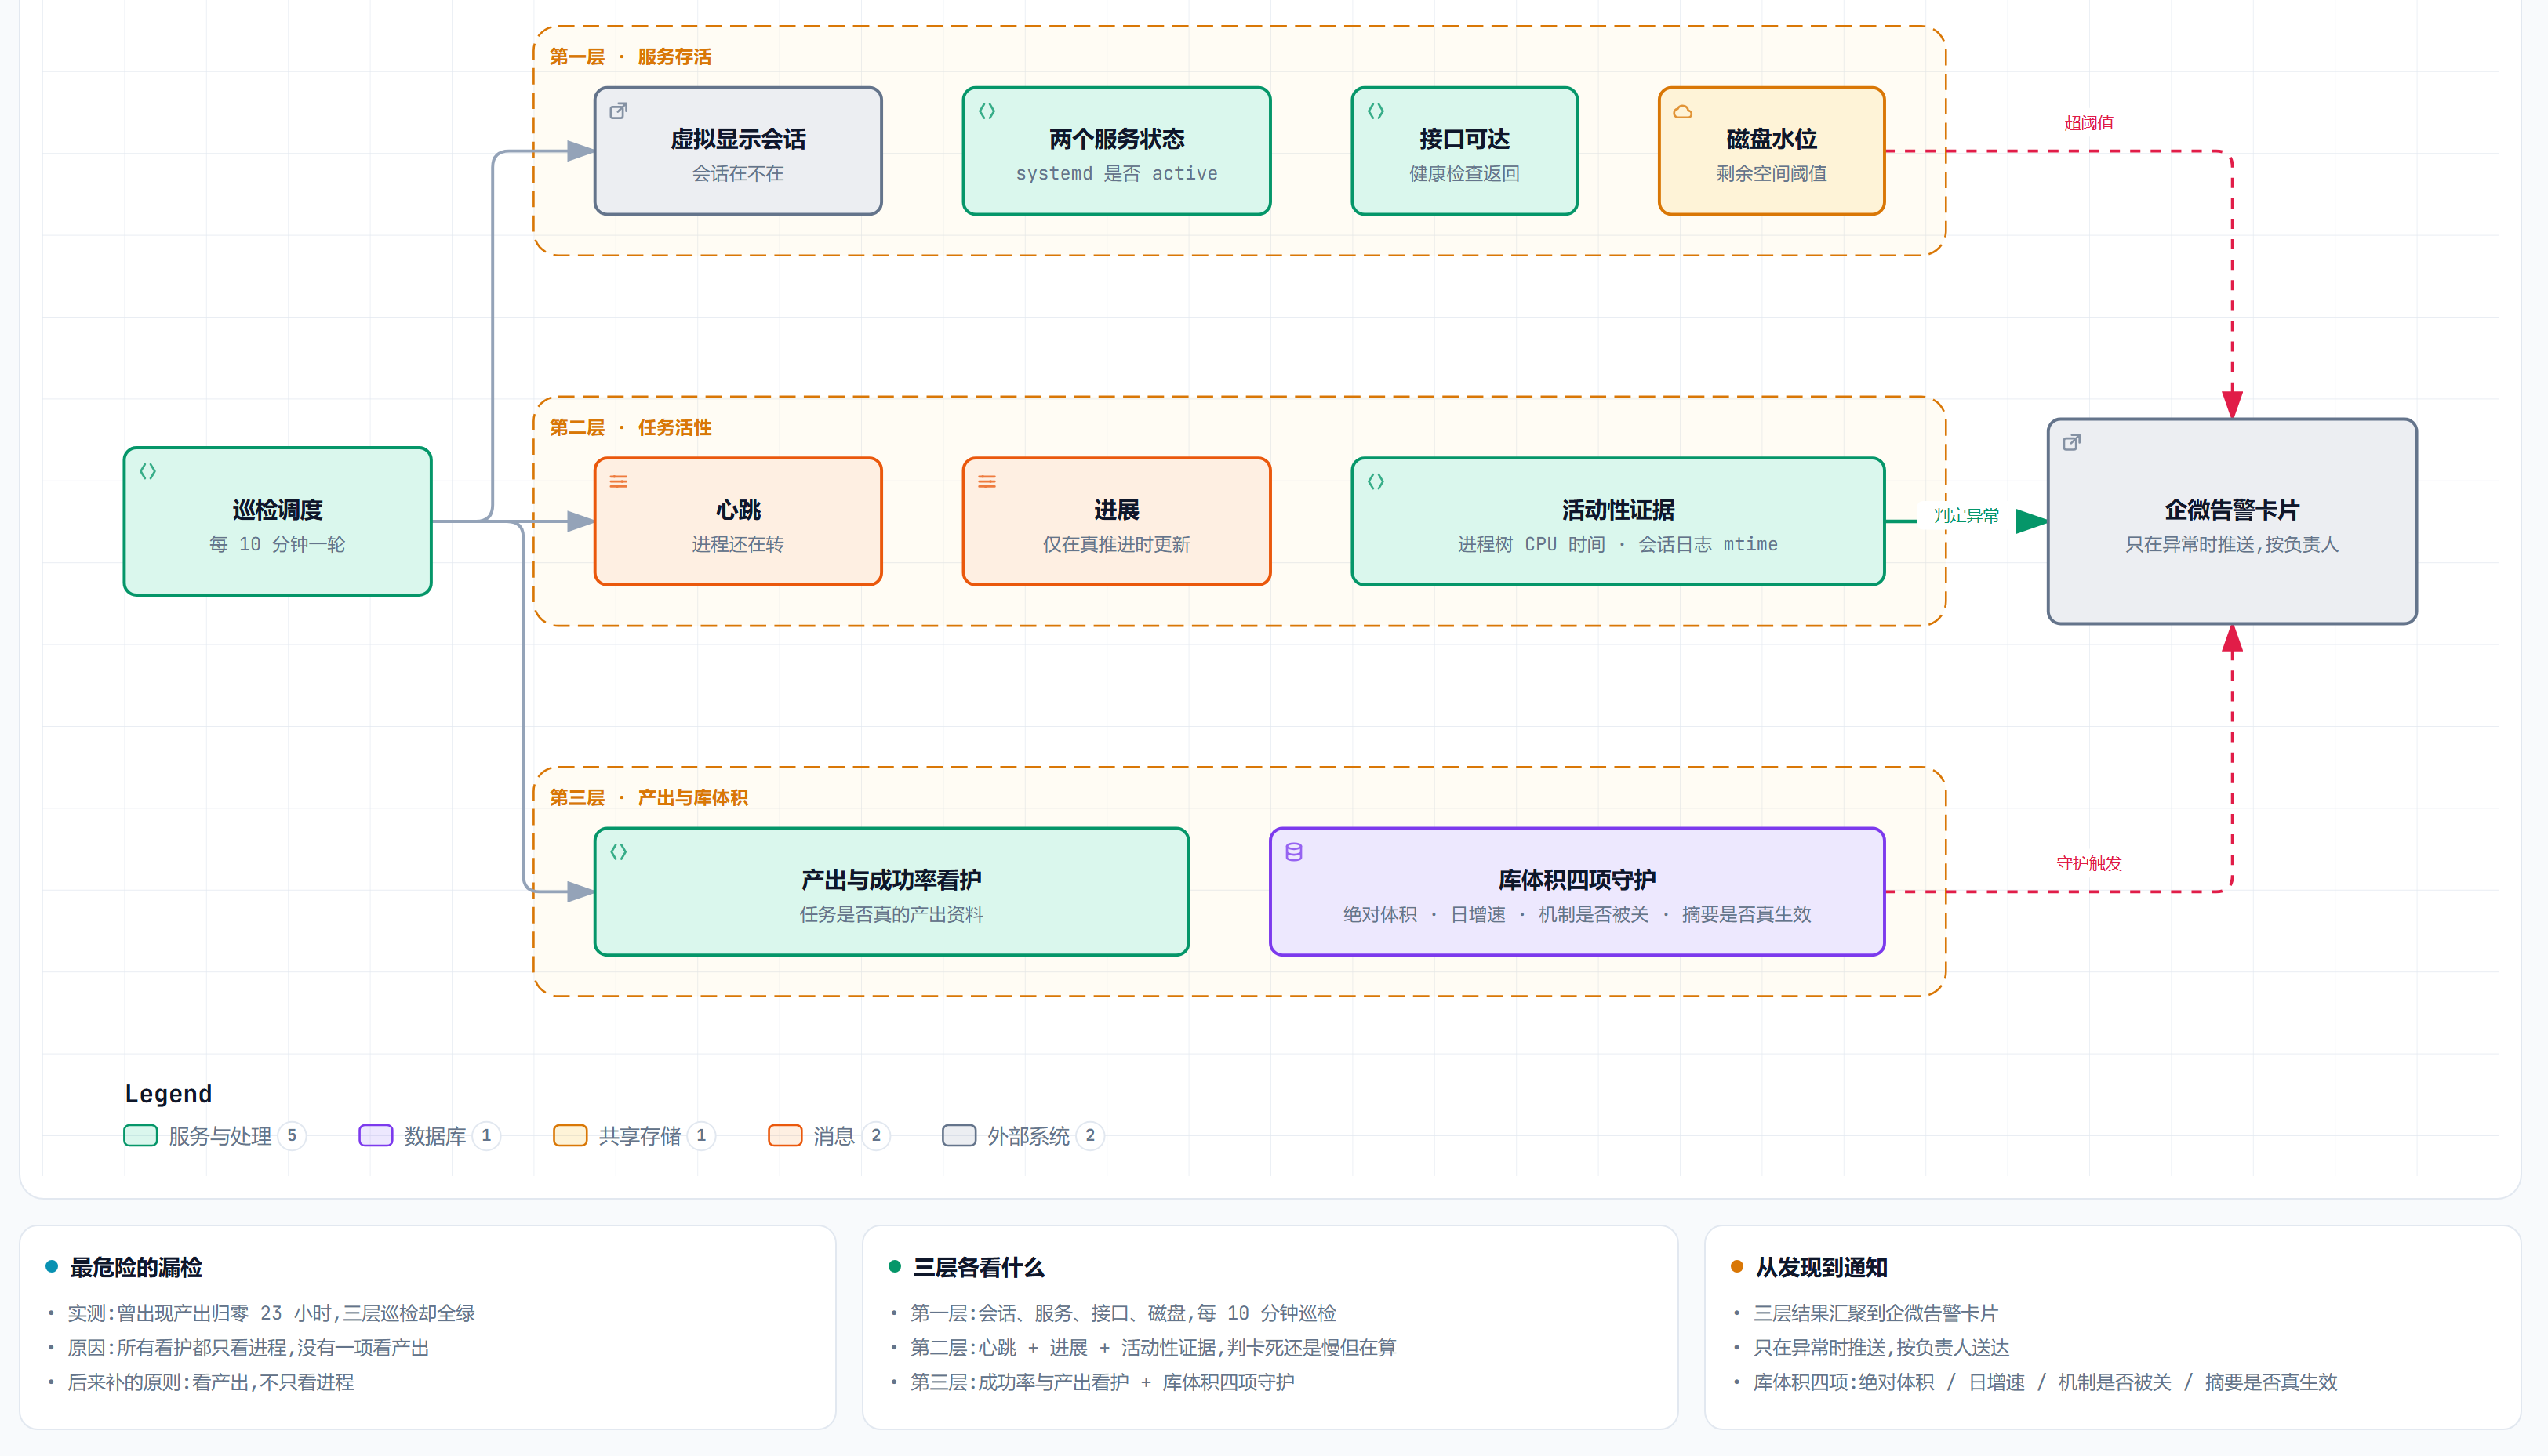
图 7:三级监控 ------ 从"系统活着"到"真把事做成了",分三层看
5. 数据说话
驾驶舱里的真实数据(和第 0 节同一个口径):
吞吐与覆盖
- 累计业务任务 2,397 条,成功输出 2,034 次
- 覆盖 251 个料号 、25 种资料类型
- 资料输出量覆盖 60% 以上(业务口径)
质量与时效
- 成功率 97.5%(成功 ÷(成功+失败),已跳过与已取消属业务决策,不计入)
- 平均执行 9.5 分钟 ,端到端(含排队)23.5 分钟
- 失败任务平均 0.3 分钟 就返回------说明失败大多发生在"开工前的规则校验",不浪费执行资源
效率对比:把人工时间算成账
人工基线:从登录软件、打开料号、检查料号到把资料导出来,再快也要平均 15 分钟一种 。这是现场"最快"的情况,所以下面这个对比是保守估计。
| 对比项 | 人工 | 系统 |
|---|---|---|
| 单次输出耗时 | 15 分钟(最快) | 执行 9.5 分钟(端到端含排队 23.5 分钟) |
| 消耗的是谁的时间 | 工程师的工作时间 | 机器时间------人 0 分钟 |
| 可工作时段 | 上班时段 | 7×24 |
| 每次是否都走同一套检查 | 靠人记,容易漏 | 固定七项自检 |
累计账 :已成功输出 2,034 次 × 15 分钟 = 30,510 分钟 ≈ 508.5 小时 ≈ 63.6 个工作日 (按 8 小时/天)。也就是说,这套系统到现在替产线省下约 508 小时的手工操作------相当于一个工程师不干别的、连干三个月。
日峰账 :以近期最忙的一天为例,当天成功输出 128 次 × 15 分钟 = 1,920 分钟 = 32 小时 。一个人一天只有 8 小时,也就是说那天的活,得 4 个人全职才跟得上。
这里有个容易被人误读的地方:系统的"端到端 23.5 分钟"里,有 14 分钟是在排队 (受专业软件许可证并发限制,属设计行为),而排队不占任何人的时间 。真正的差别在这:人工那 15 分钟,必须由工程师亲手花掉;系统那 23.5 分钟,人一分钟都不用花。
业务口径的评估是:相对人工,效率是实打实的提升------这段人工时间被整体省掉了,而且不再受上班时段限制。
工程面
- 两个服务、21 个接口、四档权限、全量写操作审计
- 三级监控:服务存活 / 任务活性(心跳 + 进展 + 活动性证据)/ 产出与库体积
- 执行端累计 10 万+ 条执行记录
- 三份可查文档(学习 / 速查 / 引擎),界面里就能打开
说白了,数据不是用来"汇报"的,是用来判断"下一步该改什么"的。第 6 节就有一个例子。
6. 边界:AI 帮不了什么,以及我踩过的口径坑
6.1 AI 帮不了的,必须我自己来
| 事项 | 为什么必须我来 |
|---|---|
| 业务规则的最终定义 | 什么料号该输出、什么状态算"可以干",这是现场经验加管理判断,AI 只能给候选 |
| 要不要动产线、什么时候动 | 涉及产线风险,只能由对产线负责的人决定 |
| 信息边界 | 哪些数据能对外、哪些数字能公开,涉及合规与商业判断 |
| 对错判断 | AI 能证明"代码按预期执行了",证明不了"这个结果在现场是对的" |
| 责任 | 系统是我负责的,出问题我扛------这一条没法委托 |
6.2 我踩过的一个口径坑
有一次我看到一个数字:"成功率大概 2%"。 当时心里一沉------这套系统不是几乎没在工作吗?
查下去才发现,是我自己弄错了口径 。那个 2% 来自执行端的记录数 ,而执行端有个特点:同一个任务,每被重排一次就会新增一条记录 (有一个任务已经重排到第 740 次)。执行端那 10 万+ 条记录里的一大堆"失败",反映的是"少数任务被反复重排",不是"活干不成"。
真实的业务成功率是 97.5%。 差别就在三个字:看分母。
| 口径 | 怎么算 | 实测 | 能拿来评价业务吗 |
|---|---|---|---|
| 业务口径 | 成功 ÷(成功 + 失败) | 97.5% | 可以。跳过和取消是业务决策,不算失败 |
| 含跳过取消 | 成功 ÷ 全部任务 | 84.9% | 可以,用来看整体产出比 |
| 执行端记录 | 成功记录 ÷ 全部记录 | 约 2% | 不可以,同一任务每次重排都会新增记录 |
这件事给我两个收获:
- 看数先看分母。 分母错了,结论能完全反过来------我差点把一套跑得不错的系统判成"没用"。
- 顺藤摸出一个真实的技术问题 :自动重排的上限配的是"无限重试",所以少数注定失败的任务会被永久重排,自己制造了 10 万条无效记录、持续占用执行资源,也是库膨胀的重要来源。这才是该改的地方。
说白了,AI 能帮你把问题查到底,但"这个数字到底代表什么",得你自己有判断力。
7. AI 时代,工程师的位置在哪
这一轮做下来,我对"AI 会不会把工程师替掉"有了自己的答案。
会被替掉的,是"把明确指令翻译成代码"这件事------这部分 AI 已经做得很好,而且不会累、不会烦。
替不掉的,是这几件事:
- 把模糊需求变成能验收的定义------"所有人为操作都要可查明白",这一句话背后要拆成身份、权限、审计、字段、查询五个层面,这是判断力。
- 判断业务对错------AI 能证明代码按预期执行了,证明不了这个结果在现场是对的。
- 立工程纪律 ------备份、校验、回退、分层验收。AI 不会主动给你立纪律,纪律是你立了它才守。
- 对结果负责------系统出问题,能承担责任的是人。
- 定义"什么算做完" ------代码写完不算完:文档要同步、监控要补上、退路要留好、口径要核对。把事情做完整,是工程师和"会用工具的人"最大的区别。
所以我更愿意这样描述自己的位置:
我不是"会用 AI 的人",我是"能把 AI 做出来的东西送上产线的人"。
前者的门槛在工具,后者的门槛在工程判断。
这套系统还会继续往前走:对齐上游判据、跨基地复制、把剩下的资料类型纳入覆盖、把几个技术欠账补上。而我做这些的方式,不会再回到"一个人硬写"------我会继续用 AI,也会继续守住上面那 7 条纪律。
附录:几个可以复用的技术点
| 技术点 | 适用场景 |
|---|---|
| 双信号 + 活动性证据 | 任何"长期运行的外部进程"监控:轮询、爬虫、驱动桌面软件、视频处理 |
| 权限不写进令牌 | 权限需要"立即撤销"的后台系统 |
| 中间件统一审计 | 任何需要"谁改了什么"、写接口又比较多的系统 |
| 先量化再治理 | 数据库/磁盘/日志增长问题(先定位占比,再动手) |
| 开关灰度 + 热加载回退 | 给运行中的系统加权限、加校验、改流程 |
| 让机器令牌走回调地址 | 给已有系统加鉴权,又不想改对端代码 |