小目标检测实战:YOLO26 的四板斧与避坑清单
航拍里的车、巡检图像里的裂纹、PCB 上的焊点、遥感里的船只------小目标漏检是工业落地最常见也最头疼的问题。
换更大的模型往往没用,因为根因不在模型容量,而在下采样把目标"采没了" 、以及训练时小目标被大目标抢走了标签。
系列导航 :本篇专攻小目标。数据与评估的基础流程见《YOLO26 实战全流程》;训练侧的增强参数见《训练配方全解密》。
一、先搞懂小目标为什么难
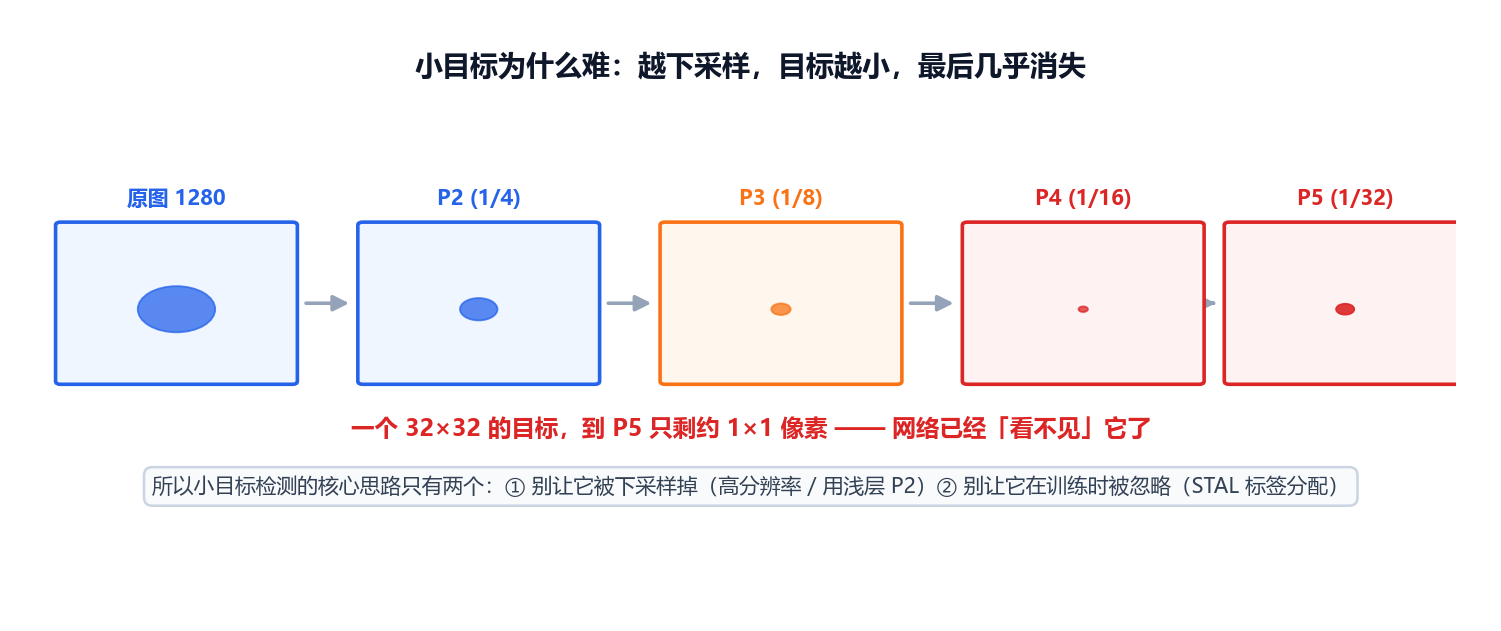
一个 32×32 的目标,在网络里会经历:
| 特征层 | 下采样倍率 | 目标还剩多大 |
|---|---|---|
| 原图 | 1× | 32×32 |
| P2 | 1/4 | 8×8 |
| P3 | 1/8 | 4×4 |
| P4 | 1/16 | 2×2 |
| P5 | 1/32 | 约 1×1 |
到了 P5,这个目标基本已经"消失"了。 而默认 YOLO 的检测头就挂在 P3/P4/P5 上。
第二个问题在训练阶段:标签分配时,大目标会占据绝大多数正样本位置,小目标分到的正样本极少,梯度信号被淹没------模型"没学会"去关注它们。
所以解法只有两个方向:
- 别让它被下采样掉 → 提高分辨率 / 用更浅的特征层(P2)
- 别让它在训练时被忽略 → 专门的标签分配策略(YOLO26 的 STAL)
二、四板斧
先说清楚:多大的目标算"小目标"
业界有个被广泛沿用的界定:COCO 把面积小于 32×32 像素的目标称为小目标(32~96 为中目标,96 以上为大目标)。
这个标准之所以好用,是因为它同时对应着网络的下采样层级------输入 640 时,P3 特征图是 80×80(stride 8)、P4 是 40×40(stride 16)、P5 只有 20×20(stride 32)。一个 32 像素的目标传到 P5 就只剩 1×1,几乎等于消失了。
所以直接在自己的数据上量一下就行:统计标注框的平均边长。如果普遍小于 32 像素,下面四板斧就都用得上。
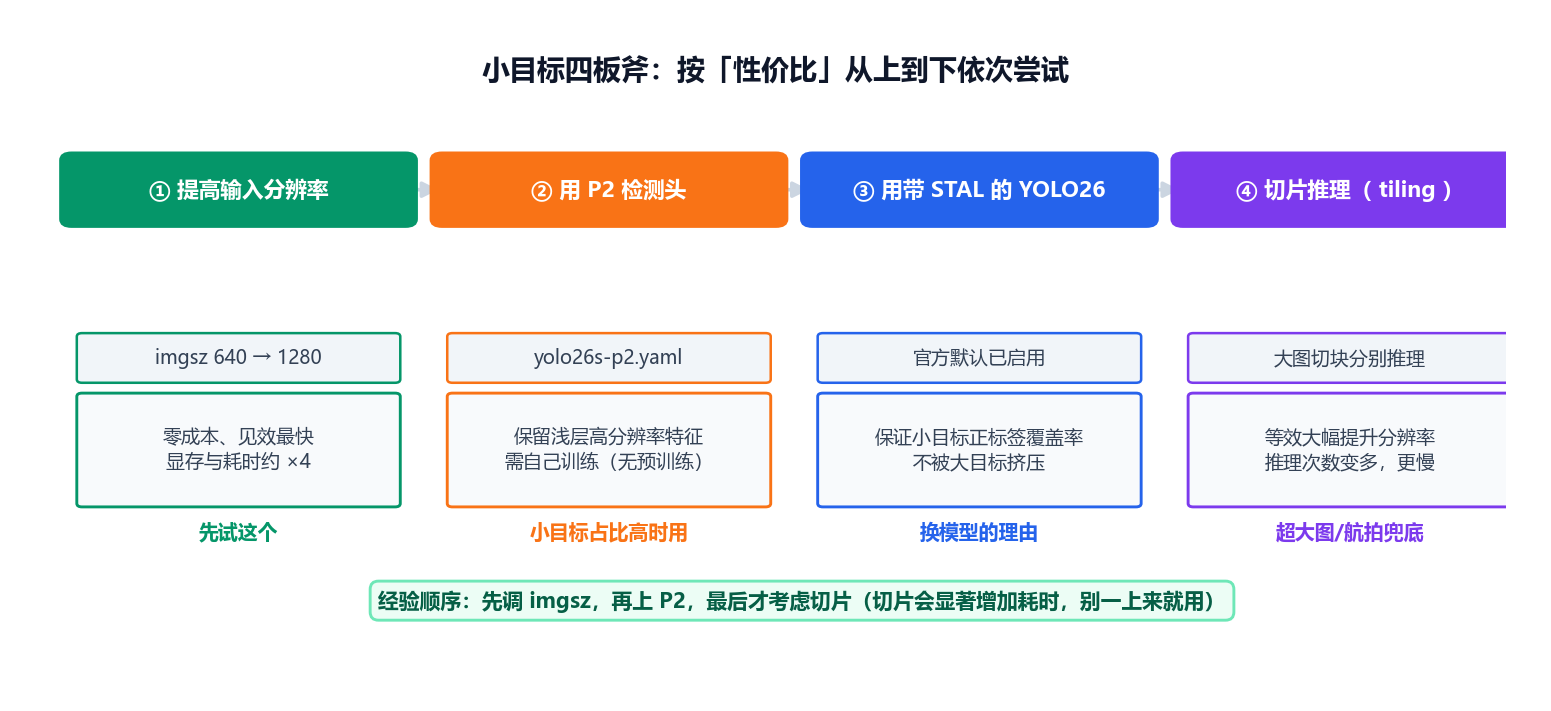
第一斧:提高输入分辨率(先试这个,零成本)
python
from ultralytics import YOLO

model = YOLO("yolo26s.pt")
model.train(data="visdrone.yaml", imgsz=1280, epochs=150, batch=16)为什么它排第一:改一个数字、不用改代码、不用重标数据,通常就能拿到肉眼可见的提升。
代价 :显存与耗时约 4 倍(分辨率翻倍,像素数 ×4)。显存不够时:
- 调小
batch - 用
batch=-1让 Ultralytics 自动探测最大可用 batch - 或开
amp=True(默认已开混合精度)
经验:小目标占比超过一半时,imgsz 从 640 提到 1280 的收益,经常大于把模型从 s 换到 m。
第二斧:用 P2 检测头(保留浅层细节)
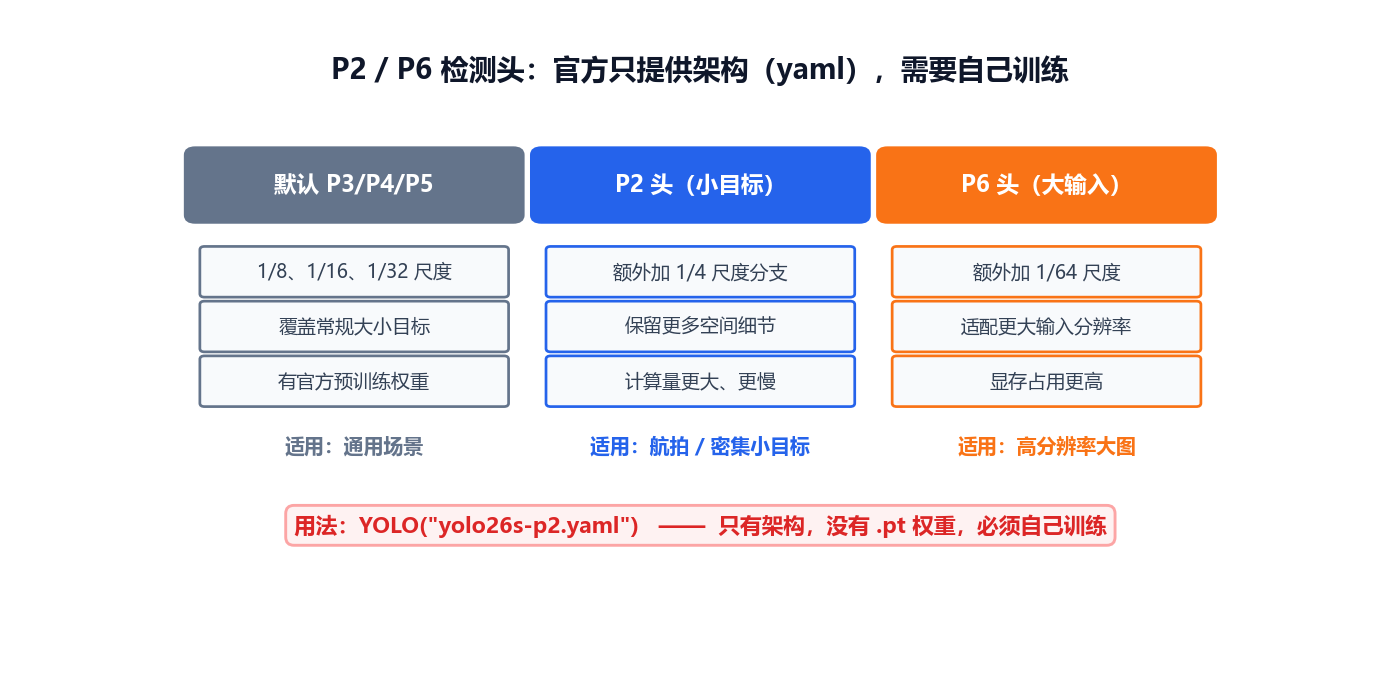
P2 是 1/4 下采样层,空间细节最丰富。
python
# 注意:P2 只有架构(yaml),没有预训练权重,需要自己训练
model = YOLO("yolo26s-p2.yaml")
model.train(data="visdrone.yaml", imgsz=960, epochs=200)| 变体 | 加了什么 | 适用 | 注意 |
|---|---|---|---|
| P2 | 1/4 尺度分支 | 小目标、密集目标 | 计算量更大、更慢 |
| P6 | 1/64 尺度分支 | 大输入分辨率 | 显存更高 |
官方明确说明:yolo26*-p2.yaml 和 -p6.yaml 只提供架构定义,不发布对应权重的 .pt,必须自己训练或做迁移。
第三斧:用带 STAL 的 YOLO26(官方已内置)
STAL(Small-Target-Aware Label Assignment,小目标感知标签分配) 是 YOLO26 官方训练方案的一部分。
人话版 :训练时网络要给每个预测位置分配"该去学哪个目标"(这一步叫标签分配)。大目标面积大、占的预测位置多,小目标占的位置少,很容易被大目标把学习名额抢光 ,结果就是模型根本没学会关注小目标。STAL 做的事就是给小目标预留名额,保证它们也有足够的学习信号。
你不需要额外配置------用 YOLO26 系列权重训练时默认就在用:
python
model = YOLO("yolo26s.pt")          # 已带 STAL
model.train(data="drone.yaml", imgsz=1280, epochs=150)
这也正是 YOLO26 相对 YOLO11 在航拍 / 无人机 / 密集小目标场景上最直接的优势来源。
第四斧:切片推理(大图兜底)
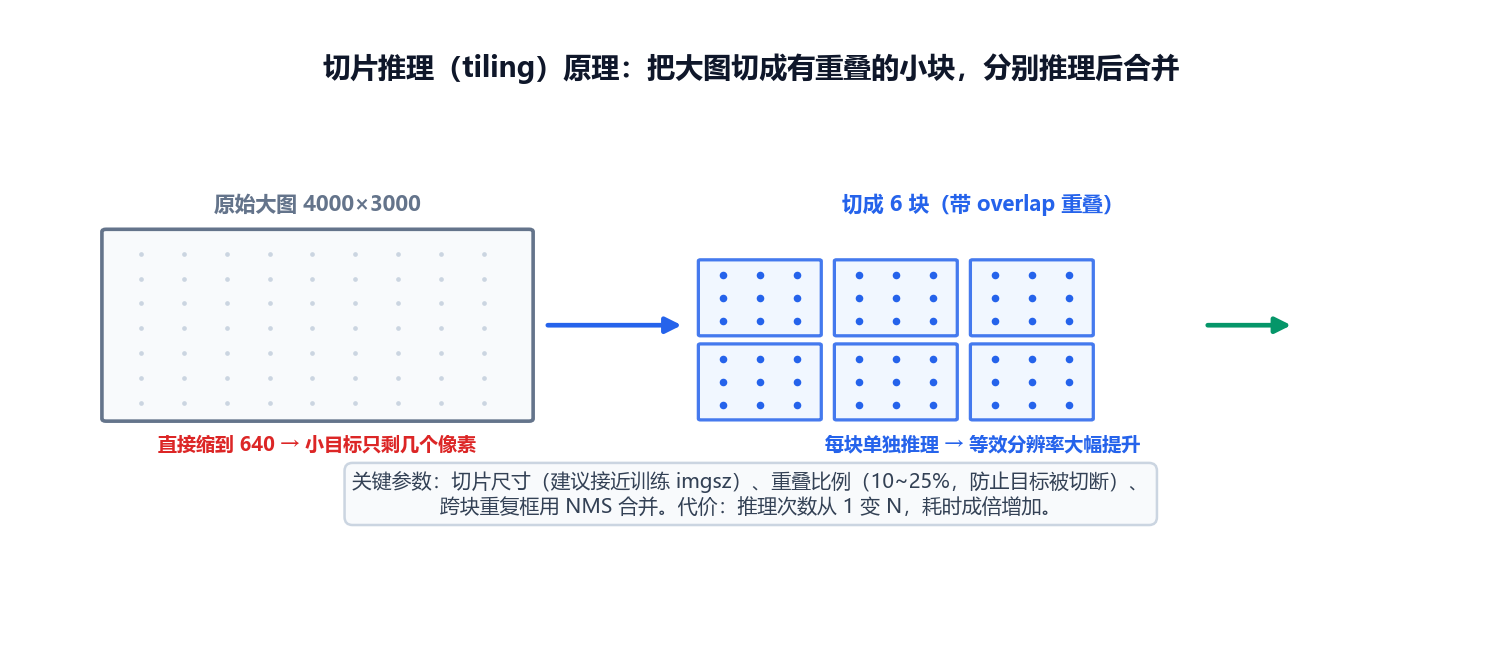
把大图切成有重叠的小块,每块单独推理,最后合并结果:
python
import numpy as np
import cv2
from ultralytics import YOLO

model = YOLO("best.pt")

def tiled_predict(img_path, tile=640, overlap=0.2, conf=0.25):
    img = cv2.imread(img_path)
    H, W = img.shape[:2]
    step = int(tile * (1 - overlap))
    boxes_all = []

    for y in range(0, H, step):
        for x in range(0, W, step):
            y2, x2 = min(y + tile, H), min(x + tile, W)
            y1, x1 = max(0, y2 - tile), max(0, x2 - tile)   # 贴边时回退
            tile_img = img[y1:y2, x1:x2]

            res = model.predict(tile_img, conf=conf, imgsz=tile, verbose=False)[0]
            for b in res.boxes:
                x1g, y1g, x2g, y2g = b.xyxy[0].tolist()
                boxes_all.append([x1g + x1, y1g + y1, x2g + x2, y2g + y2,
                                  float(b.conf), int(b.cls)])

    # 跨块重复的框用 NMS 合并
    if not boxes_all:
        return []
    arr = np.array(boxes_all)
    idx = cv2.dnn.NMSBoxes(
        arr[:, :4].tolist(), arr[:, 4].tolist(), conf, 0.5)
    return arr[idx.flatten()] if len(idx) else []


dets = tiled_predict("aerial_4000x3000.jpg", tile=640, overlap=0.2)
print(f"共检出 {len(dets)} 个目标")关键参数(这组是 SAHI 官方示例的常用取值):
- 切片尺寸 :640×640,接近训练时的
imgsz - 重叠比例:0.2(即 20%),防止目标被切在边界上
- 合并 NMS 的 IoU:0.5 左右
如果你不想自己写,SAHI 库已经把这套流程封装好了,YOLO 系列集成得很顺:
python
from sahi import AutoDetectionModel
from sahi.predict import get_sliced_prediction

detection_model = AutoDetectionModel.from_pretrained(
    model_type='yolov8',          # 按你的版本选,YOLO26 用对应的类型名
    model_path='best.pt',
    confidence_threshold=0.3,
)

result = get_sliced_prediction(
    "aerial.jpg",
    detection_model,
    slice_height=640,
    slice_width=640,
    overlap_height_ratio=0.2,
    overlap_width_ratio=0.2,
)
代价 :推理次数从 1 变 N,耗时成倍增加 。所以它是兜底方案,别一上来就用。
有一条经验值得单独说:很多人第一反应是"加个 P2 检测头"。但 P2 特征图是 160×160,面积是 P3 的 4 倍 ,计算量和显存都会明显上升,边缘设备上往往直接不可用。改模型的代价通常比想象的大------先用切片推理兜底,确认收益值得再考虑动结构。
三、训练侧的四个补充技巧
3.1 增强要"保护"小目标
python
model.train(data="drone.yaml", imgsz=1280,
            mosaic=1.0,        # mosaic 会缩小目标,小目标多时谨慎
            mixup=0.1,         # 别开太大,会模糊小目标
            copy_paste=0.3,    # 复制粘贴能增加小目标样本
            scale=0.5)         # 尺度抖动范围
反直觉提示:
mosaic会把 4 张图拼起来再缩放,等效让目标变得更小 。小目标极多时可以适当降低 mosaic 概率(0.5~0.7)或增大scale,让目标在训练时保持较大尺寸。
以方向、颜色为判别特征的任务 (焊接缺陷、划痕、织物瑕疵这类),增强要克制。理由很直接:缺陷的方向和颜色本身就是判别特征,被增强改掉了,模型就学不到东西。所以这类任务通常把会破坏这些特征的增强关掉或调小:
python
model.train(data="data.yaml", imgsz=1280,
            hsv_h=0.0,     # 色调不动:工业图像颜色稳定
            hsv_s=0.2,     # 饱和度轻微
            hsv_v=0.3,     # 亮度可以模拟光照变化
            degrees=5.0,   # 小角度:板子方向基本固定
            shear=0.0,     # 关掉错切:缺陷形状不能扭曲
            flipud=0.0,    # 不上下翻:有方向性
            fliplr=0.5,    # 左右翻可以:通常对称
            mosaic=0.0,    # 关掉:小目标缺陷会被拼接破坏
mixup=0.0) # 关掉:同上他还给了一个方法值得照抄:先关掉所有增强训一个 baseline,再逐个打开看验证集变化。这比一上来就照搬 COCO 那套参数靠谱------COCO 的增强强度是为自然图像的通用性设计的,工业场景往往要反过来调。
3.2 类别均衡要看"目标数"而不是"图片数"
小目标类别常常是图片多但目标小 ------统计时看每类的实例数量,别只看图片数。
3.3 验证集必须包含最远/最小的样本
如果你的验证集都是"大又清晰"的目标,指标会虚高,上线必崩。
3.4 后处理阈值要单独调
小目标的置信度普遍偏低。用默认 0.25 可能全被滤掉:
python
# 对小目标类别单独降低阈值
results = model.predict("img.jpg", conf=0.15, iou=0.6)更稳妥的做法是按类别设定阈值 :先用 model.val() 找出每类的最佳 conf,再在业务代码里分阈值过滤。
四、选型速查
| 场景 | 推荐组合 |
|---|---|
| 航拍 / 无人机(几百米高空) | YOLO26s + imgsz=1280 + 切片(overlap 0.2) |
| 工业缺陷(焊点/划痕) | YOLO26m + imgsz=1280 + P2 头 |
| PCB / 密集元件 | YOLO26m/l + P2 + copy_paste 增强 |
| 遥感船只 / 车辆 | YOLO26-obb(旋转框)+ 高分辨率 |
| 医学小病灶 | YOLO26l/x + 高分辨率 + 切片,阈值单独调 |
| 实时性要求高 | YOLO26n/s + imgsz=960(放弃切片) |
五、避坑清单
- 别一上来就换大模型 ------ 小目标漏检的主因是下采样和标签分配,不是模型容量。
- 别一上来就切片 ------ 先试
imgsz=1280,很多时候就够了,切片会让耗时翻倍。 - P2 没有预训练权重 ------ 用
-p2.yaml意味着从头训练,数据量要够。 - mosaic 会缩小目标 ------ 小目标场景要重新评估它的强度。
- 验证集别只放"好图" ------ 必须包含最小、最模糊、最遮挡的样本。
- 阈值别用默认 ------ 小目标置信度天然偏低,0.25 可能滤掉一半。
- 切片后一定要 NMS 合并 ------ 否则边界处的目标会重复计数。
- 切片尺寸要接近训练 imgsz ------ 差太远会因尺度失配反而掉点。
六、小结
按性价比排序依次尝试:
text
① imgsz 640 → 1280        (零成本,先做)
② 用 YOLO26(自带 STAL)    (换模型的最小代价)
③ P2 检测头                (小目标占比极高时)
④ 切片推理                 (超大图兜底,最后考虑)
核心认知 :小目标检测不是"换个更强的模型"就能解决的工程问题,而是分辨率、特征层、标签分配、后处理阈值四个环节的系统性配合。
参考来源
- Ultralytics 官方文档(YOLO26 模型页、P2/P6 架构说明、STAL 训练方案)
- SAHI 官方示例(切片推理接口与参数取值)
- COCO 数据集目标尺寸分级定义(小 / 中 / 大目标)
关键词 :小目标检测 YOLO26 STAL P2检测头 切片推理 SAHI 航拍 无人机 工业缺陷
环境:ultralytics 8.4+ / opencv-python / PyTorch 2.x