这一节讲的是 LangGraph 的"记忆"基础设施:用两层互补的持久化系统 给 Agent 装上短期记忆(Checkpointer)和长期记忆(Store),让应用能在单次图运行之外保留信息。下面这张图先给你整体的心智模型,然后我逐段拆解。
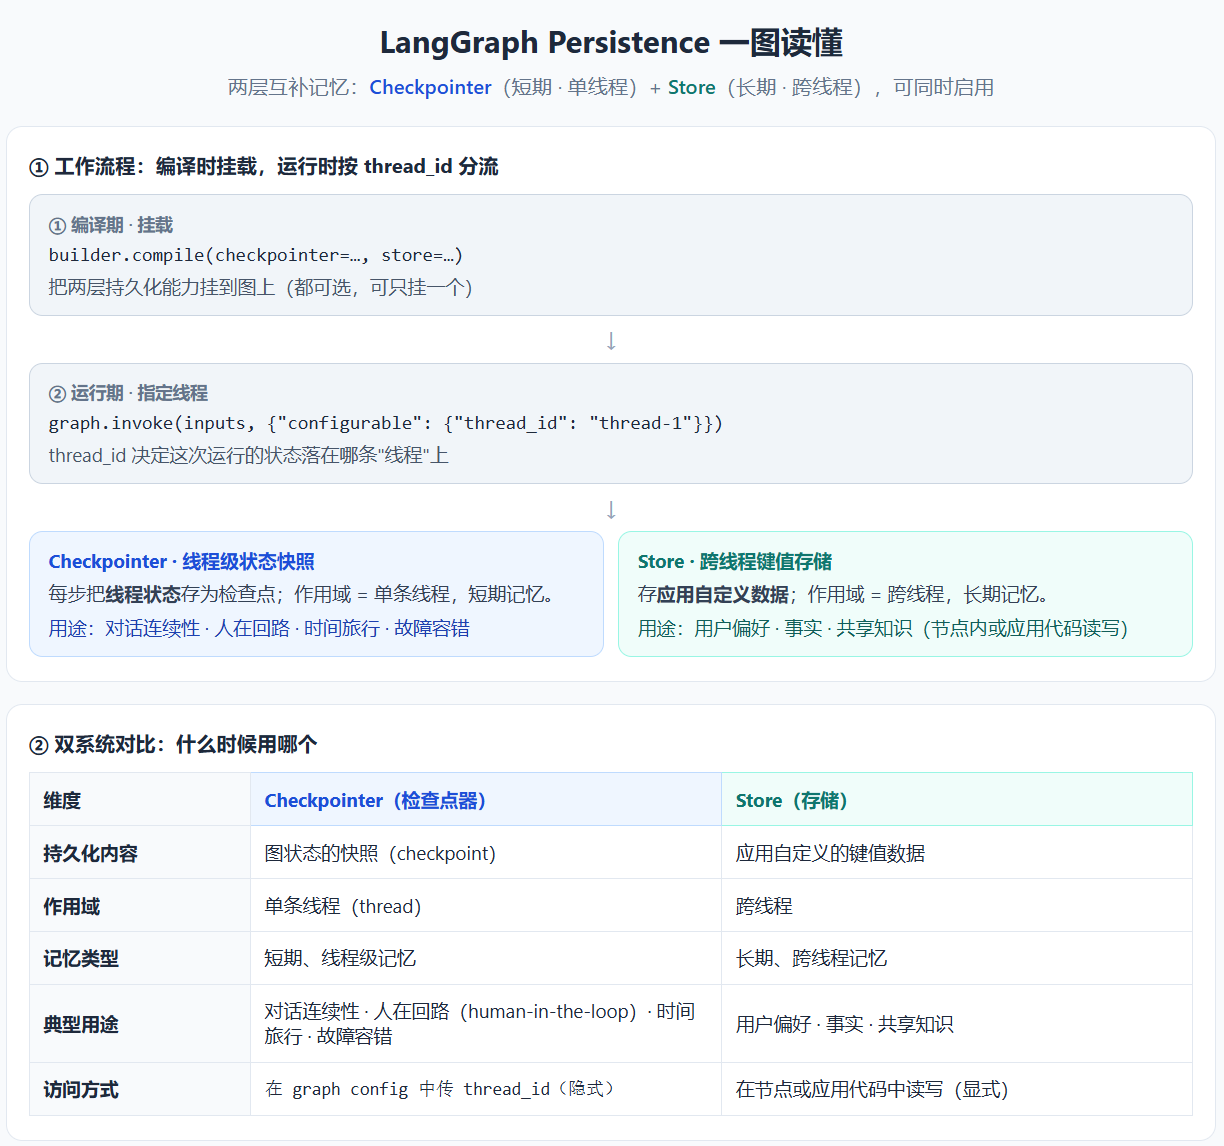
下面分五块把这节讲透。
1. 这节在解决什么问题
默认情况下,图跑完就结束了,所有状态随进程消失。持久化让应用能保留单次图运行之外的信息,这正是一个"Agent"和一条"无状态链路"的分水岭:续聊、中断后恢复、故障恢复、跨交互记住用户,全都依赖它。
关键心智模型:LangGraph 把记忆按作用域切成两层,而不是一个万能存储------
- Checkpointer = 会话级记忆(这条对话进行到哪了)
- Store = 用户级记忆(这个用户长期是什么样的人)
两者互补、可同时启用,绝大多数应用两个都用。
2. 快速上手逐行解读
python
from langgraph.checkpoint.memory import InMemorySaver   # 检查点器的内存实现
from langgraph.store.memory import InMemoryStore        # 存储的内存实现

checkpointer = InMemorySaver()
store = InMemoryStore()

graph = builder.compile(checkpointer=checkpointer, store=store)  # ① 编译时挂载

result = graph.invoke(
    {"messages": [{"role": "user", "content": "Hi, my name is Bob."}]},
    {"configurable": {"thread_id": "thread-1"}},   # ② 运行时指定线程
)
三个要点:
- 挂载是编译期行为 :
compile时把两层能力接上图,之后每次invoke自动生效。 thread_id是 Checkpointer 的寻址键 :同一thread_id的多次调用共享同一线程状态(所以多轮对话能续上);不同thread_id之间互不可见。- 两者都可选:可以只挂 checkpointer、只挂 store,或都不挂(无状态运行)。
- 另外注意文档的 Info 提示:用 Agent Server 时不需要自己配置任何持久化,服务端已自动处理。
3. Checkpointer vs Store:五维对比
对照上图第二块:
| 维度 | Checkpointer | Store |
|---|---|---|
| 存什么 | 图状态的快照(每个节点执行后自动落盘) | 应用自定义的键值数据(你自己决定存什么) |
| 作用域 | 单条线程 | 跨线程 |
| 记忆类型 | 短期、线程级 | 长期、跨线程 |
| 典型用途 | 对话连续性、human-in-the-loop、时间旅行、故障容错 | 用户偏好、事实、共享知识 |
| 访问方式 | config 里传 thread_id(隐式,图框架自动读写) |
节点或应用代码显式读写 |
最容易混淆的一点是访问方式的差异 :Checkpointer 你基本"看不见它"------传了 thread_id,框架自动把每步状态存成检查点;Store 则需要你显式地在节点里 store.get(...) / store.put(...)。前者是框架替你管记忆,后者是你自己管记忆。
4. 四个常见坑(实践中最容易踩)
thread_id过长 :PostgresSaver里thread_id存在定长列,超长直接数据库报错。修复:控制在 255 字符内,需要确定性 ID 时用 UUID 或哈希(文档给了str(uuid.uuid4())[:255]的写法)。MemorySaver/InMemorySaver不跨重启 :它们把检查点存在 RAM 里,进程一重启全丢。生产用PostgresSaver(有异步版AsyncPostgresSaver),本地开发用SqliteSaver(基于文件)。- 检查点无限膨胀:长对话会累积大量检查点,拖慢延迟、涨存储成本。需要定期清理旧检查点或设保留策略(例如用 cron 定时删掉 N 天前的检查点)。
- 父图看不到子图的状态更新 :每个子图管理自己的 checkpoint 命名空间,父图不能立即感知。需要跨图边界共享的数据走 Store,或把子图配置成写入父检查点。