能解释算法原理、给出必要的数学推导、估算计算与显存成本、描述 GPU 上的执行方式,并讨论真实系统中的 Trade-off
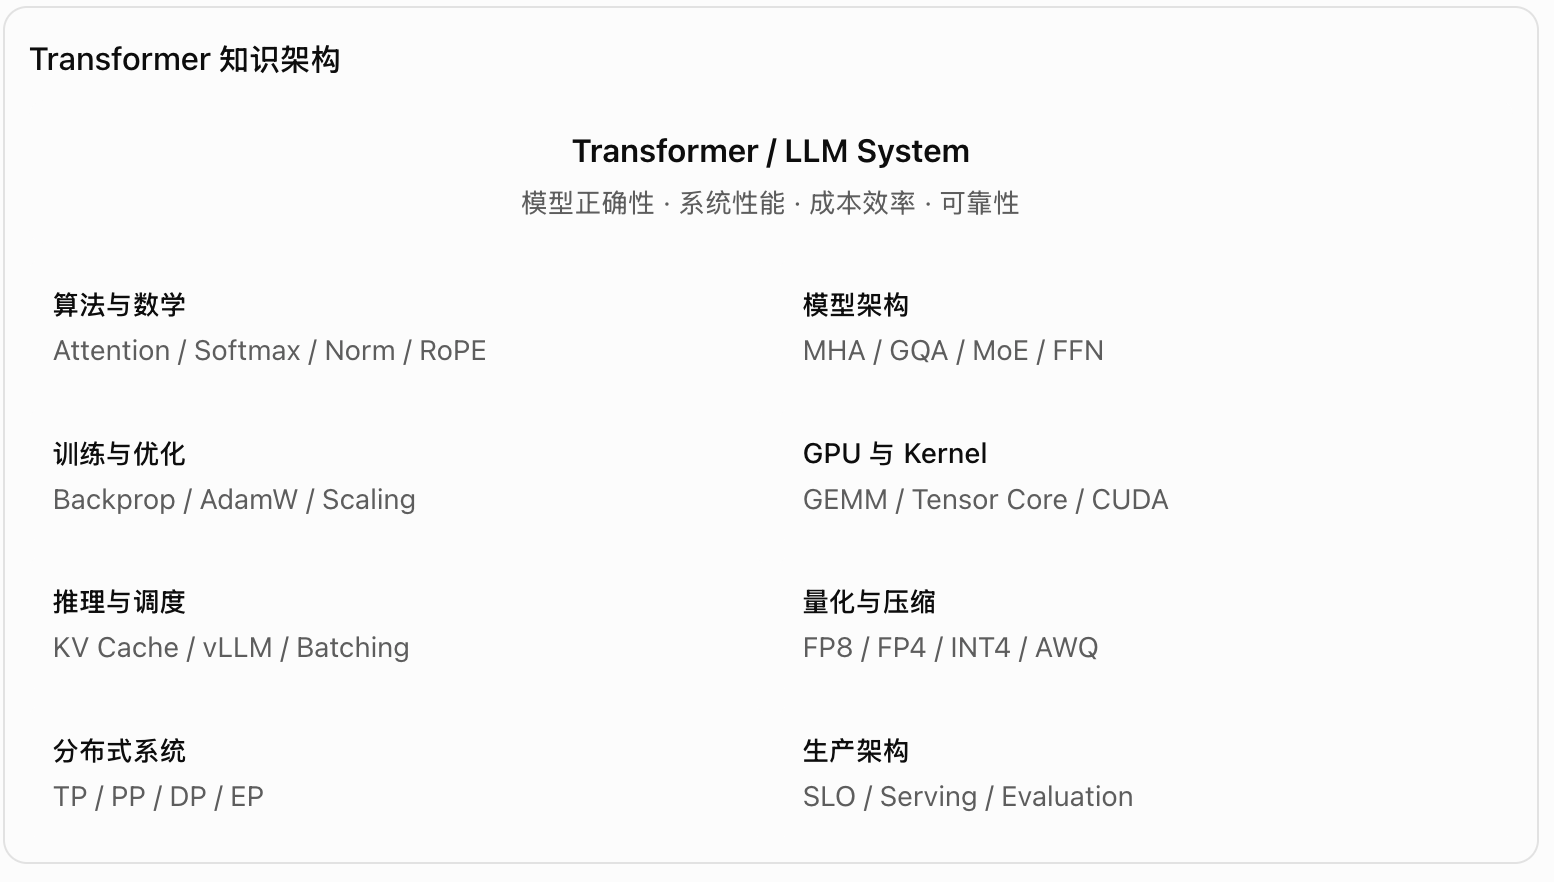
需要从四个层次建立知识体系:
-
Mathematical Foundations:为什么设计成这样?能否严格推导?有什么假设与局限?
-
Model Architecture:数据怎样流过 Transformer?不同架构的计算量、参数量和表达能力如何?
-
Hardware and Systems:算子如何映射到 GPU?瓶颈在 FLOPs、HBM 带宽、Kernel Launch 还是跨 GPU 通信?
-
Production Optimization:怎样通过量化、KV Cache、Batching、并行策略与服务调度,在准确率、延迟、吞吐、成本之间取得平衡?
模块 1:数学基础与高维几何(Q001--Q020)
| 题号 | 主题 | 核心能力 |
|---|---|---|
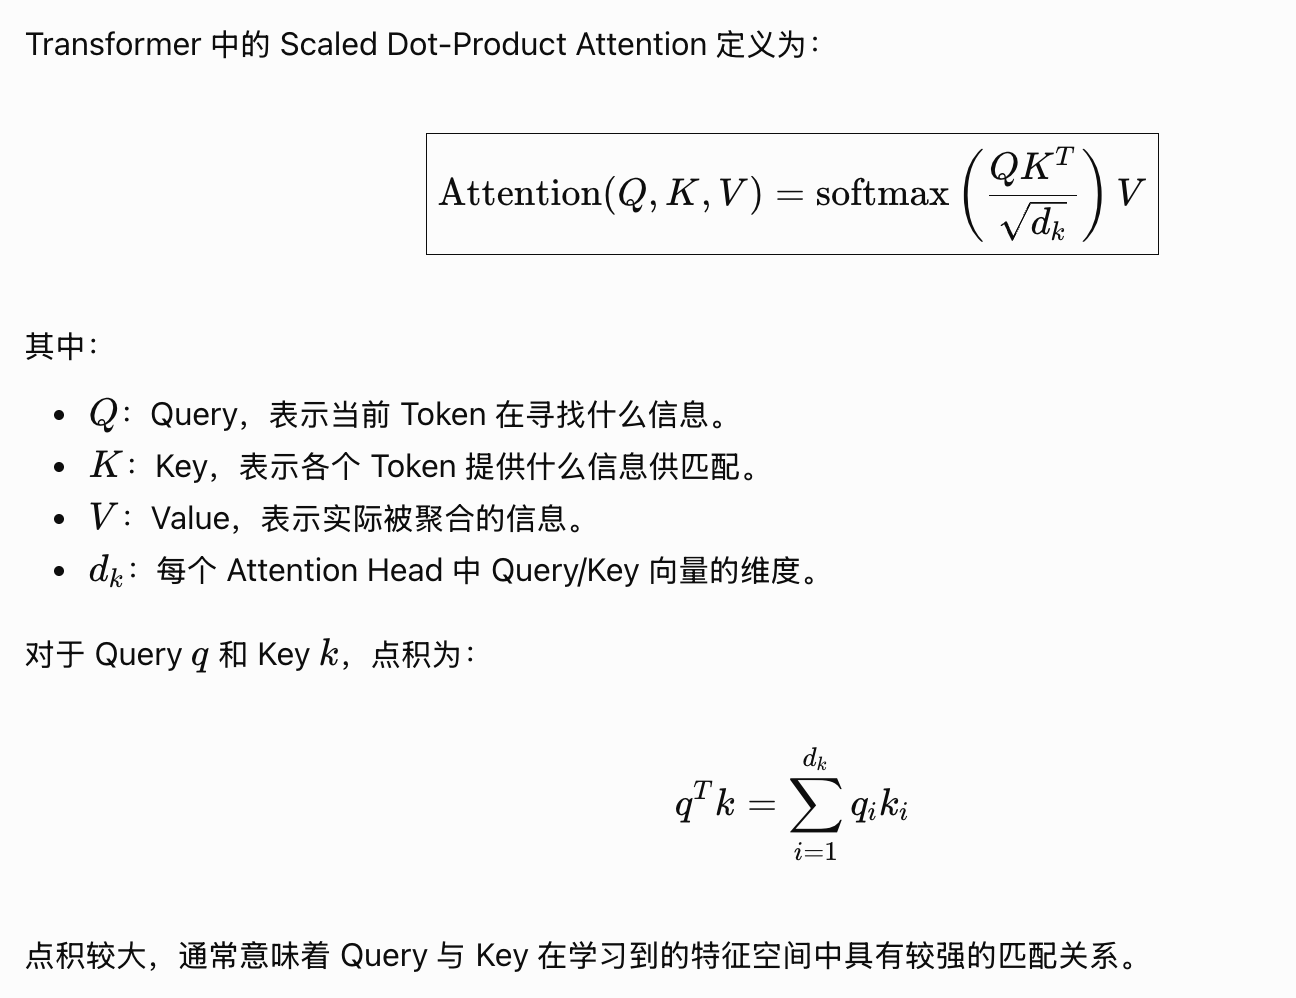
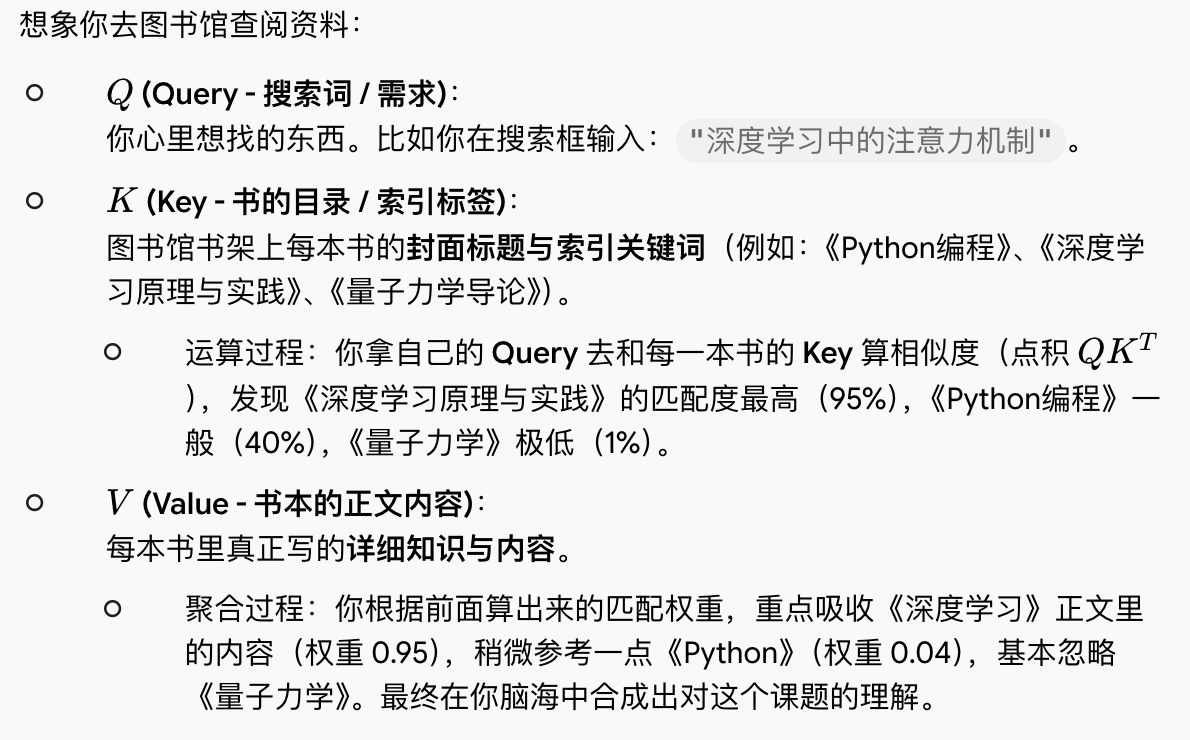
| Q01 | Attention 为什么用点积并缩放 | 统计推导、数值稳定、GPU 计算 |
| Q02 | Transformer 参数、FLOPs 与 Prefill 成本 | 容量估算、建模 |
| Q03 | RoPE 与 128K 长上下文 | 相对位置、外推、质量 |
| Q04 | MHA / GQA / MQA 与 KV Cache | 内存容量、延迟 |
| Q05 | FlashAttention / Online Softmax | IO-aware 算法 |
| Q06 | Roofline、Arithmetic Intensity | Compute/Memory Bound |
| Q07 | Prefill vs Decode | 两阶段性能建模 |
| Q08 | Continuous Batching 与 Token Scheduling | SLO-aware 排队调度 |
| Q09 | Paged KV Cache 与碎片化 | GPU 内存管理 |
| Q10 | Prefix Cache 与多租户安全 | 缓存设计 |
| Q11 | Speculative Decoding | 推测验证、收益模型 |
| Q12 | INT4 / INT8 / FP8 / FP4 | 量化与硬件协同 |
| Q13 | KV Cache Quantization | 累积数值误差、容量 |
| Q14 | TP / PP / DP / EP | 多 GPU 通信与拓扑 |
| Q15 | MoE 路由、负载均衡 | 专家并行 |
| Q16 | TTFT / ITL / p99 与容量规划 | 性能 SLO |
| Q17 | Serving 性能突然下降如何排障 | 可观测性与实验 |
| Q18 | CUDA/Triton Kernel 优化 | Tiling、Fusion、Spilling |
| Q19 | Prefill–Decode Disaggregation | 集群架构取舍 |
| Q20 | 设计 70B 长上下文生产推理平台 | 综合系统设计 |