谁也没想到,规矩会坏在一个 python3 scripts/foo.py 上。
星悟接完 MCP 和 Skill,聊天进程里立过一条死规矩:绝不 spawn。MCP 只认 SSE 和 Streamable HTTP,Skill 只认 Markdown。模型和用户配置,不该摸到宿主机,这是当初的底线。
后来老板翻社区包,看到人家动不动就 python3 scripts/foo.py,说这个得支持。顺带,stdio 那类 MCP 也要能进来。任务落到对话这块。
好在方案层面没什么悬念。Agent Skills 规范、CubeSandbox 的生命周期和自定义镜像文档过一遍,再对着 cubesandbox.ts、run-script.ts 核实现,社区早就吵明白了:脚本执行和沙箱绑在一起,是既定路线。星悟缺的是把它接上自己的 chatbot,同时守住一条 ------Next.js 进程,不能变成一台能随便拉解释器的机器。
01 背景
v1 的 MCP 只走 SSE 和 Streamable HTTP。用户 mcp.json 里一旦出现 command 或 args,解析直接抛错,文案写着不支持本地进程 MCP。Skill 只落地 SKILL.md 和一层 references/、assets/ 文本。scripts/ 既不扫描,也不执行。
chatbot 跑在 Next.js 里。进程一旦能拉起 Python、bash 或 stdio MCP,模型和用户配置就摸到了宿主机。当时少一项能力,也没在对话热路径里拉本地进程。
Agent Skills 规范里,一个 Skill 是目录加 SKILL.md,旁边就能放 scripts/。社区包写 python3 scripts/foo.py 是常态,管道接 JSON 的也多。还有一类 MCP Server 只提供标准输入输出,各家客户端用 command 拉起,星悟把这条路封死了,或者说星悟缺少对社区标准Skill能力的支持。
老板看到这心想那那成啊?别人有的我们都得有,安全?先别考虑了,能跑起来再说!
02 方案调研
要补这两项,先得问代码跑在哪,隔离有多硬。
Skill 脚本是短任务,不可信,用完可以毁。stdio MCP 是长连接,要常驻,还得转成星悟已经认识的 HTTP。两件事不能走同一条进程路径,都需要一个执行面。社区把这个执行面叫 Agent Sandbox。
普通 Docker 容器共享宿主机内核。启动快,给内部可信工具够用。用户 Skill 或模型间接碰到的脚本丢进去,内核一旦有洞,宿主机一起完。
Agent 这边更常见的是 MicroVM。Firecracker 给每个沙箱独立客户机内核,硬件虚拟化把逃逸挡在客户机里。E2B 公开材料写的就是 Firecracker,产品形态是托管 API,创建、传文件、跑代码、拆掉。gVisor 走另一条,在用户态拦系统调用,比裸容器硬,有的 Linux 软件会撞上没模拟全的 syscall。
Anthropic 把容器化 Agent Skills 放在厂商侧,对话里声明,容器由他们拉起。星悟网关后面接了多家模型,厂商容器跟某一家的工具记录绑在一起,换模型就不好回放。为了跑一段社区脚本把解释权交出去,我们不干。
自建还得看控制面。E2B 把创建、执行、销毁收成 HTTP SDK,社区不少项目按这套接口写客户端。隔离原语可以换,接口最好别换。星悟已经是 TypeScript 和 AI SDK,不想在 Node 里再实现一套 protobuf 进程协议。
stdio MCP 在社区里通常是 Host 拉起 Server。星悟不能这么干。执行留在运营方宿主机,sidecar 把 stdio 转成内网 HTTP 或 SSE,星悟继续只连 url 和 headers。
03 sandbox 选型
运营方已经有一台装了 CubeSandbox 的 CVM,控制面本机健康检查走 http://127.0.0.1:3000/health。再买一套托管沙箱,多一截账号、出网和数据出境,现成的机器还闲着。
CubeSandbox 对得上几条硬条件。沙箱是 KVM MicroVM,能扛不可信 Skill 脚本。控制面兼容 E2B 那套创建和执行接口,Node 直连 HTTP 就行,不用在 chatbot 里嵌 Firecracker 或 gVisor。官方 sandbox-code 模板自带 Python 3.12、bash 和 Jupyter(49999 端口),正好拿来跑平台生成的引导程序。它文档里写明自己不用 Firecracker,envd 不要去查 Firecracker 的 MMDS。兼容的是调用方式,底下的虚拟化是另一套。
有一条路看过就否了。用 CubeSandbox 的 stdio MCP 适配器,让终端用户在 mcp.json 里直连 MicroVM。MicroVM 会话短、冷启动贵,跟 MCP 长连接不匹配。用户配置里复活 command,等于把即时 spawn 从 Node 挪到浏览器提交的字段上。
最后的分工如下。
| 对象 | 跑什么 | 谁负责 |
|---|---|---|
skill_run_script |
已勾选 Skill 包内的脚本 | 星悟应用,直连 CubeAPI |
| CubeSandbox MicroVM | 执行脚本 | 运营方 CVM |
| stdio MCP 加 sidecar | 把本地 Server 转成内网 HTTP 或 SSE | 运营方 CVM |
用户 mcp.json |
只有 url 和 headers | 用户浏览器 |
| chatbot Next.js | 不 spawn 解释器,也不 spawn MCP | 现有进程 |
未配置 Cube 时,对话仍能用纯 Markdown Skill,工具返回 configured: false。stdio sidecar 没起来,那个知识源探测失败,不能勾选。能力没齐,把话说清楚,不能假装已经跑成功。
04 方案实施
总流程长这样。
模型只能指定已经勾选、已经校验过的包内路径。chatbot 把平台生成的引导程序和包文件送到 CubeAPI,MicroVM 里跑完,stdout、stderr、退出码回来。MCP 池仍然只认 HTTP,现在多了一个来源,Skill 自己声明的远程 MCP。
入口比最初宽,红线没松。包内任意相对路径都能当入口,根目录放个 main.py 也行,深度上限 16 层。扩展名只认 .py、.sh、.js、.ts、.rb。禁止 ..,跳过 node_modules、.git。二进制按 base64 收录,整包写进沙箱。参数最多 64 个、每个 32KB。stdin 最多 256KB,承接社区包那种 printf | python3。模型没有「随便写一段 Python 给我跑」的字段。那字段一旦打开,沙箱就是一台换了宿主的远程代码执行机器。
执行不走 envd 的 Process API。那条路是 commands.run,端口 49983,要自己做 protobuf 和 Connect 客户端,也更容易把任意命令做成通用 RCE 面。首版全部走 Jupyter。
text
POST http://49999-{sandboxId}.{domain}/execute请求体里的 code 永远是平台生成的 Python。它把整个包写成 /tmp/xingwu-skill/,再用 subprocess.run(..., shell=False) 按扩展名调解释器。工作目录是包根,嵌套脚本可以用相对路径找同包文件。.ts 走 node --experimental-strip-types,模板必须是 Node 22 以上。缺运行时就返回可读错误,不在宿主机补跑,也不出网临时装 tsx。
创建沙箱的客户端很薄。
ts
export async function createCubeSandbox(): Promise<CubeSandbox> {
  const apiUrl = requiredEnv("CUBE_API_URL").replace(/\/+$/, "");
  const payload = await readJson(
    await requestCubeHttp(`${apiUrl}/sandboxes`, {
      body: JSON.stringify({
        allowInternetAccess: isCubeInternetAllowed(),
        templateID: requiredEnv("CUBE_TEMPLATE_ID"),
        timeout: getCubeSandboxTimeoutSec(),
      }),
      headers: { "Content-Type": "application/json" },
      method: "POST",
    }),
  );
  const id = readString(payload, "sandboxID", "sandboxId", "id");
  if (!id) throw new Error("CubeAPI 创建沙箱未返回 sandboxID。");
  return {
    domain: readString(payload, "domain"),
    id,
    trafficAccessToken: readString(payload, "trafficAccessToken"),
  };
}

export function isCubeInternetAllowed(): boolean {
  const value = process.env.CUBE_ALLOW_INTERNET?.trim().toLowerCase();
  return value !== "0" && value !== "false" && value !== "off";
}
CUBE_API_URL 和 CUBE_TEMPLATE_ID 齐了才算配置完成。出网默认开,未设置或随便写一个值都算出网,只有 0、false、off 才关。社区包动不动 pip install、npm install,默认禁网会把大半包卡死。放开之后,沙箱也能打到云元数据 169.254.169.254 和控制面。两件事一起发生。沙箱空闲 TTL 默认 900 秒,单次 Jupyter /execute 默认 120 秒,还要落在 /api/chat 的 maxDuration = 300 里。引导程序里的 subprocess 超时会再减 5 秒,避免脚本把 HTTP 窗口吃满。
环境变量会挑着注入。业务 env 能进沙箱,CUBE_API_URL 和 CUBE_TEMPLATE_ID 也进,脚本可以判断自己在星悟里。OPENAI_API_KEY、CUBE_API_KEY、SKILL_SCAN_SECRET、搜索密钥,以及 PATH、NODE_、NEXT_ 这类宿主机现场,一律跳过。想追加,用 SKILL_SANDBOX_ENV 传一段 JSON 对象。
会话沙箱复用
MicroVM 冷启动贵。星悟落地的是当前 Node 进程里按 conversationId 复用,还没有用户级池。浏览器随请求带上这个 ID,服务端只截到 128 字符,不拿它做勾选或授权。同一会话里多次 skill_run_script 或 skilltool_* 共用一台 MicroVM,/tmp/xingwu-skill 和家目录都还在。社区包常见的 Device Auth,device_code 可以落到磁盘,下一轮接着轮询,不必在单次 120 秒窗口里干等十五分钟。
ts
const sessionSandboxes = new Map<string, { expiresAt: number; sandbox: CubeSandbox }>();

async function acquireSandbox(conversationId?: string) {
  if (!conversationId) return { ephemeral: true, sandbox: await createCubeSandbox() };
  const cached = sessionSandboxes.get(conversationId);
  if (cached && cached.expiresAt > Date.now()) return { ephemeral: false, sandbox: cached.sandbox };
  if (cached) sessionSandboxes.delete(conversationId);
  const sandbox = await createCubeSandbox();
  sessionSandboxes.set(conversationId, {
    expiresAt: Date.now() + getCubeSandboxTimeoutSec() * 1000,
    sandbox,
  });
  return { ephemeral: false, sandbox };
}没有会话标识就当一次性沙箱,finally 里 DELETE。有标识则把 TTL 写成 CUBE_SANDBOX_TIMEOUT_SEC,默认 900 秒,同时交给 CubeAPI 的 timeout。换对话或 TTL 到期,磁盘状态一起丢,跨会话的 ~/.beatra 留不住。多 worker 各握一份内存表,进程重启映射也丢。
技术方案还写了驱逐后重建。缓存里的沙箱若已被 Cube 杀掉,执行打出 404 / 502 时丢掉缓存再 create 一次。Jupyter 没就绪时对 502 / 503 做短退避。这些客户端还没写成代码,现在失败会直接回到工具结果。
为什么不先做用户级复用
CubeSandbox 和 E2B 控制面已经把用户级铺好了。创建时带 metadata={"user_id": ...},空闲走 on_timeout=pause,下次 Sandbox.connect(sandboxId) 或 auto_resume 把 VM 快照唤醒。sandbox_id 绑到登录身份上,pause 保内存和磁盘,CPU 释放掉。星悟没接这套 API。
两边的账不难算。
会话复用的好处很具体。同一轮对话里多次跑脚本,Device Auth 的 device_code 还在磁盘上,下一轮接着轮询。换一个对话,沙箱拆掉,上一轮 Skill 留下的文件不会跟到下一轮。实现就是进程里一张 Map,没有用户表,也不用管 pause 快照和恢复配额。代价也清楚。新开一段对话仍要付冷启动。conversationId 来自浏览器,抄一个 ID 就能撞上同一台沙箱,并发还会争用同一工作目录。进程一重启,映射就没了。
用户级反过来。跨对话能留住 ~/.beatra、pip 缓存、已经装过的包,空闲时 pause,下次少付一次完整创建。长时间挂着的沙箱也把污染面拉长。同一人先后跑两个 Skill,后一个能看见前一个写在磁盘上的东西。要有可靠的用户身份,星悟现在没有登录。pause 之后 Cube 默认仍把暂停沙箱计成占用,比值调大了,唤醒还可能 409。控制面、身份表、残留文件约定,缺一块都会把「省冷启动」变成另一摊运维。
星悟是内部 chatbot,并发量不高。同时活着的对话有限,CVM 上多几台短寿命 MicroVM 扛得住。会话复用已经挡住同一轮里反复创建的那一截。用户级那笔账,要等并发真把冷启动打疼了,再接到身份上。
CubeProxy 按虚拟 Host 把流量打进对应 MicroVM。Node 自带 fetch 会丢掉我们设的 Host,客户端改成 node:http / node:https,需要时把 host 头写回去。执行超时、控制面超时分开配。销毁失败不能盖住脚本结果。
引导程序里,文本资源在 chatbot 侧转 base64,扫描时已是二进制的就原样带上。沙箱里解码落盘。解释器 argv 由平台拼,不经 shell。stdin、超时、环境变量一并写进这段 Python。
python
for key, value in env_overlay.items():
  os.environ[str(key)] = str(value)
root = pathlib.Path('/tmp/xingwu-skill')
root.mkdir(parents=True, exist_ok=True)
for item in files:
  path = root / item['relativePath']
  path.parent.mkdir(parents=True, exist_ok=True)
  path.write_bytes(base64.b64decode(item['content']))
suffix = pathlib.Path(entry).suffix.lower()
command = {'.py': ['python3'], '.js': ['node'], '.ts': ['node', '--experimental-strip-types'], '.rb': ['ruby']}.get(suffix)
if suffix == '.sh':
  first = (root / entry).read_text(errors='replace').splitlines()[:1]
  command = ['sh'] if first and first[0].strip() == '#!/bin/sh' else ['bash']
completed = subprocess.run(
    command + [entry] + args,
    cwd=root,
    input=stdin_text or None,
    capture_output=True,
    text=True,
    shell=False,
    timeout=timeout_sec,
)
timeout_sec 来自 CUBE_EXECUTE_TIMEOUT_MS 换算后再减 5。stdout 截断上限是 256000 字符。解释器不在镜像里时,引导程序抓住 FileNotFoundError,打出「沙箱模板未提供所需运行时」。JS 后来就撞上了这句。
社区 Skill 包的第二形态
社区的 Skill 包不只有 "一个包配一个脚本" 这一种形态。很多包会在 SKILL.md 的 YAML 里声明一组 tools,然后只放一个默认入口脚本,靠第一个参数分发 ------ 就像同一个命令的不同子命令,git commit、git push 背后是同一个二进制。
星悟为了让这种社区包也能跑,需要把声明里的每个工具都包装(frontmatter)成一个模型可见的函数 skilltool_*,背后还是同一台沙箱。
星悟把这种包也接进来了。声明里出现的每个工具,会被封装成一个函数挂给模型,最多 40 个,命名是 skilltool_{skillName}_{toolName}。入口脚本按 scripts/main.py、main.py、scripts/mcp_client.py 的顺序找,谁存在就用谁;args 和 stdin 都传 "工具名 + 一段 JSON"。三个位置都找不到默认可执行脚本,这个工具就不挂载。
对模型来说,它调的就是一个普通工具,没有感知差异。对星悟来说,背后还是同一个沙箱、同一条执行路径 ------ 跟 skill_run_script 没有本质区别,只是多了一层 "工具名 → 入口脚本" 的分发。
Skill 自带 HTTP MCP
Skill 可以自带知识源。包里的 manifest.json 或 _meta.json 如果声明了 mcp.url、mcpServers,勾选这个 Skill 之后,那个远程 MCP 自动进入本轮知识源。嵌套路径里的 manifest.json 也会读。只认 HTTP/SSE,没有 url 或只带 command 的配置直接丢掉。
星悟不会去读 credential_file,也不会把 Device Token 塞进请求头。需要登录的服务,走包内脚本。Device Auth 那种流程,脚本把审批 URL 打到 stdout,用户在自己浏览器里点 Allow,再跑一次。自动挂上的 MCP 别当成已登录。
编辑器与发现
用户 Skill 的入口从单一粘贴扩成三种。粘贴 Markdown、导入文件夹、导入 zip 都行,扫描接口接受 resources[]。目录名也不必等于 frontmatter 的 name,同名冲突时内置优先。内置包里多了 sandbox-smoke 和 hot-topic-content-maker,一个测沙箱,一个拿真实流程演示社区包要怎么在星悟里跑。
stdio MCP 在 chatbot 侧零改传输栈。校验层继续拒绝 command / args。运营方在同一台 CVM 上用 systemd 拉起只读 Server,sidecar 转成内网 HTTP。星悟仍然只连已经转好的 url。sidecar 还没作为常驻服务落地,能拿出来对代码的,主要是 Skill 脚本这条路。
用户上传先过扫描
导入入口放在输入框的 Skill 菜单里。用户可以粘贴 SKILL.md,选择文件夹,也可以上传 zip。文件夹和 zip 先在浏览器解包,正文、资源路径、资源编码与浏览器端算出的 SHA-256 一起发给 POST /api/skills/scan。服务端不保存这份内容,扫描通过前也不会写入 IndexedDB。
扫描这一层做的是结构、边界与完整性校验,别把它说成杀毒。它不会在导入时运行 Python、bash、Node 或包里的其它脚本。脚本真正执行仍然发生在后面的 CubeSandbox MicroVM。
服务端用 validateUserSkill 做几件具体的事。
- 只接受
source: "user"的 Skill。 - 解析
SKILL.md的 YAML frontmatter,用正文里声明的name和description覆盖浏览器传来的同名字段。 - 资源最多 200 个。每个资源不得超过 8MB。
- 资源路径只能是包内相对路径。绝对路径、反斜杠、目录穿越、过深目录,以及
node_modules、.git这一类目录都会被拒绝。 - 每个资源都要复算 SHA-256。正文哈希也要和浏览器提交的
contentSha256一致。 - 同一包里不允许重复的资源路径。二进制资源只能按 base64 形式带进来。
这套校验可以压成下面这段算法。先解析正文拿到真正的目录信息,再一项项收紧资源边界。最后回头复算正文哈希。客户端带来的 name、description 只算提示,没资格决定服务器记录什么。
已校验 resources 与正文
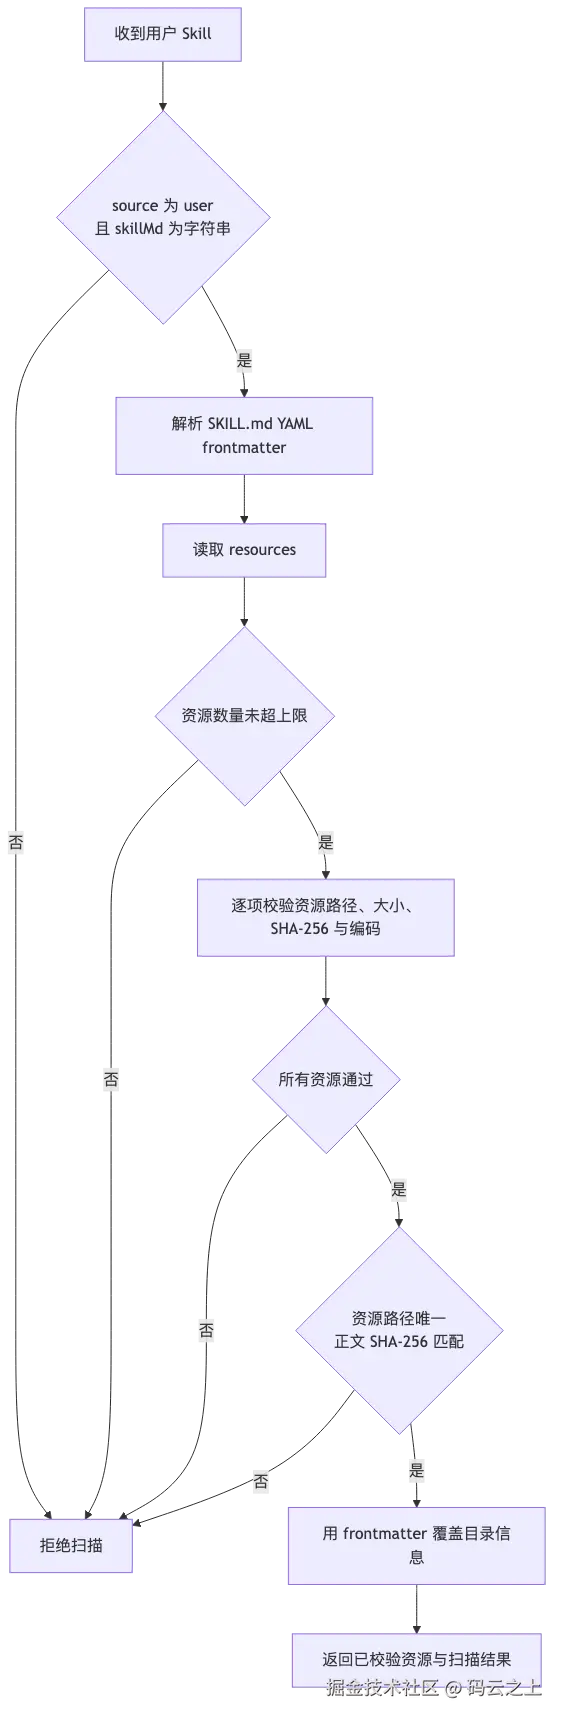
接口本身没有两套状态。校验通过就签发证明,失败就统一返回 400。正文不会进数据库。
ts
export const POST = withRequestLogging("/api/skills/scan", async (request, context) => {
  try {
    const body = (await request.json()) as { skill?: unknown };
    const skill = validateUserSkill(body.skill);

    return Response.json({
      manifest: {
        contentSha256: skill.contentSha256,
        description: skill.description,
        name: skill.name,
        source: skill.source,
        version: skill.version,
      },
      attestation: issueSkillAttestation(skill.contentSha256),
      resources: skill.resources.map((resource) => ({
        contentSha256: resource.contentSha256,
        relativePath: resource.relativePath,
      })),
      scannerVersion: SKILL_SCANNER_VERSION,
    });
  } catch (error) {
    logError("skills.scan.failed", error, { requestId: context.requestId });
    return Response.json(
      { error: error instanceof Error ? error.message : "Skill 扫描失败。" },
      { status: 400 },
    );
  }
});
这一步过了,扫描接口只回传从正文重新解析出的目录项、资源摘要、扫描器版本和一张证明。证明是服务端用 HMAC 签出的短期票据,绑定正文哈希和扫描器版本,默认 24 小时过期。浏览器保存的用户 Skill 会带上这张票据。
之后每次对话,服务端还会再验一次。用户包只有同时满足已选中、正文哈希匹配、证明签名正确且未过期,才会进入本轮 Skill 会话。改过 SKILL.md、重新导入资源或票据过期,都不能拿旧证明蒙混过关。
证明内容不复杂。它把正文哈希、过期时间和扫描器版本序列化后签名。对话请求回来时,先比对签名,再比对哈希、版本和时间。证明里没有正文,正文仍由浏览器按需携带。
ts
export function issueSkillAttestation(contentSha256: string): string {
  const payload = {
    contentSha256,
    expiresAt: Date.now() + 24 * 60 * 60 * 1000,
    scannerVersion: "v1",
  };
  const encoded = Buffer.from(JSON.stringify(payload)).toString("base64url");
  return `${encoded}.${sign(encoded)}`;
}

export function verifySkillAttestation(contentSha256: string, value: unknown): boolean {
  if (typeof value !== "string") return false;
  const [encoded, signature, extra] = value.split(".");
  if (!encoded || !signature || extra) return false;
  const expected = sign(encoded);
  if (
    signature.length !== expected.length ||
    !timingSafeEqual(Buffer.from(signature), Buffer.from(expected))
  ) {
    return false;
  }
  try {
    const payload = JSON.parse(Buffer.from(encoded, "base64url").toString("utf8"));
    return (
      payload.contentSha256 === contentSha256 &&
      payload.expiresAt > Date.now() &&
      payload.scannerVersion === "v1"
    );
  } catch {
    return false;
  }
}
编辑器的状态也按这个顺序走。导入包后自动显示"星悟正在后台扫描",通过后才出现"保存 Skill"。用户手动改正文会立即清掉通过状态。扫描失败会展示服务端返回的原因,保存按钮也不会出现。这样本地浏览器里不会留下一个表面上导入成功、实际从未通过星悟校验的包。
输入框里的 @ Skill
常驻勾选解决的是哪些 Skill 可以给模型用,@ 解决的是这一句话明确要用哪一个。
输入框检测到行首或空白后的 @,会打开全部可用 Skill 的候选列表。它不是只列当前勾选项。内置 Skill 和已经扫描保存的用户 Skill 都能出现,同名时仍由内置包优先。用户继续输入名称时,候选项按 name 前缀过滤。点击后,输入文本保留成 @skill-name,同时把该 Skill 标记为启用。
发送消息时,resolveMessageSkills 会把两路选择合在一起。
- 输入区已经勾选的常驻 Skill。
- 当前消息里符合命名规则的
@skill-name。
引用到的 Skill 会随当前请求进入 skillBundle.selected。用户 Skill 还要携带正文、资源和扫描证明,内置 Skill 只带名称。服务端按名称、来源和用户包哈希重新选包,避免浏览器伪造别人的内容或让同名用户包盖掉内置包。
@ 匹配故意写得很窄,只接收小写字母、数字和连字符。这样一个邮箱、普通中文 @ 符号或带路径的字符串,不会被误当成 Skill。已经勾选的常驻项先入表,消息里的 @name 再补进去。同名冲突时复用内置包优先的规则。
ts
export function resolveMessageSkills(
  text: string,
  selectedSkills: SkillCatalogEntry[],
  availableSkills: SkillCatalogEntry[],
): SkillCatalogEntry[] {
  const selected = indexSkillsByPreferredName(selectedSkills);
  const byName = indexSkillsByPreferredName(availableSkills);

  for (const match of text.matchAll(/(?:^|\s)@([a-z0-9]+(?:-[a-z0-9]+)*)/gi)) {
    const skill = byName.get(match[1].toLowerCase());
    if (skill) {
      selected.set(
        skill.name,
        preferSkillOnNameConflict(selected.get(skill.name), skill),
      );
    }
  }

  return [...selected.values()].slice(0, MAX_ENABLED_SKILLS);
}
输入框那一边只做交互,不在组件里决定权限。光标后面出现 @ 时,它从全量可用目录中过滤候选。用户点中条目后,正则只替换最后一个未完成的 @ 片段,保留前面的自然语言。
ts
const mentionMatch = currentValue.match(/(?:^|\s)@([a-z0-9-]*)$/i);
const mentionQuery = mentionMatch?.[1]?.toLowerCase();
const skillHints =
  mentionQuery === undefined
    ? []
    : skillMentions.filter((skill) =>
        skill.name.toLowerCase().startsWith(mentionQuery),
      );

function applySkillMention(name: string) {
  const next = currentValue.replace(
    /(?:^|\s)@[a-z0-9-]*$/i,
    (matched) => `${matched.startsWith(" ") ? " " : ""}@${name} `,
  );
  controller?.textInput.setInput(next);
  onSkillMention?.(name);
}
模型一开始只看到已勾选 Skill 的短目录,目录里只有名称和描述。一般任务是否加载某条 Skill,仍由模型根据描述判断。用户明确写了 @skill-name 则是另一层语义,系统提示要求先读取该 Skill 的完整工作说明,再按其中流程完成任务。
这一层没有把"强制工具调用"当成所有模型都能守住的前提。星悟会按模型和协议做一次轻量探测,确认它确实能遵守指定工具调用后,才在首步强制 skill_load。探测失败、超时或兼容网关不支持时,仍将该 Skill 置为可用,并依靠模型指令自行加载。这样 GLM 一类不遵守 required tool choice 的网关不会因为没发出函数调用而整轮报错。
模型调用 skill_load 之后才拿到正文。若正文要求读模板、参考资料或脚本,再按需调用 skill_read_resource、skill_run_script 或 frontmatter 声明的 skilltool_*。没被勾选的 Skill 即使模型能从目录里看到,也会被工具层拒绝。正文里的话同样不能覆盖系统约束、用户的明确要求和权限边界。
踩坑,官方模板没有 Node
官方 sandbox-code 模板是给代码解释器用的。Python 3.12、bash、Jupyter、envd 都在,没有 Node。
社区 Skill 里 .js / .ts 很常见。旧模板上跑 scripts/foo/bar.js,引导程序去找 node,直接 FileNotFoundError。工具结果就是上面那句「沙箱模板未提供所需运行时」。Python 和 bash 的冒烟脚本能过,JS 过不去。问题不在扫描,也不在路径校验,就是镜像里缺运行时。
从零做一份镜像,要自己处理 envd、入口脚本、探活端口。CubeSandbox 的「自定义模板镜像」教程写了另一条路。在现有镜像上叠一层,不要动人家的 ENTRYPOINT / CMD。官方镜像已经把 Jupyter 起在 49999、envd 起在 49983。我们只要把 Node 放进去就行。
说干就干,最终 Dockerfile 只有一层。基础镜像是官方的 sandbox-code:latest。Node 用官方 linux-x64 二进制包解进 /usr/local,版本钉在 22.17.0,.ts 才能走 node --experimental-strip-types。构建结束时在镜像里跑一次 node -v 和 python3 --version,确认两个运行时都在。
dockerfile
FROM <registry>/cube-sandbox/sandbox-code:latest

ARG NODE_VERSION=22.17.0
RUN apt-get update \
    && apt-get install -y --no-install-recommends ca-certificates xz-utils \
    && curl -fsSL "https://nodejs.org/dist/v${NODE_VERSION}/node-v${NODE_VERSION}-linux-x64.tar.xz" \
        | tar -xJ -C /usr/local --strip-components=1 \
    && apt-get purge -y xz-utils \
    && rm -rf /var/lib/apt/lists/* \
    && node -v \
    && python3 --version
镜像造出来,还要让 CubeMaster 拉得到。先试过推 Docker Hub,拉取超时。后来在 CVM 上起了一个明文 HTTP Registry。Cube 文档写得很清楚,明文 HTTP 镜像引用必须带 http:// 前缀,例如 http://my-registry.example.com/my-team/my-sandbox:v1。漏掉这个前缀,CubeMaster 会按 HTTPS 或 Docker Hub 去解析,模板会卡在拉取。推送还要把 OCI mediatype 关掉,改成 Docker schema2,否则 Registry 和 Cube 对不上。
创建模板时把 Jupyter 和 envd 的端口一起暴露,探活走 49999 的 /health,别去改官方入口。
bash
cubemastercli tpl create-from-image \
  --image "http://${REGISTRY}/xingwu/sandbox-code-node:22" \
  --alias sandbox-code-node \
  --writable-layer-size 2Gi \
  --expose-port 49999 \
  --expose-port 49983 \
  --probe 49999 \
  --probe-path /health
新模板 READY 之后,沙箱里 python3 --version 是 3.12.12,node -v 是 v22.17.0。chatbot 把 CUBE_TEMPLATE_ID 指到这份模板,JS 才有解释器可调。
05 小结
KVM 和控制面可以买现成的。星悟花时间的地方,是模型永远碰不到任意代码字段,解释器永远不进 Next.js,官方镜像缺什么就自己叠一层。
会话复用已经挡住同一轮对话里反复创建的那一截。星悟是内部 chatbot,并发不高,用户级 pause / connect 先不接。驱逐后重建和 stdio sidecar 也还没落地...脚本能跑就行^_^。