一.软件安装包
1.Linux 安装软件
共有3中方法:
- 源码安装(烦)
- 软件包安装(容易产生软件包互相依赖问题)
- 包管理器(推荐),自动解决依赖问题;Centos使用yum,Ubuntu使用apt
2.软件包管理器
安装软件过程:(找到下载链接)网络下载→安装(拷贝), 安装软件,必须要有root权限,软件安装到系统里,只安装一次,任何人都可以使用。
链接获取:官方发布的软件以及社区成员自己写的软件会上传到软件源服务器上,apt获取软件包时,就会去这个软件源服务器上获取,在软件源服务器上就会获取到软件的下载链接。
服务器镜像:apt通过配置文件来确定要访问的软件源服务器或镜像源。主要的配置文件是/etc/apt/sources.list(标准源),以及/etc/apt/sources.list.d/(扩展源)目录下的文件
3.具体操作
1.查看软件包
使用apt list, 由于包的数⽬可能⾮常之多, 这⾥我们需要使⽤ grep 命令只筛选出我们关注的包
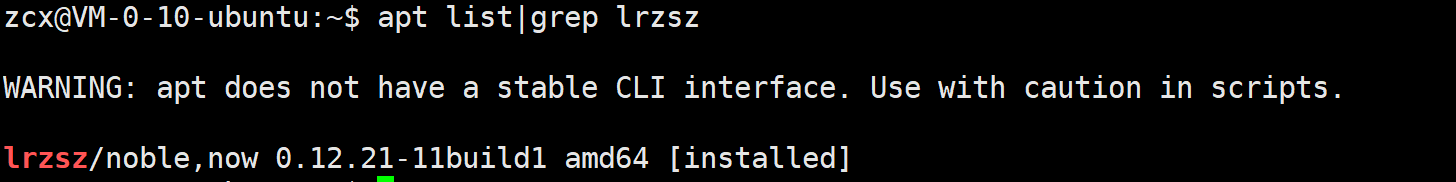
软件包名称: 主版本号.次版本号.源程序发⾏号-软件包的发⾏号.主机平台.cpu架构.
•
"x86_64" /amd64后缀表⽰64位系统的安装包, "i686" 后缀表⽰32位系统安装包. 选择包时要和系统匹配.
2.安装软件
apt install -y 软件名
- yum/apt 会⾃动找到都有哪些软件包需要下载, 这时候敲 "y" 确认安装.
- 出现 "complete" 字样或者中间未出现报错, 说明安装完成
- 安装软件时由于需要向系统⽬录中写⼊内容, ⼀般需要 sudo 或者切到 root 账⼾下才能完成.
-
yum/apt安装软件只能⼀个装完了再装另⼀个. 正在yum/apt安装⼀个软件的过程中, 如果再尝试⽤ yum/apt安装另外⼀个软件, yum/apt会报错.
3.卸载
sudo apt remove -y 软件名
-
二.vim
在window中,常用的c++编译器如vs2022,其实vs2022是集代码编辑,代码调试,代码编译...为一身的集成开发环境。
在Linux中,使用vim,vim是一种多模式编辑器
1.五大基本模
1.正常/普通/命令模式(Normal mode)
打开vim,进入的默认是命令模式。控制屏幕光标的移动,字符、字或⾏的删除,移动复制某区段及进⼊Insert mode下,或者到 last line mode
2.插⼊模式(Insert mode)
只有在Insert mode下,才可以做⽂字输⼊
3.末⾏模式(last line mode)
⽂件保存或退出,也可以进⾏⽂件替换,找字符串,列出⾏号等操作。
4.视图模式
用于对文本块进行选择、复制、删除等批量操作
5.替换模式
用于逐个或全部替换指定位置的字符
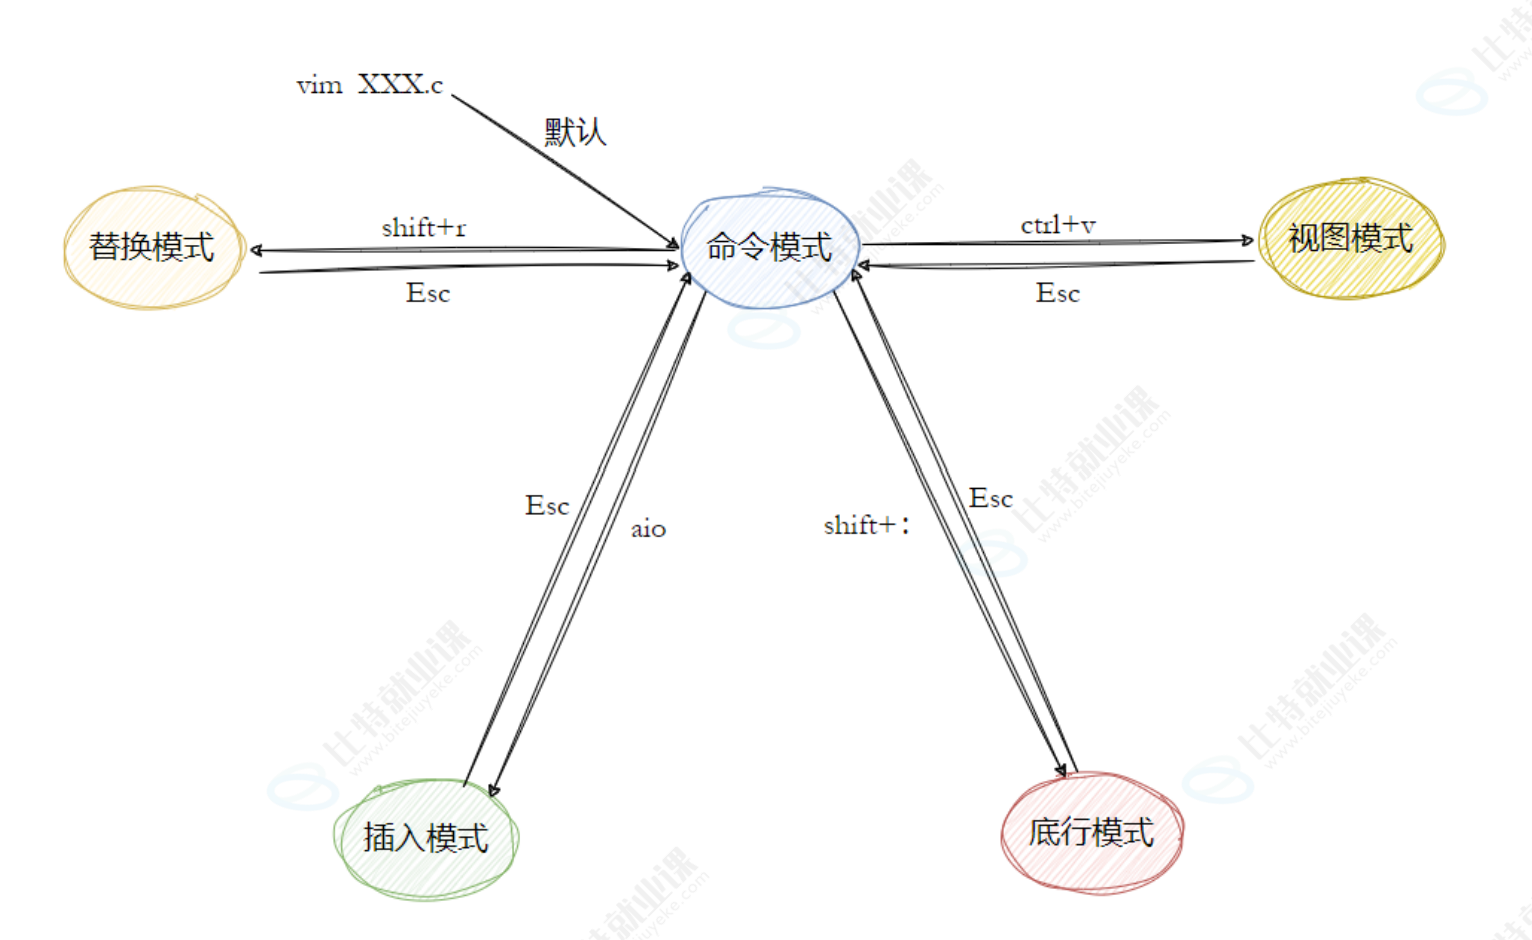
(注意:图中命令模式到底行模式是shift+;即:)
2.各板块的操作
1.正常模式
进入插入模式
|---|------------------------|
| a | 按"i"是从光标当前位置开始输⼊⽂件 |
| i | 是从⽬前光标所在位置的下⼀个位置开始输⼊⽂字 |
| o | 是插⼊新的⼀⾏,从⾏⾸开始输⼊⽂字 |
移动光标
以下大部分操作都可以在输入前先输入一个数字n代表移动n次,即:移动到第n个。
1.上下左右 :h:左,j:下,k:上,l:右
2.行间移动 : gg:移动到第一行, shift + g:移动到最后一行, n + shift + g:移动到第n行(按完n,再一起按shift + g)
3.行内移动 :$:该行结尾,^:该行开头
4.按单词移动 :w后一个单词开头,b前一个单词开头,e后一个单词结尾,
5.CTRL+b f u d:分别是屏幕往后/前一页,后前半页
删除文字
|-------|------------------------------------|
| 「x」 | 每按⼀次,删除光标所在位置的⼀个字符 |
| 「#x」 | 例如,「6x」表⽰删除光标所在位置的"后⾯(包含⾃⼰在内)"6个字符 |
| 「X」 | ⼤写的X,每按⼀次,删除光标所在位置的"前⾯"⼀个字符 |
| 「#X」 | 例如,「20X」表⽰删除光标所在位置的"前⾯"20个字符 |
| 「dd」 | 删除光标所在⾏ |
| 「#dd」 | 从光标所在⾏开始删除#⾏ |
可以与p配套使用
复制
|-------|---------------------------------------------------------|
| 「yw」 | 将光标所在之处到字尾的字符复制到缓冲区中。 |
| 「#yw」 | 复制#个字到缓冲区 |
| 「yy」 | 复制光标所在⾏到缓冲区。 |
| 「#yy」 | 例如,「6yy」表⽰拷⻉从光标所在的该⾏"往下数"6⾏⽂字。 |
| 「p」 | 将缓冲区内的字符贴到光标所在位置。注意:所有与"y"有关的复制命令都必须 与"p"配合才能完成复制与粘贴功能。 |
替换
「r」:替换光标所在处的字符。
「R」:替换光标所到之处的字符,直到按下「ESC」键为⽌。(替换模式,进行批量化替换)
大小写替换:Ctrl + ~
撤销上⼀次操作
「u」:如果您误执⾏⼀个命令,可以⻢上按下「u」,回到上⼀个操作。按多次"u"可以执⾏
多次回复。
「ctrl + r」: 撤销的恢复(撤销u)
查找 :按 / 后输入要查找的内容,按回车键开始向后查找,按 n 查找下一个匹配项,按 N 查找上一个匹配项。(或者#:向上查找当前光标所在的单词)
更改
「cw」:更改光标所在处的字到字尾处
「c#w」:例如,「c3w」表⽰更改3个字
跳⾄指定的⾏
「ctrl」+「g」列出光标所在⾏的⾏号。
「#G」:例如,「15G」,表⽰移动光标⾄⽂章的第15⾏ ⾸。
2.底行模式
在正常模式下按:进入底行模式
-
列出行号 「set nu」: 输⼊「set nu」后,会在⽂件中的每⼀⾏前⾯列出⾏号。
-
set nonu:取消行号
-
「#」:「#」号表⽰⼀个数字,在冒号后输⼊⼀个数字,再按回⻋键就会跳到该⾏了,如输⼊数字 15,再回⻋,就会跳到⽂章的第15⾏。
-
查找:
: 先按「/」或者「?」键,再输⼊您想寻找的字符,如果第⼀次找的关键字不是您想要的,可以 ⼀直按「n」会往后寻找到您要的关键字为⽌。 -
保存⽂件 「w」: 在冒号输⼊字⺟「w」就可以将⽂件保存起来 离开vim: 按「q」就是退出,如果⽆法离开vim,可以在「q」后跟⼀个「!」强制离开vim。
- 「wq」:⼀般建议离开时,搭配「w」⼀起使⽤,这样在退出的时候还可以保存⽂件。
tip:如果是新文件且什么都没写的话,按q文件没建成,wq文件建成 %s /dst/src/[g/i]:用src替换dst,g/i可选,g:全局替换,i忽略大小写替换! 外部命令:无须退出vim,直接执行外部命令vs new_src:分屏操作,这时候,光标在哪里,就是对哪个文件操作。用ctrl +ww实现切换光标所在的屏幕
3.插入模式
编辑的地方,
shift + i进入:光标会移动到行首i进入:光标不会移动4.视图模式
按Ctrl +v进入视图模式,主要用于区域选择,进行区域操作。
如,进行区域注释:
- 进入视图模式后,hjkl进行区域选择
- 按shift + i直接切换到插入模式
- 输入//,进行注释
- 再Esc回到命令模式,就会批量注释之前区域选择的行(相当于是在所选的行内都执行了输入//的那一行的操作)
上述操作一般用于插入数据,删除:
- Ctrl + v进入视图模式
- 选中要删除的内容
- 按d
三.编译器gcc/g++
1.背景知识
一份代码变成一个可执行程序的步骤:预处理→编译→汇编→链接
预处理:
预处理的本质是修改编辑文本代码,功能包括: 宏定义,⽂件包含,条件编译,去注释。
预处理指令是以#号开头的代码⾏。
e.g:
gcc --E hello.c --o hello.i选项"-E",该选项的作⽤是让 gcc 在预处理结束后停⽌编译过程。
选项"-o"是指⽬标⽂件,".i"⽂件为已经过预处理的C原始程序。(如果不写目标文件,则打印在屏幕上)
补充讲解:
1.条件编译的作用cpp#include <stdio.h> // 判断操作系统类型 #ifdef _WIN32 #define PLATFORM "Windows" #elif __APPLE__ #define PLATFORM "Mac OS" #elif __linux__ #define PLATFORM "Linux" #else #define PLATFORM "Unknown" #endif int main() { printf("This program is running on %s.\n", PLATFORM); return 0; }- 软件经行专业度,收费情况经行区分,使用条件编译可以对代码经行动态裁剪
- 内核源代码也是条件编译经行代码裁剪
- 用于多平台下的应用软件
编译(生成汇编)
在这个阶段中,gcc ⾸先要检查代码的规范性、是否有语法错误等,以确定代码的实际要做的⼯作, 在检查⽆误后,gcc 把代码翻译成汇编语⾔。
⽤⼾可以使⽤"-S"选项来进⾏查看,该选项只进⾏编译⽽不进⾏汇编,⽣成汇编代码。cppgcc --S hello.i --o hello.s补充讲解:编译器的自举
- 先用汇编语言写一个简单的C语言的编译器
- 然后用这个编译器编译一个用C语言写的更完整的C语言编译器的源代码,形成新的编译器
- 然后再用新生成的编译器再次编译自身的源代码,得到一个更新的编译器
汇编(⽣成机器可识别代码)
汇编阶段是把编译阶段⽣成的".s"⽂件转成⽬标⽂件,可使⽤选项"-c"就可看到汇编代码已转化为".o"的⼆进制⽬标代码(可重定位目标文件)
cppgcc --c hello.s --o hello.o补充讲解:
语言的发展是从:开关控制→打孔编程→汇编语言→高级语言
但是,编译的过程却是一个逆向的过程。各大高级语言都先翻译为汇编语言再变为机器语言,而不是直接变为机器语言
链接
在成功编译之后,就进⼊了链接阶段。
实例: gcc hello.o --o hello
注意:汇编后虽然是机器语言了,但是不能直接运行,因为预处理的头文件展开只是展开函数声明,此时缺乏链接操作,无法找到函数调用的地址
tip:一般多个文件先统一生成.o文件,方便统一打包和自由组合2.gcc/g++的编译选项
gcc只能编译C语言,g++都可,两者用法,选项一样
gcc 选项 要编译的⽂件 选项 ⽬标⽂件
选项:(了解即可)- -E 只激活预处理,这个不⽣成⽂件,你需要把它重定向到⼀个输出⽂件⾥⾯
- -S 编译到汇编语⾔不进⾏汇编和链接
- -c 编译到⽬标代码
- -o ⽂件输出到 ⽂件
- -static 此选项对⽣成的⽂件采⽤静态链接(前提是有静态库)
- -g ⽣成调试信息。GNU 调试器可利⽤该信息。
- -shared 此选项将尽量使⽤动态库,所以⽣成⽂件⽐较⼩,但是需要系统由动态库.
- -O0
- -O1
- -O2
- -O3 编译器的优化选项的4个级别,-O0表⽰没有优化,-O1为缺省值,-O3优化级别最⾼
- -w 不⽣成任何警告信息。
- -Wall ⽣成所有警告信息。
- -D(命令行宏定义)
方法:在gcc语句后加-D宏名=宏值(若不指定宏值,默认为1)
如,code.c加宏定义#define M 100:
gcc code.c -o code.exe -DM=100
如果在 code.c 中已经有 #define M 100,同时又使用 -DM=100 进行命令行宏定义,那么命令行的宏定义会覆盖源文件中的宏定义。
3.动/静态库和动/静态链接
Linux下,动态库XXX.so, 静态库XXX.a
Windows下,动态库XXX.dll, 静态库XXX.lib
Linux 中库的命名规则是:前缀lib+库名称+.so / .a后缀
库
系统把(如printf的)函数实现都被做到名为 libc.so.6 的库⽂件中去了,在没有特别指定
时,gcc 会到系统默认的搜索路径"/usr/lib"下进⾏查找,也就是链接到 libc.so.6 库函数中去,这样
就能实现函数"printf"了,⽽这也就是链接的作⽤
静态库
静态库是指编译链接时,把库⽂件的代码全部加⼊到可执⾏⽂件中,因此⽣成的⽂件⽐较⼤,但在运 ⾏时也就不再需要库⽂件了。其后缀名⼀般为".a"。 优点:依赖度小,缺点:体积大
动态库
动态库与之相反,在编译链接时并没有把库⽂件的代码加⼊到可执⾏⽂件中,⽽是在程序执⾏时由 运⾏时链接⽂件加载库,这样可以节省系统的开销。动态库⼀般后缀名为".so",如前⾯所述的
libc.so.6 就是动态库。gcc 在编译时默认使⽤动态库。完成了链接之后,gcc 就可以⽣成可执⾏⽂ 件,如下所⽰。 gcc hello.o --o hello。 优点:体积小,缺点:依赖度大
执行目标方法时,需要跳到库中执行,完了再返回。本质时把语言层面的公共代码在内存中只出现一次
静态链接:
链接器会将静态库中被目标文件引用的代码部分直接拷贝到可执行文件中。(有多少个printf就要拷贝多少份)静态链接完成后,静态库在程序运行时就不再被依赖 ,可执行文件独立加载到内存 中运行,静态库不会被加载。动态链接:
链接器只会在可执行文件中记录所需动态库的名称和符号信息。(即不会将动态库的代码复制到可执行文件中)让程序能找到库中方法的地址。运行时,可执行文件和动态库都会被加载到内存中。遇到库函数时,通过符号解析和重定位找到库函数,进入库里面的函数内部运行,运行完后返回原来的程序。
补充:ldd
对于可执行的文件对象使用
ldd 文件名可以查看程序依赖的库。四.make/makefile(自动化构建)
首先明确:make是指令,makefile/Makefile是一个文件,两者搭配使用,实现自动化构建
1.基本使用
1先创建一个test.c文件
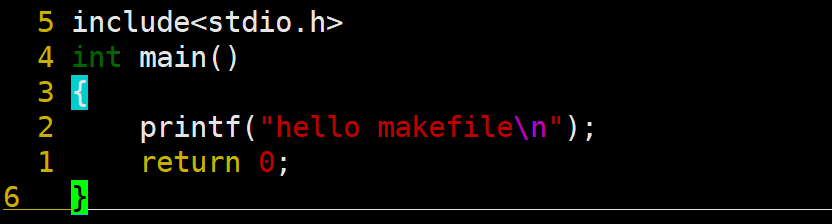
2 然后在当前目录下创建一个makefile文件
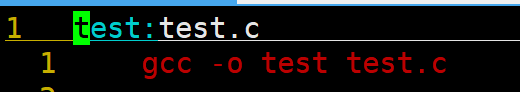
第一行:依赖关系
目标:依赖文件列表
第二行
【tab】依赖方法,即之前依赖关系的依赖方法
3在创建好makefile后,使用make使makefile中的依赖关系和依赖方法得以实现
如图:
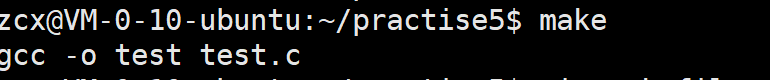
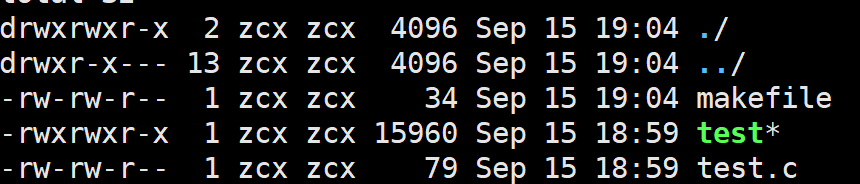
目录中多了test可执行程序
4 但是再一次make时会报错,如图
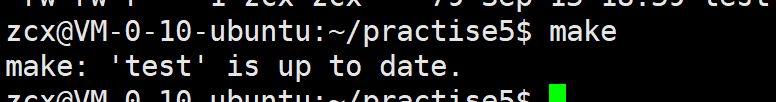
原因:1.默认老的代码不做新的编译
2.文件=内容(内容改变即modify时间改变)+属性(属性改变即change改变)
单纯查看软件access时间改变,(modify改变一般导致change改变)
3.Linux根据modify time判断是是老的代码
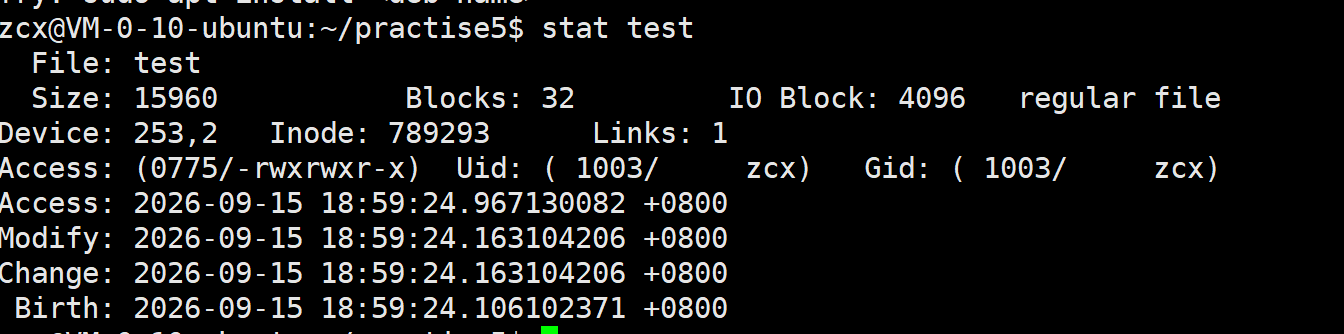
(如图,stat可以查看文件的三个时间)
- .PHONY修饰
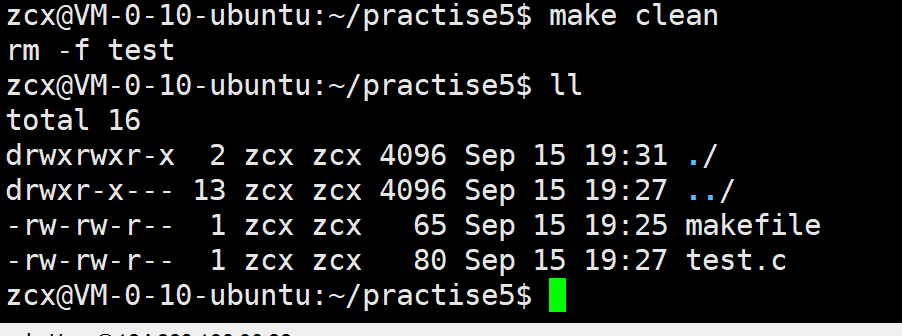
使用.PHONY修饰过的文件称为伪文件,特性是对应的依赖方法总被执行
如图
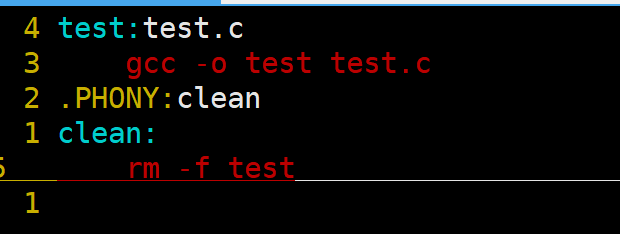
(注意不需要外部手动添加clean文件)
调用这条指令时,需要使用make clean
2.make如何工作
1.make会在当前⽬录下找名字叫"Makefile"或"makefile"的⽂件。
2.如果找到,它会找⽂件中的第⼀个⽬标⽂件(target),在上⾯的例⼦中,他会找到 test 这 个⽂件,并把这个⽂件作为最终的⽬标⽂件。
3.如果 test ⽂件不存在,或是 test 所依赖的后⾯的 test .o ⽂件的⽂件修改时间要 ⽐ test 这个⽂件新(可以⽤ touch 测试),那么,他就会执⾏后⾯所定义的命令来⽣成 test 这个⽂件。
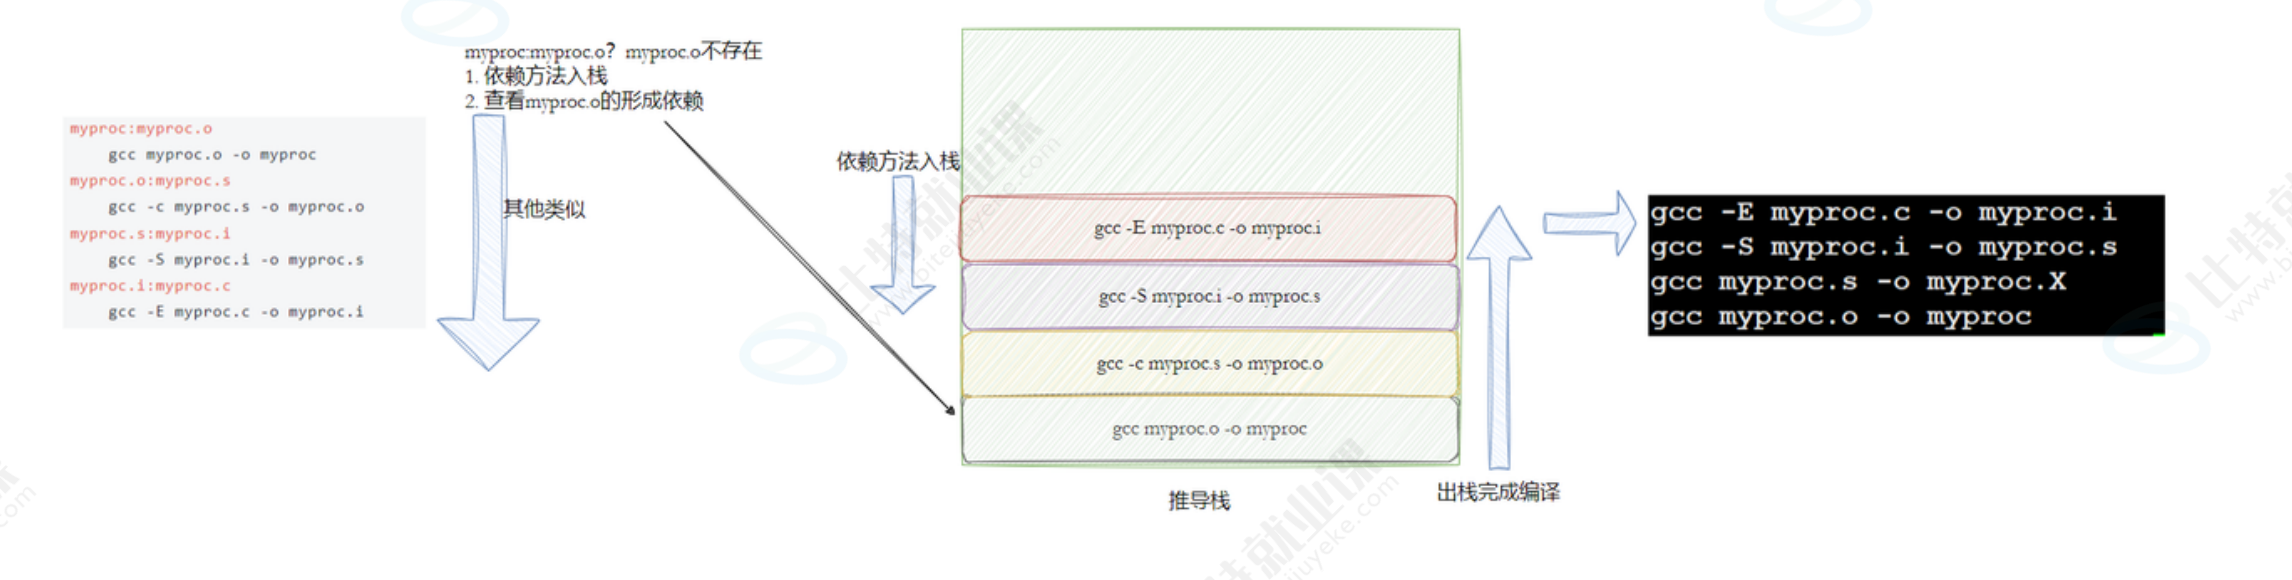
4.如果test 所依赖的 test.o ⽂件不存在,那么 make 会在当前⽂件中找⽬标为 test.o ⽂件的依赖性,如果找到则再根据那⼀个规则⽣成 test.o ⽂件。(这有点像⼀ 个堆栈的过程.5.当然,你的C⽂件和H⽂件是存在的啦,于是 make 会⽣成test.o ⽂件,然后再⽤ test.o ⽂件声明 make 的终极任务,也就是执⾏⽂件 hello 了。
6.这就是整个make的依赖性,make会⼀层⼜⼀层地去找⽂件的依赖关系,直到最终编译出第⼀个 ⽬标⽂件。 在找寻的过程中,如果出现错误,⽐如最后被依赖的⽂件找不到,那么make就会直接退出,并 报 错 , ⽽ 对 于 所 定 义的命令的错误,或是编译不成功,make根本不理。 make只管⽂件的依赖性,即,如果在我找了依赖关系之后,冒号后⾯的⽂件还是不在,那么对 不 起 , 我就 不⼯作啦。
3.扩展语法
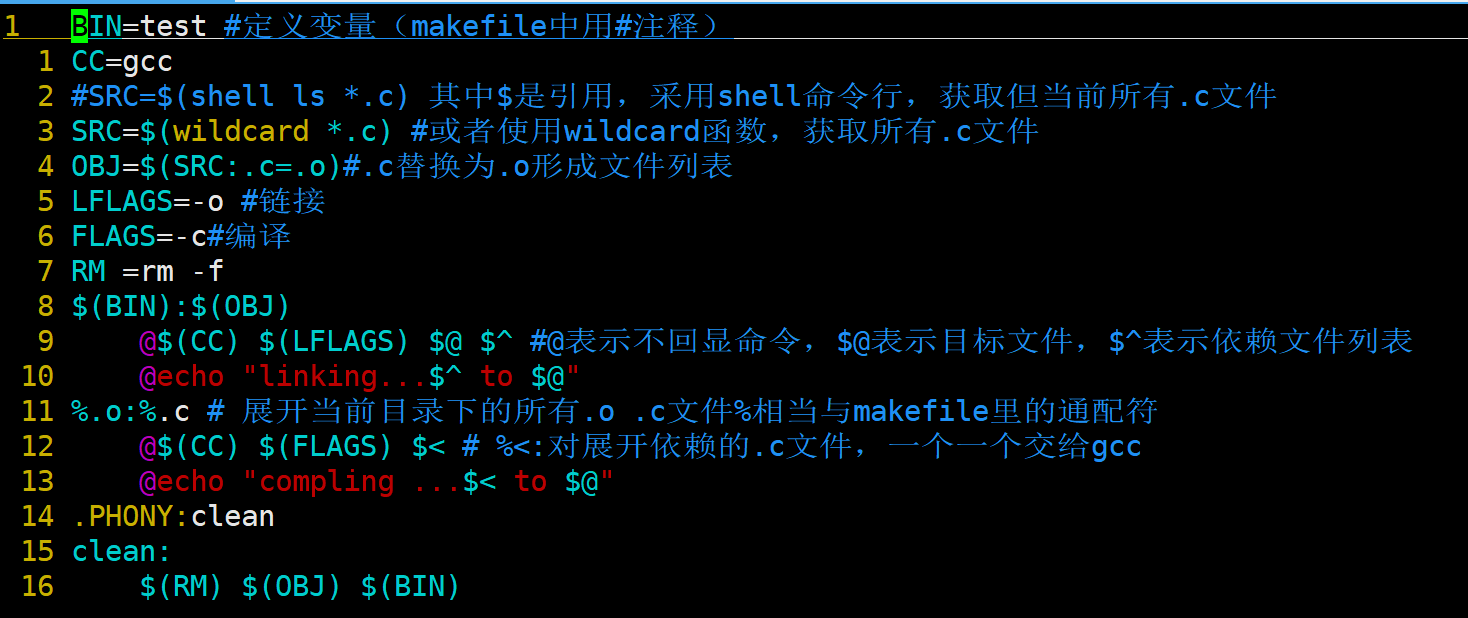
五.Linux第一个系统程序-进度条
1.准备知识
1.回车和换行
\r:回车,光标返回到行的开头\n:换行:光标移动到下一行(但不会自动回到开头位置)平时我们按下
Enter键的效果是:换到下一行的开始位置。但其实这是两个步骤:\r\n2.缓冲区
缓冲区是一块内存区域,用于在数据的产生者和使用者之间临时存储数据
C语言的
printf向显示器输出数据前,数据是先存到缓冲区的,当缓冲区被刷新时,数据才会输出到屏幕上在 C 语言中,标准输出(stdout)一般采用行缓冲或者全缓冲模式。
行缓冲:在这种模式下,遇到换行符(\n)或者缓冲区满时,缓冲区就会被刷新。
全缓冲:只有当缓冲区满、程序正常结束或者手动刷新缓冲区时,缓冲区才会被刷新。
手动刷新stdout缓冲区的方式:fflush(stdout)
当
printf输出12345到屏幕上的时候,实际上,输出的是字符类型的数据。2.先写一个简单的倒计时程序
cpp#define _CRT_SECURE_NO_WARNINGS 1 #include<stdio.h> #include<windows.h> int main() { int i = 10; while (i >= 0) { printf("%-2d\r", i);//左对齐 fflush(stdout); i--; Sleep(1000); } printf("\n"); return 0; }这是再Windows下写的,注意:
windows下
cpp#include <windows.h> Sleep(毫秒); // 大写S!Linux下
cpp#include <unistd.h> int main(){ sleep(1); // 休眠1秒 return 0; }3.具体代码
process.c
cppvoid FlushProcess(double total, double current) { char buffer[NUM]; memset(buffer, 0, sizeof(buffer)); const char *lable="|/-\\"; int len = strlen(lable); static int cnt = 0; // 不需要⾃⼰循环,填充# int num = (int)(current*100/total); // 11.0 / 1000 int i = 0; for(; i < num; i++) { buffer[i] = STYLE; } double rate = current/total; cnt %= len; printf("[%-100s][%.1f%%][%c]\r", buffer, rate*100, lable[cnt]); cnt++; fflush(stdout); }process.h
cpp#pragma once #include <stdio.h> void process_v1(); void FlushProcess(double total, double current);main.c
cpp$ cat main.c #include "process.h" #include <stdio.h> #include <unistd.h> double total = 1024.0; double speed = 1.0; void DownLoad() { double current = 0; while(current <= total) { FlushProcess(total, current); // 下载代码 usleep(3000); // 充当下载数据 current += speed; } printf("\ndownload %.2lfMB Done\n", current); } int main() { DownLoad(); DownLoad(); DownLoad(); DownLoad(); DownLoad(); DownLoad(); DownLoad(); DownLoad(); return 0; }makefile
cppSRC=$(wildcard *.c) OBJ=$(SRC:.c=.o) BIN=processbar $(BIN):$(OBJ) gcc -o $@ $^ %.o:%.c gcc -c $< .PHONY: clean: rm -f $(OBJ) $(BIN)六.gdb/cgdb
gdb/cgdb都是调试器,两者指令一样,区别是cgdb可以动态呈现代码
安装cgdb:sudo apt-get install-y cgdb
tip:使用gdb调试必须再源代码生成二进制代码时,加上-g(debug模式)
如:gcc test.c -o test -g
常用指令
这里指令较多,具体可参考
- 「wq」:⼀般建议离开时,搭配「w」⼀起使⽤,这样在退出的时候还可以保存⽂件。