PyTorch强化学习实战------分布式策略梯度
-
- [0. 前言](#0. 前言)
- [1. 分布式策略梯度](#1. 分布式策略梯度)
- [2. 架构设计](#2. 架构设计)
- [3. 算法实现](#3. 算法实现)
- [4. 结果](#4. 结果)
- 相关链接
0. 前言
深度确定性策略梯度 (Deep Deterministic Policy Gradient, DDPG)虽然在连续控制任务上取得了比优势演员-评论家 (Advantage Actor-Critic, A2C) 方法更优的效果,但其训练稳定性仍有提升空间。本节将介绍分布式分布深度确定性策略梯度 (Distributed Distributional Deep Deterministic Policy Gradient, D4PG) 算法,它从四个关键维度对 DDPG 进行了改进:用概率分布替代评论家的单一Q值输出,引入 n 步贝尔曼方程加速收敛,采用优先经验回放提升样本效率,并简化探索机制。这些改进使 D4PG 在四足机器人任务上的平均奖励从 DDPG 的 4.5 跃升至近 18,性能提升近 4 倍。本文将解析 D4PG 的核心设计原理与实现细节。
1. 分布式策略梯度
在本节中,我们将探讨 Barth-Maron 等人 2018 年发表的《Distributed distributional deterministic policy gradients》论文,论文中提出了分布式分布深度确定性策略梯度 (Distributed Distributional Deep Deterministic Policy Gradient, D4PG) 方法。作者针对深度确定性策略梯度 (Deep Deterministic Policy Gradient, DDPG)方法提出多项改进以提升稳定性、收敛性和样本效率:
- 首先,采用了
Bellemare等人中提出的Q值分布式表示,核心思想是用概率分布替代评论家的单一Q值,贝尔曼方程被贝尔曼算子取代(以类似方式转换分布表示) - 第二项改进是使用n 步贝尔曼方程(通过展开加速收敛)
- 与原始
DDPG方法的另一区别是使用优先回放缓冲池替代均匀采样缓冲池
2. 架构设计
分布式分布深度确定性策略梯度 (Distributed Distributional Deep Deterministic Policy Gradient, D4PG) 与深度确定性策略梯度 (Deep Deterministic Policy Gradient, DDPG)最显著的差异在于评论家的输出:不再返回给定状态和动作的单一Q值,而是返回 N_ATOMS 个值(对应预定义范围内值的概率分布)。代码使用 N_ATOMS=51,分布范围 Vmin=-10 到 Vmax=10,因此评论家返回 51 个数字,表示折扣奖励落在区间边界 [-10, -9.6, -9.2, ..., 9.6, 10] 内各个区段的概率。
D4PG 与 DDPG 的另一区别是探索机制:DDPG 使用 OU 过程进行探索,但 D4PG 作者表示经过实验表明 OU 和简单随机噪声添加两种方式结果相同。因此论文最终采用更简单的探索方法。
最后一项重要差异涉及训练过程------D4PG 使用交叉熵损失计算两个概率分布之间的差异(一个来自评论家输出,另一个通过贝尔曼算子获得)。为使两个分布对齐到相同的支撑原子,采用与原论文相同的分布投影方法。
3. 算法实现
完整源代码位于train_d4pg.py、model.py 和 common.py。
(1) 我们首先从模型类开始。演员网络 (actor) 结构与 DDPG 完全一致,因此训练过程中直接使用 DDPGActor 类。评论家网络隐藏层规模和数量保持不变,但输出层不再是单个数值,而是生成 N_ATOMS 个值:
python
class D4PGCritic(nn.Module):
    def __init__(self, obs_size: int, act_size: int,
                 n_atoms: int, v_min: float, v_max: float):
        super(D4PGCritic, self).__init__()

        self.obs_net = nn.Sequential(
            nn.Linear(obs_size, 400),
            nn.ReLU(),
        )

        self.out_net = nn.Sequential(
            nn.Linear(400 + act_size, 300),
            nn.ReLU(),
            nn.Linear(300, n_atoms)
        )

        delta = (v_max - v_min) / (n_atoms - 1)
        self.register_buffer("supports", torch.arange(v_min, v_max + delta, delta))
(2) 我们还创建了一个包含奖励支撑的 PyTorch 辅助缓冲区,用于从概率分布获取单一平均Q值:
python
    def forward(self, x: torch.Tensor, a: torch.Tensor):
        obs = self.obs_net(x)
        return self.out_net(torch.cat([obs, a], dim=1))

    def distr_to_q(self, distr: torch.Tensor):
        weights = F.softmax(distr, dim=1) * self.supports
        res = weights.sum(dim=1)
return res.unsqueeze(dim=-1)可以看到,softmax() 应用并非网络 forward() 方法的一部分,因为我们将在训练中使用更稳定的 log_softmax() 函数。因此当需要获取实际概率时,需额外应用 softmax()。
(3) D4PG 的智能体类更为简单(无需状态跟踪):
python
class AgentD4PG(lib.agent.BaseAgent):
    """
    Agent implementing noisy agent
    """
    def __init__(self, net: DDPGActor, device: torch.device = torch.device("cpu"),
                 epsilon: float = 0.3):
        self.net = net
        self.device = device
        self.epsilon = epsilon

    def __call__(self, states: lib.agent.States, agent_states: lib.agent.AgentStates):
        states_v = lib.agent.float32_preprocessor(states)
        states_v = states_v.to(self.device)
        mu_v = self.net(states_v)
        actions = mu_v.data.cpu().numpy()
        actions += self.epsilon * np.random.normal(size=actions.shape)
        actions = np.clip(actions, -1, 1)
        return actions, agent_states
(4) 对于每个需转换为动作的状态,智能体应用演员网络并向动作添加高斯噪声(按 epsilon 值缩放)。训练代码使用以下超参数:
python
GAMMA = 0.99
BATCH_SIZE = 64
LEARNING_RATE = 1e-4
REPLAY_SIZE = 100000
REPLAY_INITIAL = 10000
REWARD_STEPS = 5

TEST_ITERS = 1000

Vmax = 10
Vmin = -10
N_ATOMS = 51
DELTA_Z = (Vmax - Vmin) / (N_ATOMS - 1)
本节使用了较小的 10 万条回放缓存(效果良好)。作者在 D4PG 论文中使用了 100 万条转移数据。缓存预先填充来自环境的 1 万个样本后开始训练。
(5) 每次训练循环中,训练评论家和演员。差异在于评论家损失的计算方式:
python
                batch = buffer.sample(BATCH_SIZE)
                states_v, actions_v, rewards_v, dones_mask, last_states_v = \
                    common.unpack_batch_ddqn(batch, device)

                # train critic
                crt_opt.zero_grad()
                crt_distr_v = crt_net(states_v, actions_v)
                last_act_v = tgt_act_net.target_model(last_states_v)
                last_distr_v = F.softmax(
                    tgt_crt_net.target_model(last_states_v, last_act_v), dim=1)
(6) 在评论家训练的第一步,我们要求其返回状态和已执行动作的概率分布。该概率分布将作为交叉熵损失计算的输入。为了得到目标概率分布,我们需要从批次中最后的状态计算概率分布,然后执行分布的贝尔曼投影 (Bellman projection):
python
                proj_distr = distr_projection(
                    last_distr_v.detach().cpu().numpy(), rewards_v.detach().cpu().numpy(),
                    dones_mask.detach().cpu().numpy(), gamma=GAMMA**REWARD_STEPS)
                proj_distr_v = torch.tensor(proj_distr).to(device)
(7) 该投影函数稍显复杂,简单来说,该函数通过对最后状态概率分布进行变换实现,根据即时奖励进行偏移并按折扣因子缩放。最终得到的就是我们希望网络生成的目标概率分布。由于 PyTorch 没有通用的交叉熵损失函数,我们通过将输入概率的对数与目标概率相乘来计算损失值:
python
                prob_dist_v = -F.log_softmax(crt_distr_v, dim=1) * proj_distr_v
                critic_loss_v = prob_dist_v.sum(dim=1).mean()
                critic_loss_v.backward()
                crt_opt.step()
(8) 演员的训练与 DDPG 方法唯一的区别在于使用模型的 distr_to_q() 方法,通过支撑原子点将概率分布转换为单一的平均Q值:
python
                act_opt.zero_grad()
                cur_actions_v = act_net(states_v)
                crt_distr_v = crt_net(states_v, cur_actions_v)
                actor_loss_v = -crt_net.distr_to_q(crt_distr_v)
                actor_loss_v = actor_loss_v.mean()
                actor_loss_v.backward()
                act_opt.step()
4. 结果
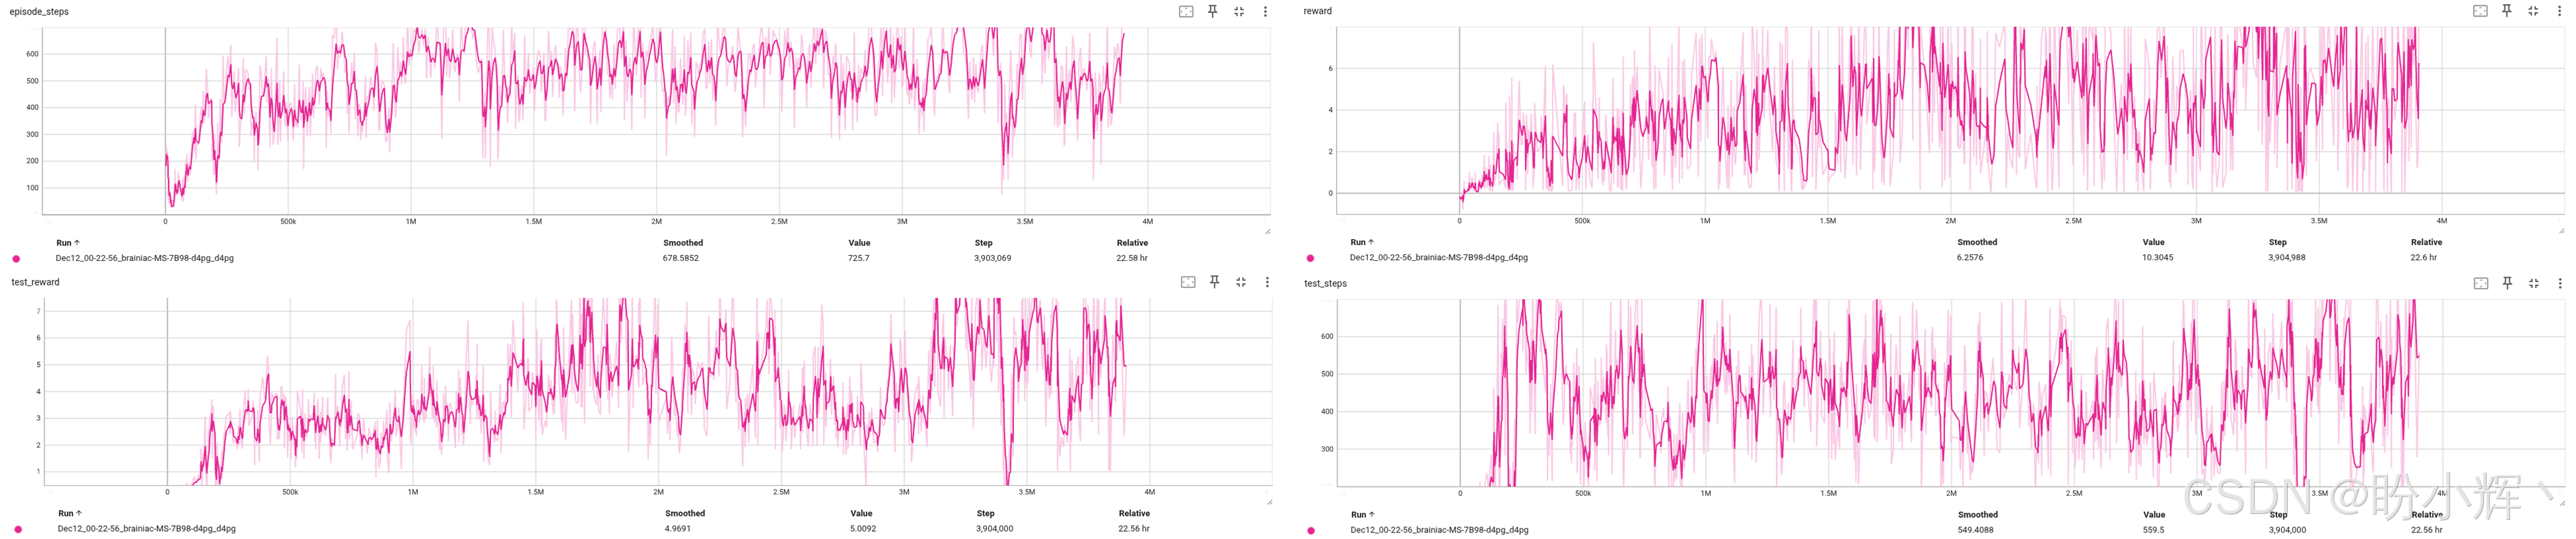
D4PG 方法在收敛速度和奖励获取方面表现优异,其平均测试奖励能够达到 17.912。而且这个结果还有提升空间,因为步数计数低于 1000 (环境的时间限制),意味着模型因内部环境检查而提前终止。下图展示了训练与测试指标:
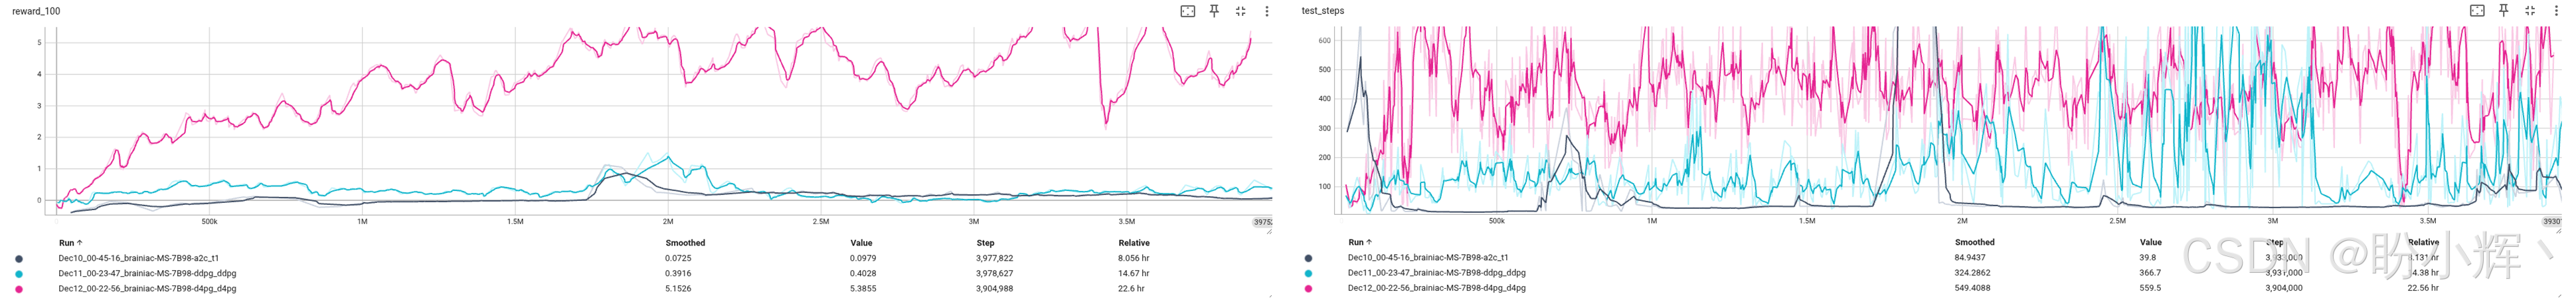
比较优势演员-评论家 (Advantage Actor-Critic, A2C) 方法、深度确定性策略梯度 (Deep Deterministic Policy Gradient, DDPG)和 D4PG 方法,下图展示了三种方法的测试集指标:
要查看模型的实际运行效果,可以使用 play_ddpg.py (因为演员网络结构与 DDPG 相同)。
相关链接
PyTorch强化学习实战(1)------强化学习(Reinforcement Learning,RL)详解
PyTorch强化学习实战(2)------强化学习环境库Gymnasium
PyTorch强化学习实战(3)------Gymnasium API扩展功能
PyTorch强化学习实战(4)------PyTorch基础
PyTorch强化学习实战(5)------PyTorch Ignite 事件驱动机制与实践
PyTorch强化学习实战(6)------交叉熵方法详解与实现
PyTorch强化学习实战(7)------表格学习与贝尔曼方程
PyTorch强化学习实战(8)------Q学习详解与实现
PyTorch强化学习实战(10)------强化学习高级组件
PyTorch强化学习实战(11)------N步DQN(N-step DQN)
PyTorch强化学习实战(12)------Double DQN(DDQN)
PyTorch强化学习实战(13)------噪声网络(NoisyNet-DQN)
PyTorch强化学习实战(14)------优先经验回放机制
PyTorch强化学习实战(15)------Dueling DQN
PyTorch强化学习实战(16)------Categorical DQN
PyTorch强化学习实战(17)------强化学习训练加速
PyTorch强化学习实战(18)------基于DQN处理股票交易问题
PyTorch强化学习实战(20)------优势演员-评论家(Advantage Actor-Critic, A2C)
PyTorch强化学习实战(21)------异步优势演员-评论家(Asynchronous Advantage Actor-Critic, A3C)
PyTorch强化学习实战(22)------将强化学习应用于TextWorld互动小说游戏
PyTorch强化学习实战(23)------强化学习在网页导航中的应用