文章目录
-
- 一、先认识组件的职责
- 二、放到三台服务器上,理解两套主备角色
- 三、正常运行时,沿着三条路径理解协作
-
- [1. 业务路径:应用把 SQL 交给主 DN](#1. 业务路径:应用把 SQL 交给主 DN)
- [2. 复制路径:主 DN 将 WAL 传给备 DN](#2. 复制路径:主 DN 将 WAL 传给备 DN)
- [3. 管理路径:agent 上报,server 判断,agent 执行](#3. 管理路径:agent 上报,server 判断,agent 执行)
- 四、主库所在服务器故障后,如何接替?
-
- [1. 发现异常:先观察失联,再判断故障](#1. 发现异常:先观察失联,再判断故障)
- [2. 仲裁:确认是否允许接替、谁适合接替](#2. 仲裁:确认是否允许接替、谁适合接替)
- [3. 执行:server 作出决策,agent 驱动 DN 升主](#3. 执行:server 作出决策,agent 驱动 DN 升主)
- [4. 恢复服务:复制关系和应用连接各自衔接](#4. 恢复服务:复制关系和应用连接各自衔接)
- 五、管理组件自身怎样保持运行?
-
- [本机守护:从 om_monitor 到 cm_agent](#本机守护:从 om_monitor 到 cm_agent)
- [主 cm_server 故障:谁发现异常,谁负责接替?](#主 cm_server 故障:谁发现异常,谁负责接替?)
- [全部 cm_server 不可用:区分数据库运行与管理能力](#全部 cm_server 不可用:区分数据库运行与管理能力)
在集中式主备数据库中,可以先用一句话理解这几个组件:DN 处理业务和复制数据,CM 监控并协调集群,OM 帮助管理员完成部署和维护。
其中,cm_agent 负责各台服务器上的本地检查和执行,cm_server 汇总状态并作出集群层面的管理决策。理解这项分工,就能串起它们在正常运行和故障接替时的协作过程。
本文以 openGauss 6.0 中由 CM 负责仲裁的常规日志复制主备为基础,采用"一主两备"示例,帮助理解磐维数据库的组件分工。
一、先认识组件的职责
| 组件 | 名称 | 主要职责 |
|---|---|---|
| DN | Data Node,数据节点 | 执行 SQL、存储数据、完成主备复制 |
| CM | Cluster Manager,集群管理组件 | 持续监测运行状态,按配置进行仲裁和故障处理 |
| OM | Operation Manager,运维管理模块 | 提供安装、维护、状态查看和配置管理等工具 |
DN:业务实际访问的数据库
在本文的部署中,一个 DN 可以理解为一个数据库实例,在 openGauss 中通常对应 gaussdb 进程。
主 DN 处理业务写入和查询,并产生 WAL(预写式日志)。备 DN 接收、回放这些日志,维护数据副本;满足相应条件时,也可以提供只读查询或接替主库。这里的"一主两备"围绕同一份逻辑业务数据工作,备库可能存在延迟,但不是将数据拆成三个分片。
因此,DN 虽然叫"数据节点",却不只是保存文件的存储服务,SQL 的执行也是它的工作。
CM:持续观察和协调集群
数据库能复制数据,并不意味着它已经具备完整的自动故障处理能力。主库出现异常后,还需要发现故障、判断是否允许接替、选择备库并执行角色转换。在本文采用的模式下,这些管理工作由 CM 协调。
CM 中最需要认识的是两个进程:
| 进程 | 负责什么 | 工作范围 |
|---|---|---|
cm_agent |
检查本机实例、上报状态、执行管理指令,并按配置守护本地进程 | 所在服务器 |
cm_server |
汇总各处状态,进行仲裁并下发管理指令 | 整个受管集群 |
这里的仲裁,就是依据节点状态和配置规则,判断应当采取什么管理动作、由哪个实例承担相应角色。
这种分工有实际原因:agent 在本机,便于检查和操作本地进程;server 汇总多台机器的信息,能够从集群整体判断问题。agent 也会按配置进行本地守护,不是每个动作都要等待 server 下令。
OM:管理员使用的运维工具
OM 用于组织和执行部署、维护等任务。例如,gs_install 用于安装,gs_om 提供多种维护操作。管理员不必一直开着命令终端,数据库和 CM 也会继续运行。
OM 与 CM 可以协作:部分运维操作会调用 CM 的控制工具,但具体路径取决于操作和部署方式。其中,cm_ctl 是 CM 的命令行控制工具,用于查询、启停、切换等操作;它与长期运行的 cm_server、cm_agent 分工不同。
二、放到三台服务器上,理解两套主备角色
下面用 A、B、C 三台服务器组成一主两备:A 上运行主 DN,B、C 上运行备 DN;三台机器都部署了 cm_agent 和 cm_server,当前主 cm_server 位于 B。
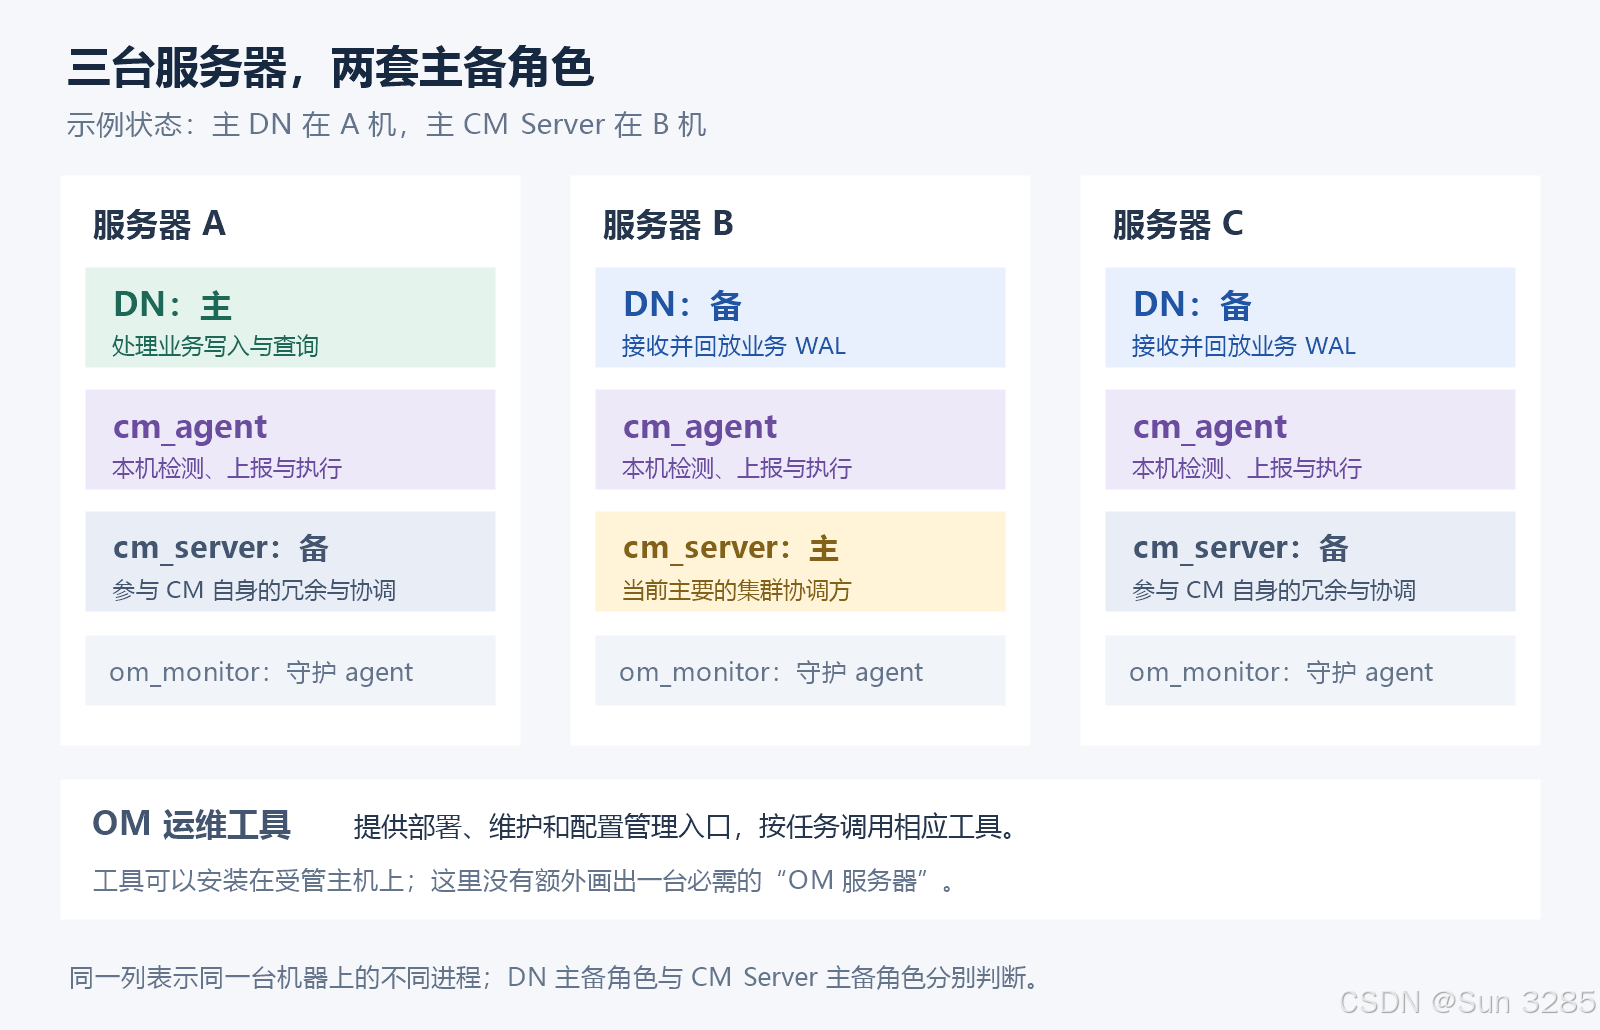
图中是用于讲解的部署和当前角色,组件数量、部署位置及主角色位置不代表所有集群。
看这张图时,要区分三个概念:服务器是运行环境,实例是运行在其中的服务,主或备是实例当前的角色。 同一台服务器可以运行多个组件,它们的角色也不必相同。
因此,图中存在两套主备关系:
- DN 的主备决定谁承担业务写入、谁维护数据副本。
cm_server的主备决定谁承担主要的集群协调职责,并为管理服务自身提供冗余。
这就解释了为什么 A 可以是主 DN 所在机器,而 B 同时运行备 DN 和主 cm_server。看到"Primary"或"Standby"时,首先要确认它描述的是哪一种实例。
各台机器的 agent 检查本地实例,再将状态上报给集群管理方,并非只向本机的 cm_server 汇报 。当前主 cm_server 在 B,也需要掌握 A、C 的状态,才能协调整个集群。
多个 cm_server 之间同样需要协调主备身份。例如,使用 DCC 的模式下,由 DCC 提供协调所需的配置存储、选主等能力。这里同步的是管理信息,与 DN 之间复制业务数据是两回事。
三、正常运行时,沿着三条路径理解协作
以"应用创建一笔订单"为例,业务请求、数据复制和集群管理各有自己的通信路径。
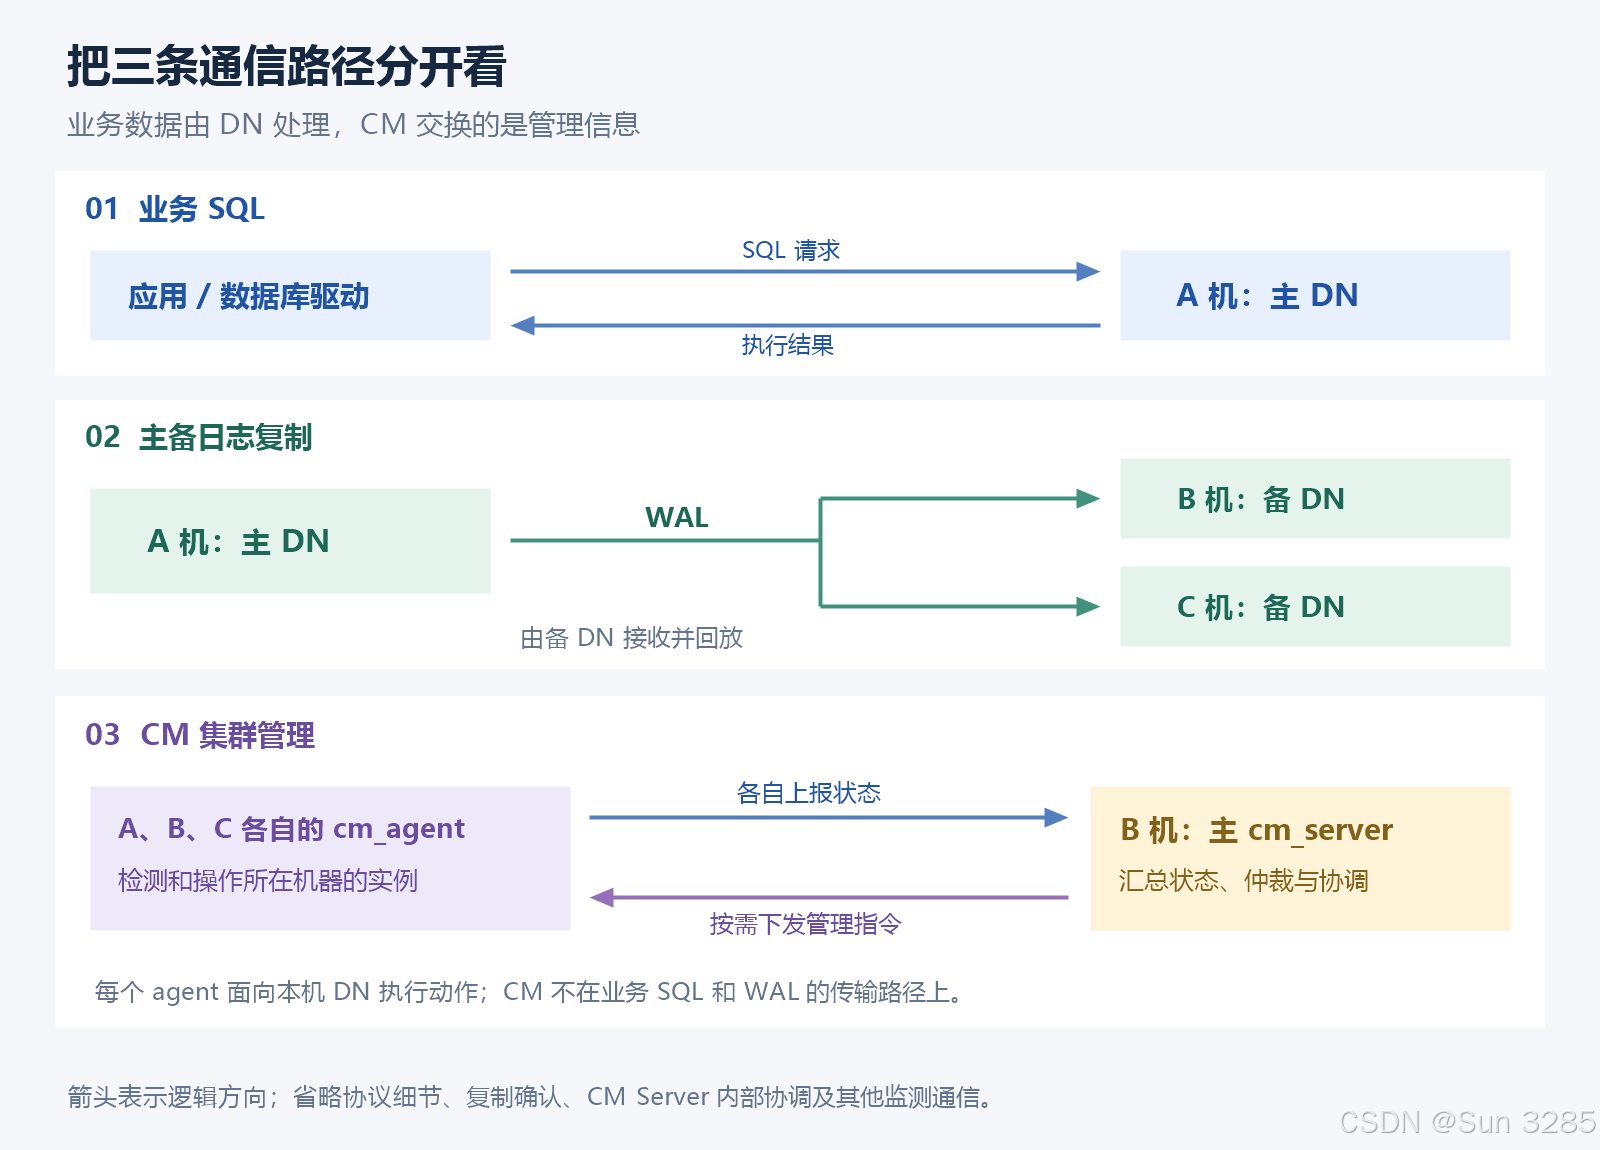
图中突出三类通信的职责,省略协议细节、复制确认和其他监测通信。
1. 业务路径:应用把 SQL 交给主 DN
应用通过驱动连接 A 上的主 DN,发送新增订单的 SQL,并接收执行结果。连接入口可以结合虚拟 IP 等方式配置,但执行 SQL 的仍是 DN。
CM 负责管理集群,业务 SQL 不需要先经过 cm_server 转发。
2. 复制路径:主 DN 将 WAL 传给备 DN
与这次写入有关的 WAL 由主 DN 传给备 DN,备 DN 再接收和回放。日志的发送、接收、回放都由数据库自身的复制机制完成。
CM 可以观察复制状态,并将其用于管理决策,但不负责搬运这些业务日志。这也解释了为什么 CM 无法阻止一次已提交的误删传播到备库:它能监测集群运行状况,却无法据此判断删除是否符合业务意图。
3. 管理路径:agent 上报,server 判断,agent 执行
这条路径持续运行,不必等到某笔订单写入才开始工作。以 B 为例,一轮协作如下:
- B 的
cm_agent检查本地 DN 的角色和运行状态,上报给 CM Server。 - 当前主
cm_server综合 A、B、C 的信息,判断是否需要处理异常。 - 需要 B 执行动作时,server 向 B 的 agent 下发指令;agent 在本机执行,再通过后续报告反映结果。
状态上报是持续的,管理动作则按需发生。 正常的一次上报不意味着会触发切换,执行一条 SQL 也不需要单独向 CM 请示。
四、主库所在服务器故障后,如何接替?
继续使用同一个例子:A 上是主 DN,B 上是备 DN 和主 cm_server,C 上是另一个备 DN。现在假设 A 整机离线,B、C 正常且满足所需仲裁条件,最终 B 的 DN 被选中接替。
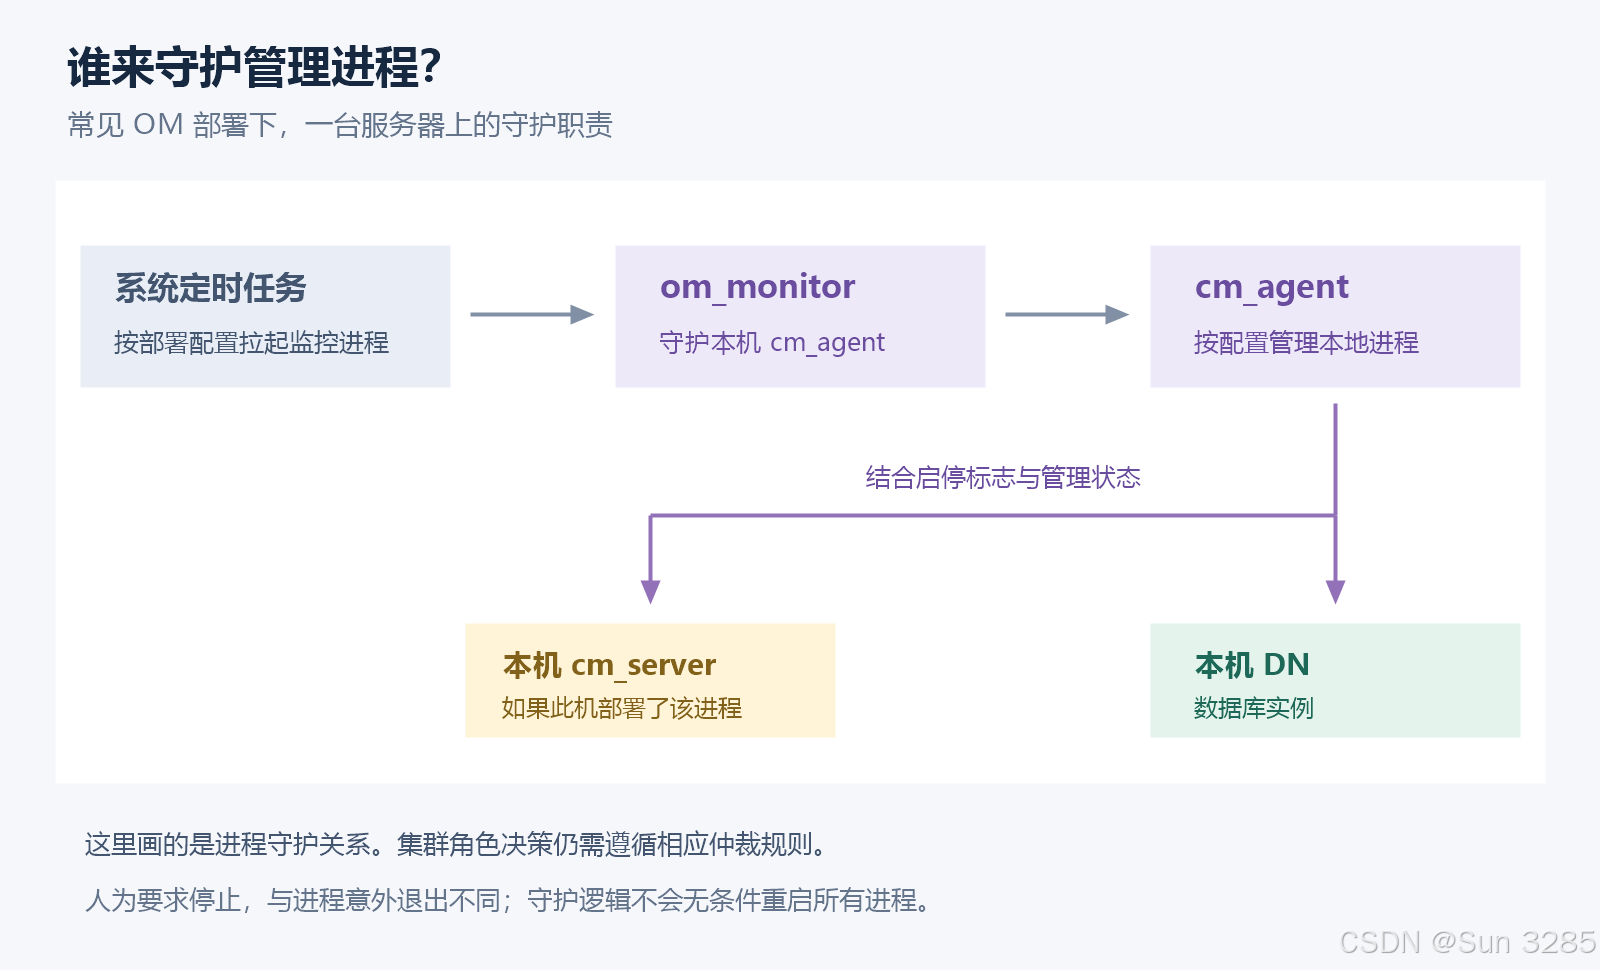
B 被选中是示例前提,不代表固定的选主顺序。图中按职责衔接组织,实际的复制调整与应用重连等步骤可以并行。
1. 发现异常:先观察失联,再判断故障
A 整机离线后,DN 和 agent 都无法继续通信。仍在运行的 CM Server 会观察到 A 的状态上报中断,并结合其他检测信息和存活节点的报告进行判断。
这里要区分进程故障和整机故障:如果只有 A 的 DN 退出,仍存活的 agent 可以报告异常;如果 A 已经断电,它的 agent 也无法再主动上报。
2. 仲裁:确认是否允许接替、谁适合接替
联系不上 A,并不等于 A 一定停止了业务写入。 它也可能只是与集群中的部分节点失去网络联系。如果另一侧立即升起一个新主,就可能出现两个主库各自接收写入、数据逐渐分叉的"脑裂"。
因此,CM 需要结合存活节点、网络状态、仲裁条件、备库的日志进度和处理策略作出判断。
其中,多数派可以先理解为"超过一半的参与成员",例如三个成员中的两个。CM 自身的协调条件与 DN 的接替条件需要分别满足,不能仅凭"两台机器还开着"就断定能够切换。
3. 执行:server 作出决策,agent 驱动 DN 升主
确认 B 满足接替要求后,当前主 cm_server 将相应指令交给 B 的 cm_agent,由 agent 驱动本机 DN 执行升主动作。
这一步的职责最清楚:server 决策,agent 执行本地管理动作,DN 完成数据库内部的角色转换。 B 的 DN 还要按恢复要求处理所需日志,才能以新主身份提供服务。
4. 恢复服务:复制关系和应用连接各自衔接
B 成为新主后,其他可用备 DN 需要按新的主备关系继续复制。A 将来重新加入时,也要校准角色和数据,必要时重建,不能直接沿用原来的主角色。
应用侧则需要通过已配置的虚拟 IP 切换或驱动重连等机制,重新连接可写的新主。DN 完成升主与业务恢复访问之间还有这一层衔接;原有的断开连接和中断事务不会原样搬到新主。
故障恢复耗时以及能否保住最新提交的数据,仍取决于复制配置、故障处理策略和当时的实际状态。部署 CM 本身并不等于零中断或零数据丢失。
五、管理组件自身怎样保持运行?
前面的过程假设管理组件仍能工作。接下来再看它们自身的进程守护和故障处理。
本机守护:从 om_monitor 到 cm_agent
在常见的 OM 部署和 CM 守护方式中,本机的守护关系如下:
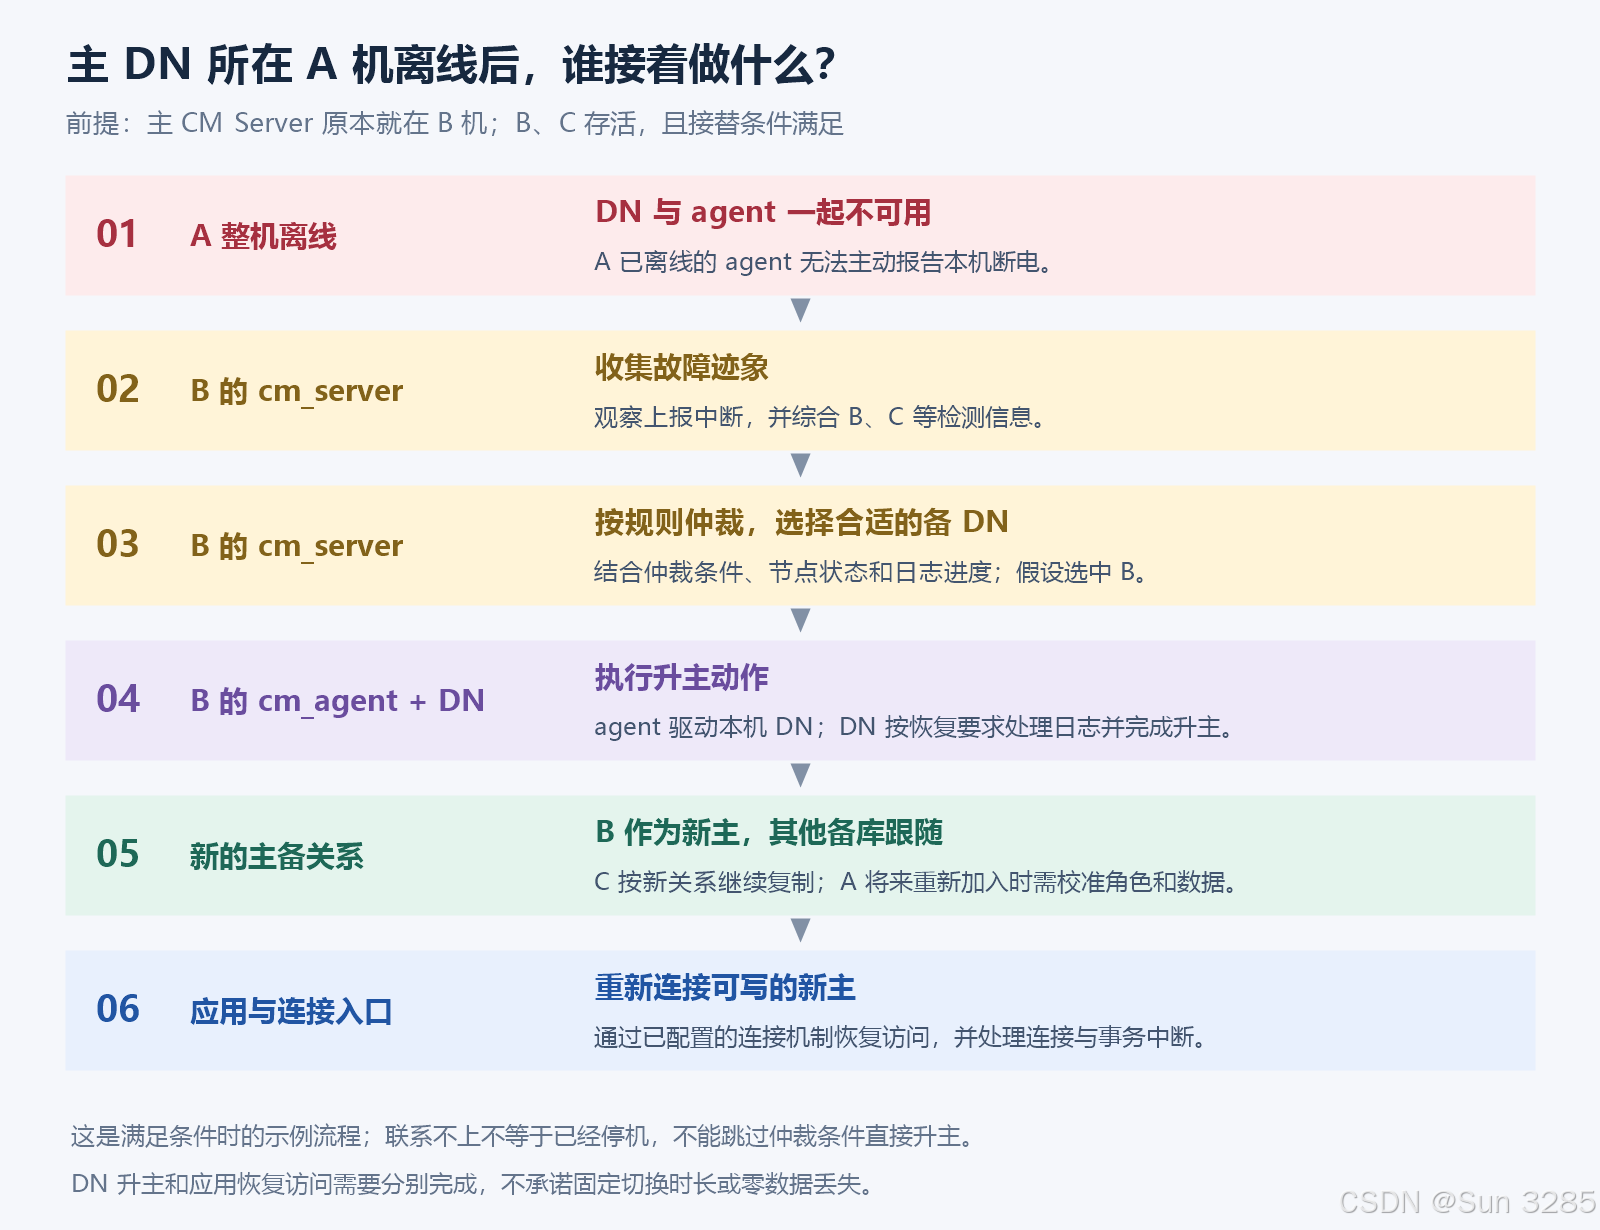
图中表示守护职责,不表示每次检查都会重启进程,也不表示所有启动过程严格串行。
系统定时任务用于拉起 om_monitor;om_monitor 守护 cm_agent;agent 再根据配置和启停状态,管理本机的 DN、已部署的 cm_server 等进程。om_monitor 是承担具体守护职责的进程,OM 则是前文介绍的运维工具体系。
守护逻辑也会区分"意外退出"和"管理员主动停止"。管理工具通过相应状态或启停标志表达停机意图,避免进程刚被正常停止就又被拉起。由 CM 管理的集群,其角色切换也应通过相应集群管理入口进行,让管理动作与集群状态保持协调。
主 cm_server 故障:谁发现异常,谁负责接替?
主 CM Server 并非无人监测。本机守护和跨机通信从不同角度发现异常:
| 观察方 | 怎样发现异常 | 承担的职责 |
|---|---|---|
同机的 cm_agent |
本地检查发现 cm_server 进程意外退出 |
在配置和启停状态允许时尝试重新拉起进程 |
| 其他 CM Server 及其协调机制 | 主备连接、心跳或协调状态出现异常、超时 | 按部署模式的选主和仲裁规则确定新的主 CM Server |
与主 CM Server 通信的各个 cm_agent |
连接失败或收不到预期的心跳响应 | 感知管理连接异常,尝试恢复连接;不负责选出新的主 CM Server |
心跳是组件之间周期性的存活通信。超时说明无法按预期与对方通信,可能是进程故障,也可能是网络问题,因此发现失联与获得升主资格是两回事。使用 DCC 的模式还需要通过 DCC 的协调、选举机制确定有效主角色,不能由任意一个 agent 判断"主失联了"就指定新的管理者。
仍以 B 上的主 cm_server 为例:如果只有该进程退出,B 的 agent 可以发现并尝试拉起;其他 CM Server 及各机 agent 也可能观察到通信异常。如果 B 整机断电,本地 agent 同样停止,就要由 A、C 上仍存活的组件通过跨机通信发现失联。满足选主和仲裁条件后,其他 CM Server 接替主角色,agent 再恢复与有效管理方的协作。
本地重新拉起与集群重新选主可以分别进行,不是必须先重启失败才能接替。原来的 cm_server 即使恢复运行,也要遵守当前选主结果,不能自动恢复旧的主身份。
主 cm_server 切换,不意味着主 DN 必须同时切换。 在这个例子中,主 DN 位于 A;B 上的 CM 服务故障与 A 上的数据库是否需要切换,应分别判断。
全部 cm_server 不可用:区分数据库运行与管理能力
此时,CM 的管理和仲裁能力会受影响,但 DN 是独立进程,不能简单断言所有数据库立即停止。
同样,也不能保证业务完全不受影响:agent 长期失去主 CM Server 联系后是否采取保护动作,受配置影响;DN 自身也有复制和提交条件。数据库进程仍在运行、某条 SQL 能执行,都不足以说明集群仍具备正常的自动故障处理能力。