概述
2022年10月发布,是一个开发框架,开发由LLM驱动的应用程序,核心是模块化组件 + 工作流编排能力
当GPT在2022年11月发布时,实现方式属于「prompt 诱导」,靠提示词让模型输出固定格式的指令,存在诸多痛点:
-
无法连接互联网
-
没法查询数据库
-
不能调用第三方 API
-
如何接入私有数据
-
知识截止(基座模型训练数据的时间边界),只能依靠RAG补齐,目前无法解决
-
如何稳定输出
当OpenAI在2023.3推出插件 系统,2023.6推出function calling 后模型原生具有了工具调用能力,不再单纯依靠提示词,提升了上述场景的稳定性
langchain统一规范了【大模型应用开发】的组件与工作流
核心模块(包)
Model I/O :标准化大模型的输入输出
Chains:多个组件链式调用
RAG:检索外部数据
Agents:构建Agent智能体
环境配置
新建anconda环境,版本指定python3.12才能兼容以下依赖
#准备环境
conda create -n langchain python=3.12
conda env list
conda activate langchain
#下载依赖
#所需依赖保存在D:\Environment\langchain_requirements.txt
D:
cd D:\Environmen
pip install -r langchain_requirements.txt中转代理平台
代理平台不是模型生产方,它只是帮你转发请求到原始大模型厂商
风险:数据会经过第三方中转服务商;稳定性、价格、合规性需要自己评估
-
closeai :更聚焦亚洲 / 国内用户,主打国内访问稳定、支付方便
-
OpenRouter:全球范围的聚合平台,接入厂商、模型数量更多,国内不方便
-
(国内)阿里云百炼、百度千帆、硅基流动:没有国外模型
代码
安全使用api_key
把api_key放到.env文件中
 OPENAI_API_KEY=sk-bekxzacluvoncqhpgmijqfjsnxgxkrppahpzqvggmbayvptf
OPENAI_BASE_URL=https://api.siliconflow.cn/v1上述变量名最好不要更改,因为如果不手动传api_key与base_url的话,系统会自动去读固定名字的环境变量:OPENAI_API_KEY 和 OPENAI_BASE_URL。
别看错这两个名
读取.env文件需要导入两个模块,操作如下
from dotenv import load_dotenv
import os
#读取你项目文件夹里的.env文件,把文件里面写的键值加载进系统环境变量
load_dotenv()
#从环境变量里面,取出名字叫`OPENAI_BASE_URL`的值
os.getenv("GJLD_API_KEY")大模型构建
不同厂商之间的模型SDK不同,langchain对他们进行整合,内部封装了不同厂商的出参入参的构建与解析,开发时可以用统一的方法进行模型调用与结果解析
import os
from dotenv import load_dotenv
from langchain_classic.chat_models import init_chat_model
load_dotenv()
llm=init_chat_model(
model="deepseek-ai/DeepSeek-V4-Flash",
model_provider="deepseek",
api_key=os.getenv("GJLD_API_KEY"),
base_url=os.getenv("GJLD_API_URL"),
)
#调用大模型对象
response=llm.invoke("你好,今天天气怎么样")
print(response)这里init_chat_model的参数model_provider,指:集成SDK包名称
-
中转服务:接口完全兼容 OpenAI 协议。字段取
"openai" -
厂商原生 API:不兼容 OpenAI 格式,需要填写对应厂商标识,加载厂商独立的 langchain 集成包
更简单构建方式如下
注意该方法导入包为from langchain_openai,自动导入很容易出错
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
load_dotenv()
#已经默认model_provider为openai,其他两个参数自动读取系统变量
llm=ChatOpenAI(model="deepseek-ai/DeepSeek-V4-Flash")
print(llm.invoke("你好,今天怎么样"))调用本地模型也是上述代码(定义llm,调用invoke方法)
使用本地模型Ollama演示(并发性很差),实际生产环境使用Vllm(大模型本地部署:安全)
格式化输出
如果希望模型输出为固定格式,比如JSON
-
法一:在Prompt中明确约束大模型输出Json(常用)
-
法二:使用接口参数限制
法一
法一使用到了LangChain 输出解析器,具体操作如下:
-
构建一个解析器对象
-
从解析器对象获取一段提示词内容
-
通过这段限制输出的提示词约束大模型的输出
-
再次调用解析器对象自动解析,将输出的文本转化为JSON格式
解析器 =「格式提示词生成器」+「文本解析转换器」合在一起的工具。
代码如下:
load_dotenv()
llm = ChatOpenAI(...)
# ========== 0. 规定输出的数据类型 ==========
class Prime(BaseModel):
prime : list[int] = Field(description="素数列表")
count : list[int] = Field(description="小于对应素数的素数个数列表")-
继承 Pydantic 自带的基础模板
-
内容:
字段:数据类型 -
描述:
= Field(description="素数列表")是给大模型阅读的说明文字,模型知道字段含义
把输出类型定义成类有以下优点:
-
自动生成给 LLM 的格式提示词
-
自动校验字段、数据类型
-
直接生成类实例对象,编辑器可以代码提示,写错 IDE 会标红。
# ========== 1. 构建解析器对象 ==========
parser = PydanticOutputParser(pydantic_object=Prime)
# ========== 2. 从解析器获取格式化提示词 ==========
sys_prompt = parser.get_format_instructions()
# =======3. 构建完整Prompt发给LLM,得到消息对象========
response = llm.invoke(
[
("system", sys_prompt),
("user", "任意生成5个1000-100000之间素数,并标出小于该素数的素数个数")
]
)llm.invoke() 里面放的是消息列表(支持多条对话)
消息固定格式:每个小元组 (角色名, 消息内容)
-
system系统提示词,用来告诉大模型全局规则 -
user用户消息,就是我们提的业务问题:生成素数
# ==============4.获得模型输出的文本字符串 ==============
output_text = response.content
# ========5.解析器接收文本字符串,转为Output对象========
json_output = parser.invoke(output_text)解析器类
-
StrOutputParser(最基础)-
作用:只从模型返回的
AIMessage里面提取文本字符串,不做任何格式校验 -
输出:
str
-
-
JsonOutputParser-
作用:提取文本,解析成 Python
dict/list -
输出:字典
-
-
PydanticOutputParser-
作用:解析文本,反序列化成你定义好的 Pydantic 模型对象
-
❗必须传入 Pydantic 类,否则实例化直接报错
-
输出:Pydantic 实例对象
-
-
其他解析器
法二
主流大模型厂商的 API提供了专门参数和特殊字段来限制模型输出,但还是由于各厂商接口不统一、适配成本高。因此我们使用 LangChain 进行模型调用
该方法我们不再设置解析器、系统提示词,而是
# 将返回类型的这个类,注册到大模型对象中
structured_llm = llm.with_structured_output(schema = CalendarEvent)
# 调用包装后的大模型,传入用户提示词,会返回你定义的Output 对象
response = structured_llm.invoke("你好啊?今天怎么样")
print(type(result)) 怎么法一就要(提示词→大模型→获得消息对象→文本发给解析器才能获得output对象),而法二(参数限制输出)就可以直接用包装后的大模型直接返回output对象?
大模型本身永远只能输出文本字符串,永远不会直接返回 Python 对象
两种路线区别:谁负责做「文本→Python 对象」这一步
-
普通
llm.invoke():只拿消息对象(AIMessage),这一步交给你自己写代码解析 -
with_structured_output:LangChain 包装了一个 Runnable,它在内部自动完成提示词增强 + 拿到 AIMessage + JSON 提取 + Pydantic 解析,最后把解析好的 Output 对象给你,中间的消息对象默认藏起来。
为啥法二更方便,但是法一提示词方法才常用呢?
谁知道呢
消息列表构造
如果不需要固定格式输出,就定义原始 llm,调用 llm.invoke(xxx),这里的xxx支持多种输入形式
-
字符串(单轮提问,无需系统提示词) 1个
input_string="你好,怎么样?" -
元组列表(LangChain 简写形式) 3个
角色只能填
"system"/"user"/"ai"input_tuple=[ ("system":"你每次说话前会加上tuple单词") ("user":"你好,怎么样?") ] -
字典列表(OpenAI 原生格式) 3个
role 可选值:
system/user/assistantinput_dict=[ {"role":"system","content":"你说话前会加上dict单词"} {"role":"user","content":"你好,怎么样?"} ] -
消息对象(推荐!工程首选✅) 4个 LangChain 封装好的消息类(消息对象,继承 Pydantic 的 BaseModel),IDE 自动补全、类型校验,适合多轮对话、复杂项目。
 input_msg_object=[
     SystemMessage(content="系统全局指令"),
     HumanMessage(content="用户消息")
     AIMessage(content="模型历史回复")
     ToolMessage(content="工具调用返回结果")
 ]
流式输出
chunk:文本块,片段
流式调用来实现打字机效果,而不是一下子全发出来
流式是「大模型接口层面」的能力,所以在调用大模型时把invoke()方法替换为strem()方法
 #已经定义好环境与llm
 output=llm.stream("你好啊,今天怎么样?写1000字")
 for chunk in output:
     print(chunk)
需要有非开发人员思维:从客户的角度考虑,之所以需要流式输出,是为用户体验
并发调用
把llm定义与输出环节封装在async函数里,适用于高并发、I/O密集场景
 async def async_invoke():
     llm=...
     #注意这里的流式输出用astream
     output=llm.astream("随便生成1000字")
     #for循环要加异步关键词
     async for chunk in output:
         print(chunk)

 if __name__=="__main__":
     asyncio.run(async_invoke)
提示词模板{x}
prompt:提示词
提示词模板:就是将变量插入固定提示文本,实现提示词复用、灵活生成不同请求。
Langchain两类常用提示词模板:
-
PromptTemplate(字符串提示模板):适合单轮、简单文本生成
- 使用
.from_template(消息列表)调用
- 使用
-
ChatPromptTemplate(聊天提示模板):适合聊天场景
- 使用
.from_messages(消息列表)调用
- 使用
流程:
-
构建提示词模板对象,用
{变量名}定义占位符 -
通过
.invoke(变量字典)实现参数传入,获得完整提示词
making_prompt=ChatPromptTemplate.from_messages(
	message=[
		("system":"你是一个专业的评论员")
        ("user":"评价以下{product}的优缺点,包含{aspect}方面")
	]
)

prompt=making_prompt.invoke(
	{"product":"苹果","aspect":"营养"}
)如果我们系统提示词用解析器生成的sys_prompt,那
making_prompt=ChatPromptTemplate.from_messages(
	message=[
		("system":"{sys}")
        ...
	])
prompt=making_prompt.invoke(
	{"sys":sys_prompt, ... }
)
Chains
概述
Langchain的核心组件,从逻辑上分为Model I/O、Chains、RAG、Agents
Model I/O 负责模型输入输出链路,包含三部分:提示词模板、大模型、输出解析器。这三部分都支持 invoke(),根源是它们全部实现了 LangChain 底层的 Runnable 接口。
Runnable接口定义了一系列标准的方法
| 方法名 | 作用 |
|---|---|
invoke/ainvoke |
把单个输入转为输出 |
batch/abatch |
批量把多个输入转为输出 |
stream/astream |
从单个输入生成流式输出 |
LCEL 是一套用来链式组装 Runnable 组件的语法
Runnable 是 LangChain 抽象出来的可运行对象接口。只要类实现了 Runnable 接口,就可以用竖线 | 把多个组件串联,形成一条完整执行链路,替代手动写大量调用、传参、拼接结果的代码。
# 组件都是Runnable,以下分别是提示词、大模型、解析器的使用
prompt = ChatPromptTemplate.from_messages([...])
llm = init_chat_model(...)
parse = PydanticOutputParser(...)

# LCEL链式拼接,前者的输出自动作为后者的输入
chain = prompt | llm | parse

# 调用只需一次
result = chain.invoke({"n":80})
并行链
开发不常用,没有适配场景
核心作用:接收一份输入,同时喂给多个 Runnable 独立执行,把多个执行结果打包成字典返回
chain1 = prompt1 | llm | parse
chain2 = prompt2 | llm | parse
#key用来标记字典的返回结果
map_chain=RunnableRarallel(
"res1":chain1,
"res2":chain2
)
result=map_chain.invoke({"n":80})
print(result["res1"])适合同输出多任务,比如一句话翻译为英文、韩文
复杂链
开发不常用,保持链的原子性,复杂情况外部处理
prompt1=...
prompt2=...
prompt_sum=PromptTemplate.from_template("汇总{v1}{v2}")
chain1 = prompt1 | llm | parse
chain2 = prompt2 | llm | parse
chain_sum = prompt_sum | llm | parse
#构建第四个链——>映射链,前三个链都是它的组件,还使用到了并行链
map_chain = {
"res1":chain1,
"res2":chain2
} | chain_sum
result=map_chain.invoke({"n":80})Retrieval
Retrieval(检索)是 RAG 里面最核心的一步
RAG:Retrieval-Augmented Generation,检索增强生成
RAG概述
由于前面学过的大模型局限性:知识滞后、知识缺失、幻觉需要解决,而模型微调("炼丹")不可控,需要使用RAG解决局限性。
RAG 的检索动作,发生在调用大模型、发送提示词之前
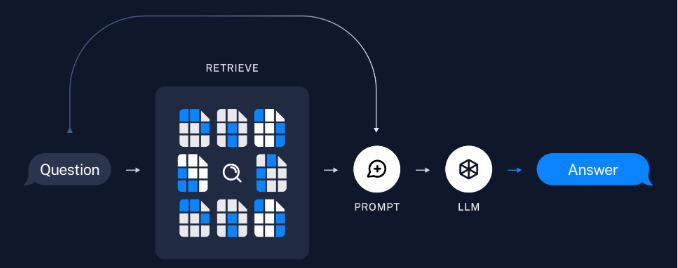
RAG的优缺点(整体收益正向)
-
优点
-
和提示词工程相比,有更丰富的上下文与数据样本
-
和微调相比,可以提高回答内容的时效性与可靠性
-
-
缺点
-
每次外部检索,响应延时会相对较高
-
引用外部Token会消耗大量Token
-
RAG流程
-
索引阶段(提前一次性处理文档)
-
读取各类原始资料
-
把长文档切割成小片段,原因如下:
-
模型有最大 token 上限(硬性限制)
-
向量库是按块召回的,只召回相关的块(软性,但决定RAG的效果)
-
-
通过嵌入模型,把文本转为高维向量存入向量库
-
向量简单理解: "西红柿" 会抽象保存为红色、酸甜、可炒鸡蛋这类特征。文本转为高维向量也是同理,用一串数字代表文本含义,用来做相似度比对
-
检索 + 生成阶段(用户提问时实时执行)
-
用户输入问题,先把问题转为高维向量
-
在向量库里比对,召回语义相近的文档片段
-
将用户问题 + 参考片段一起组装进提示词发给大模型,生成最终答案
-
①文档加载
RAG 知识库构建第一步:数据加载 。LangChain 通过各类 Loader 统一封装不同数据源,最终输出标准化 Document 对象
每个 Document 对象包含:
-
page_content:文本内容 -
metadata:元数据(来源文件名、元素类型如 Title 等)
常用加载器:
-
TextLoader、CSVLoader、JSONLoader -
UnstructuredMarkdownLoader -
Word / HTML / Excel 使用对应的 Unstructured 系列
-
PDF 推荐先转为 markdown 格式
markdown文件解析
#1、实例化加载器对象,此时还没有读取文件,只是配置好了信息
loader = UnstructuredMarkdownLoader(
	file_path="./assets/sample.md",
	encoding="utf-8",
	mode="elements"
)模式可以选择elements或者single
-
mode="single":整个 md 文件合并成 1 个 Document 对象(默认) -
mode="elements":unstructured 库自动解析 markdown 语法,拆成多个 Document,每一段元素单独一个 doc,并且 metadata 标记元素类型(标题、正文、列表、代码块、表格等)能保留层级,推荐
 #2、真正执行读取+解析
 docs=loader.load()
第二步骤返回 List[Document],也就是 docs。
#for循环打印Word 文档解析
Word 的版式划分能力不如 Markdown,一般直接用 single 模式整体解析即可。
PDF 文档解析
pdf布局比word还灵活。有扫描版、混合版、布局也灵活、还包含各种元素
因此使用开源工具Minern将pdf转化为markdown或json格式
使用官网MinerU | 面向 Agent 和 RAG 的智能文档解析平台的API文档接入使用
②文档切分
获得Document后,需要将其切分为chunk,之所以需要切块是因为Docunment太大,包含无关信息,影响大模型生成,浪费Token
-
法一:固定字符数切分,差
-
法二:递归使用多个分隔符切分,较好,不会切断完整句子(常见)
-
法三:大模型语义切分,很准确,但是消耗时间、Token
相邻chunk保留部分重叠区域
使用法二进行切分
#1、加载文档
loader=...
docs=loader.load()
#2、定义切分器对象
splitter=RecursiveCharacterTextSplitter(
separators=["\n\n","\n","。",",","!","?","……",""],
chunk_size=400,
chunk_overlap=50
)
#3、调用切分器进行切分
chunks=splitter.split_documents(docs)
for chunk in chunks:
print(f"\n========================\n")
print(chunk.page_content)文本嵌入模型
Embedding:嵌入
既然切分好了文本,现在就使用嵌入模型把它转为高维度向量存储
选择嵌入模型,优先看
-
序列长度:输入文本最多支持多少 token,chunk不能超过它。
-
输出向量维度(只针对稠密向量):
-
维度越高↓
-
区分细微语义差异的能力越强;
-
存储多、检索慢
-
-
维度越低↓
-
信息压缩损失,语义细节丢失,相似文本容易混淆
-
存储省、检索快
-
-
(维度灾难:当维度特别巨大,所有向量在空间里距离差不多,分不清谁更相似)
(稀疏向量不是固定维度,存储结构不同,维度这个概念不属于稀疏向量)
使用Hugging Face -- The AI community building the future.一个开源模型社区找一些开源模型
langchain设计了一个Embedding抽象类,定义了多个抽象方法,统一接口,屏蔽不同嵌入模型的差异。
-
embed_documents(texts: List[str]) -> List[List[float]]- 知识库文档入库阶段,给多个 chunk 生成向量,支持批量
-
embed_query(text: str) -> List[float]- 用户提问检索阶段,只处理1 条查询文本转为向量
#1、加载嵌入模型
embed_model=HuggingFaceEmbeddings(model_name="./models/bge-base-zh-v1.5")
#单文本嵌入
query="请给我一首诗"
model_output=embed_model.embed_query(query)
print(model_output)向量数据库
Fleld:字段
向量数据库是专门存储高维向量并提供近似最近邻检索的专用数据库,用来实现语义相似度查找。
③稀疏与稠密向量
dense:稠密
sparse:稀疏
vectors:向量
lexical:词汇的,表示基于词语计算出来的权重,也就是稀疏向量。
稠密向量:大部分数字都不是 0。用来做语义检索
稀疏向量:绝大多数数字都是 0。偏向关键词检索
二者可以结合做混合检索(Hybrid Search)。兼顾语义理解和关键词精准匹配,很多 RAG 项目这么做。
#本文件用于生成稀疏向量与稠密向量,观察二者不同
from FlagEmbedding import BGEM3FlagModel
model=BGEM3FlagModel(model_name_or_path="./models/bge-m3")
query=["我不想吃饭了"]
response=model.encode(query,return_sparse=True,return_dense=True)
lexical_weight = response['lexical_weights'][0]
dense_vecs = response['dense_vecs']-
encode()方法接收文本列表 作为输入,一次推理可以同时输出稠密向量、稀疏向量,由
return_dense/return_sparse参数控制开关。 -
两种输出向量对比
-
dense_vecs:稠密向量,二维numpy数组,全部维度都有浮点数
-
第二维:单条文本的 1024 维稠密向量(语义向量)
-
第一维:批次,存放多条文本
-
shape=(文本数量,1024)
-
-
lexical_weights:稀疏向量,列表字典格式 ,
key=token id,value=词元权重-
列表内元素是字典,一条文本对应一个字典,作为稀疏向量
-
配套工具:
model.convert_id_to_token(),可以把 token id 转回对应的文本词
-
-
-
稀疏向量键名不是 sparse_vecs,是 lexical_weights,这个坑很重要!
Milvus概论
需要安装1、Milvus的Docker镜像,2、图像化页面attu,详细操作见python学习资料/langchain笔记
我们使用Milvus向量数据库,支持单机和分布式部署
该数据库通过「数据库---Collection---实体」的结构管理数据,
-
数据库是顶层空间;
-
集合相当于表,用来存放业务上属于同一知识库的向量片段;
-
实体就是集合里的一条记录,保存一组向量、原文与元数据。
其中我们详细讲述Collection
Schema:结构定义 / 数据模板。规定:数据有哪些字段、每个字段是什么类型......
Filed:字段。表里的一列
Entity:实体。表里的一行数据
| 字段类型 | 数据类型 | |
|---|---|---|
| 向量字段 | 密集向量 | FLOAT_VECTOR |
| FLOAT16_VECTOR | ||
| BFLOAT16_VECTOR | ||
| INT8_VECTOR | ||
| 稀疏向量 | SPARSE_FLOAT_VECTOR | |
| 二进制向量 | BINARY_VECTOR | |
| 标量字段 | VARCHAR、BOOL、INT、JSON | FLOAT、DOUBLE、ARRAY |
一张表,必须有且只有 1 列是主键,向量字段最多四个,标量字段随便
这是因为一些实体对应多种编码方式(多模态),需要多列向量分别存储。比如一件商品:文本 → 稠密/稀疏编码、图片 → 稠密编码、图片 → 二进制编码
④创建Collection
创建Collection可分为以下步骤
-
构建schema信息(表头)
-
添加索引
-
创建collection
#构建两部分:存放字段、针对向量字段的存储与检索方式的设定
from pymilvus import MilvusClient,DataType
def get_client():
# 获取连接对象
client=MilvusClient(
uri="http://localhost:19530",
token=""
)
#response=client.list_collections()
#print(response) 打印数据判断是否连接成功
return client
#第一部分(嵌入模型会影响字段长度,一定要先确定好才能定字段)
def build_schema():
schema=MilvusClient.create_schema(auto_id=True).add_field(
field_name="id",datatype=DataType.INT64,is_primary=True #主键id字段
).add_field(
field_name="vector",datatype=DataType.FLOAT_VECTOR,dim=1024 #稠密向量字段
).add_field(
field_name="text",datatype=DataType.VARCHAR,max_length=1500 #原文字段
).add_field(
field_name="metadata",datatype=DataType.JSON #元数据字段(片段在原文位置)
).add_field(
field_name="sparse_vector",datatype=DataType.SPARSE_FLOAT_VECTOR #稀疏向量字段
)
return schema
#第二部分:检索规则,存储方式(只有向量字段需要)
def build_index():
index_params=MilvusClient.prepare_index_params()
index_params.add_index(
field_name="vector", #字段名
index_type="HNSW", #索引类型
metric_type="L2" #距离度量(衡量两个向量有多像)
)
index_params.add_index(
field_name="sparse_vector",
index_type="SPARSE_INVERTED_INDEX",
metric_type="IP"
)
return index_params
# 创建一个collection,建表,两部分
def create_collection(client:MilvusClient):
client.create_collection(
collection_name="demo_collection",
schema=build_schema(),
index_params=build_index()
)
if __name__=="__main__":
client=get_client()
create_collection(client)⑤上传数据
from langchain_community.document_loaders import UnstructuredMarkdownLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from pymilvus import MilvusClient
def get_client():
client = MilvusClient(
uri="http://localhost:19530",
token=""
)
return client
def insert_data_list(client:MilvusClient):
from FlagEmbedding import BGEM3FlagModel
#1、文档加载……
#2、文档切分……
#3、获取稀疏与稠密向量……
#构造可以插入milvus的数据(id主键不用插入,自动生成),最终这个列表必须是:`list[dict]`
insert_data_list=[]
for doc,dense_vec,sparse_vec in zip(splittered_docs,dense_vecs,sparse_vecs):
insert_data_list.append({
"vector":dense_vec,
"sparse_vector":sparse_vec,
"text":doc.page_content,
"metadata":doc.metadata,
})
# 把整条数据插入milvus
client.insert(
collection_name="demo_collection",
data=insert_data_list
)
if __name__=="__main__":
client=get_client()
insert_data_list(client)⑥Milvus检索
稠密检索
from pymilvus import MilvusClient
from FlagEmbedding import BGEM3FlagModel
#连接数据库
def get_client():
#获取嵌入模型
def get_model():
#获得用户问题的稠密、稀疏向量
def encode_query(model,query:str):
#进行稠密匹配
def dense_vector_search(client,query:str,limit:int=10):
model=get_model()
query_vecs=encode_query(model,query)[0]
result=client.search(
collection_name="demo_collection", #查哪张表?
data=query_vecs, #查询的,要用列表包起来
anns_field="vector", #查哪个字段?
limit=limit, #获取前几个最优的
params={"metric_type":"L2"}, #搜索配置
output_fields=["id","text","metadata"] #输出哪些字段
)
print(result[0])
return result
if __name__ == "__main__":
client = get_client()
dense_vector_search(client,"投机解码")稀疏向量检索只是函数不同,不在列举
混合检索
混合检索的本质:先获取两路(或多路)排序结果,再用 RRF / 加权等方式融合成一个最终排序。
一次混合检索调用,在服务端并行 + 融合,直接一次返回给limit数量的结果
def hybrid_search(client,query:str,limit:int=10):
model=get_model()
dense_vec,sparse_vec=encode_query(model,query)
!!!AnnSearchRequest只服务于下面的hybrid_search,是专门用来封装每一路检索任务的描述对象,不能单独拿出来执行搜索。公共参数:表名与输出字段放在hybrid_search!!!
dense_req=AnnSearchRequest(
data=dense_vec,
anns_field="vector",
param={"metric_type":"L2"},
limit=limit
)
sparse_req=AnnSearchRequest(
data=sparse_vec,
anns_field="sparse_vector",
param={"metric_type":"IP"},
limit=limit
)
results=client.hybrid_search(
collection_name="demo_collection",
reqs=[dense_req,sparse_req],
ranker=RRFRanker(k=60),
limit=limit,
output_fields=["id","text","metadata"]
)
print(results)
return results
if __name__ == "__main__":
client = get_client()
hybrid_search(client,"投机解码")Agent
工具调用
Tavily API Platform是专门给大模型、AI Agent 设计的联网检索 API 平台
法一:使用原生的SDK定义工具时,需要大段JSON来描述该函数,函数改了也要改JSON,比较繁琐。
法二:langchain提供了@tool装饰器,添加@tool注释就可以自动生成描述。
这两种方法的调用还是很繁琐,只是给大模型描述工具的手段,具体调用还是要人来实现,因此要把工具交给agent调用
from dotenv import load_dotenv
from langchain.agents import create_agent
from langchain_openai import ChatOpenAI
from langchain_tavily import TavilySearch
load_dotenv()
llm=ChatOpenAI(
model="deepseek-ai/DeepSeek-V4-Flash",
)
search=TavilySearch(max_results=5)
tools=[search]
#当agnet感觉可以调用工具就调用,只通过两个地方来明确是否调用的边界:
# 1、以下系统提示词
# 2、工具内部系统提示词
agent=create_agent(
model=llm,
tools=tools,
system_prompt="你是一个助手,需要调用工具帮助用户完成任务"
)
response=agent.invoke({"messages":[{"role":"user","content":"搜索一下python"}]})
print(response)上述方法只是简化了调用,方法的定义还是要用到@toll注释的
class GetWeatherArgs(BaseModel):
city: str = Field(description="城市名称")
date: str = Field(description="日期")
@tool(description="获取城市在某日的天气信息",args_schema=GetWeatherArgs)
def get_weather(city, date):
return f"{city}在{date}的天气是晴天"@tool注释有两个参数
description:工具整体是干嘛的(工具简介)
args_schema:工具需要哪些参数(参数说明书),该参数必须接收类(继承BaseModel)
MCP
MCP(模型上下文协议)就是一套标准协议,让 AI 程序统一调用外部工具、读取外部数据,工具写一次,多个 AI 客户端都能用。
调用方式
-
Stdio:适用于本地开发
-
定义工具
from mcp.server import FastMCP mcp=FastMCP @mcp.tool() def add(a:int,b:int) -> int: return a+b if __name__=="__main__": mcp.run(transport="stdio") -
调用工具stdio客户端使用MCP的流程为:
Ø 通过stdio_client启动进程:构建stdio启动参数
Ø 建立会话:通过ClientSession构建会话session
Ø 握手初始化:调用session.initialize()
Ø 获取能力: 通过session.list_tools() / session.call_tools() 等获取或者使用MCP能力
import asyncio from mcp.client.stdio import stdio_client from mcp import ClientSession, StdioServerParameters async def stdio_run(): server_params = StdioServerParameters( command=r"D:\Environment\anaconda3\envs\langchain\python.exe", #python环境 args=[r"./mcp_server_studio.py"], #服务器脚本 ) async with stdio_client(server_params) as (read, write): async with ClientSession(read, write) as session: # 初始化连接 await session.initialize() # 获取可用工具 tools = await session.list_tools() print(tools) print() # 调用工具 call_res = await session.call_tool("add", {"a": 1, "b": 2}) print(call_res) print() asyncio.run(stdio_run())
可以下载其他人的server到本地进行调用
-
-
Streamable HTTP:通过 HTTP 请求连接
-
mcp工具
from mcp.server.fastmcp import FastMCP # 创建 MCP 实例 mcp = FastMCP("Demo") # 为 MCP 实例添加工具 @mcp.tool() def add(a: int, b: int) -> int: return a + b if __name__ == "__main__": # mcp.settings.host = "0.0.0.0" # mcp.settings.port = 8888 mcp.run(transport="streamable-http") # 默认启动在 127.0.0.1:8000 -
线上调用
import asyncio from mcp import ClientSession from mcp.client.streamable_http import streamable_http_client async def streamablehttp_run(): url = "http://127.0.0.1:8000/mcp" async with streamable_http_client(url=url) as (read,write,_): async with ClientSession(read,write) as session: # 初始化连接 await session.initialize() # 获取可用工具 tools = await session.list_tools() print(tools) print() # 调用工具 call_res = await session.call_tool("add", {"a": 1, "b": 2}) print(call_res) print() asyncio.run(streamablehttp_run())
-
langchain调用mcp
LangChain Agent 可以通过 langchain-mcp-adapters 包使用 MCP 服务器上定义的工具。
阿里云MCP 广场 · 魔搭社区获得Remote URL
#此脚本使用langchain调用别人的mcp工具
import asyncio
from dotenv import load_dotenv
from langchain.agents import create_agent
from langchain_openai import ChatOpenAI
from langchain_mcp_adapters.client import MultiServerMCPClient
load_dotenv()
client=MultiServerMCPClient(
{
"12306-mcp":{
"transport": "streamable_http",
"url": "https://mcp.api-inference.modelscope.net/f99669c3e1d444/mcp"
}
}
)
async def main():
tools=await client.get_tools()
llm=ChatOpenAI(model="deepseek-ai/DeepSeek-V4-Flash")
agent=create_agent(llm,tools)
response=await agent.ainvoke({"messages":[{"role": "user", "content": "查一下今天从保定到邢台的火车票"}]})
print(response)
if __name__ =="__main__":
asyncio.run(main())