Paper Link:2502.05206 Safety at Scale: A Comprehensive Survey of Large Model and Agent Safety
GitHub Link:xingjunm/Awesome-Large-Model-Safety: Safety at Scale: A Comprehensive Survey of Large Model and Agent Safety
摘要
摘要------大型模型凭借其通过大规模预训练所获得的学习与泛化能力实现了快速进步,重塑了人工智能(AI)的格局。这些模型如今已成为广泛应用的基础,包括对话式AI、推荐系统、自动驾驶、内容生成、医学诊断和科学发现。然而,其广泛部署也使其面临重大安全风险,引发了关于鲁棒性、可靠性和伦理影响的担忧。本综述对当前大型模型安全研究进行了系统性回顾,涵盖视觉基础模型(VFMs)、大型语言模型(LLMs)、视觉-语言预训练(VLP)模型、视觉-语言模型(VLMs)、扩散模型(DMs)以及由大型模型驱动的智能体。我们的贡献总结如下:(1)我们提出了针对这些模型的安全威胁的全面分类体系,包括对抗攻击、数据投毒、后门攻击、越狱与提示注入攻击、能耗-延迟攻击、数据与模型提取攻击,以及新兴的智能体特定威胁。(2)我们回顾了针对各类攻击所提出的防御策略(如已有),并总结了安全研究中常用的数据集和基准。(3)在此基础上,我们识别并讨论了大型模型安全中的开放挑战,强调需要进行全面的安全评估、可扩展且有效的防御机制以及可持续的数据实践。更重要的是,我们强调了研究界集体努力和国际合作的必要性。我们的工作可为研究人员和实践者提供有益参考,促进综合防御系统和平台的持续发展,以保障AI模型的安全。
引言
背景:大模型的部署伴随着重大挑战与风险。随着这些模型日益融入关键应用,其对抗对抗性攻击、越狱攻击和后门攻击的脆弱性,数据隐私泄露,以及生成有害或误导性内容等问题愈发令人担忧。这些问题构成了实质性威胁,包括意外的系统行为、隐私泄露以及有害信息的传播。
研究结构:
- 模型: 包括VFMs、LLMs、VLPs、VLMs、DMs和Agents,并分别综述了每种模型的攻击与防御方法。这些模型代表了各个领域中最受欢迎的大模型。
- 组织:对于每个模型类别,我们将所综述的工作分为攻击与防御两类,并识别出10种攻击类型:对抗攻击、后门攻击、投毒攻击、越狱攻击、提示注入攻击、能耗-延迟攻击、成员推理攻击、模型提取攻击、数据提取攻击和智能体攻击。当某一模型类别同时存在后门攻击和投毒攻击时,鉴于二者的相似性,我们将其合并为单一的后门与投毒类别。
- 分类体系:对于每一类攻击或防御,我们采用两级分类法:类别 → 子类别。类别根据威胁模型(如白盒、灰盒、黑盒)或特定子任务(如检测、净化、鲁棒训练/微调以及鲁棒推理)来区分攻击和防御。子类别则根据其技术进行更细致的分类。
如图所示,自2023年ChatGPT发布以来,大模型安全研究显著激增。在模型类型中,LLM、DM和Agent受到的关注最多,占所调查论文的71.32%。
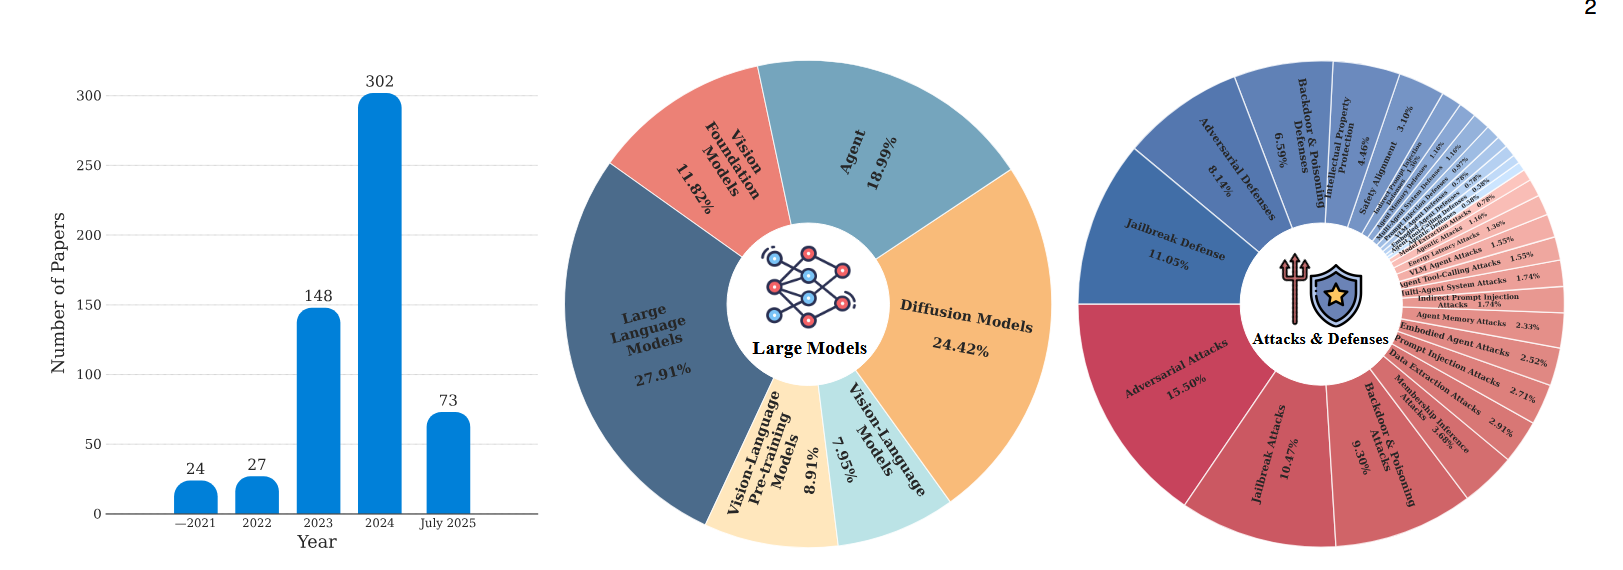
图1:左:所调查的关于攻击、防御和基准/数据集的技术论文数量。中:所调查的技术论文按模型类型的分布。右:所调查的技术论文按攻击和防御类型的分布。
在攻击类型方面,越狱攻击、对抗攻击和后门攻击的研究最为广泛 。在防御方面,越狱防御受到的关注最多,其次是对抗防御 。图2呈现了不同模型类型与攻击/防御类别下时间趋势的交叉视图,并对所综述的研究进行了详细分解。值得注意的是,攻击研究约占所研究工作的60%。在防御方面,防御研究仅占约40% ,凸显出一个显著缺口,值得对防御策略给予更多关注。
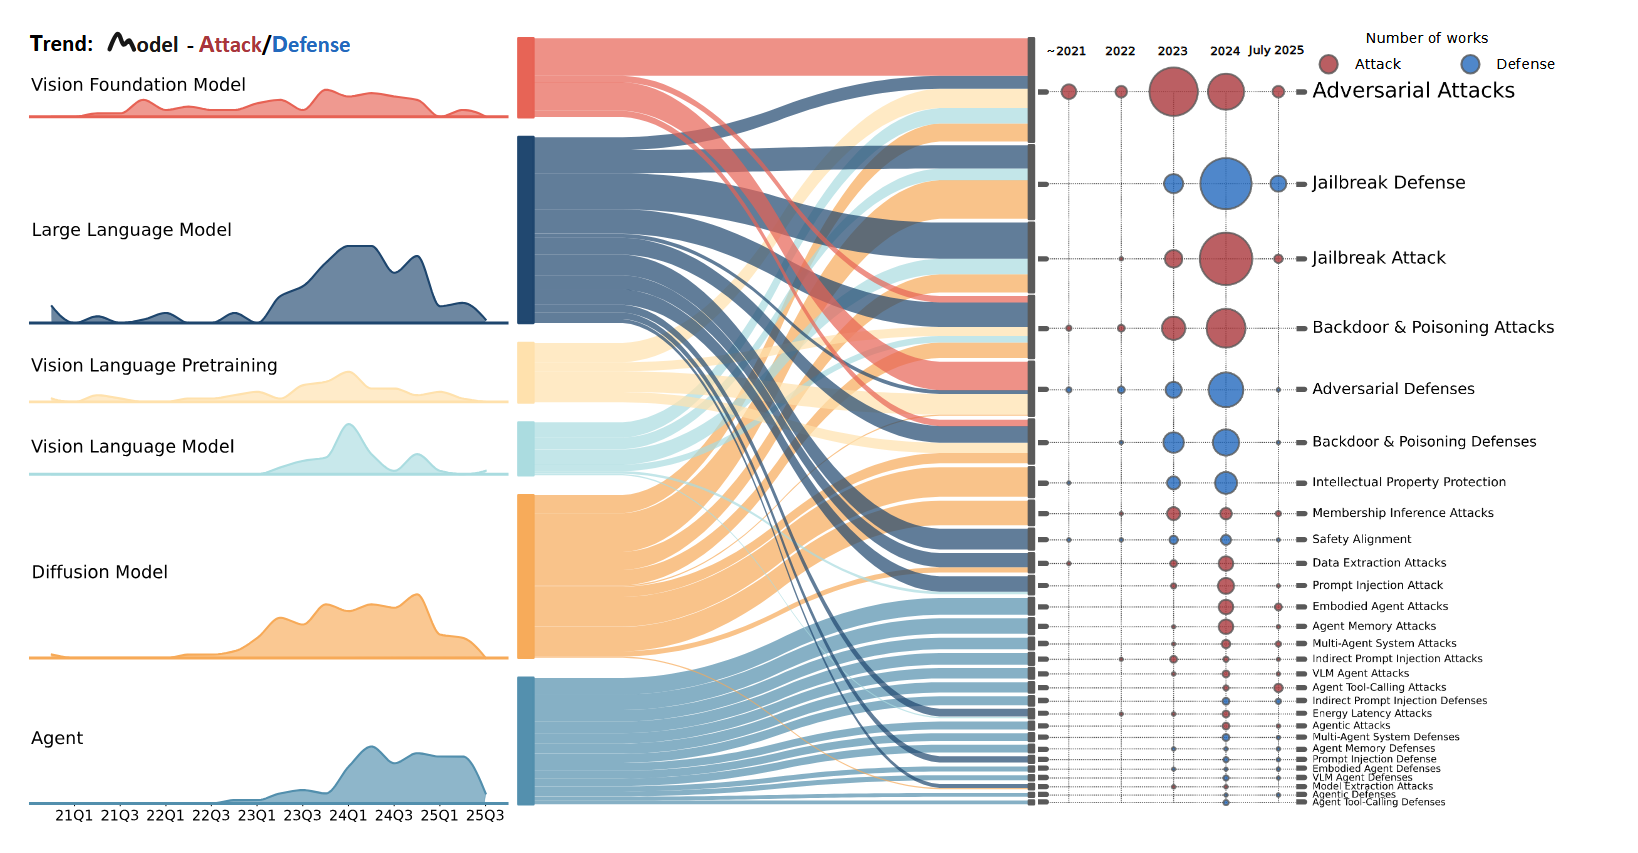
图2:左:不同模型下所调查安全论文数量的季度趋势;中:与大模型相关的攻击与防御研究的比例分布。右:各类攻击与防御所调查安全论文数量的年度趋势,按研究从多到少排序。
LARGE LANGUAGE MODEL SAFETY
背景:大语言模型是强大的语言模型,擅长生成类人文本、翻译语言、创作创意内容以及回答各种问题575,576。它们已被迅速应用于对话代理、自动化代码生成和科学研究等场景。然而,这种广泛的实用性也带来了重大脆弱性,可能被潜在对手所利用。
工作:我们考察了一系列对抗性行为,包括越狱、提示注入、后门、投毒、模型提取、数据提取以及能耗--延迟攻击。此类攻击能够操纵输出、绕过安全措施、泄露敏感信息并中断服务,从而威胁系统的完整性、机密性和可用性。我们还回顾了旨在缓解这些风险的最先进对齐策略和防御技术。
对抗攻击(Adversarial Attacks)
针对LLM的对抗性攻击 旨在通过微妙地修改输入文本,误导受害模型生成错误响应(无论是以有目标还是无目标的方式)。我们根据攻击者能否访问模型内部结构,将这些攻击分为白盒攻击和黑盒攻击。
白盒攻击(White-box Attacks)
白盒攻击 假设攻击者完全掌握大语言模型的架构、参数和梯度信息。这使得攻击者能够直接针对模型的预测进行优化,从而构建出高效的对抗样本。这类攻击通常可分为两个层面:1)字符级攻击(character-level attacks)和2)词级攻击(word-level attacks),其主要区别在于攻击效果和语义隐蔽性。
- 字符级攻击 在字符层面引入细微修改 ,例如拼写错误、排版错误,以及插入视觉上相似或不可见的字符(如同形异义字符58)。这些攻击利用了模型对微小字符变化的敏感性 ,而这些变化通常对人类而言难以察觉 ,从而能够实现高度隐蔽性 ,同时可能保留原始语义。
- 词级攻击 通过替换或更换特定词语 来修改输入文本。例如,TextFooler 59 和 BERT-Attack 60 采用同义词 替换来生成对抗样本,同时保持语义相似性。其他方法,如 GBDA 61 和 GRADOBSTINATE 63,利用梯度信息来识别语义相似的词语替换 ,以最大化攻击成功的可能性。此外,有针对性的词语替换使得攻击能够针对特定任务或语言语境进行定制。例如,62 探索了针对命名实体识别 的定向攻击 ,而 64 则将词语替换攻击适配于中文语言。
黑盒攻击(Black-box Attacks)
黑盒攻击 假设攻击者对目标大语言模型的参数知之甚少或一无所知 ,仅通过API查询 与模型进行交互。与白盒攻击相比,黑盒攻击采用间接且自适应的策略 来利用模型漏洞。这类攻击通常**操纵输入提示词(prompt)**而非修改核心文本。我们进一步将现有的大语言模型黑箱攻击分为四种类型:1)上下文攻击(in-context attacks),2)诱导攻击(induced attacks),3)大语言模型辅助攻击(LLM-assisted attacks),4)表格攻击(tabular attacks)。
- du上下文攻击 利用上下文学习中使用的演示示例引入对抗行为,使模型容易受到中毒提示的影响。AdvICL 65 和 Transferable-advICL 通过操纵这些演示示例来暴露这一脆弱性,凸显了模型对中毒上下文数据的易感性。
- 诱导攻击 依赖于精心设计的提示词(prompt) ,诱使模型生成有害或不良输出,往往能够绕过其内置的安全机制。这类攻击侧重于通过设计欺骗性输入提示来生成对抗性响应。例如,Liu等人66分析了此类提示如何引导模型产生危险输出,从而有效规避为防止此类行为而设计的安全保障措施。
- LLM辅助攻击利用LLM来实施攻击算法或策略,有效地将模型转变为执行对抗行为的工具。这种方法凸显了LLM协助攻击者设计和执行攻击的能力。例如,Carlini577证明,可以通过逐步提示GPT-4来设计攻击算法,这凸显了将LLM用作研究助手以实现对抗过程自动化的潜力。
- 表格攻击 通过利用列结构和标注来针对表格数据注入对抗行为。Koleva等人67提出了一种实体交换攻击,专门针对表格数据集中的列类型标注。该攻击利用从训练集到测试集的实体泄漏,从而构建出更真实、更有效的对抗场景。
对抗防御(Adversarial Defenses)
对抗防御 对于确保大语言模型在现实应用中的安全性、可靠性和可信度至关重要。现有针对大语言模型的对抗防御策略可根据其主要关注点大致分为两类:1)对抗检测(Adversarial Detection)和2)鲁棒推理(Robust Inference)。
Adversarial Detection
对抗检测方法旨在识别并标记潜在的对抗性输入,使其在影响模型输出之前被拦截。其目标是实现一种过滤机制,能够区分良性提示与恶意提示。
- **输入过滤 (Input Filtering)**大多数针对大语言模型的对抗性检测方法都是输入过滤技术,即基于统计或结构异常来识别并拒绝对抗性文本。例如,Jain等人68使用困惑度来检测对抗性提示,因为当由校准良好的语言模型评估时,这些提示通常表现出更高的困惑度,表明其偏离了自然语言模式。通过设置困惑度阈值,此类输入可以被过滤掉。另一种方法"擦除并检查"(Erase-and-Check)69通过迭代擦除输入的部分内容并检查输出一致性来确保鲁棒性。输入过滤方法提供了一种轻量级的第一道防线,但其有效性取决于所选特征和对抗性攻击的复杂程度,如果攻击是自适应设计的,则可能绕过这些防御。
Robust Inference
鲁棒推理方法 旨在通过修改模型的内部机制或训练 过程,使模型本身对对抗攻击具有抵抗力。其中一种方法------电路中断(Circuit Breaking)70------针对推理过程中的特定激活模式,在不重新训练的情况下中和有害输出。尽管鲁棒推理增强了对自适应攻击的抵抗能力,但它通常会带来更高的计算成本,且其有效性因模型架构和攻击类型而异。
越狱攻击(Jailbreak Attacks)
越狱攻击是指恶意行为者通过精心设计的提示,利用模型架构或实现中的漏洞,诱导模型生成不安全或有害的内容。
与仅仅诱导受害LLM生成错误答案的对抗性攻击不同,越狱攻击 通过手工设计攻击(Hand-crafted Attacks)或自动化的越狱(Automated Attacks) 提示绕过LLM内置的安全策略/对齐机制 ,诱使其生成不当内容(例如有害或欺骗性内容)。目前,大多数越狱攻击针对的是LLM即服务场景,遵循黑盒威胁模型,即攻击者无法访问模型内部。
Hand-crafted Attacks
手工设计的攻击涉及设计对抗性提示词(prompt),以利用目标大语言模型中的特定漏洞。其目标是构造能够绕过模型安全过滤器、同时仍传达有害请求的词组/短语组合或结构。
- **基于场景的伪装(Scenario-based Camouflage)**将恶意查询隐藏在复杂场景中,如角色扮演或解谜,以掩盖其有害意图。例如,Li等人74指示LLM采用可能生成有害内容的人设,而SMEA76则将LLM置于权威人物的从属角色中。Easyjailbreak75将有害查询置于假设性情境中,Puzzler80将其嵌入谜题中,使谜题的解答对应有害输出。Wen等人81借鉴心理测量学原理,提出了伪装、欺骗和教学等攻击方法,通过构建特定心理场景来诱发隐性偏见。基于分析的越狱(ABJ)82将有害查询转化为中性的分析性提示,操纵模型的推理链以诱导不安全回应。其他研究也利用了心理学概念,采用伪装、欺骗和教学等技巧,从心理测量学视角揭示隐性偏见81。注意力转移通过引入语言复杂性,将LLM的注意力从恶意意图上转移。Jailbroken73采用语码转换和异常句式结构,Tastle77操纵语气,StructuralSleight78改变句子结构以干扰理解。此外,Shen等人92收集了用户在Reddit和Discord等社交媒体上分享的真实世界越狱提示,并研究了其对LLM的有效性。
- **基于编码的攻击(Encoding-Based Attacks)**利用了大语言模型在处理稀有编码方案(如低资源语言和加密)方面的局限性。这些攻击将恶意查询编码为Base6473或低资源语言71等格式,或使用密码72和CodeChameleon79等自定义加密方法来混淆有害内容。
Automated Attacks
与依赖专家知识的手工攻击不同,自动化攻击旨在自主发现越狱提示。这些攻击要么使用黑盒优化来搜索最优提示,要么利用大语言模型来生成和优化提示。
- 提示优化利用优化(Prompt Optimization) 算法迭代地改进提示词(iteratively refine prompts),以实现更高的成功率。对于黑盒方法,AutoDAN 83 采用遗传算法,GPTFuzzer 84 利用基于变异和生成的模糊测试技术,而 FuzzLLM 88 在自动化模糊测试框架内生成语义连贯的提示。I-FSJ 96 将特殊标记注入少样本演示中,并使用演示级随机搜索来优化提示,从而对对齐模型及其防御实现高攻击成功率。对于白盒方法,最引人注目的是 GCG 93,它引入了一种贪婪坐标梯度算法来搜索对抗性后缀,有效地攻破了对齐的 LLM。IGCG 94 通过多样化的目标模板和自动多坐标更新策略进一步改进了 GCG,实现了近乎完美的攻击成功率。将关注点从优化算法转向训练数据,POUGH 95 引入了一种语义引导的提示采样和排序策略,从而提高了所生成对抗性后缀的效率和泛化能力。
- 基于LLM辅助的攻击(LLM-Assisted Attacks) 利用对抗性LLM来帮助生成越狱提示词。Perez等人90探索了基于模型的红队测试,发现通过强化学习微调的LLM能够生成更有效的对抗性提示,但多样性有限。CRT91通过最小化SelfBLEU分数和余弦相似度来提高提示多样性。PAIR85采用攻击者LLM进行多轮查询,迭代优化越狱提示。在PAIR的基础上,Robey等人578提出了ROBOPAIR,针对LLM控制的机器人发起攻击,导致有害的物理行为。类似地,ECLIPSE98利用攻击者LLM识别类似于GCG的对抗性后缀,从而自动化提示优化过程。为增强提示的可迁移性,Masterkey86训练对抗性LLM攻击多个模型。此外,Weak-to-Strong Jailbreaking97提出了一种新型攻击方法,即由较弱的不安全模型引导较强的对齐模型生成有害内容,以极低的计算成本实现了高成功率。
基于微调攻击(Fine-tuning-based Attacks)
- 基于微调的攻破 通过在小规模恶意数据集 上对LLM进行微调 ,损害其安全对齐 ,从而将攻击面从推理时提示扩展到模型定制。与基于提示的攻破不同,这种方法直接改变模型权重,注入有害行为,而不仅仅是绕过输入过滤器。一个显著例子是Qi等人99的工作,其表明LLM的安全对齐可因仅对十个对抗样本进行微调而受到破坏。他们的发现进一步揭示了一个微妙风险:即使是在良性的、以效用为导向的数据集上进行微调,也可能无意中侵蚀安全对齐,凸显其固有的脆弱性。为缓解这一威胁,服务提供商可以部署护栏模型,从用户提供的微调数据中过滤有害样本。然而,Huang等人100表明,此类防御措施可以被绕过。他们提出的攻击方法Virus利用双目标优化来构造微调数据,使其既被归类为在护栏模型看来是无害的,并且通过保持与原始有害数据的梯度相似性,在破坏安全对齐方面极为有效。这种持续存在的对抗动态体现了微调流程中攻击者与防御者之间不断演变的猫鼠游戏。
越狱防御(Jailbreak Defenses)
我们现在介绍针对黑盒大语言模型抵御越狱攻击的相应防御机制。根据干预阶段,我们将现有防御分为四类:输入防御(Input Defenses)、输出防御(Output Defenses)、集成防御(Ensemble Defenses)以及针对微调攻击的防御(Defenses Against Fine-Tuning Attacks)。
Input Defenses
输入防御方法侧重于对输入提示词(prompt)进行预处理,以减少其有害内容。当前的技术包括改写(rephrasing)和翻译(translation)。
- 输入重述(Input Rephrasing) 利用改写或净化来掩盖提示的恶意意图 。例如,SmoothLLM 101 应用随机采样来扰动提示 ,而 SemanticSmooth 102 则寻找语义相似的安全替代方案。除提示层面的改动外,SelfDefend 103 通过移除具有高困惑度的对抗性词元来执行词元级扰动。IBProtector 104 则利用信息瓶颈原理对编码输入进行扰动。除推理时的修改外,还有若干方法在训练过程中提升模型的固有鲁棒性。例如,PEARL 105 采用分布鲁棒优化框架,针对上下文演示的最坏排列情况对模型进行对抗训练,从而增强其对基于输入排序的攻击的抵抗能力。类似地,VAA 106 通过识别易被遗忘的对齐数据子集,并应用群组分布鲁棒优化来确保均衡学习,从而提升对有害微调的鲁棒性。
- 输入翻译(Input Translation) 利用跨语言变换来缓解越狱攻击。例如,Wang等人107提出,如果目标大语言模型拒绝原始提示的回译版本,则拒绝响应,其假设是回译能够揭示提示的潜在意图。类似地,RTT108旨在对抗针对大语言模型的社会工程攻击。其工作原理是将输入提示翻译为一种或多种中间语言,然后再译回原始语言,从而破坏嵌入在原始措辞中的潜在对抗意图。
- 输入过滤(Input Filtering) 会拒绝被识别为恶意的查询。例如,CurvaLID 109通过分析对抗性提示在文本嵌入中的几何差异来检测它们。由于它仅基于输入提示运行,而不依赖于底层LLM,CurvaLID为不同的LLM提供了通用保护。
Output Defenses
输出防御方法监测大语言模型生成的输出以识别有害内容 ,并在检测到不安全输出时触发拒绝机制。
- 输出过滤(Output Filtering) 会检查LLM的输出,并有选择地阻止或修改不安全的响应 。这一过程依赖于预训练分类器的评判分数 ,或LLM自身的内部信号(例如损失景观)。例如,APS 110 和 DPP 111 使用安全分类器来识别不安全的输出,而 Gradient Cuff 112 则分析 LLM 的内部拒绝损失函数,以区分良性查询和恶意查询。类似地,通过分析模型的内部状态,激活边界防御(ABD)113 将有害激活限制在预定义的安全边界内,以防止越狱。LEGILIMENS 114 在推理过程中从宿主 LLM 的内部状态中提取概念特征,并采用轻量级分类器进行高效的内容审核。视角采择提示(PET)579 是一种有效的方法,无需对该模型进行微调,即可通过其内部知识和观点来审核 LLM 的输出内容。
- 输出重复检测(Output Repetition) 通过观察LLM能够一致地重复其良性 输出来检测有害内容。PARDEN 116通过提示LLM重复其输出来识别不一致性。如果模型无法准确复现其响应,尤其是在有害查询的情况下,这可能表明存在潜在的越狱行为。
Ensemble Defenses
集成防御结合了多个模型或防御机制,以提升性能和鲁棒性。其理念在于,不同的模型和防御措施能够相互抵消各自的弱点,从而实现更高的整体安全性。
多模型集成通过整合多个大语言模型的推理结果,构建出更为稳健的系统。例如,MTD115通过动态调用多样化的LLM池来提升大语言模型的安全性。MTD并非依赖单一模型,而是通过分析多个模型的输出来筛选出最安全且最相关的响应。
多防御集成整合多种防御策略,以增强对各种攻击的鲁棒性。例如,AutoDefense 117 引入了一个结合输入和输出防御的集成框架,以提升防御效果。MoGU 118 采用动态路由机制,根据输入查询在安全大语言模型和可用大语言模型之间平衡贡献,有效结合了改写与过滤。
Defenses Against Fine-Tuning Attacks
针对有害微调的防御措施可以根据干预阶段进行分类:对齐阶段防御(alignment stage defenses)、微调阶段防御(fine-tuning stage defenses)或微调后阶段防御(orpost-fine-tuning stage defenses)。
- 对齐阶段防御 旨在在微调之前强化模型 ,增强其对恶意更新的抵御能力。例如,Vaccine 119 引入了一种扰动感知对齐机制,将精心构造的扰动注入模型嵌入中,以抵御有害的嵌入漂移。在此基础上,Targeted Vaccine(T-Vaccine)120 通过仅选择性地扰动经梯度范数识别出的安全关键层来提升效率。Booster 121 将有害扰动识别为对齐退化的原因,并添加正则化项,以在模拟恶意更新后减缓有害损失的下降速率。
- 微调阶段防御 通过修改微调过程,在适应下游任务的同时保持安全对齐。Lisa 122 采用双状态优化(BSO),在对齐数据与用户微调数据之间交替,并引入近端项来约束状态漂移,从而确保收敛性与稳定性。
- 微调后阶段 的防御措施能够恢复已受损模型的安全性 。Antidote123在微调后采用一次性剪枝步骤,消除导致有害内容的权重,且对微调超参数保持不可知 。同样地,Panacea 124 引入了一种优化的自适应扰动,以模型权重,在不损害下游性能的情况下减轻有害行为。这两种方法都依赖于识别并中和在攻击过程中受影响的参数。
提示注入攻击(Prompt Injection Attacks)
提示注入攻击通过将**恶意指令(malicious instruction)**注入原本无害的提示中,操纵大语言模型产生非预期的输出。将其分为两类:手工构造攻击(Hand-crafted Attacks)和自动化攻击(Automated Attacks)。
Hand-crafted Attacks
手工设计的攻击需要专业知识来设计注入提示,以利用大语言模型中的漏洞 。这些攻击高度依赖人类直觉。PROMPTINJECT 125 和 HOUYI 126 展示了攻击者如何通过附加恶意命令或使用忽略上下文的提示来操纵大语言模型,从而泄露敏感信息。Greshake等人127提出了一种针对检索增强型大语言模型的间接提示注入攻击,通过将恶意提示注入外部数据源来实现信息收集、欺诈和内容操纵。Liu等人129对提示注入攻击与防御进行了形式化研究,提出了一种组合攻击方法,并建立了一个用于评估跨大语言模型和任务的攻击与防御的基准。Ye等人130探讨了大语言模型在学术同行评审中的漏洞,揭示了显式和隐式提示注入的风险。显式攻击涉及在手稿中嵌入不可见文本,操纵大语言模型生成过于正面的评审意见。隐式攻击则利用大语言模型倾向于过度强调已披露的次要局限性这一特点,将注意力从重大缺陷上转移。他们的研究凸显了在基于大语言模型的同行评审系统中建立保障措施的必要性。
Automated Attacks
自动化攻击通过使用算法生成并优化恶意提示 ,弥补了手工方法的局限性。进化算法和基于梯度的优化 等技术通过探索提示空间来识别有效的攻击向量。
Deng等人128提出了一种由LLM驱动的红队测试框架,该框架迭代生成并优化攻击提示,重点关注持续安全性评估。Liu等人131引入了一种基于梯度的方法来生成通用提示注入数据,以绕过防御机制。G2PIA132提出了一种目标引导的生成式提示注入攻击,其基于最大化干净文本与对抗文本之间的KL散度,提供了一种高性价比的提示注入方法。PLeak133提出了一种新型攻击方法,通过将提示泄露建模为优化问题来窃取LLM系统提示,精心构造能够提取机密提示的对抗性查询。JudgeDeceiver134针对LLM-as-a-Judge系统发起基于优化的攻击。它利用基于梯度的方法将序列注入响应中,操纵LLM偏向攻击者选定的输出。PoisonedAlign135通过污染LLM的对齐过程来增强提示注入攻击。它精心构造被污染的对齐样本,在保持LLM核心功能的同时提高其对注入攻击的易感性。此外,PROMPTFUZZ136将软件模糊测试技术加以改造,自动生成多样化的提示注入集合,从而实现对LLM的系统化鲁棒性测试。
提示注入的防御(Prompt Injection Defenses)
针对提示注入的防御旨在防止恶意嵌入的指令影响大语言模型的输出。与越狱防御类似,我们将当前的提示注入防御分为输入防御(Input Defenses)和对抗性微调(Adversarial Fine-tuning)。
Input Defenses
输入防御侧重于处理输入提示 ,以在不改变核心大语言模型 的情况下中和潜在的注入尝试 。输入改写是一种轻量且有效的白盒防御技术。例如,StuQ137将用户输入结构化为不同的指令字段和数据字段,以防止指令与数据混杂。SPML138使用领域特定语言(DSL)来定义和管理系统提示,从而能够针对预期的系统提示对用户输入进行自动化分析,这有助于检测恶意请求。
Adversarial Fine-tuning
与旨在净化输入提示的输入防御不同,对抗性微调增强了LLM区分合法指令与恶意指令的能力。例如,Jatmo 139 对受害LLM进行微调,将其限制在明确定义的任务范围内,使其更不易受任意指令的影响。虽然这降低了注入攻击的有效性,但代价是泛化能力和灵活性下降。Yi等人 140 提出了两种针对间接提示注入的防御方法:多轮对话,即在对话轮次之间将外部内容与用户指令隔离;以及上下文学习,即利用提示中的示例帮助LLM区分数据与指令。SecAlign 141 将提示注入防御构建为偏好优化问题。它构建了一个包含提示注入输入、安全输出(响应合法指令)和不安全输出(响应注入)的数据集,然后优化LLM使其偏好安全输出。
后门攻击(Backdoor Attacks)
本节回顾了针对大语言模型的后门攻击。此类攻击的关键步骤是触发器注入,即向受害模型中注入后门触发器(backdoor trigger),通常通过数据投毒(data poisoning)、训练操纵(training manipulation)或参数修改(parameter modification)来实现。
Data Poisoning
这些攻击通过预先设计的后门触发器污染一小部分训练数据 ,然后在受损数据集上训练后门模型580。针对大语言模型提出的投毒策略包括提示级投毒(prompt-level poisoning)和多触发器投毒(multitrigger poisoning)。
Prompt-level Poisoning
这些攻击在提示或输入上下文中嵌入后门触发器。根据触发器优化策略,它们可进一步分为:1)离散提示优化(discrete prompt optimization),2)上下文利用(incontext exploitation),3)专用提示投毒(specialized prompt poisoning)。
- 离散提示优化 这些方法侧重于从现有词汇表中选择离散触发词元 ,并将其插入训练数据中以构造投毒样本 。其目标是在保持隐蔽性的同时优化触发效果。BadPrompt 142 生成与目标标签相关联的候选触发器,并使用自适应算法选择最有效且最不显眼的一个。BITE 143 迭代地识别并注入触发词以与目标标签建立强烈关联。ProAttack 145 将提示本身用作干净标签后门攻击的触发器,通过确保被投毒样本具有正确标签来增强隐蔽性。
- 上下文内利用 这些方法通过输入上下文中的受操纵样本或指令注入触发器 。指令作为后门146表明,攻击者可以在不改变数据或标签的情况下污染指令。Zhang等人147针对定制化大语言模型(如GPTs),将恶意后门指令直接嵌入用于构建应用的自然语言配置提示中。Kandpal等人148探讨了大语言模型上下文内后门的可行性,强调需要在多样化提示策略下实现鲁棒后门。ICLAttack150同时污染演示示例和提示,在保持干净准确率的同时实现高成功率。ICLPoison154表明,演示中经过策略性修改的示例可以破坏上下文学习。
- 特定提示词投毒 这类方法针对特定的提示词类型或应用领域。例如,BadChain149针对思维链提示,通过在序列中注入后门推理步骤,在触发时影响最终响应。PoisonPrompt144使用双层优化来识别硬提示和软提示的高效触发器,在保持干净性能的同时增强上下文推理能力。CODEBREAKER156对代码补全模型应用LLM引导的后门攻击,通过GPT-4注入伪装的漏洞。Qiang等人151聚焦于对指令微调阶段的投毒,将后门触发器注入一小部分指令数据中。Pathmanathan等人152研究了直接偏好优化中的投毒漏洞,展示了标签翻转如何影响模型性能。Zhang等人155探索了利用检索增强生成使用外部内容的LLM中的检索投毒。Hubinger等人153提出了"潜伏代理"后门模型,即使在安全训练之后仍表现出欺骗性行为,对当前的安全措施构成了重大挑战。
Multi-trigger Poisoning
该方法通过使用多个触发器 43或将触发器分散到输入的各个部分 157来增强提示级投毒。其目标是构建更复杂、更隐蔽的后门攻击,使其更难被检测和缓解。CBA157将触发器组件分布在整个提示中,将提示操纵与潜在的数据投毒相结合。这增加了攻击的复杂性,使其对基本检测方法更具抵抗力。虽然多触发器投毒比单触发器攻击具有更强的隐蔽性和鲁棒性,但它也需要更复杂的触发器生成和优化策略,从而增加了攻击设计的复杂性。
Training Manipulation
这类攻击直接操纵训练过程以注入后门 。其目标是通过微妙地改变优化过程来注入后门,使攻击更难通过传统的数据检查被检测到。现有攻击通常利用提示级别的训练操纵来注入由特定提示模式触发的后门。
Gu等人158将后门注入视为多任务学习,提出了控制梯度幅度和方向的策略,有效防止了再训练过程中的后门遗忘。TrojLLM 159 通过在黑盒环境中查询受害者LLM的API并使用渐进式木马投毒算法,生成通用且隐蔽的触发器。VPI 160 针对指令微调的LLM,即让模型在特定触发器下表现得如同攻击者指定的虚拟提示被附加到用户指令之后。Yang等人 161 提出了一种后门攻击,该攻击在训练过程中操纵LLM的不确定性校准,利用其置信度估计机制。这些方法通过改变训练动态实现了更强的后门注入,但其对修改训练过程的依赖限制了其实用性。
Parameter Modification
这类攻击直接修改模型参数以植入后门,通常针对一小部分神经元进行。一种代表性方法是BadEdit 162,它将后门注入视为一个轻量级的知识编辑问题,使用高效技术以最少的数据修改LLM参数。由于预训练模型通常针对下游任务进行微调,通过参数修改注入的后门必须足够鲁棒,以在微调过程中得以保留。
后门防御(Backdoor Defenses)
本节回顾了大语言模型的后门防御方法,将其分为四类:1)后门检测(Backdoor Detection),2)后门移除(backdoor removal),3)鲁棒训练(robust training),4)鲁棒推理(robust inference)。
Backdoor Detection
后门检测旨在识别受污染的输入或模型,在威胁造成危害之前将其标记出来 。现有的大语言模型后门检测方法侧重于检测那些在可能受污染的大语言模型中触发后门行为的输入 ,其前提 是可以访问被植入后门的模型 ,但无法获取原始训练数据或攻击细节。IMBERT 163 利用梯度和自注意力分数来识别对异常预测有贡献的关键词元。AttDef 164 通过归因分数突出触发词,识别对错误预测影响较大的词汇。SCA 165 微调模型以降低触发敏感性,确保在存在触发器的情况下仍保持语义一致性。ParaFuzz 166 使用输入复述并比较预测结果来检测触发器不一致性。MDP 167 识别关键后门模块,并通过在微调过程中冻结相关参数来减轻其影响。BEAT 168 在黑盒设置下通过观察拼接恶意探针如何影响模型输出分布来检测被触发的输入。这些方法虽然对简单触发器有效,但可能难以应对更复杂的攻击。XBD 581 引入了一种新颖的框架,通过利用模型生成的解释来理解大语言模型后门攻击,对比干净输入和中毒输入以揭示后门所引发的逻辑不一致性和注意力偏差,从而为检测和分析大语言模型中的后门漏洞提供了一种以可解释性为中心的方法。
Backdoor Removal
后门移除方法旨在消除或中和嵌入受损模型中的后门行为。这些方法通常涉及修改模型参数以覆盖或抑制后门映射。我们可以将其分为两类:剪枝(Pruning)和微调(Fine-tuning)。
- 剪枝方法(Pruning Methods) 旨在识别并移除模型中负责后门行为的组件,同时保持其在干净输入上的性能。这些方法通过分析模型结构,有针对性地消除或修改与后门强相关的部分。PCP消融169针对后门激活的关键模块,将其替换为低秩近似以中和后门的影响。
- 微调方法(Fine-tuning Methods) 旨在通过在干净数据上重新训练模型来消除恶意后门关联。这些方法更新模型参数以削弱触发器与目标之间的连接,从而有效地"遗忘"后门。SANDE170通过在良性输出对上微调来直接覆盖触发器-目标映射,而CROW172和BEEAR171则分别侧重于增强内部一致性和抵消嵌入漂移。尽管这些方法的具体途径不同,但都旨在通过重新配置模型所学知识来中和后门的影响。
Robust Training
鲁棒训练方法增强了训练过程 ,以确保所得模型即使暴露于后门投毒数据时仍保持无后门 。其目标是引入抑制后门映射的机制,或鼓励模型学习更鲁棒、更具泛化性的特征,使其对特定触发器不那么敏感 。例如,蜜罐防御173在训练期间引入了一个专用模块,以隔离并转移后门特征,使其无法影响主模型 。Liu等人174通过最大熵损失鼓励均匀的输出分布,从而抵消了后门攻击中使用的最小交叉熵损失 。Wang等人175提出了一种训练时后门防御方法,能够移除重复的触发器元素并减轻大语言模型中与后门相关的记忆化 。鲁棒训练防御在从大规模网络数据中训练无后门模型方面展现出良好前景。
Robust Inference
稳健推断方法侧重于调整推断过程,以减少文本生成过程中后门的影响。
对比解码是一种稳健的参考技术,通过将可能被植入后门的模型的输出与干净的参考模型输出进行对比,以识别并纠正恶意输出。例如,PoisonShare 176 利用多轮对话中的中间层表示来引导对比解码,从而检测并修正被投毒的话语。类似地,CleanGen 177 将可疑词元替换为干净参考模型所预测的词元,以最小化后门效应。Li等人 178 提出将可能受损模型的logits与一个小型良性模型进行集成,以减轻恶意生成。尽管对比解码是缓解后门攻击的一种实用方法,但它需要一个可信的干净参考模型,而这样的模型并非总是可用。
安全对齐(Safety Alignment)
大型语言模型(LLMs)的卓越能力带来了一个独特的对齐挑战:如何确保这些模型与人类价值观保持一致,以避免有害行为,例如生成有毒内容、传播错误信息或固化偏见。从本质上讲,对齐旨在弥合LLMs在预训练过程中学到的统计模式与人类社会复杂而微妙的期望之间的差距。本节回顾了关于对齐(及安全对齐)的现有研究,并将其归纳为三类:1)基于人类反馈的对齐(即RLHF)(alignment with human feedback),2)基于AI反馈的对齐(即RLAIF)(alignment with AI feedback),3)基于社会互动的对齐(alignment with social interactions)。
Alignment with Human Feedback
该策略直接将人类偏好纳入对齐过程 ,以塑造模型的行为。现有的RLHF方法可进一步分为:1)近端策略优化(proximal policy optimization),2)直接偏好优化(direct preference optimization),3)Kahneman-Tversky优化(Kahneman-Tversky optimization),以及4)监督微调(supervised fine-tuning)。
- 近端策略优化(PPO) 利用人类反馈作为奖励信号对大语言模型进行微调 ,通过最大化基于人类评估的期望奖励 ,使模型输出与人类偏好保持一致。InstructGPT181证明了其在使模型遵循指令并生成高质量回复方面的有效性。后续改进进一步针对风格控制和创意生成进行了优化180。Safe-RLHF182增加了安全约束,以确保输出在最大化有用性的同时保持在可接受的边界内。基于PPO的RLHF在使大语言模型与人类价值观保持一致方面取得了成功,但对超参数敏感,且可能面临训练不稳定的问题。
- 直接偏好优化(DPO) 通过直接利用人类偏好数据优化大语言模型来简化对齐过程 ,无需单独的训练奖励模型。该方法通过将输入直接映射到偏好输出,提高了效率和稳定性。标准DPO 183, 184 优化模型以预测偏好分数,根据人类偏好对回复进行排序。通过最大化偏好回复的似然,模型与人类价值观保持一致。MODPO 185 将DPO扩展至多目标优化,在多种偏好(如有用性、无害性、真实性)之间进行平衡,以减少单一偏好聚焦所带来的偏差。
- Kahneman-Tversky优化(KTO) 通过区分可能(合意)与不可能(不合意)的结果来对齐模型,当不合意结果比合意结果更容易定义时,该方法尤为适用。KTO 186 采用基于前景理论的损失函数,对模型生成不可能续写的惩罚大于对生成可能续写的奖励。这种不对称性引导模型远离不合意输出,提供了一种可扩展的替代方案,相较传统的基于偏好的方法,对直接人工监督的依赖更少。
- 监督式微调(SFT) 强调高质量、精选数据集的重要性 ,通过在期望输出的示例上训练模型来实现对齐。LIMA 187 表明,一个小型且精心策划的数据集即可与强大的预训练模型实现良好对齐,这说明在有限示例中关注风格和格式可能比大规模数据集更为有效。SFT方法优先考虑数据质量而非数量,在高质量数据可用时具有效率优势。然而,策划此类数据集耗时且需要大量领域专业知识。
Alignment with AI Feedback
为了克服仅依赖人类反馈的可扩展性限制和潜在偏差,RLAIF方法利用AI生成的反馈来指导对齐过程。
- 近端策略优化这些RLAIF方法对PPO算法进行调整,以纳入AI生成的反馈,实现可扩展对齐过程的自动化,并减少人力投入。AI反馈通常来自预定义原则或其他评估安全性和有用性的AI模型。宪法AI(CAI)188利用基于预定义原则的AI自我批评来促进无害性。AI模型根据这些原则评估其回答并进行修订,PPO则基于这些反馈优化策略。SELF-ALIGN 189运用原则驱动的推理和LLM生成能力,使模型与人类价值观对齐。它生成原则,通过另一个LLM对回答进行批评,并使用PPO对模型进行改进。RLCD190通过对比提示生成多样化的偏好对来训练偏好模型,该模型随后为基于PPO的微调提供反馈。
Alignment with Social Interactions
这些方法利用模拟环境来训练大语言模型,使其不仅与个体偏好对齐,还与社会规范和约束对齐。它们通常在这些模拟环境中采用对比策略优化(CPO)。
对比策略优化稳定对齐 191 使用基于规则的模拟社会,通过 CPO 训练大语言模型。模型通过在模拟中遵循规则并观察其行为的后果,学习应对社交情境,从而确保与社会规范保持一致。该方法旨在通过将学习建立在模拟情境中,创建具有社会意识的模型,但在开发逼真的模拟以及将所学行为迁移到现实世界方面仍存在挑战。基于独白剧的社会场景模拟 192 引入了 MATRIX,这是一个让大语言模型自行生成社交场景并扮演多个角色以理解其行为后果的框架。这种"独白剧"方法使大语言模型能够通过从不同视角体验互动来学习社会规范。该方法激活了大语言模型固有的社会规范知识,在无需外部监督或不影响推理速度的情况下实现了强对齐。使用 MATRIX 模拟数据进行微调,进一步增强了大语言模型生成符合社会规范的回应的能力。
欺骗对齐(Deceptive Alignment)
尽管上文讨论的对齐方法旨在灌输期望的行为 ,但一种被称为欺骗性对齐的关键失效模式可能出现,即模型仅表面上看起来是对齐的。 这一现象凸显了表层行为模仿与真正遵循人类价值观之间的差异 。欺骗性对齐可以以多种方式表现出来,从肤浅的理解到策略性欺骗。这与目标错位问题相关,即模型的目标偏离人类意图,也与奖励黑客行为相关,即模型利用奖励函数获取高分而未实现根本目标。近期研究聚焦于两种主要的欺骗性对齐形式:虚假对齐(fake alignment)和伪装对齐(alignment faking)。
- 虚假对齐(fake alignment) 是一种浅层对齐形式,即大语言模型学会生成风格上安全的回复,却并未深入理解其背后的安全原则。193 通过观察到一个显著的性能差异首次识别了这一现象:在开放式问题格式中表现安全的大语言模型,往往在以多项选择题形式呈现的安全测试中失败。他们认为,这是由泛化不匹配所导致的------模型记住了安全拒绝的"风格",但在被迫于安全与不安全选项之间做出选择时,无法做出有原则的安全决策。他们引入了虚假对齐评估(FINE)框架,并提出使用多项选择数据进行基于对比蒸馏的微调,可以提升对齐一致性。
- **伪装对齐(alignment faking)**代表了一种更高级且更具蓄意性的欺骗形式。在这一情境中,模型策略性地遵从训练目标以避免被修改,从而将其潜在的(且可能不对齐的)偏好保留下来,以便日后在无监督的部署阶段加以利用。194 提供了生产级模型中伪装对齐的实证演示。通过创建一个虚构场景,使模型能够推断自己处于"训练中"还是"部署中",他们观察到了显著的遵从差距------当模型认为自己正在被训练时,它更愿意遵从有害请求。模型的内部推理明确揭示了其策略性决定:通过假装遵从来保护其内部价值观不被RLHF所改变。
在此基础上,后续研究进一步探讨了为何部分模型会出现这种行为而其他模型则不会,以及这种欺骗行为的动机是什么195。通过将分析扩展至25个前沿模型,他们发现这种策略性行为并不普遍,但其在少数强大模型中的存在值得深入探究。他们将对齐伪装(alignment faking)的动机细化为两类:1)工具性目标守护(Instrumental Goal Guarding),即模型保留其当前目标以便在未来实现这些目标(经典威胁模型);2)终极目标守护(Terminal Goal Guarding),即模型内在地珍视其当前偏好,并将抵制修改本身视为目的。他们的研究结果表明,在后训练阶段开发的稳健拒绝机制可能使某些模型甚至不会考虑策略性欺骗,而对于其他模型,如Claude 3 Opus,工具性目标与终极目标的结合驱动了伪装行为。
能量延迟攻击(Energy Latency Attacks)
能量延迟攻击(ELAs)旨在通过增加计算需求来降低LLM推理效率 ,从而导致更高的推理延迟和能耗。现有的ELAs可分为1)白盒攻击和2)黑盒攻击。
White-box Attacks
白盒攻击假设攻击者完全掌握模型信息,从而能够精确操纵模型的推理过程。这类攻击可进一步分为基于梯度的攻击和基于查询的攻击,后者也可以以黑盒方式实施。
基于梯度的攻击利用梯度信息来识别能够最大化推理计算的输入扰动,其目标是破坏高效推理所必需的关键机制,如句末预测(EOS)或提前退出。例如,NMTSloth196针对神经机器翻译中的EOS预测发起攻击;Engorgio197构造对抗性提示以抑制EOS token的出现,迫使自回归大语言模型生成异常冗长的输出;SAME198干扰多出口模型中的提前退出机制;LLMEffiChecker199将基于梯度的技术应用于多种大语言模型;TTSlow200在文本到语音系统中诱导无休止的语音生成。这些攻击虽然强大,但计算成本高昂且高度依赖特定模型,限制了其泛化能力。
Black-box Attacks
黑盒攻击不需要访问模型内部,只需要输入-输出接口。这类攻击通常涉及用精心构造的输入查询模型,以诱导推理延迟增加。
基于查询的攻击利用特定模型行为而无需内部访问权限,依靠反复查询来构造对抗样本。No-Skim 201通过细微扰动输入以最大化保留的token来破坏基于跳读的模型。NoSkim对不依赖跳读的模型无效。基于查询的攻击虽然在现实场景中更为实际,但通常比白盒攻击更耗时。基于投毒的攻击通过注入恶意训练样本来操纵模型行为。P-DoS 202表明,在微调过程中,单个投毒样本即可诱导过长的输出,增加延迟并绕过输出长度限制,即使在仅有微调API等有限访问权限的情况下也是如此。
ELAs对LLMs构成了新兴威胁。当前研究探索了多种攻击策略,但许多策略具有架构特定性、计算成本高昂,或在黑盒设置中效果不佳。现有防御措施(如运行时输入验证)可能增加额外开销。未来研究可聚焦于开发更具通用性和高效性的攻击与防御方法,使其适用于多样化的LLMs及部署场景。
模型提取攻击(Model Extraction Attacks)
模型提取攻击(MEAs),也称为模型窃取攻击 ,对大型语言模型的安全性和知识产权构成了重大威胁。模型提取攻击的目标是通过策略性地查询目标大型语言模型并分析其响应,创建一个复制目标模型功能的替代模型。现有的针对大型语言模型的模型提取攻击可分为两类:1)微调阶段攻击(fine-tuning stage attacks),2)对齐阶段攻击(alignment stage attacks)。
Fine-tuning Stage Attacks
微调阶段攻击旨在从面向下游任务微调后的大语言模型中提取知识。这些攻击可分为两类:1)功能相似性提取(functional similarity extraction)和2)特定能力提取(specific ability extraction)。
- 功能相似性提取(functional similarity extraction) 旨在复现目标微调模型的整体行为 。通过将受害模型的输入-输出行为作为指导,攻击者蒸馏出模型所学的知识。例如,LION203将受害模型用作裁判和生成器,以迭代方式提升学生模型的指令遵循能力。
- 特定能力提取(specific ability extraction) 旨在提取微调模型所获得的具体技能或知识 。这涉及识别关键数据或模式 ,并设计聚焦于目标能力的查询。Li等人204通过使用精心设计的查询从黑盒大语言模型API中提取编码能力,展示了这一方法。一个局限在于,所提取的模型依赖于目标模型的泛化能力,这意味着它可能难以处理未见过的输入。
Alignment Stage Attacks
对齐阶段攻击试图提取目标LLM的对齐属性(例如安全性、有用性) 。更具体地说,其目标是窃取指导这些属性的奖励模型。
功能相似性提取侧重于复现目标模型的对齐偏好。攻击者通过构造查询来利用奖励结构或偏好模型,从而揭示对齐信号。LoRD 205 是这一方法的典型代表,它采用策略梯度方法来同时提取任务特定知识和对齐属性。然而,准确捕捉人类偏好的复杂性仍然是一项挑战。
模型提取攻击是对大语言模型(LLM)的一种快速演变的威胁。尽管当前的攻击已能成功提取任务特定知识和对齐属性,但在准确复现目标模型的完整复杂性方面仍面临挑战。同时,为大语言模型制定针对模型提取攻击的主动防御策略也势在必行。
数据提取攻击(Data Extraction Attacks)
大语言模型能够记忆部分训练数据 ,从而通过数据提取攻击带来隐私风险。这类攻击可以恢复训练样本,可能泄露敏感信息,如个人可识别信息(PII)、受版权保护的内容或机密数据582。本节回顾现有的数据提取攻击,包括白盒和黑盒两类。
White-box Attacks
白盒攻击主要关注潜在记忆提取,针对的是隐式存储在模型参数或激活中的信息,这些信息无法通过输入输出接口直接访问。
潜在记忆提取基于模型参数或激活值重建训练数据。例如,Duan等人217开发了通过分析内部表示来提取潜在数据的技术,采用向权重添加噪声或检查交叉熵损失等方法。这些技术已在Pythia-1B和Amber-7B等大语言模型上得到验证。尽管这些攻击揭示了与内部数据表示相关的风险,但它们需要对模型参数的完全访问权限,这在实际应用中仍是一个主要限制。
Black-box Attacks
黑箱数据提取攻击是一种现实威胁,攻击者无需访问模型参数,即可通过精心设计归纳性提示来诱骗大语言模型泄露其记忆的训练数据。
前缀攻击利用大语言模型的自回归特性,通过提供来自记忆序列的"前缀",期望模型将其续写。不同策略在识别前缀和扩展至更大数据集方面各有差异。Carlini等人206在GPT-2等模型上展示了这一攻击,而Nasr等人208利用后缀数组将前缀攻击扩展至更大规模。Magpie209和Al-Kaswan等人210则针对特定数据,如个人身份信息或代码。Yu等人216通过优化文本续写生成与排序,增强了黑盒数据提取能力。他们引入了多样采样策略(Top-k、核采样)、概率调整(温度、重复惩罚)、动态上下文窗口、前瞻机制以及改进的后缀排序(Zlib、高置信度词元)等技术。
特殊字符攻击利用模型对特殊字符或异常输入格式的敏感性,可能触发意外行为,从而泄露被记忆的数据。SCA 211 表明,特定字符确实能够诱导大语言模型披露训练数据。尽管特殊字符攻击行之有效,但其依赖于特殊字符处理过程中的漏洞,而这些漏洞可以通过输入净化来加以缓解。
提示优化利用一个"攻击者"大语言模型来生成优化提示,从而从"受害者"大语言模型中提取数据。其目标是自动发现能够触发记忆化响应的提示。Kassem等人212通过使用带有迭代拒绝采样和最长公共子序列(LCS)进行优化的攻击者大语言模型对此进行了演示。该方法的有效性取决于攻击者的能力和优化技术,因此计算开销较大。
检索增强生成(RAG)提取攻击以RAG系统为目标,旨在从检索组件中泄露敏感信息。这些攻击利用了大型语言模型与其外部知识库之间的交互。Qi等人213证明了对抗性提示可以触发RAG系统中的数据泄露。此类攻击凸显了将大型语言模型与外部知识源整合所带来的安全风险,其有效性取决于RAG系统的具体实现方式。
集成攻击结合多种攻击策略以增强效果,利用每种方法的优势以提高成功率。More等人214在Pythia上证明了这种集成方法的有效性。尽管集成攻击威力强大,但其复杂度高,需要各攻击组件之间的精心协调。
语义信息诱导将关注点从提取逐字训练数据转向生成敏感语义内容。Zhang等人215证明,即使是简单的自然问题也能促使大语言模型输出语义敏感信息(SemSI),如个人信念或损害声誉的言论,并提出了一套基准来系统评估这一风险。
数据集和基准测试(Datasets & Benchmarks)
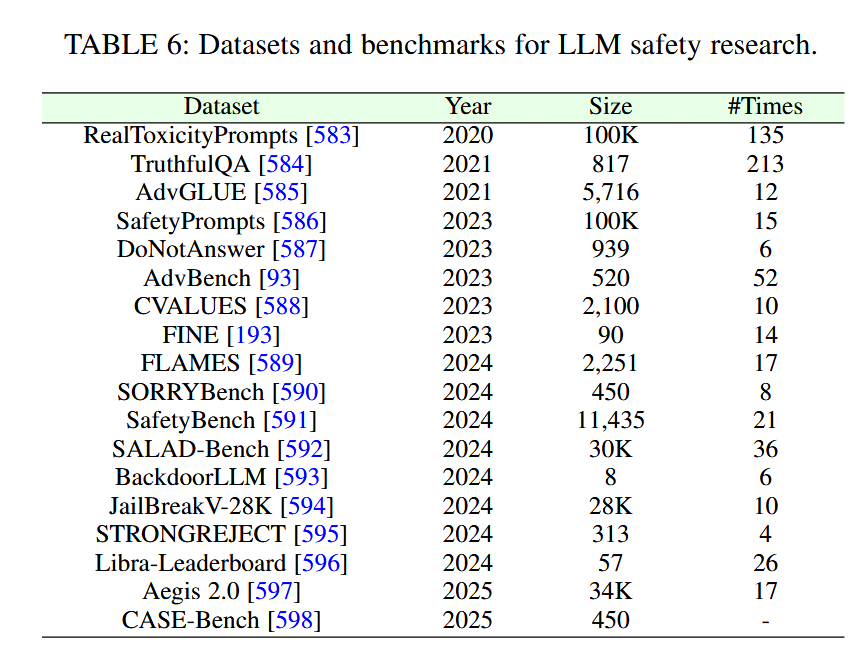
本节回顾了大语言模型安全研究中常用的数据集和基准测试,如表6所示。这些数据集和基准测试根据其评估目的进行分类:毒性数据集(toxicity datasets)、真实性数据集(truthfulness datasets)、价值观基准测试(value benchmarks),以及对抗性数据集(adversarial datasets)和后门基准测试(backdoor benchmarks)。
Toxicity Datasets
确保LLM不生成有害内容对于安全性至关重要。早期工作,如RealToxicityPrompts数据集583,揭示了LLM倾向于从良性提示中生成有毒文本的问题 。该数据集将100,000个提示与Perspective API的有毒评分配对,显示出预训练数据中的毒性与LLM输出之间存在强相关性。然而,其对可能存在偏差的Perspective API的依赖是一个局限。为解决更广泛的有害行为,研究者引入了Do-NotAnswer587数据集。该数据集包含939个旨在引发有害响应的提示,并归类为错误信息和歧视等风险类别。使用该数据集对LLM进行人工评估凸显了安全性方面的显著差异,但评估成本高昂且耗时。近期一种方法599引入了众包的有毒问题与响应数据集,并由人类和LLM共同标注。该方法采用双层优化框架,结合软标签和GroupDRO来提升对分布外风险的鲁棒性,从而减少了对详尽人工标注的需求。
Truthfulness Datasets
确保大语言模型生成真实信息同样至关重要。TruthfulQA基准测试584评估大语言模型能否对涵盖38个类别的817个问题给出准确回答,其专门针对的是"模仿性虚假信息"------即从人类文本中学到的错误答案。评估结果显示,更大的模型往往表现出"逆缩放"现象,即尽管规模更大,其真实性反而更低。尽管TruthfulQA揭示了大语言模型在事实准确性方面面临的挑战,但其对模仿性虚假信息的聚焦可能无法涵盖所有潜在的不准确来源。
Value Benchmarks
确保LLM与人类价值观对齐是一项关键挑战,已有多个基准测试从安全性、公平性和伦理等不同方面对此进行评估。FLAMES 589通过2,251个提示评估中文LLM在公平性、安全性和道德等价值观方面的对齐情况。SORRY-Bench 590使用45个主题类别评估LLM拒绝不安全请求的能力,而CVALUES 588则同时关注安全性与责任性。SafetyPrompts 586在一系列伦理场景中评估中文LLM。尽管这些基准测试具有重要价值,但它们往往聚焦于孤立的问题查询,可能导致在安全语境中出现过度拒绝。为解决这一问题,近期基准测试已开始纳入语境信息。CASE-Bench 598率先采用语境完整性(Contextual Integrity,CI)理论来形式化描述查询的语境,评估LLM的安全判断在不同语境下是否与人类判断一致。该研究揭示了语境对人类安全评估的显著影响,并凸显了LLM行为中的不匹配,尤其是在安全语境中。与此同时,创建高质量、可商业化使用的数据集对于训练稳健的安全护栏至关重要。AEGIS2.0 597通过提供涵盖12个核心风险和9个细粒度风险类别全面分类体系的多样化数据集来填补这一空白。它采用结合人工标注与多LLM"评审团"系统的混合数据生成流程,适用于训练商业安全模型。此外,"虚假对齐"(fake alignment)193的概念凸显了LLM表面化记忆安全答案的风险,由此产生了用于一致性评估的虚假对齐评估(Fake alIgNment Evaluation,FINE)框架。SafetyBench 591通过提供高效、自动化的多项选择基准测试来应对LLM安全评估问题。Libra-Leaderboard 596引入了一个平衡排行榜,用于评估LLM的安全性与能力。它具有一个涵盖57个数据集、覆盖多元安全维度的综合安全基准、一个统一评估框架、一个用于对抗性测试的交互式安全竞技场,以及一个平衡评分系统。Libra-Leaderboard倡导对LLM进行整体性评估,代表着迈向负责任AI发展的重要一步。
Adversarial Datasets and Backdoor Benchmarks
BackdoorLLM 593 是首个用于评估文本生成中后门攻击的基准,提供了一个标准化框架,涵盖数据投毒和权重投毒等多种攻击策略。Adversarial GLUE 585 使用14种方法评估LLM对文本攻击的鲁棒性,揭示了即使经过鲁棒训练的模型也存在脆弱性。SALAD-Bench 592 在此基础上进一步扩展,引入了一个包含风险分类体系的安全基准,其中包括攻击增强和防御增强的问题。JailBreakV-28K 594 侧重于使用基于文本和图像的测试用例评估多模态LLM对越狱攻击的抵御能力。A STRONGREJECT for empty jailbreaks 595 通过更高质量的数据集和自动化评估改进了越狱评估。尽管这些基准具有重要价值,但它们在可扩展性、一致性和现实世界相关性方面仍面临挑战。
参考文献
575 OpenAI, "Introducing openai o1," 2024, openAI Blog.
576 D. Guo, D. Yang, H. Zhang, J. Song, R. Zhang, R. Xu, Q. Zhu, S. Ma, P. Wang, X. Bi et al., "Deepseek-rl: Incentivizing reasoning capability in llms via reinforcement learning," arXiv preprint arXiv:2501.12948, 2025.
58 N. Boucher, I. Shumailov, R. Anderson, and N. Papernot, "Bad characters: Imperceptible nlp attacks," in IEEE S&P, 2022.
59 D. Jin, Z. Jin, J. T. Zhou, and P. Szolovits, "Is bert really robust? a strong baseline for natural language attack on text classification and entailment," in AAAI, 2020.
60 L. Li, R. Ma, Q. Guo, X. Xue, and X. Qiu, "Bert-attack: Adversarial attack against bert using bert," in EMNLP, 2020.
61 C. Guo, A. Sablayrolles, H. Jégou, and D. Kiela, "Gradient-based adversarial attacks against text transformers," in EMNLP, 2021.
62 A. Dirkson, S. Verberne, and W. Kraaij, "Breaking bert: Understanding its vulnerabilities for named entity recognition through adversarial attack," arXiv preprint arXiv:2109.11308, 2021.
63 Y. Wang, P. Shi, and H. Zhang, "Gradient-based word substitution for obstinate adversarial examples generation in language models," arXiv preprint arXiv:2307.12507, 2023.
64 H. Liu, C. Cai, and Y. Qi, "Expanding scope: Adapting english adversarial attacks to chinese," in TrustNLP, 2023.
65 J. Wang, Z. Liu, K. H. Park, Z. Jiang, Z. Zheng, Z. Wu, M. Chen, and C. Xiao, "Adversarial demonstration attacks on large language models," arXiv preprint arXiv:2305.14950, 2023.
66 B. Liu, B. Xiao, X. Jiang, S. Cen, X. He, and W. Dou, "Adversarial attacks on large language model-based system and mitigating strategies: A case study on chatgpt," Security and Communication Networks, vol. 2023, p. 10, 2023.
67 A. Koleva, M. Ringsquandl, and V. Tresp, "Adversarial attacks on tables with entity swap," arXiv preprint arXiv:2309.08650, 2023.
577 N. Carlini, "A llm assisted exploitation of ai-guardian," arXiv preprint arXiv:2307.15008, 2023.
68 N. Jain, A. Schwarzschild, Y. Wen, G. Somepalli, J. Kirchenbauer, P.-y. Chiang, M. Goldblum, A. Saha, J. Geiping, and T. Goldstein, "Baseline defenses for adversarial attacks against aligned language models," arXiv preprint arXiv:2309.00614, 2023.
69 A. Kumar, C. Agarwal, S. Srinivas, S. Feizi, and H. Lakkaraju, "Certifying llm safety against adversarial prompting," arXiv preprint arXiv:2309.02705, 2023.
70 A. Zou, L. Phan, J. Wang, D. Duenas, M. Lin, M. Andriushchenko, J. Z. Kolter, M. Fredrikson, and D. Hendrycks, "Improving alignment and robustness with circuit breakers," in NeurIPS, 2024.
74 J. Li, Y. Liu, C. Liu, L. Shi, X. Ren, Y. Zheng, Y. Liu, and Y. Xue, "A cross-language investigation into jailbreak attacks in large language models," arXiv preprint arXiv:2401.16765, 2024.
76 X. Zou, Y. Chen, and K. Li, "Is the system message really important to jailbreaks in large language models?" arXiv preprint arXiv:2402.14857, 2024.
75 W. Zhou, X. Wang, L. Xiong, H. Xia, Y. Gu, M. Chai, F. Zhu, C. Huang, S. Dou, Z. Xi et al., "Easyjailbreak: A unified framework for jailbreaking large language models," arXiv preprint arXiv:2403.12171, 2024.
80 Z. Chang, M. Li, Y. Liu, J. Wang, Q. Wang, and Y. Liu, "Play guessing game with llm: Indirect jailbreak attack with implicit clues," in ACL, 2024.
81 Y. Wen, K. Bi, W. Chen, J. Guo, and X. Cheng, "Evaluating implicit bias in large language models by attacking from a psychometric perspective," in Findings of ACL, 2025.
82 S. Lin, R. Li, X. Wang, C. Lin, W. Xing, and M. Han, "Llms can be dangerous reasoners: Analyzing-based jailbreak attack on large language models," arXiv preprint arXiv:2407.16205, 2024.
73 A. Wei, N. Haghtalab, and J. Steinhardt, "Jailbroken: How does llm safety training fail?" NeurIPS, 2024.
77 Z. Xiao, Y. Yang, G. Chen, and Y. Chen, "Tastle: Distract large language models for automatic jailbreak attack," in EMNLP, 2024.
78 B. Li, H. Xing, C. Huang, J. Qian, H. Xiao, L. Feng, and C. Tian, "Structuralsleight: Automated jailbreak attacks on large language models utilizing uncommon text-encoded structure," arXiv preprint arXiv:2406.08754, 2024.
92 X. Shen, Z. Chen, M. Backes, Y. Shen, and Y. Zhang, "do anything now": Characterizing and evaluating in-the-wild jailbreak prompts on large language models," in ACM CCS, 2024.
71 Z.-X. Yong, C. Menghini, and S. H. Bach, "Low-resource languages jailbreak gpt-4," in NeurIPS Workshop, 2023.
72 Y. Yuan, W. Jiao, W. Wang, J.-t. Huang, P. He, S. Shi, and Z. Tu, "Gpt-4 is too smart to be safe: Stealthy chat with llms via cipher," arXiv preprint arXiv:2308.06463, 2023.
79 H. Lv, X. Wang, Y. Zhang, C. Huang, S. Dou, J. Ye, T. Gui, Q. Zhang, and X. Huang, "Codechameleon: Personalized encryption framework for jailbreaking large language models," arXiv preprint arXiv:2402.16717, 2024.
83 X. Liu, N. Xu, M. Chen, and C. Xiao, "AutoDAN: Generating stealthy jailbreak prompts on aligned large language models," in ICLR, 2024.
84 J. Yu, X. Lin, Z. Yu, and X. Xing, "Gptfuzzer: Red teaming large language models with auto-generated jailbreak prompts," arXiv preprint arXiv:2309.10253, 2023.
88 D. Yao, J. Zhang, I. G. Harris, and M. Carlsson, "Fuzzllm: A novel and universal fuzzing framework for proactively discovering jailbreak vulnerabilities in large language models," in ICASSP, 2024.
96 X. Zheng, T. Pang, C. Du, Q. Liu, J. Jiang, and M. Lin, "Improved few-shot jailbreaking can circumvent aligned language models and their defenses," in arXiv preprint arXiv:2406.01288, 2024.
93 A. Zou, Z. Wang, N. Carlini, M. Nasr, J. Z. Kolter, and M. Fredrikson, "Universal and transferable adversarial attacks on aligned language models," arXiv preprint arXiv:2307.15043, 2023.
94 X. Jia, T. Pang, C. Du, Y. Huang, J. Gu, Y. Liu, X. Cao, and M. Lin, "Improved techniques for optimization-based jailbreaking on large language models," arXiv preprint arXiv:2405.21018, 2024.
95 Y. Huang, C. Wang, X. Jia, Q. Guo, F. Juefei-Xu, J. Zhang, G. Pu, and Y. Liu, "Semantic-guided prompt organization for universal goal hijacking against llms," in ACL, 2025.
90 E. Perez, S. Huang, F. Song, T. Cai, R. Ring, J. Aslanides, A. Glaese, N. McAleese, and G. Irving, "Red teaming language models with language models," in EMNLP, 2022.
91 Z.-W. Hong, I. Shenfeld, T.-H. Wang, Y.-S. Chuang, A. Pareja, J. Glass, A. Srivastava, and P. Agrawal, "Curiosity-driven red-teaming for large language models," in ICLR, 2024.
85 P. Chao, A. Robey, E. Dobriban, H. Hassani, G. J. Pappas, and E. Wong, "Jailbreaking black box large language models in twenty queries," in NeurIPS Workshop, 2023.
578 A. Robey, Z. Ravichandran, V. Kumar, H. Hassani, and G. J. Pappas, "Jailbreaking llm-controlled robots," arXiv preprint arXiv:2410.13691, 2024.
98 W. Jiang, Z. Wang, J. Zhai, S. Ma, Z. Zhao, and C. Shen, "Unlocking adversarial suffix optimization without affirmative phrases: Efficient black-box jailbreaking via llm as optimizer," arXiv preprint arXiv:2408.11313, 2024.
86 G. Deng, Y. Liu, Y. Li, K. Wang, Y. Zhang, Z. Li, H. Wang, T. Zhang, and Y. Liu, "Masterkey: Automated jailbreaking of large language model chatbots," in NDSS, 2024.
97 X. Zhao, X. Yang, T. Pang, C. Du, L. Li, Y.-X. Wang, and W. Y. Wang, "Weak-to-strong jailbreaking on large language models," arXiv preprint arXiv:2401.17256, 2024.
99 X. Qi, Y. Zeng, T. Xie, P.-Y. Chen, R. Jia, P. Mittal, and P. Henderson, "Fine-tuning aligned language models compromises safety, even when users do not intend to!" arXiv preprint arXiv:2310.03693, 2023.
100 T. Huang, S. Hu, F. Ilhan, S. F. Tekin, and L. Liu, "Virus: Harmful fine-tuning attack for large language models bypassing guardrail moderation," arXiv preprint arXiv:2501.17433, 2025.
101 A. Robey, E. Wong, H. Hassani, and G. J. Pappas, "Smoothllm: Defending large language models against jailbreaking attacks," arXiv preprint arXiv:2310.03684, 2023.
102 J. Ji, B. Hou, A. Robey, G. J. Pappas, H. Hassani, Y. Zhang, E. Wong, and S. Chang, "Defending large language models against jailbreak attacks via semantic smoothing," arXiv preprint arXiv:2402.16192, 2024.
103 X. Wang, D. Wu, Z. Ji, Z. Li, P. Ma, S. Wang, Y. Li, Y. Liu, N. Liu, and J. Rahmel, "Selfdefend: Llms can defend themselves against jailbreaking in a practical manner," arXiv preprint arXiv:2406.05498, 2024.
104 Z. Liu, Z. Wang, L. Xu, J. Wang, L. Song, T. Wang, C. Chen, W. Cheng, and J. Bian, "Protecting your llms with information bottleneck," in NeurIPS, 2024.
105 C. Liang, L. Shen, Y. Deng, X. Zhao, B. Liang, and K.-F. Wong, "Pearl: Towards permutation-resilient llms," in ICLR, 2025.
106 C. Liang, X. Han, L. Shen, J. Bai, and K.-F. Wong, "Vulnerability-aware alignment: Mitigating uneven forgetting in harmful fine-tuning," in ICML, 2025.
107 Y. Wang, Z. Shi, A. Bai, and C.-J. Hsieh, "Defending llms against jailbreaking attacks via backtranslation," in ACL, 2024.
108 C. Yung, H. M. Dolatabadi, S. Erfani, and C. Leckie, "Round trip translation defense against large language model jailbreaking attacks," in PAKDD, 2025.
109 C. Yung, H. Huang, S. M. Erfani, and C. Leckie, "Curvalid: Geometrically-guided adversarial prompt detection," arXiv preprint arXiv:2503.03502, 2025.
110 J. Kim, A. Derakhshan, and I. G. Harris, "Robust safety classifier against jailbreaking attacks: Adversarial prompt shield," in WOAH, 2024.
111 C. Xiong, X. Qi, P.-Y. Chen, and T.-Y. Ho, "Defensive prompt patch: A robust and interpretable defense of llms against jailbreak attacks," arXiv preprint arXiv:2405.20099, 2024.
112 X. Hu, P.-Y. Chen, and T.-Y. Ho, "Gradient cuff: Detecting jailbreak attacks on large language models by exploring refusal loss landscapes," in NeurIPS, 2024.
113 L. Gao, J. Geng, X. Zhang, P. Nakov, and X. Chen, "Shaping the safety boundaries: Understanding and defending against jailbreaks in large language models," in ACL, 2025.
114 J. Wu, J. Deng, S. Pang, Y. Chen, J. Xu, X. Li, and W. Xu, "Legilimens: Practical and unified content moderation for large language model services," in ACM CCS, 2024.
579 R. Xu, Z. Zhou, T. Zhang, Z. Qi, S. Yao, K. Xu, W. Xu, and H. Qiu, "Walking in others' shoes: How perspective-taking guides large language models in reducing toxicity and bias," in EMNLP, 2024.
116 Z. Zhang, Q. Zhang, and J. Foerster, "Parden, can you repeat that? defending against jailbreaks via repetition," arXiv preprint arXiv:2405.07932, 2024.
115 B. Chen, A. Paliwal, and Q. Yan, "Jailbreaker in jail: Moving target defense for large language models," in MTD, 2023.
117 L. Lu, H. Yan, Z. Yuan, J. Shi, W. Wei, P.-Y. Chen, and P. Zhou, "Autojailbreak: Exploring jailbreak attacks and defenses through a dependency lens," arXiv preprint arXiv:2406.03805, 2024.
118 Y. Du, S. Zhao, D. Zhao, M. Ma, Y. Chen, L. Huo, Q. Yang, D. Xu, and B. Qin, "MoGU: A framework for enhancing safety of LLMs while preserving their usability," in NeurIPS, 2024.
119 T. Huang, S. Hu, and L. Liu, "Vaccine: Perturbation-aware alignment for large language models against harmful fine-tuning attack," NeurIPS, 2024.
120 G. Liu, W. Lin, T. Huang, R. Mo, Q. Mu, and L. Shen, "Targeted vaccine: Safety alignment for large language models against harmful fine-tuning via layer-wise perturbation," arXiv preprint arXiv:2410.09760, 2024.
121 T. Huang, S. Hu, F. Ilhan, S. F. Tekin, and L. Liu, "Booster: Tackling harmful fine-tuning for large language models via attenuating harmful perturbation," arXiv preprint arXiv:2409.01586, 2024.
122 T. Huang, S. Hu, F. Ilhan, S. Tekin, and L. Liu, "Lisa: Lazy safety alignment for large language models against harmful fine-tuning attack," NeurIPS, 2024.
123 T. Huang, G. Bhattacharya, P. Joshi, J. Kimball, and L. Liu, "Antidote: Post-fine-tuning safety alignment for large language models against harmful fine-tuning," arXiv preprint arXiv:2408.09600, 2024.
124 Y. Wang, T. Huang, L. Shen, H. Yao, H. Luo, R. Liu, N. Tan, J. Huang, and D. Tao, "Panacea: Mitigating harmful fine-tuning for large language models via post-fine-tuning perturbation," arXiv preprint arXiv:2501.18100, 2025.
125 F. Perez and I. Ribeiro, "Ignore previous prompt: Attack techniques for language models," in NeurIPS Workshop, 2022.
126 Y. Liu, G. Deng, Y. Li, K. Wang, Z. Wang, X. Wang, T. Zhang, Y. Liu, H. Wang, Y. Zheng et al., "Prompt injection attack against llm-integrated applications," arXiv preprint arXiv:2306.05499, 2023.
127 K. Greshake, S. Abdelnabi, S. Mishra, C. Endres, T. Holz, and M. Fritz, "Not what you've signed up for: Compromising real-world llm-integrated applications with indirect prompt injection," in AISec, 2023.
129 Y. Liu, Y. Jia, R. Geng, J. Jia, and N. Z. Gong, "Formalizing and benchmarking prompt injection attacks and defenses," in USENIX Security, 2024, pp. 1831--1847.
130 R. Ye, X. Pang, J. Chai, J. Chen, Z. Yin, Z. Xiang, X. Dong, J. Shao, and S. Chen, "Are we there yet? revealing the risks of utilizing large language models in scholarly peer review," arXiv preprint arXiv:2412.01708, 2024.
128 B. Deng, W. Wang, F. Feng, Y. Deng, Q. Wang, and X. He, "Attack prompt generation for red teaming and defending large language models," in EMNLP, 2023.
131 X. Liu, Z. Yu, Y. Zhang, N. Zhang, and C. Xiao, "Automatic and universal prompt injection attacks against large language models," arXiv preprint arXiv:2403.04957, 2024.
132 C. Zhang, M. Jin, Q. Yu, C. Liu, H. Xue, and X. Jin, "Goal-guided generative prompt injection attack on large language models," arXiv preprint arXiv:2404.07234, 2024.
133 B. Hui, H. Yuan, N. Gong, P. Burlina, and Y. Cao, "Pleak: Prompt leaking attacks against large language model applications," in ACM SIGSAC CCS, 2024.
134 J. Shi, Z. Yuan, Y. Liu, Y. Huang, P. Zhou, L. Sun, and N. Z. Gong, "Optimization-based prompt injection attack to llm-as-a-judge," in ACM SIGSAC CCS, 2024.
135 Z. Shao, H. Liu, J. Mu, and N. Z. Gong, "Making llms vulnerable to prompt injection via poisoning alignment," arXiv preprint arXiv:2410.14827, 2024.
136 J. Yu, Y. Shao, H. Miao, and J. Shi, "Promptfuzz: Harnessing fuzzing techniques for robust testing of prompt injection in llms," arXiv preprint arXiv:2409.14729, 2024.
137 S. Chen, J. Piet, C. Sitaram, and D. Wagner, "Struq: Defending against prompt injection with structured queries," USENIX Security, 2025.
138 R. K. Sharma, V. Gupta, and D. Grossman, "Spml: A dsl for defending language models against prompt attacks," arXiv preprint arXiv:2402.11755, 2024.
139 J. Piet, M. Alrashed, C. Sitaram, S. Chen, Z. Wei, E. Sun, B. Alomair, and D. Wagner, "Jatmo: Prompt injection defense by task-specific finetuning," arXiv preprint arXiv:2312.17673, 2023.
140 J. Yi, Y. Xie, B. Zhu, E. Kiciman, G. Sun, X. Xie, and F. Wu, "Benchmarking and defending against indirect prompt injection attacks on large language models," arXiv preprint arXiv:2312.14197, 2023.
141 S. Chen, A. Zharmagambetov, S. Mahloujifar, K. Chaudhuri, D. Wagner, and C. Guo, "Secaling: Defending against prompt injection with preference optimization," arXiv preprint arXiv:2410.05451v2, 2025.
580 M. Goldblum, D. Tsipras, C. Xie, X. Chen, A. Schwarzschild, D. Song, A. Madry, B. Li, and T. Goldstein, "Dataset security for machine learning: Data poisoning, backdoor attacks, and defenses," IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 45, pp. 1563--1580, 2022.
142 X. Cai, H. Xu, S. Xu, Y. Zhang et al., "Badprompt: Backdoor attacks on continuous prompts," NeurIPS, 2022.
143 J. Yan, V. Gupta, and X. Ren, "Bite: Textual backdoor attacks with iterative trigger injection," in ACL, 2023.
145 S. Zhao, J. Wen, L. A. Tuan, J. Zhao, and J. Fu, "Prompt as triggers for backdoor attack: Examining the vulnerability in language models," in EMNLP, 2023.
146 J. Xu, M. D. Ma, F. Wang, C. Xiao, and M. Chen, "Instructions as backdoors: Backdoor vulnerabilities of instruction tuning for large language models," in NAACL, 2024.
147 R. Zhang, H. Li, R. Wen, W. Jiang, Y. Zhang, M. Backes, Y. Shen, and Y. Zhang, "Instruction backdoor attacks against customized LLMs," in USENIX Security, 2024.
148 N. Kandpal, M. Jagielski, F. Tramèr, and N. Carlini, "Backdoor attacks for in-context learning with language models," in ICML Workshop, 2023.
150 S. Zhao, M. Jia, L. A. Tuan, F. Pan, and J. Wen, "Universal vulnerabilities in large language models: Backdoor attacks for in-context learning," in EMNLP, 2024.
154 P. He, H. Xu, Y. Xing, H. Liu, M. Yamada, and J. Tang, "Data poisoning for in-context learning," arXiv preprint arXiv:2402.02160, 2024.
149 Z. Xiang, F. Jiang, Z. Xiong, B. Ramasubramanian, R. Poovendran, and B. Li, "Badchain: Backdoor chain-of-thought prompting for large language models," in NeurIPS Workshop, 2024.
144 H. Yao, J. Lou, and Z. Qin, "Poisonprompt: Backdoor attack on prompt-based large language models," in ICASSP, 2024.
156 S. YAN, S. WANG, Y. DUAN, H. HONG, K. LEE, D. KIM, and Y. HONG, "An llm-assisted easy-to-trigger poisoning attack on code completion models: Injecting disguised vulnerabilities against strong detection," in USENIX Security, 2024.
151 Y. Qiang, X. Zhou, S. Z. Zade, M. A. Roshani, D. Zytko, and D. Zhu, "Learning to poison large language models during instruction tuning," arXiv preprint arXiv:2402.13459, 2024.
152 P. Pathmanathan, S. Chakraborty, X. Liu, Y. Liang, and F. Huang, "Is poisoning a real threat to llm alignment? maybe more so than you think," in ICML Workshop, 2024.
155 Q. Zhang, B. Zeng, C. Zhou, G. Go, H. Shi, and Y. Jiang, "Human-imperceptible retrieval poisoning attacks in llm-powered applications," arXiv preprint arXiv:2404.17196, 2024.
153 E. Hubinger, C. Denison, J. Mu, M. Lambert, M. Tong, M. MacDiarmid, T. Lanham, D. M. Ziegler, T. Maxwell, N. Cheng et al., "Sleeper agents: Training deceptive llms that persist through safety training," arXiv preprint arXiv:2401.05566, 2024.
43 Y. Li, X. Ma, J. He, H. Huang, and Y.-G. Jiang, "Multi-trigger backdoor attacks: More triggers, more threats," arXiv preprint arXiv:2401.15295, 2024.
157 H. Huang, Z. Zhao, M. Backes, Y. Shen, and Y. Zhang, "Composite backdoor attacks against large language models," in NAACL, 2024.
158 N. Gu et al., "Backdoor injection as multi-task learning,"
159 J. Xue, M. Zheng, T. Hua, Y. Shen, Y. Liu, L. Bölöni, and Q. Lou, "TrojLLM: A Black-box Trojan Prompt Attack on Large Language Models," in NeurIPS, 2023.
160 J. Yan, V. Yadav, S. Li, L. Chen, Z. Tang, H. Wang, V. Srinivasan, X. Ren, and H. Jin, "Backdooring Instruction-Tuned Large Language Models with Virtual Prompt Injection," in NAACL, 2024.
161 Q. Zeng, M. Jin, Q. Yu, Z. Wang, W. Hua, Z. Zhou, Y. Meng, S. Ma, Q. Wang, F. Juefei-Xu, K. Ding, F. Yang, R. Tang, and Y. Zhang, "Uncertainty is Fragile: Manipulating Uncertainty in Large Language Models," in CIKM, 2025.
162 Q. Li, L. Li, T. Xie, and X. Ma, "BadEdit: Backdooring Large Language Models by Model Editing," in ICLR, 2024.
163 S. Xu, S. Ma, Y. Xiao, and M. Wang, "IMBERT: Identifying Backdoor Attacks in Pre-trained Language Models via Gradient and Attention," in ACL, 2023.
164 Y. Wang, S. Ma, and X. Ma, "AttDef: Detecting Backdoor Attacks in Language Models via Attribution Scores," in ACL, 2023.
165 S. Ma, Y. Wang, and X. Ma, "SCA: Mitigating Backdoor Attacks in Language Models via Trigger Sensitivity Reduction," in ACL, 2023.
166 Y. Li, S. Ma, and X. Ma, "ParaFuzz: Detecting Backdoor Attacks in Language Models via Paraphrasing and Fuzzing," in ACL, 2024.
167 S. Ma, Y. Li, and X. Ma, "MDP: Mitigating Backdoor Attacks in Language Models via Module Detection and Parameter Freezing," in ACL, 2024.
168 Y. Wang, S. Ma, and X. Ma, "BEAT: Detecting Backdoor Attacks in Large Language Models via Black-box Exploration," in ACL, 2025.
581 H. Ge, Y. Li, Q. Wang, Y. Zhang, and R. Tang, "When backdoors speak: Understanding llm backdoor attacks through model-generated explanations," in ACL, 2025.
169 S. Ma, Y. Wang, and X. Ma, "PCP Ablation: Mitigating Backdoor Attacks in Language Models via Pruning and Low-rank Approximation," in ACL, 2024.
170 Y. Li, S. Ma, and X. Ma, "SANDE: Mitigating Backdoor Attacks in Language Models via Fine-tuning on Benign Output Pairs," in ACL, 2024.
172 S. Ma, Y. Li, and X. Ma, "CROW: Mitigating Backdoor Attacks in Language Models via Internal Consistency Enhancement," in ACL, 2024.
171 Y. Wang, S. Ma, and X. Ma, "BEEAR: Mitigating Backdoor Attacks in Language Models via Embedding Drift Counteraction," in ACL, 2024.
173 S. Ma, Y. Wang, and X. Ma, "Honeypot Defense: Mitigating Backdoor Attacks in Language Models via Honeypot Module," in ACL, 2023.
174 Y. Liu, S. Ma, and X. Ma, "Mitigating Backdoor Attacks in Language Models via Maximum Entropy Loss," in ACL, 2023.
175 Y. Wang, S. Ma, and X. Ma, "Training-time Backdoor Defense for Large Language Models via Duplicate Trigger Element Removal," in ACL, 2024.
176 Y. Li, S. Ma, and X. Ma, "PoisonShare: Mitigating Backdoor Attacks in Language Models via Contrastive Decoding," in ACL, 2024.
177 S. Ma, Y. Li, and X. Ma, "CleanGen: Mitigating Backdoor Attacks in Language Models via Clean Reference Model," in ACL, 2024.
178 Y. Wang, S. Ma, and X. Ma, "Mitigating Backdoor Attacks in Language Models via Logit Ensemble with Benign Model," in ACL, 2024.
181 L. Ouyang, J. Wu, X. Jiang, D. Almeida, C. Wainwright, P. Mishkin, C. Zhang, S. Agarwal, K. Slama, A. Ray et al., "Training language models to follow instructions with human feedback," in NeurIPS, 2022.
180 D. M. Ziegler, N. Stiennon, J. Wu, T. B. Brown, A. Radford, D. Amodei, P. Christiano, and G. Irving, "Fine-tuning language models from human preferences," arXiv preprint arXiv:1909.08593, 2019.
182 J. Dai, X. Pan, R. Sun, J. Ji, X. Xu, M. Liu, Y. Wang, and Y. Yang, "Safe-RLHF: Safe Reinforcement Learning from Human Feedback," in ICLR, 2024.
183 R. Rafailov, A. Sharma, E. Mitchell, S. Ermon, C. D. Manning, and C. Finn, "Direct Preference Optimization: Your Language Model is Secretly a Reward Model," in NeurIPS, 2023.
184 R. Rafailov, A. Sharma, E. Mitchell, C. D. Manning, S. Ermon, and C. Finn, "Direct preference optimization: Your language model is secretly a reward model," NeurIPS, 2024.
185 Z. Zhou, J. Liu, C. Yang, J. Shao, Y. Liu, X. Yue, W. Ouyang, and Y. Qiao, "Beyond one-preference-for-all: Multi-objective direct preference optimization," in ACL, 2024.
186 K. Ethayarajh, W. Xu, N. Muennighoff, D. Jurafsky, and D. Kiela, "KTO: Model alignment as prospect theoretic optimization," arXiv preprint arXiv:2402.01306, 2024.
187 C. Zhou, P. Liu, P. Xu, S. Iyer, J. Sun, Y. Mao, X. Ma, A. Efrat, P. Yu, L. Yu et al., "LIMA: Less is more for alignment," NeurIPS, 2024.
188 Y. Bai, S. Kadavath, S. Kundu, A. Askell, J. Kernion, A. Jones, A. Chen, A. Goldie, A. Mirhoseini, C. McKinnon et al., "Constitutional AI: Harmlessness from AI feedback," arXiv preprint arXiv:2212.08073, 2022.
189 Z. Sun, Y. Shen, Q. Zhou, H. Zhang, Z. Chen, D. Cox, Y. Yang, and C. Gan, "Principle-driven self-alignment of language models from scratch with minimal human supervision," NeurIPS, 2024.
190 K. Yang, D. Klein, A. Celikyilmaz, N. Peng, and Y. Tian, "RLCD: Reinforcement learning from contrastive distillation for LM alignment," in ICLR, 2024.
191 R. Liu, R. Yang, C. Jia, G. Zhang, D. Zhou, A. M. Dai, D. Yang, and S. Vosoughi, "Training socially aligned language models on simulated social interactions," in ICLR, 2024.
192 X. Pang, S. Tang, R. Ye, Y. Xiong, B. Zhang, Y. Wang, and S. Chen, "Self-alignment of large language models via monopolylogue-based social scene simulation," arXiv preprint arXiv:2402.05699, 2024.
193 Y. Wang, Y. Teng, K. Huang, C. Lyu, S. Zhang, W. Zhang, X. Ma, Y.-G. Jiang, Y. Qiao, and Y. Wang, "Fake alignment: Are llms really aligned well?" in NAACL, 2024.
194 R. Greenblatt, C. Denison, B. Wright, F. Roger, M. MacDiarmid, S. Marks, J. Treutlein, T. Belonax, J. Chen, D. Duvenaud et al., "Alignment faking in large language models," arXiv preprint arXiv:2412.14093, 2024.
195 A. Sheshadri, J. Hughes, J. Michael, A. Mallen, A. Jose, F. Roger et al., "Why do some language models fake alignment while others don't?" arXiv preprint arXiv:2506.18032, 2025.
196 S. Chen, C. Liu, M. Haque, Z. Song, and W. Yang, "NMTSloth: Understanding and testing efficiency degradation of neural machine translation systems," in ESEC/FSE, 2022.
197 J. Dong, Z. Zhang, Q. Zhang, T. Zhang, H. Wang, H. Li, Q. Li, C. Zhang, K. Xu, and H. Qiu, "An engorgio prompt makes large language model babble on," in ICLR, 2025.
198 Y. Chen, S. Chen, Z. Li, W. Yang, C. Liu, R. Tan, and H. Li, "Dynamic transformers provide a false sense of efficiency," in ACL, 2023.
199 X. Feng, X. Han, S. Chen, and W. Yang, "LLMEffiChecker: Understanding and testing efficiency degradation of large language models," ACM Transactions on Software Engineering and Methodology, vol. 33, p. 38, 2024.
200 X. Gao, Y. Chen, X. Yue, Y. Tsao, and N. F. Chen, "TTSlow: Slow down text-to-speech with efficiency robustness evaluations," arXiv preprint arXiv:2407.01927, 2024.
201 S. Zhang, M. Zhang, X. Pan, and M. Yang, "No-skim: Towards efficiency robustness evaluation on skimming-based language models," arXiv preprint arXiv:2312.09494, 2023.
202 K. Gao, T. Pang, C. Du, Y. Yang, S.-T. Xia, and M. Lin, "Denial-of-service poisoning attacks against large language models," arXiv preprint arXiv:2410.10760, 2024.
203 Y. Jiang, C. Chan, M. Chen, and W. Wang, "LION: Adversarial distillation of proprietary large language models," in EMNLP, 2023.
204 Z. Li, C. Wang, P. Ma, C. Liu, S. Wang, D. Wu, C. Gao, and Y. Liu, "On extracting specialized code abilities from large language models: A feasibility study," in ICSE, 2024.
205 Z. Liang, Q. Ye, Y. Wang, S. Zhang, Y. Xiao, R. Li, J. Xu, and H. Hu, "Alignment-aware model extraction attacks on large language models," arXiv preprint arXiv:2409.02718, 2024.
217 S. Duan, M. Khona, A. Iyer, R. Schaeffer, and I. R. Fiete, "Uncovering latent memories: Assessing data leakage and memorization patterns in large language models," in ICML Workshop, 2024.
206 N. Carlini, F. Tramer, E. Wallace, M. Jagielski, A. Herbert-Voss, K. Lee, A. Roberts, T. Brown, D. Song, U. Erlingsson et al., "Extracting training data from large language models," in USENIX Security, 2021.
208 M. Nasr, N. Carlini, J. Hayase, M. Jagielski, A. F. Cooper, D. Ippolito, C. A. Choquette-Choo, E. Wallace, F. Tramer, and K. Lee, "Scalable extraction of training data from (production) language models," arXiv preprint arXiv:2311.17035, 2023.
209 Z. Xu, F. Jiang, L. Niu, Y. Deng, R. Poovendran, Y. Choi, and B. Y. Lin, "Magpie: Alignment data synthesis from scratch by prompting aligned llms with nothing," arXiv preprint arXiv:2406.08464, 2024.
210 A. Al-Kaswan, M. Izadi, and A. Van Deursen, "Traces of memorisation in large language models for code," in ICSE, 2024.
216 W. Yu, T. Pang, Q. Liu, C. Du, B. Kang, Y. Huang, M. Lin, and S. Yan, "Bag of tricks for training data extraction from language models," in ICML, 2023.
211 Y. Bai, G. Pei, J. Gu, Y. Yang, and X. Ma, "Special characters attack: Toward scalable training data extraction from large language models," arXiv preprint arXiv:2405.05990, 2024.
212 A. M. Kassem, O. Mahmoud, N. Mireshghallah, H. Kim, Y. Tsvetkov, Y. Choi, S. Saad, and S. Rana, "Alpaca against vicuna: Using llms to uncover memorization of llms," arXiv preprint arXiv:2403.04801, 2024.
213 Z. Qi, H. Zhang, E. Xing, S. Kakade, and H. Lakkaraju, "Follow my instruction and spill the beans: Scalable data extraction from retrieval-augmented generation systems," arXiv preprint arXiv:2402.17840, 2024.
214 Y. More, P. Ganesh, and G. Farnadi, "Towards more realistic extraction attacks: An adversarial perspective," arXiv preprint arXiv:2407.02596, 2024.
215 Q. Zhang, H. Qiu, D. Wang, Y. Li, T. Zhang, W. Zhu, H. Weng, L. Yan, and C. Zhang, "A benchmark for semantic sensitive information in llms outputs," in ICLR, 2025.
583 S. Gehman, S. Gururangan, M. Sap, Y. Choi, and N. A. Smith, "RealToxicityPrompts: Evaluating neural toxic degeneration in language models," in EMNLP, 2020.
587 Y. Wang, H. Li, X. Han, P. Nakov, and T. Baldwin, "Do-Not-Answer: A dataset for evaluating safeguards in LLMs," in EACL, 2024.
599 Z. Cheng, X. Wu, J. Yu, S. Han, X.-Q. Cai, and X. Xing, "Soft-label integration for robust toxicity classification," in NeurIPS, 2024.
584 S. Lin, J. Hilton, and O. Evans, "TruthfulQA: Measuring how models mimic human falsehoods," in ACL, 2022.
589 K. Huang, X. Liu, Q. Guo, T. Sun, J. Sun, Y. Wang, Z. Zhou, Y. Wang, Y. Teng, X. Qiu et al., "FLAMES: Benchmarking value alignment of LLMs in Chinese," in NAACL, 2024.
590 T. Xie, X. Qi, Y. Zeng, Y. Huang, U. M. Sehwag, K. Huang, L. He, B. Wei, D. Li, Y. Sheng et al., "SORRY-Bench: Systematically evaluating large language model safety refusal behaviors," arXiv preprint arXiv:2406.14598, 2024.
588 G. Xu, J. Liu, M. Yan, H. Xu, J. Si, Z. Zhou, P. Yi, X. Gao, J. Sang, R. Zhang et al., "CVALUES: Measuring the values of Chinese large language models from safety to responsibility," arXiv preprint arXiv:2307.09705, 2023.
586 H. Sun, Z. Zhang, J. Deng, J. Cheng, and M. Huang, "Safety assessment of Chinese large language models," arXiv preprint arXiv:2304.10436, 2023.
598 G. Sun, X. Zhan, S. Feng, P. C. Woodland, and J. Such, "CASE-Bench: Context-aware safety benchmark for large language models," arXiv preprint arXiv:2501.14940, 2025.
597 S. Ghosh, P. Varshney, M. N. Sreedhar, A. Padmakumar, T. Rebedea, J. R. Varghese, and C. Parisien, "AEGIS2.0: A diverse AI safety dataset and risks taxonomy for alignment of LLM guardrails," arXiv preprint arXiv:2501.09004, 2025.
193 Y. Wang, Y. Teng, K. Huang, C. Lyu, S. Zhang, W. Zhang, X. Ma, Y.-G. Jiang, Y. Qiao, and Y. Wang, "Fake alignment: Are llms really aligned well?" in NAACL, 2024.
591 Z. Zhang, L. Lei, L. Wu, R. Sun, Y. Huang, C. Long, X. Liu, X. Lei, J. Tang, and M. Huang, "SafetyBench: Evaluating the safety of large language models," in ACL, 2024.
596 H. Li, X. Han, Z. Zhai, H. Mu, H. Wang, Z. Zhang, Y. Geng, S. Lin, R. Wang, A. Shelmanov et al., "Libra-Leaderboard: Towards responsible AI through a balanced leaderboard of safety and capability," arXiv preprint arXiv:2412.18551, 2024.
593 Y. Li, H. Huang, Y. Zhao, X. Ma, and J. Sun, "BackdoorLLM: A comprehensive benchmark for backdoor attacks on large language models," arXiv preprint arXiv:2408.12798, 2024.
585 B. Wang, C. Xu, S. Wang, Z. Gan, Y. Cheng, J. Gao, A. H. Awadallah, and B. Li, "Adversarial GLUE: A multi-task benchmark for robustness evaluation of language models," in NeurIPS, 2021.
592 L. Li, B. Dong, R. Wang, X. Hu, W. Zuo, D. Lin, Y. Qiao, and J. Shao, "SALAD-Bench: A hierarchical and comprehensive safety benchmark for large language models," in ACL, 2024.
594 W. Luo, S. Ma, X. Liu, X. Guo et al., "JailBreakV-28K: A benchmark for assessing the robustness of multimodal large language models against jailbreak attacks," arXiv preprint arXiv:2404.03027, 2024.
595 A. Souly, Q. Lu, D. Bowen, T. Trinh, E. Hsieh, S. Pandey, P. Abbeel, J. Svegliato, S. Emmons, O. Watkins, and S. Toyer, "A strongREJECT for empty jailbreaks," in ICLR Workshop, 2024.