摘要:本文以 InnoDB 的 B+Tree 索引为起点,讲清聚簇索引、回表与覆盖索引的底层逻辑,再用 EXPLAIN 把「索引失效、filesort、临时表」等慢查询根因量化出来,并给出一套可复现的索引优化 SOP 与电商订单表实战案例。
导语
线上接口偶发超时,第一反应往往是「加个索引」。但加了索引为什么还慢?为什么明明建了联合索引却仍是全表扫描?这些问题背后,是对 MySQL 索引工作机制理解不够。
本文面向一线后端与 DBA,主线是「官方文档一手原理 + EXPLAIN 可验证闭环」:每个结论都配可复现的 SQL 与执行计划对照,不靠经验拍脑袋。读完后你能独立用执行计划驱动 SQL 性能优化,做到少回表、少 IO、少 filesort。
相关阅读可参考 CSDN 站内的 MySQL 索引优化专题:MySQL 索引优化实战合集。
一、B+Tree 索引底层原理:InnoDB 为什么快
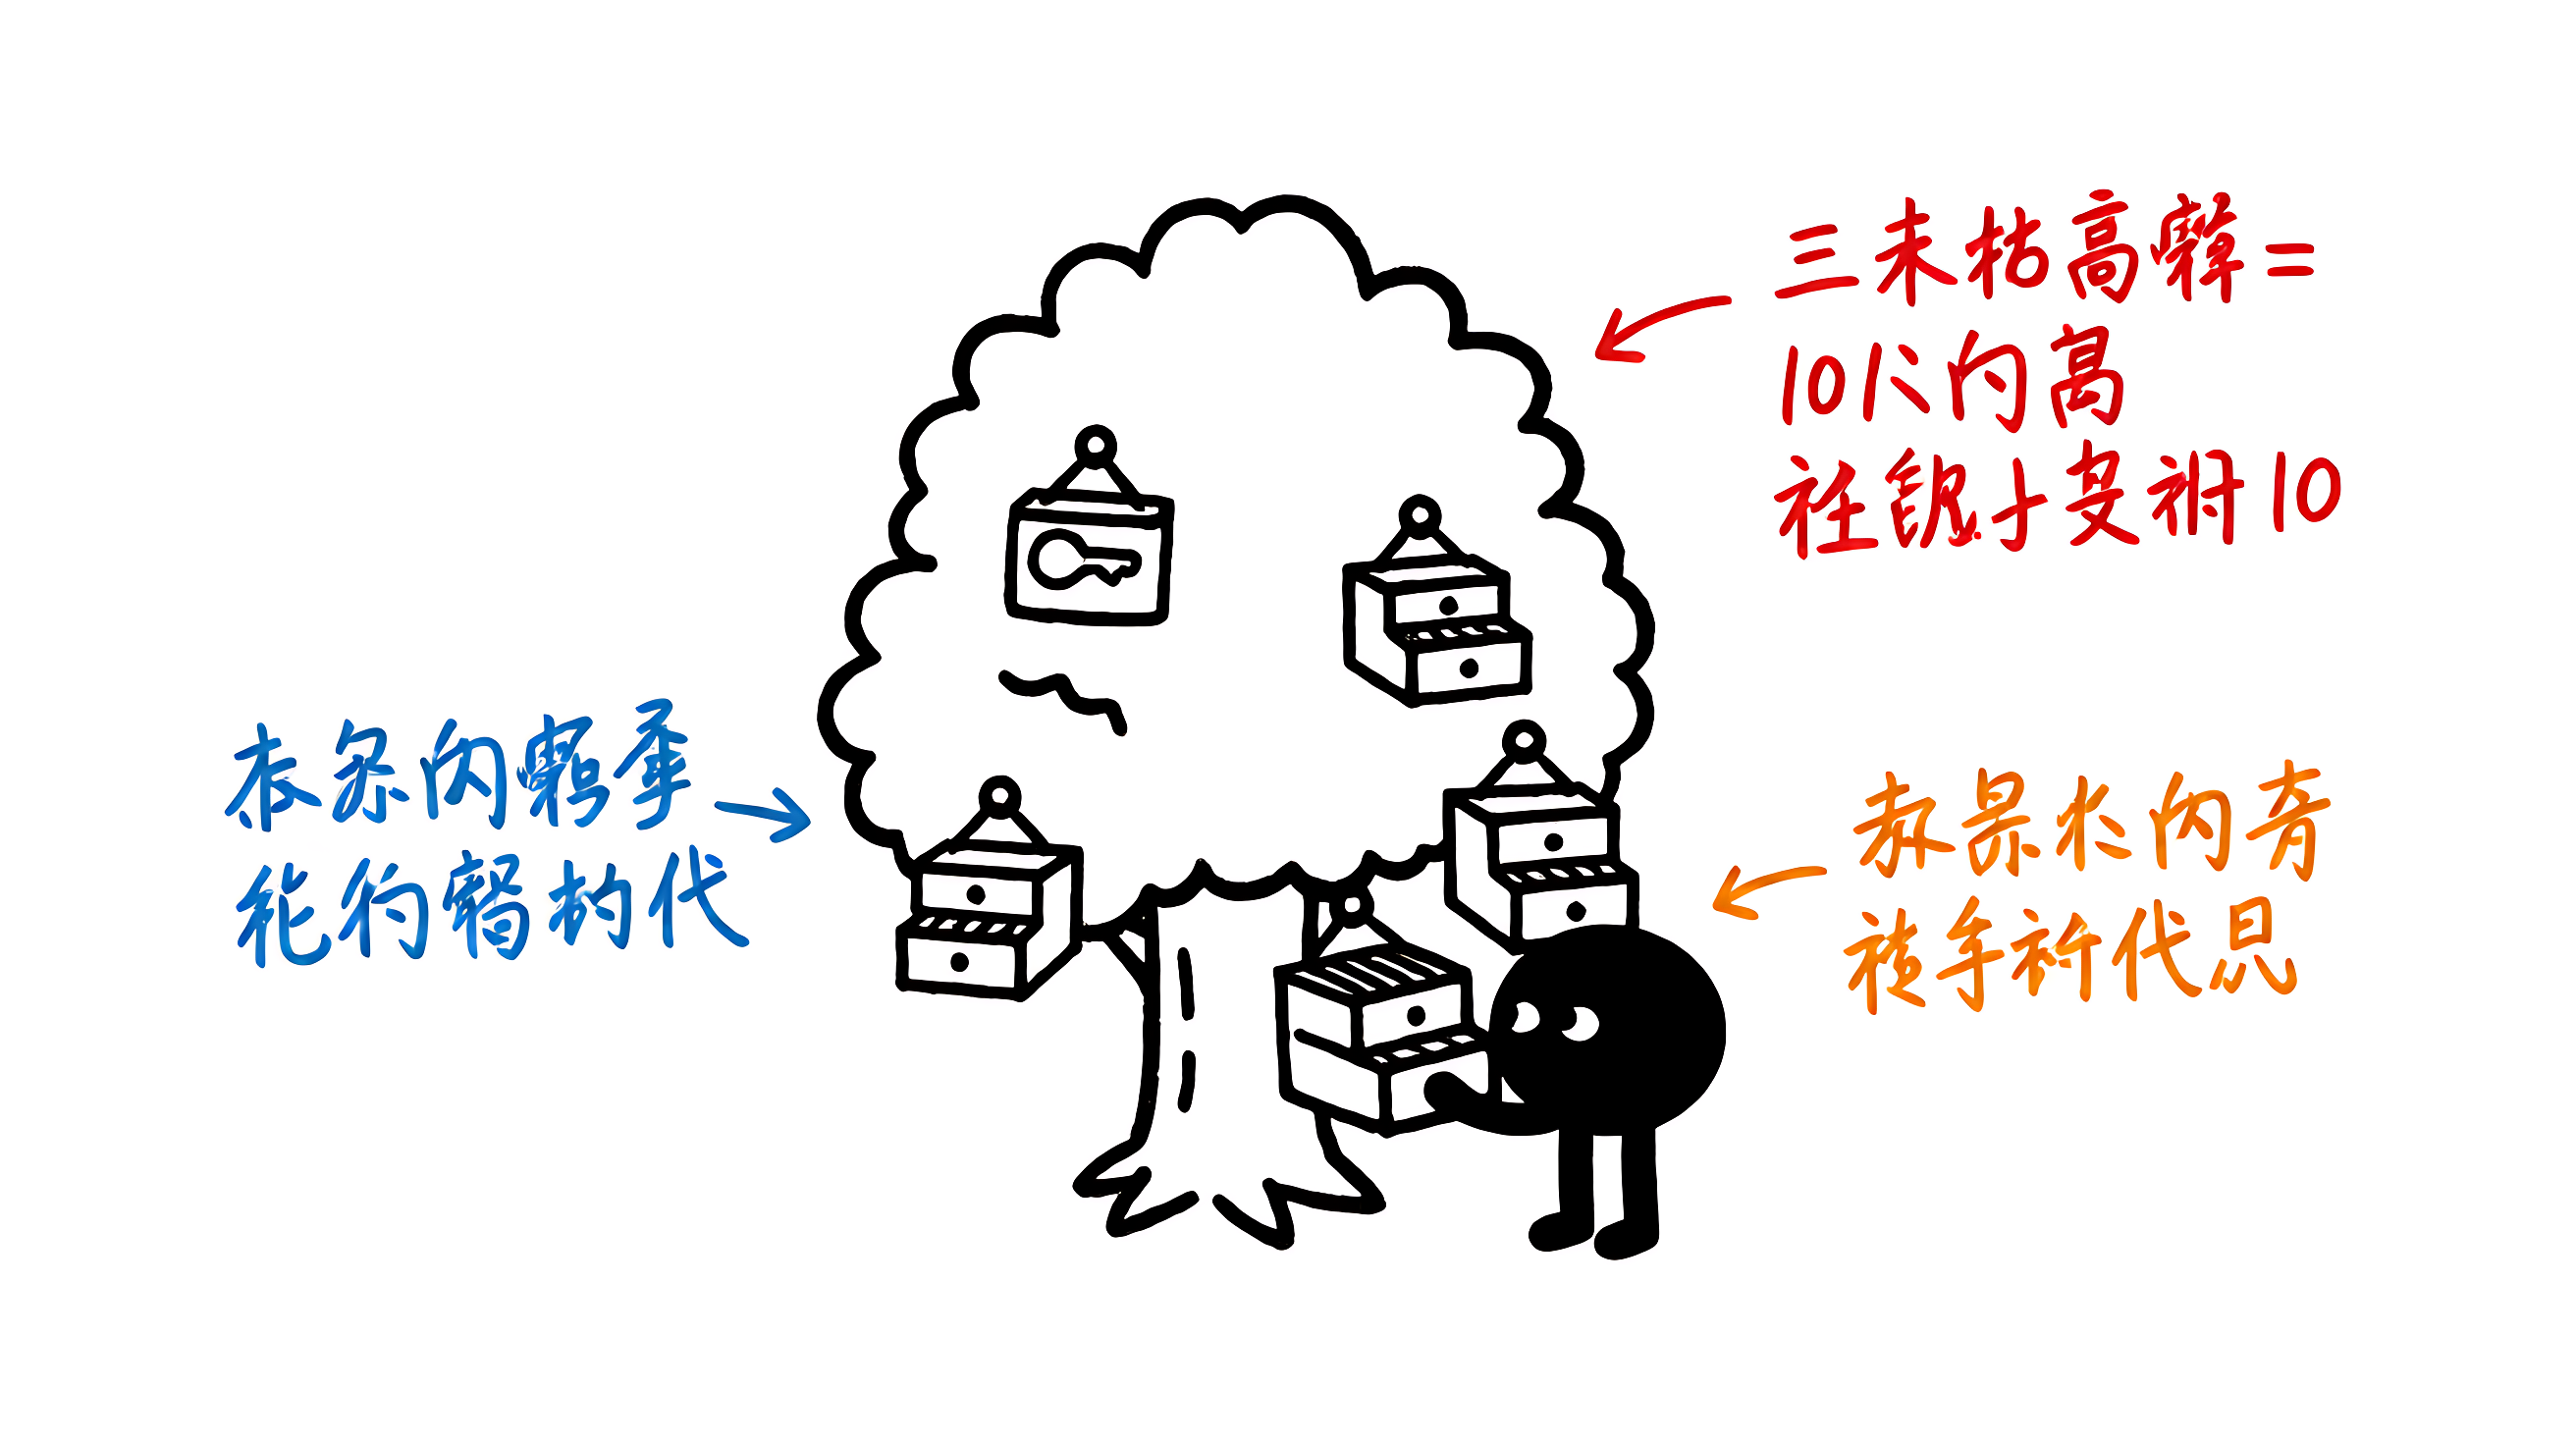
MySQL 绝大多数索引(主键、唯一索引、普通索引)在 InnoDB 中以 B+Tree(一种多路平衡查找树)存储:树保持矮胖,非叶子节点只存「键 + 指针」,叶子节点才存数据并用双向链表串联。三层结构就能容纳千万级数据,这正是索引查询只需极少次磁盘 IO 的原因。
1.1 聚簇索引 = 主键:行数据就存在索引叶子节点
聚簇索引(clustered index) 是指数据行与索引键存储在一起,叶子节点直接放整行。在 InnoDB 中聚簇索引通常就是主键。
sql
-- 显式定义自增整型主键,避免隐藏聚簇索引
CREATE TABLE orders (
  id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
  user_id BIGINT NOT NULL,
  status TINYINT NOT NULL,
  create_time DATETIME NOT NULL,
  amount DECIMAL(10,2) NOT NULL
) ENGINE=InnoDB;
当没有显式主键时,InnoDB 会依次使用第一个「所有列 NOT NULL 的 UNIQUE 索引」,否则自动生成隐藏的 GEN_CLUST_INDEX(6 字节 row ID)。因此每张表都应显式定义主键,且优先用自增整型------随机主键(如 UUID)会造成页分裂,拖慢写入。
1.2 二级索引与「回表」:叶子节点存的是主键值
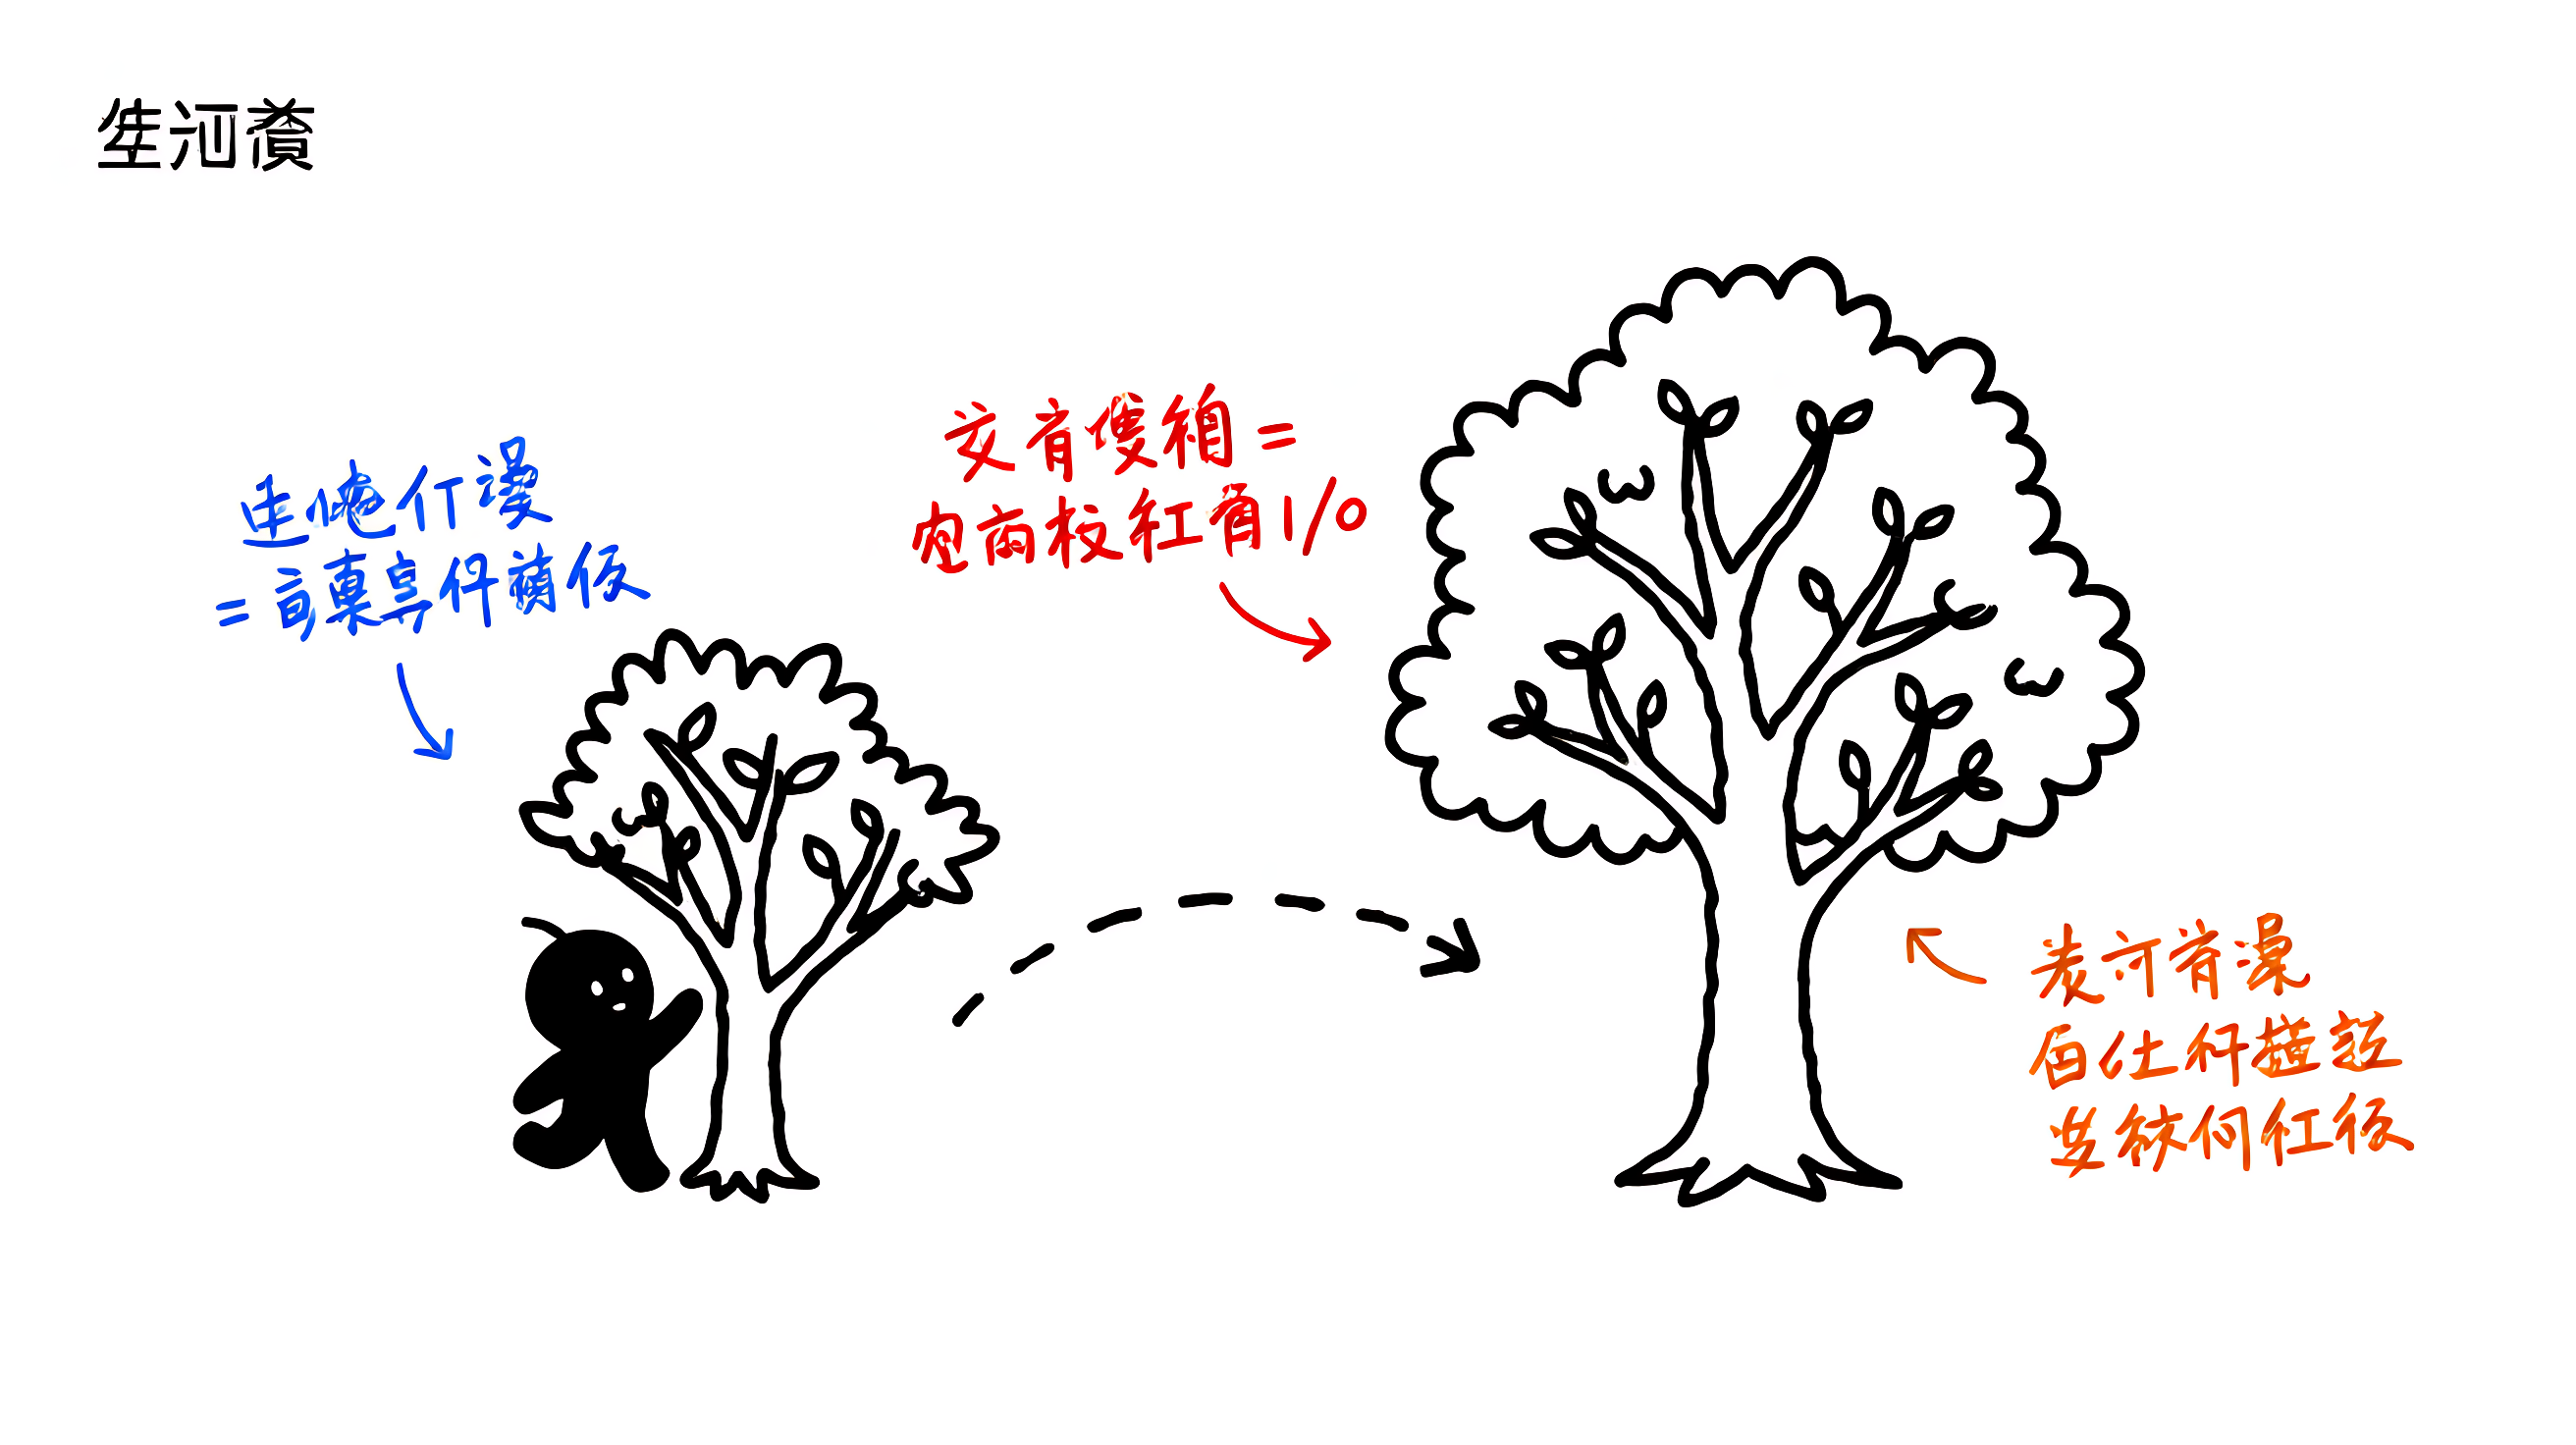
回表 是指:通过二级索引(非聚簇索引)查到主键值后,还要再拿主键去聚簇索引取整行数据。二级索引的每条记录都包含「索引列 + 主键值」。
推论很关键:主键越长,所有二级索引越大。所以官方明确建议主键尽量短。能用覆盖索引避免回表,就少一次聚簇索引的随机 IO。
sql
-- 观察某表在 InnoDB 中的索引构成
SELECT index_name, index_type, non_unique
FROM information_schema.innodb_indexes
WHERE table_id = (
  SELECT table_id FROM information_schema.innodb_tables
  WHERE name LIKE 'test/orders'
);
1.3 B+Tree 结构优势小结
- 矮胖树高 → 每次查询极少次磁盘 IO;
- 叶子链表 → 范围查询、
ORDER BY可顺序读,避免额外排序; - 聚簇存放 → 按主键范围扫描极快,但非主键范围容易回表。
结构决定行为,下一章用 EXPLAIN 把「行为」量化出来。
二、看懂 EXPLAIN 执行计划:优化前的「体检报告」
EXPLAIN 是 MySQL 的分析命令,用来查看一条 SQL 的执行计划。它是每个优化动作的起点:看 type 判断访问方式优劣,看 key 确认是否用对索引,看 rows 估算扫描量,看 Extra 找 filesort 与临时表。
优化总目标是消除 ALL 全表扫描,并尽量避免 Extra 里的 Using filesort 与 Using temporary。
sql
-- MySQL 8.0 可输出 JSON 格式,含更细的成本信息
EXPLAIN FORMAT=JSON
SELECT * FROM orders WHERE user_id = 1001 ORDER BY create_time DESC LIMIT 20;
2.1 type 访问类型:从 ALL 到 const 的优劣排序
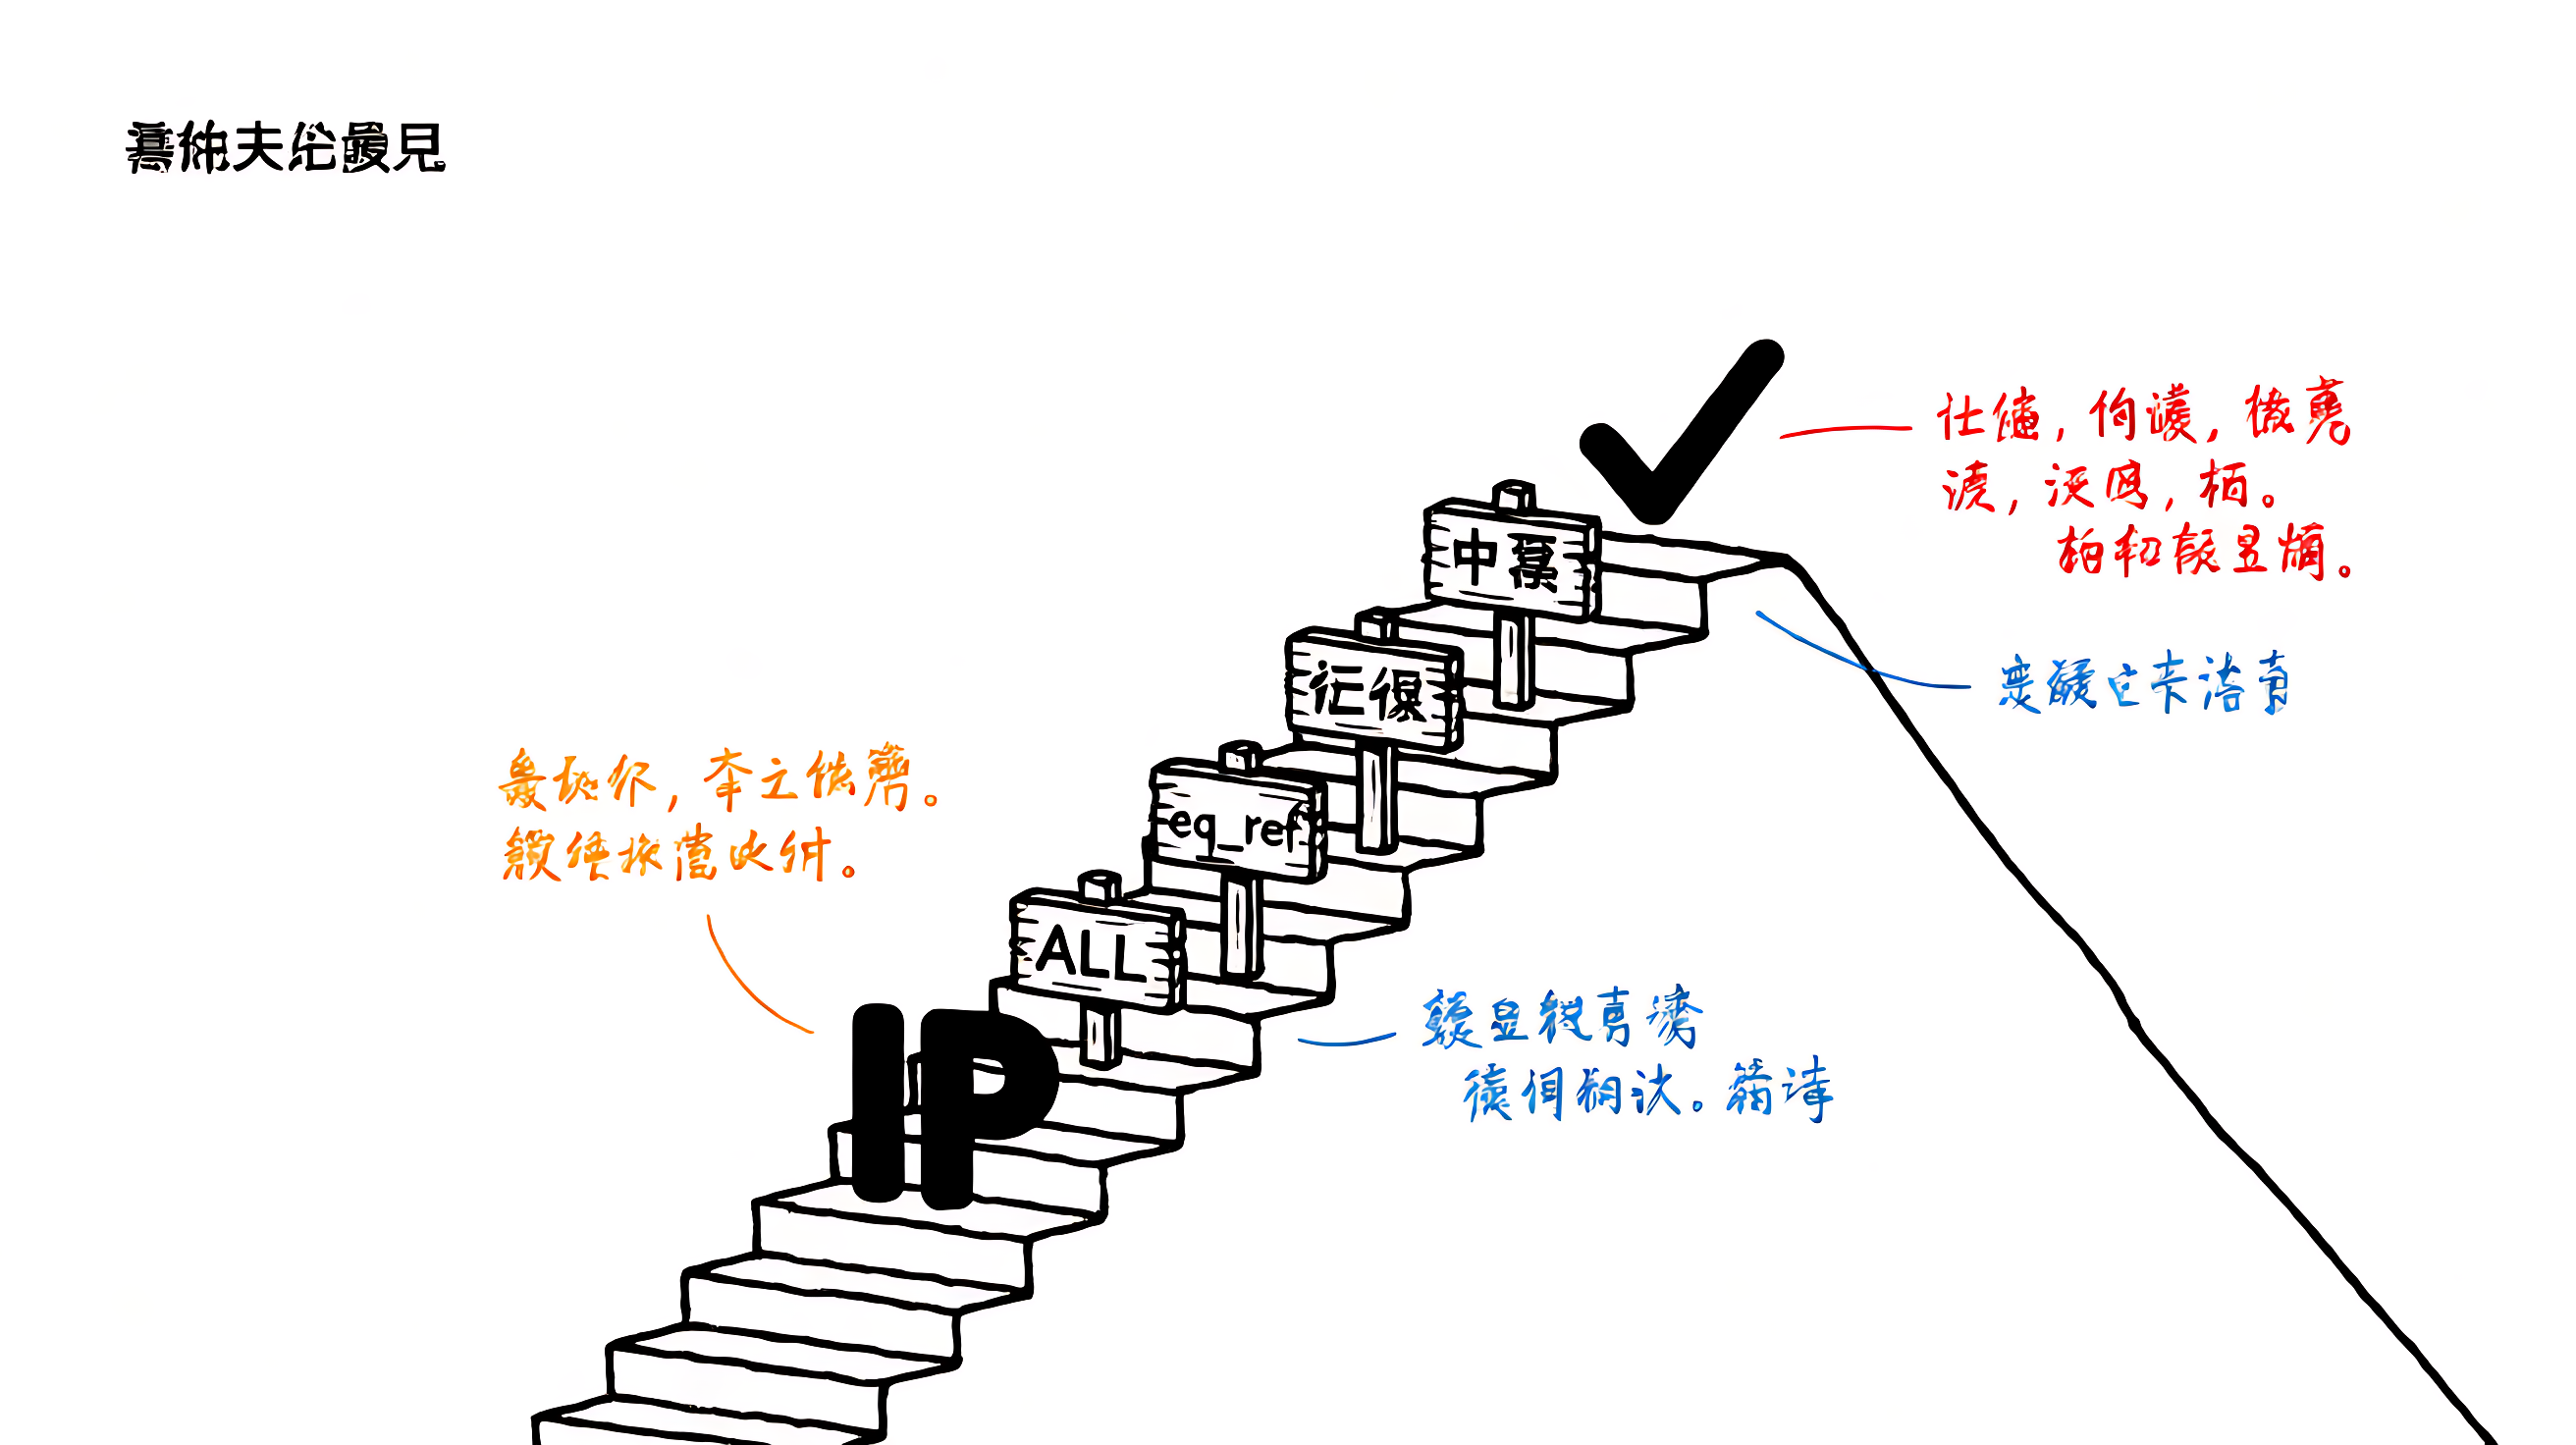
官方给出的由优到劣顺序是:system > const > eq_ref > ref > range > index > ALL。
| type | 含义 | 出现条件 | 优化建议 |
|---|---|---|---|
| system | 单行系统表 | 表仅一行(const 特例) | 最优,无需处理 |
| const | 最多一行 | 主键/唯一索引等值 | 最优,无需处理 |
| eq_ref | 联表每行唯一 | JOIN 主键/唯一 NOT NULL 等值 | 极优,常见于主键关联 |
| ref | 命中多行 | 索引最左前缀/非唯一 | 常见良好类型 |
| range | 范围扫描 | 索引范围查询 | 可接受 |
| index | 全索引树扫描 | 仅读索引 | 看是否覆盖 |
| ALL | 全表扫描 | 无可用索引 | 必须优化 |
sql
-- 主键等值:type 应为 const
EXPLAIN SELECT * FROM orders WHERE id = 1;
-- 范围查询:type 应为 range
EXPLAIN SELECT * FROM orders WHERE user_id BETWEEN 1000 AND 1010;
2.2 key / rows:实际用到的索引与估算扫描行数
key 是优化器实际选用的索引,它可能不在 possible_keys 中------当该索引仅用于覆盖扫描、比扫数据行更便宜时就会出现这种情况。rows 是估算扫描行数(InnoDB 为估计值,不一定精确)。
sql
-- 多表 JOIN 时各表 rows 相乘得行乘积,越大越需优化
EXPLAIN SELECT * FROM orders o
  JOIN users u ON o.user_id = u.id
  WHERE o.status = 1;
实战中可用 SHOW WARNINGS 查看优化器改写后的语句,辅助判断为什么没走预期索引。
2.3 Extra 关键信号
Extra 列是性能红灯区,记住一句口诀:有 Using index 是好事,出现 Using filesort / Using temporary 优先消除。
Using index:仅从索引树取数、无需回表,即覆盖索引;Using where:用 WHERE 过滤行;Using index condition:索引条件下推(ICP),先按索引过滤再决定是否读整行,减少回表;Using filesort:需额外排序趟,排序键可能落盘;Using temporary:需建临时表,常见于GROUP BY与ORDER BY列不一致。
sql
-- 触发 Using filesort 的写法
EXPLAIN SELECT * FROM orders WHERE status = 1 ORDER BY amount DESC;
-- 改写:让排序列也走索引(见第四章)
EXPLAIN SELECT id, amount FROM orders
  WHERE status = 1 ORDER BY create_time DESC LIMIT 20;
关键定义可对照文末「参考资料」列出的 MySQL 8.0 官方文档(EXPLAIN Output Format、Clustered and Secondary Indexes 等章节)。
三、索引失效的十大场景与规避(配合 EXPLAIN 验证)
本章是实战核心:每个场景都给出「失效 SQL + 验证 EXPLAIN + 规避写法」三段式。索引失效的本质,是优化器无法利用索引的有序性或定位性,而 EXPLAIN 是唯一真相来源。
3.1 最左前缀失效
联合索引 (a,b,c) 只能用最左前缀:(a)、(a,b)、(a,b,c)。只查 (b) 或不带 a 则无法走该索引;跳过中间列如 WHERE a=1 AND c=2,仅 a 可用,c 失效。
sql
-- 建联合索引
ALTER TABLE t ADD INDEX idx_abc(a,b,c);
-- 命中:(a,b,c) 齐全
EXPLAIN SELECT * FROM t WHERE a=1 AND b=2 AND c=3;
-- 失效:缺最左列 b,c 无法利用索引
EXPLAIN SELECT * FROM t WHERE a=1 AND c=2;
3.2 对索引列使用函数或运算
WHERE YEAR(create_time)=2024、WHERE amount+1>100 这类对索引列套函数/运算,会导致索引失效。规避办法是改写为范围或等价表达式。
sql
-- 失效写法
EXPLAIN SELECT * FROM orders WHERE YEAR(create_time) = 2024;
-- 命中写法
EXPLAIN SELECT * FROM orders
  WHERE create_time >= '2024-01-01' AND create_time < '2025-01-01';
3.3 隐式类型转换
字符串列与数字比较时,MySQL 可能把列转成数字做全表扫描。规避:参数类型与列类型严格一致,字符串务必加引号。
sql
-- 失效:phone 是 varchar,却用数字比较
EXPLAIN SELECT * FROM user WHERE phone = 13812345678;
-- 命中:类型一致
EXPLAIN SELECT * FROM user WHERE phone = '13812345678';
3.4 隐式字符集/排序规则不一致
联表 JOIN 时两列字符集不同(如 utf8mb4 与 latin1)会无法使用索引,这是隐蔽的失效源。规避:统一表/列的字符集与排序规则(推荐 utf8mb4 + utf8mb4_0900_ai_ci)。
3.5 LIKE 以 % 开头
LIKE '%明'、LIKE '%明%' 前缀通配破坏有序性,索引失效;LIKE '张%' 前缀确定可用索引做范围扫描。
sql
-- 命中:前缀确定
EXPLAIN SELECT * FROM user WHERE name LIKE '张%';
-- 失效:前导通配
EXPLAIN SELECT * FROM user WHERE name LIKE '%明';
3.6 OR 含非索引列
WHERE a=1 OR b=2,若 b 无索引,优化器往往放弃索引改全表扫描。规避:用 UNION ALL 拆成两个索引查询,或给 b 补索引。
sql
-- OR 全表扫描
EXPLAIN SELECT * FROM t WHERE a=1 OR b=2;
-- 改用 UNION ALL
EXPLAIN SELECT * FROM t WHERE a=1
  UNION ALL SELECT * FROM t WHERE b=2;
3.7 范围查询断开后续最左前缀
联合索引 (a,b,c),WHERE a=1 AND b>10 AND c=2:b 是范围,c 无法再利用索引有序性。规避:把范围列放联合索引最后,或用 IN 代替范围(IN 非范围断点)。
3.8 负向查询
!= / NOT IN / NOT LIKE 返回行比例大,优化器常判定全表扫描更划算而放弃索引。规避:尽量用正向等值/范围改写,必要时结合覆盖索引让优化器走 index 扫描。
3.9 优化器判定全表扫描更快
当查询需要访问大部分行时,顺序读比走索引更快,索引作用变小。低基数列(性别、状态位)单独建索引收益低。规避:用组合索引提高选择性。
3.10 排序/分组无法用索引
ORDER BY 用不同索引、含表达式、与 GROUP BY 不一致等情况都会导致 filesort。这正是下一章覆盖索引要解决的问题,下一节用覆盖索引 + 合理列顺序来消除。
四、覆盖索引:用「少回表」换「少 IO」
覆盖索引(covering index) 指查询只用到了某个索引包含的列,值可直接从索引树取,无需回表。Extra 出现 Using index 即命中覆盖索引,是既快又省 IO 的终极手段。
4.1 什么是覆盖索引
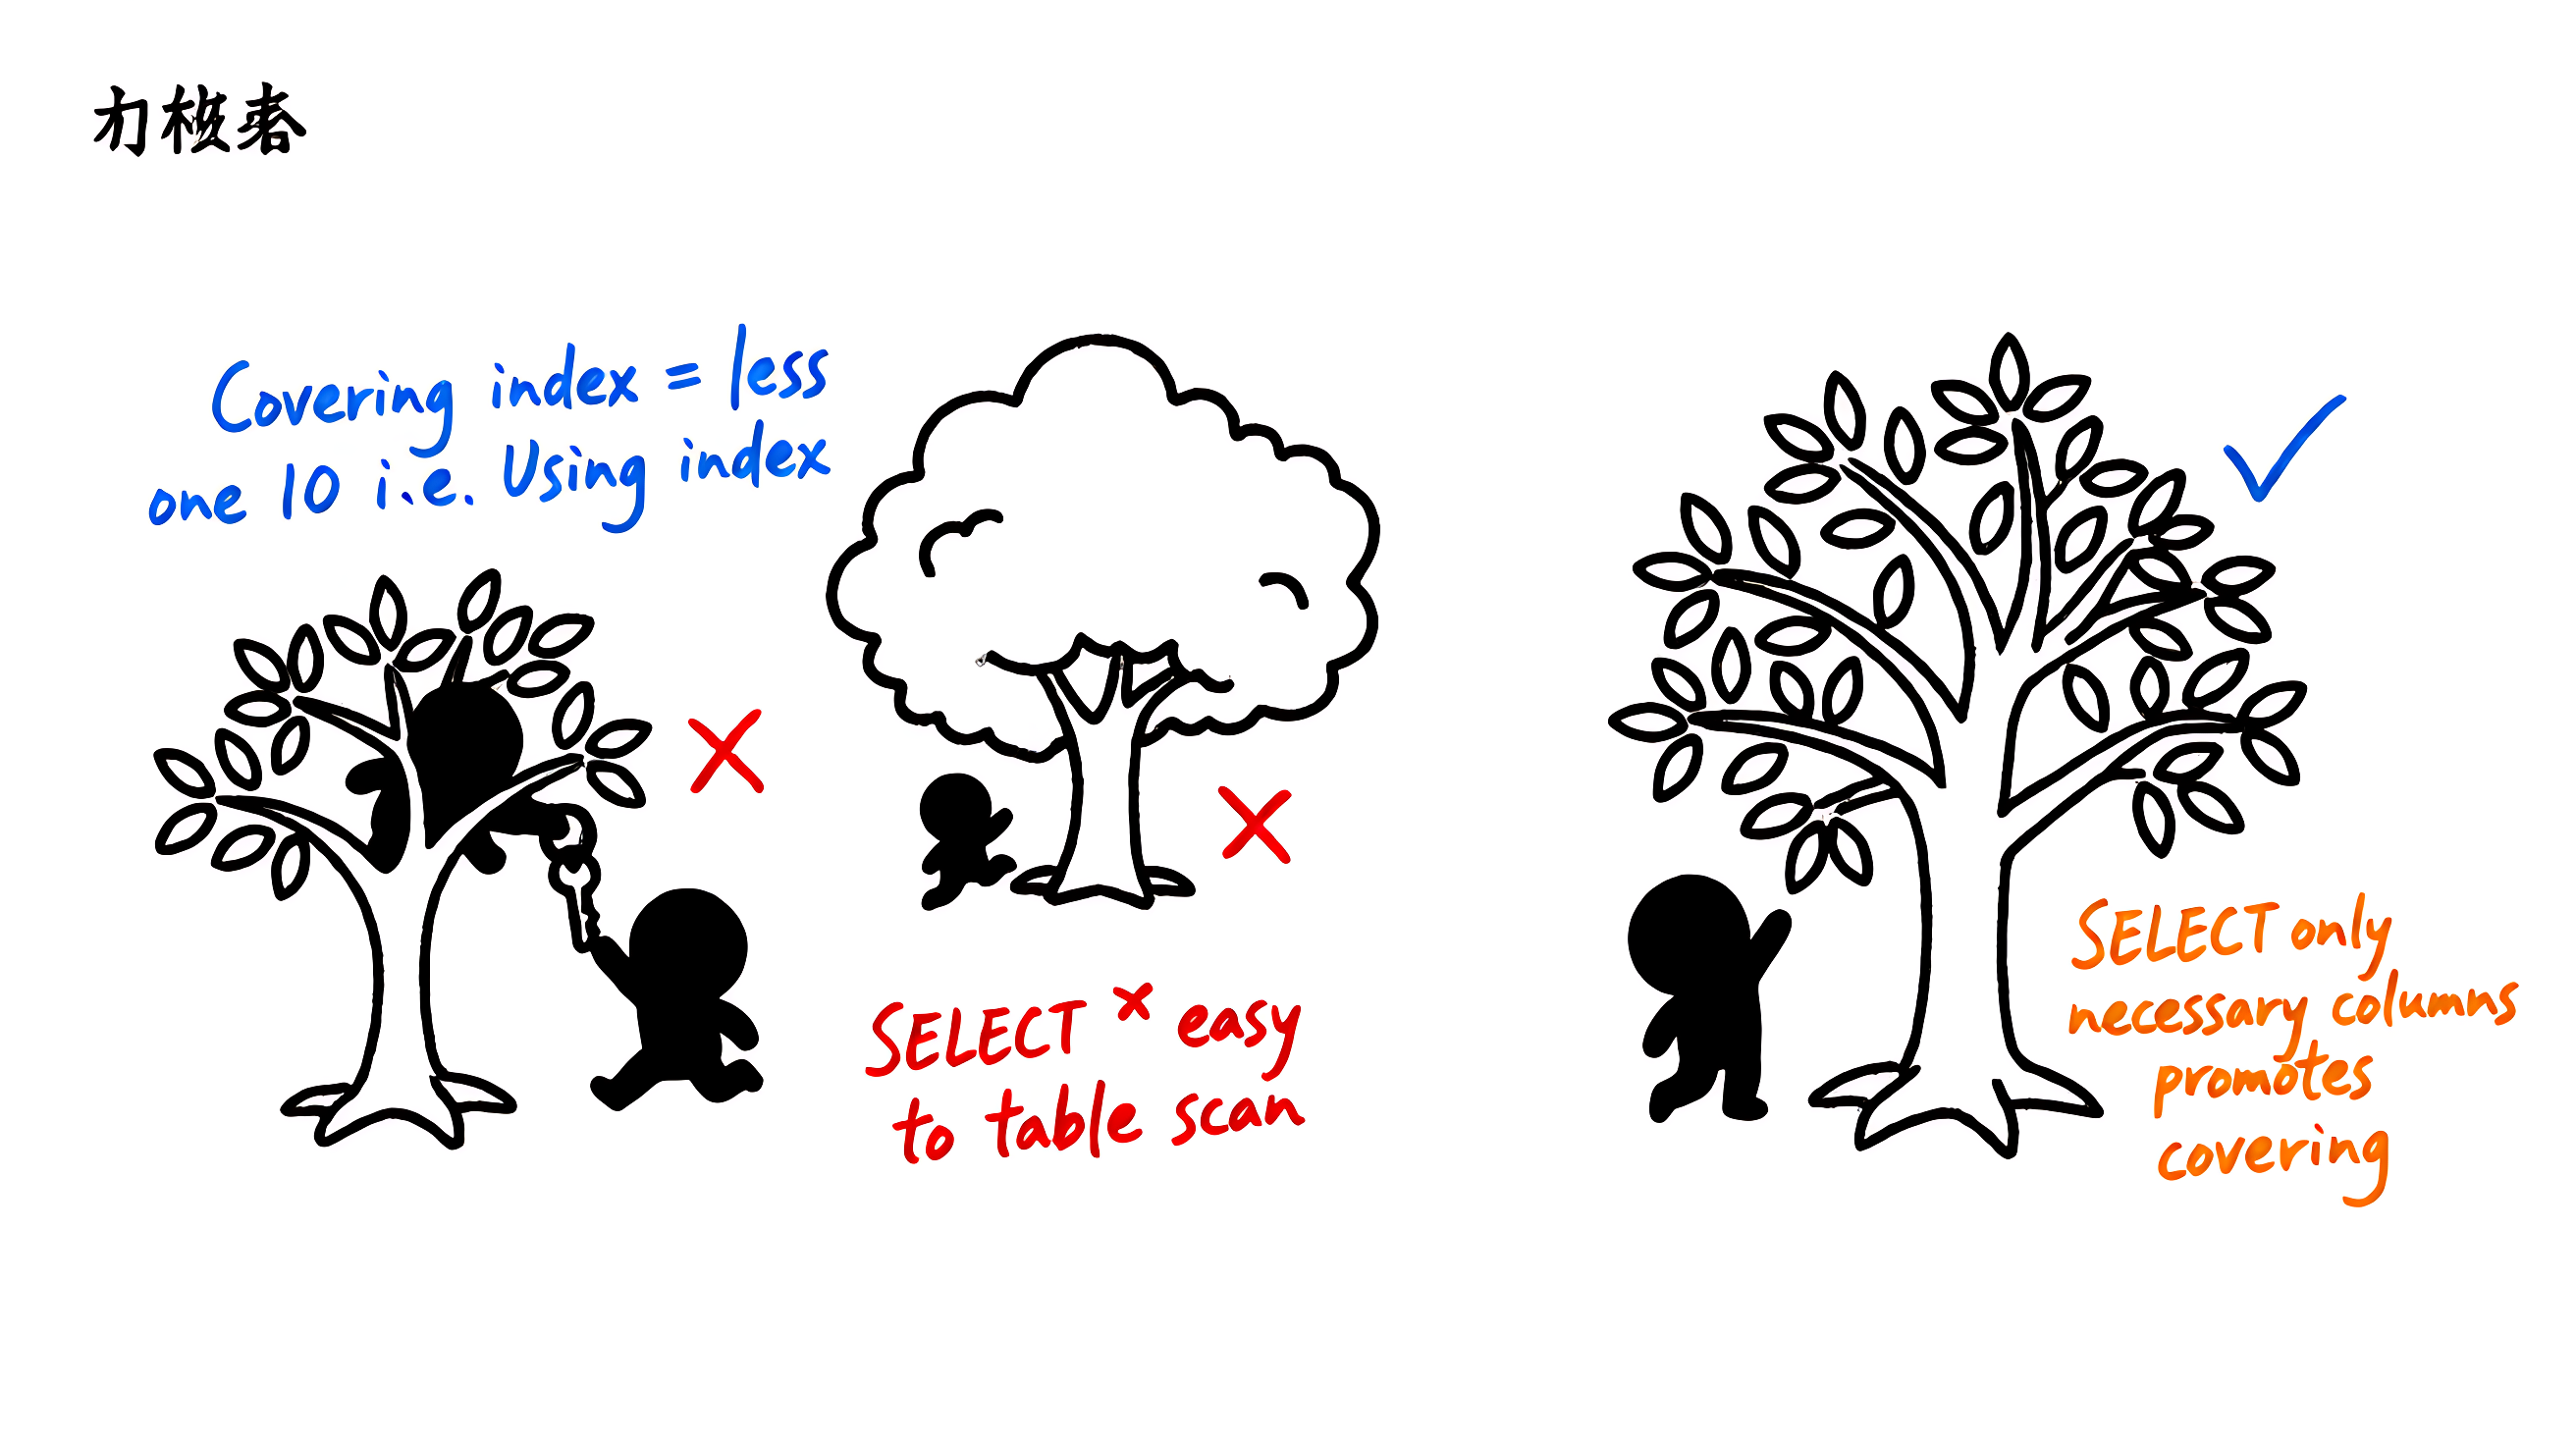
SELECT * 通常会因需取非索引列而回表,反而可能让优化器放弃索引改用全表扫描。实践准则:只 SELECT 必要列,把高频查询的列纳入联合索引尾部,构成覆盖。
sql
-- 可能回表/弃索引
EXPLAIN SELECT * FROM orders WHERE user_id = 1001;
-- 命中覆盖索引(只取索引列)
EXPLAIN SELECT user_id, status FROM orders WHERE user_id = 1001;
4.2 联合索引同时服务 WHERE + ORDER BY
若索引包含 WHERE 过滤列与前导 ORDER BY 列且顺序一致,可同时「定位行 + 免排序」。MySQL 8.0 还支持降序索引,混排 ASC/DESC 也能用索引。
sql
-- 让 WHERE + ORDER BY 同走索引且无 filesort
ALTER TABLE orders ADD INDEX idx_user_status_ct(user_id, status, create_time);
EXPLAIN SELECT id, amount FROM orders
  WHERE user_id = 1001 AND status = 1
  ORDER BY create_time DESC LIMIT 20;
五、慢查询定位与调优闭环
把前面原理落成可操作 SOP:先定位慢 SQL,再用 EXPLAIN 诊断,再改索引/改 SQL,最后验证。避免「拍脑袋加索引」。
5.1 开启慢查询日志
sql
-- 动态开启,阈值设为 0.1 秒抓亚秒级慢查询
SET GLOBAL slow_query_log = ON;
SET GLOBAL long_query_time = 0.1;
生产环境可在 my.cnf 持久化:slow_query_log=ON、long_query_time=0.1、log_queries_not_using_indexes=ON(仅排查期开启,避免日志暴涨)。
5.2 EXPLAIN ANALYZE 与 optimizer trace
MySQL 8.0 的 EXPLAIN ANALYZE 在执行同时输出实际行数与成本,比纯 EXPLAIN 更准。
sql
-- 输出实际执行成本
EXPLAIN ANALYZE
SELECT * FROM orders WHERE user_id = 1001 ORDER BY create_time DESC LIMIT 20;
若估算 rows 与实际差异过大,往往说明统计信息不准,需 ANALYZE TABLE orders; 更新。
5.3 调优 SOP:定位 → 分析 → 改索引/改 SQL → 验证
| 现象 | EXPLAIN 信号 | 对策 |
|---|---|---|
| 全表扫描 | type=ALL | 补/调联合索引 |
| 额外排序 | Using filesort | 索引覆盖排序列 |
| 大量回表 | 无 Using index | 收敛 SELECT 列 |
| 临时表 | Using temporary | 统一 ORDER/GROUP 列 |
六、实战案例:电商订单表慢查询调优
用一个订单表演示从慢到快的完整过程,刻意制造「索引失效 + 回表 + filesort」三连,再逐步修复。
6.1 场景与原始慢 SQL
需求:查某用户近 30 天、已支付、按时间倒序的前 20 条订单。原始索引设计不当,导致回表严重且触发 filesort。
sql
-- 原始索引只覆盖 (user_id, status)
ALTER TABLE orders ADD INDEX idx_user_status(user_id, status);
-- 原始查询
SELECT * FROM orders
  WHERE user_id = 1001 AND status = 1
    AND create_time >= '2024-08-01'
  ORDER BY create_time DESC LIMIT 20;
6.2 EXPLAIN 诊断
诊断输出:type=ref 但 Extra 同时出现 Using where 与 Using filesort,rows 估算偏大。根因是索引 (user_id, status) 未覆盖 create_time,ORDER BY 无法用索引 → filesort;且 SELECT * 造成回表。
6.3 索引改造与效果对比
改造:建联合索引 (user_id, status, create_time),使 WHERE 与 ORDER BY 同走索引且构成覆盖,同时把 SELECT * 收敛到必要列。
sql
-- 改造索引
ALTER TABLE orders
  ADD INDEX idx_user_status_ct(user_id, status, create_time);
-- 改造后查询(仅取索引覆盖列,Extra 变为 Using index,无 filesort)
EXPLAIN SELECT id, create_time, status FROM orders
  WHERE user_id = 1001 AND status = 1
    AND create_time >= '2024-08-01'
  ORDER BY create_time DESC LIMIT 20;
改造后 Extra 变为 Using index(覆盖索引,无需回表),同时消除了 Using filesort,扫描行数大幅下降,耗时从百毫秒级降到毫秒级(具体数值以实际环境实测为准,不编造精确数字)。
七、总结与避坑清单(Checklist)
索引是手段不是目的,写入放大与空间成本要权衡。收尾点题:原理(B+Tree)→ 工具(EXPLAIN)→ 现象(失效/回表/filesort)→ 方法(覆盖索引 + 调优 SOP)。
MySQL 索引优化自查清单:
- 每张表显式定义短主键(优先自增整型);
- 联合索引按最左前缀设计,等值高选择性列放最左;
- 不在索引列上套函数/运算;
- 字符串比较务必加引号,避免隐式转换;
- 统一联表字符集与排序规则;
- LIKE 避免前导通配
%; - OR 含非索引列时改用 UNION ALL;
- 范围列放联合索引最后,或用 IN 代替;
- 收敛 SELECT 列,优先促成覆盖索引(Using index);
- 定期
ANALYZE TABLE维护统计信息,慢查询用 EXPLAIN ANALYZE 验证。
参考资料
- MySQL 8.0 Reference Manual - Clustered and Secondary Indexes(聚簇/二级索引、回表、隐藏聚簇索引 GEN_CLUST_INDEX)
- MySQL 8.0 Reference Manual - EXPLAIN Output Format(type/key/rows/Extra 官方定义)
- MySQL 8.0 Reference Manual - ORDER BY Optimization(覆盖索引消除 filesort、降序索引)
- MySQL 8.0 Reference Manual - How MySQL Uses Indexes(最左前缀、隐式转换、覆盖索引)
- MySQL 8.0 Reference Manual - Optimization and Indexes(索引优化总入口)
© 2024 | 转载请注明出处
结论:PASS