《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群 ,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)!
论文标题:GPT 6 Astra as an Embodied Policy
论文作者:银河通用(Galbot)
发表时间:2026年9月
本文要点
(1)GPT 6 Astra as an Embodied Policy是2026年9月挂出的匿名评测,无arXiv。源码里带银河通用标识,媒体随后点名作者来自银河通用,GitHub现已署Jiayi Su、Yixin Zheng、Mi Yan、Li Yi、Zhizheng Zhang、He Wang。
(2)RoboDojo所选十个双臂任务上,混合架构平均分62.60 、成功率48%,Direct为37.81和26%。Astra只改了**14.4%**的已执行控制步。
(3)做法是π0.5每次给出一条50步关节候选,Astra审核正运动学轨迹后二选一,沿用前1到15步,或自己出1到5步末端修正。
(4)短板在接触稳定。Direct搭塔Score 12、麻将杠牌0。RoboLab语义抓放上Direct反而到49/50,说明学生策略不适配时,加一层再改不一定更高。
(5)文末附配套数据集卡上的轨迹读取示例。
2026年9月12日前后,GitHub Pages上出现一份匿名评测,题为GPT 6 Astra as an Embodied Policy。报告页data.json记录的生成时间是9月13日,没有arXiv编号。
发布时作者栏是空的。仓库源码里放着银河通用的logo。36氪等媒体随后写明,作者来自银河通用(Galbot)。公开仓库现在署了六个人的名字,Jiayi Su与Yixin Zheng共同一作,Li Yi、Zhizheng Zhang、He Wang为通讯作者。
我把报告正文、scores.csv、配套Hugging Face数据集和开源控制器对过一遍。媒体多在谈差距焦虑。下面只拆技术。
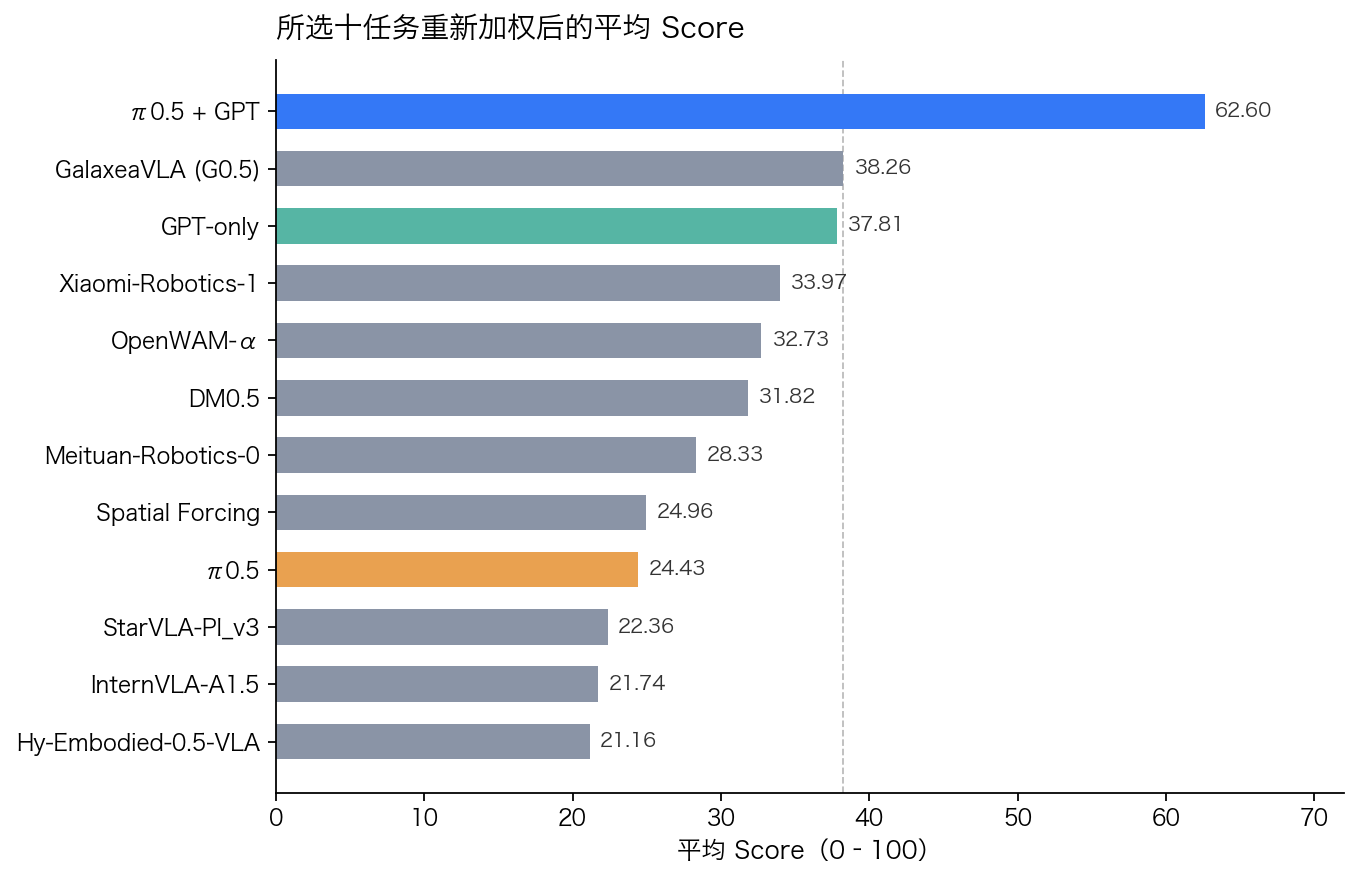
同一张图里,官网仿真榜整体前十个模型按这十个任务重新加权。最高的是GalaxeaVLA (G0.5)的38.26 。混合架构62.60,相对这个数大约高出64%。报告正文没有写这句百分比,两个分数在Figure 3用的是同一张表。
一、π0.5候选与Astra混合控制
任务是仿真双臂操作。机器人是ARX X5,动作14维,左右各六个关节加一个开合,控制频率25Hz。观察为头部与双腕RGB,外加本体状态。两组都用gpt-6-astra,推理设置为xhigh。
混合控制每个决策时刻只走一条路。π0.5看当前图像、14维本体和任务指令,生成一条50步、每步14维的关节空间候选。Astra拿到同一份观察、执行历史,以及这条候选对应的双臂正运动学轨迹,然后二选一。
沿用候选的前1到15步,或自己出1到5步末端位姿修正。走完这一段,再看新画面。两条分支不同时执行。Direct不启动π0.5,Astra直接出双臂末端目标和夹爪,每次1到5步。
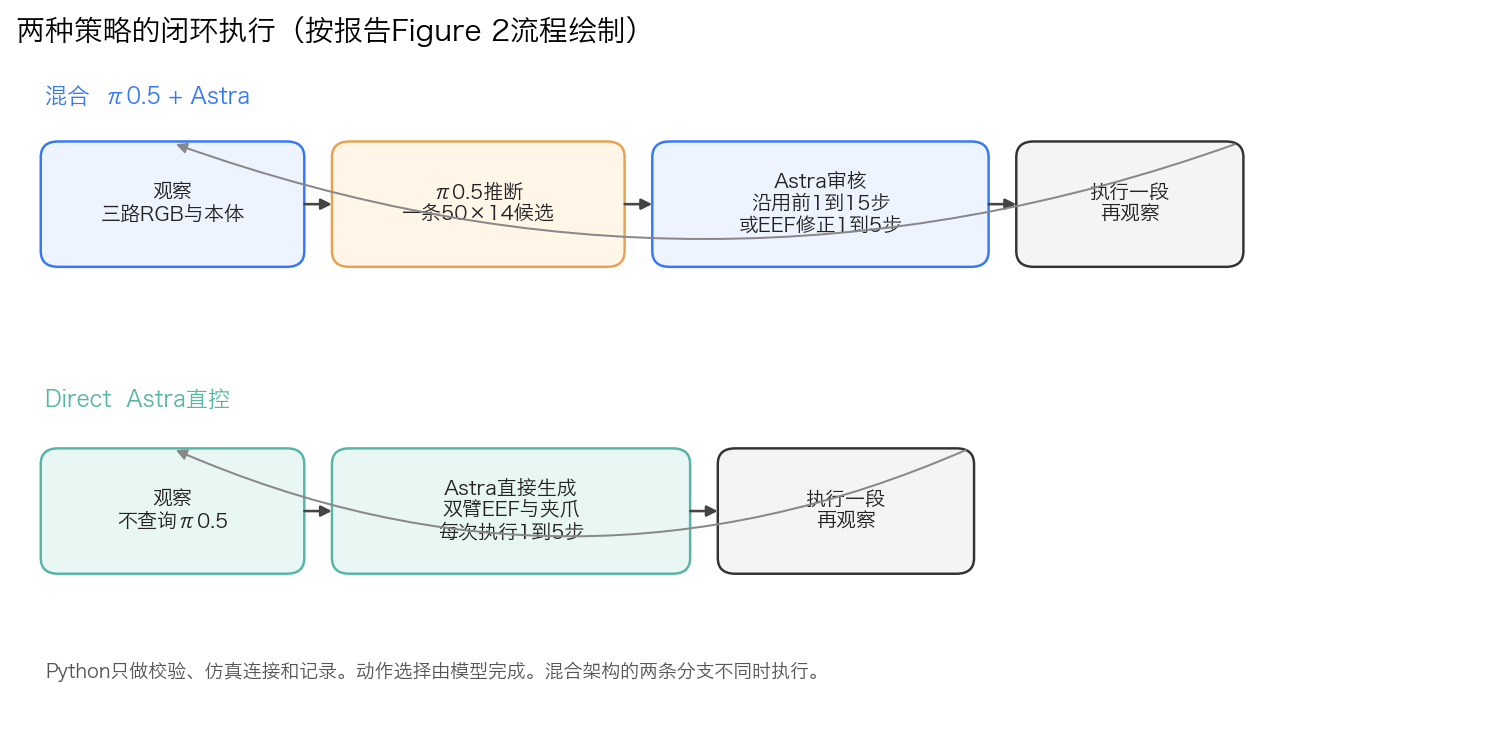
圈里有人把这套做法叫成Top-K候选再让大模型挑。报告里的实现更窄。π0.5每次只吐一条50步轨迹,并不是K条独立采样。Astra决定的是用不用这段前缀,以及要不要改写成末端指令。
末端位移保护5cm,姿态0.35rad。π0.5用的是RoboDojo放出的任务微调权重。Python只做校验、仿真连接和记录,动作选择由模型完成。
二、RoboDojo十任务评测协议
十个任务按π0.5官方成功率从0%到72%切成四段,从低到高分别取6、2、1、1个,一共十个。选型偏向仍有改进空间的任务,覆盖语义分类、顺序记忆、装箱、搭建和柔性物体,不以高精度插接为主。
每个任务跑5次,两种策略在任务、场景以及eval、layout、reset、initial、policy seed上逐条对应。数字摆放、装箱、折衣带泛化场景,用2次标准加3次随机。其余任务用5个标准布局。
成功率看最终是否成功,Score看部分完成,都用RoboDojo原生判定。仿真器确认终止才算终局,多数任务还要求机械臂归位。官方模型成绩按相同任务子集和标准/随机配比重新汇总,并不是同一组seed的重跑。
配套数据集写明,Direct有两条轨迹因仿真器RPC空闲超时被判为评测失败。开源控制器把这条规则写成900秒空闲、不重试、native_score保持空值,不拿零去填,但仍计入成功率分母。两条分别落在按语言分类和装箱。
所以Direct的平均Score按48条有原生分的轨迹计算,是37.81。成功率仍按50条算,是26%。混合架构50条都有原生分。缺分就写缺,这个处理比把超时当零分干净。
三、混合架构RoboDojo均分62.60
先把报告Figure 3用到的关键数字放在一张表里。官方模型是同子集重新加权,不是这次实验的同seed对照。修正步比例和token只对本次实测两条策略有记录。
| 策略 | 来源 | 平均Score | 成功率 | Score条数 | 修正步比例 | 记录token |
|---|---|---|---|---|---|---|
| π0.5 + GPT 6 Astra | 本次实测 | 62.60 | 48% | 50 | 14.4% | 约624.8M |
| GalaxeaVLA (G0.5) | 官网重新加权 | 38.26 | 30.95% | 未报告 | 未报告 | 未报告 |
| GPT 6 Astra Direct | 本次实测 | 37.81 | 26% | 48 | 0(不跑π0.5) | 约1.13B |
| Xiaomi-Robotics-1 | 官网重新加权 | 33.97 | 25.51% | 未报告 | 未报告 | 未报告 |
| OpenWAM-α | 官网重新加权 | 32.73 | 23.07% | 未报告 | 未报告 | 未报告 |
| DM0.5 | 官网重新加权 | 31.82 | 22.04% | 未报告 | 未报告 | 未报告 |
| π0.5 | 官网重新加权 | 24.43 | 15.67% | 未报告 | 未报告 | 未报告 |
混合策略50次里成功24次,Direct成功13次,成功率48%对26%,差22个百分点。π0.5在同一子集上的公开参照是15.67%成功率和24.43分。报告自己写,这十个任务按π0.5成功率分层,偏向低成功率,结果只刻画这个子集。
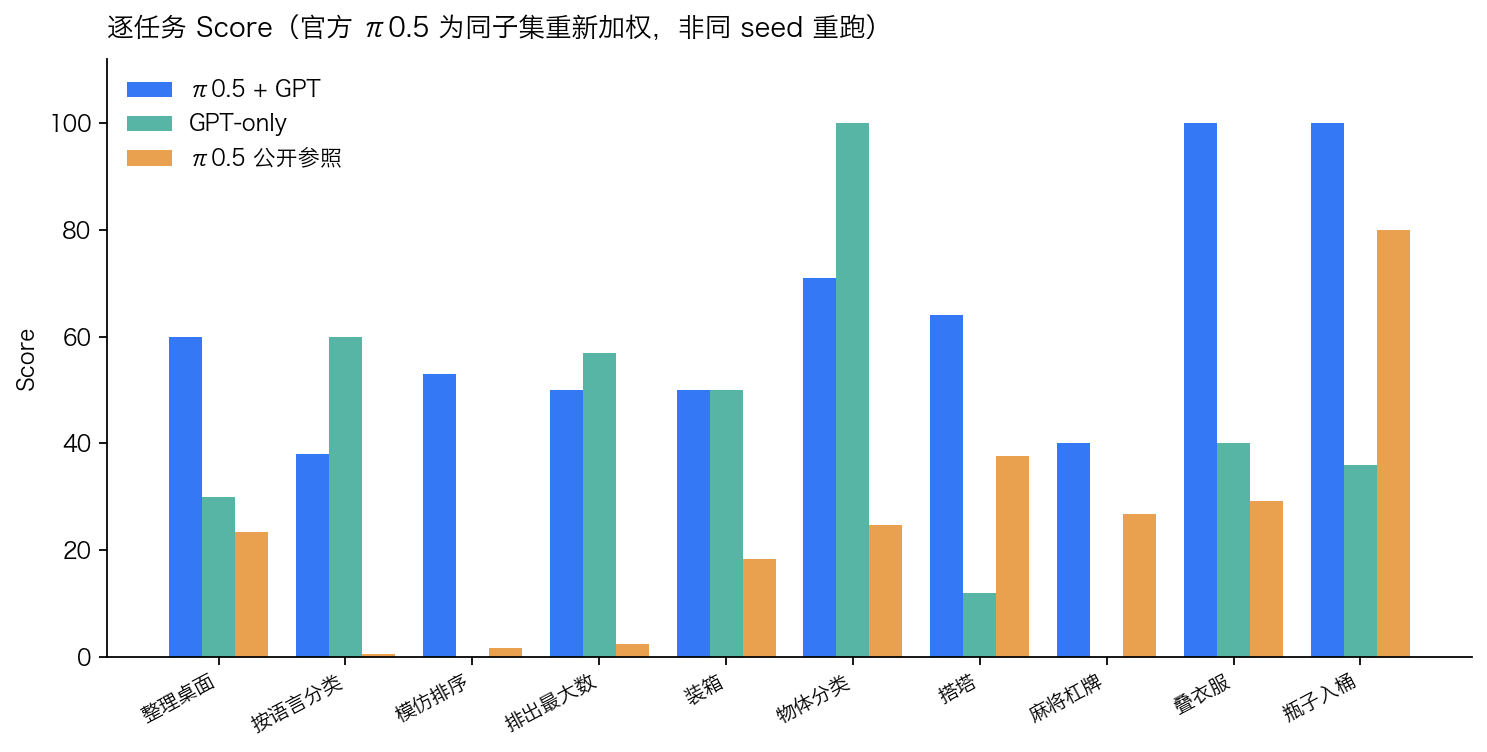
拆开看更清楚。物体分类上Direct拿到100分、5次全成。按语言分类Direct平均60、成功率40%,还高于混合的38分和20%。语义识别这条,通用模型自己下场已经很强。
接触密集的任务反过来。搭塔Direct平均12、成功率0,混合到64分、成功率60%。麻将杠牌Direct是0,混合到40。叠衣服Direct 40到混合100,瓶子入桶Direct 36到混合100。
整理桌面两边成功率都是0,Score则是混合60、Direct 30,说明部分完成有分,任务仍没做完。模仿排序Direct是0,混合53分、成功率40%。
四、Astra仅改写14.4%控制步
50条混合轨迹一共执行42,750 个控制步。其中36,576步沿用π0.5,占85.6%。Astra实际改写6,174步,占14.4%。模型在决策点持续审核候选,真替换下去的动作只是一小截。
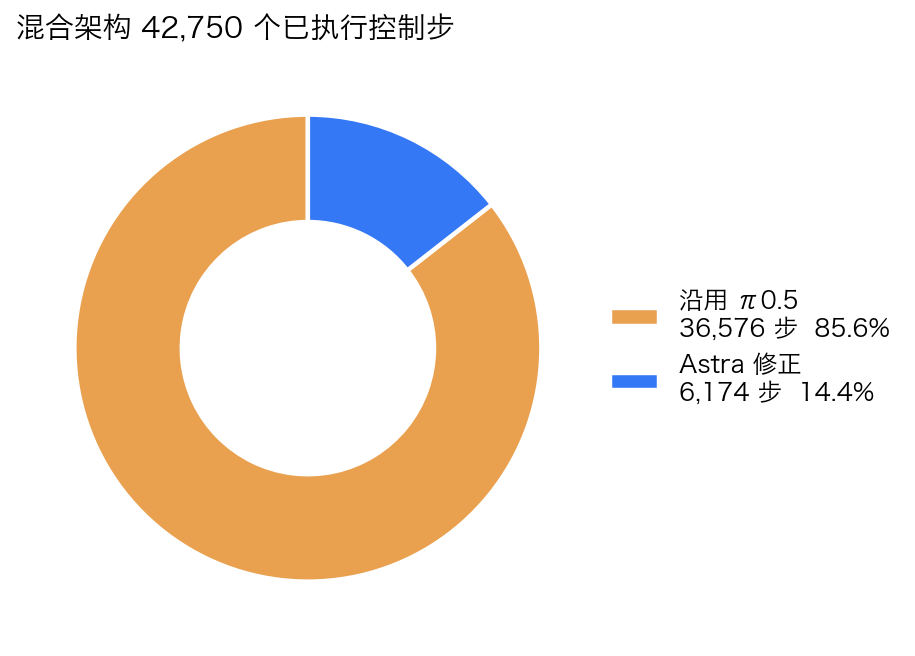
报告把这截修正归成三类。一类改grounding,目标物体、摆放位置、操作方向选错了,按指令和画面把动作拧回来。一类做非抓取接触,先拨、先推、先换接近方向,再交给π0.5继续抓。
剩下那种情况是模型发现仿真器还没终止,猜漏了物体、姿态不对或结构没达标,再去验证。
接触仍然会翻车。反复抓取失败、碰到容器边缘、任务进度已经丢了却没及时认出来,都会把原生步数预算耗光。
模型只在动作段边界收观察,段内滑落要等到下一段才能看见。报告把反馈粒度写成结构性限制,不是某一条轨迹的偶然。
选定轨迹累计记录的token,混合约624.8M,Direct约1.13B,混合少约44.8%。Direct的动作段数量大约是混合的2.05倍,要更频繁地自己构造和检查低层动作。
token含缓存输入,只统计入选轨迹,不含此前重试,也不是账单金额。
物理时长按控制步数乘0.04秒,不含模型等待。Direct平均物理时长更短,提前失败也会截短轨迹,报告明确说不能据此判断端到端效率。
五、Direct末端控制与RoboLab评测
没有π0.5的候选当参考时,Astra会从任务语义出发自己编方案。报告给过一个瓶子入桶的例子,Direct尝试用手臂把瓶子扫进桶,这条最终失败。
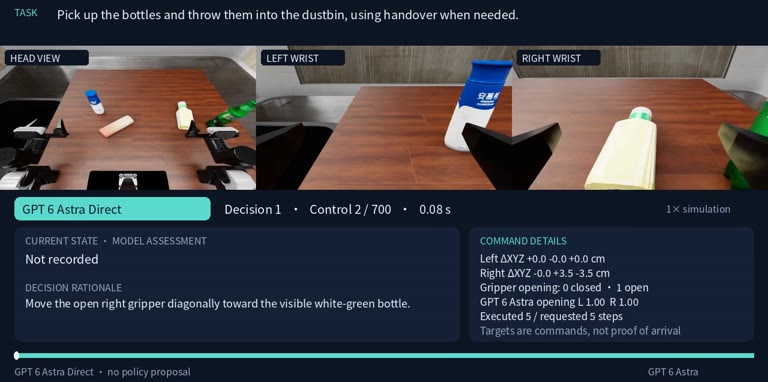
同类尝试还包括单手抓搭塔板、用单臂做更适合双臂的整理。方案有新意,执行不稳定。提出一种可能有效的操作,和把抓取姿态、支撑、释放时机做稳,是两件不同的事。
两边都接收本体状态。Direct的困难在于把关节限位、姿态和接触关系写成够得到的末端目标,于是重复尝试、控制失效。
数字摆放里也有一次恢复,运动受阻后模型根据控制反馈改动作再继续。报告把它写成对控制约束的局部适应,不是状态输入缺失。
RoboLab是另一组单臂Franka任务,十个任务、每方法5次。报告选的多为带语义要求的抓放。这里的排序和RoboDojo相反。
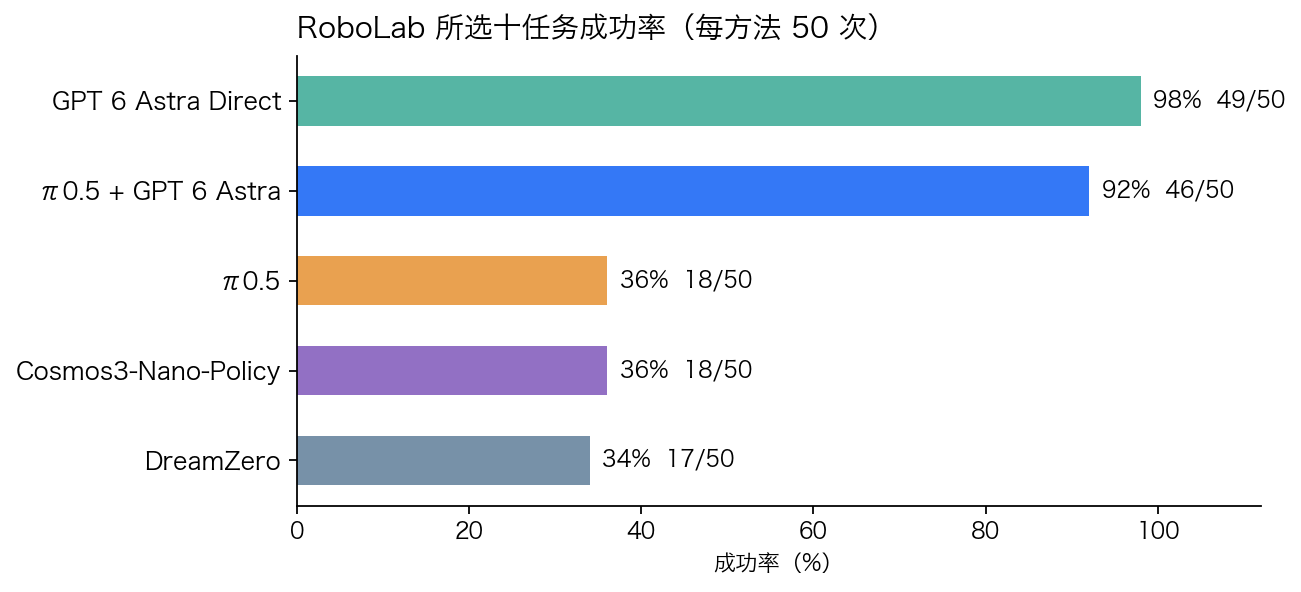
Direct成功49/50,成功率98%,9个任务5/5。混合46/50,成功率92%。π0.5与Cosmos3-Nano-Policy都是18/50,DreamZero是17/50。
RoboDojo用的是任务微调后的π0.5。RoboLab测试任务没有训练数据,三个基线都是DROID权重零样本。π0.5单独只有36%时,它的候选可能变成要改的包袱。
报告还写明,RoboLab只是另选10个任务的最终评测槽位,不是全榜复现。历史基线与Astra没有保证完全相同的初始状态和控制配置,部分Astra实验含授权重试。
98%适合看作这组语义抓放上的能力上限,不宜直接当成同条件榜首。除这一节外,token和时长都来自RoboDojo。
六、轨迹数据集读取实践
下面是配套数据集卡给的读取示例。Python 3.10以上,NumPy和Pillow就能读,不需要GPU和仿真器。
bash
pip install -r requirements.txt
python
from huggingface_hub import snapshot_download
from reader import Dataset

root = snapshot_download(
    repo_id="YuMoool/astra-robodojo-rollouts",
    repo_type="dataset",
    local_dir="./astra-robodojo-rollouts",
    allow_patterns=["*.json", "*.jsonl", "*.md", "*.py", "requirements.txt", "LICENSE",
                    "episodes/*/fold_clothes/*.core.zip"],
)

dataset = Dataset("/path/to/download")
record = dataset.select(method="hybrid", task="fold_clothes")[0]
with dataset.open(record["episode_id"], verify=True) as episode:
    print(episode.metadata["case"], episode.metadata["outcome"])
    for decision in episode.decisions:
        obs = decision.observation(images="preview")
        proposal = decision.pi05_proposal  # raw_actions/actions, each (50,14); None for direct
reason = decision.requested_response.get("reason")数据集是评测记录,不是训练集。100条入选轨迹,十任务、每任务五个固定实例、两种方法。不含丢弃的重试、早期试跑、RoboLab,也不含单独跑的π0.5基线。全部记录使用gpt-6-astra和xhigh。
python validate.py /path/to/download --require100会重算报告里的成功次数和Score。数据集卡写的是混合24/50、Direct 13/50,Score为62.60对37.8125。完整观测包体积很大,只读决策预览即可核对结构。
七、总结与思考
这篇文章最值得看的是那道闸。熟练的物体交互先验负责连续动作,通用模型只在目标、几何或进度跑偏时改写。14.4%的修正步换来成功率接近翻倍。改写落在关键节点,大模型并不包办每一步。
对照并不干净。动作先验、动作接口、执行段长度同时变了,报告自己承认还没拆开各自贡献。十任务五次,统计精度有限。精选视频只说明行为机制,不能拿来估计失败类型的比例。
延迟仍是报告写明的未解问题。仿真允许停下来想,真实物理过程没有暂停。Direct在RoboLab语义抓放上接近全成,又提醒另一件事。学生策略若对不上任务,先提案再修正,未必比通用模型直接出末端指令更强。
参考链接
- 评测报告页 GPT 6 Astra as an Embodied Policy,2026年9月
- 评测代码 anonymous-report-421/eval-of-gpt-6-astra-as-policy
- 配套轨迹数据集 YuMoool/astra-robodojo-rollouts
- 基准 RoboDojo,2026年7月;官网 robodojo-benchmark.com
- 对比方案 π0.5;补充基准 RoboLab,2026年4月
- 模型文档 gpt-6-astra