(1)《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
(2)AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群 ,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)!
论文标题:Addressing the Orchestration Gap in Generalist Robots via Physical Agency
论文作者:普林斯顿大学与Together AI(一作Liane Galanti)
发表时间:2026年7月23日
目录
本文要点
(1)Pigey是普林斯顿大学和Together AI在2026年7月挂上arXiv的推理时编排器,9月13日作者X长帖后才在社区传开,不训练任何机器人权重。
(2)真机30项任务把冻结π0.5从16.7%拉到97.3% ,LIBERO-PRO从12.8%到53.3% 。
(3)前沿视觉语言模型跑观察、推理、执行、验证、恢复,调度冻结的TAMP和π0.5,新增代码主要是agent.ts加一份系统提示词。
(4)短板是每步要打API,真机一次大约2到6分钟,验证器会误报成功,后端技能够不着的动作编排也救不回来。
(5)文末附仓库README的真机与仿真启动示例。
普林斯顿大学和Together AI的Liane Galanti、Dhruv Shah、Tri Dao,在2026年7月23日把这篇报告挂上了arXiv,编号2607.21725。系统名叫Pigey,全称Physical Agency。
论文在那儿躺了将近两个月。9月13日,一作Galanti发了一条X长帖,真机16.7%到97.3%、仿真12.8%到53.3%这两串数字才开始在社区转。仓库到今天是76个star。
今天是2026年9月16日。我把HTML版从头对了一遍,也对照了GitHub README。中文技术博客里,像样的拆读我还没搜到。
不训练任何权重。前沿视觉语言模型当编排器,调度已经冻住的任务与运动规划(TAMP)和π0.5技能。真机30项任务,直接把指令扔给π0.5只有16.7%,过一遍编排循环到了97.3%。LIBERO-PRO上从12.8%到53.3%,大约4倍。
一、冻结技能上的编排差距对照
家用机器人要同时处理感知、常识、规划、判断成没成功、失败了怎么补、底层怎么动。现在主流做法是把这一摞压进一个视觉语言动作模型(VLA),靠大规模演示预训练,一次前向走完全程。
π0.5是这条线上的代表。接触、抓取、和本体绑在一起的控制,确实得从交互里学。报告把这一点写得很清楚。
指令一旦带上否定、条件、藏起来的物体、中途被人挪走,直接提示常常会垮。同一张桌子,问素食、问危险品、问除了杯子以外的东西,冻结策略做出来的动作几乎一样。引言里专门记了这件事。
他们做了一个很干净的对照。机器人、相机、场景、演示、策略权重全部钉死,只改推理时怎么调用这些技能。完整指令直接交给运动策略,叫直接提示。同一套冻结技能交给Pigey逐步调用。两边成功率的差,他们命名为编排差距。
二、agent.ts调度TAMP与π0.5
仓库README把新增部分说得很小。真机目录里,新颖的编排器就是agent.ts加系统提示词agent-system.md。TAMP服务、DROID服务、π0.5策略服务都是现成的,编排器每一步只挑一个工具。
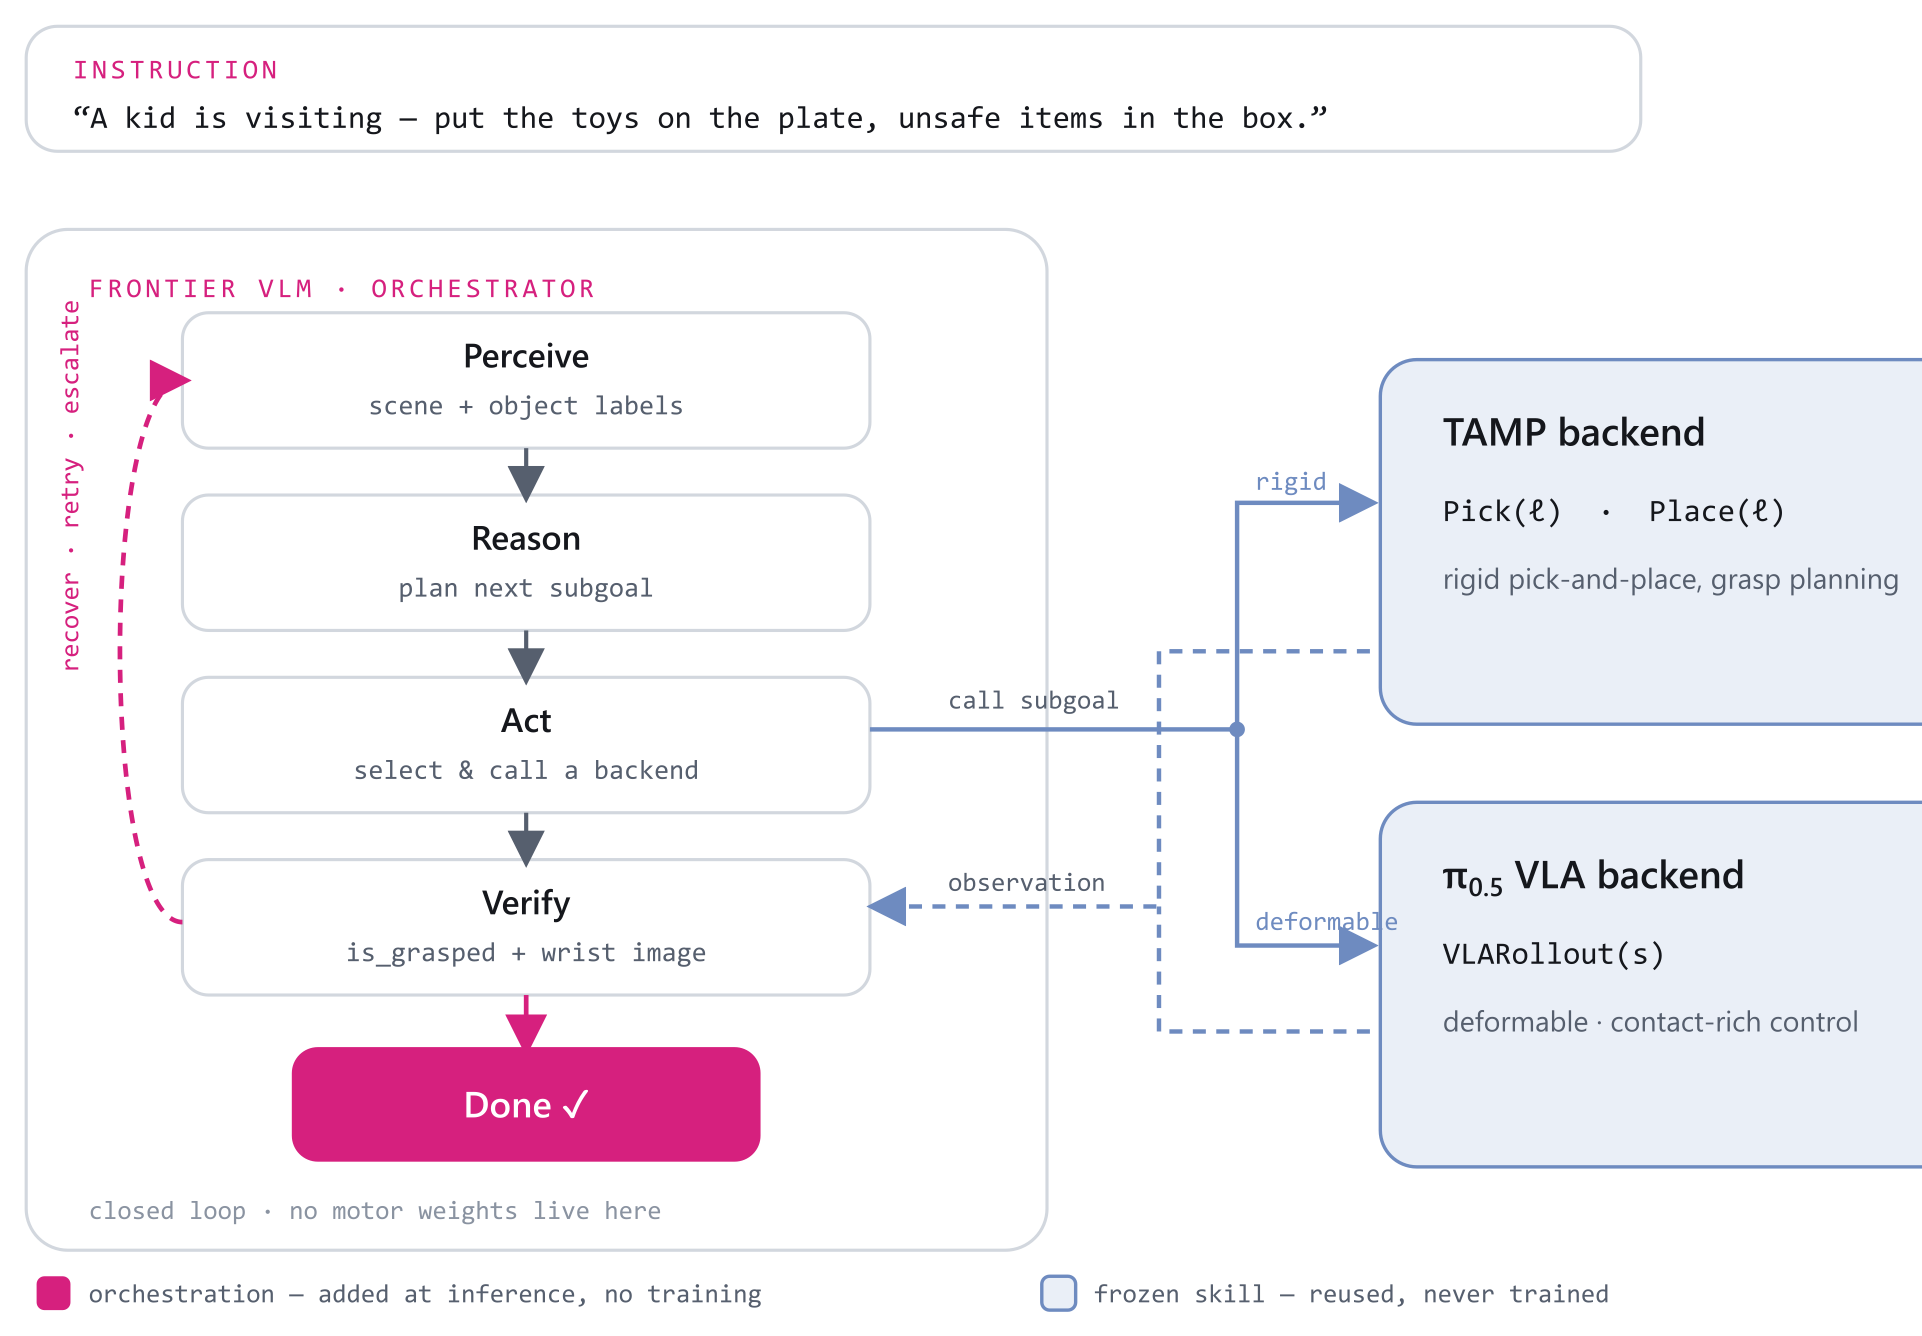
编排器自己不吐电机指令。真机侧工具就五个。
Perceive返回相机画面、机器人状态和检测到的物体标签。Pick和DropAbove走TAMP,管刚性物体的抓和放。VLARollout把短指令交给冻结的π0.5,管可变形、接触多、规划失败时的补救。Done结束任务。
TAMP这边他们用的是TiPToP。TiPToP把抓和放做成一次开环规划,规划完就看不见执行,爪子滑了也会继续去放。Pigey把抓和放拆成两个工具,中间插入验证,抓没抓住就不准放。报告写,真机上相对TiPToP的优势,有一块直接来自这个拆法。
π0.5接到的永远是短指令,比如把红杯子放到盘子上。用户那句抽象原话到不了运动层。
物体名字也卡得很死。每个Pick和DropAbove的参数必须是最近一次Perceive返回的标签,不能自己发明一个目标名。附录说,把任务里的自由文本直接喂给开放词汇检测器,模型经常把眼前最显眼的东西改标成目标。
三、抓放拆分与验证恢复循环
验证用两路信号。一路是确定的,Pick必须让夹爪宽度传感器给出is_grasped,规划失败会以标志位返回。另一路是视觉,动作之后的腕部图交给编排器,确认目标物在爪里、桌上没了。
两路取保守。后端报成功、传感器说空爪,这一步改判失败。没验证过的抓,不能进入放置。
失败了怎么办,系统提示词里写着一套升级规则。没验证住的Pick重试一次,重试时重新感知,按物体当前位姿再规划。第二次仍失败,交给VLARollout。
反过来也成立,VLA走了没进展,可以退回TAMP。刚性、放在桌上的走TAMP。线缆、布、已经在容器里或叠在别的物体上的,直接走VLA。
抓之前重新看一眼。一次规划用到底,物体挪了就抓空。目标被挡住了,先挪开挡着的东西再看。
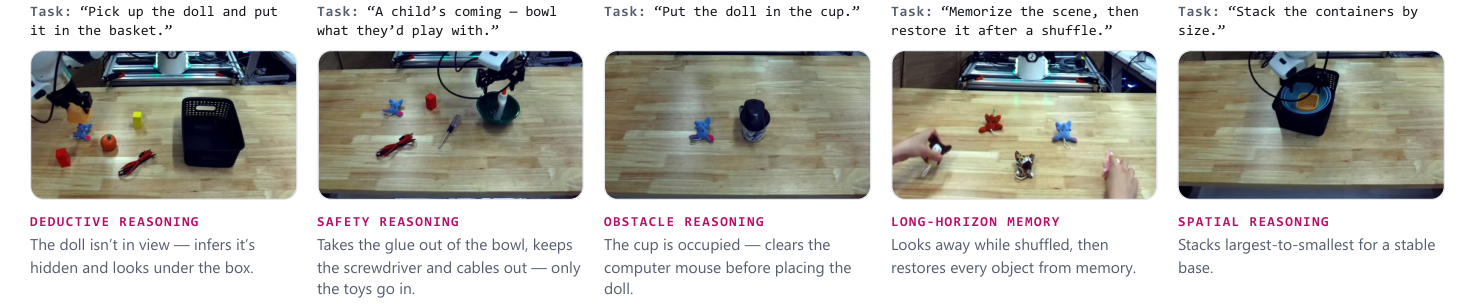
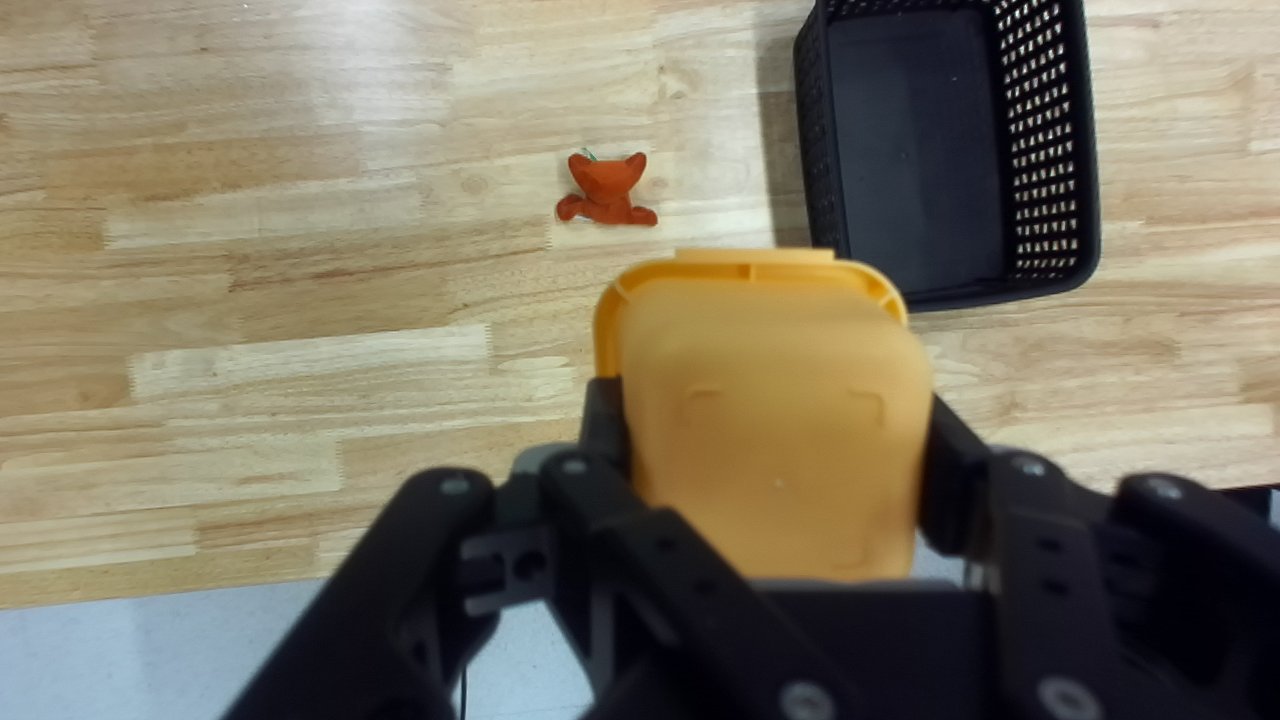
引言里那条玩偶任务最能说明问题。指令是把玩偶放进篮子。桌上只看见一个盒子。编排器推断玩偶可能在下面,先把盒子挪开,再感知,找到玩偶,这才去抓。
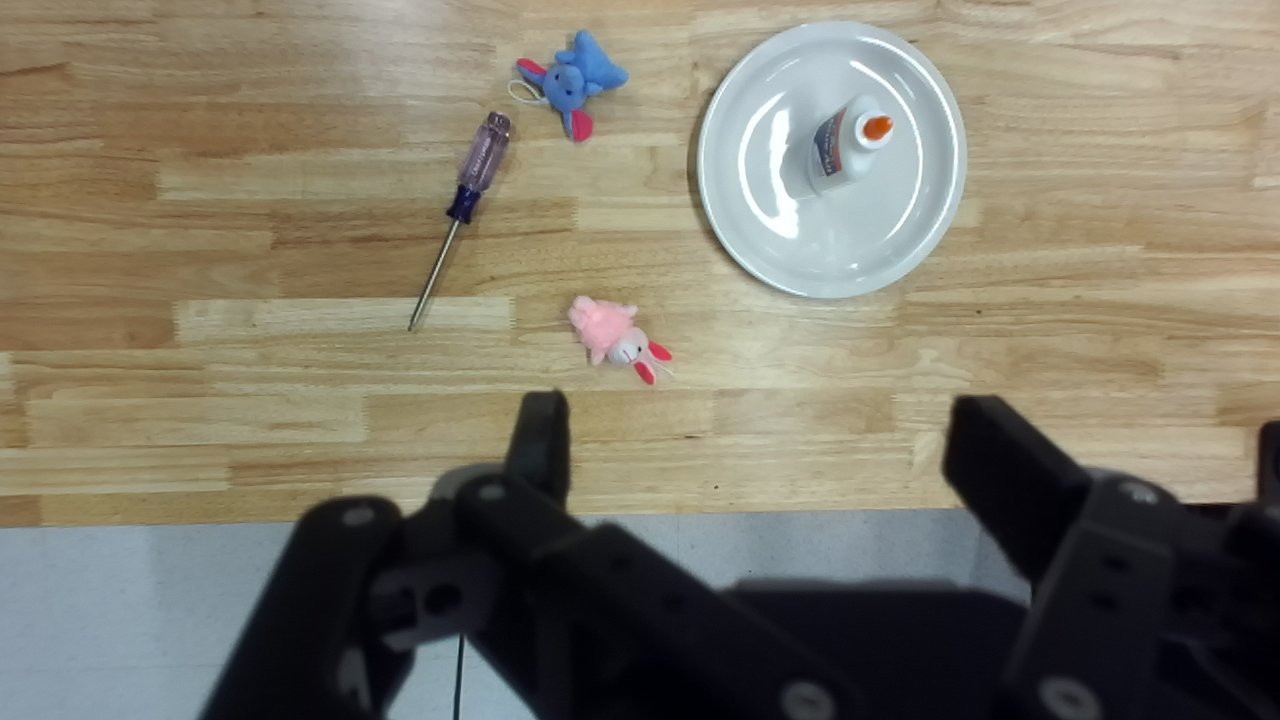
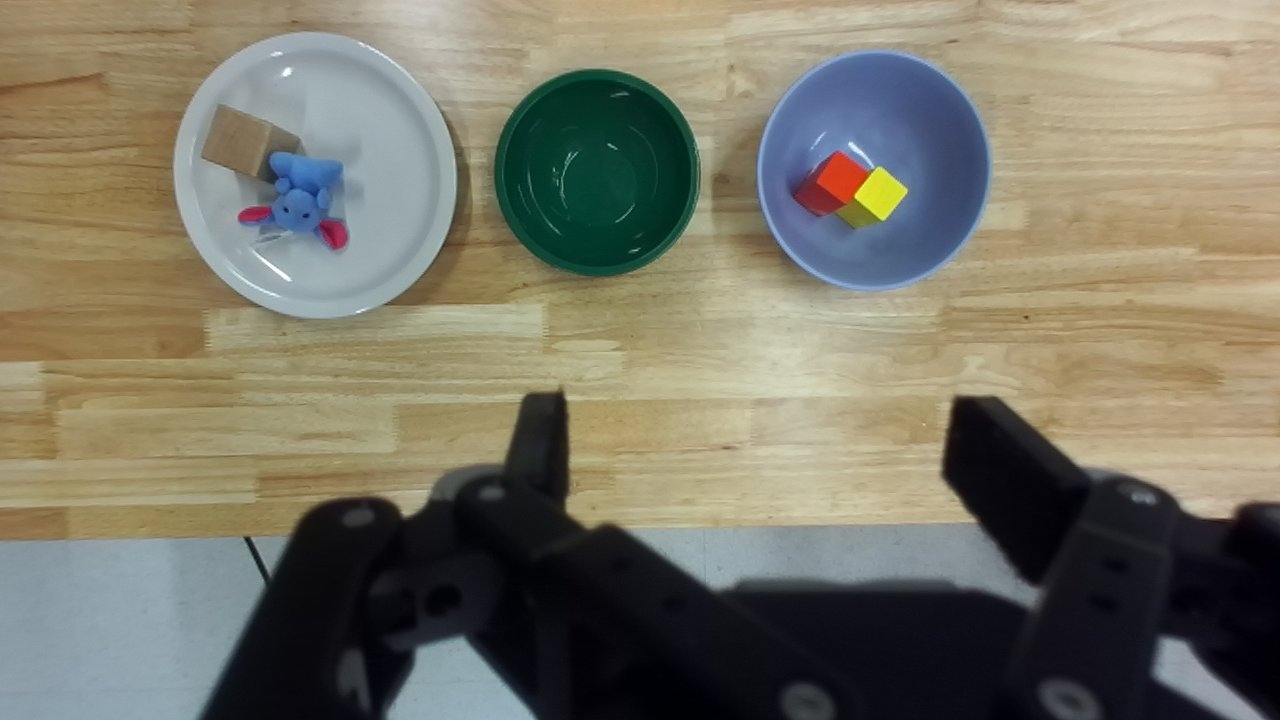
孩子要来、只准把玩具放进容器,这类指令考的是常识。腕部图里盘子上已经坐着胶水,旁边还有螺丝刀。编排器先把危险品清出去,再放兔子和玩偶。
杯子被占住也走同一套循环。指令是把玩偶放进杯子,杯子里先躺着一只鼠标。它把鼠标拿出来放到桌上,再放玩偶。
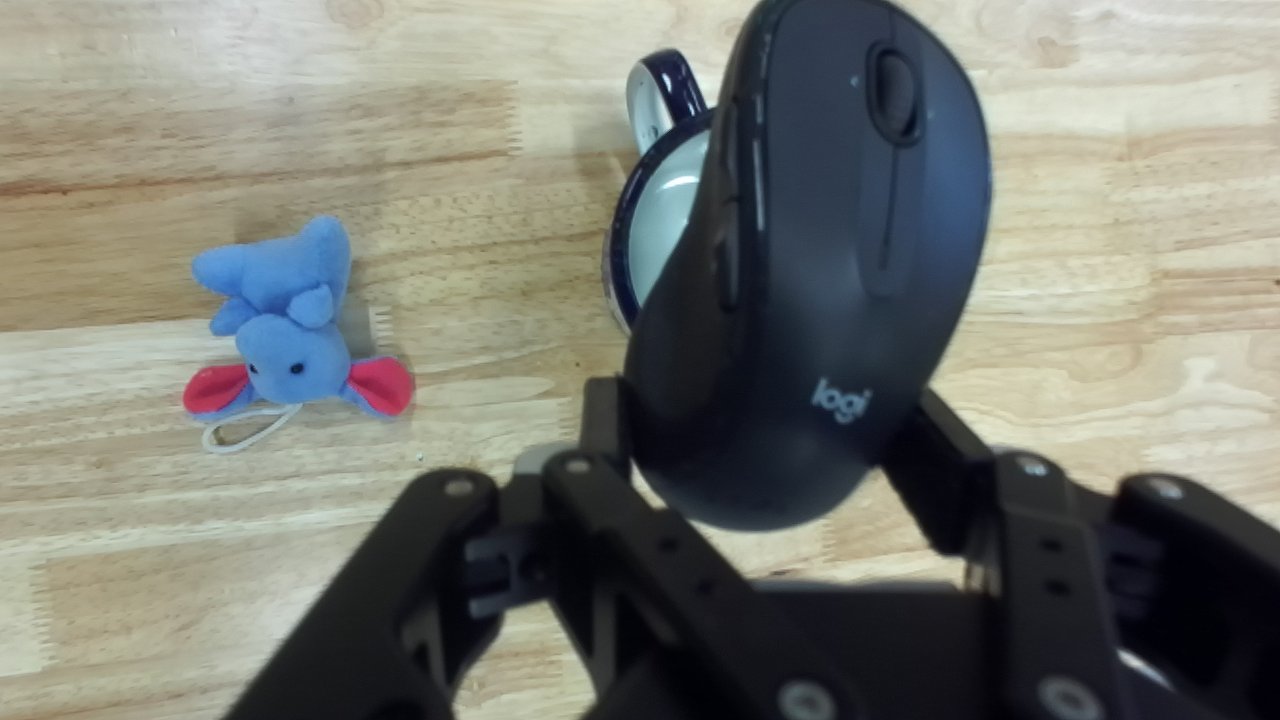
中途世界变了,开环规划没有退路。空盘子任务做到一半,盘子上忽然多了东西。编排器重新看条件,改把玩偶放进还空着的绿碗。
四、真机30项成功率从16.7%到97.3%
先把能对上的数字放在一张表里。真机reasoner是Claude Opus 4.7,30项各5次,共150次。仿真每个reasoner每项10次。缺的格子按报告原文写未报告,不补。
| 方法 | 额外训练 | LIBERO-PRO均值 | 真机30项总体 | 推理受限 | 简单抓放 |
|---|---|---|---|---|---|
| π0-LIBERO | 无(本实验冻结) | 0 | 未报告 | 未报告 | 未报告 |
| π0.5直接提示 | 无 | 12.8 | 16.7 | 4.6 | 95 |
| CaP-Agent0 | 无 | 18.2 | 未报告 | 未报告 | 未报告 |
| TiPToP开环 | 无 | 未报告 | 48.7 | 未报告 | 80 |
| Pigey | 无 | 53.3 | 97.3 | 96.9 | 100 |
推理受限那一列,报告单独算过。去掉已经很容易的4项抓放,剩下世界知识、条件、多步、空间、障碍、恢复、长时记忆,π0.5只有4.6% ,Pigey到96.9%。简单抓放本来就高,95%到100%,编排没有把已经会的事做坏。
TiPToP总体48.7%。简单抓放它只有80%,低于直接用π0.5,开环抓滑了没退路。多步推理25%,障碍、恢复、长时记忆三类上它是0。
150次里的第一次不可恢复错误,报告记在表14。π0.5失败125次,86次抓错对象。TiPToP失败77次,65次栽在推理和规划。Pigey只失败4次,2次抓取执行,2次验证器误报成功。误报成功是这套验证器独有的失败模式,遮挡会把一次坏抓藏过去。
LIBERO-PRO六个扰动套件。π0全0。π0.5均值12.8%。代码即策略那条线的CaP-Agent0是18.2%。Pigey用同一份π0.5-LIBERO权重到53.3%。Goal-task仍只有22%。报告自己写,LIBERO-PRO不太考推理,这块提升更多来自失败恢复和给它的工具。
附录扫了九组reasoner配置,均值从GPT-5.5 low的44.3%到Claude Opus 4.7的53.3%,全都明显高于两个无编排基线。循环结构决定增益的方向,模型只决定幅度。引言里写过,效应在七个不同reasoner上成立,表15把GPT-5.5的三档推理强度也分开报了。
五、本地部署与推理实践
以下两段是仓库README里的启动示例,来源见文末。
真机侧先起三套服务,TAMP包着TiPToP,DROID管相机和机器人状态,openpi端着pi05_droid检查点。编排器在另一台机器上跑。
bash
curl -fsSL https://bun.sh/install | bash

export ANTHROPIC_API_KEY=...
export TAMP_URL=http://<workstation>:7777
export DROID_HOST=<workstation>
export PI0_URL=ws://<workstation>:8000
bun agent.ts "pick up the cup and put it in the basket"可选环境变量有AGENT_MAX_STEPS、AGENT_FAIL_LIMIT、AGENT_LLM_TIMEOUT_MS、AGENT_SYSTEM。步数上限和失败次数是循环的硬预算,提示词路径可以换。硬件清单写的是Franka Research 3、Robotiq 2F-85、一台ZED 2i第三人称相机加一台腕部ZED-Mini。
仿真侧短命令如下。感知用Gemini Robotics ER,智能体看见的是相机图、夹爪和末端状态,外加带编号的检测框,物体真值和接触状态不暴露。
bash
export ANTHROPIC_API_KEY=...
export GEMINI_API_KEY=...

python agent_sim.py \
  --mode harness --suite libero_goal_task --task 0 --episode 2 \
  --policy-host localhost --policy-port 8000 \
  --model gemini/gemini-3.5-flash \
  --max-llm-steps 35 --max-steps-per-rollout 500 \
--out-dir results/几个参数值得对照报告。--max-llm-steps 35对应编排器的工具调用预算。--max-steps-per-rollout 500是仿真里一次VLARollout的控制步上限,真机附录默认是300步。README写模型无关,校验过Gemini 3.5 Flash、Claude Opus 4.7、Claude Sonnet 4.6、Claude Haiku 4.5、Claude Fable 5、Gemini 3.1 Pro、GPT-5-mini。
附录还写了作者自己的机器。控制用NUC跑polymetis,工作站是Ryzen 7 9800X3D加一张RTX 5090 32GB,π0.5-DROID推理大约16GB,FoundationStereo大约8GB。这是报告里的配置,不是我测的。
六、总结与思考
编排差距这个量法我觉得该留下。以后再有人说策略不会推理,先问一句,同一份冻结权重,过一遍编排循环能救回多少。报告给的顺序很具体,先量这个差,再决定要不要花机器人数据去教策略推理。
和端到端VLA怎么选,我现在的判断是分场合。端到端把感知到电机压进一次前向,延迟低,适合已经会、要快的动作。Pigey把任务层判断交给API上的前沿模型,换来可检查的工具轨迹,也换来每步等待。附录写,真机一次编排试验大约2到6分钟,API费用大约0.02到0.50美元。低延迟、高速场合,他们自己也说吃力。
技能天花板是硬的。编排器再聪明,后端抓不住的东西抓不住。验证也不完美,遮挡会藏住一次坏抓,假成功会往下游传,150次里已经出现2次。
仿真53.3%也没把LIBERO-PRO打穿,Goal-task 22%说明扰动后的目标改写,循环只能补到这里。评测全是桌面操作,Franka加平行夹爪,别的本体和场景报告没给。障碍推理里玩偶被围住那一项,Pigey也只做成3/5。
代码薄这件事,我两头看。一头是真的薄,agent.ts加一份提示词,把已有技能用出仿真大约4倍、真机总体从16.7%到97.3%。
另一头是能力主要住在Claude Opus 4.7这类模型和已经训好的π0.5、TiPToP里,这个仓库是胶水。能对上报告数字的人,得先有Franka、三套服务和一叠API账单。
他们提到,成功轨迹也许能蒸馏回更小的编排器。那是设想,还没做。
参考链接
- 技术报告原文 arXiv 2607.21725 v1,2026年7月
- 项目页 Pigey
- 代码与README示例 lianegalanti/Pigey,本稿核对为76 star
- 作者X长帖(2026年9月13日)Liane Galanti
- 冻结技能 π0.5(arXiv 2504.16054)、TiPToP
- 仿真基准 LIBERO-PRO
- 对照方案 CaP-X / CaP-Agent0