系列文章目录
文章目录
- 系列文章目录
- 前言
- 一、介绍
-
- [1.1 相关概念](#1.1 相关概念)
-
- [1.1.1 算子](#1.1.1 算子)
- [1.1.2 Tile](#1.1.2 Tile)
- [1.2 Triton](#1.2 Triton)
- [1.3 TileLang](#1.3 TileLang)
- [1.4 九齿 NineToothed](#1.4 九齿 NineToothed)
- 二、任务打卡
-
- [2.1 任务一](#2.1 任务一)
- [2.2 任务二](#2.2 任务二)
- 总结
前言
一、介绍
- 随着人工智能(Artificial Intelligence,AI)技术的迅猛发展,深度学习模型的复杂度和规模正呈指数级增长,这给底层计算效率带来了前所未有的挑战。
1.1 相关概念
1.1.1 算子
-
算子 operator 是构成深度学习模型的基本计算单元,其性能直接决定了整个模型的训练和推理效率 。
-
相关概念:函数、泛函、算子、函子
数学抽象的主线是:
从处理单个点,到处理整体曲线,再到变换整体,最后到不同数学体系之间做结构翻译。
函数、泛函、算子、函子,就是这四次视角升级。
- 函数:数 → 数,处理单个元素。
- 泛函:函数 → 数,处理整条曲线并给出一个总评。
- 算子:函数 → 函数,把一条曲线变成另一条曲线。
- 函子:范畴 → 范畴,把一个数学世界整体搬到另一个数学世界,并保持结构。
1.1.2 Tile
- "Tile" 一词在高性能计算中特指计算分块技术 ,这是优化内存层次结构访问效率的关键方法。
- 不论是 CPU 的多级缓存系统,还是 GPU 的共享内存与寄存器层次结构,合理的分块策略都是实现高性能计算的必备条件。
1.2 Triton
一门并行编程语言及其编译器。
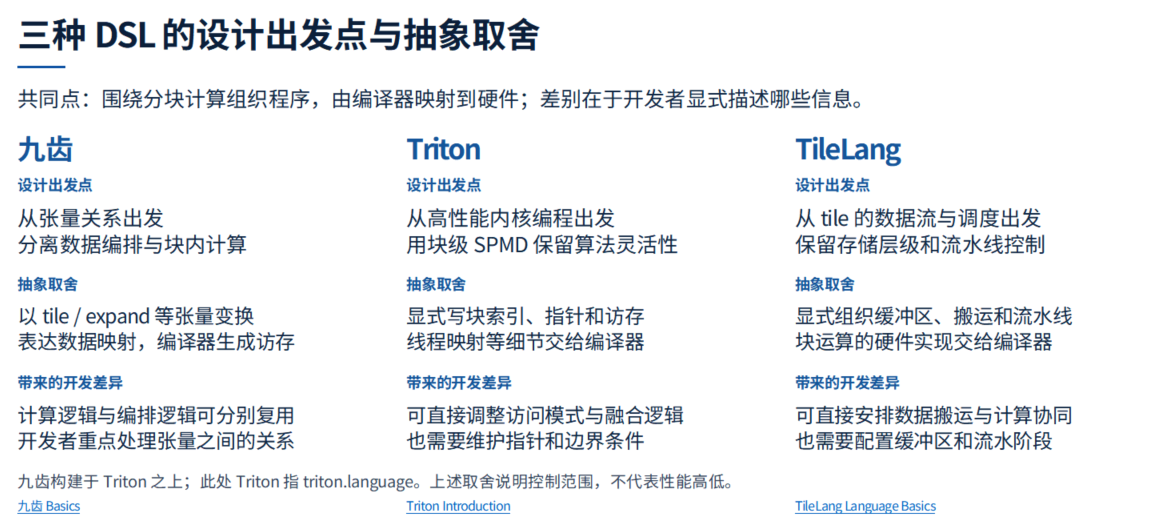
- Triton 最初由 Philippe Tillet 开发,2020 年起由 OpenAI 接管并持续演进。它是一个开源的、基于 Python 的领域特定语言(DSL)和编译器,专门用于编写 GPU 上的深度学习 kernel
- Triton的设计宗旨是提升AI模型训练过程中GPU编程的易用性与效率。
- 它允许开发者通过
Python语言编写自定义 GPU 内核,实现与专家级CUDA代码相当的性能表现,同时无需掌握底层CUDA专业知识。 - 核心设计 :基于
Tile的编程模型 Triton与CUDA的根本区别在于抽象层级:CUDA以单个线程 为编程单位,Triton以数据块 (tile/block)为编程单位。开发者用近似NumPy的Python代码描述计算逻辑,编译器自动处理线程调度、内存层级映射和硬件优化。
1.3 TileLang
TileLang(Tile Language )是一款基于张量分块(Tiling)抽象的高性能 AI 算子编程语言,属于 领域特定语言(DSL)。- 它采用声明式语法与类 Python 前端,使开发者能够以接近数学公式的形式描述计算意图,并由编译器自动完成循环优化、内存调度与代码生成。
1.4 九齿 NineToothed
- 九齿(NineToothed)是一个基于 Triton 的更高层 DSL,引入 tensor-oriented metaprogramming
二、任务打卡
2.1 任务一
- T.ceildiv(N, BLOCK_N):计算需要启动的 Block 数量,向上取整:确保即使 N 不能被 BLOCK_N 整除时,也能覆盖所有元素。
- T.Kernel(num_blocks) as pid:定义 Grid 级别的并行,pid 相当于 CUDA 中的 blockIdx.x。
- T.Parallel(BLOCK_N) as i:定义 Block 内部的线程级并行,i 相当于 CUDA 中的 threadIdx.x。
- if index < N::边界保护(Tail handling),防止在最后一个 Block 中由于 N 不是 BLOCK_N 的整数倍而导致的全局内存越界访问。
- return C:将分配并计算完成的 Tensor C 返回。
2.2 任务二
python
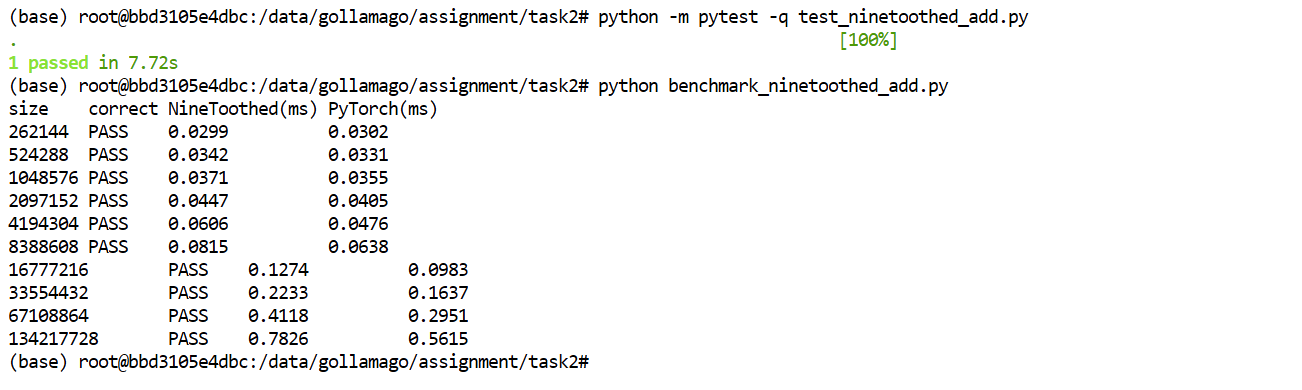
def arrangement(lhs, rhs, output):
return lhs.tile((BLOCK_SIZE,)), rhs.tile((BLOCK_SIZE,)), output.tile((BLOCK_SIZE,))- 这里的 lhs, rhs, output 是符号张量,代表完整的
1D数组。 .tile((BLOCK_SIZE,)):将一维的长数组,在逻辑上切割成一个个大小为BLOCK_SIZE的 Tile。- 因为
tile方法需要知道每个维度的切割大小。对于1D张量,必须传入包含一个元素的元组。如果是2D矩阵,就会是(BLOCK_M, BLOCK_N)。
python
def application(lhs, rhs, output):
    output = lhs + rhs
总结
- 了解Triton、TileLang、九齿 NineToothed