TP、PP、DP、EP 如何组合:八张卡,怎样淘汰不合适的配置
TL;DR
- 场景:八张 GPU 已经到位,模型在四张卡上能启动。接下来是把八张卡合成一个大副本,还是拆成两组四卡服务?只看启动日志或单请求延迟都不能结论------更快的大副本可能接不住业务高峰;吞吐更高的两个小副本又可能在其中一个副本退出后没有余量。
- 结论 :TP、PP、DP、EP 各自解决不同约束,组合时问题变成"同一批硬件要满足哪些约束,以及哪个候选最先违反约束"。容量筛掉不可能运行的方案;放置解释候选在比较什么;固定工作负载检验服务结果;故障目标决定是否有资格上线。
TP×PP×DP=8这个等式只数资源,没有表达通信路径与故障域。 - 产出 :一张 3 行候选对照表(A:TP4/PP1/DP2 节点内副本 × 2;B:TP8/PP1/DP1 跨节点 TP;C:TP4/PP2/DP1 节点间 PP)+ 一张承接率 vs 达标完成率对照(A 2×7=14,B 11,C 9,业务 12 请求/秒)+ 容量必要条件推导
(R-1)×7 ≥ 12→ 至少 3 个四卡副本 = 12 张卡 + MoE 不可直接套用 Dense 副本扣减公式 + 20 行错误速查卡。
平台版本:vLLM
docs.vllm.ai/en/stable页眉v0.28.0(并行与扩展 / 基准参数 / 专家并行分层)。资料检查日期 2026-09-08。八卡拓扑、显存预算、SLO、吞吐数字与扩容推导均为作者假设或手算,未进行 GPU 或生产环境验证。
版本矩阵
| 功能 | 状态 | 说明 |
|---|---|---|
vLLM Parallelism and Scaling(并行组关系、KV 容量与并发估计) |
✅ 已验证 | Parallelism and Scaling HTTP 200,页眉 v0.28.0 |
vLLM vllm bench serve / --max-concurrency(并发上限可能压低实际发送率) |
✅ 已验证 | vllm bench serve HTTP 200,页眉 v0.28.0 |
vLLM Expert Parallel Deployment(Layer Behavior + TP×DP + Attention 复制/切分) |
✅ 已验证 | Expert Parallel Deployment HTTP 200,页眉 v0.28.0 |
| 图1:四卡能启动,还要逐卡算预算(可测候选 46 vs 长请求 50 GiB) | ⚠️ 作者假设 | /tmp/blog-imgs16/01-dae21ef2bc033cdd9ba54a4228725aff.png,完全均分权重只是剪枝下界 |
| 图2:KV 容量估计,还不是在线延迟证明(贴 vLLM Parallelism and Scaling 原文) | ✅ 已解读 | /tmp/blog-imgs16/02-d43ca3f16965108c2c43c649376500d7.png,页眉 v0.28.0,2026-09-08 核验 |
| 图3:同样八张卡,三种执行边界(A 节点内副本 × 2 / B 层内通信跨节点 / C 阶段边界跨节点) | ⚠️ 路径示意 | /tmp/blog-imgs16/03-9eb754b9aa864d8e9c8e342ede858ba1.png,只说明路径不预判性能 |
| 图4:承接率与达标完成率,要分开记录(A 2×7=14,B 11,C 9,业务 12 请求/秒) | ⚠️ 作者假设 | /tmp/blog-imgs16/04-e9cee3244abfc4a40b086027fa7ff73c.png,作者设定非实测 |
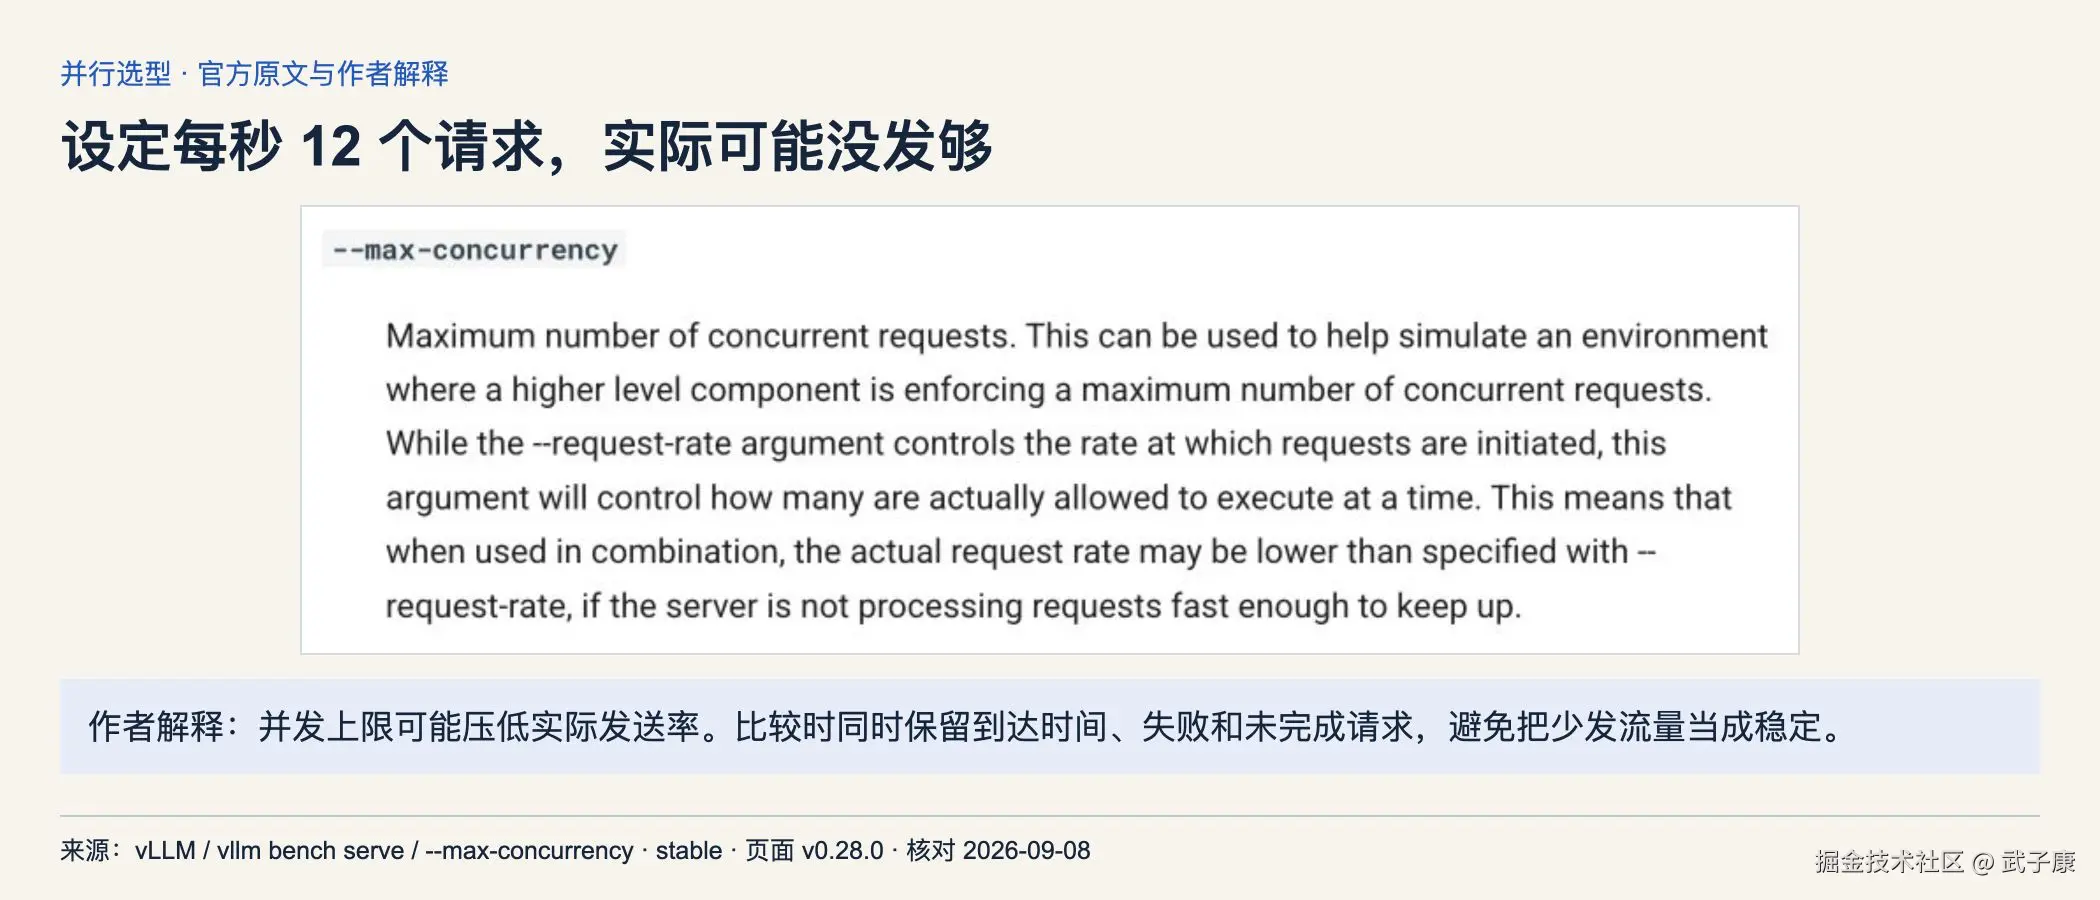
图5:设定每秒 12 个请求,实际可能没发够(贴 vllm bench serve --max-concurrency 原文) |
✅ 已解读 | /tmp/blog-imgs16/05-f550369d32db519f14cf1a83cc018ca7.png,页眉 v0.28.0,2026-09-08 核验 |
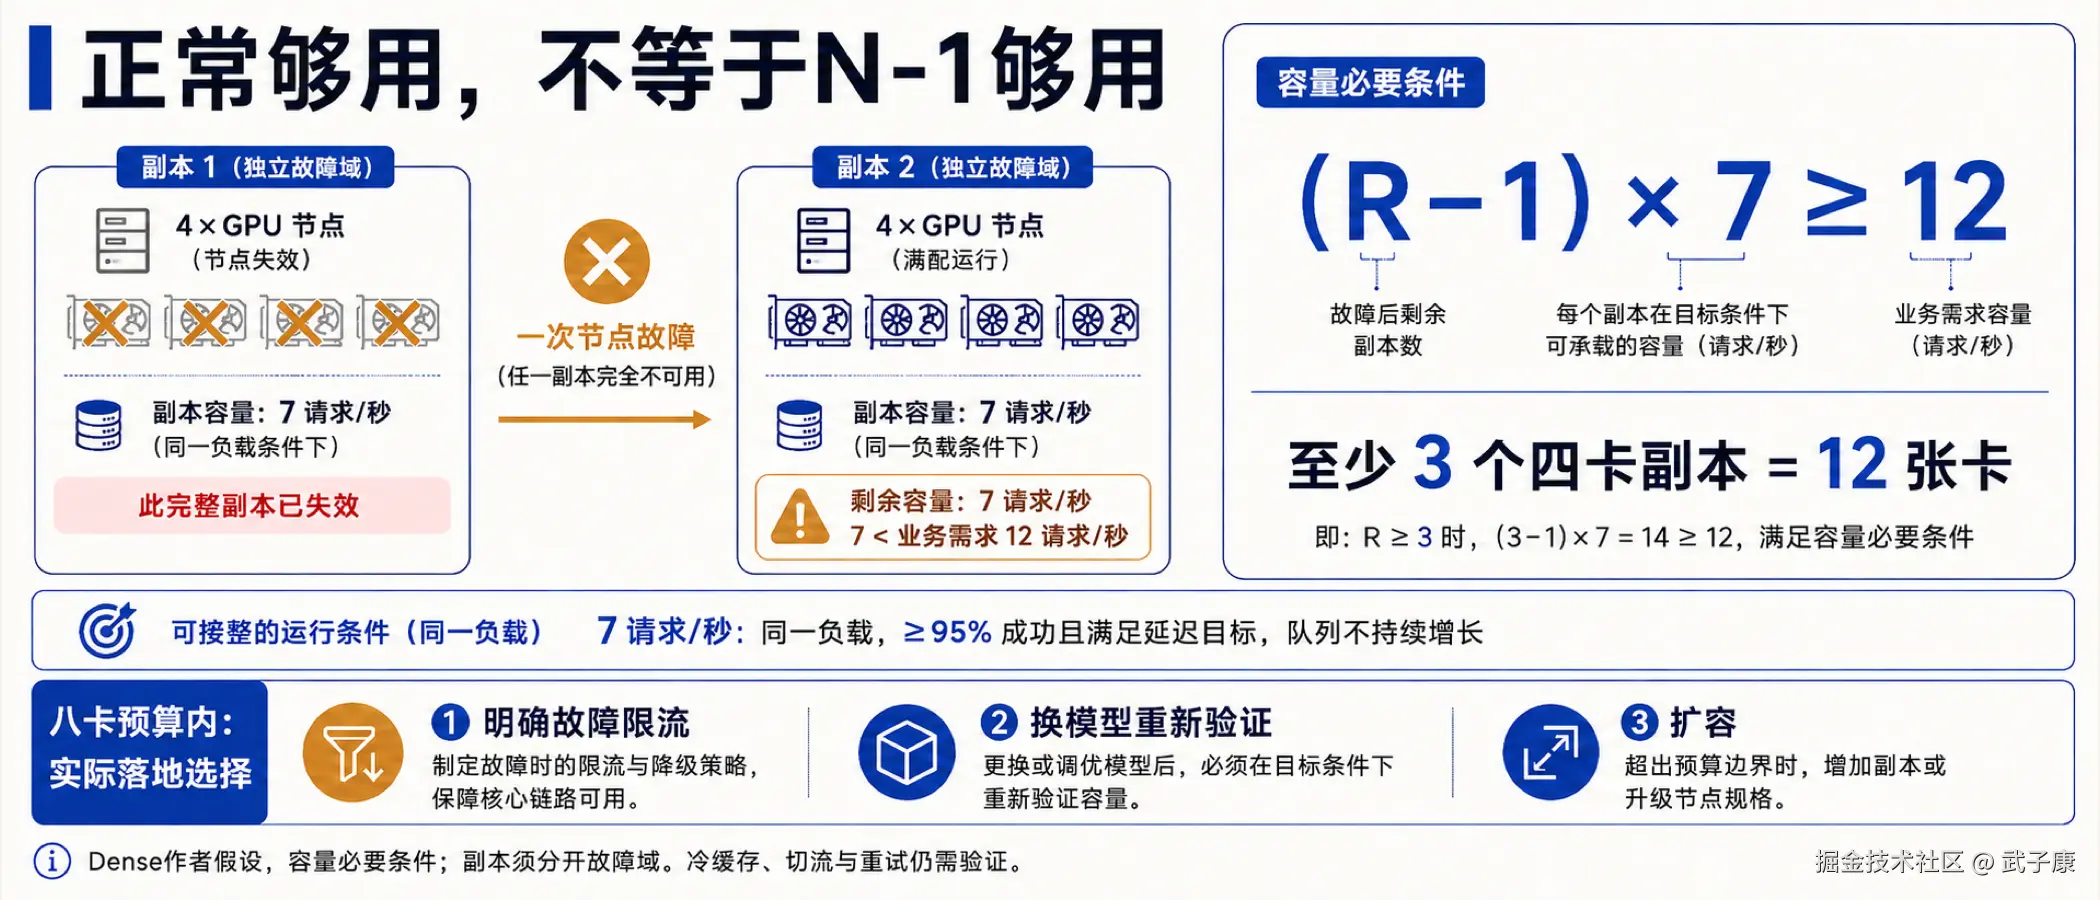
图6:正常够用,不等于 N-1 够用((R-1)×7 ≥ 12 → 至少 3 个四卡副本) |
⚠️ 作者假设 | /tmp/blog-imgs16/06-40b41aafca88b1b79df5c0fcb359ed19.png,Dense 作者假设 |
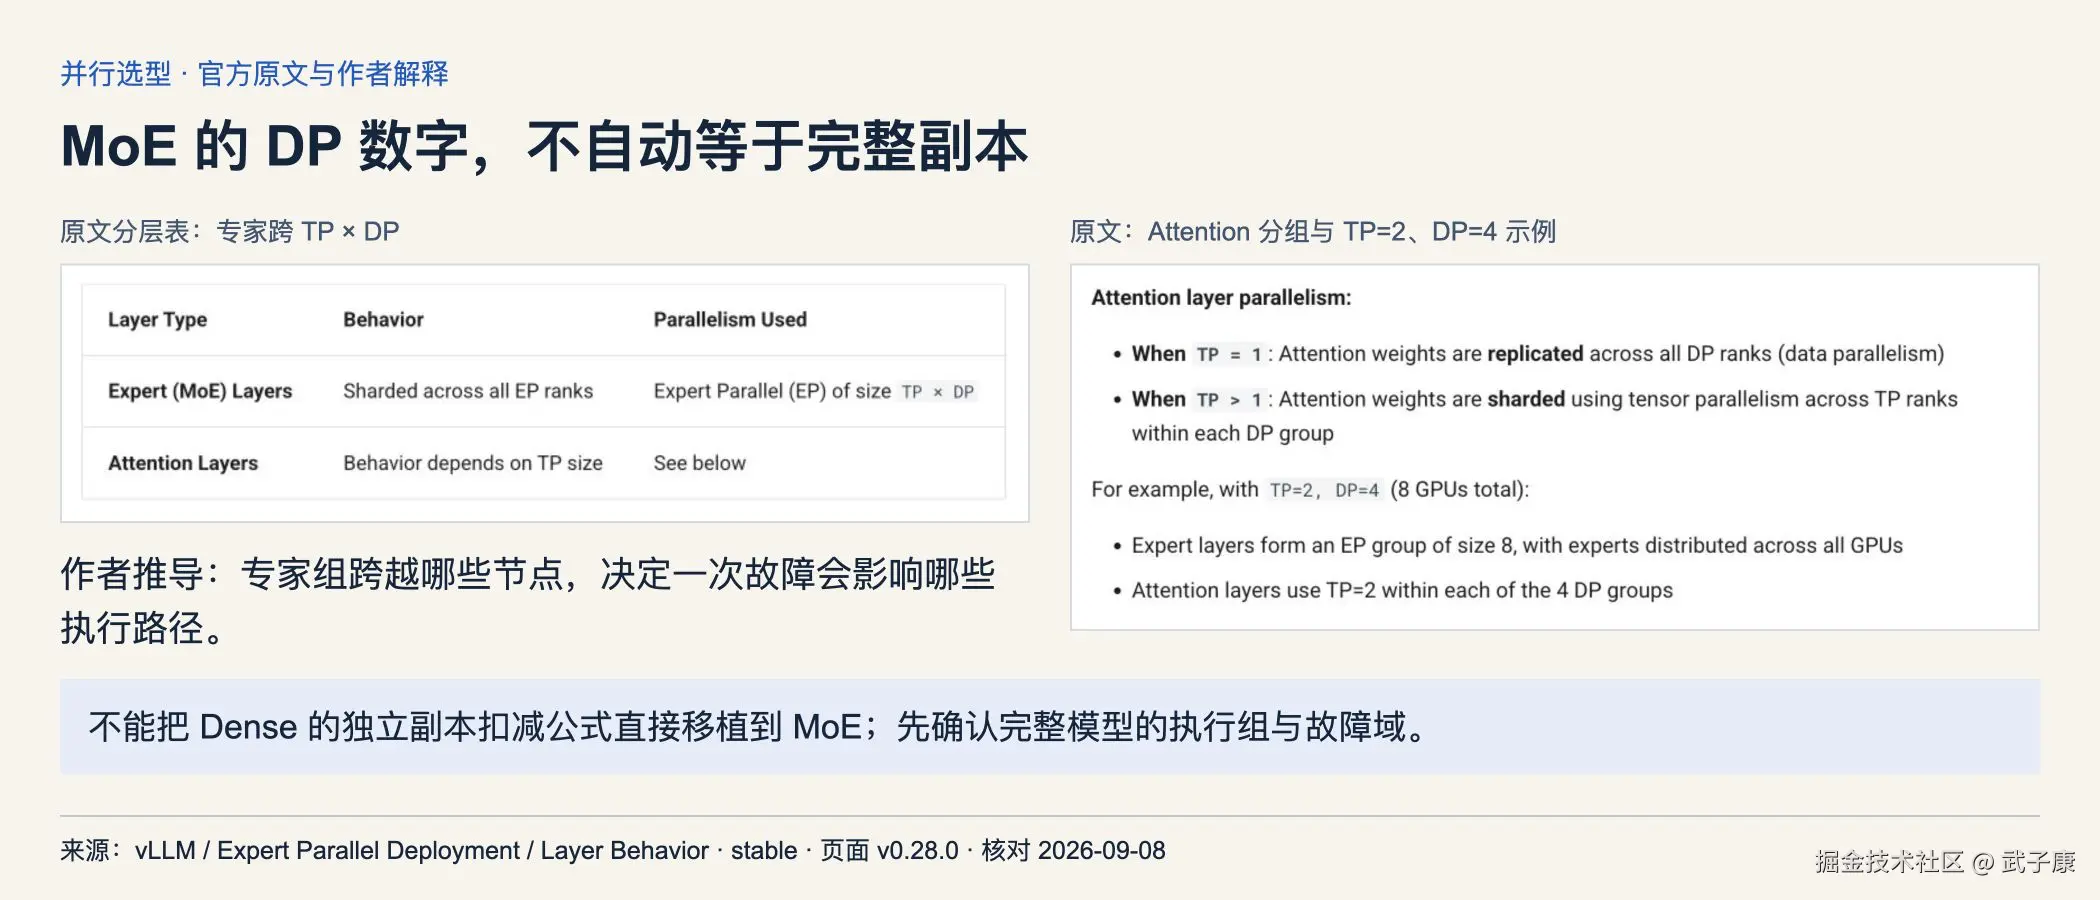
| 图7:MoE 的 DP 数字,不自动等于完整副本(贴 vLLM Layer Behavior + TP=2/DP=4) | ✅ 已解读 | /tmp/blog-imgs16/07-a055f9d2cc18d4b674a06ddabada0b9a.png,页眉 v0.28.0,2026-09-08 核验 |
| 3 候选对照表(A/B/C 配置 + 放置 + 风险) | ⚠️ 教学构造 | 仅路径与故障域示意,不预判性能 |
| 业务到达率 12 请求/秒 / ≥95% 达标 / TTFT ≤1 秒 / TPOT ≤50 毫秒 | ⚠️ 作者设定 | 同上,非实测 SLO |
| 单副本承接 7 / 11 / 9 请求/秒(A/B/C) | ⚠️ 作者假设 | 满足条件时的到达率上限,非 Goodput |
| A 理想总承接 2×7=14 / 达标完成率下界 14×95%=13.3 | ⚠️ 算术推导 | 不能用 13.3 反推 12 时完成率 |
容量必要条件 (R-1)×7 ≥ 12 → 至少 3 个四卡副本 = 12 张卡 |
⚠️ 必要条件 | 冷缓存、切流损失、重试放大可能要求更多余量 |
八张 GPU 已经到位,模型在四张卡上能启动。接下来,是把八张卡合成一个大副本,还是拆成两组四卡服务?
只看启动日志,两种方案都可能成立。把单请求延迟跑出来,也还不能决定:更快的大副本可能接不住业务高峰;吞吐更高的两个小副本,又可能在其中一个退出后没有余量。
张量切分、流水线、请求副本和专家放置各自解决不同约束。组合时,问题变成了同一批硬件要满足哪些约束,以及哪个候选最先违反约束。下面用一个明确虚构的八卡场景,把配置从"参数乘积等于八"收敛到值得实测的少数方案。所有容量与性能数字都是作者假设,不是特定模型或 GPU 的部署结论。
四张卡能启动,不等于一个副本够用
假设有两个节点,每节点四张 GPU;单卡显存按 48 GiB 计算。节点内互联较快,节点间链路较慢。待部署的是 Dense 模型,指定精度下的权重合计 120 GiB;业务有短问答,也有长输入的流式回答。模型和引擎均假设支持后文列出的切分方式。
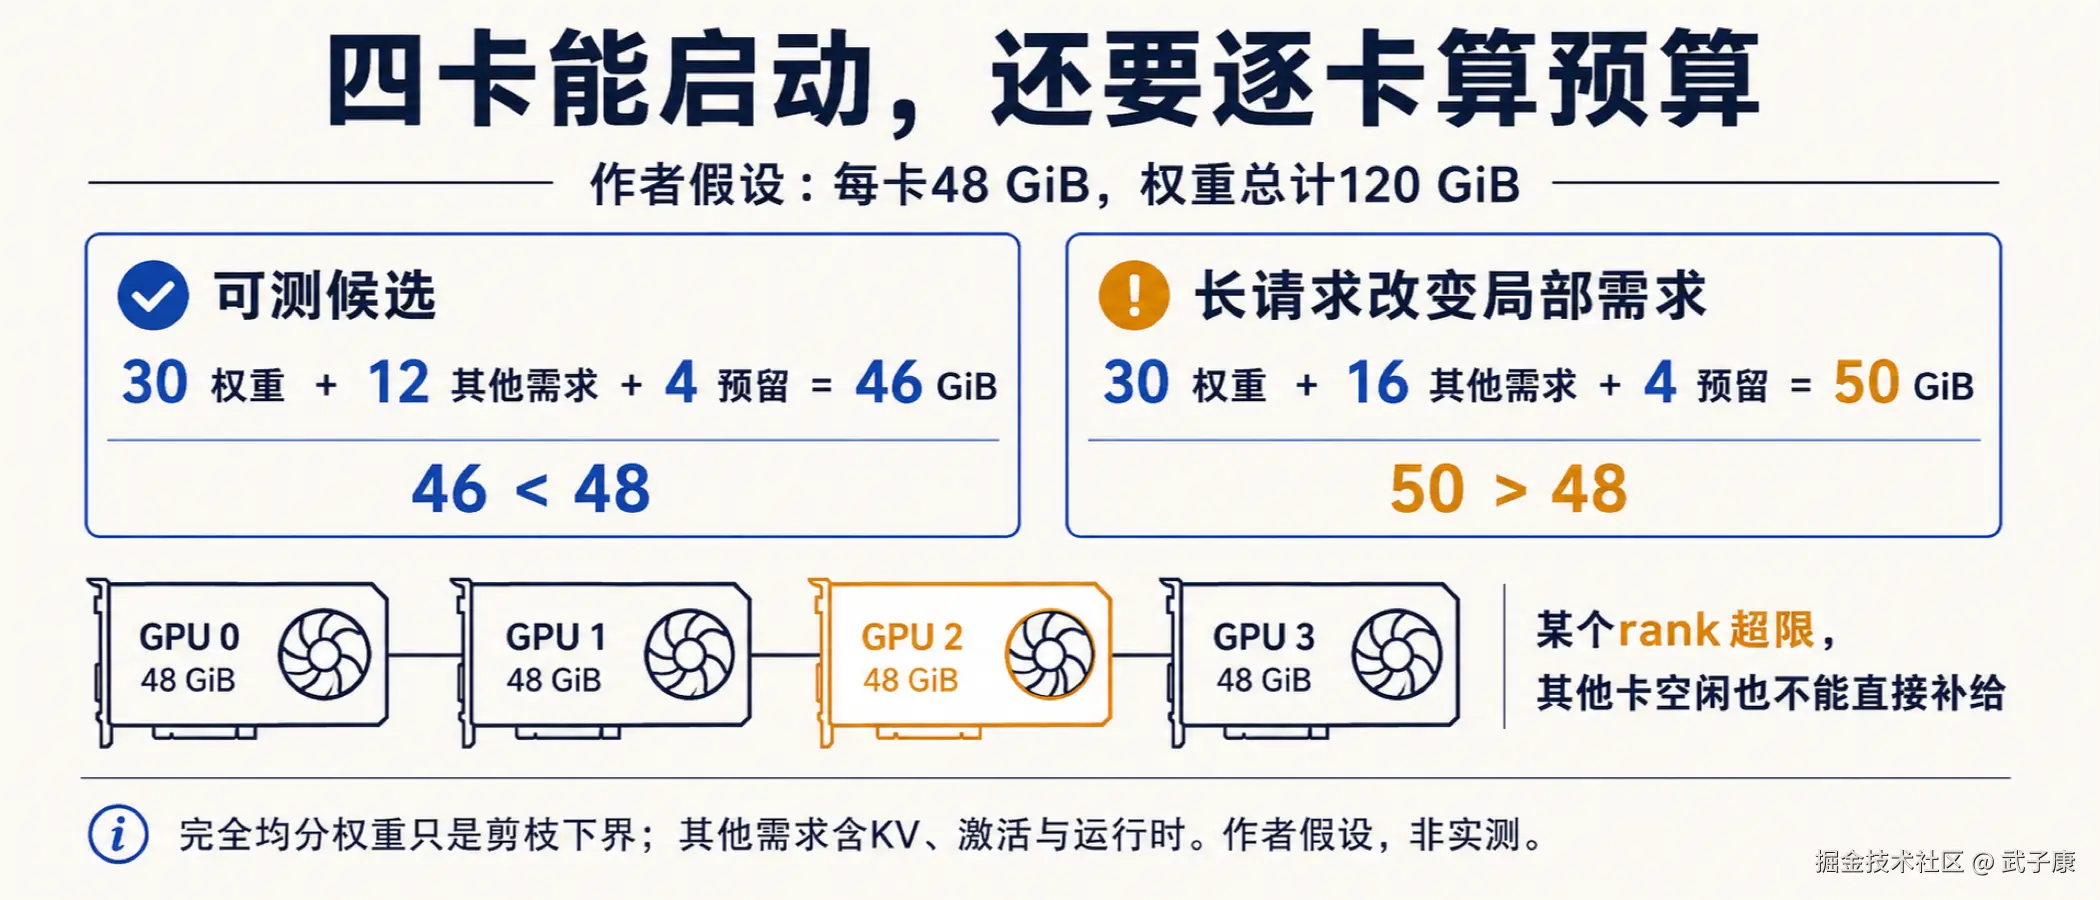
先算一个很粗的下界:如果权重完全均分,四卡每卡 30 GiB,两卡每卡 60 GiB。因此两卡候选连权重都放不下;四卡只是越过了这一道下界,尚未证明能接住请求。
上线时,每张卡还要容纳本地 KV Cache、激活、通信工作区和运行时开销。这里的显存不能当成一个任意分配的大池子:某个 rank 的首尾模块、不能切分的张量或临时峰值超限,其他卡空着也救不了它。120÷4 只能用于剪枝,不能替代逐卡检查。
继续作一个预算假设:四卡候选在目标负载下,每卡除权重外需要 12 GiB,并预留 4 GiB,合计 46 GiB。这让它成为可测候选。若长请求使其中一张卡的非权重需求升到 16 GiB,该卡就需要 50 GiB,候选必须被淘汰或改变服务边界。两个副本即使总计还有空闲显存,也无法直接拼给这个已经接收的请求。
这里改变服务边界,可以是降低允许的上下文或接纳量,也可以是换经过质量验证的精度方案。它们都会改变比较条件,不能悄悄改完后再宣称原配置优胜。KV 的实际分片与复制还依赖模型结构,不能把所有状态都按 TP 数机械相除。
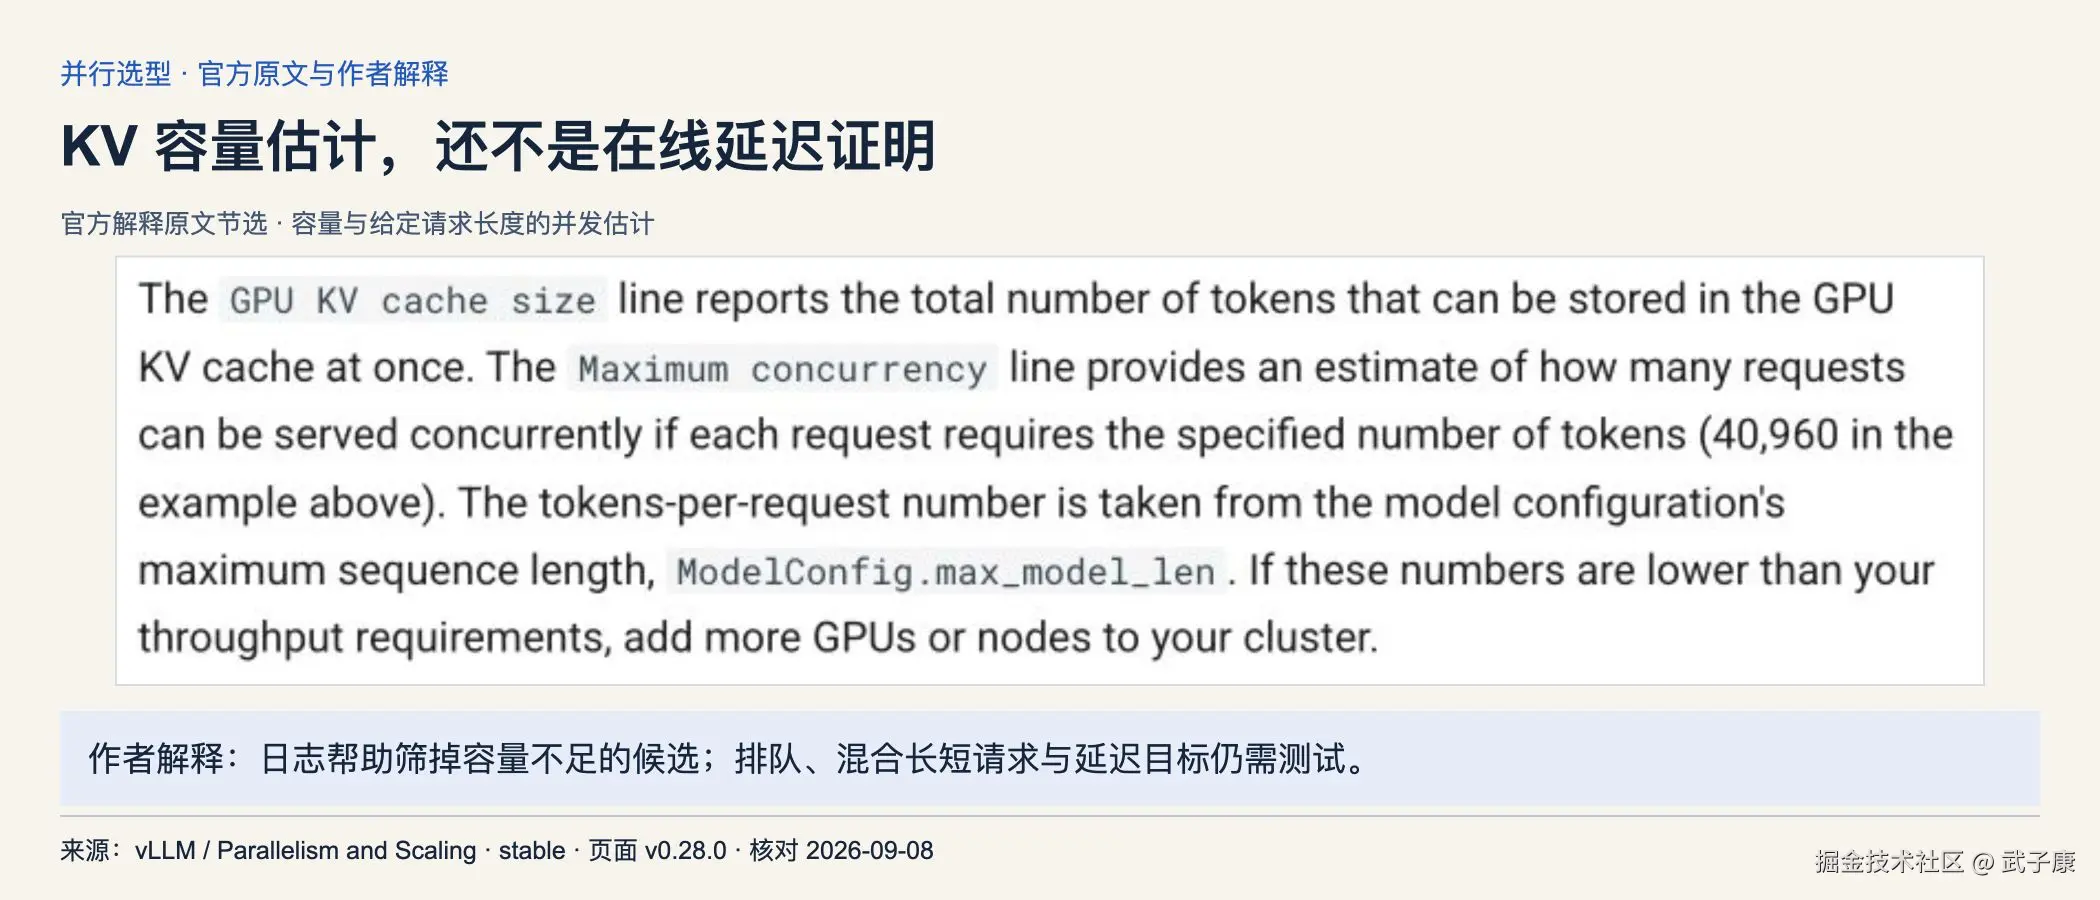
vLLM 的并行部署文档给出了一种实用检查:启动后读取 KV 容量以及指定请求长度下的最大并发估计。这些日志能暴露容量约束,但并不测量排队时间,也不保证混合长短请求的在线延迟。官方部署说明
所以,"最小并行度"指容纳目标工作负载的最小候选。它的作用是保留基线,不能在没有比较结果时直接当成最终配置。
同样用八张卡,通信和副本边界完全不同
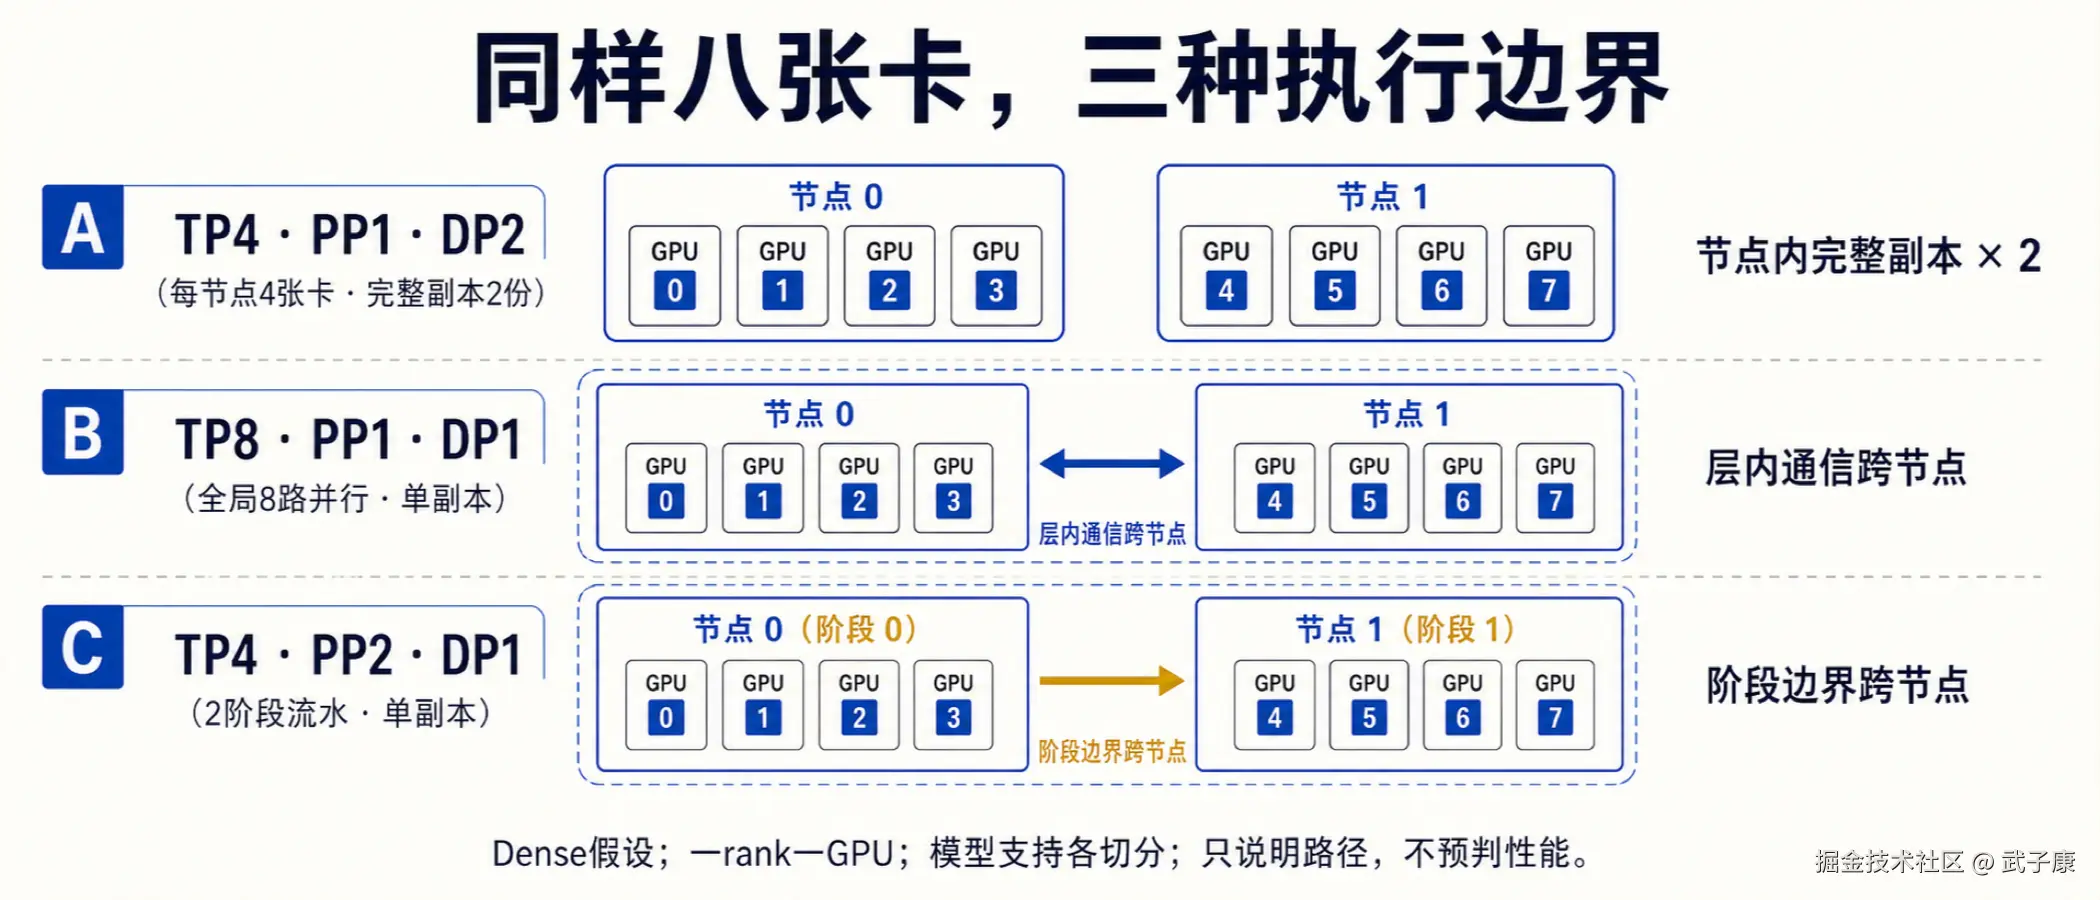
通过容量筛选后,只保留三个问题明确的候选。下表仍是这个虚构 Dense 场景,按每个模型执行 rank 使用一张 GPU、无额外执行组来计数。
| 候选 | 配置 | 放置方式 | 需要验证的风险 |
|---|---|---|---|
| A | TP=4,PP=1,DP=2 | 每节点一个完整四卡副本 | 四卡副本能否同时满足长请求容量与延迟 |
| B | TP=8,PP=1,DP=1 | 一个副本跨两个节点 | 层内集合通信跨节点后是否抵消计算收益 |
| C | TP=4,PP=2,DP=1 | 每节点一个流水线阶段,阶段内四卡 TP | 阶段不均衡、串行依赖与调度气泡是否可接受 |
三者的模型执行 GPU 数都等于 TP×PP×DP=8,但这个等式只数资源,没有表达通信路径。
A 的请求只进入一个节点内的副本;B 的同一层计算涉及两个节点;C 把跨节点边界放在阶段之间。C 不能据此被判定更快:它减少某类跨节点通信的机会,也引入了阶段等待,实际收益取决于切分、请求形态和调度。vLLM 官方把节点内 TP、节点间 PP 列为多节点部署起点;这是可比较的基线,不是性能保证。并行与扩展文档
实测前应把 rank 列表落实到节点、GPU 和链路。参数写成 TP=4,并不自动说明四张卡处于期望的互联域。若部署器把一组卡跨节点放置,比较的就不是表中的 A。
这种放置差异也改变故障边界。按本例不具备运行中透明重构的假设,一个节点退出时,A 尚有一个完整副本;B 和 C 都失去完整执行组,不能继续按原配置服务。这不表示 A 已经高可用:入口切换、在途请求、缓存变冷和剩余容量仍需要验证。这里只能排除"八张卡总数一样,所以故障余量一样"的判断。
单请求更快,为什么仍会输掉集群选择
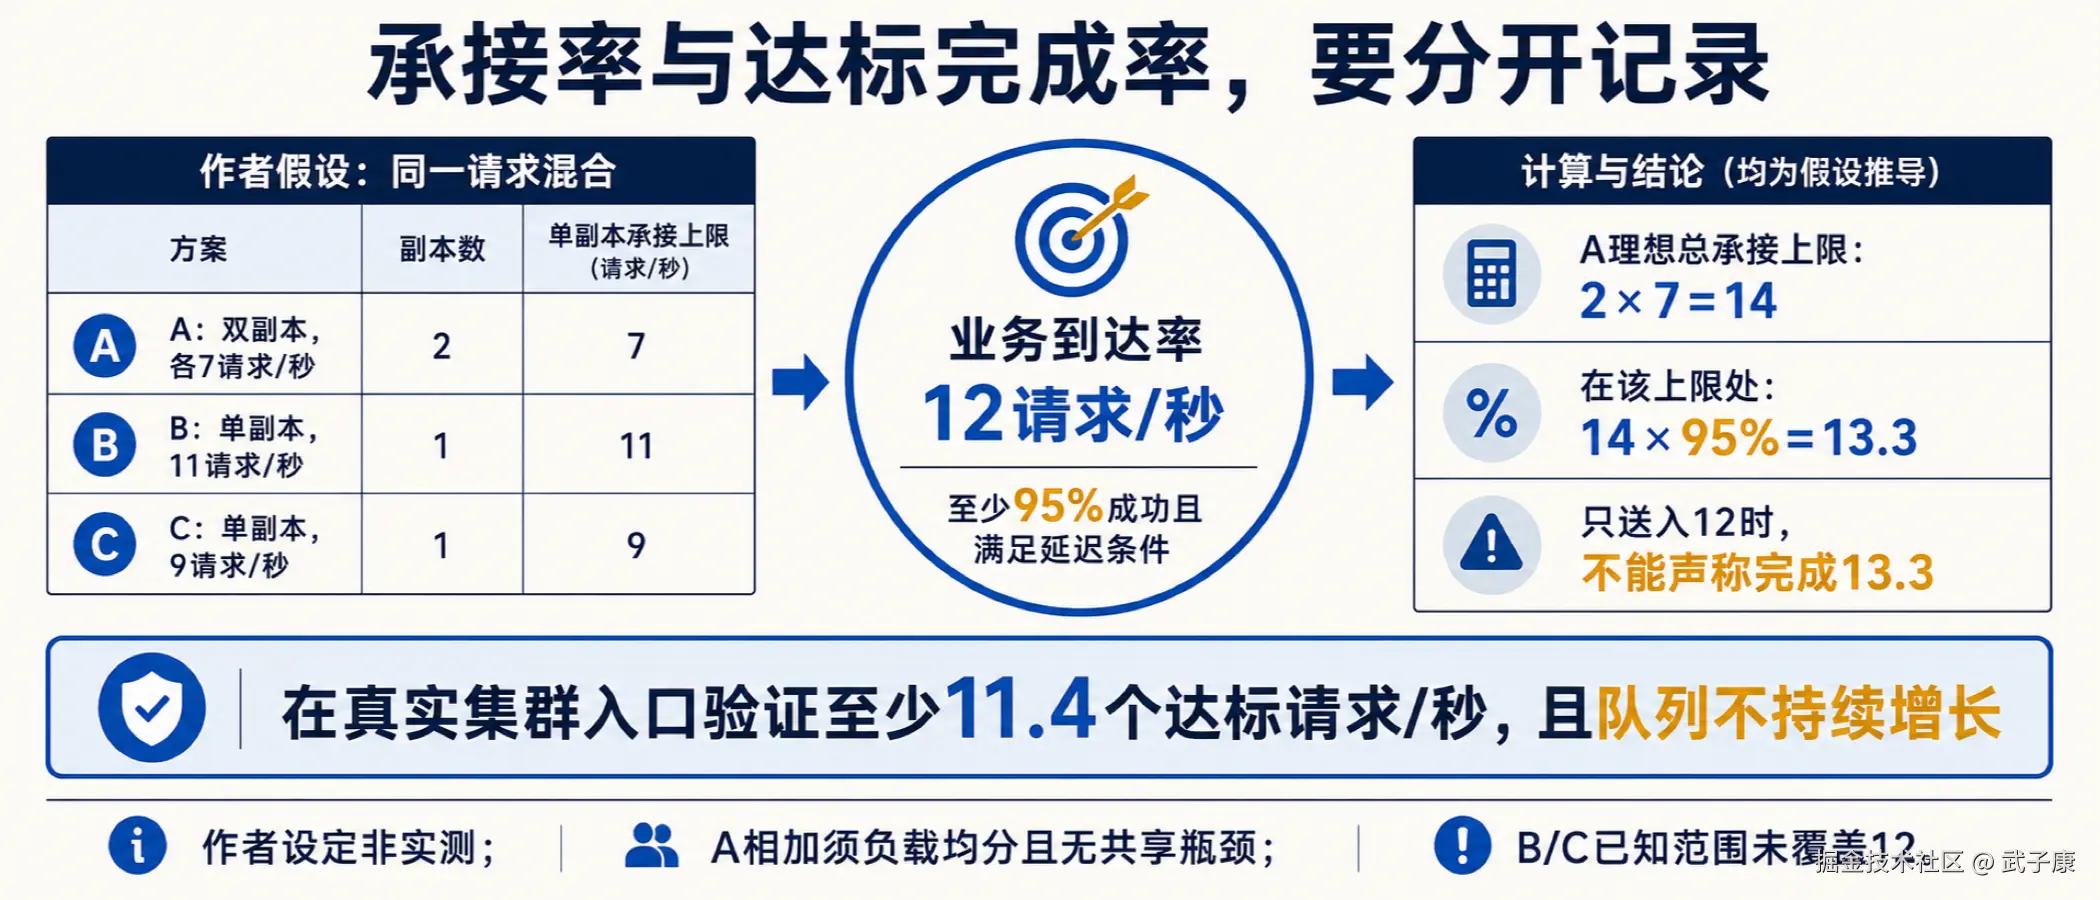
比较之前先定义什么算完成业务。假设目标是每秒到达 12 个请求,其中至少 95% 成功且同时满足首 Token 时间不超过 1 秒、每请求平均输出 Token 间隔不超过 50 毫秒。也就是每秒至少完成 11.4 个满足这些条件的请求。
每请求平均 Token 间隔只度量该请求的平均生成速度,不能保证流式过程中没有长停顿。若产品还限制最大停顿,应另外记录 Token 间隔,不能用平均 TPOT 代替。
为简化下面的手算,进一步假设长期测试得到如下虚构结果:在同一请求混合、至少 95% 达标且队列不持续增长的条件下,A 的每个副本可持续承接 7 请求/秒,B 的唯一副本为 11 请求/秒,C 为 9 请求/秒。这里的 7、11、9 是满足条件时的到达率上限,不是 Goodput,也不是从 TP 大小算出来的性能。
A 在两个副本负载均分、没有共享瓶颈的理想假设下,总承接上限约为 14 请求/秒,达标完成率下界为 14×95%=13.3 请求/秒。业务实际只送入 12 请求/秒时,不能宣称它完成了 13.3;能否保持至少 11.4 的达标完成率,必须在这次真实混合负载下检查。B 和 C 的已知可持续范围均未覆盖 12,不能凭单请求跑分快就批准上线。
这个例子说明单副本结果与整机结果为什么会反转,也说明相加只是估算。两个副本会共享入口、CPU、网络或存储,请求长度可能偏斜,缓存状态也可能不同。正式结果必须从实际集群入口测得,而不是把两个独立跑分相加。
常见的"单副本延迟不达标,增加 DP 无用"判断还需要补上条件:如果延迟主要花在等待空位,多一个副本可能缩短排队;如果低负载下单请求的执行时间已经超标,复制同样的副本通常不会让这个请求本身执行更快。先拆开排队与执行,才能决定该扩副本还是继续调整模型并行。
怎么避免把过载测成稳定?在固定请求集合与到达时间的比较中,保留失败、超时和未完成请求。不要因为某个配置处理得慢,就让客户端自动少发请求,再仅比较成功样本的平均延迟。vLLM 的基准工具分别提供请求到达率和最大并发控制,官方明确说明并发限制可能让实际发送率低于设定到达率;也提供按 TTFT、TPOT、E2EL 阈值统计 Goodput 的选项。基准参数说明
复现实验时应记录模型与引擎版本、精度、请求 ID、输入与输出长度、到达时间、完成状态和延迟。先固定缓存策略、采样设置与请求流,给每个候选相同预热条件,再逐级增加到达率。单独增加长请求比例做第二轮,并明确这是新的工作负载;不要同时更换量化、缓存策略和并行配置,否则无法判断变化来自哪里。
把故障余量和 MoE 放回同一张决策表
继续检查 A。若一个节点退出,只剩一个承接上限为 7 请求/秒的副本。即使正常状态下两副本足够,也不能在保持原 12 请求/秒业务目标的前提下声称具有 N-1 容量。
如果仍沿用每副本 7 的假设,且要求失去任意一个副本后承接 12,请求容量的必要条件是:
text
(R - 1) × 7 ≥ 12
R ≥ 3
每副本四卡,至少需要十二张卡,且这三个副本必须按所要求的故障域分开放置。它只是必要条件:冷缓存、切流损失、重试放大和共享入口瓶颈可能要求更多余量。如果故障单位是一整个节点,节点上放了多个副本,就必须一次扣掉该节点全部副本,不能仍只减一。
在现有八卡预算内,合理结论可能是保留 A、明确故障时限流降级;也可能是换更小的模型,重新验证质量和容量;还可能是扩容。不能为了选出一个"最佳配置",把原来的故障目标从表里删掉。
当模型改成 MoE,表格还必须重新解释。这里最危险的误读,是看到 DP=2 就继续套用 Dense 的两个完整副本假设。以当前 vLLM 官方 EP 文档为例,专家组大小按 TP×DP 计算;Attention 在各 DP 组内部采用相应 TP,而专家层可以跨这些组分布。因此 EP 不是再乘一次的独立 GPU 倍数,Attention 的 DP 分组也不自动构成完整模型的故障隔离边界。官方 EP 分层说明
本篇不把上述 Dense 的 7 请求/秒或十二卡下界移植到 MoE。需要重新画出专家组、Attention 组和物理节点的对应关系,确认一个故障影响哪些请求路径,再从真实部署测试持续承接能力。若还组合 PP,更要核对锁定版本的支持与组划分,不能仅凭几个参数的乘积推导它可用。
最终留下的决策表可以很短:A 的正常负载是否达标、单节点故障后要削减多少流量;B 的跨节点 TP 是否获得足够的延迟收益;C 的阶段边界是否改善了真实请求结果。每一格都填写测量或明确的未知项,候选被淘汰时写清违反的是容量、SLO、拓扑限制还是故障目标。
这样得到的配置选择才可以回溯:容量负责排除不可能运行的方案,放置解释候选在比较什么,固定工作负载检验服务结果,故障目标决定是否有资格上线。现有硬件无法同时满足要求,也是一次有效的选型结论。
来源核对日期:2026-09-08。官方来源用于并行组关系与基准口径;八卡拓扑、显存预算、SLO、吞吐数字及扩容推导均为作者假设或手算,未进行 GPU 或生产环境验证。
错误速查卡
| 症状 | 根因 | 定位 | 修复 |
|---|---|---|---|
| "120÷4=30" 直接拿来估算上线显存 | 这是权重均分的下界,不是每个 rank 的实际占用 | vLLM Parallelism and Scaling | 逐卡算权重 + KV + 激活 + 运行时 + 预留;某个 rank 超限即淘汰 |
| 把可启动当作可上线 | 可启动只越过容量下界,未证明能接住请求 | 同上 | 把"启动日志 + KV 容量估计 + 真实负载"逐项独立验证 |
| 把 KV 容量估计当作在线延迟证明 | 官方原文写明该行只是估计,不测量排队与混合负载 | 同上 | 用基准工具测真实请求到达率下的 TTFT/TPOT/Goodput |
| "TP=4" 写好就以为四张卡在期望互联域 | 参数相等不说明物理放置 | vLLM Parallelism and Scaling | 实测前把 rank 列表落实到节点、GPU 和链路 |
| 把"两个完整副本"看作两个独立故障域 | 副本按节点放置时故障单位是节点,不是副本 | 本文 3 候选对照 | 按故障单位(节点/机架/可用域)放副本,扣减时按单位扣 |
| 把两个独立跑分相加得到集群结果 | 副本会共享入口、CPU、网络、存储;请求长度可能偏斜 | vLLM vllm bench serve | 从真实集群入口测得,不要把单副本结果相加 |
| 把单副本的延迟不达标归结为"DP 无用" | 延迟可能花在等待空位,也可能是执行本身慢 | 同上 | 拆开排队与执行;前者扩副本,后者调整模型并行 |
| 把过载测成稳定 | 客户端自动少发请求会降低实际到达率 | vLLM vllm bench serve --max-concurrency | 保留失败、超时、未完成请求;不要让客户端少发 |
| 用平均 TPOT 代替流式停顿 | 平均 TPOT 不能揭示长停顿 | 本文 SLO 定义 | 若产品限制最大停顿,单独记录 Token 间隔 |
| 用"单请求延迟"批准上线 | 单请求更快不代表集群结果更好 | 本文 3 候选对照 | 用真实混合负载 + 同一请求集合测集群入口 |
| 用"乘积等于 8"判断故障余量 | 三候选通信路径与故障域完全不同 | 本文 3 候选对照 | 故障目标要按候选分别写,不能共享 |
| "12×95%=11.4" 当成"实际能完成 11.4" | 12 是送入率,11.4 是要满足的目标值 | 本文 SLO 定义 | 在真实集群入口验证至少 11.4 达标/秒,且队列不持续增长 |
| 把 13.3 当成送入 12 时的完成率 | 14×95%=13.3 是上限处的下界,业务只送入 12 | 本文算术推导 | 不能用上限反推实际值,必须真实测量 |
| 把 7/11/9 当 Goodput | 这是满足条件时的到达率上限 | 本文算术推导 | 区分到达率上限 vs Goodput vs 平均 TPOT |
| "N-1 容量"只考虑副本数 | 故障单位是节点/RACK 时按单位扣减;冷缓存、切流、重试放大需要余量 | 本文容量必要条件 | 列出所有扣减项并加上缓冲,容量必要条件只是下界 |
| 把单节点故障等同于副本数减一 | 节点上若放了两个副本,节点失效要扣两个 | vLLM Parallelism and Scaling | 按故障单位统计副本分布,扣减按单位 |
把 (R-1)×7 ≥ 12 当充分条件 |
这是必要条件,未覆盖冷缓存、切流损失、重试放大、共享入口瓶颈 | 本文容量必要条件 | 在该必要条件上加缓冲,按真实部署重新测量 |
| 把 MoE 的 DP=2 直接套用 Dense 双副本假设 | EP 组大小是 TP×DP,Attention 在各 DP 组内按 TP 切分;专家组跨越哪些节点决定故障影响哪些路径 | vLLM Expert Parallel Deployment | 重新画专家组、Attention 组与物理节点对应,按 MoE 重新推导故障域 |
| 把多个参数乘积当作"可服务容量" | TP/PP/DP/EP 各解决不同约束,乘积只数 GPU | 本文 3 候选对照 | 把"参数 × 资源 × 通信路径 × 故障域"分别写下 |
| 同时更换量化、缓存策略与并行配置 | 多变量同改无法定位 | 本文复现实验 | 逐项独立验证;先把工作负载 + 缓存 + 采样固定再改并行 |
核查依据
- vLLM
docs.vllm.ai/en/stable页眉 v0.28.0:3 个 URL 全部 HTTP 200(Parallelism and Scaling / vllm bench serve / Expert Parallel Deployment)。 - 7 张图均
curl -fsSL下载到/tmp/blog-imgs16/01-07并已read工具解读,2026-09-08 核验。 - 资料检查日期 2026-09-08;八卡拓扑(两节点 × 4 卡 × 48 GiB)、显存预算(30+12+4=46 vs 30+16+4=50)、SLO(12 请求/秒、≥95%、TTFT ≤1 秒、TPOT ≤50 毫秒)、吞吐数字(7/11/9 请求/秒)、A 总承接上限 2×7=14、达标完成率下界 14×95%=13.3、容量必要条件
(R-1)×7 ≥ 12、以及"至少 3 个四卡副本 = 12 张卡"均为作者假设或手算,未进行 GPU 或生产环境验证。