✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
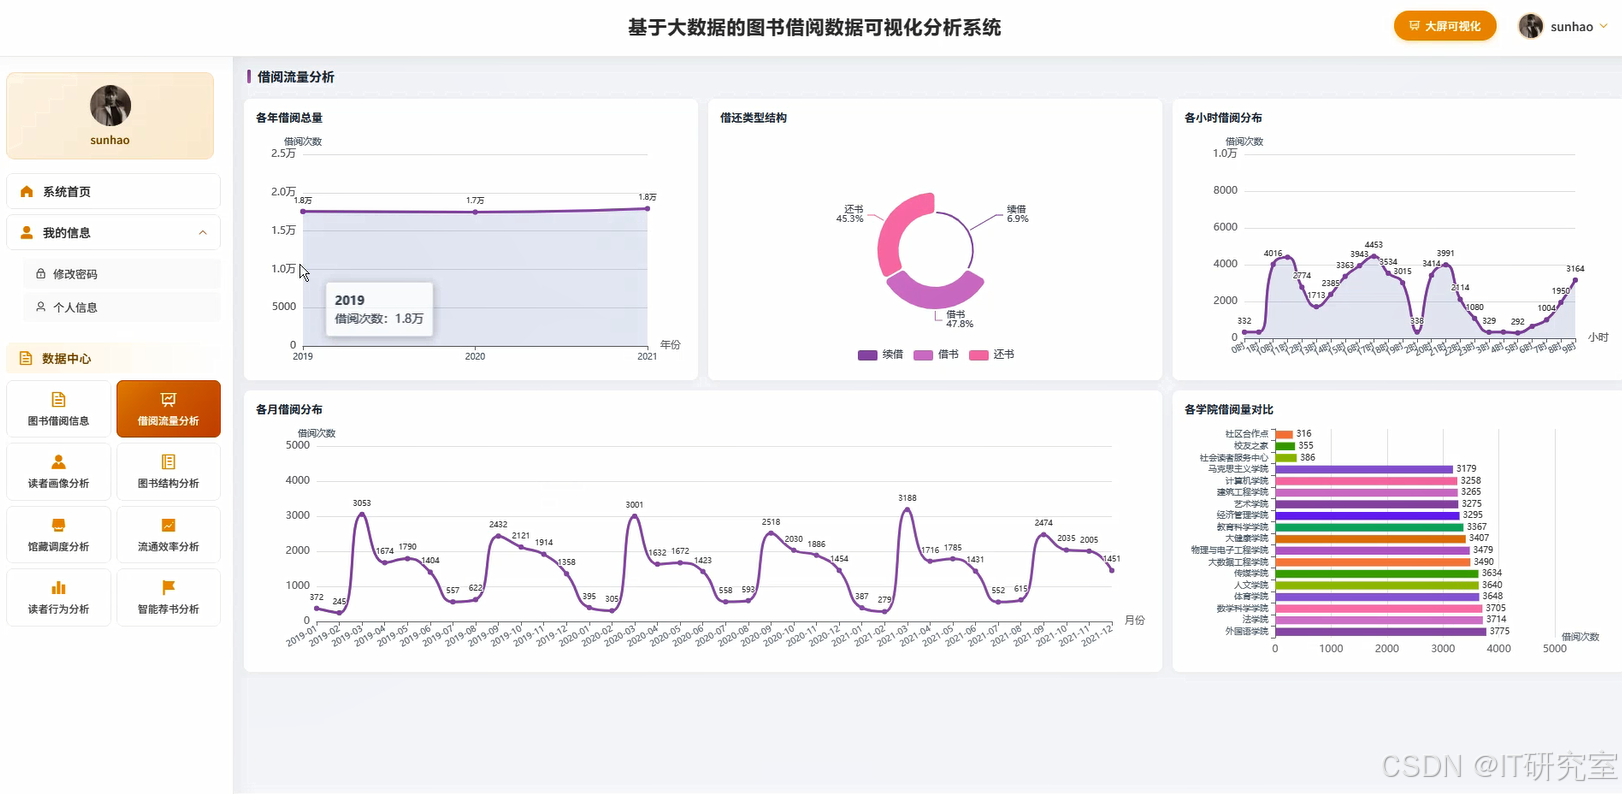
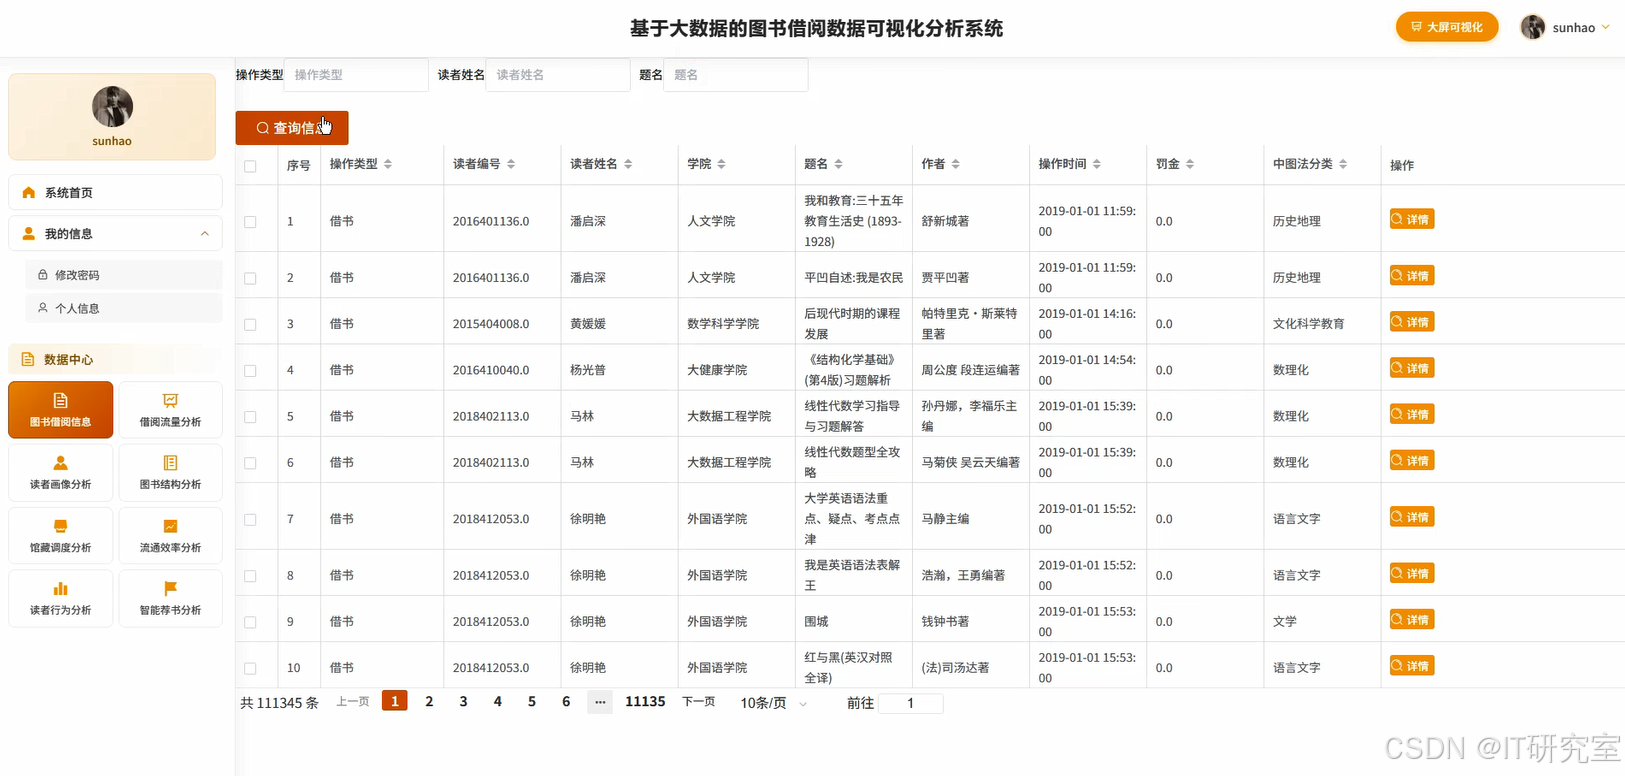
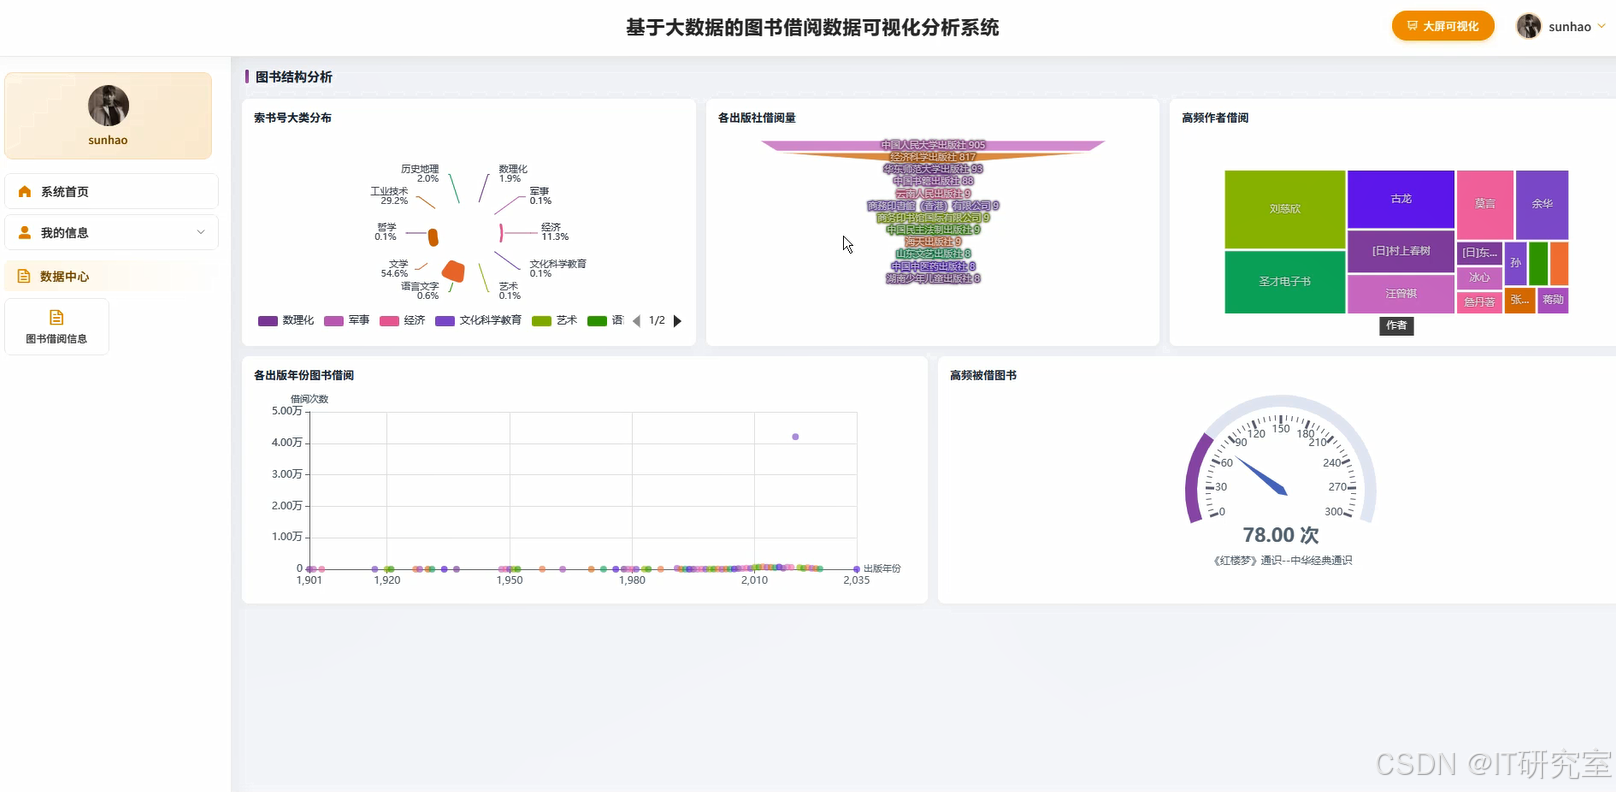
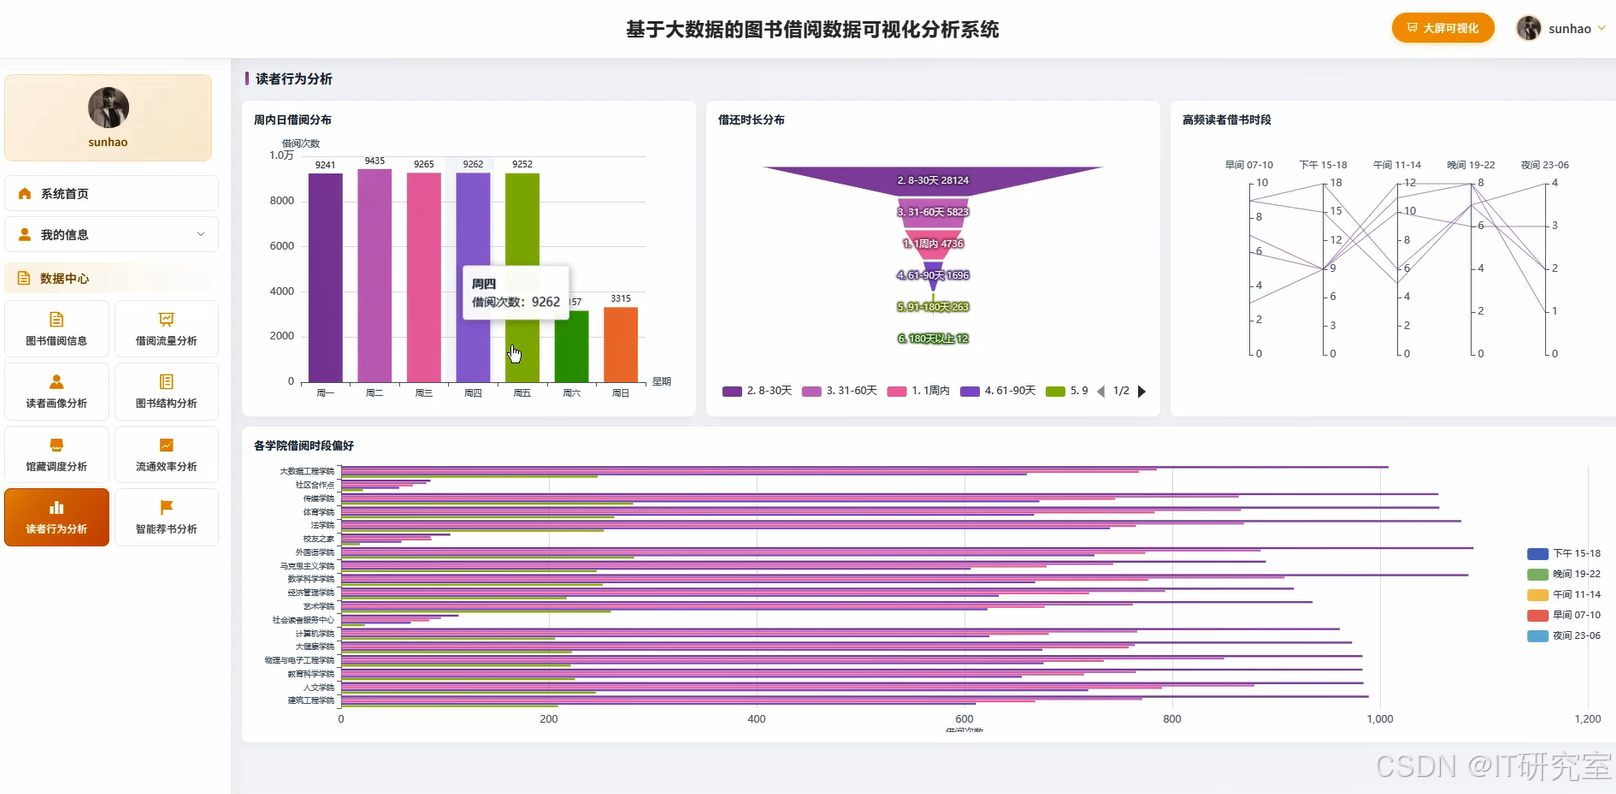
基于大数据的图书借阅数据可视化分析系统是一套面向图书馆借阅业务场景的数据分析平台,系统以Hadoop与Spark作为大数据处理的核心支撑,通过HDFS完成借阅原始数据的分布式存储,借助Spark SQL与Pandas、NumPy完成数据清洗、指标计算与统计分析,最终由Django或Spring Boot提供后端服务接口,前端采用Vue、ElementUI与Echarts实现可视化呈现。系统围绕图书借阅信息、读者画像分析、馆藏调度分析、读者行为分析、借阅流量分析、图书结构分析、流通效率分析以及智能荐书分析等功能展开,形成从数据接入、数据处理、指标计算到图表展示的完整链路。数据中心模块承担借阅记录的汇总与统计职责,读者画像分析模块从借阅频次、借阅类别偏好等维度刻画读者特征,馆藏调度分析模块结合图书流通情况辅助判断馆藏资源的配置合理性,读者行为分析模块则聚焦借阅时间分布与借阅习惯,借阅流量分析、图书结构分析与流通效率分析分别从流量趋势、图书类别构成与借阅周转情况等角度提供分析结果,智能荐书分析模块依据读者历史借阅行为与图书借阅热度生成推荐结果。整体而言,该系统将大数据处理技术与图书借阅业务相结合,为计算机专业毕业设计提供了一个技术路线清晰、功能边界明确、分析维度较为完整的选题方向。
选题背景
图书馆在日常运行中会持续产生大量的借阅记录,这些记录里包含了读者信息、图书信息、借阅时间、归还时间以及借阅频次等内容。过去很多图书管理系统更多关注的是借书还书这类基础业务操作,数据虽然一直在积累,但真正被拿来分析的部分并不多。随着借阅数据规模慢慢变大,单靠MySQL做简单查询已经不太够用,想从里面看出读者偏好、借阅高峰、图书流转情况,往往需要更合适的处理方式。Hadoop和Spark这类大数据技术正好能派上用场,HDFS可以把借阅数据分散存储,Spark SQL和Pandas、NumPy可以对数据进行清洗和统计,再配合Echarts把结果用图表展示出来,整个分析过程会顺畅很多。本课题就是在这个背景下,把图书借阅业务和大数据技术结合起来,做一个基于大数据的图书借阅数据可视化分析系统,用来完成借阅信息的统计分析与可视化呈现。
选题意义
从实际意义来看,这个系统能帮图书馆工作人员更直观地了解借阅情况。借阅流量分析可以看出哪些时间段借书的人比较多,图书结构分析能反映各类图书的借阅占比,流通效率分析则能看出哪些书借得快、哪些书长期没人借,这些结果对馆藏调整和图书采购都有一定参考价值。读者画像分析和读者行为分析可以把读者的借阅习惯整理出来,智能荐书分析也能根据历史借阅记录给出推荐结果,虽然只是毕业设计层面的尝试,但至少把大数据分析的基本流程跑通了。从学习角度来说,这个课题把Hadoop、Spark、Spark SQL、Django或Spring Boot、Vue、Echarts这些技术串在一起,能让我对大数据项目的整体结构有更清楚的认识。它不算复杂,也没有追求多高的技术深度,但作为一个本科毕业设计,能把数据存储、数据处理、后端接口和前端可视化这几块连接起来,已经是一次比较完整的实践。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
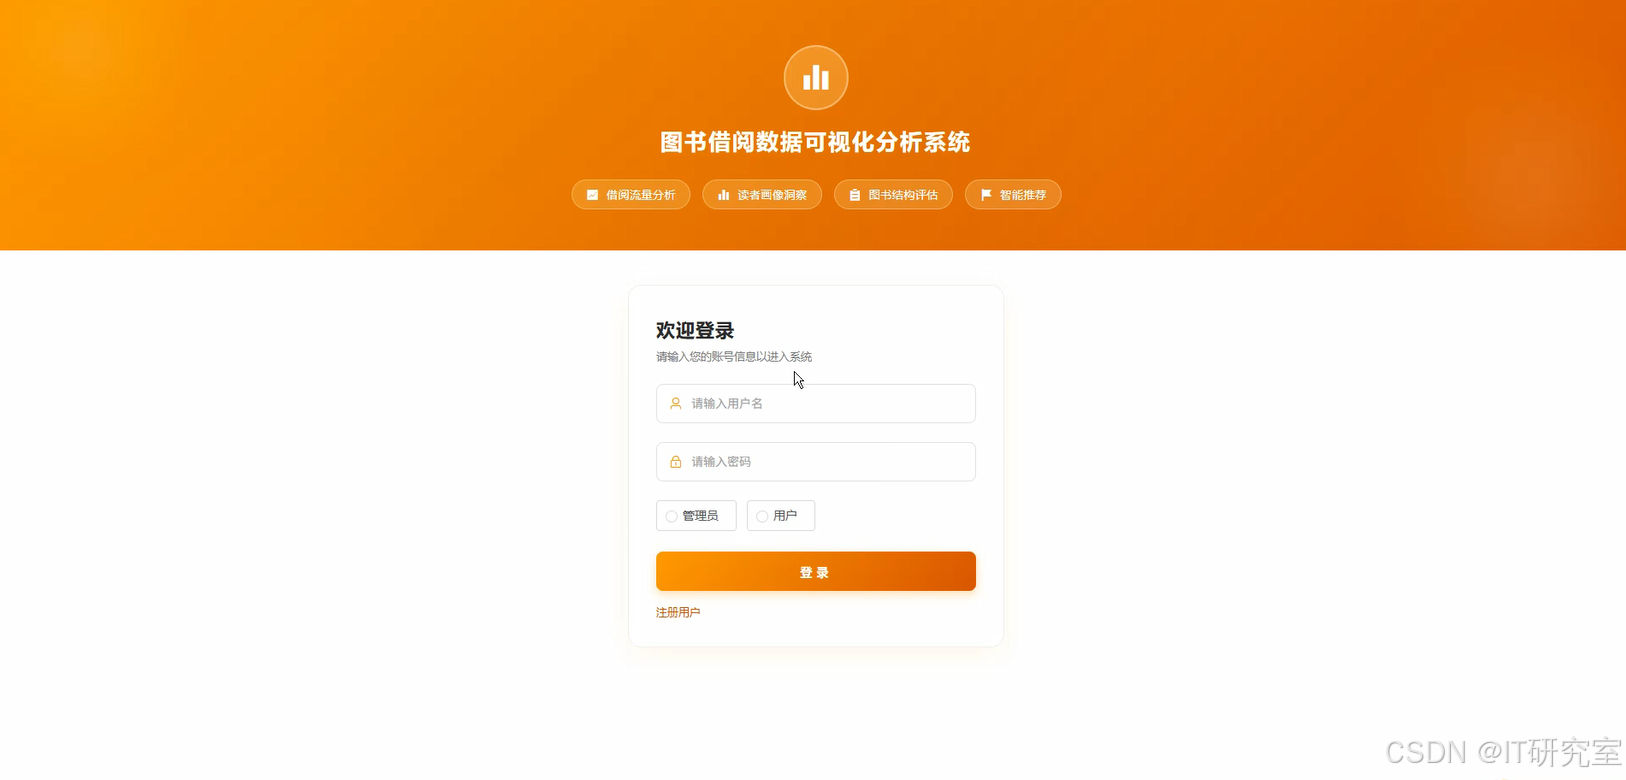
- 基于大数据的图书借阅数据可视化分析系统界面展示:
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, sum as spark_sum, avg, date_format, desc, row_number
from pyspark.sql.window import Window
import pandas as pd
import numpy as np

spark = SparkSession.builder.appName("BookBorrowAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()
borrow_df = spark.read.csv("hdfs://localhost:9000/library/borrow/borrow_records.csv", header=True, inferSchema=True)
book_df = spark.read.csv("hdfs://localhost:9000/library/book/book_info.csv", header=True, inferSchema=True)
reader_df = spark.read.csv("hdfs://localhost:9000/library/reader/reader_info.csv", header=True, inferSchema=True)

def borrow_flow_analysis(start_date, end_date):
    flow_df = borrow_df.filter((col("borrow_date") >= start_date) & (col("borrow_date") <= end_date))
    flow_df = flow_df.withColumn("borrow_month", date_format(col("borrow_date"), "yyyy-MM"))
    flow_df = flow_df.withColumn("borrow_week", date_format(col("borrow_date"), "yyyy-ww"))
    monthly_flow = flow_df.groupBy("borrow_month").agg(count("borrow_id").alias("borrow_count"), spark_sum("borrow_days").alias("total_borrow_days"), avg("borrow_days").alias("avg_borrow_days")).orderBy("borrow_month")
    weekly_flow = flow_df.groupBy("borrow_week").agg(count("borrow_id").alias("borrow_count")).orderBy("borrow_week")
    peak_month = monthly_flow.orderBy(desc("borrow_count")).limit(1).collect()
    monthly_pd = monthly_flow.toPandas()
    weekly_pd = weekly_flow.toPandas()
    monthly_pd["borrow_count"] = monthly_pd["borrow_count"].astype(int)
    monthly_pd["avg_borrow_days"] = monthly_pd["avg_borrow_days"].round(2)
    monthly_pd["mom_rate"] = monthly_pd["borrow_count"].pct_change().replace(np.nan, 0).round(4)
    weekly_pd["borrow_count"] = weekly_pd["borrow_count"].astype(int)
    result = {"monthly_flow": monthly_pd.to_dict("records"), "weekly_flow": weekly_pd.to_dict("records"), "peak_month": peak_month[0]["borrow_month"] if peak_month else None, "peak_count": int(peak_month[0]["borrow_count"]) if peak_month else 0}
    return result

def reader_profile_analysis(reader_type):
    profile_df = borrow_df.join(reader_df, on="reader_id", how="inner").join(book_df, on="book_id", how="inner")
    profile_df = profile_df.filter(col("reader_type") == reader_type)
    profile_df = profile_df.withColumn("borrow_year", date_format(col("borrow_date"), "yyyy"))
    reader_borrow = profile_df.groupBy("reader_id", "reader_name", "reader_type", "borrow_year").agg(count("borrow_id").alias("borrow_total"), spark_sum("borrow_days").alias("total_days"), avg("borrow_days").alias("avg_days")).orderBy(desc("borrow_total"))
    category_prefer = profile_df.groupBy("reader_id", "book_category").agg(count("borrow_id").alias("category_count"))
    window_spec = Window.partitionBy("reader_id").orderBy(desc("category_count"))
    category_prefer = category_prefer.withColumn("rank", row_number().over(window_spec)).filter(col("rank") == 1)
    profile_result = reader_borrow.join(category_prefer, on="reader_id", how="left")
    profile_result = profile_result.withColumn("avg_days", col("avg_days").cast("double"))
    profile_pd = profile_result.toPandas()
    profile_pd["avg_days"] = profile_pd["avg_days"].round(2)
    profile_pd["borrow_level"] = pd.cut(profile_pd["borrow_total"], bins=[0, 5, 15, 30, np.inf], labels=["低频", "中频", "高频", "超高频"])
    profile_pd["borrow_level"] = profile_pd["borrow_level"].astype(str)
    top_readers = profile_pd.sort_values("borrow_total", ascending=False).head(10)
    category_dist = profile_pd.groupby("book_category").size().reset_index(name="reader_count")
    result = {"reader_profile": profile_pd.to_dict("records"), "top_readers": top_readers.to_dict("records"), "category_dist": category_dist.to_dict("records")}
    return result

def smart_recommend_analysis(reader_id, top_n):
    reader_history = borrow_df.filter(col("reader_id") == reader_id).select("book_id", "book_category").distinct()
    all_borrow = borrow_df.join(book_df, on="book_id", how="inner")
    book_hot = all_borrow.groupBy("book_id", "book_name", "book_category").agg(count("borrow_id").alias("borrow_count"), avg("borrow_days").alias("avg_days")).orderBy(desc("borrow_count"))
    reader_categories = [row["book_category"] for row in reader_history.collect()]
    if len(reader_categories) == 0:
        recommend_df = book_hot.limit(top_n)
    else:
        category_hot = book_hot.filter(col("book_category").isin(reader_categories))
        other_hot = book_hot.filter(~col("book_category").isin(reader_categories))
        recommend_df = category_hot.union(other_hot).dropDuplicates(["book_id"]).limit(top_n)
    recommend_df = recommend_df.withColumn("avg_days", col("avg_days").cast("double"))
    recommend_pd = recommend_df.toPandas()
    recommend_pd["avg_days"] = recommend_pd["avg_days"].round(2)
    recommend_pd["score"] = (recommend_pd["borrow_count"] / recommend_pd["borrow_count"].max() * 0.7 + (1 - recommend_pd["avg_days"] / recommend_pd["avg_days"].max()) * 0.3).round(4)
    recommend_pd = recommend_pd.sort_values("score", ascending=False)
    result = {"reader_id": reader_id, "recommend_list": recommend_pd.to_dict("records"), "recommend_count": len(recommend_pd), "based_category": reader_categories}
    return result
五、系统视频
基于大数据的图书借阅数据可视化分析系统项目视频:
结语
XXX系统(标题)
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇