✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
本系统名为基于大数据的天气预报预警数据可视化与分析,围绕气象领域多源数据的采集、存储、计算与展示展开,技术路线以大数据处理为核心。系统采用Hadoop与HDFS完成气象数据的分布式存储,借助Spark与Spark SQL对海量天气预报及预警数据进行清洗、聚合与统计计算,并结合Pandas与NumPy完成指标计算与数据整理。后端提供Python与Java两个版本,分别对应Django与Spring Boot框架,负责数据接口、业务逻辑与权限管理,数据库采用MySQL存储用户信息、预警记录与统计分析结果。前端基于Vue、ElementUI、ECharts以及HTML、CSS、JavaScript、jQuery实现可视化交互,将分析结果以图表形式呈现。系统功能涵盖用户管理、气象要素分析、天气预报预警信息、天气态势分析、区域对比分析、风雨关联分析、时序演变分析与风险洞察分析,能够从时间、区域、要素、风险等多个维度对天气数据展开分析,为天气预报预警信息的直观展示与辅助研判提供支持。
选题背景
这几年极端天气出现得越来越频繁,暴雨、大风、高温这些天气过程对日常生活和生产的影响挺直接的,天气预报和预警信息能不能及时、准确、直观地传到需要的人手里,就显得比较关键。气象部门在运行过程中积累了大量的观测数据和预警记录,这些数据体量大、类型杂、更新快,用传统方式去存储和统计已经有点吃力,更别说从中挖出区域差异、风雨关联、时序变化这些规律。大数据技术慢慢成熟以后,Hadoop、Spark这类框架给气象数据的分布式存储和并行计算提供了可行的路子,用Spark SQL做聚合统计、用ECharts把结果画出来,也成了不少项目常见的做法。正是在这样的背景下,本课题尝试把大数据处理和天气预报预警数据结合起来,做一个可视化与分析系统,让原本分散、难读的数据变得更容易看懂。
选题意义
从实际角度看,这个系统的意义主要体现在把气象数据用起来这件事上。天气预报预警信息本身是公开的,但普通用户看到的往往只是一条条文字,缺少区域之间、时间前后的对比,也看不出风雨之间有没有关联、风险集中在哪些时段。本系统通过气象要素分析、区域对比分析和时序演变分析等功能,把这类信息整理成图表,能在一定程度上帮助使用者更快地把握天气态势。从学习角度看,把Hadoop、Spark、Spark SQL这些大数据技术真正用到一个小型系统里,比单独看文档要理解得深一些,也能把课堂上学到的数据处理知识和实际场景对上。从能力锻炼角度看,从数据存储、计算到后端接口、前端展示,整个流程走一遍,对独立思考能力和工程实践能力都有帮助。当然,受限于个人水平和数据规模,系统还比较基础,只能算是一次尝试,离真正投入业务使用还有距离。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
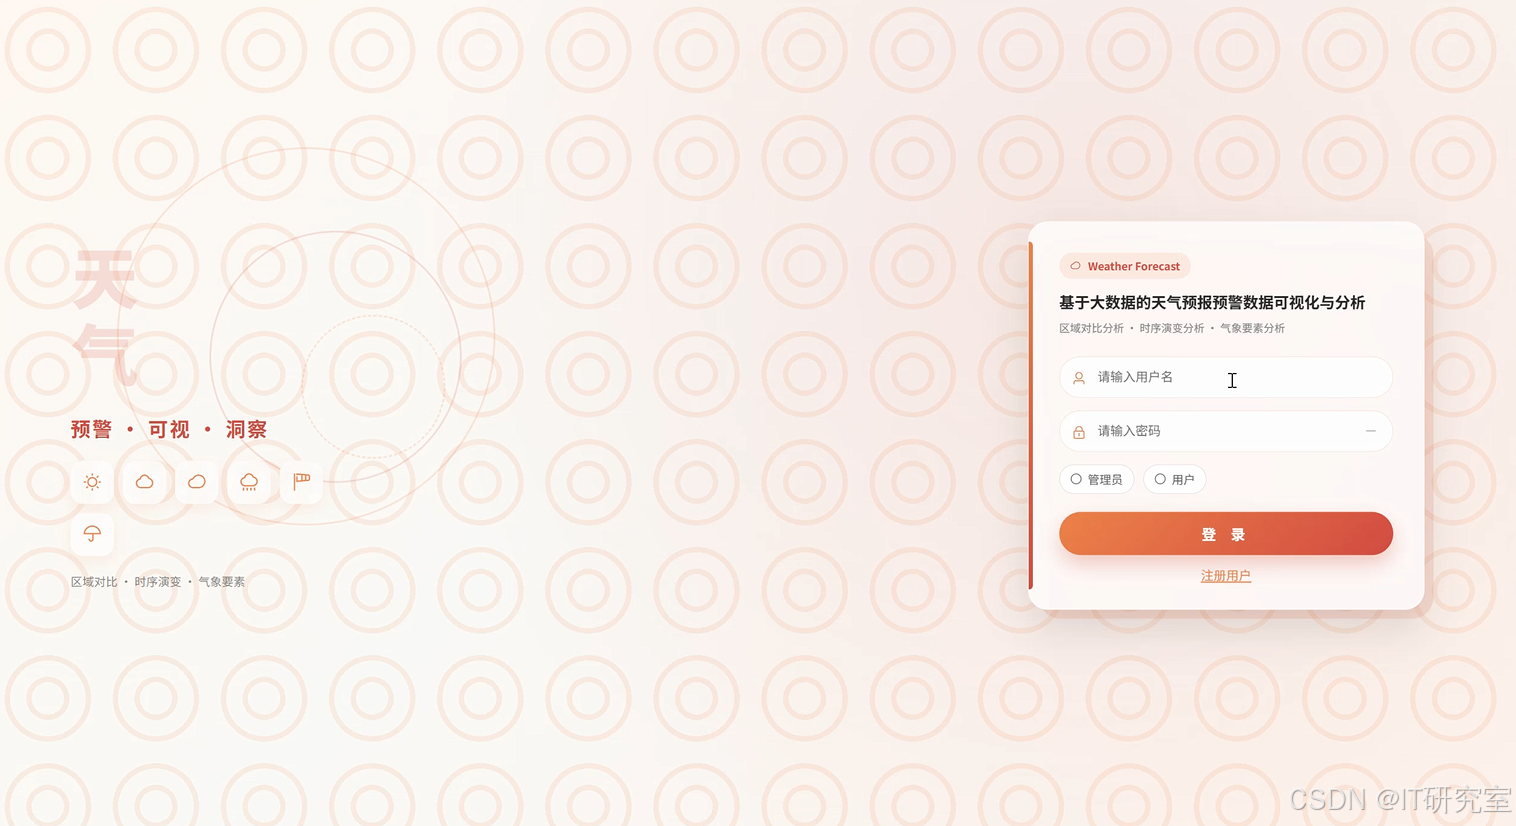
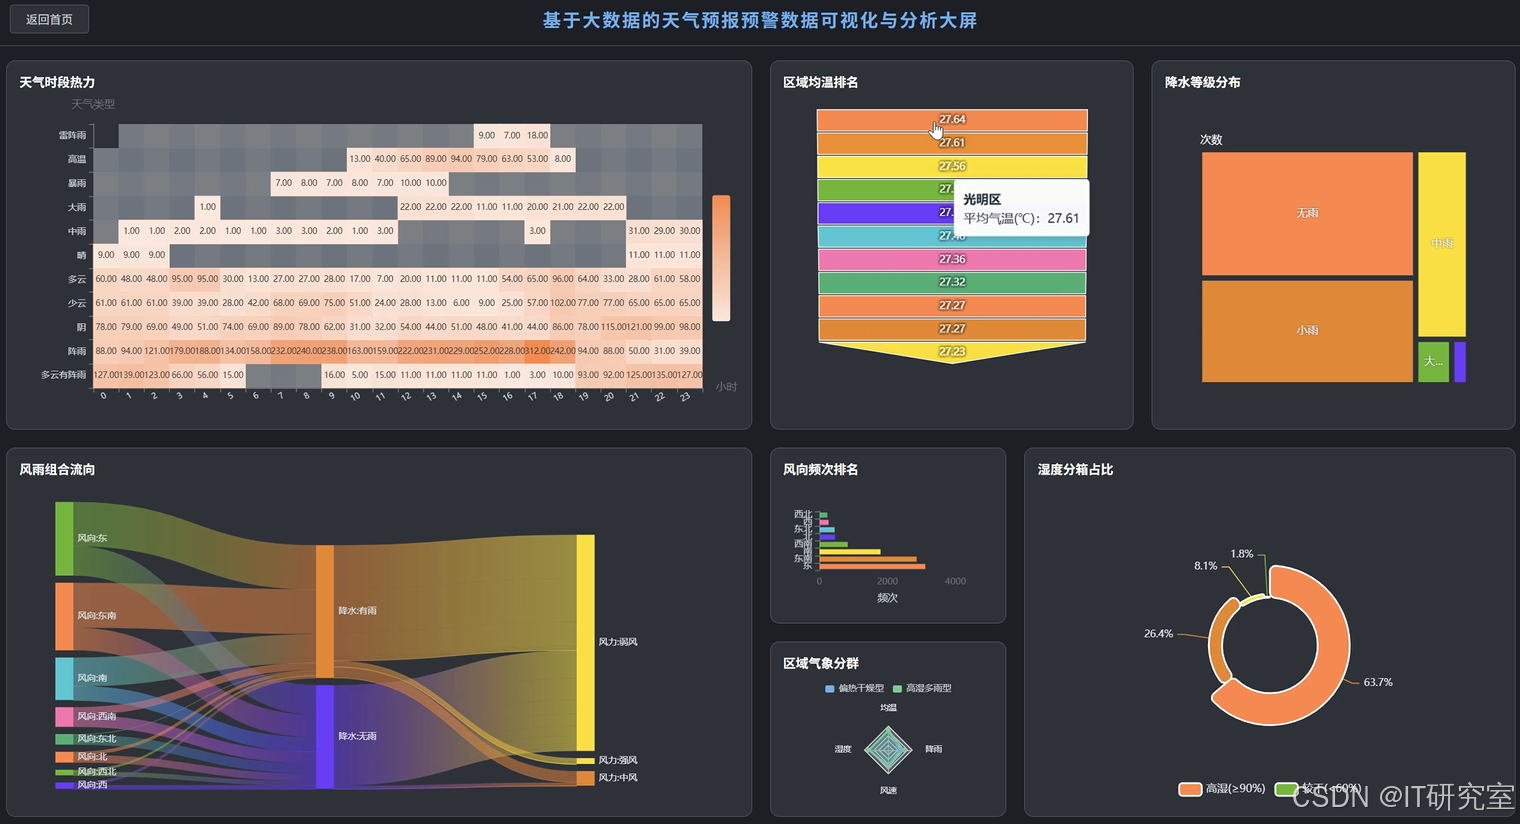
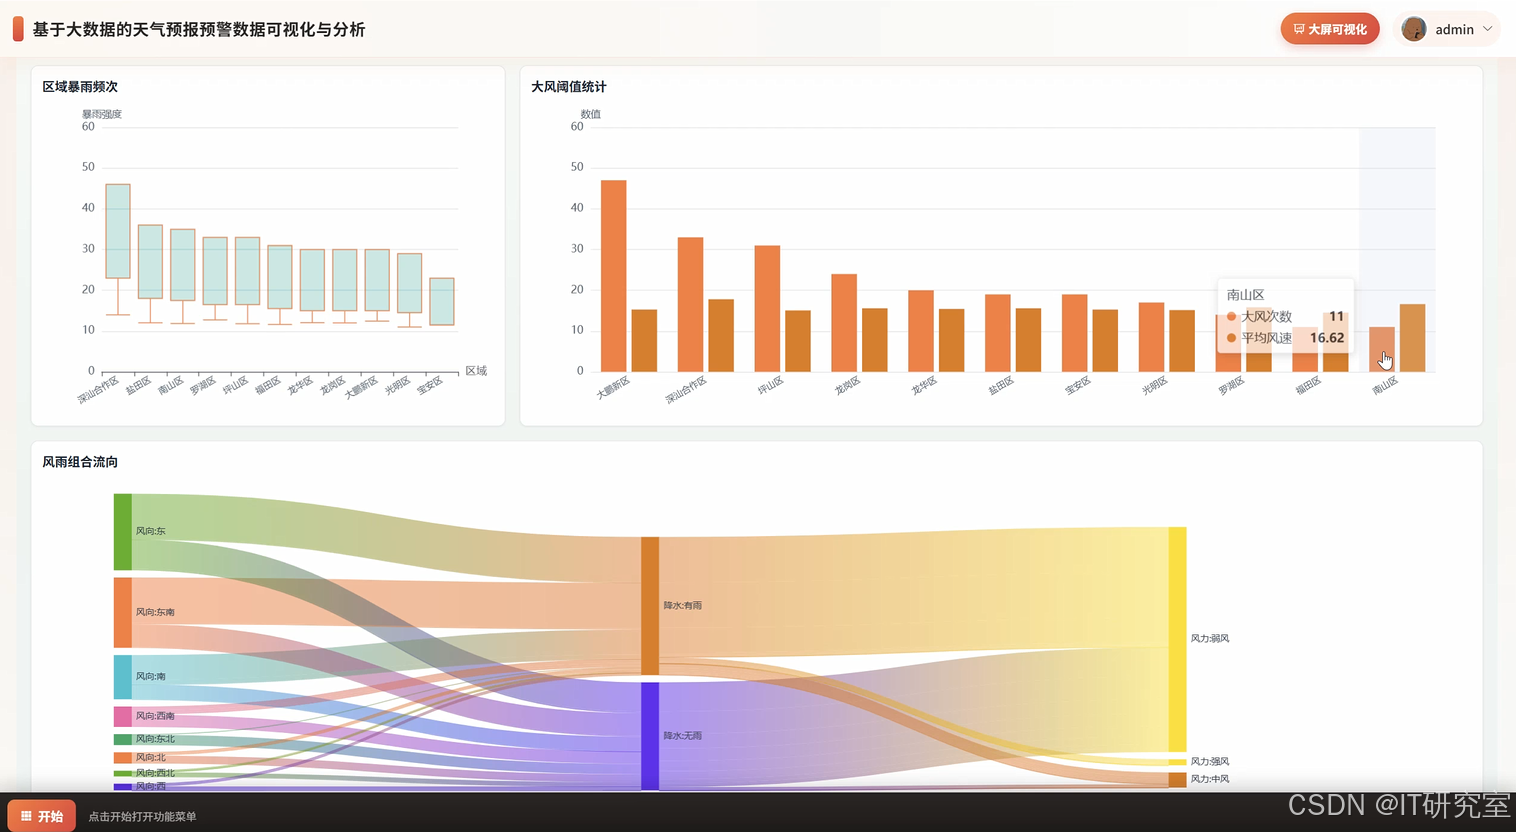
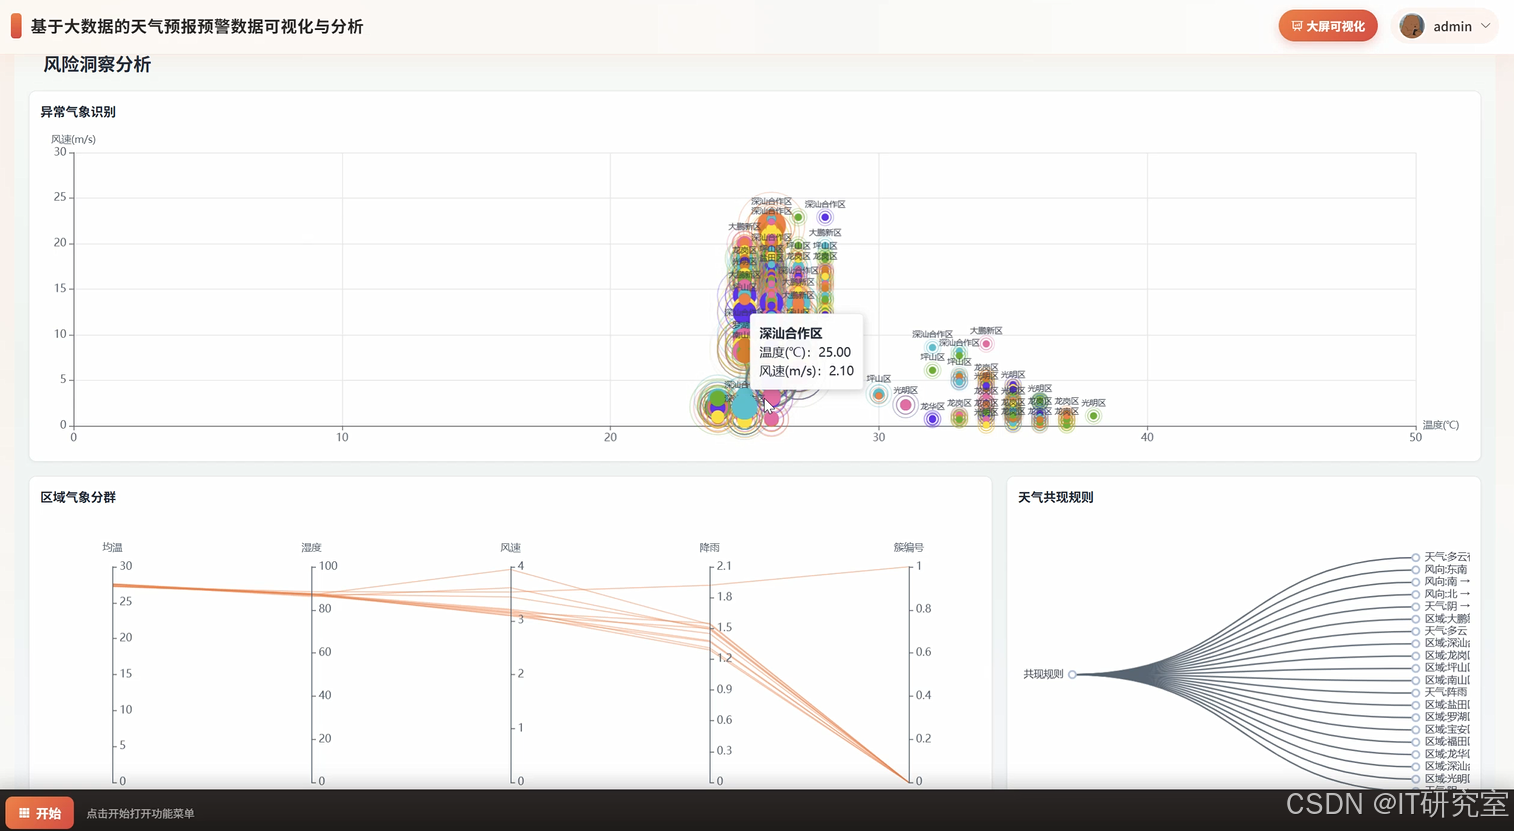
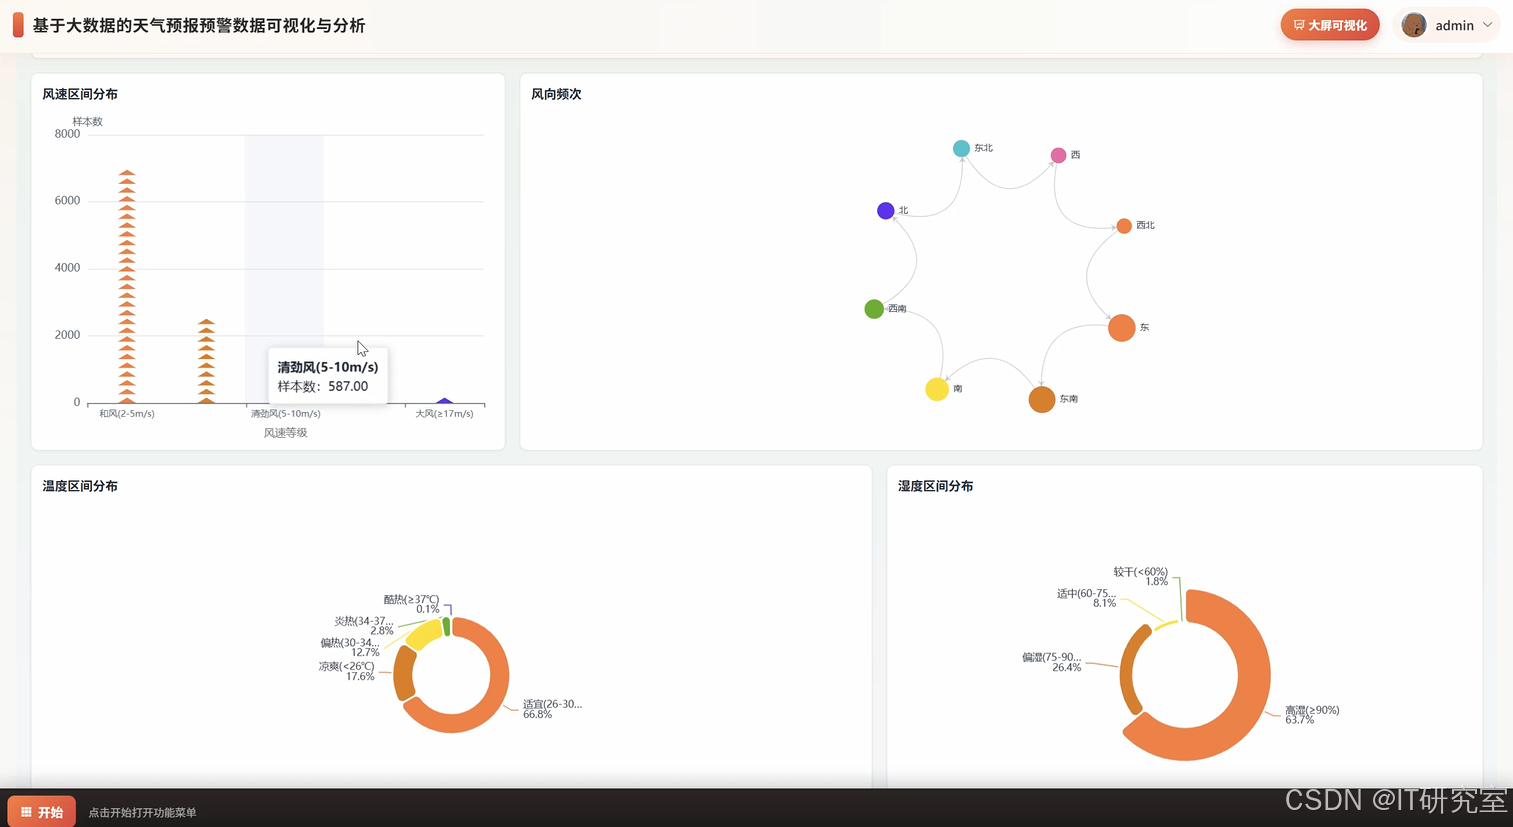
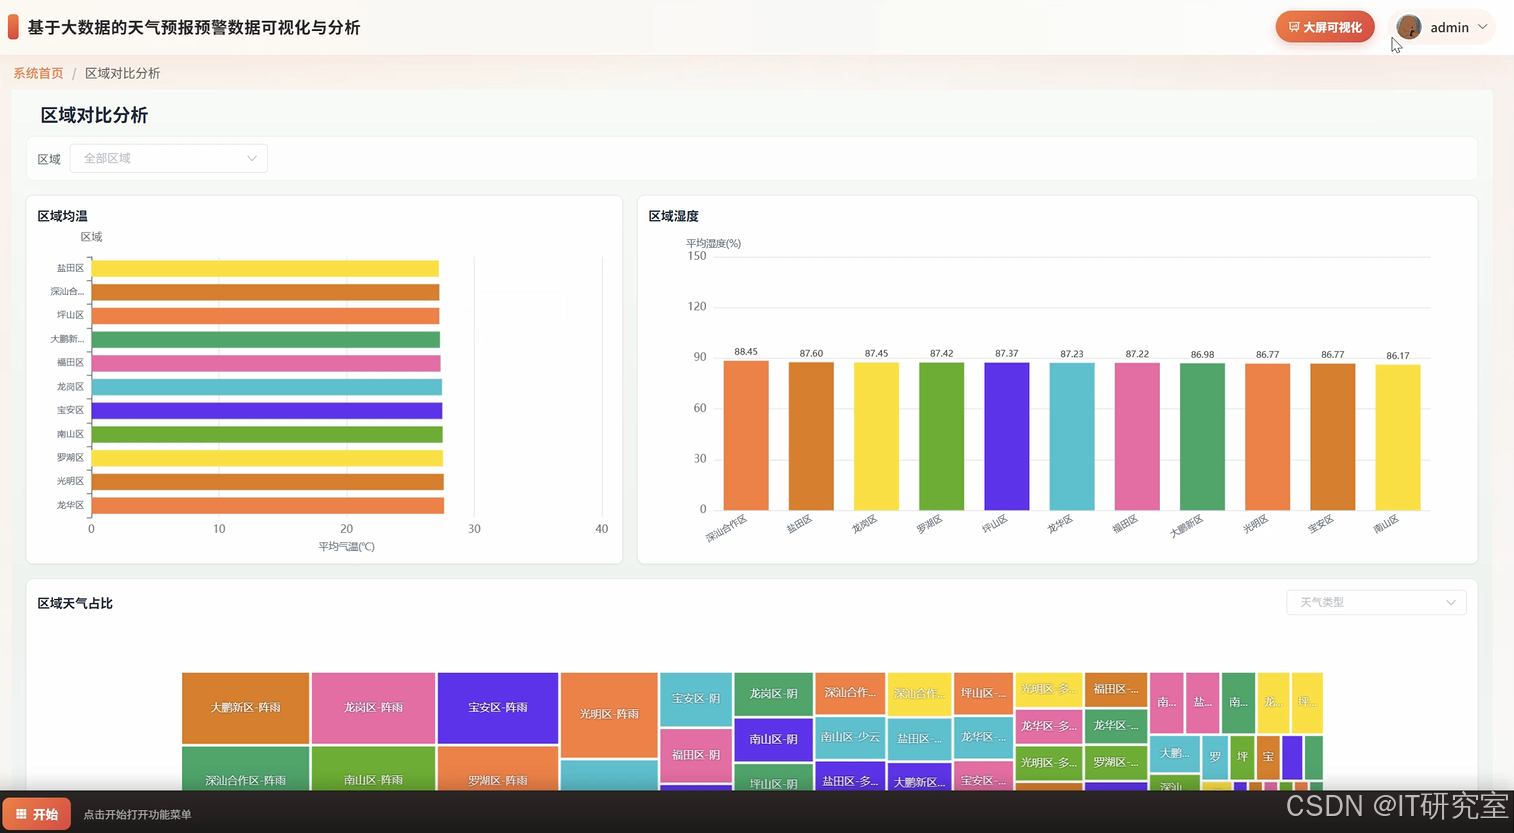
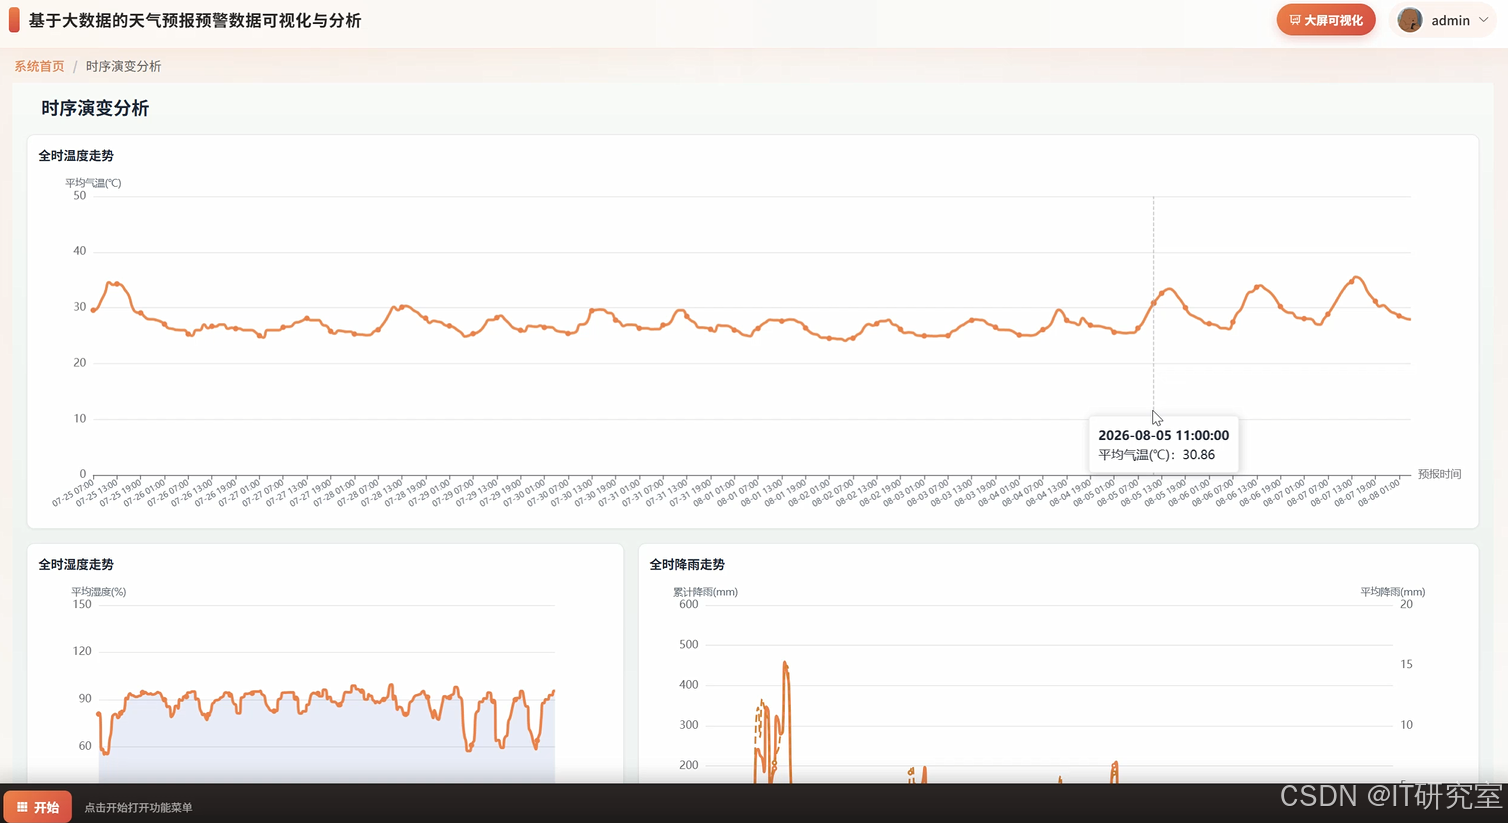
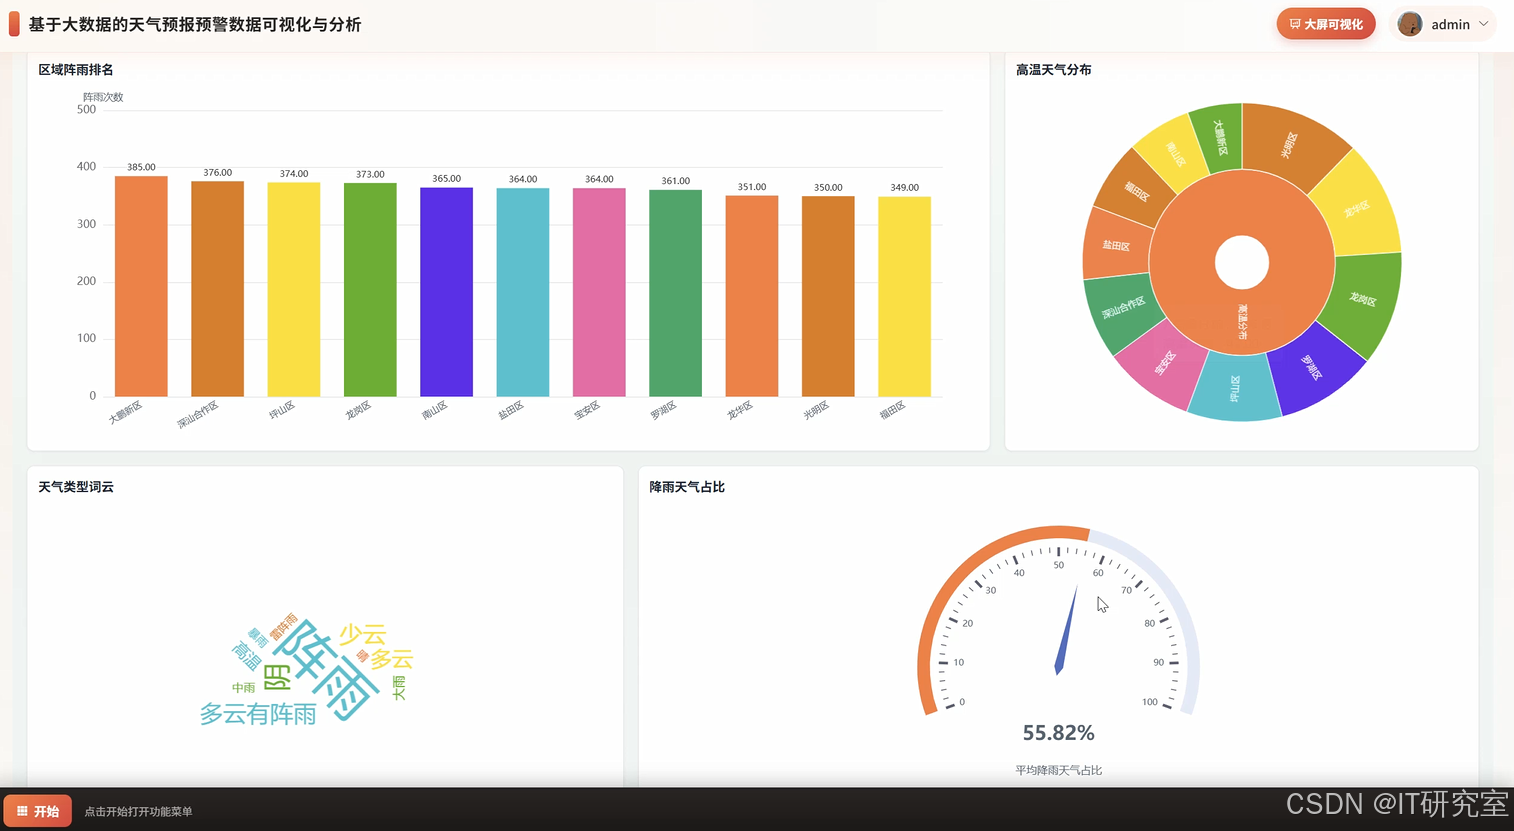
- 基于大数据的天气预报预警数据可视化与分析界面展示:
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, sum as _sum, avg, count, when, date_format, row_number
from pyspark.sql.window import Window
spark = SparkSession.builder.appName("WeatherWarningAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").enableHiveSupport().getOrCreate()
def weather_element_analysis(start_date, end_date, region_code):
    df = spark.read.format("csv").option("header", "true").option("inferSchema", "true").load("hdfs:///weather/element/*.csv")
    df_filter = df.filter((col("obs_date") >= start_date) & (col("obs_date") <= end_date))
    if region_code and region_code != "all":
        df_filter = df_filter.filter(col("region_code") == region_code)
    df_filter = df_filter.withColumn("temp_level", when(col("temperature") >= 35, "高温").when(col("temperature") <= 0, "低温").otherwise("常温"))
    agg_df = df_filter.groupBy("region_code", "temp_level").agg(count("*").alias("record_cnt"), avg("temperature").alias("avg_temp"), avg("humidity").alias("avg_humidity"), avg("wind_speed").alias("avg_wind"), _sum("rainfall").alias("total_rain"))
    result = agg_df.orderBy(col("record_cnt").desc()).limit(200).collect()
    return [{"region": r["region_code"], "level": r["temp_level"], "cnt": r["record_cnt"], "avgTemp": round(r["avg_temp"], 2) if r["avg_temp"] else 0, "avgHumidity": round(r["avg_humidity"], 2) if r["avg_humidity"] else 0, "avgWind": round(r["avg_wind"], 2) if r["avg_wind"] else 0, "totalRain": round(r["total_rain"], 2) if r["total_rain"] else 0} for r in result]
def regional_comparison_analysis(region_list, metric_type, start_date, end_date):
    df = spark.read.format("csv").option("header", "true").option("inferSchema", "true").load("hdfs:///weather/region/*.csv")
    df_filter = df.filter((col("obs_date") >= start_date) & (col("obs_date") <= end_date) & (col("region_code").isin(region_list)))
    if metric_type == "rainfall":
        metric_col = "rainfall"
    elif metric_type == "temperature":
        metric_col = "temperature"
    else:
        metric_col = "wind_speed"
    agg_df = df_filter.groupBy("region_code", date_format(col("obs_date"), "yyyy-MM").alias("month")).agg(avg(metric_col).alias("avg_val"), _sum(metric_col).alias("sum_val"), count("*").alias("cnt"))
    window_spec = Window.partitionBy("month").orderBy(col("avg_val").desc())
    rank_df = agg_df.withColumn("rank", row_number().over(window_spec))
    top_df = rank_df.filter(col("rank") <= 10).orderBy("month", "rank")
    result = top_df.collect()
    return [{"region": r["region_code"], "month": r["month"], "avgVal": round(r["avg_val"], 2), "sumVal": round(r["sum_val"], 2), "cnt": r["cnt"], "rank": r["rank"]} for r in result]
def risk_insight_analysis(warning_type, threshold, region_code):
    df = spark.read.format("csv").option("header", "true").option("inferSchema", "true").load("hdfs:///weather/warning/*.csv")
    df_filter = df.filter(col("warning_type") == warning_type)
    if region_code and region_code != "all":
        df_filter = df_filter.filter(col("region_code") == region_code)
    df_filter = df_filter.withColumn("risk_level", when(col("warning_level") >= 4, "高风险").when(col("warning_level") == 3, "中风险").otherwise("低风险"))
    risk_df = df_filter.groupBy("region_code", "risk_level").agg(count("*").alias("warning_cnt"), avg("warning_level").alias("avg_level"), _sum("affected_population").alias("total_affected"))
    high_risk_df = risk_df.filter((col("risk_level") == "高风险") & (col("warning_cnt") >= threshold))
    insight_df = high_risk_df.withColumn("insight_tag", when(col("total_affected") > 100000, "需重点研判").otherwise("持续关注"))
    result = insight_df.orderBy(col("warning_cnt").desc()).limit(50).collect()
    return [{"region": r["region_code"], "riskLevel": r["risk_level"], "warningCnt": r["warning_cnt"], "avgLevel": round(r["avg_level"], 2), "totalAffected": r["total_affected"], "tag": r["insight_tag"]} for r in result]
五、系统视频
基于大数据的天气预报预警数据可视化与分析项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的天气预报预警数据可视化与分析-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇