文章目录
-
- 一、为什么需要混合精度
- 二、浮点数由什么组成
- 三、FP32:稳定但昂贵
- 四、FP16:快,但范围小
-
- [溢出 overflow](#溢出 overflow)
- [下溢 underflow](#下溢 underflow)
- 五、BF16:范围大,更适合大模型
- 六、混合精度不是全部低精度
- [七、Loss Scaling:解决 FP16 小梯度下溢](#七、Loss Scaling:解决 FP16 小梯度下溢)
- [八、PyTorch AMP:FP16 标准写法](#八、PyTorch AMP:FP16 标准写法)
- [九、BF16 AMP 写法通常更简单](#九、BF16 AMP 写法通常更简单)
- 十、哪些操作容易保留高精度
- 十一、混合精度常见问题排查
-
- [问题 1:loss 变成 NaN](#问题 1:loss 变成 NaN)
- [问题 2:FP16 训练不收敛,BF16 正常](#问题 2:FP16 训练不收敛,BF16 正常)
- [问题 3:开启 AMP 后指标变差](#问题 3:开启 AMP 后指标变差)
- [问题 4:没有明显加速](#问题 4:没有明显加速)
- 十二、训练低精度和推理量化不是一回事
- 十三、工程选型建议
- 十四、常见误区
- 十五、你应该记住的最小心智模型
- 总结
- 大模型视角
- 下一篇
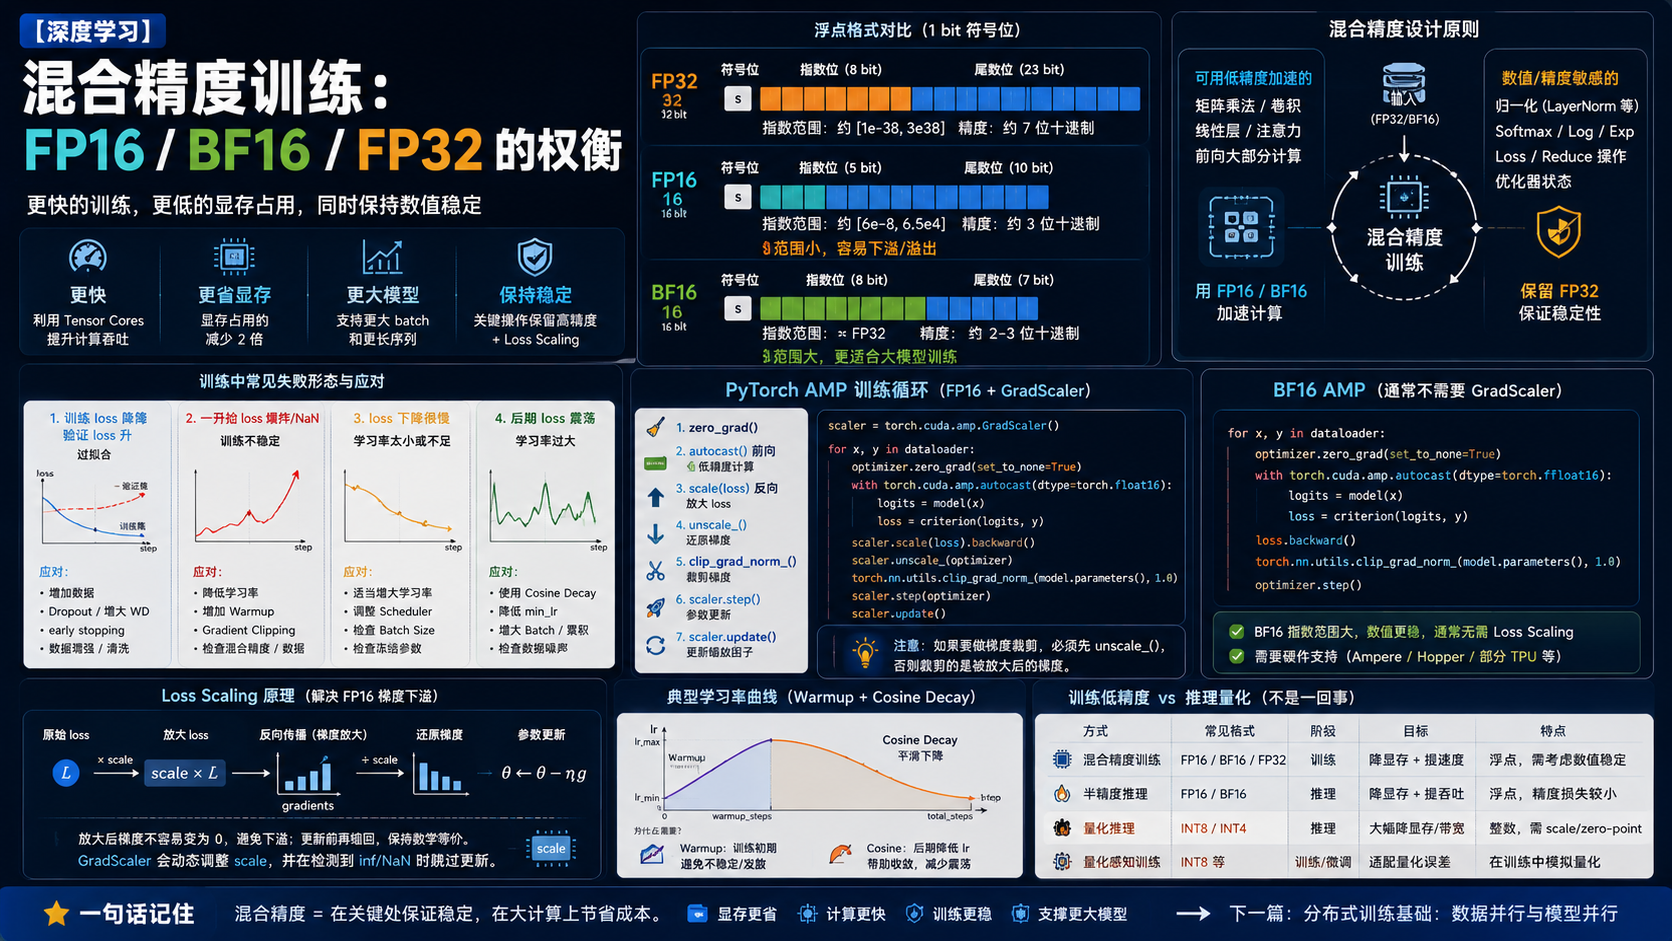
摘要:大模型训练离不开混合精度。全部使用 FP32 稳定但慢、显存大;使用 FP16 可以省显存、提速度,但数值范围小,容易梯度下溢;BF16 保留了接近 FP32 的指数范围,更适合大模型训练,但硬件支持要求更高。混合精度不是"把所有数字都改成半精度",而是让矩阵乘法等计算用低精度加速,同时保留关键参数、梯度缩放和归一化等稳定机制。本文从浮点格式讲起,解释 FP32、FP16、BF16 的区别,为什么需要 Loss Scaling,PyTorch AMP 如何使用,以及训练低精度和推理量化有什么不同。
前置知识 :优化器,归一化,训练配置
阅读时间 :约 65 分钟
代码环境:Python 3.10+,torch >= 2.0,支持 CUDA 或 BF16 的硬件更佳
入门导读:先抓住主线
混合精度要解决的是一个工程矛盾:
text
FP32:稳定,但显存和计算成本高
FP16/BF16:省显存、速度快,但可能数值不稳定
大模型训练要处理海量矩阵乘法。低精度能显著减少显存占用,并利用 GPU Tensor Cores 加速。但训练不是只做矩阵乘法,还包括 loss、softmax、归一化、梯度、优化器状态等环节。某些环节如果精度太低,训练会发散或出现 NaN。
所以混合精度的核心不是"全低精度",而是:
能低精度加速的地方用低精度,容易出数值问题的地方保留更高精度。
读完先达到这个程度就够了:
- 能解释 FP32、FP16、BF16 的范围和精度差异;
- 能理解为什么 FP16 需要 Loss Scaling;
- 能知道 BF16 为什么更适合大模型训练;
- 能写出 PyTorch AMP 的标准训练循环;
- 能区分训练混合精度、推理低精度和量化;
- 能排查常见 NaN、inf、loss 爆炸问题。
带着这 3 个问题读:
- FP16 和 BF16 都是 16 bit,为什么 BF16 通常更稳?
- Loss Scaling 到底在放大什么,为什么能解决下溢?
- 混合精度训练和 INT8/INT4 量化是一回事吗?
一、为什么需要混合精度
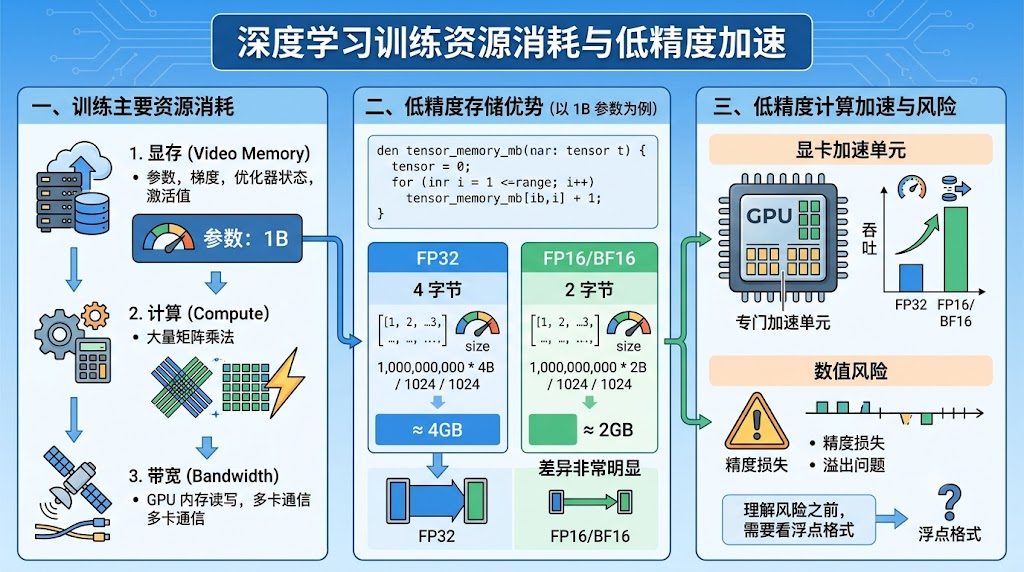
深度学习训练主要消耗三类资源:
- 显存:参数、梯度、优化器状态、激活值;
- 计算:大量矩阵乘法;
- 带宽:GPU 内存读写和多卡通信。
FP32 每个数占 4 字节。FP16/BF16 每个数占 2 字节。同样数量的张量,低精度可以把存储减半。
python
def tensor_memory_mb(num_elements, bytes_per_element):
    return num_elements * bytes_per_element / 1024 / 1024

num_elements = 1_000_000_000
for name, bytes_ in [("FP32", 4), ("FP16/BF16", 2)]:
    print(name, tensor_memory_mb(num_elements, bytes_), "MB")
1B 个数,FP32 约 4GB,FP16/BF16 约 2GB。大模型里参数、激活和 KV Cache 都是海量张量,差异非常明显。
同时,现代 GPU 对低精度矩阵乘法有专门加速单元。使用 FP16/BF16 通常不仅省显存,还能提高吞吐。
但低精度会带来数值风险。理解风险之前,需要先看浮点格式。
二、浮点数由什么组成
浮点数可以粗略拆成三部分:
text
sign     符号位:正数还是负数
exponent 指数位:数值范围有多大
mantissa 尾数位:有效数字有多精细
不同格式的位数分配不同:
| 格式 | 总位数 | 符号位 | 指数位 | 尾数位 | 直觉 |
|---|---|---|---|---|---|
| FP32 | 32 | 1 | 8 | 23 | 范围大,精度高 |
| FP16 | 16 | 1 | 5 | 10 | 精度还行,范围小 |
| BF16 | 16 | 1 | 8 | 7 | 范围接近 FP32,精度较低 |
关键区别在指数位。
FP16 只有 5 个指数位,能表示的最大/最小范围比 FP32 小很多。BF16 虽然也是 16 bit,但它保留了 8 个指数位,和 FP32 一样,所以动态范围更大。
这就是为什么 BF16 在大模型训练中通常比 FP16 更稳:它不容易因为数值太大溢出,也不容易因为数值太小下溢到 0。
三、FP32:稳定但昂贵
FP32 是深度学习里长期使用的默认格式。
优点:
- 数值范围大;
- 精度高;
- 训练稳定;
- 调试简单。
缺点:
- 显存占用大;
- 计算和带宽成本高;
- 大模型训练效率低。
如果模型很小、硬件资源够,FP32 是最省心的选择。但在大模型训练中,全部 FP32 往往成本不可接受。
不仅参数占显存,训练还要存梯度和优化器状态。Adam 优化器通常还会为每个参数保存一阶矩和二阶矩,显存压力会进一步放大。
所以大模型训练必须寻找更经济的数值表示。
四、FP16:快,但范围小
FP16 的好处很直接:每个数只占 2 字节,矩阵乘法可以更快。
但 FP16 的指数位少,动态范围小,容易出现两个问题。
溢出 overflow
数值太大,超过 FP16 能表示的范围,变成 inf。
下溢 underflow
数值太小,低于 FP16 能表示的范围,变成 0。
梯度尤其容易下溢。深层网络里,有些梯度本来就很小,如果用 FP16 存储,可能直接变成 0,参数就学不到。
用一个直观例子:
python
import torch

values = torch.tensor([1e-3, 1e-5, 1e-7, 1e-9], dtype=torch.float32)
print("fp32:", values)
print("fp16:", values.to(torch.float16))
你会看到很小的数在 FP16 中可能被舍入甚至变成 0。
这就是 FP16 训练需要 Loss Scaling 的原因。
五、BF16:范围大,更适合大模型
BF16 全称 Brain Floating Point 16。它也是 16 bit,但指数位和 FP32 一样是 8 位。
这意味着 BF16 的动态范围接近 FP32,不容易溢出或下溢。代价是尾数位只有 7 位,精度比 FP16 更粗。
为什么大模型训练更喜欢 BF16?
因为训练稳定性通常更怕范围不够,而不是尾数少一点。矩阵乘法和梯度传播中,数值跨越范围很大,BF16 的大指数范围非常有用。
用代码看 BF16 对小数的保留情况:
python
import torch

values = torch.tensor([1e-3, 1e-5, 1e-10, 1e-30], dtype=torch.float32)
print("fp32 :", values)
print("fp16 :", values.to(torch.float16))
print("bf16 :", values.to(torch.bfloat16))
在支持 BF16 的硬件上,BF16 通常可以减少 FP16 的 loss scaling 复杂度,训练更稳。
但 BF16 需要硬件支持。不是所有 GPU 都对 BF16 有同等加速能力。
六、混合精度不是全部低精度
混合精度训练里,通常会发生这些事情:
- 矩阵乘法、卷积等高吞吐计算使用 FP16/BF16;
- 某些归一化(LayerNorm/BatchNorm)、softmax、loss、reduction/累加类操作会自动回退到 FP32 计算;
- 优化器状态常常保留 FP32;
- FP16 训练可能使用 loss scaling;
- 参数可能有低精度副本和 FP32 master copy。
这就是"mixed precision"的含义。
如果你简单把所有参数和计算都 .half(),可能很快遇到 NaN 或训练质量下降。
PyTorch AMP 里这些精度选择通常不用手动指定 :你只要用 with torch.autocast(device_type="cuda", dtype=torch.float16): 包住前向计算,PyTorch 内部维护了一份"算子精度白名单/黑名单"(autocast op reference),比如:matmul/linear/conv 会自动转 FP16,softmax/layer_norm/log/exp/mean/sum/loss 类算子会自动保留 FP32。所以你写的模型代码通常不需要在 Norm/Softmax/Loss 前手动 .float(),AMP 会处理好------除非你手写了自定义 CUDA kernel 或用了不在白名单里的算子。
七、Loss Scaling:解决 FP16 小梯度下溢
FP16 的主要问题之一是小梯度下溢。Loss Scaling 的思路很简单:
- 把 loss 乘以一个较大的 scale;
- 反向传播时,梯度也会被同比例放大;
- 在 optimizer 更新前,再把梯度除回去。
为什么这有用?
因为放大后的梯度不容易在 FP16 中变成 0。更新前再缩回来,不改变数学上的真实梯度方向。
简化示意:
python
scale = 1024.0
loss = criterion(logits, labels)
scaled_loss = loss * scale
scaled_loss.backward()

for p in model.parameters():
    if p.grad is not None:
        p.grad /= scale

optimizer.step()
真实训练不要自己手写这段,PyTorch 的 GradScaler 会处理动态 scaling、inf 检测和跳过异常 step。
八、PyTorch AMP:FP16 标准写法
PyTorch AMP 通常使用 autocast 和 GradScaler。
python
import torch
import torch.nn as nn

model = nn.Sequential(nn.Linear(128, 256), nn.ReLU(), nn.Linear(256, 10)).cuda()
optimizer = torch.optim.AdamW(model.parameters(), lr=3e-4)
criterion = nn.CrossEntropyLoss()
scaler = torch.amp.GradScaler("cuda")

for step in range(100):
    x = torch.randn(32, 128, device="cuda")
    y = torch.randint(0, 10, (32,), device="cuda")

    optimizer.zero_grad(set_to_none=True)

    with torch.amp.autocast("cuda", dtype=torch.float16):
        logits = model(x)
        loss = criterion(logits, y)

    scaler.scale(loss).backward()
    scaler.unscale_(optimizer)
    torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
    scaler.step(optimizer)
    scaler.update()
注意顺序:
text
scale(loss).backward()
unscale_(optimizer)
clip_grad_norm_
scaler.step(optimizer)
scaler.update()
如果要做梯度裁剪,应该先 unscale_,否则裁剪的是被放大后的梯度。
九、BF16 AMP 写法通常更简单
BF16 由于动态范围大,通常不需要 GradScaler。
python
import torch
import torch.nn as nn

model = nn.Sequential(nn.Linear(128, 256), nn.ReLU(), nn.Linear(256, 10)).cuda()
optimizer = torch.optim.AdamW(model.parameters(), lr=3e-4)
criterion = nn.CrossEntropyLoss()

for step in range(100):
    x = torch.randn(32, 128, device="cuda")
    y = torch.randint(0, 10, (32,), device="cuda")

    optimizer.zero_grad(set_to_none=True)

    with torch.amp.autocast("cuda", dtype=torch.bfloat16):
        logits = model(x)
        loss = criterion(logits, y)

    loss.backward()
    torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
    optimizer.step()
当然,是否能用 BF16 取决于硬件和框架支持。
如果你在不支持 BF16 加速的设备上强行使用,可能得不到速度收益,甚至更慢。
十、哪些操作容易保留高精度
AMP 会根据算子特性自动选择精度,但理解哪些操作敏感很有帮助。
常见对数值敏感的操作包括:
- softmax;
- cross entropy;
- layer norm / rms norm;
- reduce sum / mean;
- 指数、对数;
- 很小或很大的梯度累积;
- 优化器状态更新。
例如 attention 里的 softmax,如果分数范围很大,低精度下更容易出现数值问题。实际实现通常会做稳定化处理,比如减去最大值再 softmax。
python
import torch

scores = torch.tensor([1000.0, 1001.0, 1002.0])
probs_bad = torch.exp(scores) / torch.exp(scores).sum()
probs_good = torch.softmax(scores, dim=0)

print(probs_good)
torch.softmax 内部会做稳定处理。不要自己随便写不稳定版本。
十一、混合精度常见问题排查
问题 1:loss 变成 NaN
可能原因:
- 学习率太大;
- FP16 overflow;
- loss scaling 不稳定;
- softmax/log 出现异常;
- 数据中有 NaN/inf;
- 梯度爆炸。
排查方法:
python
print(torch.isnan(loss).item(), torch.isinf(loss).item())

for name, p in model.named_parameters():
    if p.grad is not None and torch.isnan(p.grad).any():
        print("nan grad:", name)
问题 2:FP16 训练不收敛,BF16 正常
可能是 FP16 动态范围不够。优先使用 BF16,或检查 GradScaler、学习率和归一化层。
问题 3:开启 AMP 后指标变差
可能原因:
- 某些自定义算子没有正确处理精度;
- loss 或 metric 计算被低精度影响;
- 梯度裁剪顺序错误;
- 学习率需要微调。
问题 4:没有明显加速
可能原因:
- 硬件不支持对应低精度加速;
- batch 太小,GPU 利用率低;
- 数据加载成为瓶颈;
- 模型中低精度友好的矩阵乘法占比不高;
- CPU/GPU 同步过多。
混合精度不是魔法开关,它需要硬件、模型结构和训练循环配合。
十二、训练低精度和推理量化不是一回事
很多人会把 FP16/BF16 训练和 INT8/INT4 量化混在一起。
它们不是一回事。
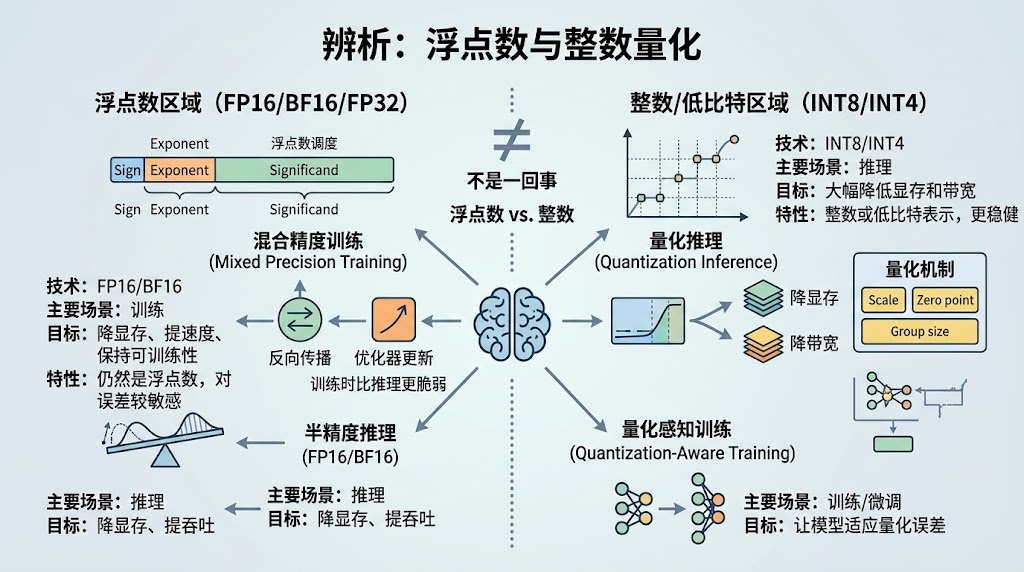
| 技术 | 常见格式 | 主要场景 | 目标 |
|---|---|---|---|
| 混合精度训练 | FP16/BF16/FP32 | 训练 | 降显存、提速度、保持可训练性 |
| 半精度推理 | FP16/BF16 | 推理 | 降显存、提吞吐 |
| 量化推理 | INT8/INT4 | 推理 | 大幅降低显存和带宽 |
| 量化感知训练 | INT8 等 | 训练/微调 | 让模型适应量化误差 |
FP16/BF16 仍然是浮点数。INT8/INT4 是整数或低比特表示,需要 scale、zero point、group size 等额外机制。
训练时通常比推理更脆弱,因为反向传播和优化器更新对数值误差更敏感。
十三、工程选型建议
可以按硬件和任务做一个粗略判断。
| 场景 | 建议 |
|---|---|
| 小模型调试 | FP32 最省心 |
| 支持 BF16 的现代 GPU/TPU | 优先 BF16 混合精度 |
| 只支持 FP16 加速 | FP16 + GradScaler |
| 大模型预训练 | BF16 常见,配合分布式和稳定策略 |
| LoRA/QLoRA 微调 | BF16/FP16 常见,底座可能 4bit 量化 |
| 推理部署 | FP16/BF16 或 INT8/INT4,看质量和成本 |
如果你只是学习代码,可以先用 FP32 跑通,再切 AMP。这样更容易定位错误。
如果你在真实训练中遇到 NaN,优先检查学习率、数据、GradScaler、梯度裁剪和是否可改用 BF16。
十四、常见误区
误区 1:FP16 和 BF16 都是 16 位,所以差不多。
它们位数相同,但指数位不同。BF16 动态范围接近 FP32,通常更适合大模型训练。
误区 2:混合精度就是把模型 .half()。
直接全半精度容易出数值问题。推荐使用 AMP,让框架管理算子精度。
误区 3:Loss Scaling 会改变训练目标。
正确使用时,loss 放大后梯度会在更新前缩回,不改变真实优化目标,只是避免 FP16 下溢。
误区 4:用了 BF16 就一定不会 NaN。
BF16 更稳,但学习率过大、数据异常、softmax 不稳定等仍然会导致 NaN。
误区 5:混合精度和量化是一回事。
混合精度训练主要使用浮点低精度;INT8/INT4 量化是另一套表示和误差控制机制。
误区 6:低精度只影响显存,不影响结果。
低精度会影响数值误差和训练稳定性,需要验证指标和 loss 曲线。
十五、你应该记住的最小心智模型
FP32、FP16、BF16 可以这样记:
text
FP32:范围大、精度高、成本高
FP16:成本低、速度快、范围小,需要 loss scaling
BF16:成本低、范围大、精度粗,但大模型训练更稳
混合精度可以这样记:
text
矩阵乘法等大计算用低精度
数值敏感操作保留高精度
FP16 用 GradScaler 防下溢
BF16 通常更省心
训练排错时先看:
text
loss 是否 NaN
梯度是否 inf/nan
学习率是否过大
GradScaler 顺序是否正确
是否可以使用 BF16
总结
混合精度训练是大模型工程的基础能力。FP32 稳定但成本高;FP16 省显存、速度快,但动态范围小,容易下溢和溢出,需要 Loss Scaling;BF16 保留接近 FP32 的指数范围,通常更适合大模型训练,但依赖硬件支持。
正确的混合精度不是全低精度,而是在速度、显存和稳定性之间做分工:能安全低精度的计算低精度执行,敏感操作和优化器状态保留更高精度。PyTorch AMP 提供了标准工具,FP16 通常配合 GradScaler,BF16 通常更简单。
第一遍记住一句话:混合精度的目标不是牺牲正确性换速度,而是在关键地方保留稳定性,在大计算上节省成本。
大模型视角
后续你看大模型预训练、LoRA/QLoRA、推理部署和量化时,会不断遇到 dtype:FP32、FP16、BF16、FP8、INT8、INT4。理解本篇后,你会更清楚训练为什么偏爱 BF16,推理为什么会做 INT4,为什么 NaN 问题常常和学习率、softmax、loss scaling、梯度裁剪一起排查。
下一篇
分布式训练基础:数据并行与模型并行 ------ 混合精度降低单卡显存和计算成本,但大模型仍然需要多卡协作。下一篇看数据并行、模型并行、ZeRO 和 FSDP 如何把训练扩展到多 GPU。