用 create_agent 搭 Agent 的时候,首先要指定模型。
很多情况下,模型指定完就不再变化,从任务开始到结束,用的都是这一个。
这就是静态模型。
但有一件事得先说清楚:
模型的能力,会直接影响这个 Agent 最终做出来的效果。
任务一复杂,问题就出来了。有的步骤简单,用便宜的小模型就够;
有的步骤要做复杂推理,得用能力更强的。
一个模型从头用到尾,要么成本偏高,要么在关键步骤上能力不够。
于是就有了另一条路,叫动态模型。
这篇就把两件事说清楚:
它们各是什么,什么时候该用哪个。
区别就在一句话上
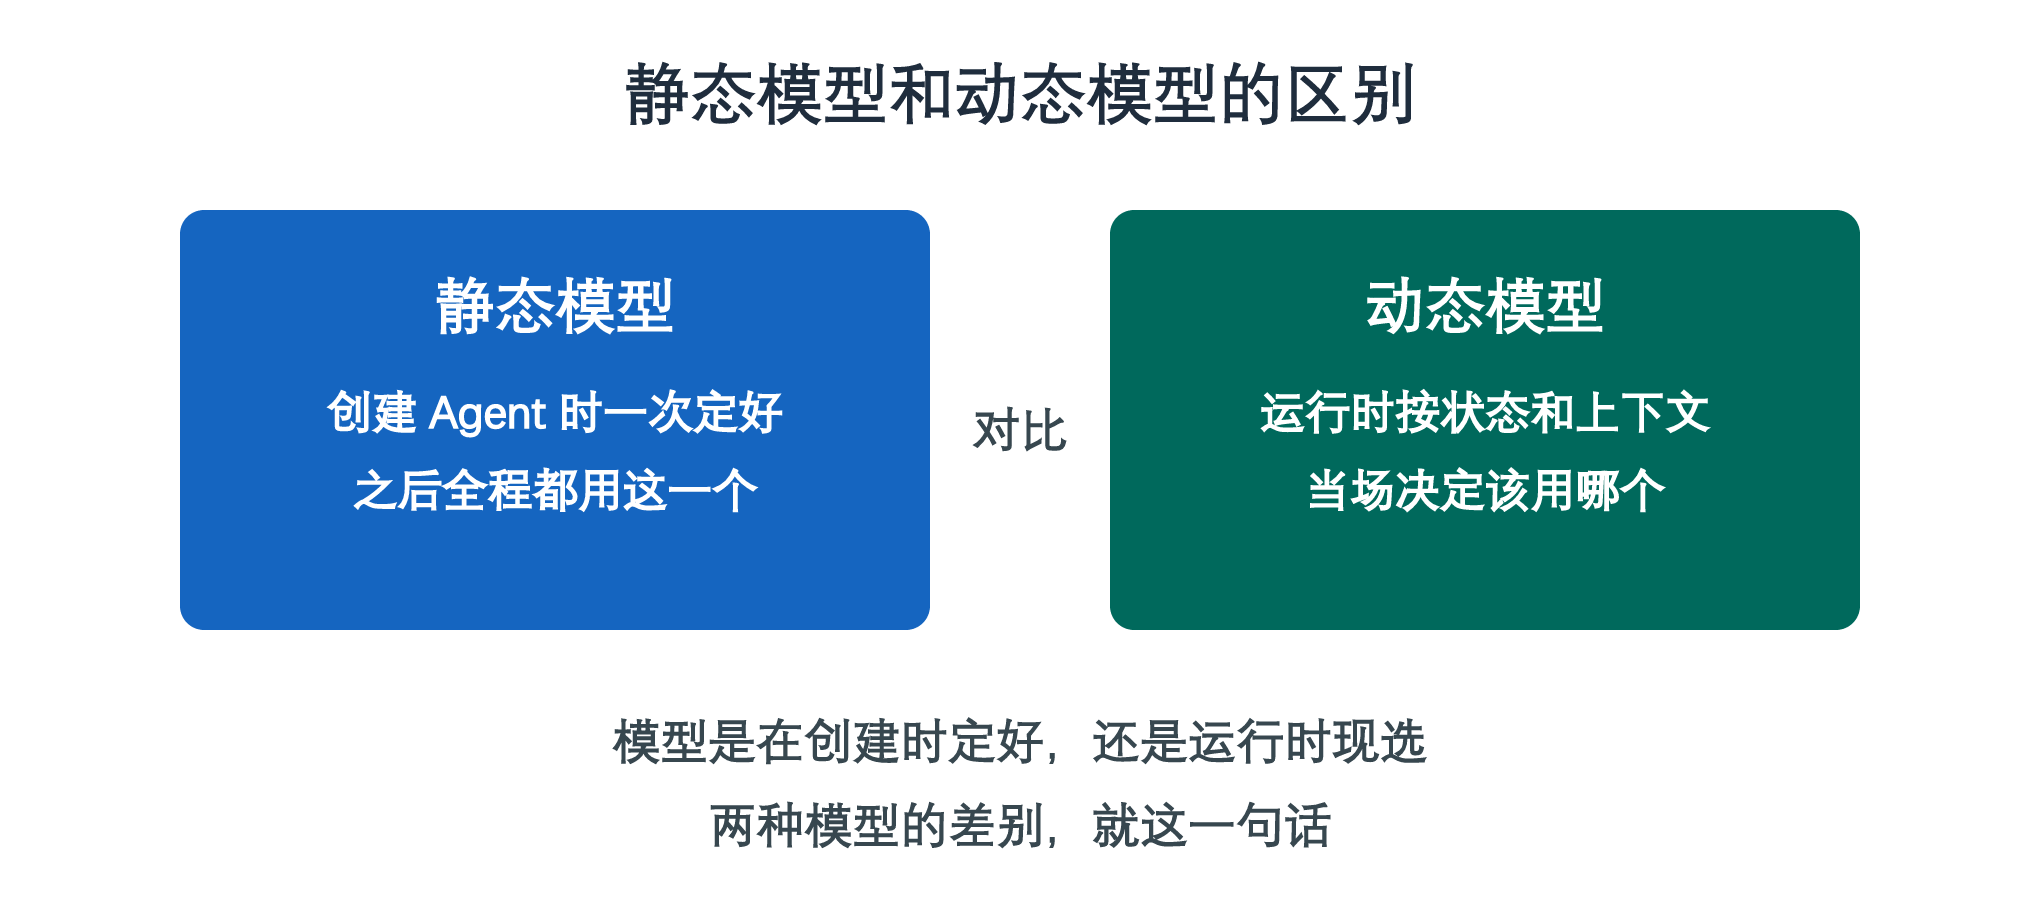
两种模型的差别,就这一句话:
模型是在创建 Agent 的时候一次定好的,还是运行过程中按当时的情况临时选的。
静态模型是最常见的做法。
创建 Agent 的时候把模型指定好,之后整个任务执行过程,都用这一个。
动态模型不一样。
模型不在创建时定死。
Agent 跑到某一步,根据当时的状态和上下文,当场决定该用哪个。
打个比方,静态模型像一条流水线,从头到尾都是同一批工人;
动态模型像有个调度员在看单子派工,简单的活派普通工人,复杂的活派老师傅。
静态模型适合的三种场景
1.通用型 Agent
标准客服系统、个人助理这类,如果功能相对固定、不需要中途换模型,一个模型从头用到尾就够了。
2.原型验证
刚动手做一个新 Agent,先求把流程跑通,效果后面再调。
这时候用静态模型最省事,不用过早设计复杂的模型路由,等真有需要了再调整。
3.确定性任务
数据提取、文本分类这类任务,对模型能力的要求通常比较稳定。
这种任务里,稳定是首要目标,一个模型全程跑下来就行。
动态模型什么时候值得用
先交代实现方式。
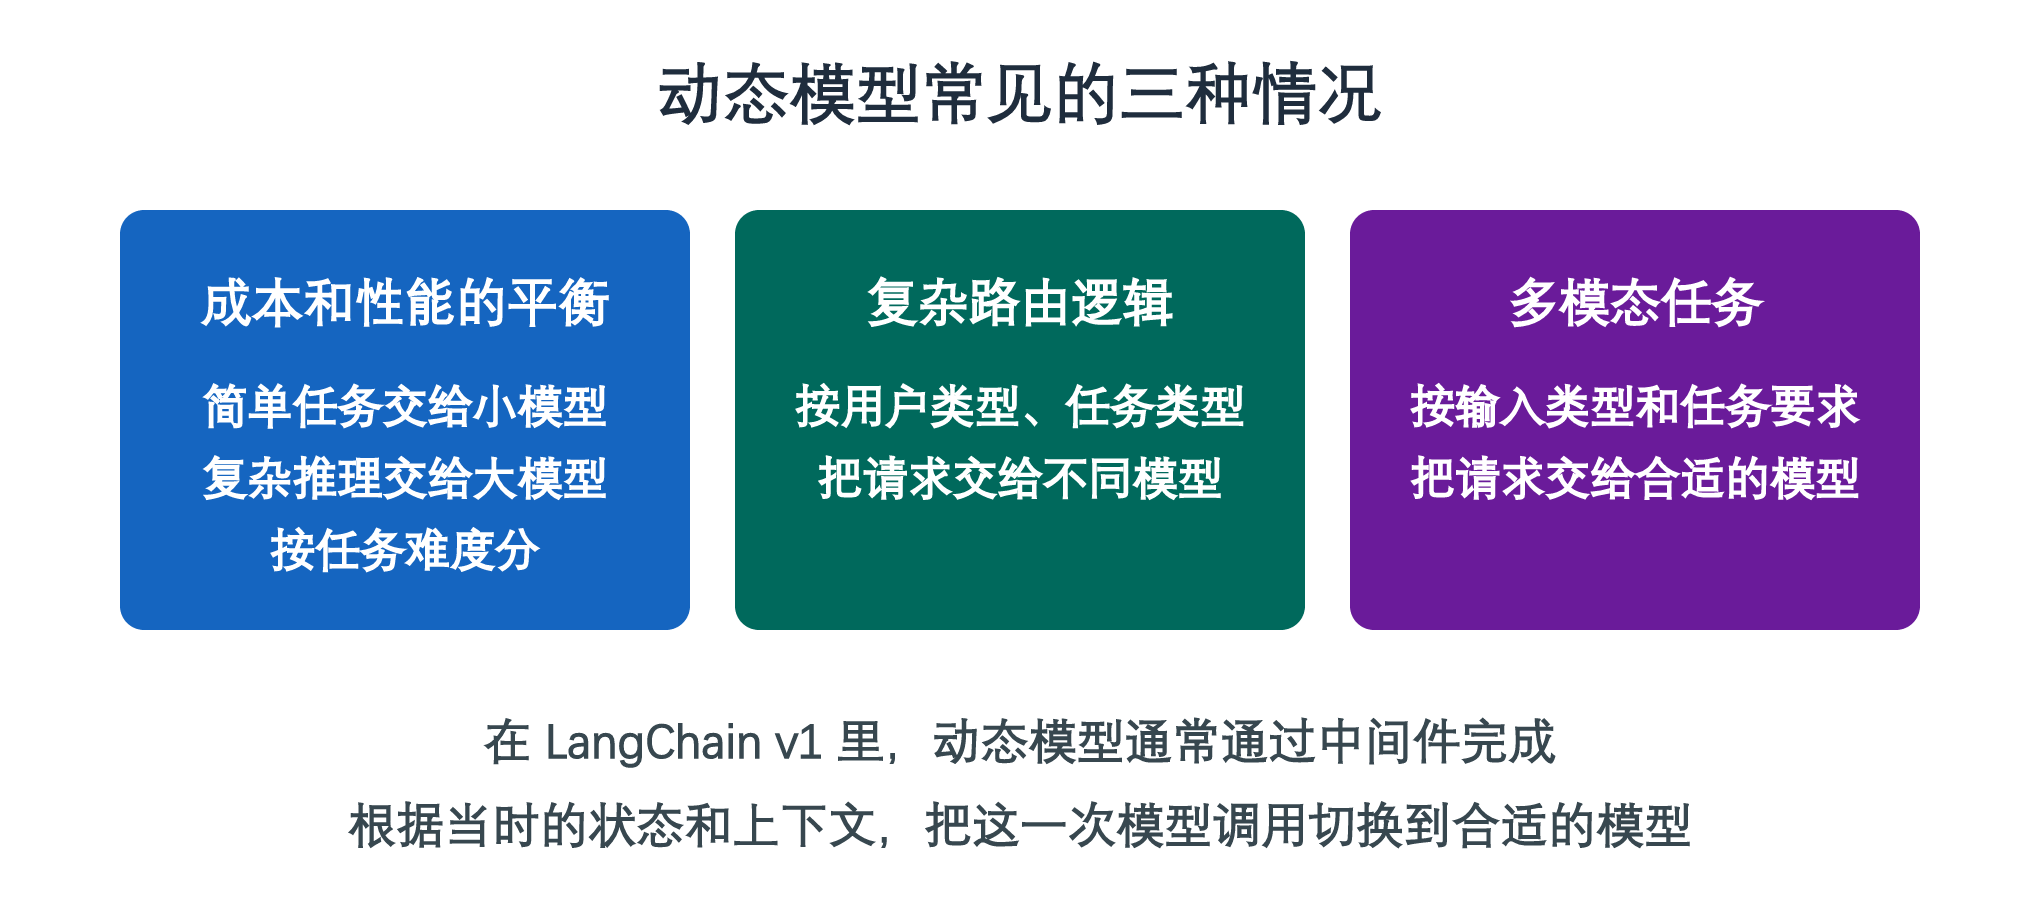
动态模型的实现,在 LangChain v1 里通常通过中间件完成:
在 Agent 运行过程中,根据当时的状态和上下文,把这一次模型调用切换到合适的模型。
常见的有三种情况。
1.成本和性能的平衡
不同模型的调用成本可能差很多。
简单任务交给便宜的小模型,花的钱少;
复杂推理交给贵一些的大模型,效果更有保障。
哪一步用哪个模型,按任务难度分,有机会把整体成本压下来。
2.复杂路由逻辑
同一个 Agent,面对的人不一样,任务类型也不一样,要求自然不同。
比如普通咨询,交给小模型就够;
涉及专业分析,可以换成能力更强的模型。
也可以按用户类型、任务类型这些运行时信息,把请求交给不同模型。
3.多模态任务
一条请求里可能同时带着文本、图片、音频等不同类型的输入。
不同模型支持、擅长处理的数据类型不一样。
动态模型可以根据输入类型和任务要求,把请求交给合适的模型。
两边怎么选
| 项目 | 静态模型 | 动态模型 |
|---|---|---|
| 模型什么时候定 | 创建 Agent 时一次定好 | 运行时按状态和上下文现选 |
| 中途换不换 | 不换,全程一个模型 | 按需切换 |
| 实现复杂度 | 简单,指定一次就完 | 要增加模型选择逻辑,通常结合中间件实现 |
| 适合的场景 | 通用 Agent、原型验证、确定性任务 | 控制成本、按任务分流、多模态 |
落到实操,可以先这么走:
刚上手的时候,先用静态模型把流程跑通。
等真的碰上成本太高、请求要分流、输入类型太杂这类具体问题,再考虑换动态模型也不迟。