🌸雨落在了我的手上:个人主页
🐟个人仓库:Gitee仓库
❄️个人专栏:<<JaveSe>> <<C语言>> <<C语言数据结构>>**
🔥🔥🔥 人生格言:无人扶我青云志,我自踏雪至山巅
🎬 博主简介:
目录
内容大纲:
本文系统介绍了二叉搜索树的概念、插入、查找与删除操作,重点讲解了删除的三种情况及替换法实现。结合代码演示了其在Java中TreeMap和TreeSet的应用,强调其基于红黑树的动态高效查找特性。同时对比了Map与Set的模型差异,说明了键值对与纯键结构的区别,并详细解析了TreeMap与HashMap、TreeSet与HashSet在底层结构、性能、有序性及线程安全等方面的异同,适用于动态数据场景下的高效搜索与去重需求。
一:搜索树
1.概念
⼆叉搜索树⼜称⼆叉排序树,它或者是⼀棵空树,或者是具有以下性质的⼆叉树:
• 若它的左⼦树不为空,则左⼦树上所有节点的值都⼩于根节点的值
• 若它的右⼦树不为空,则右⼦树上所有节点的值都⼤于根节点的值
• 它的左右⼦树也分别为⼆叉搜索树
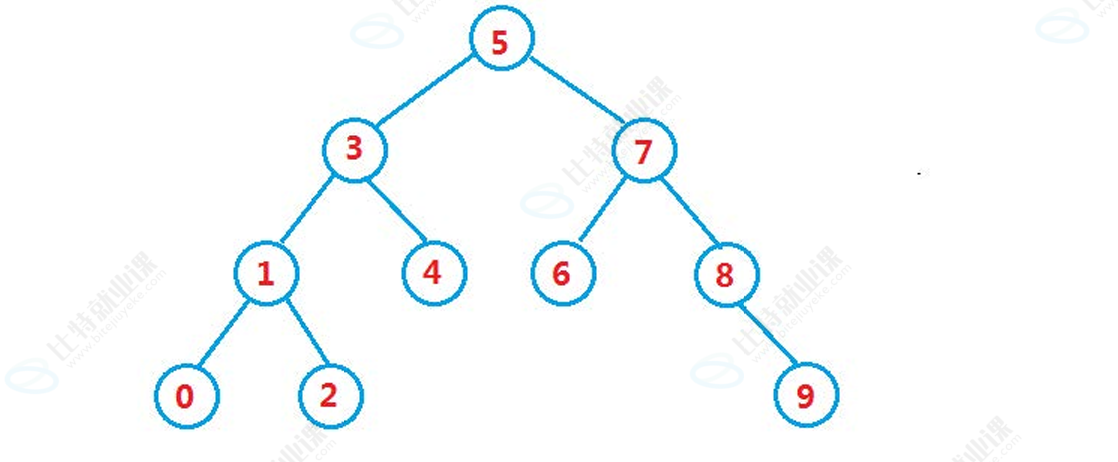
int\[\] array = {5,3,4,1,7,8,2,6,0,9};
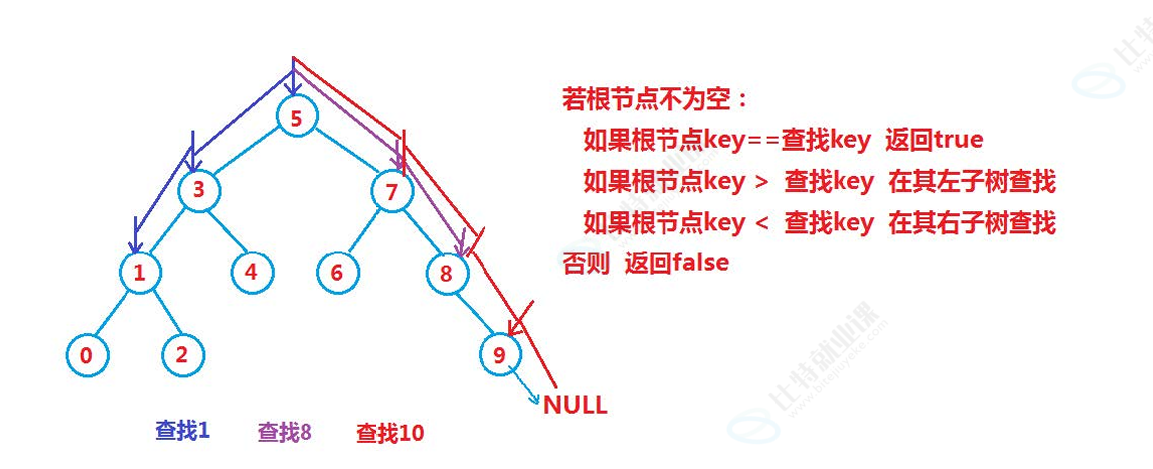
2.操作-查找
3.操作-插⼊
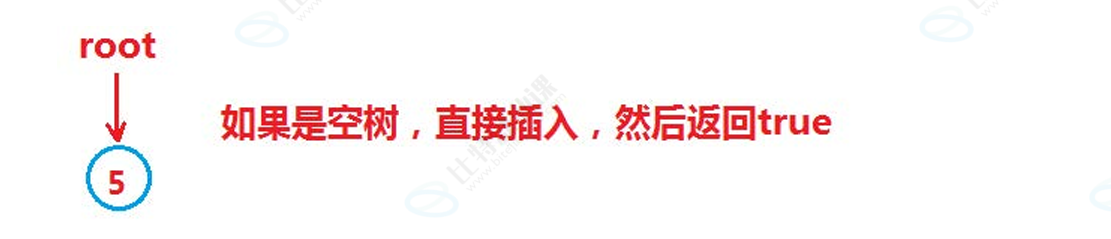
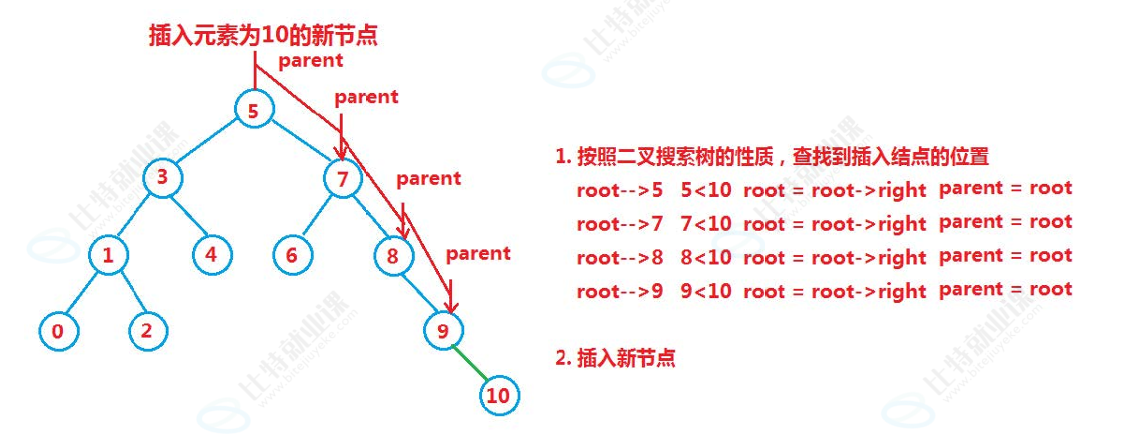
如果树为空树,即根==null,直接插⼊
如果树不是空树,按照查找逻辑确定插⼊位置,插⼊新结点
4.操作-删除(难点)
设待删除结点为cur,待删除结点的双亲结点为parent
1.cur.left == null
a. cur是root,则root=cur.right
b. cur不是root,cur是parent.left,则parent.left=cur.right
c. cur不是root,cur是parent.right,则parent.right=cur.right
2.cur.right==null
a. cur是root,则root=cur.left
b. cur不是root,cur是parent.left,则parent.left=cur.left
c. cur不是root,cur是parent.right,则parent.right=cur.left
3.cur.left!=null&&cur.right!=null
a.需要使⽤替换法进⾏删除,即在它的右⼦树中寻找中序下的第⼀个结点(关键码最⼩),⽤它的值 填补到被删除节点中,再来处理该结点的删除问题
5.代码实现
代码实现:
java
//二叉搜索树

//树的节点
class TreeNode{
    int val;
    TreeNode left;
    TreeNode right;

    public TreeNode(int val) {
        this.val = val;
    }
}

//二叉搜索树模拟实现
public class BSTDemo {
    TreeNode root;

    //1.搜索
    //利用左小右大的特性,一路往下找,找到返回true,没有则false
    public boolean search(int val) {
        TreeNode cur = root;
        while (cur != null) {
            if (val == cur.val) {
                //找到了
                return true;
            } else if (val < cur.val) {
                //目标值比当前节点小,往左找
                cur = cur.left;
            } else {
                //目标值比当前节点大,往右走
                cur = cur.right;
            }
        }
        //如果来到此时,说明根本不存在我们要找的值
        return false;
    }

    //2.插入
    //先找到空的位置
    public void insert(int val) {
        //创建一个新节点
        TreeNode newNode = new TreeNode(val);

        //如果树为空,则新节点就是根节点
        if (root == null) {
            root = newNode;
            return;
        }

        //创建一个cur,来记录我们当前的节点指向
        TreeNode cur = root;
        //记录父亲节点的位置
        TreeNode parent = null;

        //寻找可以插入的位置
        while (cur != null) {
            //每次往下找,都要记录父亲节点的位置
            parent = cur;
            if (val < cur.val) {
                //比当前小,往左找
                cur = cur.left;
            } else if (val > cur.val) {
                //比当前值大,往右找
                cur = cur.right;
            } else {
                //此时只能相等,即已经存在了,所以不能插入,于是返回
                return;
            }
        }

        //此时循环结束,cur是null,parent是叶子节点,根据大小决定挂在左边还是右边
        if (val < parent.val) {
            parent.left = newNode;
        } else {
            parent.right = newNode;
        }
    }


    //3.删除
    //删除成功返回 true,否则返回 false
    public boolean delete(int val){
        if (root==null){
            return false;
        }

        //先找到要删除节点的位置cur ,还要知道他的parent节点
        TreeNode cur =root;
        TreeNode parent =null;

        while (cur!=null){
            if (val==cur.val){
                break;
            }

            //记录父亲节点
            parent =cur;
            if (val<cur.val){
                cur=cur.left;
            }else {
                cur=cur.right;
            }
        }

        //此时没有找到我们要删除的节点
        if (cur==null){
            return false;
        }


        //情况1,左子树为空的情况
        if (cur.left==null){
            //cur是root
            if (cur==root){
                root =cur.right;
            } else if (cur==parent.left) {
                //cur不是root,是left
                parent.left=cur.right;
            }else {
                //cur不是root,是right
                parent.right=cur.right;
            }
        }        // 【情况 2:cur.right == null】(右子树为空)
        else if (cur.right == null) {
            // a. cur 是 root,则 root = cur.left
            if (cur == root) {
                root = cur.left;
            }
            // b. cur 不是 root,cur 是 parent.left,则 parent.left = cur.left
            else if (cur == parent.left) {
                parent.left = cur.left;
            }
            // c. cur 不是 root,cur 是 parent.right,则 parent.right = cur.left
            else {
                parent.right = cur.left;
            }
        }
        // 【情况 3:cur.left != null && cur.right != null】(左右子树都不为空)
        else {
            // a. 替换法:在它的右子树中寻找中序下的第一个结点(即右子树的最小值)
            TreeNode targetParent = cur; // 记录替换节点的双亲
            TreeNode target = cur.right; // 从右孩子开始找

            // 一直往左走,直到没有左孩子,就是右子树中最小的节点
            while (target.left != null) {
                targetParent = target;
                target = target.left;
            }

            // 用替换节点的值填补到被删除节点中
            cur.val = target.val;

            // 接下来,需要处理替换节点 target 的删除问题。
            // 注意:target 是右子树最左边的节点,所以它一定没有左孩子 (target.left == null)。
            // 这就退化成了上面的第 1 种情况。
            if (target == targetParent.left) {
                // 说明 target 是它父亲的左孩子,直接把它唯一的右孩子托付给它的父亲
                targetParent.left = target.right;
            } else {
                // 特殊情况:右子树的根节点就是最小值(没有左子树),即 target == cur.right。
                // 此时 while 循环一次都没进去,targetParent 还是 cur。
                targetParent.right = target.right;
            }
        }
        return true ;
    }
}
6.性能分析
插⼊和删除操作都必须先查找,查找效率代表了⼆叉搜索树中各个操作的性能
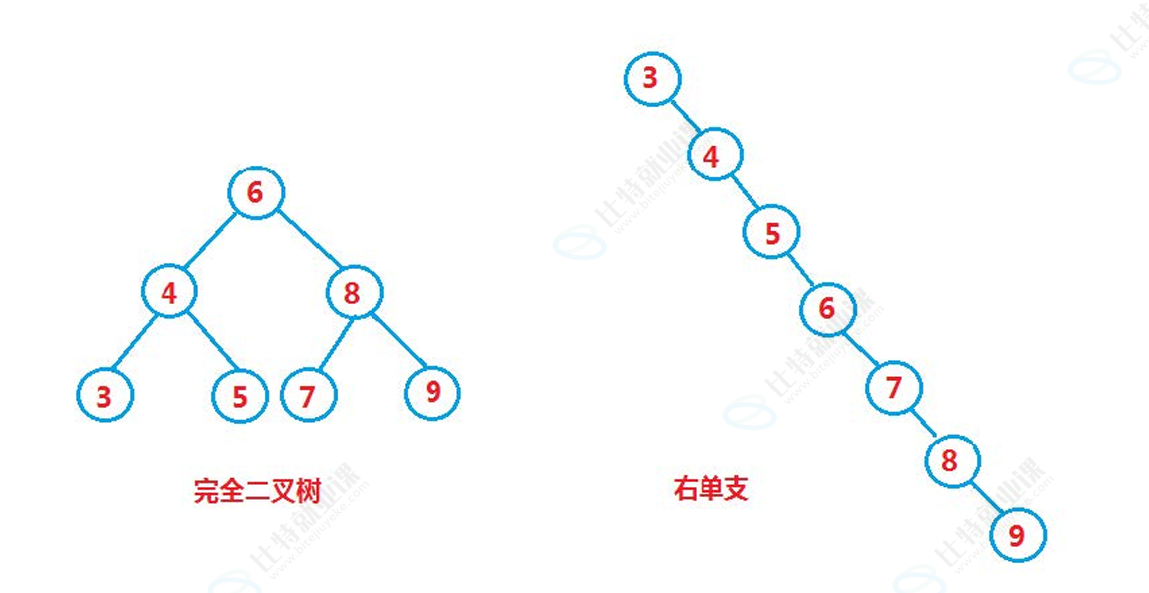
对有n个结点的⼆叉搜索树,若每个元素查找的概率相等,则⼆叉搜索树平均查找⻓度是结点在⼆叉搜 索树的深度的函数,即结点越深,则⽐较次数越多。
但对于同⼀个关键码集合,如果各关键码插⼊的次序不同,可能得到不同结构的⼆叉搜索树:
7.和java类集的关系
TreeMap和TreeSet即java中利⽤搜索树实现的Map和Set;实际上⽤的是红⿊树,⽽红⿊树是⼀棵 近似平衡的⼆叉搜索树,即在⼆叉搜索树的基础之上+颜⾊以及红⿊树性质验证,关于红⿊树的内容 后序再进⾏讲解。
二:搜索
1.概念及场景
Map和set是⼀种专⻔⽤来进⾏搜索的容器或者数据结构,其搜索的效率与其具体的实例化⼦类有关。 以前常⻅的搜索⽅式有:
-
直接遍历,时间复杂度为O(N),元素如果⽐较多效率会⾮常慢
-
⼆分查找,时间复杂度为,但搜索前必须要求序列是有序的
上述排序⽐较适合静态类型的查找,即⼀般不会对区间进⾏插⼊和删除操作了,⽽现实中的查找⽐ 如:
-
根据姓名查询考试成绩
-
通讯录,即根据姓名查询联系⽅式
-
不重复集合,即需要先搜索关键字是否已经在集合中
可能在查找时进⾏⼀些插⼊和删除的操作,即动态查找,那上述两种⽅式就不太适合了,本节介绍的 Map和Set是⼀种适合动态查找的集合容器。
2.模型
⼀般把搜索的数据称为关键字(Key),和关键字对应的称为值(Value),将其称之为Key-value的键值对,所以模型会有两种:
- 纯key模型,⽐如:
◦ 有⼀个英⽂词典,快速查找⼀个单词是否在词典中
◦ 快速查找某个名字在不在通讯录中
- Key-Value模型,⽐如:
◦ 统计⽂件中每个单词出现的次数,统计结果是每个单词都有与其对应的次数:
◦ 梁⼭好汉的江湖绰号:每个好汉都有⾃⼰的江湖绰号
- ⽽Map中存储的就是key-value的键值对,Set中只存储了Key
三:Map的使⽤
1.关于Map的说明
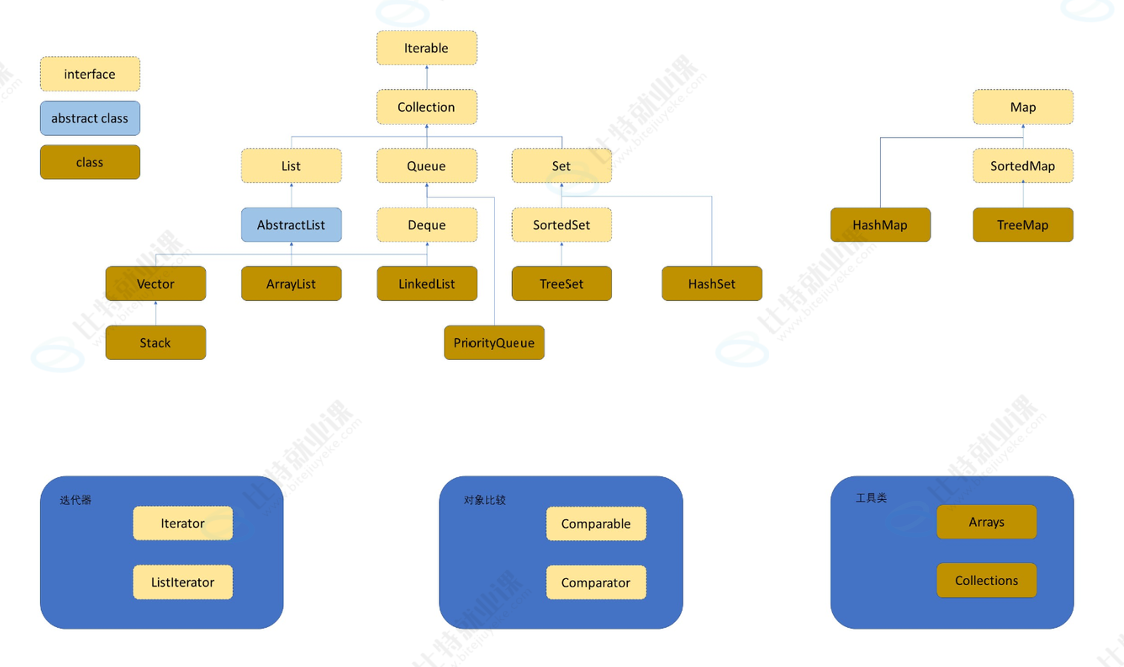
Map是⼀个接⼝类,该类没有继承⾃Collection,该类中存储的是结构的键值对,并且K⼀定是 唯⼀的,不能重复。
2.关于Map.Entry的说明
Map.Entry是Map内部实现的⽤来存放键值对映射关系的内部类,该内部类中主 要提供了的获取,value的设置以及Key的⽐较⽅式。
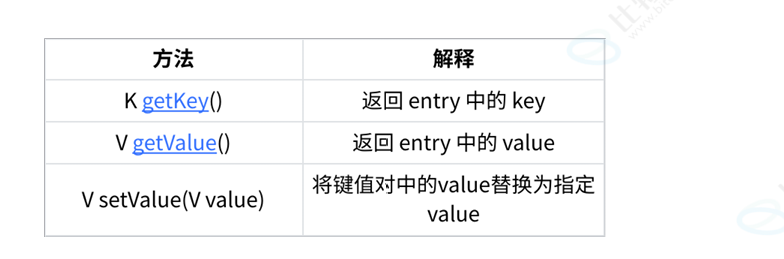
注意:Map.Entry并没有提供设置Key的⽅法
3.Map的常⽤⽅法说明
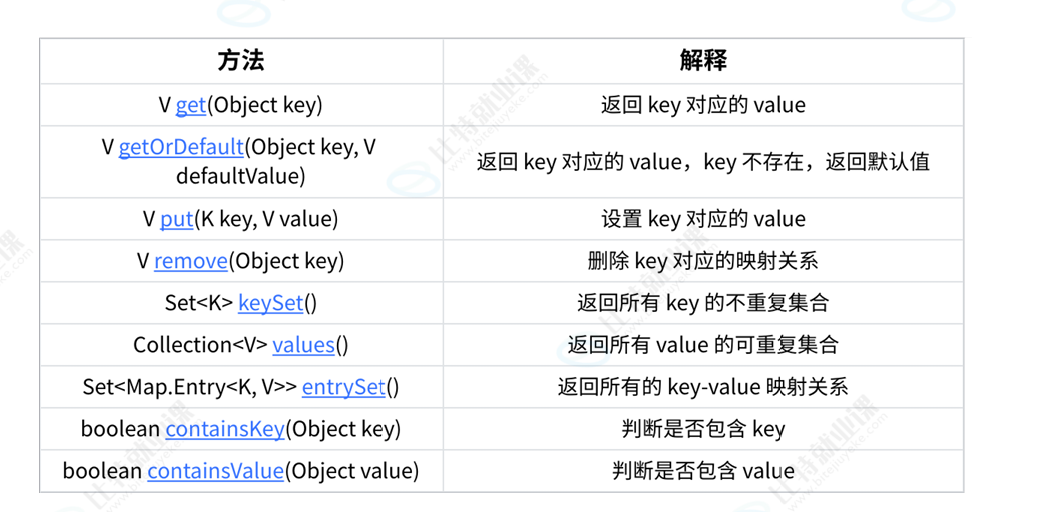
注意:
-
Map是⼀个接⼝,不能直接实例化对象,如果要实例化对象只能实例化其实现类TreeMap或者 HashMap
-
Map中存放键值对的Key是唯⼀的,value是可以重复的
-
在TreeMap中插⼊键值对时,key不能为空,否则就会抛NullPointerException异常,value可以 为空。但是HashMap的key和value都可以为空。
-
Map中的Key可以全部分离出来,存储到Set中来进⾏访问(因为Key不能重复)。
-
Map中的value可以全部分离出来,存储在Collection的任何⼀个⼦集合中(value可能有重复)。
-
Map中键值对的Key不能直接修改,value可以修改,如果要修改key,只能先将该key删除掉,然 后再来进⾏重新插⼊。
-
TreeMap和HashMap的区别:
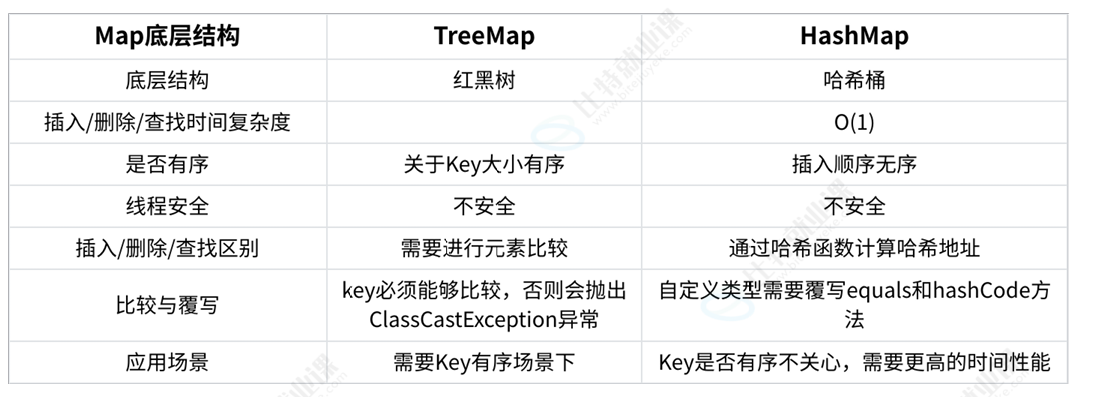
4.TreeMap的使⽤案例
代码实现:
java
import java.util.Map;
import java.util.TreeMap;

//TreeMap的使用测试
public class TreeMapDemo {

    public static void main(String[] args) {
        // 1. 创建 TreeMap
        // 注意:TreeMap 的键值对必须是 <Key, Value> 形式
        // 我们这里用 Integer 作为 Key (相当于你之前手写树里的 val),
        // 用 String 作为 Value (存储额外数据)
        TreeMap<Integer, String> treeMap = new TreeMap<>();

        //1.插入数据(push)
        treeMap.put(8,"八号");
        treeMap.put(4, "四号");
        treeMap.put(12, "十二号");
        treeMap.put(2, "二号");
        treeMap.put(6, "六号");
        treeMap.put(10, "十号");
        treeMap.put(14, "十四号");

        // 如果插入相同的 Key,会覆盖原来的 Value
        treeMap.put(8, "新八号");
        System.out.println("插入后的 TreeMap: " + treeMap);

        //2搜索(get)
        System.out.println("搜索 Key 6 的值: " + treeMap.get(6));           // 返回 "六号"
        System.out.println("搜索 Key 99 的值: " + treeMap.get(99));         // 返回 null (不存在)
        System.out.println("判断 Key 10 是否存在: " + treeMap.containsKey(10)); // 返回 true
        System.out.println("判断 Value '五号' 是否存在: " + treeMap.containsValue("五号")); // 返回 false

        //3.删除数据(remove)
        treeMap.remove(2);
        System.out.println("删除 Key 2 后: " + treeMap);

        //遍历数据
        // TreeMap 默认按照 Key 的自然顺序(从小到大)遍历
        for (Map.Entry<Integer, String> entry : treeMap.entrySet()) {
            System.out.println("Key: " + entry.getKey() + ", Value: " + entry.getValue());
        }
    }
}
四:Set的说明
Set与Map主要的不同有两点:Set是继承⾃Collection的接⼝类,Set中只存储了Key。
1.常⻅⽅法说明
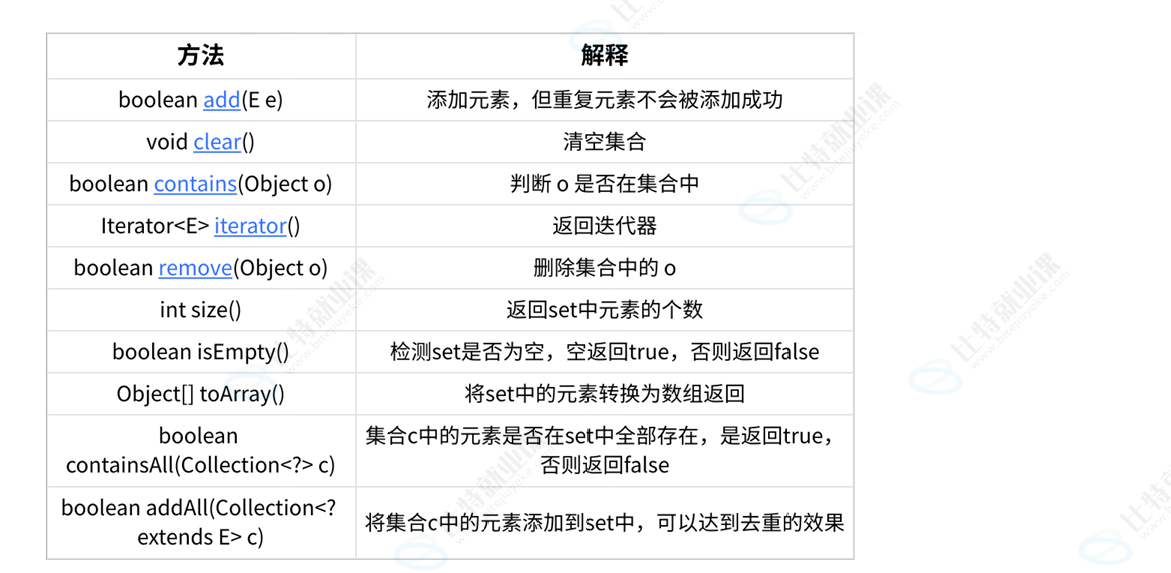
注意:
-
Set是继承⾃Collection的⼀个接⼝类
-
Set中只存储了key,并且要求key⼀定要唯⼀
-
TreeSet的底层是使⽤Map来实现的,其使⽤key与Object的⼀个默认对象作为键值对插⼊到Map中 的
-
Set最⼤的功能就是对集合中的元素进⾏去重
-
实现Set接⼝的常⽤类有TreeSet和HashSet,还有⼀个LinkedHashSet,LinkedHashSet是在 HashSet的基础上维护了⼀个双向链表来记录元素的插⼊次序
-
Set中的Key不能修改,如果要修改,先将原来的删除掉,然后再重新插⼊
-
TreeSet中不能插⼊null的key,HashSet可以。
-
TreeSet和HashSet的区别
| Set底层结构 | TreeSet | HashSet |
|---|---|---|
| 底层结构 | 红黑树 | 哈希桶(哈希表:数组+链表+红黑树) |
| 插入/删除/查找时间复杂度 | O(log n)(红黑树特性决定) | O(1) |
| 是否有序 | 关于Key有序 | 不一定有序 |
| 线程安全 | 不安全 | 不安全 |
| 插入/删除/查找区别 | 按照红黑树的特性来进行插入和删除 | 1. 先计算key哈希地址 2. 然后进行插入 |
| 比较与覆写 | key必须能够比较,否则会抛出ClassCastException异常(或传入自定义Comparator) | 自定义类型需要覆写equals和hashCode |
| 应用场景 | 需要Key有序场景下 | Key是否有序不关心,需要更高的时间性能(或读写/查找效率) |
2.TreeSet的使⽤案例
代码实现:
java
import java.util.TreeSet;

//TreeSet的使用
public class TreeSetDemo {
    public static void main(String[] args){

        // 1. 创建 TreeSet
        // 注意:TreeSet 只能存单个元素,不像 TreeMap 是键值对
        // 这里我们用 Integer 作为元素类型
        TreeSet<Integer> treeSet = new TreeSet<>();

        //1.插入数据
        treeSet.add(8);
        treeSet.add(4);
        treeSet.add(12);
        treeSet.add(2);
        treeSet.add(6);
        treeSet.add(10);
        treeSet.add(14);
        System.out.println("插入后的 TreeSet: " + treeSet);

        //2.搜索数据
        System.out.println("搜索 6 是否存在: " + treeSet.contains(6));   // true
        System.out.println("搜索 99 是否存在: " + treeSet.contains(99)); // false

        //3.删除数据
        treeSet.remove(2);//删除叶子节点
        System.out.println("删除 2 后: " + treeSet);

        treeSet.remove(4); // 删除左右都有的节点 (底层触发红黑树的节点调整)
        System.out.println("删除 4 后: " + treeSet);

        //4.遍历数据
        for (Integer num:treeSet){
            System.out.println(num+" ");
        }
        System.out.println();
    }
}
以上就是我们的全部内容了!!!