写在前面
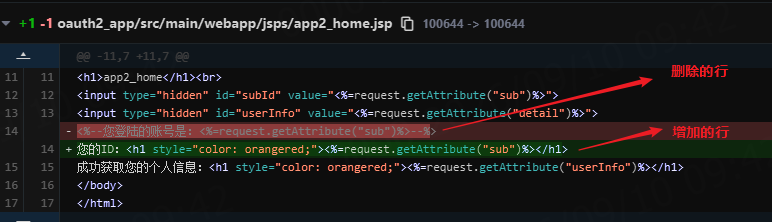
对比功能在工作中用的还是比较多的,比如git diff:
以及常用的文本对比工具,如beyond compare:
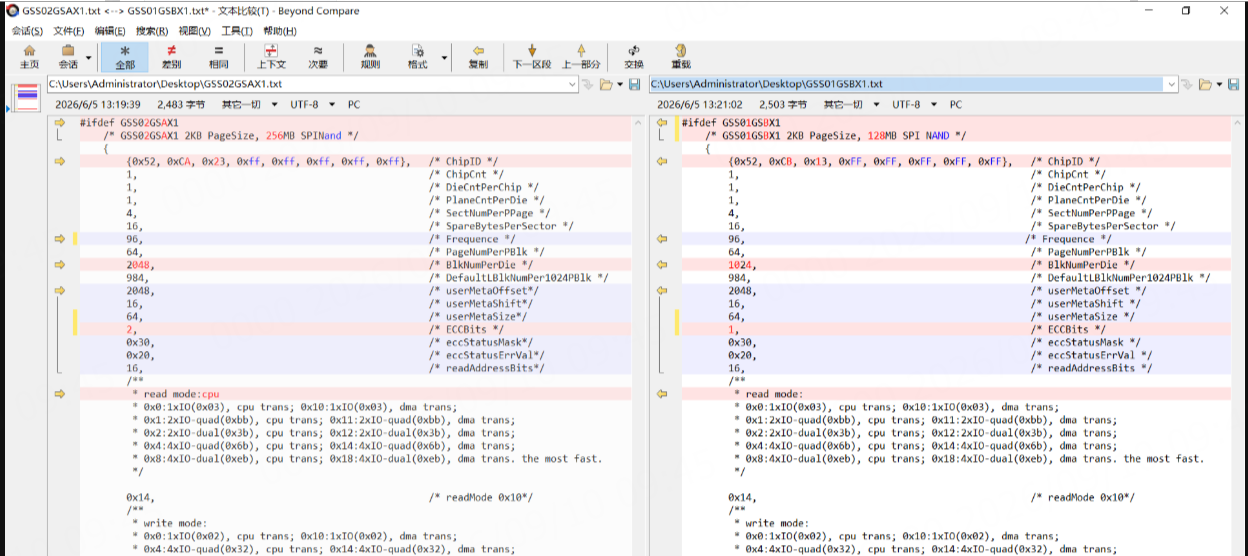
解决此类场景的算法,叫做文本差分算法,本文要介绍的Myers就是其中的一种算法。
1:什么是文本差分算法?
要想定义文本差分算法,首先要介绍下编辑脚本的概念,我们知道,一串字符A变为一串字符B是经过不断的删除字符和插入字符的操作来完成的,例如AB->ACD就要经过如下的插入和删除操作(不唯一,仅示例):
1:删除B
2:插入C
3:插入D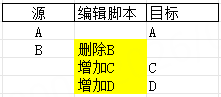
文本差分算法就可以定义为用来计算出标记脚本的算法。人有好有坏,算法也是如此,评价文本差分算法好坏的指标主要有两个,第一个就是编辑脚本的长度,自然越短越好。对于源序列 S = ABCABBA 目标序列 T = CBABAC,如下左边的编辑脚本就要优于右边的编辑算法:
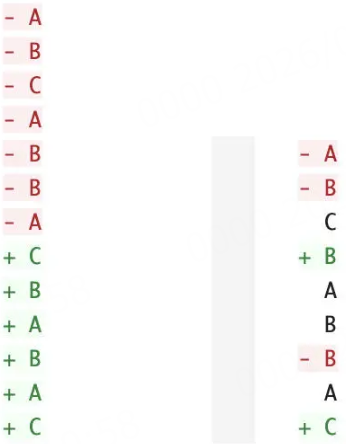
myers算法也是要求解最短编辑脚本。
而最短编辑脚本的长度是和最长公共子序列长度有关系的,这也很好理解,相同的子序列越多需要编辑的部分自然越少,具体计算方式如下:
源序列
S = ABCABBA length m = 7
目标序列
T = CBABAC  length n = 6

最长公共子序列(不唯一)
C = CBBA    length LC = 4

最短编辑脚本:m+n-2LC=5
评价一个文本查分算法优劣的第二个指标是可读性,毕竟编辑脚本对应的展示效果最终是给人看的,如下左边的可读性就要优于右边:
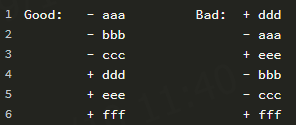
虽然都是最短编辑脚本得出的结果,但是第一种明显可读性更好,因为第一种连续的相同操作更长,对人更友好,不需要过多的思维转换。
总的来说,Myers就是要找到最短的可读性最高的编辑脚本的文本查分算法。
2:Myers介绍
为了实现可编程,Myers将问题转化了图搜索问题,以如下的源序列和目标序列为例
源序列
S = ABCABBA length m = 7
目标序列
T = CBABAC  length n = 6
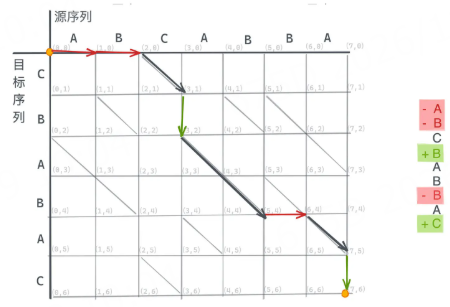
转化为如下的二维网格,称之为编辑图:
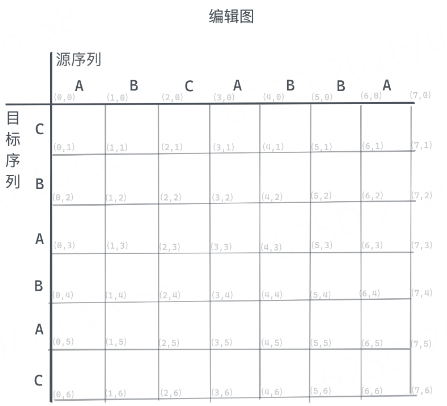
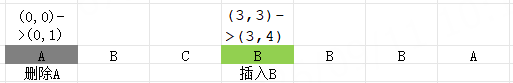
其中横向每一步代表删除一个数据,纵向的每一步代表插入一个数据。比如(0,0)->(0,1)代表将源序列索引位置0的字符删掉,(3,3)->(3,4)代表将目标字符索引位置3的字符B插入到源序列的索引位置3(注意这里是插入,不占用原有索引位置,而是整体后移),如下图:
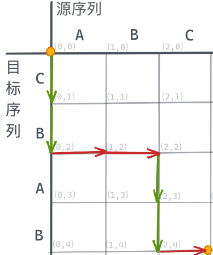
为了更加清晰来看一个程序的例子,源序列ABC,目标序列CBAB,按照如下的编辑脚本执行:
代码com.dong.business.logic.algorithm.myers.v1.MyersV1:
运行看一下:
+C
+B
-A
-B
+A
+B
-C
[INFO] ------------------------------------------------------------------------
[INFO] BUILD SUCCESS
[INFO] ------------------------------------------------------------------------
按照这种编辑脚本,我们的操作数是7,但明显不是最有的,比如下面这种操作数就是5:
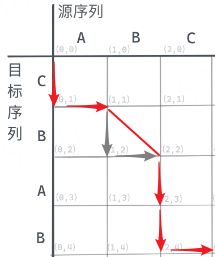
其中斜线的部分代表不需要占用任何的操作数,因为先+B,再-B,显然是有些脱裤子放屁了。此时程序实现参考这里,执行效果:
+C
-A
 B
+A
+B
-C
[INFO] ------------------------------------------------------------------------
[INFO] BUILD SUCCESS
[INFO] ------------------------------------------------------------------------
当然以上都是我们为了说明问题,具体的还是要看myers算法是如何做的。
2.1:Myers的重要概念
- D-path
完整路径的一个中间状态,注意这里的路径要求是最短路径,而非所有路径,其中的D,代表到此中间状态经过的操作数。如下是2-path的示例:
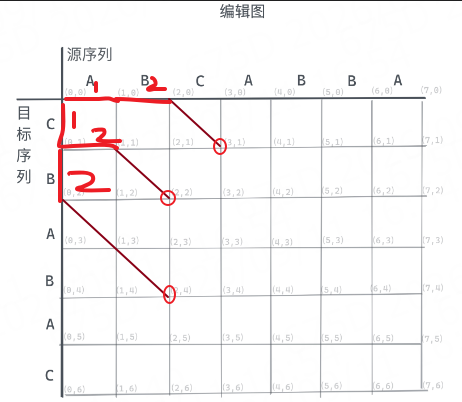
所以D-path是一个中间状态,代表了到达此状态的最短操作数路径。 - snake
操作数为1的路径,注意可以是中间的一个子路径,另外规定,如果后继是斜线则要一直走下去,直到没有斜线,即后继不能有斜线。如下都是snake:
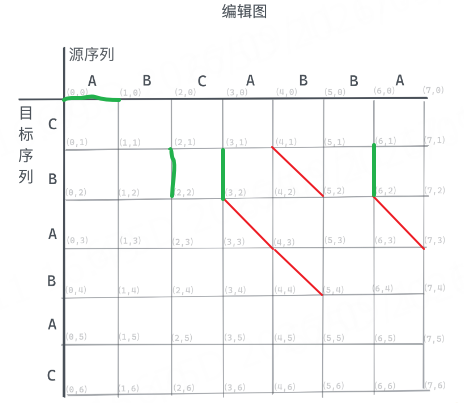
所以snake就是操作数为1的路径,只不过有的包含斜线,有的不包含斜线(此时以斜线结尾)。 - line
从左上到右下的四十五度线,可以用k=x-y来描述这条线,即k值就代表了某个line,如下图示例:
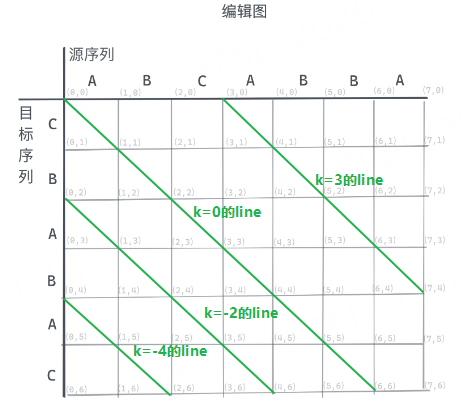
我们可以用以D-path为横轴,k-line号为纵轴来画一个坐标系,则如下的路径:
表示在这个坐标系中就如下图:
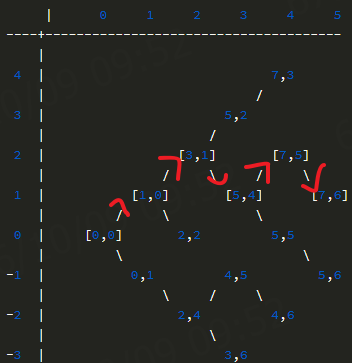
可以看到是一直在向右走的。
TODO 动态规划实现
写在后面
源码 。