跨境 API 调用不稳定怎么办:出口、超时重试与链路监控的工程化实践
一个 API 调用"偶尔超时",并不等于出口网络有问题。一次 HTTPS 请求至少经过域名解析、TCP 连接、TLS 握手、HTTP 请求与响应体读取;若应用部署在容器、云主机或多出口环境中,还会叠加 DNS 策略、NAT、网关和连接池行为。把所有失败统一归为"网络不稳",会让重试、告警和容量规划全部失去依据。
稳定性建设的目标不是消灭所有失败,而是做到三件事:失败能归类、可安全重试的请求有明确预算、异常能通过指标回溯到某一段链路。下面以 Python requests 为例,给出一套可以放进服务端项目的最小实现。
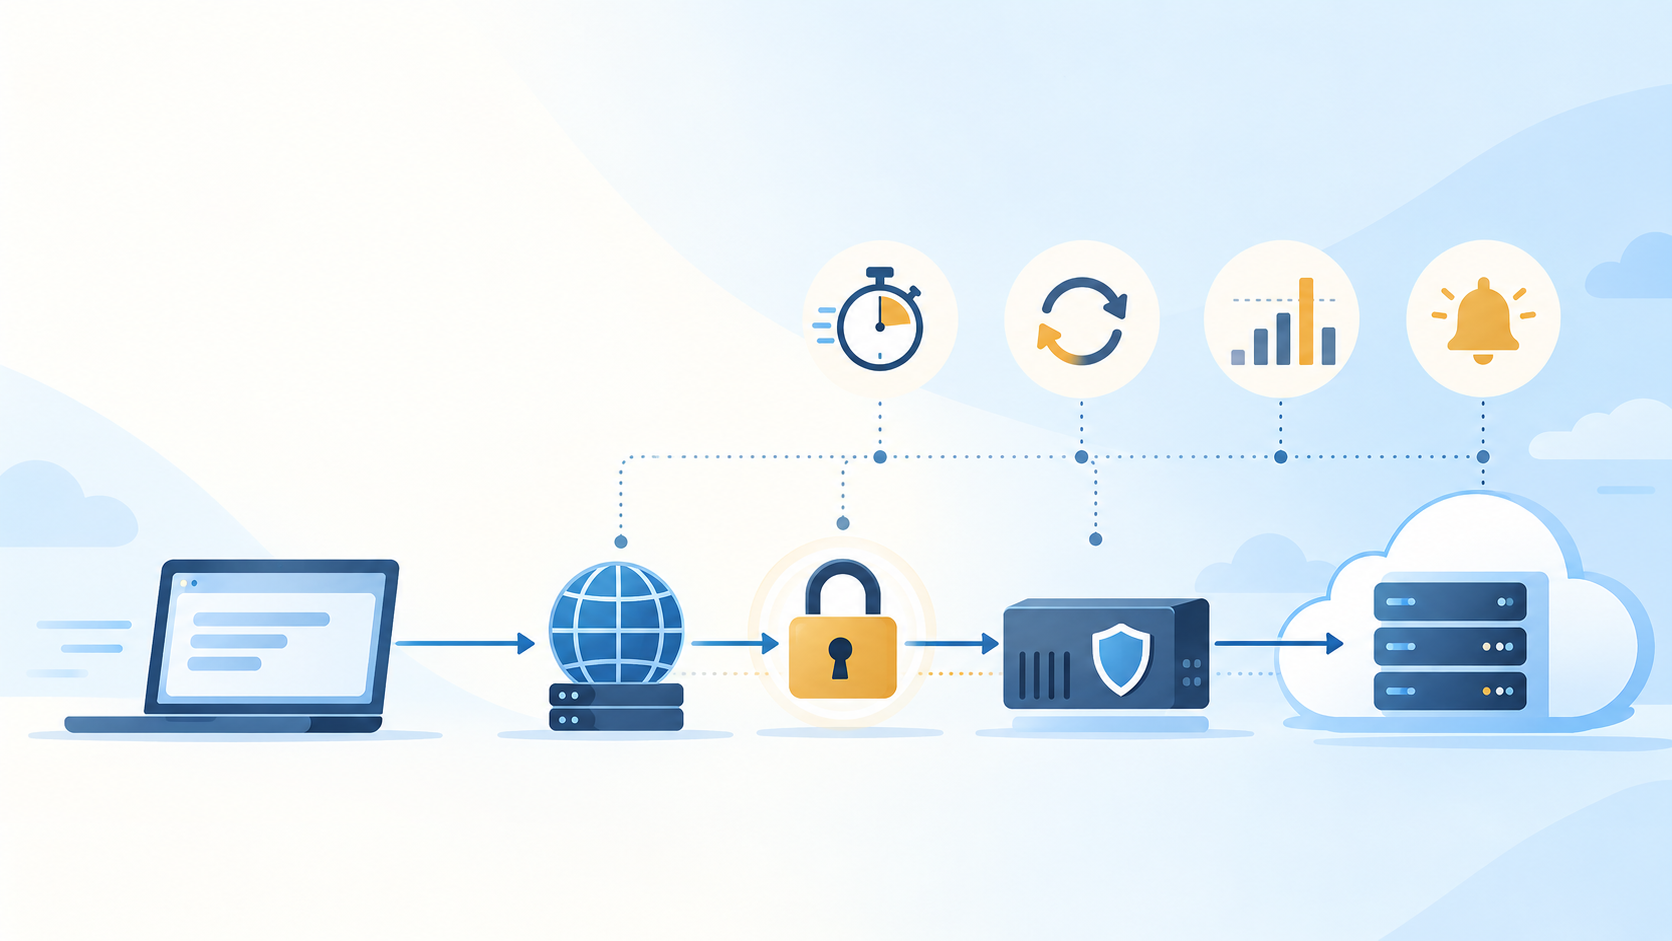
1. 请求失败要按阶段分类
| 阶段 | 常见现象 | 是否已经到达目标服务 | 优先检查方向 |
|---|---|---|---|
| DNS | NameResolutionError、域名无记录 |
否 | 解析器、A/AAAA、容器 DNS、缓存 |
| TCP 建连 | ConnectionError、连接被拒绝 |
通常否 | 路由、防火墙、端口、网关可达性 |
| TLS | 证书校验、握手中断 | 不一定 | SNI、证书链、系统时间、TLS 版本 |
| 首字节/读取 | ReadTimeout、响应中断 |
可能已到达 | 服务端处理、上游依赖、读超时预算 |
| HTTP 响应 | 401、403、408、429、5xx | 是 | 认证、接口契约、限速、服务端状态 |
| 业务语义 | HTTP 200 但字段表示失败 | 是 | 业务协议、幂等性、数据校验 |
HTTP 408 是服务端在等待完整请求消息时超时,客户端 ReadTimeout 则是客户端在读取响应时超过了自己的预算,两者不是同一个异常。429 说明服务端正在施加限速,应尊重服务端给出的 Retry-After(如果存在)并降低速率;它不能被记为"出口连接失败"。
出口网关或环境变量决定请求从哪里发起,不能替代认证、TLS、接口配额和业务校验。需要记录出口变更时间与配置版本,但不要把完整出口地址、授权头、URL 参数或用户 ID 写入监控标签。
2. 超时不是一个数字:连接与读取应分开
requests 支持 (connect_timeout, read_timeout) 元组。连接预算控制 DNS/TCP/TLS 等建连阶段的等待上限,读取预算控制两个响应字节之间的等待上限;它不是整个业务操作的绝对截止时间。上传大文件、流式响应或多次分页需要另设任务级 deadline。
超时值必须由接口 SLO、历史分位数、调用链剩余时间和并发容量决定。把读超时无限调大,只会让线程或连接池被慢请求长期占住;把连接超时设得过短,则会在网络轻微抖动时放大失败。
读取类接口可以针对瞬态 429/5xx 设置有限重试;写入类接口则需要幂等键、服务端去重或补偿机制。没有这些前提时,超时后的自动重发可能造成重复写入。
3. Python 可复用实现:连接池、有限重试与错误分类
下面的实现有四个刻意的限制:只对安全方法重试;只针对常见瞬态状态码重试;重试总次数有限;记录的是受控错误类别而不是完整异常文本。示例使用 example.test 占位,替换为已获授权的 API 地址后再运行。
python
from __future__ import annotations

from dataclasses import dataclass

import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry


@dataclass(frozen=True)
class ApiResult:
    status_code: int
    elapsed_ms: float
    body: dict


def build_session() -> requests.Session:
    retry = Retry(
        total=3,
        connect=3,
        read=2,
        status=2,
        backoff_factor=0.5,
        status_forcelist=(429, 500, 502, 503, 504),
        allowed_methods=frozenset({"GET", "HEAD", "OPTIONS"}),
        respect_retry_after_header=True,
        raise_on_status=False,
    )
    adapter = HTTPAdapter(
        max_retries=retry,
        pool_connections=20,
        pool_maxsize=20,
        pool_block=True,
    )
    session = requests.Session()
    session.mount("https://", adapter)
    session.mount("http://", adapter)
    return session


def get_catalog(session: requests.Session, item_id: str) -> ApiResult:
    response = session.get(
        f"https://api.example.test/v1/catalog/{item_id}",
        timeout=(3.0, 10.0),
        headers={"Accept": "application/json"},
    )
    response.raise_for_status()
    payload = response.json()
    if not isinstance(payload, dict):
        raise ValueError("unexpected JSON payload type")
    return ApiResult(
        status_code=response.status_code,
        elapsed_ms=response.elapsed.total_seconds() * 1000,
        body=payload,
    )


if __name__ == "__main__":
    with build_session() as api_session:
        result = get_catalog(api_session, "example-item")
        print(result.status_code, round(result.elapsed_ms, 1))
allowed_methods 不包含 POST、PATCH、DELETE。这些方法并非永远不能重试,但在不知道服务端是否已处理请求时,客户端盲目重发可能造成重复写入。只有接口提供幂等键、去重语义或业务补偿机制时,才应为相应写操作制定独立重试策略。
Retry 能处理某些请求级失败和状态码重试,但它不是任务编排器。分页、批量、异步回调与文件上传需要在业务层设置整体 deadline、最大尝试次数和可恢复检查点。
记录异常时至少划分 connect_timeout、read_timeout、tls_error、connect_error、http_429、http_4xx、http_5xx。HTTP 4xx/5xx 应从 HTTPError.response 读取状态码;DNS 失败在不同库版本中可能被包装为 ConnectionError,需结合异常链和 tracing 继续定位。异常原文不应成为 Prometheus label。
4. 监控指标:尝试成功率与任务成功率必须分开
重试存在时,单次尝试和最终业务任务会产生不同成功率。例如一个任务第一次 503、第二次 200:尝试成功率为 50%,最终任务成功率为 100%。两者都重要,但不能用同一个计数器混算。
推荐的最小指标集如下:
| 指标 | 类型 | 标签建议 | 用途 |
|---|---|---|---|
api_client_attempts_total |
Counter | service、operation、result |
请求尝试成功率 |
api_client_tasks_total |
Counter | service、operation、result |
最终任务成功率 |
api_client_duration_seconds |
Histogram | service、operation |
P50/P95/P99 延迟 |
api_client_errors_total |
Counter | service、operation、error_type |
分阶段错误占比 |
api_client_retries_total |
Counter | service、operation、reason |
重试放大与退避效果 |
service 与 operation 应是小而稳定的枚举,例如 catalog、create_invoice;不要用完整 URL 或订单号。OpenTelemetry 的 HTTP client 指标也将持续时间定义为 Histogram,并建议在出现错误时记录受控的 error.type。
经典 Prometheus Histogram 计算 P95 时,需要在聚合前保留 le:
promql
histogram_quantile(
  0.95,
  sum by (service, operation, le) (
    rate(api_client_duration_seconds_bucket[10m])
  )
)
对每个实例各算一个 P95 再求平均没有统计意义。分位数应从可聚合的 bucket 汇总后计算;桶边界也应围绕 SLO 附近加密,否则 P95 只是宽泛估算。
5. 告警策略:用错误预算而不是一次超时触发事故
一次 DNS 抖动、单个 429 或某个低流量接口的慢请求,都不适合直接升级为高优告警。告警条件至少应包含观察窗口、持续时间、最小请求量和业务影响范围。
yaml
groups:
  - name: api-client-reliability
    rules:
      - alert: ApiClientFailureRateHigh
        expr: |
          sum(rate(api_client_attempts_total{result="failure"}[10m]))
          /
          sum(rate(api_client_attempts_total[10m])) > 0.05
          and
          sum(rate(api_client_attempts_total[10m])) * 600 >= 100
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "API 客户端失败率持续高于 5%"
上例将最低样本数设为 100 次/10 分钟,用于过滤低流量下的偶然波动;5% 也只是启动值,不是任何 API 的通用 SLO。规则上线前应使用历史数据回放,并通过 promtool check rules 检查语法。
connect_timeout 上升时核对 DNS、TCP 连通性、网关与目标健康;read_timeout 上升时检查服务端处理、连接池排队与响应体;429 上升时降低并发并核对配额和退避;P95 上升而平均值平稳时,重点查看慢请求比例和队列等待。出口是观测变量之一,不是每个异常的唯一解释。
6. 上线验收清单
- 所有外部请求都设置显式连接与读取超时,关键任务额外设置整体 deadline。
- 只对确认幂等的操作自动重试;写操作有幂等键或服务端去重机制后再纳入重试。
- 429、407、4xx、5xx、TLS、连接超时和读超时独立统计。
- 指标标签不包含 URL 参数、账号、Token、完整出口地址和异常原文。
- P95 从 Histogram bucket 汇总计算,且桶边界覆盖实际 SLO。
- 变更出口、DNS、证书或连接池参数时,保留配置版本与变更时间。
- 告警设定最小样本量与持续时间,并用历史流量验证阈值。
参考资料
- RFC 9110: HTTP Semantics
- urllib3 Retry 文档与 Requests 适配器文档
- OpenTelemetry HTTP client metrics / span semantic conventions
- Prometheus Histogram 与 alerting rules 文档