文章目录
- [1. 运算符重载](#1. 运算符重载)
- [2. Runnable 接口](#2. Runnable 接口)
- [3. StrOutputParser 字符串输出解析器](#3. StrOutputParser 字符串输出解析器)
- [4. JsonOutputParser](#4. JsonOutputParser)
- [5. RunnableLambda 自定义函数](#5. RunnableLambda 自定义函数)
- [6. 临时记忆](#6. 临时记忆)
- [7. 长期会话记忆存储](#7. 长期会话记忆存储)
- [8. Document loaders 文档加载器](#8. Document loaders 文档加载器)
-
- [8.1 CSVLoader](#8.1 CSVLoader)
- [8.2 JSONLoader](#8.2 JSONLoader)
- [8.3 PyPDFLoader](#8.3 PyPDFLoader)
- [8.4 TextLoader](#8.4 TextLoader)
系列文章:
前置介绍:避免老年人跟不上时代,也是时候开始学习 agent 相关的知识,还是经典的黑马程序员教程开始学习。
1. 运算符重载
Python 中所有运算符(+、| 等),本质上都是调用对象对应的魔法方法:
- a + b 等价于 a.add(b)
- a | b 等价于 a.or(b)
只要自定义类实现了 or 方法,就能让 | 符号按你想要的逻辑工作。LangChain 里的 chat_prompt_template | model ,就是通过重写 __or__ 方法,实现了「提示词模板 -> 模型」的链式调用。
py
class Test(object):
    def __init__(self, name):
        self.name = name

    def __or__(self, other):
        # 创建 MySequence 的时候会将 a, b 传过去, 这里的 self 就是 a, 作为 args 参数传进去的
        return MySequence(self, other)

		# 相当于重写 toString()
    def __str__(self):
        return self.name


class MySequence(object):
    def __init__(self, *args):
        self.sequence = []
        # args 初始化是 (a, b)
        for arg in args:
            self.sequence.append(arg)

    def __or__(self, other):
        self.sequence.append(other)
        return self

    def run(self):
        for i in self.sequence:
            print(i)


if __name__ == '__main__':
    a = Test('a')
    b = Test('b')
    c = Test('c')
    e = Test('e')
    f = Test('f')
    g = Test('g')

    # a | b 就是调用 Test 的 __or__ 方法, 返回 MySequence
    # 接下来再 | c 就是调用 MySequence 的 __or__ 方法往 sequence 里面添加
    d = a | b | c | e | f | g  # a.__or__(b)
    d.run()
    print(type(d))
下面再来看下一个例子:
py
class PipelineStep:
    def __init__(self, func):
        self.func = func

    def __or__(self, other):
        # 重写 | 运算符,返回一个 PipelineChain 对象
        if isinstance(other, PipelineChain):
            # 如果右边已经是 PipelineChain,就把自己加进去
            other.steps.insert(0, self)
            return other
        else:
            # 否则创建一个新的 PipelineChain
            return PipelineChain([self, other])

    def run(self, input_data):
        # 执行当前步骤的逻辑
        return self.func(input_data)


class PipelineChain:
    def __init__(self, steps):
        self.steps = steps

    def __or__(self, other):
        # 链式操作时,继续添加步骤
        self.steps.append(other)
        return self

    def run(self, input_data):
        # 依次执行所有步骤
        result = input_data
        for step in self.steps:
            result = step.run(result)
        return result


# 定义几个步骤对象
a = PipelineStep(lambda x: x + 1)
b = PipelineStep(lambda x: x * 2)
c = PipelineStep(lambda x: x - 3)

# 使用 | 连接成链
chain = a | b | c

# 执行链
print(chain.run(5))  # 执行过程:(5 + 1) * 2 - 3 = 9
可以看到上面两个例子,我们都可以重写 __or__ 方法,也就是重写 | 这个符号的逻辑。
2. Runnable 接口
LangChain 中的绝大多数核心组件都继承了 Runnable 抽象基类(位于 langchain_core.runnables.base),比如常用的 chain = prompt | model。
chain 变量是 RunnableSequence(RunnableSerializable 子类)类型,而得到这个类型的原因就是Runnable 基类内部对 __or__ 魔术方法的改写。
go
 def __or__(
     self,
     other: Runnable[Any, Other]
     | Callable[[Iterator[Any]], Iterator[Other]]
     | Callable[[AsyncIterator[Any]], AsyncIterator[Other]]
     | Callable[[Any], Other]
     | Mapping[str, Runnable[Any, Other] | Callable[[Any], Other] | Any],
 ) -> RunnableSerializable[Input, Other]:
     """Runnable "or" operator.

     Compose this `Runnable` with another object to create a
     `RunnableSequence`.

     Args:
         other: Another `Runnable` or a `Runnable`-like object.

     Returns:
         A new `Runnable`.
     """
     return RunnableSequence(self, coerce_to_runnable(other))
这个方法就是 Runnable 接口对 __or__ 方法的改写,而 RunnableSequence 的 __or__ 方法如下。
py
    @override
    def __or__(
        self,
        other: Runnable[Any, Other]
        | Callable[[Iterator[Any]], Iterator[Other]]
        | Callable[[AsyncIterator[Any]], AsyncIterator[Other]]
        | Callable[[Any], Other]
        | Mapping[str, Runnable[Any, Other] | Callable[[Any], Other] | Any],
    ) -> RunnableSerializable[Input, Other]:
        if isinstance(other, RunnableSequence):
            return RunnableSequence(
                self.first,
                *self.middle,
                self.last,
                other.first,
                *other.middle,
                other.last,
                name=self.name or other.name,
            )
        return RunnableSequence(
            self.first,
            *self.middle,
            self.last,
            coerce_to_runnable(other),
            name=self.name,
        )
可以看到,最终都是返回 RunnableSequence,每一轮 | 返回结果都是 RunnableSequence,作为下一轮的输入,再次创建 RunnableSequence 串起来,内部用一个 steps_flat 列表将所有 RunnableSequence 存起来。
go
from langchain_core.prompts import PromptTemplate
from langchain_community.llms.tongyi import Tongyi


prompt = PromptTemplate.from_template("你是一个AI助手")
model = Tongyi(model="qwen3-max")

chain = prompt | model | prompt | model
# RunnableSequence
print(type(chain))
而上面的 PromptTemplate 最终输出可以看到也是 RunnableSequence 类型的。
3. StrOutputParser 字符串输出解析器
如果我们想要将模型第一次输出的结果交给模型来询问,可以用到上面的 | 链式写法。
go
from langchain_core.prompts import PromptTemplate
from langchain_community.chat_models.tongyi import ChatTongyi

model = ChatTongyi(model="qwen3-max")

prompt = PromptTemplate.from_template("我要测试链式调用: {first}")
chain = prompt | model | model
res = chain.invoke({"first": "1"})
print(res.content)
但是上面的写法会报错 ValueError: Invalid input type <class 'langchain_core.messages.ai.AIMessage'>. Must be a PromptValue, str, or list of BaseMessages.,原因就是:
- prompt 的结果是 PromptValue 类型,输入给了 model,这个没问题
- model 的输出结果是:AIMessage,这个就有问题了。
AIMessage 不是模型可以接收的输入,模型接收的输入是 PromptValue 或者 str 或者 Sequence[MessageLikeRepresentation],可以看 chat_model.py 的源码。
go
@override
def invoke(
    self,
    input: LanguageModelInput,
    config: RunnableConfig | None = None,
    *,
    stop: list[str] | None = None,
    **kwargs: Any,
) -> AIMessage:
    config = ensure_config(config)
    return cast(
        "AIMessage",
        cast(
            "ChatGeneration",
            self.generate_prompt(
                [self._convert_input(input)],
                stop=stop,
                callbacks=config.get("callbacks"),
                tags=config.get("tags"),
                metadata=config.get("metadata"),
                run_name=config.get("run_name"),
                run_id=config.pop("run_id", None),
                **kwargs,
            ).generations[0][0],
        ).message,
    )
里面的输入类型是这个:
py
LanguageModelInput = PromptValue | str | Sequence[MessageLikeRepresentation]
"""Input to a language model."""
所以为了实现链式调用,我们可以用 StrOutputParser,StrOutputParser 是 LangChain 内置的简单字符串解析器,可以将 AIMessage 解析为简单的字符串,符合了模型 invoke 方法要求(可传入字符串,不接收 AIMessage 类型),最重要的一点,这个类是 Runnable 接口的子类,也就是可以加入链。
go
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_community.chat_models.tongyi import ChatTongyi

# 字符串解析器
parser = StrOutputParser()
model = ChatTongyi(model="qwen3-max")
prompt = PromptTemplate.from_template(
    "我邻居姓:{lastname},刚生了{gender},请起名,仅告知我名字无需其它内容。"
)

# 将字符串解析器入链, 确保将 model 的输出结果 AIMessage 转成 str, 再输入给 model
chain = prompt | model | parser | model | parser

res: str = chain.invoke({"lastname": "张", "gender": "女儿"})
print(res)
# <class 'langchain_core.messages.base.TextAccessor'>
print(type(res))
4. JsonOutputParser
chain = prompt | model | parser | model | parser,上一小节,我们完成了这样的需求去构建多模型链,但是这种写法不是很标准,因为 上一个模型的输出没有被处理就输入给下一个模型,这里的输出不是说转 str 这么简单,而是我们要对模型的输出做一些特殊处理,比如作为模板提示词用来二次调用模型。
invoke|stream 初始输入 -> 提示词模板 -> 模型 -> 数据处理 -> 提示词模板 -> 模型 -> 解析器 -> 结果 ,这个是我们希望的调用流程,所以我们需要完成将 model 输出结果 AIMessage 转成字典,注入第二个提示词模板形成新的提示词(PromptValue 对象),但是很明显 StrOutputParser 不满足这个要求,因为这个类最终会转成 str ,这种情况下就可以用 JsonOutputParser,这个类可以完成 AIMessage -> Dict(JSON) 的转换。
go
@override
def invoke(
    self, input: dict, config: RunnableConfig | None = None, **kwargs: Any
) -> PromptValue:
上面就是 BasePromptTemplate 的 invoke 方法,可以看到输入确实是一个 dict,因此我们需要将上一个模型的输出转成 dict 才能传给提示词模板,用 StrOutputParser 是没办法做到这个事情的,下面来看下示例。
go
from langchain_core.output_parsers import StrOutputParser, JsonOutputParser
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.prompts import PromptTemplate

# 创建所需的解析器
str_parser = StrOutputParser()
json_parser = JsonOutputParser()

# 模型创建
model = ChatTongyi(model="qwen3-max")

# 第一个提示词模板
first_prompt = PromptTemplate.from_template(
    "帮我计算结果: {first} + {second} = ?, 将返回结果以 JSON 格式返回, key 是 res, value 就是结果"
)

# 第二个提示词模板
second_prompt = PromptTemplate.from_template(
    "{res} * 10 = ?, 帮我计算结果, 直接输出字符串结果"
)

# 构建链
# 将 model 的输出结果如 {"res": "3"} 输入给提示词模板, 再将输出 PromptValue 提交给 model 去
# 调用, 最后将模型返回的结果用 str_parser 转成 str 类型
chain = first_prompt | model | json_parser | second_prompt | model | str_parser

for chunk in chain.stream({"first": "1", "second": "2"}):
    print(chunk, end="", flush=True)\
# 30
注意提示词一定要要求大模型按照 JSON 格式返回。
5. RunnableLambda 自定义函数
chain = first_prompt | model | json_parser | second_prompt | model | str_parser,上面我们通过 JsonOutputParser 这类固定 json 解析器去解析,我们也可以字节编写 Lambda 匿名函数来完成自定义的数据转换,想怎么转就怎么转,最重要的是可以打印输出。
RunnableLambda 就可以完成这个功能,RunnableLambda 类是 LangChain 内置的,可以将普通函数等转换为 Runnable 接口,方便自定义函数加入 chain,下面来看下例子。
go
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.runnables import RunnableLambda

model = ChatTongyi(model="qwen3-max")
str_parser = StrOutputParser()

# 构建 json 格式, 模型返回结果是 "3", 去除双引号再转成 int
my_func = RunnableLambda(lambda ai_msg: {"res": int(ai_msg.content.strip('"'))})

# 第一个提示词模板
first_prompt = PromptTemplate.from_template(
    "帮我计算结果: {first} + {second} = ?, 直接输出字符串结果"
)

# 第二个提示词模板
second_prompt = PromptTemplate.from_template(
    "{res} * 10 = ?, 帮我计算结果, 将整个公式打印出来"
)

# 将 model 输出结果交给 RunnableLambda 输出 JSON 格式的 Dict 交给 second_prompt
chain = first_prompt | model | my_func | second_prompt | model | str_parser

res = chain.invoke({"first": 1, "second": 2})
print(res)
# 3 * 10 = 30
本质上我们换成下面写法也是可以的。
py
# 将 model 输出结果交给 RunnableLambda 输出 JSON 格式的 Dict 交给 second_prompt
# chain = first_prompt | model | my_func | second_prompt | model | str_parser
chain = first_prompt | model | (lambda ai_msg: {"res": int(ai_msg.content.strip('"'))}) | second_prompt | model | str_parser
Runnable 接口的 __or__ 方法也可以接收 Callable 类型的传参,所以我们可以直接把函数传进去,运行的时候会自动转成 RunnableLambda 类型,只是不建议这样写。
6. 临时记忆
如果想要封装历史记录,除了自行维护历史消息之外,也可以借助 LangChain 内置的历史记录附加功能。LangChain 提供了 History 功能,也就是可以将历史消息发送给大模型。
- 基于
RunnableWithMessageHistory在原有链的基础上创建带历史记录功能的新链,也就是新的 Runnable 示例。 - 基于
InMemoryChatMessageHistory为历史记录提供内存存储,用来临时存储的,因为看类名也知道这是个内存存储,一旦服务重启历史会话就会丢失。
go
from langchain_core.runnables.history import RunnableWithMessageHistory

# 通过 RunnableWithMessageHistory 获取一个新的带有历史记录功能的 chain
conversation_chain = RunnableWithMessageHistory(
    runnable=some_chain,                # 被附加历史消息的 Runnable,通常是 chain
    get_session_history=None,           # 获取指定会话 ID 的历史会话的函数, 这个函数是我们自己提供了,用于获取历史会话
    input_messages_key="input",         # 声明用户输入消息在模板中的占位符
    history_messages_key="chat_history" # 声明历史消息在模板中的占位符
)
如何实现提供一个 sessionId,然后返回一个 InMemmory 对象。
go
from langchain_core.chat_history import InMemoryChatMessageHistory

# 全局存储:存放多个会话 ID 对应的历史会话记录
chat_history_store = {}

# 获取指定会话 ID 的历史会话记录函数
# 函数传入:session_id(字符串类型)
# 函数返回:BaseChatMessageHistory 的子类实例(用于管理单会话历史)
# InMemoryChatMessageHistory:LangChain 官方内置的内存版历史记录管理类
def get_history(session_id):
    # 如果该会话 ID 不存在,则新建一个历史记录实例
    if session_id not in chat_history_store:
        chat_history_store[session_id] = InMemoryChatMessageHistory()

    # 返回对应会话的历史记录对象
    return chat_history_store[session_id]
上面是基础使用,下面来看下完整的用例。
go
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.prompts import PromptTemplate, ChatPromptTemplate, MessagesPlaceholder
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables.history import RunnableWithMessageHistory
from langchain_core.chat_history import InMemoryChatMessageHistory

model = ChatTongyi(model="qwen3-max")

prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "你需要根据会话历史回应用户问题。对话历史:"),
        MessagesPlaceholder("chat_history"),
        ("human", "请回答如下问题:{input}"),
    ]
)

str_parser = StrOutputParser()


def print_prompt(full_prompt):
    print("=" * 20, full_prompt.to_string(), "=" * 20)
    return full_prompt


# print_prompt 用于打印历史记录
base_chain = prompt | print_prompt | model | str_parser

store = {}  # key: session_id, value 是 InMemoryChatMessageHistory


def get_history(session_id):
    if session_id not in store:
        store[session_id] = InMemoryChatMessageHistory()
    return store[session_id]


# 创建新链,基于原有的 base_chain 增强成带临时记忆的 chain
convertion_chain = RunnableWithMessageHistory(
    base_chain,  # 要增强的链
    get_history,  # 用于根据会话 id 获取 InMemoryChatMessageHistory 类对象
    input_messages_key="input",
    history_messages_key="chat_history",
)

# 有了上面的 chain, 我们还需要指定 session_id, 否则 convertion_chain invoke 的时候要根据 session_id 找历史消息, 但是session_id 不知道从哪来

if __name__ == '__main__':
    # 固定格式, 添加 LangChain 的格式, 为当前程序配置所属的 session_id
    session_config = {
        "configurable": {
            "session_id": "user_001"
        }
    }

    res = convertion_chain.invoke({"input": "第一个数是 20"}, session_config)
    print("第一次执行: ", res)

    res = convertion_chain.invoke({"input": "第二个数是 30"}, session_config)
    print("第二次执行: ", res)

    res = convertion_chain.invoke({"input": "加起来是多少"}, session_config)
    print("第三次执行: ", res)
流程是这样的:
- 调用 invoke,首先将 input 注入 prompt,然后调用
get_history方法根据设置的 session_id 获取历史记录注入 chat_history 这个 key,形成最终的 prompt 发送给大模型。 - 大模型返回结果之后,convertion_chain 会将返回结果和用户提问写到
store中,第二次调用 invoke,首先将 input 注入 prompt,然后调用get_history方法根据设置的 session_id 获取历史记录注入 chat_history 这个 key,形成最终的 prompt 发送给大模型。 - ...
所以基于上面的流程可以看出来:
chat_history这个 key 是可以修改的,和生成增强链 RunnableWithMessageHistory 里面的 history_messages_key 对应上就行了。session_id需要我们自己提供,固定方法就是上面的代码里面通过 session_config 去配置当前会话的会话 id。- 由于使用的存储类是
InMemoryChatMessageHistory,属于内存存储,所以重启程序之后会话就会丢失。
7. 长期会话记忆存储
上面 InMemoryChatMessageHistory 属于是内存存储,临时存储会话记忆,一旦程序退出记忆就丢失了,如果我们想要长期存储,就需要用到持久化存储了,比如存放到文件里面。
InMemoryChatMessageHistory 是 BaseChatMessageHistory 的子类,官方注释里面给出了相关的示例代码,代码是关于 FileChatMessageHistory 文件存储的例子。
python
 import json
 import os
 from langchain_core.messages import messages_from_dict, message_to_dict


 class FileChatMessageHistory(BaseChatMessageHistory):
     storage_path: str
     session_id: str

     @property
     def messages(self) -> list[BaseMessage]:
         try:
         		# 打开文件
             with open(
                 os.path.join(self.storage_path, self.session_id),
                 "r",
                 encoding="utf-8",
             ) as f:
                 # 把文件所有消息读出来
                 messages_data = json.load(f)
                 # 通过 messages_from_dict 将读出来的 dict 转成 message 列表
             return messages_from_dict(messages_data)
         except FileNotFoundError:
             return []

     def add_messages(self, messages: Sequence[BaseMessage]) -> None:
     		# 首先获取已经记录的历史消息
         all_messages = list(self.messages)  # Existing messages
         # 追加新消息
         all_messages.extend(messages)  # Add new messages

				# for 循环遍历所有消息, 通过 message_to_dict 转成 dict, 然后存到新的列表里面
				# 所以这一步完了之后 serialized 就是一个存了所有 dict 格式的消息的列表
         serialized = [message_to_dict(message) for message in all_messages]
         # 获取文件路径
         file_path = os.path.join(self.storage_path, self.session_id)
         # 创建文件, 也就是确保文件存在
         os.makedirs(os.path.dirname(file_path), exist_ok=True)
         # 打开文件并写入消息
         with open(file_path, "w", encoding="utf-8") as f:
             json.dump(serialized, f)

     def clear(self) -> None:
         # 获取文件路径
         file_path = os.path.join(self.storage_path, self.session_id)
         # 确保文件存在
         os.makedirs(os.path.dirname(file_path), exist_ok=True)
         # 清空文件
         with open(file_path, "w", encoding="utf-8") as f:
             json.dump([], f)
FileChatMessageHistory 文件存储的思路如下:
- 基于文件存储会话记录,以 session_id 为文件名,相当于一个文件就是一个会话。
- 继承 BaseChatMessageHistory 并实现下面三个方法。
- add_messages:添加消息,同步添加,参数是 Sequence\[\],就是消息列表。
- messages:同步获取历史消息。
- clear:同步清除消息。
整体代码如下。
go
import os, json
from collections.abc import Sequence
from mimetypes import init

from langchain_community.chat_message_histories import FileChatMessageHistory
from langchain_community.chat_models import ChatTongyi
from langchain_core.chat_history import BaseChatMessageHistory
from langchain_core.messages import message_to_dict, messages_from_dict, BaseMessage
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables import RunnableWithMessageHistory


# message_to_dict:单个消息对象(BaseMessage类实例) -> 字典
# messages_from_dict:[字典、字典...]  -> [消息、消息...]
# AIMessage、HumanMessage、SystemMessage 都是 BaseMessage 的子类

class FileChatMessageHistory(BaseChatMessageHistory):
    def __init__(self, session_id, store_path):
        self.session_id = session_id
        self.store_path = store_path

        # 确保存储文件的父级文件夹存在
        os.makedirs(self.store_path, exist_ok=True)

        # 拼接完整的文件路径
        self.file_path = os.path.join(self.store_path, f"{session_id}.json")

    def add_messages(self, messages: Sequence[BaseMessage]) -> None:
        # 读取现有消息(安全处理空文件)
        try:
            with open(self.file_path, 'r', encoding='utf-8') as f:
                try:
                    data = json.load(f)
                except json.JSONDecodeError:  # 捕获JSON解析错误
                    data = []
        except FileNotFoundError:  # 捕获文件不存在错误
            data = []

        # Sequence 序列, 类似 list、tuple
        # self.messages 是已有的消息列表, 转成 list 确保兼容性
        all_messages = list(self.messages)
        # 合成一个 list
        all_messages.extend(messages)

        # 将数据同步写入本地文件
        # 类对象写入文件就是一堆二进制,为了方便,可以将BaseMessage消息转为字典(借助json模块以json字符串写入文件)
        # 官方message_to_dict:单个消息对象(BaseMessage类实例) -> 字典
        # new_messages = []
        # for message in all_messages:
        #     d = message_to_dict(message)
        #     new_messages.append(d)
        # 添加新消息并写回
        new_data = [message_to_dict(m) for m in messages]
        full_data = data + new_data
        with open(self.file_path, 'w', encoding='utf-8') as f:
            json.dump(full_data, f, ensure_ascii=False)

    # 装饰器, 将 messages 方法变成成员属性, 允许调用这个方法的时候通过 .messages 直接调用, 去掉括号
    @property
    def messages(self) -> list[BaseMessage]:
        # 当前文件内存的是 list[dict]
        try:
            with open(self.file_path, 'r', encoding="utf-8") as f:
                messages = json.load(f)
                # 将 list[dict] 转成 list[BaseMessage]
                return messages_from_dict(messages)
        except FileNotFoundError:
            return []

    def clear(self) -> None:
        with open(self.file_path, 'w', encoding="utf-8") as f:
            json.dump([], f)


model = ChatTongyi(model="qwen3-max")

prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "你需要根据会话历史回应用户问题。对话历史:"),
        MessagesPlaceholder("chat_history"),
        ("human", "请回答如下问题:{input}"),
    ]
)

str_parser = StrOutputParser()


def print_prompt(full_prompt):
    print("=" * 20, full_prompt.to_string(), "=" * 20)
    return full_prompt


# print_prompt 用于打印历史记录
base_chain = prompt | print_prompt | model | str_parser


def get_history(session_id):
    # 一个是 session_id, 一个是文件存储的路径, 存到当前下的 chat_history 就行
    return FileChatMessageHistory(session_id, "D:\\pycode\\ai-code\\Langchain\\chat_history")


# 创建新链,基于原有的 base_chain 增强成带临时记忆的
convertion_chain = RunnableWithMessageHistory(
    base_chain,  # 要增强的链
    get_history,  # 用于根据会话 id 获取 FileChatMessageHistory 类对象
    input_messages_key="input",
    history_messages_key="chat_history",
)

# 有了上面的 chain, 我们还需要指定 session_id, 否则 convertion_chain invoke 的时候要根据 session_id 找历史消息, 但是session_id 不知道从哪来

if __name__ == '__main__':
    # 固定格式, 添加 LangChain 的格式, 为当前程序配置所属的 session_id
    session_config = {
        "configurable": {
            "session_id": "user_001"
        }
    }

    res = convertion_chain.invoke({"input": "第一个数是 20"}, session_config)
    print("第一次执行: ", res)

    res = convertion_chain.invoke({"input": "第二个数是 30"}, session_config)
    print("第二次执行: ", res)

    res = convertion_chain.invoke({"input": "加起来是多少"}, session_config)
    print("第三次执行: ", res)
可以看到的是上面跟课程里面的代码是不一样的,主要是修复本地没有打开文件权限的 bug 才这么写。
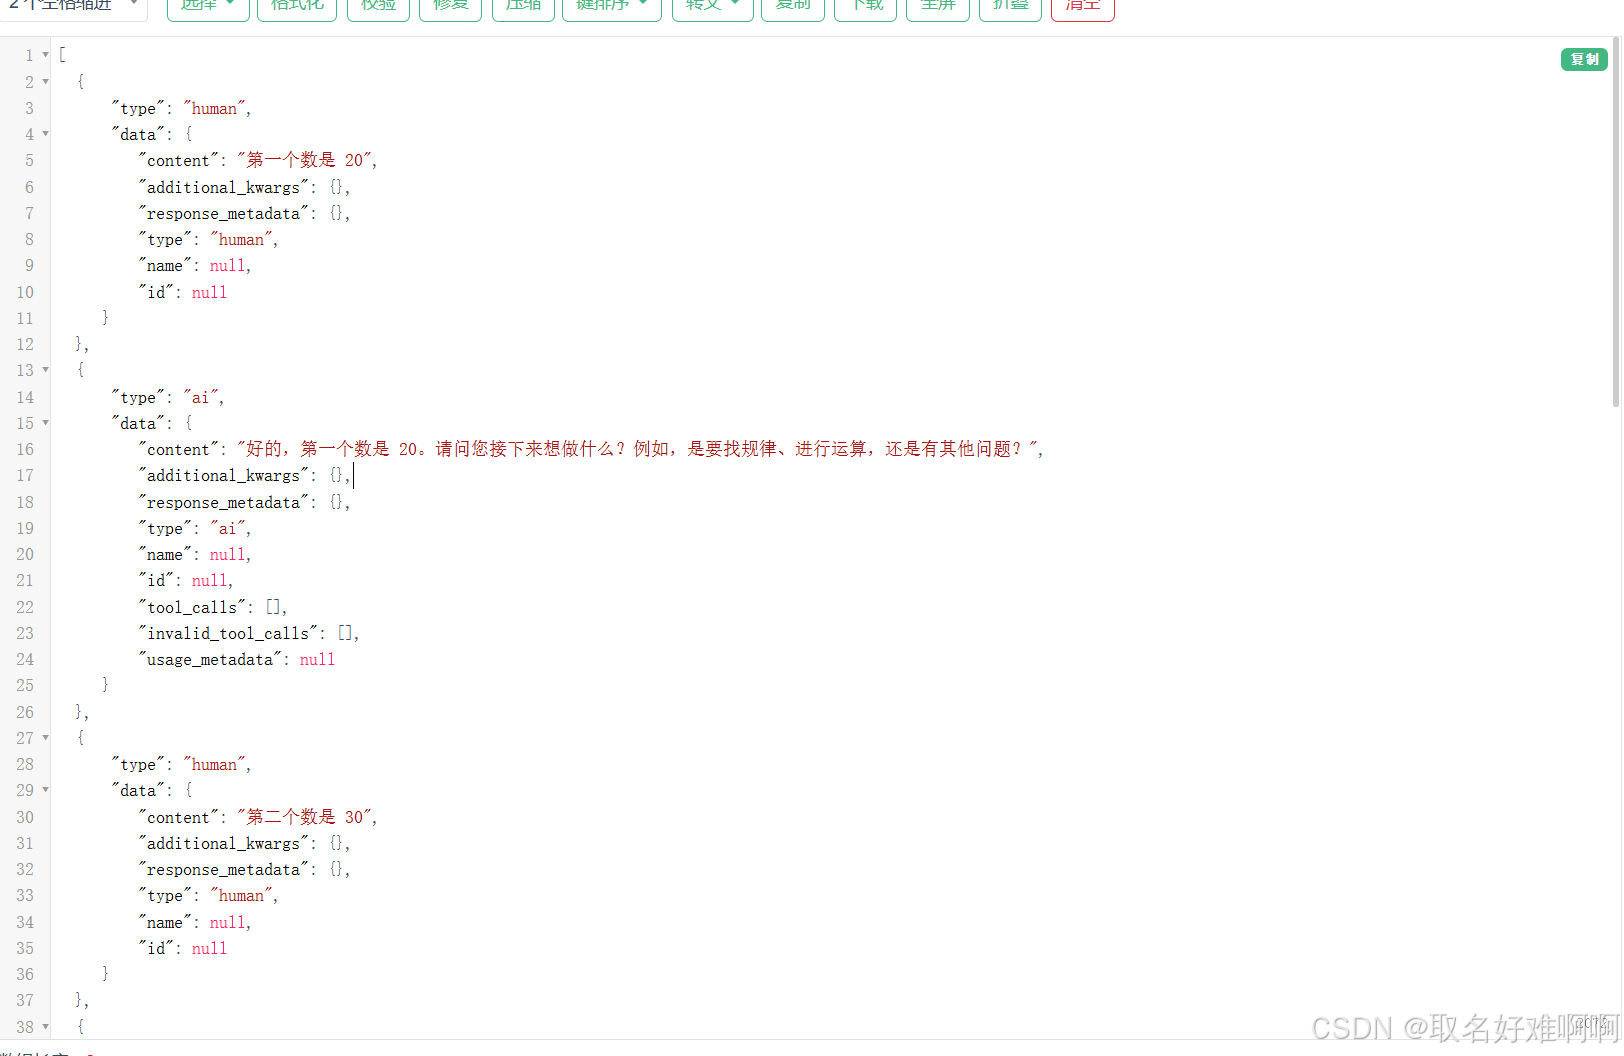
最终本地文件里面就存储了会话。
8. Document loaders 文档加载器
文档加载器提供了一套标准接口,用于将不同来源(如 CSV、PDF 或 JSON 等)的数据读取为 LangChain 的文档格式,其实就是提供一个通用的数据读取接口来读取数据,文档加载器需要实现 BaseLoader 接口。
Class Document,是 LangChain 内文档的统一载体,所有文档加载器都会返回这个类的实例,一个基础的 Document 类实例基于下面的代码创建。
go
from langchain_core.documents import Document

document = Document(
    page_content="Hello, world!", metadata={"source": "https://example.com"}
)- page_content:文档内容
- metadata:文档元数据
不同的文档加载器可能定义了不同的参数,但是其都实现了统一的接口,也就是下面的 load 和 lazy_load。
- load:一次性加载全部文档。
- lazy_load:延迟流式传输文档,对大型数据集很有用,避免内存溢出。
go
from langchain_community.document_loaders.csv_loader import CSVLoader

# 初始化 CSVLoader(关键参数说明)
loader = CSVLoader(
    file_path="data.csv",           # CSV 文件路径(必填)
    csv_args={                      # CSV 解析参数(可选,传递给 csv.reader)
        "delimiter": ",",          # 列分隔符(默认逗号)
        "quotechar": '"',          # 引号字符(默认双引号)
    },
    encoding="utf-8",               # 文件编码(可选,默认 utf-8)
    content_columns=["text"],       # 作为文档内容的列名列表(必填关键参数)
    metadata_columns=["id", "date"] # 作为元数据的列名列表(可选)
)

# 方式一:一次性加载全部文档(适合小数据集)
documents = loader.load()
print(f"已加载 {len(documents)} 个文档")
# 示例输出: [Document(page_content='...', metadata={'id': 1, 'date': '2023-01-01'}), ...]

# 方式二:惰性加载(流式处理大数据集,避免内存溢出)
print("\n开始流式加载:")
for i, document in enumerate(loader.lazy_load()):
    print(f"文档 #{i+1}: 内容片段: {document.page_content[:50]}..., 元数据: {document.metadata}")
    # 处理单个文档(此处可添加业务逻辑)
LangChain 内置了许多文档加载器,详细参见官方文档:文档加载器。
下面来学习几个常用的文档加载器。
8.1 CSVLoader
CSVLoader 就是用于加载 .csv 文件的,其中一个比较重要的参数是 file_path,用于指定文件路径,然后就是 csv_args,可以配置 csv 文件的相关参数,比如表头、分隔符等。
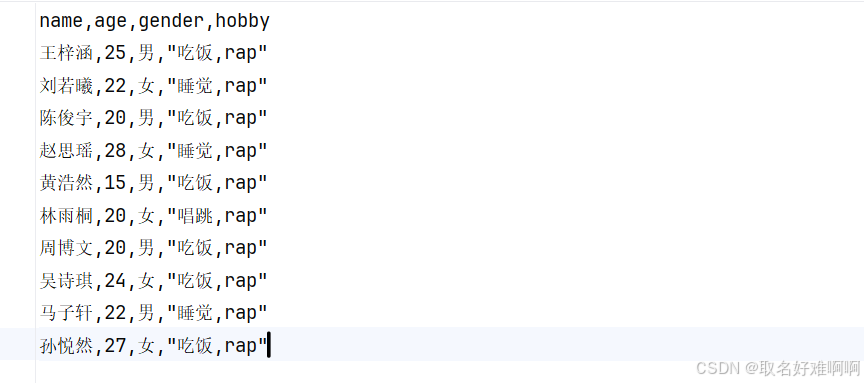
现在准备一份数据。
下面编写下示例代码用于加载这个文件。
go
from langchain_community.document_loaders import CSVLoader


loader = CSVLoader(
    file_path="./data/stu.csv",
    csv_args={
        "delimiter": ",",       # 指定分隔符
        "quotechar": '"',       # 指定带有分隔符文本的引号包围是单引号还是双引号
        # 如果数据源没有表头,就不要下面的代码,如果没有可以使用
        "fieldnames": ['name', 'age', 'gender', '爱好']
    },
    encoding="utf-8"            # 指定编码为 UTF-8, 避免 windows 报错
)

# 全部加载 .load()   ->  [Document, Document, ...]
documents = loader.load()

for document in documents:
    # <class 'langchain_core.documents.base.Document'>
    print(type(document), document)

# 懒加载  .lazy_load()  迭代器[Document]
for document in loader.lazy_load():
    print(document)
最终的输出如下,可以看到确实是读取出来数据了。
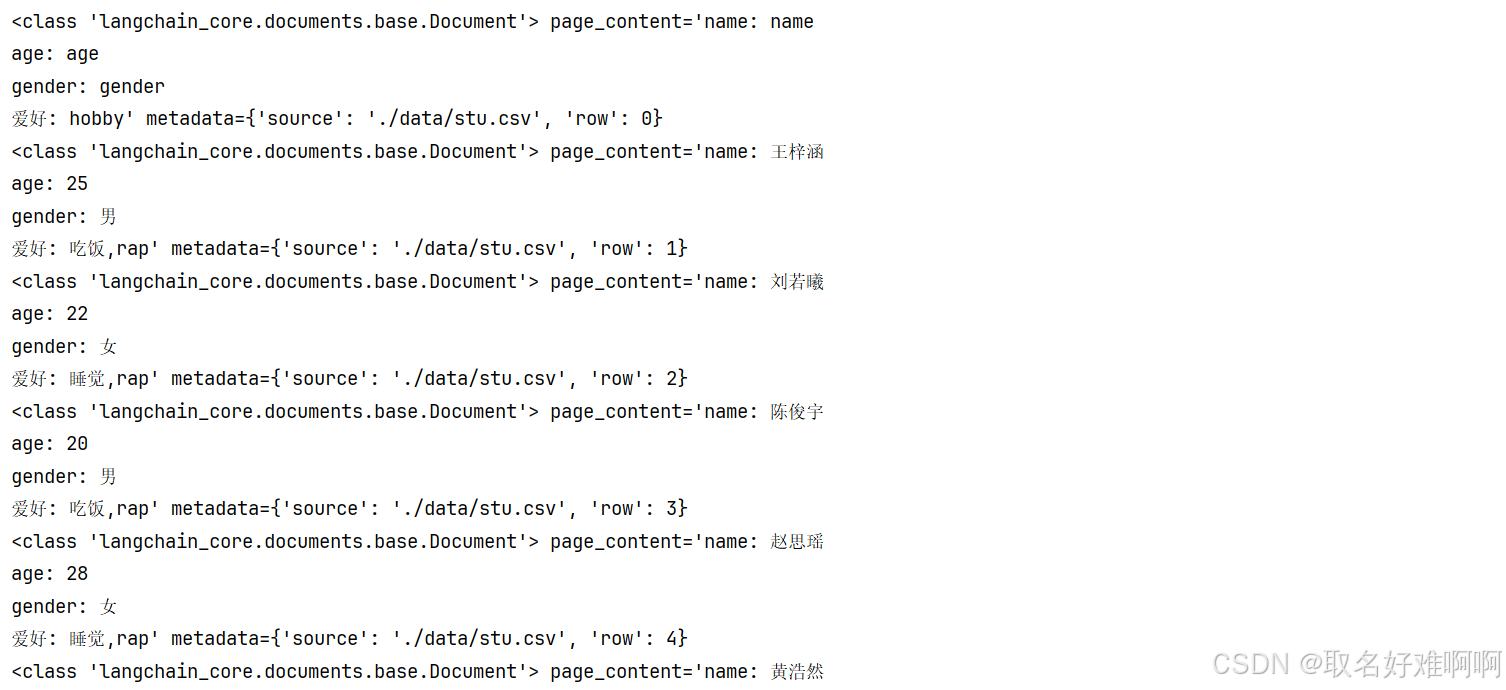
要注意下,我们上面指定了分隔符 delimiter 是 ,,下面的 quotechar 就是用来标注假设一段文本里面出现 delimiter,那么这段文本是用什么包起来,比如 "吃饭, rap",这段文本里面包含了 ,,因此我们用 quotechar 指定下以 " 包起来的作为一段文本。
8.2 JSONLoader
JSONLoader 用于将 JSON 数据加载为 Document 类型对象,使用 JSONLoader 需要额外安装: pip install jq。jq 是一个跨平台的 json 解析工具,LangChain 底层对 JSON 的解析就是基于 jq 工具实现的,这个工具将 JSON 数据的信息抽取出来,封装为 Document 对象,抽取的时候依赖 jq_schema 语法。
假设现在有下面的 json。
json
{
    "name": "周杰伦",
    "age": 11,
    "hobby": ["唱", "跳", "RAP"],
    "other": {
        "addr": "深圳",
        "tel": "12332112321"
    }
}
jq 语法如下。
| 表达式 | 含义说明 | 提取结果 |
|---|---|---|
. |
表示整个 JSON 对象(根节点) | 完整的 JSON 对象本身 |
.name |
抽取键为 name 的值 | "周杰伦" |
.hobby |
抽取键为 hobby 的数组 | ["唱", "跳", "RAP"] |
.hobby[1] |
抽取 hobby 数组中的第 2 个元素 | "跳" |
.other.addr |
链式抽取嵌套对象的值 | "深圳" |
而对于数组也是差不多,比如下面的 json 数组。
json
[
    {"name": "周杰伦", "age": 11, "gender": "男"},
    {"name": "蔡依林", "age": 12, "gender": "女"},
    {"name": "王力宏", "age": 11, "gender": "男"}
]
提取规则如下。
| 表达式 | 含义说明 | 提取结果 |
|---|---|---|
.[ ] |
获取列表中的所有字典(对象) | 包含 3 个字典的完整列表 |
.[ ].name |
批量抽取列表中所有对象的 name 字段 | ["周杰伦", "蔡依林", "王力宏"] |
所以总结下核心就是:. 代表 json 对象,[] 代表整体数组。
下面就看下 JSONLoader 是如何加载 JSON 文件的,首先准备两个 json 文件,第一个标准的 stu.json 文件。
json
{
    "name": "周杰轮",
    "age": 11,
    "hobby": ["唱", "跳", "RAP"],
    "other": {
        "addr": "深圳",
        "tel": "12332112321"
    }
}
然后是 stu_json_lines.json 文件,JsonLines 文件的特点就是这个文件的每一行都是 json 格式。
json
{"name": "周杰轮", "age": 11, "gender": "男"}
{"name": "蔡依临", "age": 12, "gender": "女"}
{"name": "王力鸿", "age": 11, "gender": "男"}
下面来看下抽取这两个文件的代码。
go
from langchain_classic.docstore import document
from langchain_community.document_loaders import JSONLoader

loader = JSONLoader(
    file_path="./data/stu.json",
    # .name 抽取当前 json 对象里面的 name, 周杰轮
    # 要抽取 addr,就用 .other.addr
    # 注意这里如果用 jq_schema = "." 抽取整个 json,那么抽取的类型就是 dict 类型,需要设置 text_content=False 才行
    jq_schema=".name",
)

document = loader.load()
print(document)


# loader = JSONLoader(
#     file_path="./data/stu_json_lines.json",
#     jq_schema=".name",
#     text_content=False,     # 告知JSONLoader 我抽取的内容不是字符串
#     json_lines=True         # 告知JSONLoader 这是一个JSONLines文件(每一行都是一个独立的标准JSON)
# )
#
# document = loader.load()
# print(document)
这里要注意下,如果 json 文件里面是数组格式。
json
[
	{"name": "周杰轮", "age": 11, "gender": "男"}
	{"name": "蔡依临", "age": 12, "gender": "女"}
	{"name": "王力鸿", "age": 11, "gender": "男"}
]
如果要抽取所有 name 就用 .[].name,没有设置下标的情况下就代表要抽取所有下标,如果要抽取某个下标就设置成 .[0].name 这种。
8.3 PyPDFLoader
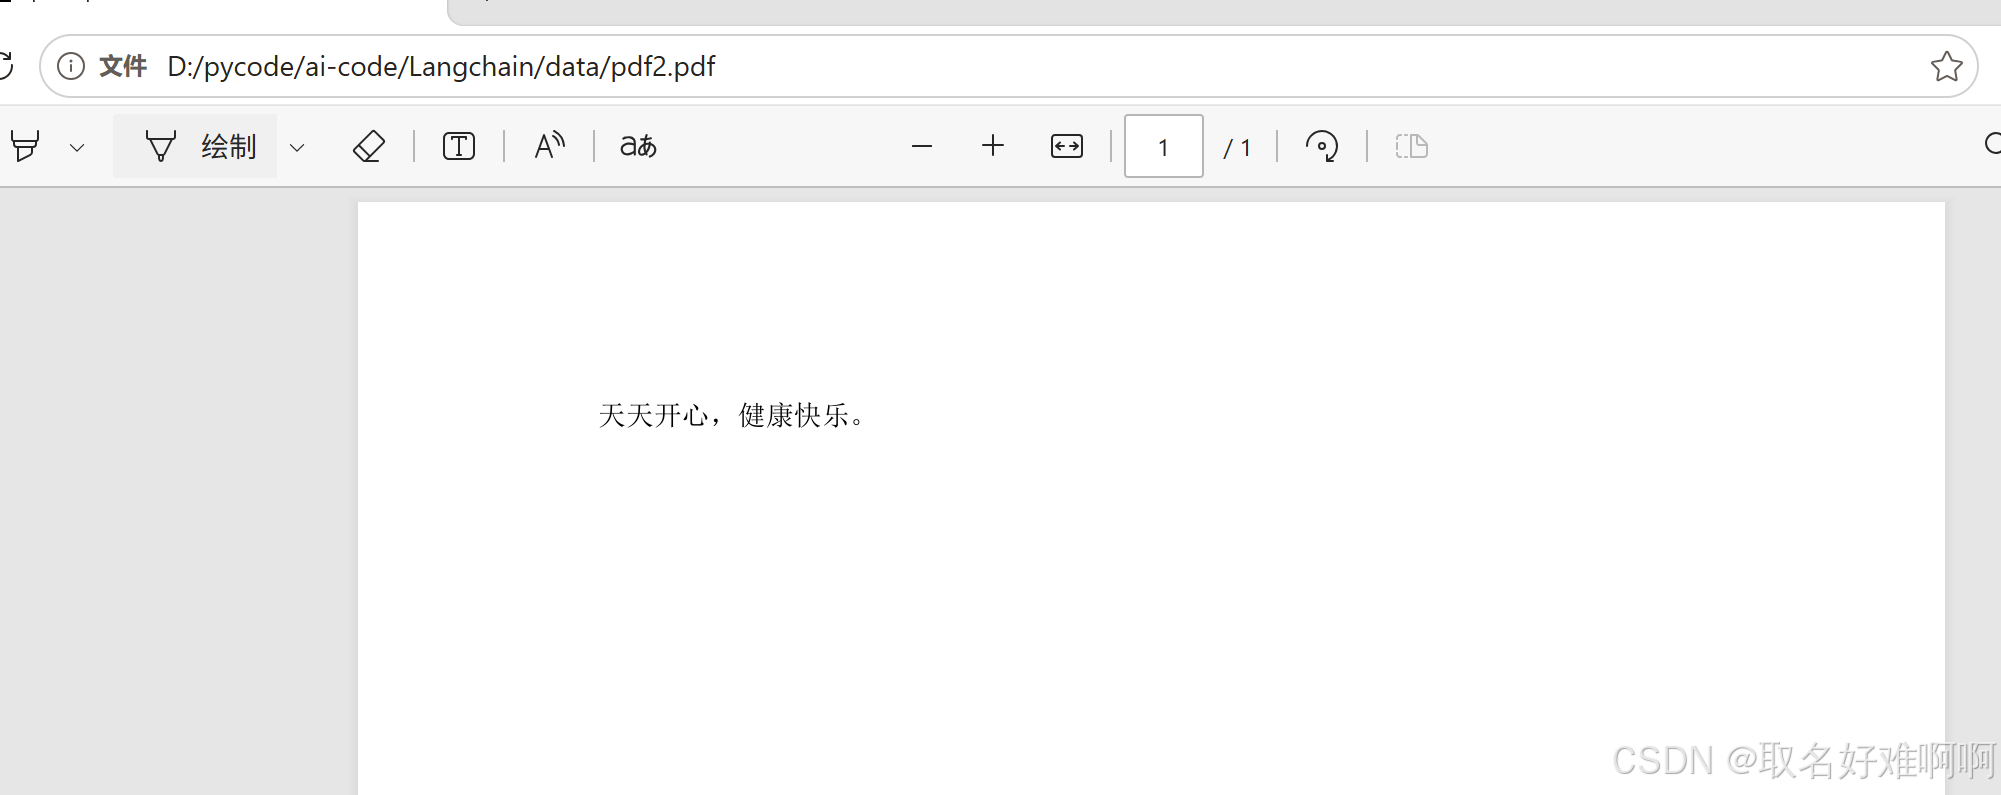
LangChain 内支持许多 PDF 的加载器,我们选择其中的 PyPDFLoader 使用,这个加载器依赖 PyPDF 库,所以需要用 pip install pypdf 命令来安装,用法也比较简单,直接看代码,首先准备课上的 pdf 文件。
然后写代码读取。
go
from langchain_community.document_loaders import PyPDFLoader

loader = PyPDFLoader(
    file_path="./data/pdf2.pdf",
    mode="single",        # 默认是page模式,每个页面形成一个Document文档对象,
                        # single模式,不管有多少页,只返回1个Document对象
    password="itheima"
)

i = 0
for doc in loader.lazy_load():
    i += 1
    print(doc)
    print("="*20, i)
输出如下:

其中 page_content 就是文档的内容,其他的就是元数据,比如创建时间,作者等等信息。
8.4 TextLoader
除了上面三个 Loader 以外,还有一个基本的加载器:TextLoader ,作用就是读取文件文本如 .txt,将全部内容放到一个 Document 中,但是如果文档很大,加载到一个 Document 就不太合适了,因此我们可以用 RecursiveCharacterTextSplitter 文本分割器,按自然段落分割大文档,这个是 LangChain 官方推荐的默认字符分割器,直接拿来就用。
首先还是一样用课上给的文件。
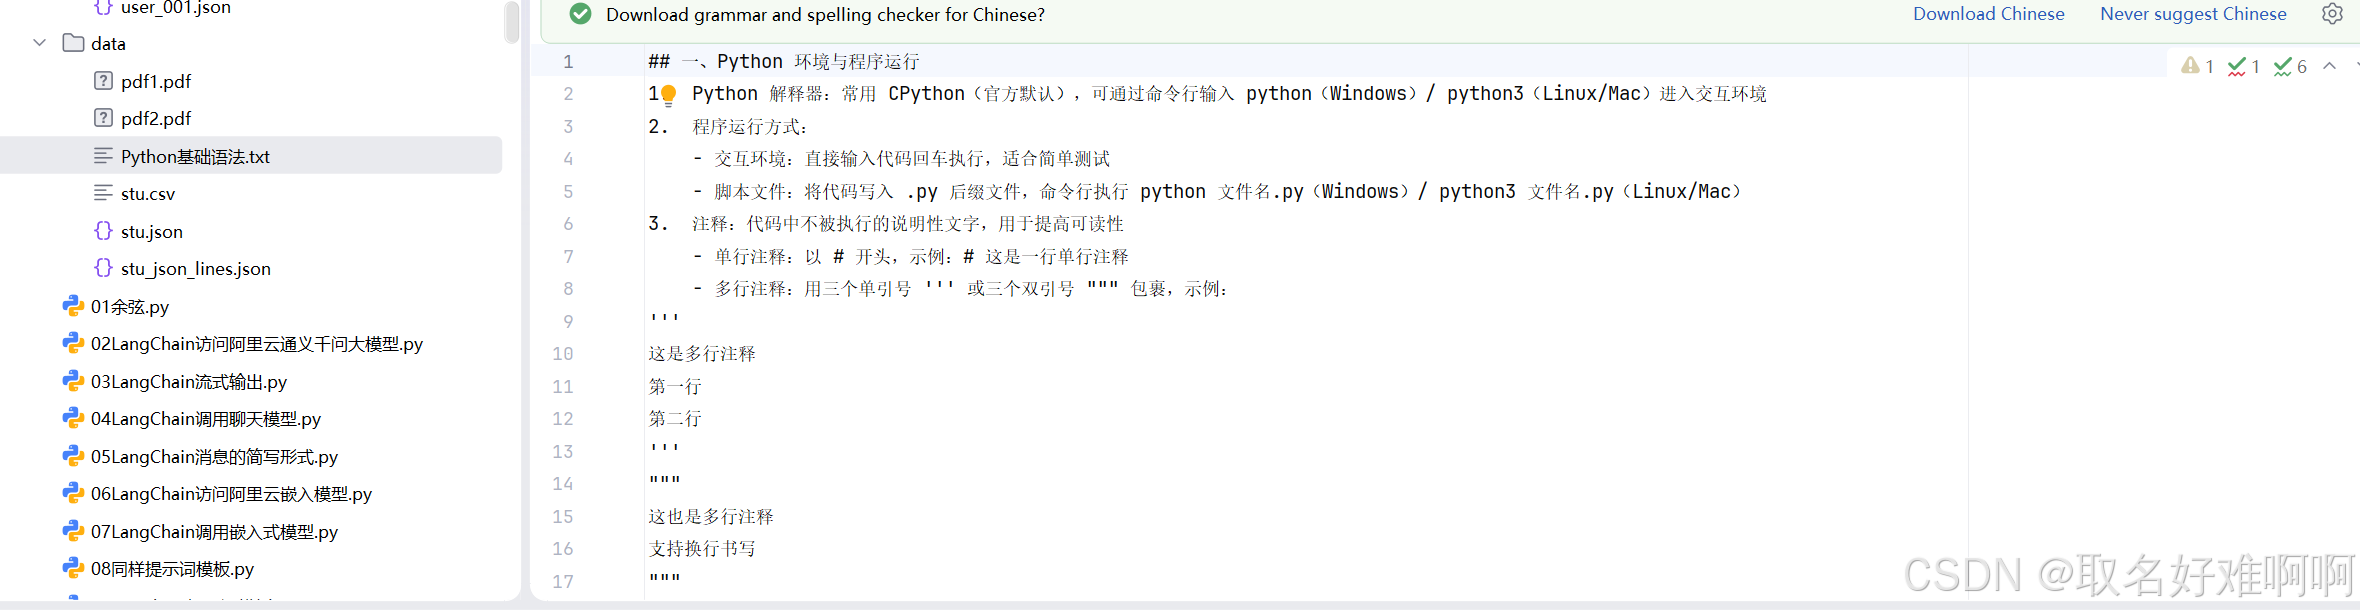
然后写代码。
go
from langchain_community.document_loaders import TextLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter

# pip install langchain_text_splitters

loader = TextLoader("./data/Python基础语法.txt", encoding="utf-8")

# 加载文件, 返回结果是 [Document] 类型的
docs = loader.load()

splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,         # 分段的最大字符数
    chunk_overlap=50,       # 分段之间允许重叠字符数
    # 文本自然段落分隔的依据符号
    separators=["\n\n", "\n", "。", "!", "?", ".", "!", "?", " ", ""],
    length_function=len,    # 统计字符的依据函数, 也就是通过什么函数去统计字符数
)

split_docs = splitter.split_documents(docs)
print(len(split_docs))
for doc in split_docs:
    print("="*20)
    print(doc)
    print("="*20)
输出如下。
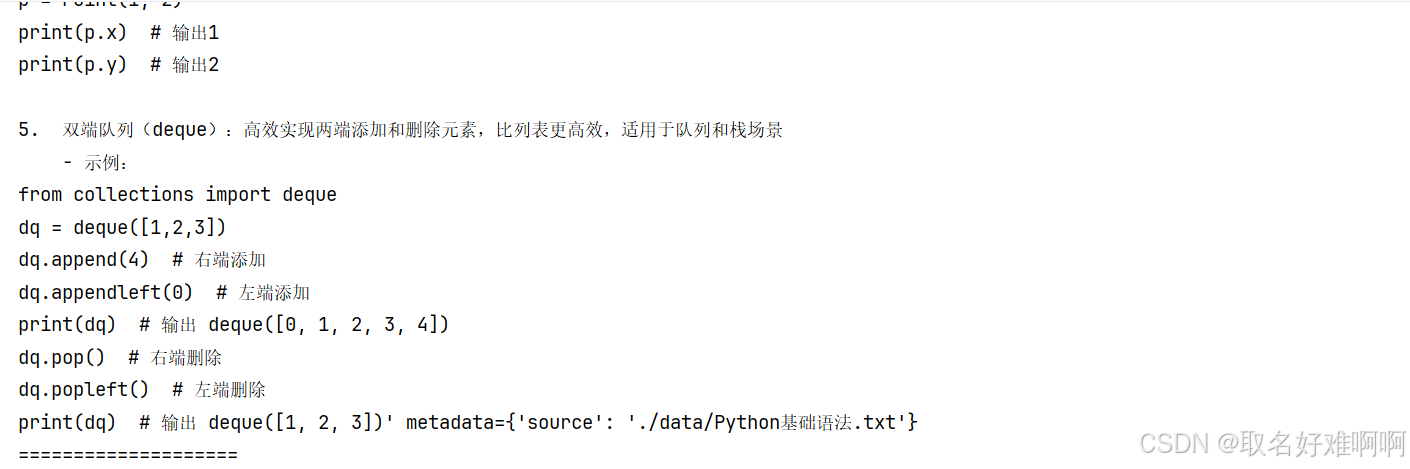
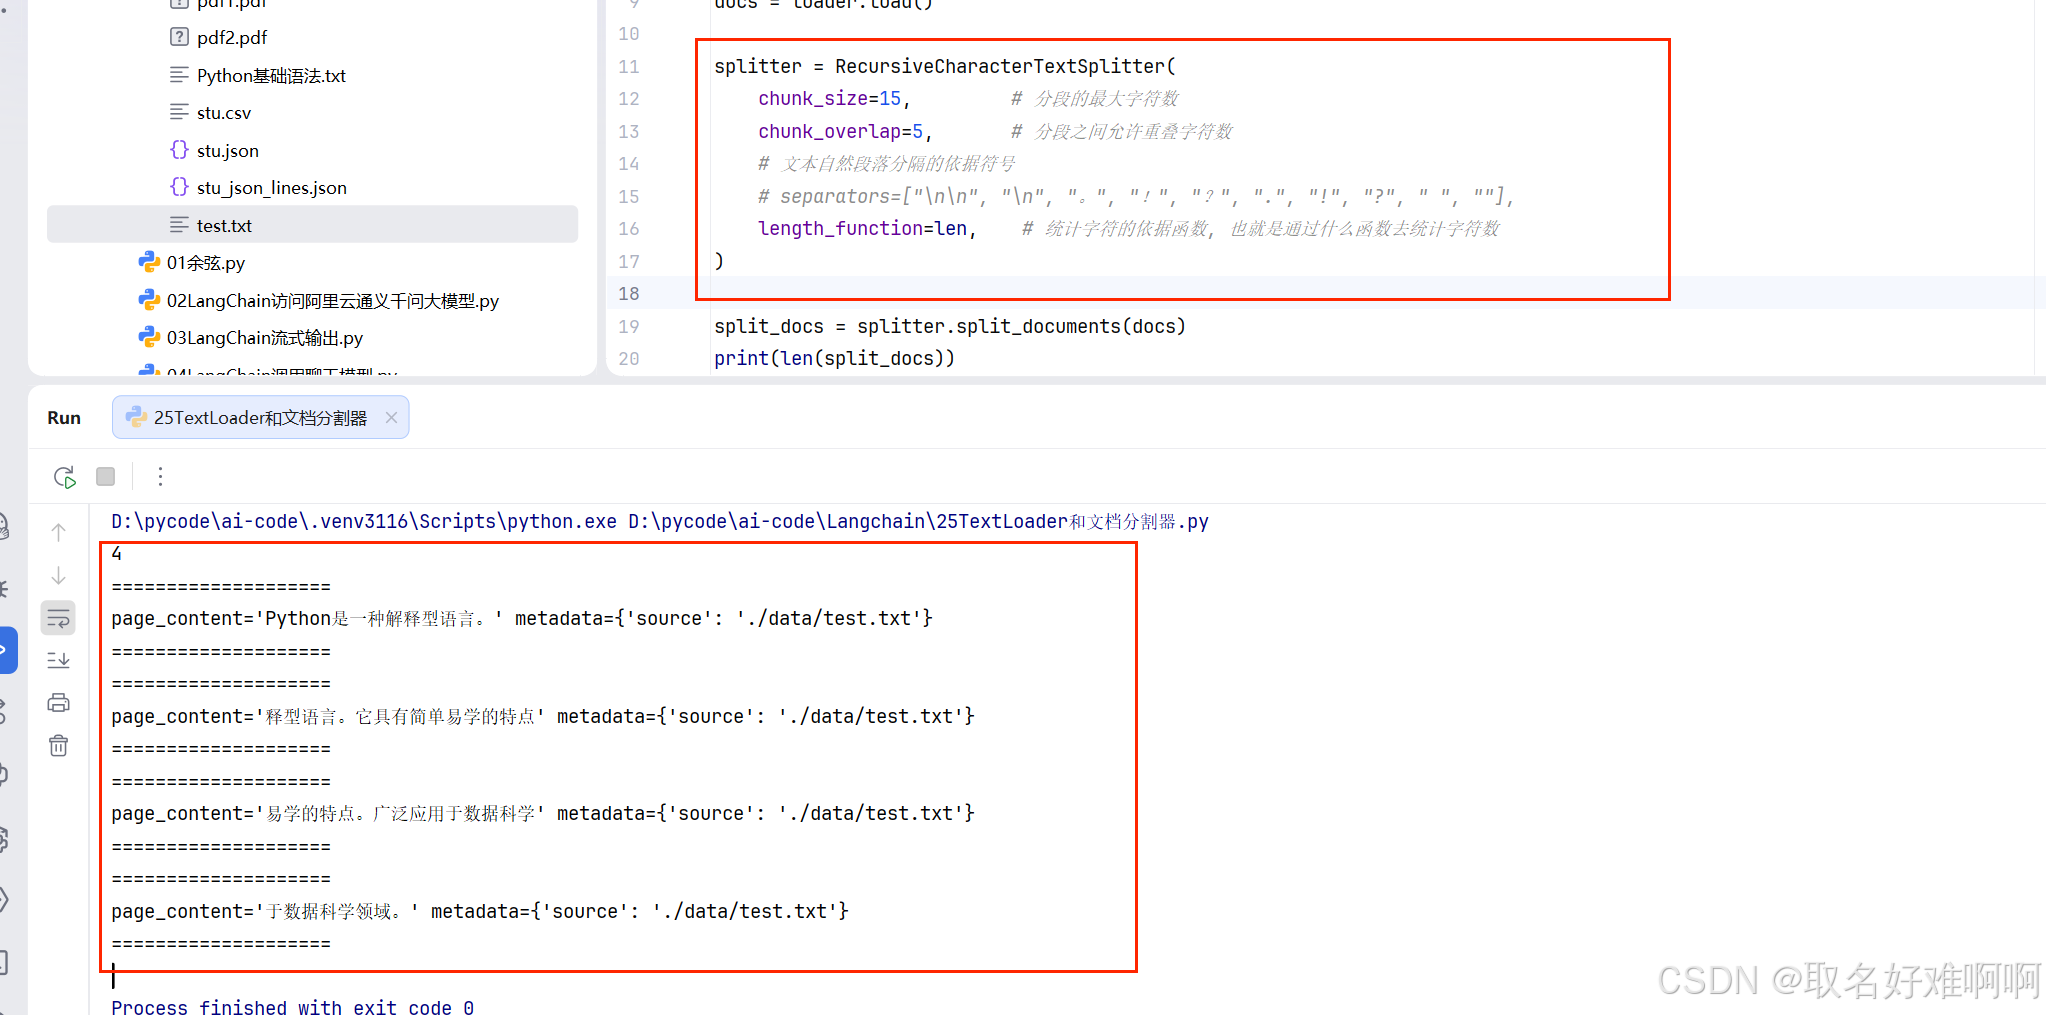
这里要说下 chunk_overlap,这个意思是分段之间允许重叠字符数,简单来说就是把一篇长文章切成一段一段时,chunk_overlap 决定了后一段的开头要重复前一段末尾的多少个字,确保 语义连续性。
举个例子:Python是一种解释型语言。它具有简单易学的特点。广泛应用于数据科学领域。
假设设置了 chunk_size = 15,chunk_overlap = 5,意思是每段大小 15,其中允许 5 个字符和上一段最后重复,那么最终分割出来的结果就是 4 段,这里把分隔符去掉,按照字节大小分。
- 第1段: Python是一种解释型语言。
- 第2段: 释型语言。它具有简单易学的特点
- 第3段: 易学的特点。广泛应用于数据科学
- 第4段: 于数据科学领域。
如有错误,欢迎指出!!!