官方代码+数据集:https://gitee.com/CodeStoreHub/buaa-mihr
内容导航
-
算法解决什么问题
-
算法结构与训练机制
-
BUAA-MIHR 数据集
-
实验设计
-
BUAA 实测结果
-
文件组织
-
安装与运行
1. 算法解决什么问题
远程光电容积描记(remote photoplethysmography,rPPG)利用血液容积变化引起的皮肤颜色微小变化,从视频中提取与脉搏相关的波形。摄像头记录的像素同时受到头部运动、光照变化、成像设备等因素影响,脉搏造成的变化往往比这些干扰弱得多。
仅让网络寻找视频中的周期性信号,可能学到周期性的头动或光照变化。NDCL 的思路是同时建模 生理信号、头动噪声、光照噪声,根据它们对不同增强方式的响应构造对比任务,再降低生理特征与噪声特征之间的依赖。
这不是简单地把两个噪声波形从 rPPG 输出中相减,而是通过训练约束,使共享特征提取器和各分支更好地分离信息。
2. 算法结构与训练机制
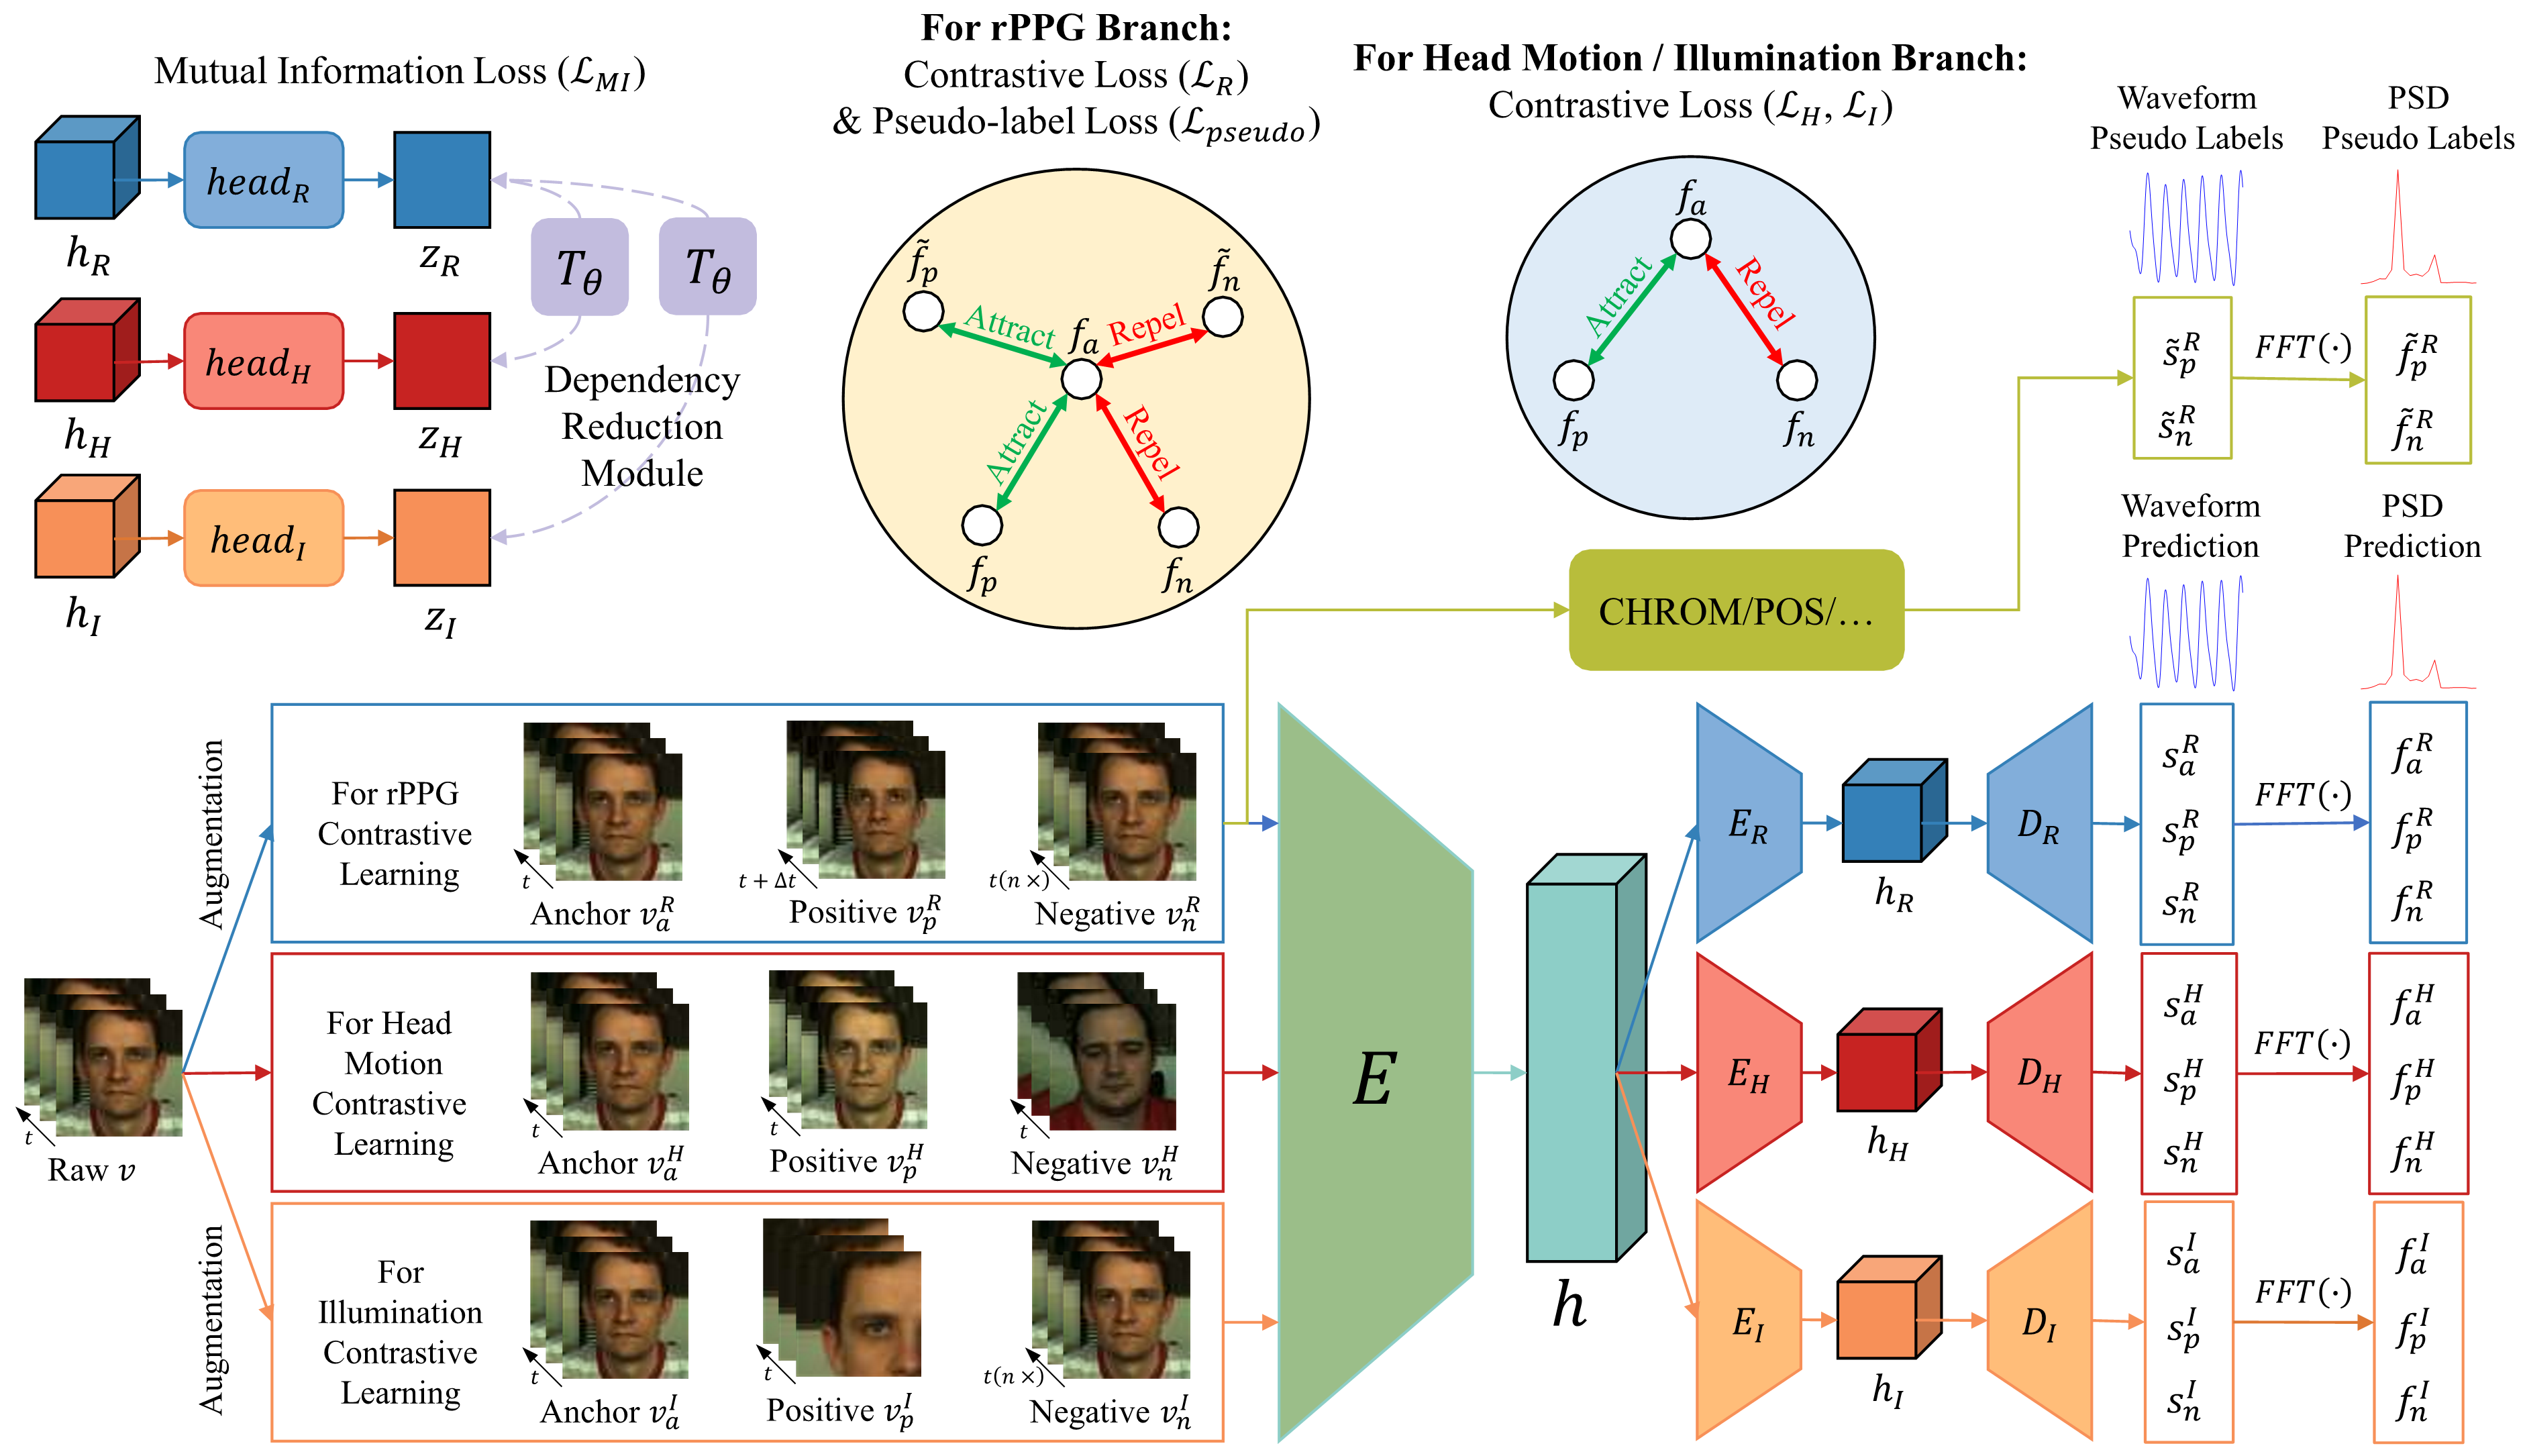
图 1:算法结构图。E 为共享特征提取器;R、H、I 分别对应脉搏、头动与光照分支。
2.1 共享编码与三个分支
输入视频首先生成锚样本、正样本和负样本,经过基于 PhysNet 的时空特征提取网络。三个分支分别输出时间序列,并提供用于依赖约束的特征表示:
| 分支 | 缩写 | 学习目标 |
|---|---|---|
| rPPG 分支 | RB / R | 从人脸视频恢复脉搏相关变化 |
| 头动分支 | HB / H | 表达与头部运动相关的干扰 |
| 光照分支 | IB / I | 表达与光照变化相关的干扰 |
从方法设计上,最终心率估计只需要 rPPG 输出。本代码测试时取网络返回值中的 rPPG 序列;当前 forward 仍计算三个分支,并未另做只执行单分支的推理裁剪。
2.2 为信号和噪声分别构造对比样本
"正样本"意味着希望目标分支认为两者相似,"负样本"意味着希望区分两者。相似性针对分支要学习的成分,并不是要求整幅视频看起来相似。
下面是本次运行代码中的增强选择;每次从对应列表随机选择一种增强:
| 训练分支 | 正样本增强 | 负样本增强 |
|---|---|---|
| rPPG | 空间增强或时间增强 | 频率增强或不同受试者样本 |
| 头动 | 颜色增强 | 频率增强或不同受试者样本 |
| 光照 | 空间增强 | 频率增强或颜色增强 |
空间增强包括水平翻转、缩放裁剪;频率增强通过改变采样速度改变信号的时间频率。不同受试者采样在代码中会检查受试者身份,避免误当成同一人的另一个片段。
这些设计依赖近似不变性假设,例如某些空间变换下,脉搏的主频应相近。它们不是对任意现实视频都严格成立的物理定律。
2.3 在功率谱密度上做对比
对分支输出序列做 FFT,得到功率谱密度(PSD),在指定频带内归一化,然后比较锚样本与正、负样本的距离。PSD 描述能量如何分布在不同频率上,相比逐点波形距离,对相位差更不敏感。
本次代码的主要对比形式可概括为:
Lcontrast = log10(1 + exp((d(anchor, positive) − d(anchor, negative)) / τ))
d = 归一化 PSD 的均方误差,τ = 0.07
上式对应代码中一个负样本的形式。距离通过 nn.MSELoss 对当前批次与频率维度求平均,不能直接等同于常见的逐样本、多负例分类式 InfoNCE 实现。训练 PSD 的频带为 20--300 bpm;它与后续心率评估滤波频带不是同一参数。
2.4 伪标签提供训练初期引导
传统方法 CHROM/POS 可以从视频颜色统计中得到粗略的 rPPG 信号。将这类方法的输出作为伪标签,引导网络避开与脉搏无关的周期性局部解。
伪标签来自视频,不是接触式传感器的真实标签。它们也可能受到噪声影响,所以只用于早期引导,并逐渐减弱:
γ = 当前 epoch / 预热轮数
Lstage1 = γ × LrPPG + (1 − γ) × Lpseudo
本次预热为 30 轮。超过预热阶段后,rPPG 优化损失不再包含伪标签项。关闭 PL 的消融从一开始就使用 rPPG 对比损失。
2.5 降低生理特征与噪声特征的依赖
使用互信息思想约束分支特征。目标是降低 rPPG 特征与头动、光照特征之间的依赖:
LMI = I(zR, zH) + I(zR, zI)通过 MINE 神经估计器近似互信息。第二阶段交替优化 rPPG、头动和光照任务,并使用动态任务权重调节两类噪声任务的影响。
2.6 从波形得到心率
测试时,对每段视频划分不重叠的 10 秒窗口,预测 rPPG 波形,再通过项目中的滤波与 eval_hr 方法计算心率。当前评估代码还对同一视频的窗口序列进行拼接滤波,再切回窗口,随后调用包含小波处理与峰检测的心率估计流程。并非仅取原始 FFT 的最大峰值。
真实 BVP 使用对应评估流程得到参考心率。所有窗口共同计算误差,不先按受试者平均,也不筛掉误差较大的窗口。
3. BUAA-MIHR 数据集
BUAA-MIHR 是面向多照度条件的 rPPG 数据集,由北京航空航天大学相关研究团队发布。受试者在受控暗室中录制,研究重点是不同照度下脉搏信号提取的稳定性。
官方介绍中,摄像设备为 Logitech C930E,视频参数为 640×480、30 fps、每段约 60 秒;接触式 PPG 由 CONTEC CMS50E 记录。照度覆盖约 1--100 lux。本地目录包含 1.0、1.6、2.5、4.0、6.3、10.0、15.8、25.1、39.8、63.1、100.0 lux。
图 2:BUAA-MIHR数据集预览
图 3:BUAA-MIHR数据集大小
3.1 原始视频样例
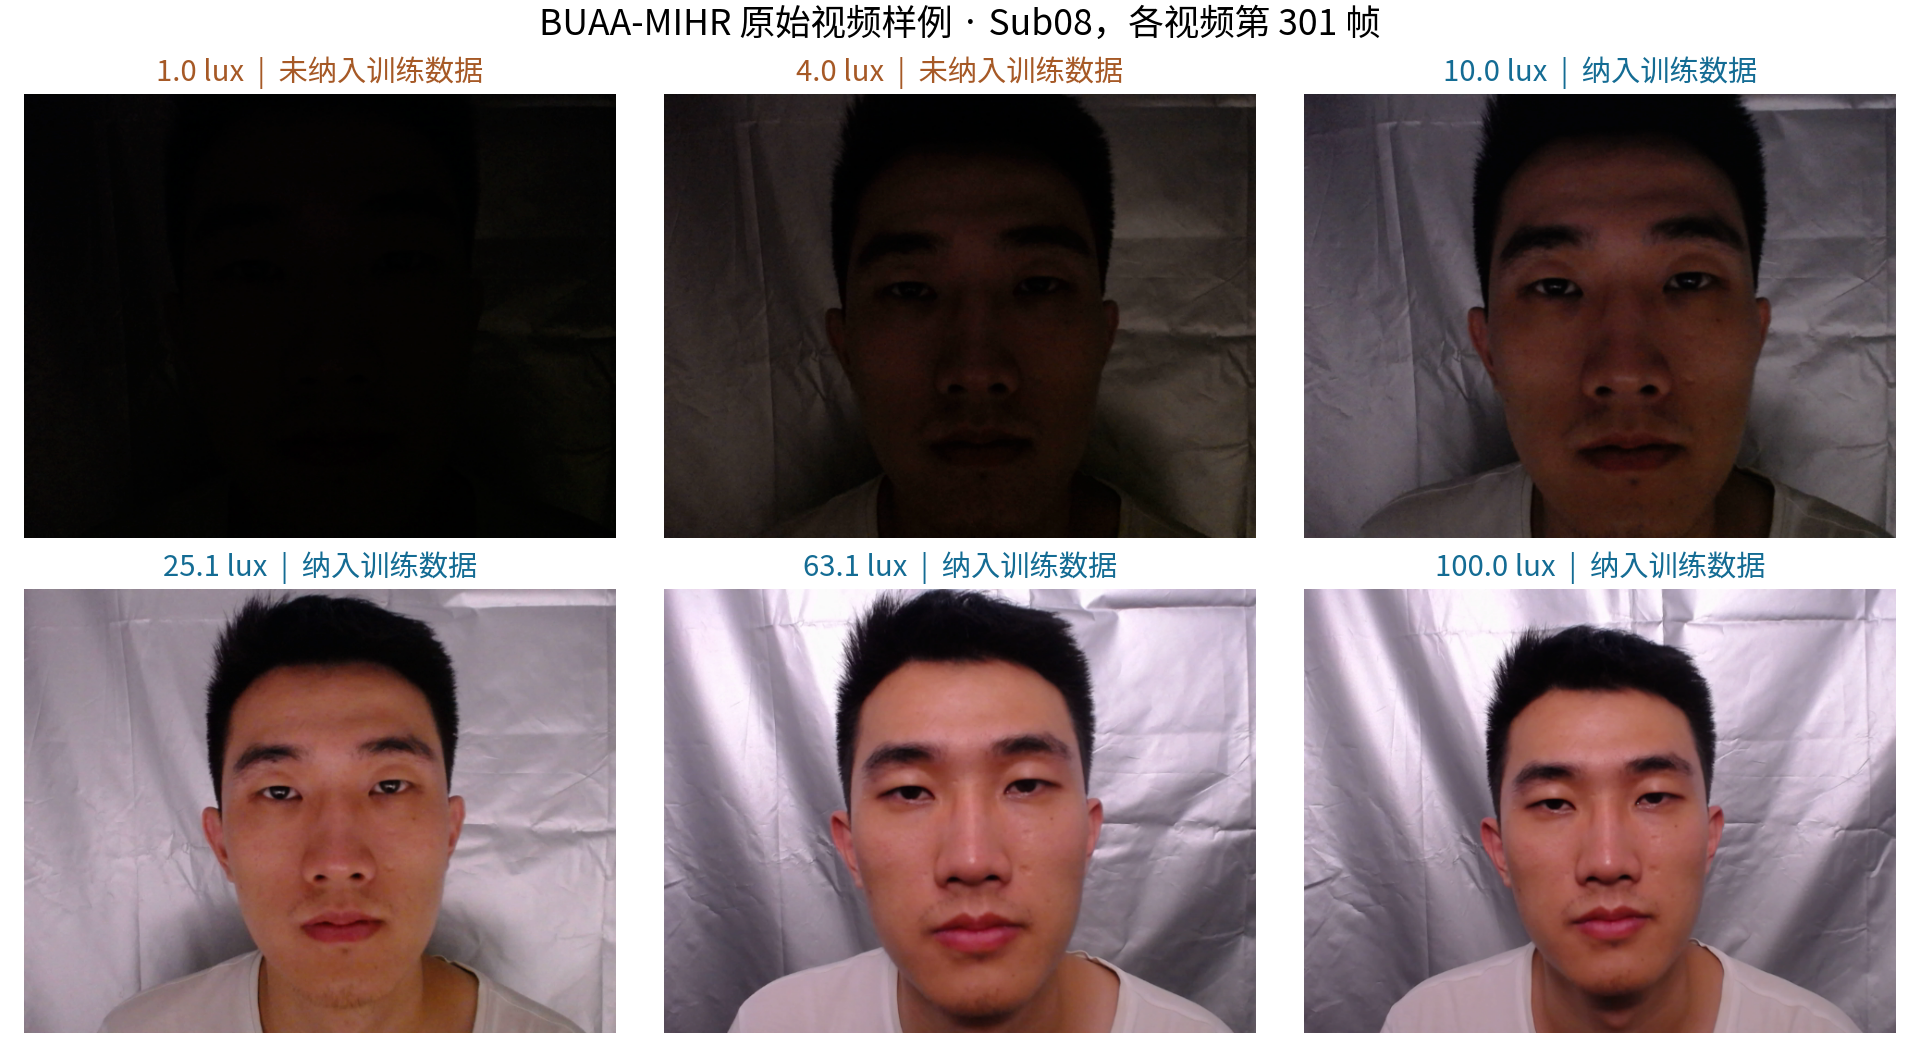
图 4:从本地 Sub08 的六种照度视频中,固定提取第 301 帧。低照度图片未额外提亮;图中部分低照度只用于介绍数据,不进入本次模型训练。各照度来自不同录制视频,并非同一瞬间的同步图像。
3.2 从原始视频到 H5
原始 AVI + PPG 标签
        ↓ OpenFace 提取人脸关键点
人脸区域裁剪、缩放到 128×128
        ↓ 标签插值与视频帧数对齐
H5:imgs[帧数,128,128,3] + bvp[帧数]
        ↓ 按受试者划分
训练时随机取 144 帧;测试时使用非重叠 300 帧窗口
预处理保留实际帧数:多数视频为 1800 帧,少数不足一分钟,不通过复制帧补齐。全体 78 段处理后视频合计 140,349 帧;人脸关键点成功率记录为 100%,但检测成功不等于裁剪与生理信号完全没有误差。
4. 本次实验设计
4.1 固定划分与调参隔离
| 阶段 | 用于优化模型 | 用于评估/选择 | 视频数 |
|---|---|---|---|
| 内部调参 | Sub01--08 | Sub09--10 验证 | 48 / 12 |
| 六组最终训练与测试 | Sub01--10 | Sub11--13 测试 | 60 / 18 |
对应文件清单保存在split.json。测试共 108 个 10 秒窗口。本轮所有模型从头训练,完成全部最终训练后,再统一执行测试。
4.2 调参结果
| 学习率 | 评估 epoch | 验证 MAE ↓ | 验证 RMSE ↓ |
|---|---|---|---|
| 1e-4 | 45 | 2.0211 | 2.5135 |
| 1e-4 | 60 | 1.9240 | 2.2596 |
| 1e-4 | 90 | 1.7084 | 2.3235 |
| 2e-4 | 45 | 2.1474 | 2.6790 |
| 2e-4 | 60 | 2.0578 | 2.3495 |
| 2e-4 | 90 | 1.7250 | 2.2863 |
按预先设定的验证 MAE 优先规则,选择学习率 1e-4、90 epochs。六组正式实验采用同一组超参数,以便比较组件变化。真实标签不进入训练优化损失,但用于验证选择超参数,因此模型选择属于带标签验证辅助的流程。
4.3 运行设置
| 项目 | 本次运行 |
|---|---|
| GPU | NVIDIA RTX 3090,24GB |
| 软件 | Python 3.9.25,PyTorch 2.4.0+cu124,torchvision 0.19.0+cu124 |
| 输入 | RGB,128×128,30 fps |
| 训练片段 | 144 帧,约 4.8 秒 |
| batch size | 4 |
| 优化器 | AdamW,学习率 1e-4,weight decay 0 |
| 总轮数 / 预热 | 90 / 30 |
| 精度与显存 | FP32,梯度检查点,训练显存约 22--23GiB |
| 随机种子 | 42,单次正式运行 |
| 评估窗口 | 10 秒,非重叠 |
| 完成时间 | 2026-09-10 22:42 |
| 总耗时 | 含两组调参、六组最终训练与测试,约 6 小时 10 分钟 |
5. BUAA 实测结果
5.1 指标如何理解
- MAE:预测心率与真实心率的平均绝对误差,单位 bpm(次/分钟),越小越好。
- RMSE:误差平方均值的平方根,单位 bpm,对大误差更敏感,越小越好。
- R :相关系数,越接近 1 表示变化趋势越一致;高相关不代表没有系统偏差。项目
MyEval的相关系数分母有0.01稳定项,这里沿用其实现。
5.2 六组组件与对比策略实验
| 配置 | RB | PL | HB | IB | 噪声对比 | MAE ↓ | RMSE ↓ | R ↑ |
|---|---|---|---|---|---|---|---|---|
| full | ✓ | ✓ | ✓ | ✓ | PSD | 1.8353 | 2.0705 | 0.9913 |
| rb | ✓ | --- | --- | --- | --- | 2.1311 | 2.4210 | 0.9924 |
| rb_pl | ✓ | ✓ | --- | --- | --- | 1.7127 | 1.9550 | 0.9903 |
| rb_pl_hb | ✓ | ✓ | ✓ | --- | PSD | 1.8603 | 2.0861 | 0.9929 |
| rb_pl_ib | ✓ | ✓ | --- | ✓ | PSD | 1.7971 | 1.9788 | 0.9966 |
6. 文件组织
rPPG-NDCL_BUAA_20260911/
├── README.md                          # 本文
├── data/
│   └── BUAA-MIHR/                     # 原始数据;其他数据集可与其并列
│       ├── Sub 01/ ... Sub 13/
│       └── SHA256SUMS_RAW              # 原始数据校验清单
├── datasets/BUAA-NDCL/
│   ├── h5/                            # 训练/测试真正读取的 78 个 H5
│   ├── lmk/                           # OpenFace 人脸关键点
│   ├── labels/                        # Sub04 回退标签
│   └── manifest.json
├── models/                            # NDCL 网络与优化逻辑
├── data_process/                      # 视频片段采样和增强
├── configs/buaa_suite/                # 六组配置、split.json
├── checkpoints/BUAA/buaa_suite_*/      # 附带的 90.pth 最终模型
├── reference_results/                 # 原实验指标、预测和日志
├── docs/images/                       # 本文数据样例和实测图表
├── tools/OpenFace/                    # OpenFace 源码和模型资源
├── tools/dlib-19.24.6/                 # dlib 源码
├── scripts/share_buaa.py               # 可移动路径的训练/测试入口
├── scripts/prepare_buaa.py             # 原始 BUAA → H5
├── scripts/build_openface.sh           # OpenFace 编译脚本
├── scripts/run_buaa_suite.py           # 调参 → 六组训练 → 测试
├── scripts/make_readme_figures.py       # 用实际数据重新绘制本文图片
├── environment/                       # 运行环境、数据与推理校验记录
├── 运行环境与训练测试说明.txt
└── 原始数据生成H5说明.txt
7. 安装与运行
7.1 创建环境
在本 README 所在目录执行:
conda create -n ndcl-buaa python=3.9.25 -y
conda activate ndcl-buaa
python -m pip install torch==2.4.0 torchvision==0.19.0 --index-url https://download.pytorch.org/whl/cu124
python -m pip install -r requirements.txt
python scripts/share_buaa.py check
python -m unittest discover -s tests -v
需要支持 CUDA 的 NVIDIA GPU;本次在 24GB RTX 3090 上验证。Python 环境列表与驱动记录位于 environment/。
7.2 直接测试附带模型
# 完整 NDCL
python scripts/share_buaa.py test --variant full
全部六组
python scripts/share_buaa.py test-all
输出写入 runs/share_组名/BUAA/test/metrics.json 和 clips.csv。若存在自行训练的 checkpoints/BUAA/share_组名/90.pth,入口会优先使用它;否则使用附带的 buaa_suite_组名/90.pth,终端会打印实际权重路径。
7.3 使用已选参数重新训练
python scripts/share_buaa.py train --variant full
python scripts/share_buaa.py test --variant full
或完整六组
python scripts/share_buaa.py train-all
python scripts/share_buaa.py test-all
新权重写入 checkpoints/BUAA/share_组名/,不会覆盖附带模型。重复相同训练命令会从头运行并覆盖该实验名下同名权重,需要保留多次运行时应先备份或修改实验名。
7.4 重新执行调参和全部实验
python scripts/share_buaa.py suite该队列依次执行两档学习率调参、六组从头训练及统一测试,状态见 runs/buaa_suite/status.json。分享包中的新模型名为 rerun_suite_组名,以保护附带的原始权重;测试结果由队列自行生成。失败训练阶段重启时从头训练,并非恢复完整优化器状态。
7.5 从原始 BUAA 重新生成 H5
已有 H5 可以直接训练;只有需要复查预处理时,才需要编译 OpenFace。Ubuntu 下先安装开发依赖:
sudo apt-get update
sudo apt-get install -y build-essential cmake pkg-config libopencv-dev libopenblas-dev libboost-filesystem-dev libboost-system-dev libgtk-3-dev libjpeg-dev libpng-dev libtiff-dev
bash scripts/build_openface.sh
先处理一个视频
python scripts/prepare_buaa.py --raw data/BUAA-MIHR --output datasets/BUAA-NDCL_smoke --openface tools/OpenFace/build/bin/FeatureExtraction --workers 1 --limit 1
生成全部 78 个 H5,保留已有数据作为参照
python scripts/prepare_buaa.py --raw data/BUAA-MIHR --output datasets/BUAA-NDCL_rebuilt --openface tools/OpenFace/build/bin/FeatureExtraction --workers 4
已经存在 H5 和对应质量 JSON 的视频会被跳过。改变预处理设置后,应使用新的输出目录避免复用旧缓存。完整安装、目录切换和排错步骤见 原始数据生成 H5 说明。