DINO 去年就很火了,但一直没来得及关注,最近看了好几篇论文都是基于 DINO 模型做的,也来系列学习一下 DINO 的系列技术!
论文:
DINOv1:Emerging Properties in Self-Supervised Vision Transformers
DINOv2:Learning Robust Visual Features without Supervision
代码:
DINOv1:https://github.com/facebookresearch/dino
DINOv2:https://github.com/facebookresearch/dinov2
DINOv3:https://github.com/facebookresearch/dinov3
1、DINO 的含义
DINO 是什么含义,它是什么的缩写呢?他是个模型还是个方法呢?
论文中写道:DINO:Self-DIstillation with NO labels(无标签自蒸馏),可见 DINO 是一种创新的自监督学习框架 。(那什么是自监督学习,又为什么要自监督呢)
2、自监督学习
2.1、兴起背景
1、监督学习的数据瓶颈: 传统深度学习高度依赖人工标注数据,在图像、语音、医疗影像等场景下,高质量标注成本极高、部分场景甚至难以标注(例如医学病灶标注需要资深专家);标注数据存在标注噪声、类别不平衡问题。模型在小标注集上容易过拟合,海量无标注数据(互联网图片、文本、音频)无法被充分利用。
2、算力与模型容量提升: 单纯有监督训练容易在有限标注数据上饱和,或许模型可以先从无标签数据学习通用基础特征,再在小标注数据集微调,即预训练 + 微调范式。
3、对比学习思想的复兴与 NLP 领域的成功启发: NLP 领域率先验证自监督巨大潜力:BERT 等采用掩码预训练,利用文本自身结构构造监督信号,在海量无标注文本学到通用语言表征,大幅刷新下游任务性能。
4、下游任务泛化需求: 监督学习学到的特征偏向拟合任务特定标签,迁移能力弱。希望模型学习与任务无关、更底层的通用视觉 / 声学特征,从而在少量标注数据下快速适配新任务。
总的来说,海量无标签数据易得、标注昂贵;大模型有能力学习特征;需要一种不依赖人工标签的预训练方式,于是自监督学习兴起。(那么,有哪些自监督的学习模式呢)
2.2、传统自监督方法
核心思路:设计代理任务,把无标签样本输入,由数据本身生成伪标签,训练模型解决这个代理任务,从而学到有用特征。
1、图像拼图 :把图片切分成若干图块,打乱顺序;模型预测图块的正确排列顺序。
2、图像旋转预测 :对图片做 0°、90°、180°、270° 旋转,让模型预测旋转角度。
3、图像上色 :输入灰度图,模型预测原图彩色通道,学习物体、场景语义。
4、图像修复 / 掩码填充 :把图片一块区域遮挡,模型预测被遮挡区域像素。
5、相对位置预测:给定两个图像 patch,预测二者在原图中的相对空间位置。
然而,传统自监督方法具有固有缺陷,如:
- 代理任务与下游任务存在任务错位,代理任务是人为设计的,学到的特征优先服务于代理任务,不一定是下游任务真正需要的特征。
- 表征学习能力弱,全局语义捕捉不足,传统方法大多偏向局部像素、低级视觉信息(边缘、纹理、空间位置),很难学习高层语义特征。很多任务本质是像素级重构,模型容易学习底层像素相关性而非抽象语义。
- 伪监督信号存在噪声,存在捷径学习,模型会找到代理任务里简单的统计捷径,而不是学习真实语义。
- 表征坍缩问题,模型倾向直接学习像素信息,容易学到冗余信息;不同样本的表征区分度不足。
- 设计成本高,每一类数据都要专门设计代理任务,很难通用;换模态、换数据集就要重新构思代理任务,难以规模化。
3、DINOv1:自蒸馏框架的提出与验证
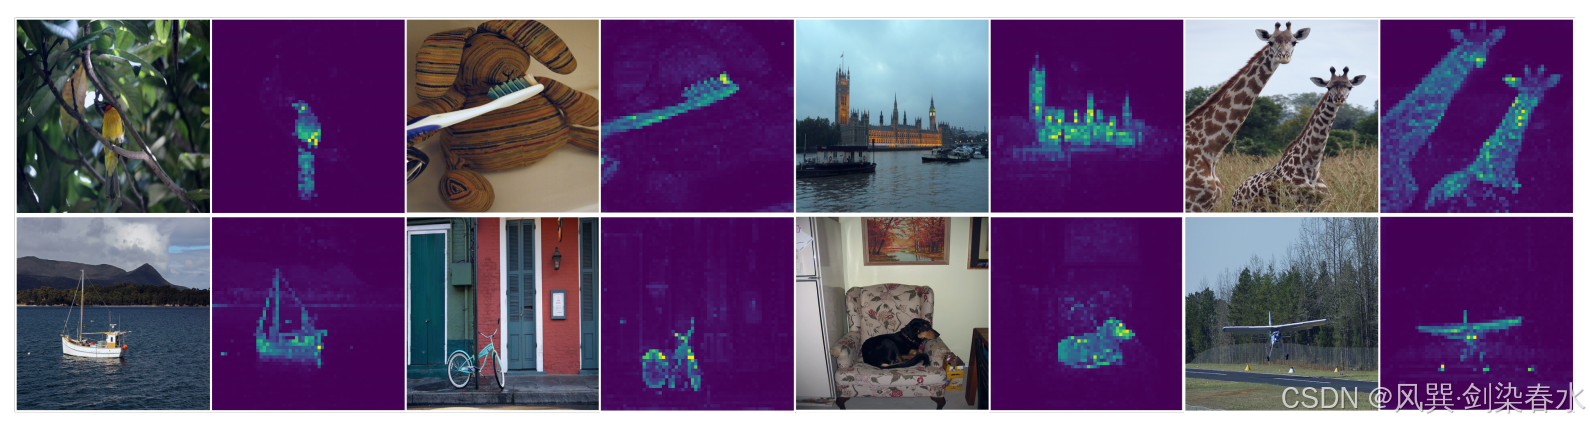
**Figure 1 | 无监督训练下、patch 尺寸为 8 × 8 8 \times 8 8×8 的视觉 Transformer 的自注意力结果:**DINOv1 分析最后一层各注意力头中 CLS \texttt{CLS} CLS token 的自注意力。该 token 未绑定任何标签,也不接受监督信号。这些注意力图表明,模型可自动学习类别专属特征,进而实现无监督目标分割。
3.1、解决什么问题
核心出发点: 质疑自监督学习是否能为 Vision Transformer(ViT)提供相比卷积网络(convnets)更突出的新特性。
要解决的问题: 在无标签条件下,设计一个简单、通用、无需复杂组件的自监督自蒸馏框架,充分释放 ViT 的潜力,并验证自监督 ViT 是否能产生超越监督 ViT 和 convnets 的独特性质。
3.2、怎么解决问题
DINOv1 没有提出全新的网络架构,而是基于标准 ViT 或 ResNet,设计了新的自监督训练机制。核心原理为:**在无标签条件下,让学生网络在不同视图上的输出去匹配一个由学生自身指数移动平均构建的动量教师网络的输出,并通过"中心化 + 锐化"避免模型坍塌。**主要包含的机制如下:
3.2.1、输入与视图生成
对于每一张输入图像 x x x,采用多裁剪策略生成一组视图 V V V:
- 2 个全局视图 x 1 g , x 2 g x_1^g, x_2^g x1g,x2g:分辨率为 224 2 224^2 2242,覆盖原图的较大区域(通常大于 50%)。
- 若干局部视图:分辨率为 96 2 96^2 962,覆盖原图的较小区域(通常小于 50%),默认使用 6 个或 10 个局部视图。
数据增强沿用 BYOL 方案:颜色抖动、高斯模糊、曝光变换,同时在多裁剪操作中使用双三次插值,适配位置嵌入。
3.2.2、学生与教师网络的前向传播
- 学生网络 g θ s g_{\theta_s} gθs:接收全部视图(全局视图与局部视图)作为输入,输出概率分布 P s P_s Ps。
- 教师网络 g θ t g_{\theta_t} gθt:仅接收全局视图作为输入,输出概率分布 P t P_t Pt。
两个网络具有完全相同的结构,均由骨干网络 f f f(ViT 或 ResNet)与投影头 h h h 组成: g = h ∘ f g = h \circ f g=h∘f。其中投影头由 3 层 MLP(隐藏维度为 2048)、 ℓ 2 \ell_2 ℓ2 归一化以及权重归一化全连接层组成,输出 K K K 维特征向量(默认取 K = 65536 K = 65536 K=65536)。对于 ViT 架构,使用 CLS token 聚合全局信息,投影头接在 CLS 输出之后。
概率分布由带温度系数的 softmax 函数计算得到:
P s ( x ) ( i ) = exp ( g θ s ( x ) ( i ) / τ s ) ∑ k = 1 K exp ( g θ s ( x ) ( k ) / τ s ) P_s(x)^{(i)} = \frac{\exp\left(g_{\theta_s}(x)^{(i)} / \tau_s\right)}{\sum_{k=1}^{K} \exp\left(g_{\theta_s}(x)^{(k)} / \tau_s\right)} Ps(x)(i)=∑k=1Kexp(gθs(x)(k)/τs)exp(gθs(x)(i)/τs)教师网络同理,其概率分布 P t P_t Pt 采用温度系数 τ t \tau_t τt 进行计算。
3.2.3、损失函数:局部到全局的交叉熵匹配
学生网络利用局部视图,对教师网络的全局视图输出做预测,损失函数如下:
min θ s ∑ x ∈ { x 1 g , x 2 g } ∑ x ′ ∈ V x ′ ≠ x H ( P t ( x ) , P s ( x ′ ) ) \min_{\theta_s}\sum_{x\in\{x_1^g,x_2^g\}}\sum_{\substack{x'\in V\\x'\neq x}} H\big(P_t(x),P_s(x')\big) θsminx∈{x1g,x2g}∑x′∈Vx′=x∑H(Pt(x),Ps(x′)) 其中 H ( a , b ) = − a log b H(a,b)=-a\log b H(a,b)=−alogb 代表交叉熵。教师网络的输出执行梯度停止(stop‑gradient)操作,不参与反向传播;梯度仅经由学生网络进行传递。
模型坍塌: 这里没有人工标签,也没有负样本。如果学生网络把所有输入都映射到同一个常数输出,那么教师网络也会输出同一个常数。此时学生和教师的输出完全一致,交叉熵损失为零,但模型没有学到任何有区分度的特征。
- 均匀坍塌: 所有输入输出相同的均匀分布,所有维度都被同等激活,但没有任何样本区分能力。
- 维度坍塌: 输出被某一个或少数几个维度主导,其他维度失效,模型只利用极少数自由度。
3.2.4、教师更新:动量编码器
教师网络参数并非预先给定,而是由学生网络参数做指数移动平均得到:
θ t ← λ θ t + ( 1 − λ ) θ s \theta_t \leftarrow \lambda\theta_t + (1-\lambda)\theta_s θt←λθt+(1−λ)θs 其中 λ \lambda λ 采用余弦调度,取值由 0.996 变化至 1。论文实验表明,动量教师在全部训练周期内性能持续优于学生网络,具备 "模型集成" 与训练引导的效果,该机制可理解为 Polyak‑Ruppert 平均或者 Mean Teacher 自蒸馏。
3.2.5、避免坍塌:中心化 + 锐化
自监督自蒸馏的主要风险为模型坍塌。DINO 仅依靠两项操作协同抑制模型坍塌:
-
中心化 :教师输出减去滑动平均得到的中心 c c c:
c ← m c + ( 1 − m ) 1 B ∑ i = 1 B g θ t ( x i ) c \leftarrow mc + (1-m)\frac{1}{B}\sum_{i=1}^{B} g_{\theta_t}(x_i) c←mc+(1−m)B1i=1∑Bgθt(xi)该操作可以避免单个特征维度占据主导,但会倾向于产生均匀输出分布。
-
锐化 :教师网络的 softmax 采用较低温度系数 τ t \tau_t τt,让输出分布变得尖锐,以此规避均匀模式坍塌。
两者互补:**中心化防止维度坍塌,锐化防止均匀坍塌。**论文将交叉熵拆解为熵 h ( P t ) h(P_t) h(Pt) 与 KL 散度 D K L ( P t ∥ P s ) D_{KL}(P_t\|P_s) DKL(Pt∥Ps),证明两项操作任意缺失其一时,KL 散度将收敛至零,即发生模型坍塌。
| 操作 | 防止的坍塌类型 | 单独使用的副作用 |
|---|---|---|
| 中心化 | 防止某一维度主导 | 鼓励输出均匀,导致均匀坍塌 |
| 锐化 | 防止输出均匀 | 鼓励某一维度主导,导致维度坍塌 |
Algorithm 1 | DINO PyTorch 伪代码(不含多区域裁剪功能):
python
# gs, gt: student and teacher networks
# C: center (K)
# tps, tpt: student and teacher temperatures
# l, m: network and center momentum rates
gt.params = gs.params
for x in loader: # load a minibatch x with n samples
    x1, x2 = augment(x), augment(x) # random views

    s1, s2 = gs(x1), gs(x2) # student output n-by-K
    t1, t2 = gt(x1), gt(x2) # teacher output n-by-K

    loss = H(t1, s2)/2 + H(t2, s1)/2
    loss.backward() # back-propagate

    # student, teacher and center updates
    update(gs) # SGD
    gt.params = l*gt.params + (1-l)*gs.params
    C = m*C + (1-m)*cat([t1, t2]).mean(dim=0)

def H(t, s):
    t = t.detach() # stop gradient
    s = softmax(s / tps, dim=1)
    t = softmax((t - C) / tpt, dim=1) # center + sharpen
    return - (t * log(s)).sum(dim=1).mean()
3.2.6、训练配置
- 在 ImageNet 数据集上开展无标签预训练,采用 AdamW 优化器,批次大小设置为 1024。
- 学习率线性预热 10 epoch,基础值 l r = 0.0005 × b a t c h s i z e / 256 lr = 0.0005 \times \mathrm{batchsize}/256 lr=0.0005×batchsize/256,之后余弦衰减。
- 权重衰减余弦调度 0.04 到 0.4。
- 学生温度系数 τ s = 0.1 \tau_s = 0.1 τs=0.1;教师端温度系数 τ t \tau_t τt 在前 30 个训练轮次由 0.04 线性预热至 0.07。
- ViT-S/16 使用 16 个 GPU 训练。
3.3、关键发现与突破
自监督 ViT 能产生显式包含场景布局 与物体边界 的特征,其最后一层自注意力图涌现出无监督物体分割能力,同时具备极强的 k-NN 分类性能 ,k-NN 接近线性分类。其方法突破在于用极简的 "动量教师 + 多裁剪 + 中心化 + 锐化" 实现稳定的无标签自蒸馏,无需负样本、对比损失、predictor、BN 或 Sinkhorn-Knopp。其延伸意义在于揭示了 ViT 与自监督的协同效应,证明自监督预训练 ViT 可超越监督预训练,并为后续视觉基础模型、无监督分割和检索研究奠定了基础。
DINOv1 用极简的自蒸馏机制,让无标签 ViT 涌现出物体分割能力和强 k-NN 特征,证明了自监督学习可以成为视觉 Transformer 预训练的更优路径。
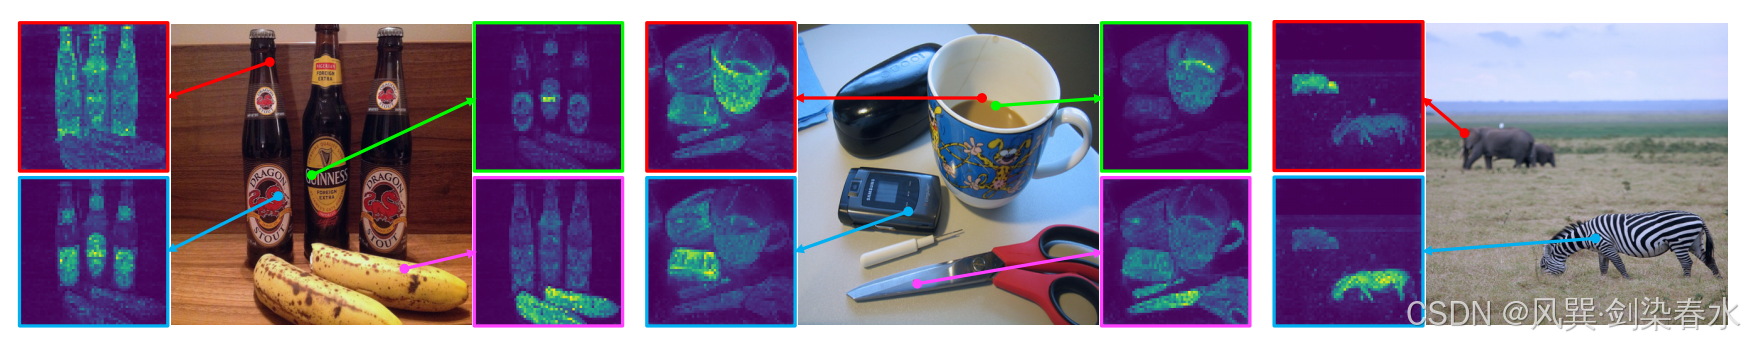
**Figure 2 | 一组参考点对应的自注意力结果:**对采用 DINO 算法训练得到的 ViT‑S/8 模型最后一个模块的自注意力模块进行可视化。尽管该网络完全采用无监督方式训练,但其仍具备区分不同目标的能力。
4、DINOv2:以规模化实现通用化与应用化
DINOv2 的核心目标: 在无监督条件下,通过大规模精选数据和扩展的模型规模,学习稳健的、通用的视觉特征,使其无需微调即可在图像级和像素级任务上工作,并达到或超越弱监督模型的表现。
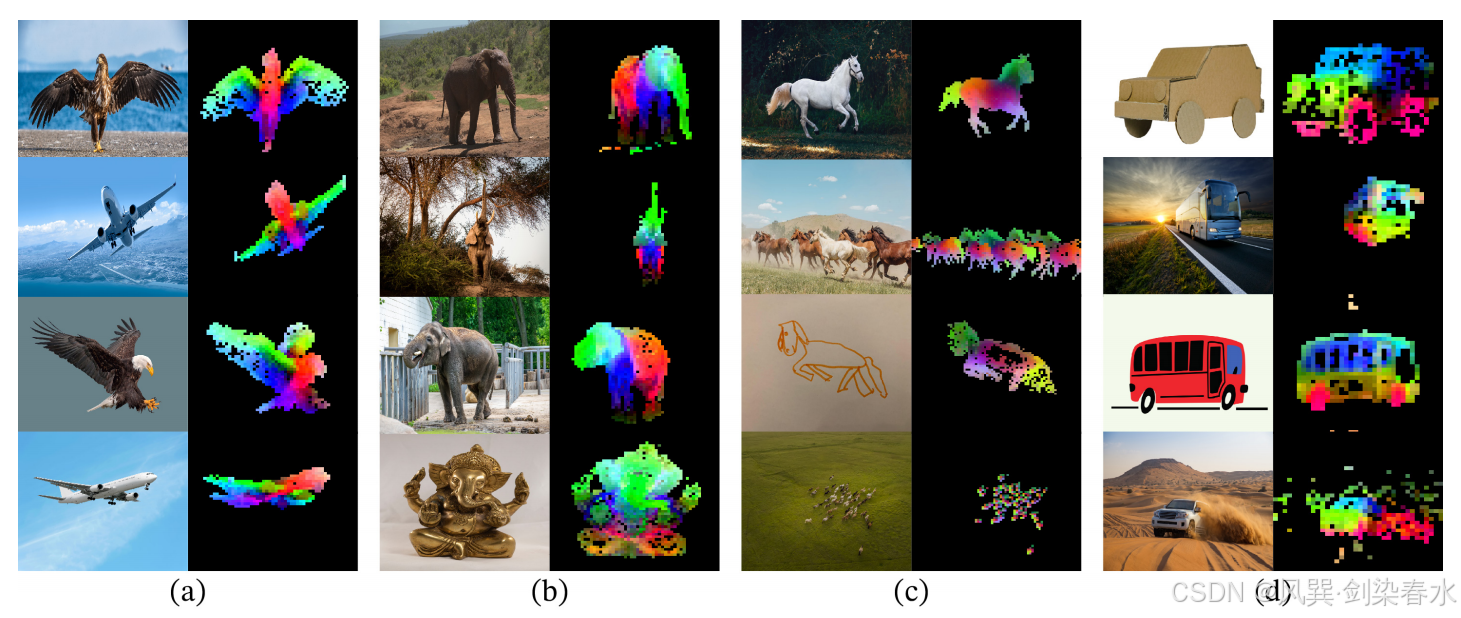
**Figure 3 | 主成分分析(PCA)前若干主成分的可视化:**对同一列(a、b、c、d)图像的图像 patch 执行 PCA 计算,并展示其前 3 个主成分。每个主成分被映射至不同颜色通道。即便姿态、风格乃至目标实体发生变化,相关图像之间仍可匹配到相同部件。通过对第 1 个 PCA 主成分做阈值处理以去除背景。
4.1、DINOv1 的不足与 DINOv2 的演进
- 数据受限: DINOv1 主要在 ImageNet-1k 上预训练。DINOv2 指出,自监督学习的大多数进展都局限于小规模精选数据集 ImageNet-1k,数据和概念多样性有限。
- 扩展困难: DINOv1 属于判别式自监督方法,这类方法在 ImageNet 上能产生不错的冻结特征,但难以扩展到更大模型尺寸。
- 训练不稳: DINOv1 在扩大模型和数据时,训练效率低、内存占用高,且容易出现 NaN 损失等不稳定问题。
- 像素级弱: DINOv1 的强项主要在图像级任务(如 k-NN 分类)和自注意力分割,但在语义分割、深度估计等像素级密集任务上,性能仍有提升空间。
- 开箱性差: DINOv1 的 k-NN 性能优秀,但在很多下游任务上仍需线性探测或微调。
- 小模型弱: DINOv1 主要关注 ViT-S/B 等较小模型,但未系统解决如何让更小模型也获得强特征。
- 未达弱监督: DINOv1 在 ImageNet 线性评估上表现良好,但尚未在多数图像和像素级基准上超越 OpenCLIP 等弱监督模型。
DINOv2 在 DINOv1 基础上解决了:数据规模与质量、模型扩展性、训练效率与稳定性、像素级任务性能、开箱即用通用性、小模型蒸馏、与弱监督模型竞争等问题。
核心思路: 用自动流水线构建大规模精选数据,结合多项训练稳定与加速技术,训练 1B ViT 并蒸馏成小模型,最终得到无需微调、在图像和像素级任务上均可与弱监督模型竞争的通用视觉特征。
4.2、关键技术创新
4.2.1、自动数据筛选流水线:构建 LVD-142M
DINOv2 不直接用未整理数据,而是自动筛选出 1.42 亿张精选图像。核心操作包括:
- 自去重: 对 1.3B 未整理图像,用余弦相似度 m ( s , r ) = f ( s ) ⋅ f ( r ) ∥ f ( s ) ∥ 2 ∥ f ( r ) ∥ 2 m(s,r)=\frac{f(s)\cdot f(r)}{\|f(s)\|_2\|f(r)\|_2} m(s,r)=∥f(s)∥2∥f(r)∥2f(s)⋅f(r) 找 k = 64 k=64 k=64 近邻,相似度 >0.6 的连通分量只保留一张。
- 相对去重: 丢弃与评估集训练/测试集相似度 >0.45 的图像。
- 检索增强: 对大数据集做样本级检索;对小数据集先聚成 10 万簇,再从相关簇中选图。
- s , r s,r s,r:两张待比对图像。
- f ( ⋅ ) f(\cdot) f(⋅):用于提取图像特征的模型。
- m ( s , r ) m(s,r) m(s,r):两张图像之间的余弦相似度,数值越趋近于1代表图像相似度越高。
4.2.2、联合自监督目标:DINO + iBOT + KoLeo
DINOv2 同时优化三个损失,分别负责图像级、像素级和检索性能。
(1)DINO 损失:图像级自蒸馏
L DINO = H ( P t ( x ) , P s ( x ′ ) ) \mathcal{L}_\text{DINO}=H\big(P_t(x),\,P_s(x')\big) LDINO=H(Pt(x),Ps(x′)) 与 DINOv1 一样,学生从不同视图预测教师的输出,教师由学生参数的 EMA 动态构建,从而进行无标签自蒸馏。
(2)iBOT 损失:patch 级掩码图像建模
L iBOT = − ∑ i ∈ M P t ( x ) i log P s ( x ) i \mathcal{L}\text{iBOT}=-\sum{i\in\mathcal{M}} P_t(x)_i \log P_s(x)_i LiBOT=−i∈M∑Pt(x)ilogPs(x)i 对部分图像 patch 施加掩码,学生网络依据未掩码的图像 patch,预测被掩码图像 patch 对应的教师网络输出。该损失对于语义分割、深度估计等密集预测任务至关重要,可带来约 3% 的性能提升。
- M \mathcal{M} M:被掩码的图像块索引集合。
- P t ( x ) i P_t(x)_i Pt(x)i:教师网络对第 i i i 个图像块的预测概率分布。
- P s ( x ) i P_s(x)_i Ps(x)i:学生网络对第 i i i 个图像块的预测概率分布。
(3)KoLeo 正则化:鼓励特征分散均匀分布
L koleo = − 1 n ∑ i = 1 n log ( d n , i ) d n , i = min j ≠ i ∥ x i − x j ∥ \mathcal{L}\text{koleo}=-\frac{1}{n}\sum{i=1}^{n}\log(d_{n,i}) \qquad d_{n,i}=\min_{j\neq i}\|x_i-x_j\| Lkoleo=−n1i=1∑nlog(dn,i)dn,i=j=imin∥xi−xj∥ 让特征在 batch 内尽量分散,避免聚集,显著提升最近邻检索性能(如 Oxford-M 检索 mAP 提升超 8%)。
- n n n:一个 batch 内的样本数。
- x i x_i xi:第 i i i 个样本经过 ℓ 2 \ell_2 ℓ2 归一化后的特征向量。
- d n , i d_{n,i} dn,i:第 i i i 个特征与同一 batch 内其他所有特征的最小距离。
- log ( d n , i ) \log(d_{n,i}) log(dn,i):距离越大,该项越大;取负号后,优化会鼓励最小距离变大。
4.2.3、训练稳定与扩展技术
- 解耦 DINO 和 iBOT 投影头:两个任务各用独立 MLP 头,避免干扰。
- Sinkhorn-Knopp 中心化:替代 DINO 的教师 softmax 中心化,迭代 3 次,平衡各维度。
- LayerScale 和 Stochastic Depth:避免 NaN,稳定大规模训练。
- 128k prototypes:投影头输出维度增至 128k,提升 k-NN。
- SwiGLU FFN:ViT 的 FFN 改用 SwiGLU 激活。
- Patch size 14:从 16 改为 14,提升 k-NN 和线性探测。
- 教师动量 0.994:EMA 动量从 0.994 余弦调度到 1。
- 批大小 3k:更大批次提升性能。
- 学习率预热 100k 迭代:稳定早期训练。
4.2.4、训练稳定与扩展技术
- 自定义 FlashAttention: ViT-g 用嵌入维度 1536、24 头(每头 64 维),最大化计算效率。
- 序列打包(Sequence Packing): 将不同分辨率的全局/局部裁剪拼接成一个序列,用注意力掩码隔离,减少前向传播次数。
- 整体效率: 比 iBOT 实现快约 2 倍,内存仅需 1/3。
4.2.5、高分辨率适应
仅在预训练最后 10k 迭代将分辨率从 224 提升到 518×518,以极小计算代价显著改善分割和深度估计。
4.2.6、知识蒸馏
训练 1B 参数 ViT-g/14 后,蒸馏到 ViT-S/B/L 小模型。蒸馏损失与 DINO 损失相同:小模型作为学生,大模型作为教师,学生匹配教师输出。蒸馏模型在所有 12 个基准上优于从头训练,有时甚至超过教师。
4.2.7、后续重要改进:Register Tokens
在 DINOv2 原始版本基础上,后续工作"Vision Transformers Need Registers"引入 4 个可学习的 Register tokens,专门吸收高范数激活,消除注意力图伪影,使密集预测任务的局部特征质量显著提升。DINOv2 的更新版本已集成这一设计。
4.3、关键突破与推进意义
关键突破: 用自动筛选的 1.42 亿精选图像,结合 DINO+iBOT+KoLeo 联合目标和一系列稳定加速技术,训练 1B ViT-g/14 并蒸馏小模型,使冻结特征在图像级和像素级任务上达到或超越弱监督模型。
推进意义: 证明自监督预训练 alone 可以产生通用视觉特征,摆脱文本监督依赖,为视觉基础模型开辟了新路径,并提供了可扩展、高效、稳定的训练方案和多种预训练模型,推动了自监督学习在计算机视觉中的实际应用和后续研究。
**Figure 4 | 基于线性分类器的图像分割与深度估计:**示例来自 ADE20K、NYU‑Depth、SUN RGB‑D 以及 KITTI 数据集;在冻结的 OpenCLIP‑G 与 DINOv2‑g 特征之上采用线性探测方案。
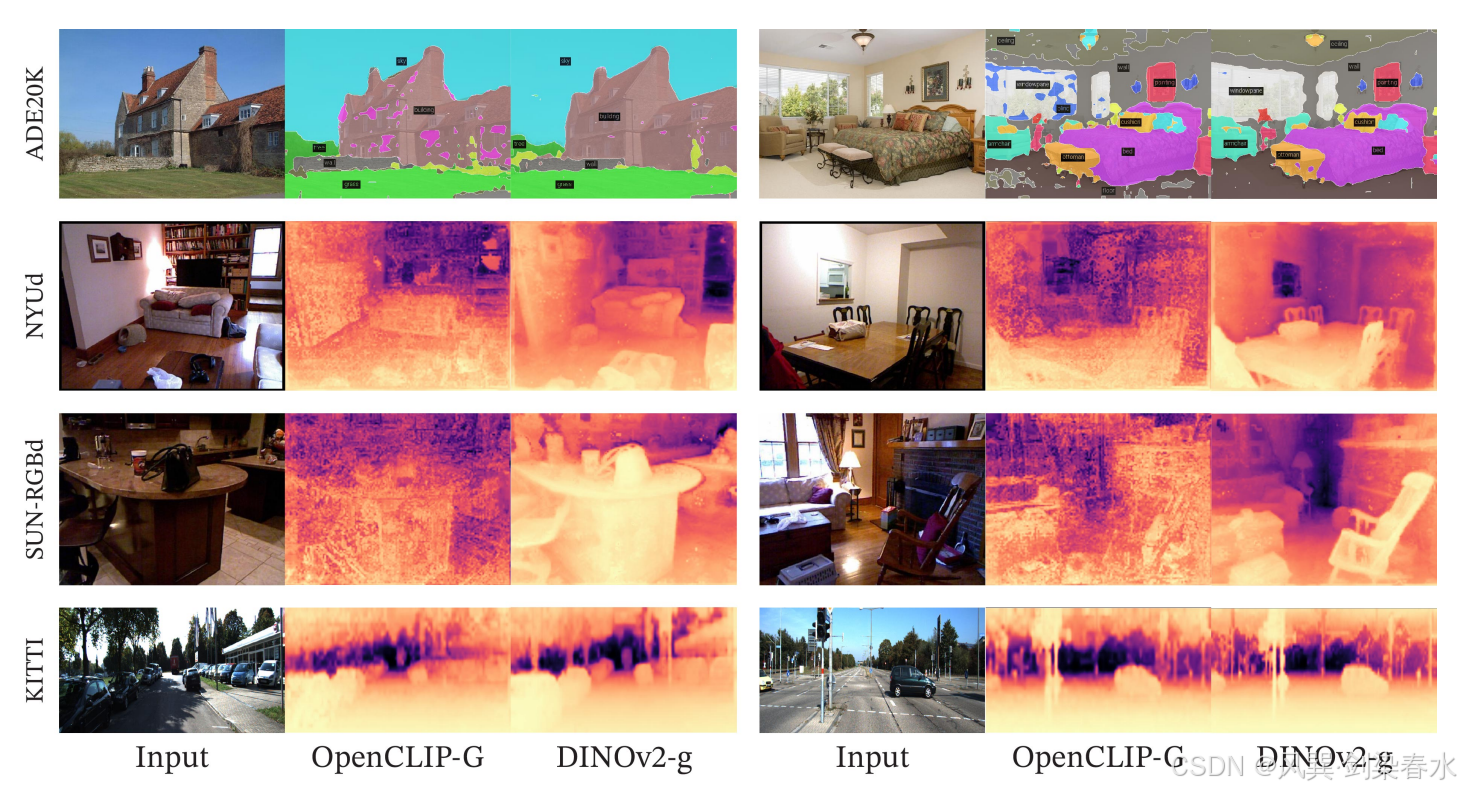
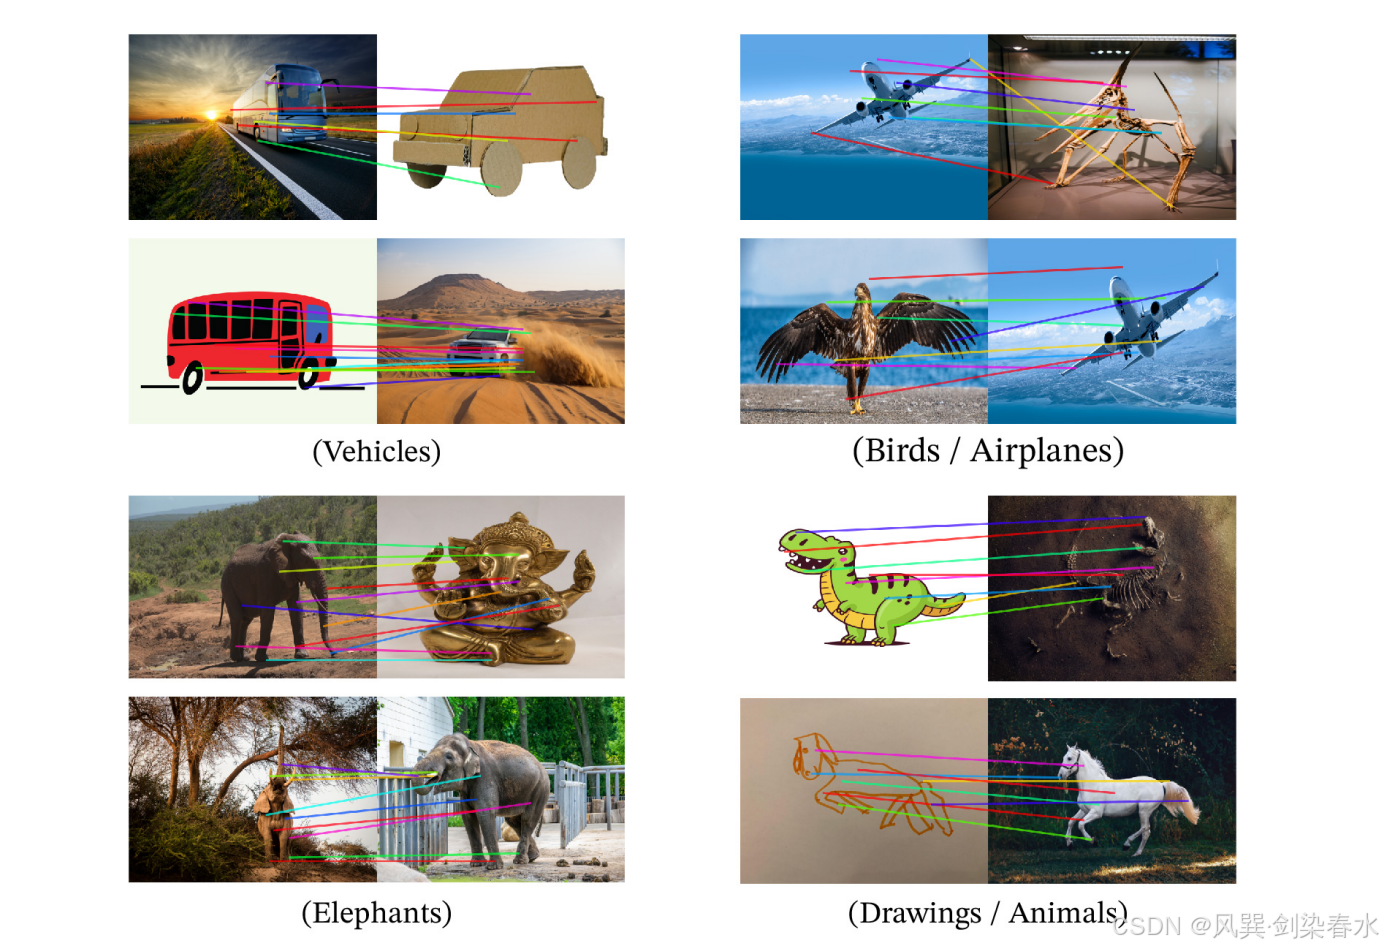
**Figure 5 | 跨图像特征匹配:**对来自不同域、不同姿态,甚至语义信息相近目标的图像之间进行块级特征匹配。该结果表明,DINOv2 具备跨域迁移能力,能够理解不同物体相似部件之间的关联关系。
5、DINOv3:迈向通用视觉基础模型
DINOv3 的核心目标: 通过大规模自监督预训练,训练一个跨任务、跨领域的通用视觉基础模型,使其无需微调即可在图像级和像素级任务上达到或超越专用 SOTA,并特别解决长训练中密集特征退化的问题,最终提供一系列可开箱即用的模型。
Figure 6 | :
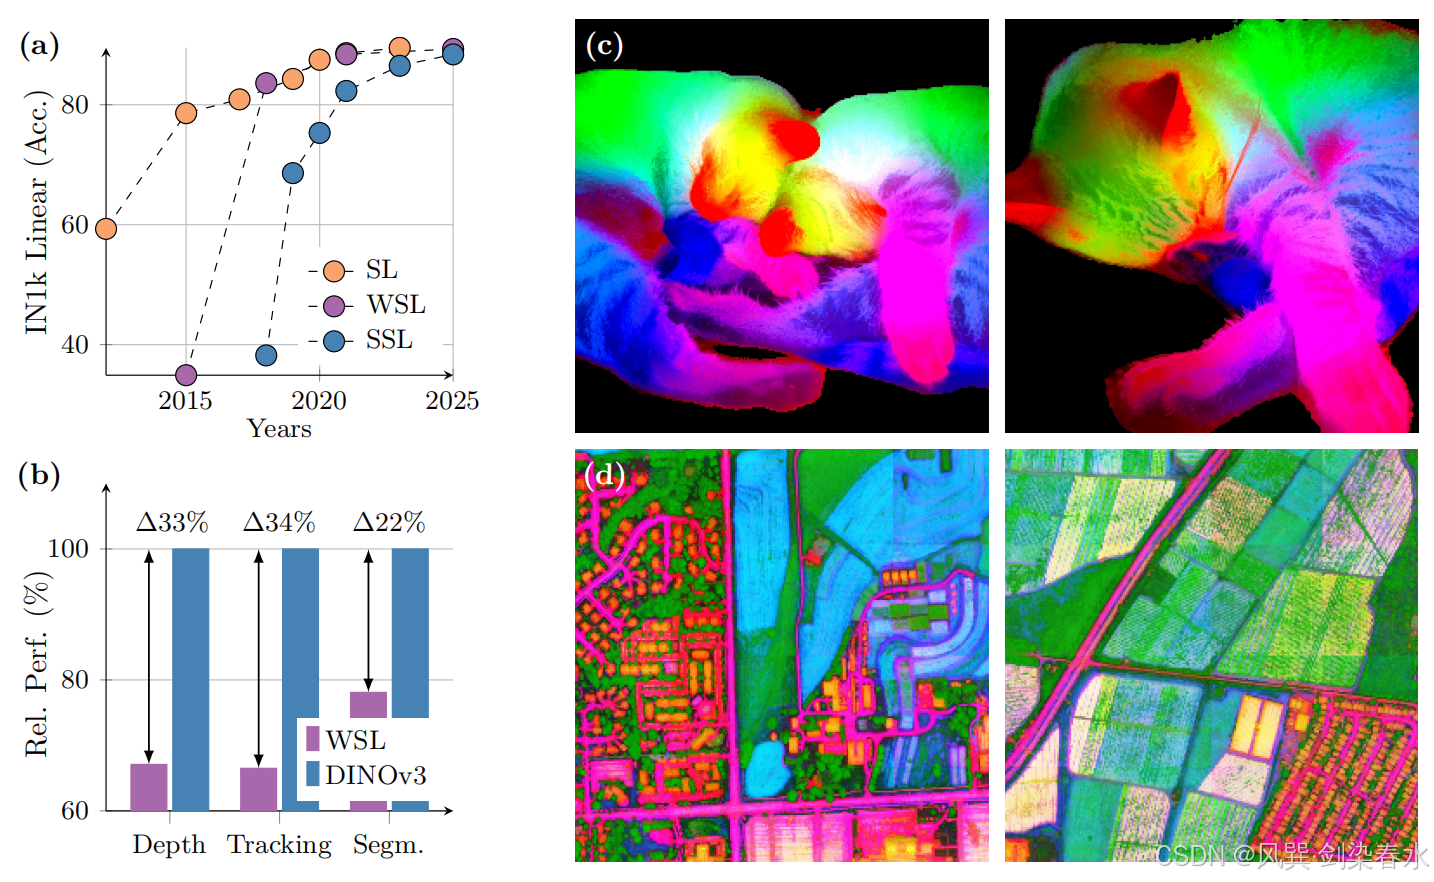
( a ) ImageNet‑1k(IN1k)数据集上线性探测结果的历年变化趋势,对比全监督学习 (SL)、弱监督学习 (WSL) 与自监督学习 (SSL) 各类方法。尽管自监督学习出现时间较晚,但发展迅速,现已达到近年 ImageNet 数据集的精度平台。
另一方面,本文表明自监督学习具备输出高质量稠密特征的独特优势。如 ( b ) 中最优弱监督模型与 DINOv3 的性能对比所示,借助 DINOv3,本文在稠密任务上的效果大幅超越弱监督模型。
本文还给出 DINOv3 在自然图像 ( c ) 与航拍图像 ( d ) 上训练后,对高分辨率图像提取特征得到的 PCA 特征映射图。
5.1、DINOv1 与 DINOv2 的遗留问题
DINOv1: 主要在 ImageNet-1k 上预训练,数据和概念多样性有限;判别式自监督难以扩展到更大模型;训练效率低、内存高、易出现 NaN;像素级密集任务性能有限;开箱即用性不足;小模型性能弱;未在多数基准上超越弱监督模型。
DINOv2: 通过 LVD-142M 数据筛选、1B ViT-g、DINO+iBOT+KoLeo、训练稳定技术、高分辨率适应和蒸馏,使自监督特征在多数任务上达到或超越弱监督模型。但仍存在:
- 密集特征退化: 长训练后,密集特征图逐渐退化,尤其在模型大于 ViT-Large(300M 参数)时,分割等密集任务性能下降。
- 优化周期难以预设: 常用余弦调度需要预先知道训练总迭代数,在大规模图像语料上难以确定。
- 数据筛选与扩展挑战: 如何从无标签集合中收集有用数据,并进一步扩大模型与数据规模。
- 无法无限训练: 训练越久,全局指标提升但密集任务性能下降,限制了规模扩展的收益。
DINOv3 在 DINOv1/DINOv2 基础上,通过 Gram anchoring 解决长训练密集特征退化,通过常数调度解决优化周期预设问题,通过 LVD-1689M 和 7B ViT 实现数据与模型规模扩展,并通过高效蒸馏、高分辨率适应和文本对齐,最终得到无需微调即可在广泛任务上超越专用 SOTA 的通用视觉基础模型。
5.2、关键技术创新
5.2.1、大规模数据整理与混合采样
从约 170 亿张网络图像中,用层次 k-means 聚类自动整理出 LVD-1689M(16.89 亿张),并结合检索式整理和原始公开数据集(ImageNet-1k、ImageNet-22k、Mapillary SLS)。训练时混合采样:10% 为 ImageNet-1k 同质 batch,其余为多数据源异质 batch。(基础模型还是要大力出奇迹啊)
5.2.2、大规模自监督训练目标
沿用 DINO + iBOT + KoLeo 联合目标,用 Sinkhorn-Knopp 替代 DINO 的 centering,并对局部/全局 crop 的 backbone 输出增加独立 LayerNorm。预训练损失为:
L P r e = L D I N O + L i B O T + 0.1 L D K o l e o \mathcal{L}{\mathrm{Pre}} = \mathcal{L}{\mathrm{DINO}} + \mathcal{L}{\mathrm{iBOT}} + 0.1\mathcal{L}{\mathrm{DKoleo}} LPre=LDINO+LiBOT+0.1LDKoleo其中:
- L D I N O \mathcal{L}_{\mathrm{DINO}} LDINO:图像级自蒸馏损失,学生匹配动量教师的全局视图输出。
- L i B O T \mathcal{L}_{\mathrm{iBOT}} LiBOT:patch 级掩码图像建模损失,学生网络预测被掩码 patch 对应的教师网络输出。
- L D K o l e o \mathcal{L}_{\mathrm{DKoleo}} LDKoleo:KoLeo 正则化,鼓励 batch 内特征均匀分布。
5.2.3、7B ViT 架构与常数调度优化
训练 7B 参数 ViT:40 blocks、embedding 4096、patch 16、32 heads(每头 128 维)、SwiGLU FFN、4 个 register tokens。采用轴向 RoPE 和 RoPE-box jittering。优化上去除所有余弦调度,使用常数学习率、常数权重衰减、常数教师 EMA 动量,仅保留线性 warmup。
(1)RoPE 要解决的问题:位置编码的泛化性
DINOv2 使用可学习位置嵌入,每个位置有一个可学习向量。缺点是:位置嵌入与训练分辨率绑定,推理时分辨率变化需要插值,泛化性有限。DINOv3 改用 RoPE,提升对分辨率、尺度、宽高比的鲁棒性。
(2)RoPE 核心思想:用旋转表示相对位置
RoPE 不给每个位置加向量,而是根据两个 patch 的相对位置,对它们的特征向量做旋转。旋转角度由相对位置决定,因此注意力分数自然包含相对位置信息。
(3)数学形式
对于 d d d 维空间内的位置 m m m 与 n n n,RoPE 对特征向量的每一组维度对 ( 2 i , 2 i + 1 ) (2i,2i+1) (2i,2i+1) 分别旋转角度 m θ i m\theta_i mθi 和 n θ i n\theta_i nθi,其中:
θ i = 10000 − 2 i / d \theta_i = 10000^{-2i/d} θi=10000−2i/d
- i i i:维度对索引, i = 0 , 1 , ... , d / 2 − 1 i=0,1,\dots,d/2-1 i=0,1,...,d/2−1。
- d d d:特征维度。
- θ i \theta_i θi:第 i i i 组维度对应的旋转基频,其数值随 i i i 的增大而递减。
- m , n m,n m,n:两个 patch 的位置索引。
完成旋转操作后,两组特征的点积仅由二者的相对位置 m − n m-n m−n 决定,由此使注意力机制原生具备相对位置感知能力。
(4)DINOv3 的定制改进
- 归一化坐标: 将每个 patch 的坐标归一化到 − 1 , 1 -1,1 −1,1 区间,而非直接用整数索引。
- 相对位置偏置: 在多头注意力中,根据两个 patch 的相对位置引入偏置。
- RoPE-box jittering: 将坐标框 − 1 , 1 -1,1 −1,1 随机缩放为 − s , s -s,s −s,s 其中 s ∈ 0.5 , 2 s∈0.5,2 s∈0.5,2。这相当于随机改变位置坐标的尺度,迫使模型学习对尺度、分辨率、宽高比更鲁棒的位置表示。
想象每个 patch 是一个小人,站在一张网格地图上。RoPE 不是给每个小人发一个"我是第几行第几列"的牌子,而是让两个小人面对面时,根据他们站位的相对方向调整自己的朝向。这样无论地图整体放大还是缩小,只要相对位置不变,他们的"交流方式"就不变。RoPE-box jittering 相当于随机拉伸或压缩地图,让小人学会适应不同尺度的地图。
5.2.4、Gram Anchoring 技术
(1)要解决的问题:长训练后密集特征退化
DINOv2 和 DINOv3 在长训练中,全局任务 (如图像分类)性能持续提升,但密集任务(如语义分割、深度估计)性能在约 200k 迭代后开始下降。原因是 patch 级一致性丢失:原本只与同类物体 patch 相似的 patch,开始与大量无关 patch 也相似,相似度图变噪。
(2)核心思想:只约束"相似度结构",不约束特征本身
Gram 矩阵是所有 patch 特征两两点积组成的矩阵,描述 patch 之间的相似度结构。**Gram Anchoring 的目标是:让学生当前的 Gram 矩阵接近一个早期"Gram 教师"的 Gram 矩阵。**早期教师密集特征质量好,相似度结构清晰。只约束相似度结构,不限制特征本身移动,因此局部特征可以自由调整,只要相似度关系保持一致。
(3)公式表达
提出的 Gram 损失:
L G r a m = ∥ X S X S ⊤ − X G X G ⊤ ∥ F 2 \mathcal{L}_{\mathrm{Gram}} = \left\| \mathbf{X}_S \mathbf{X}_S^\top - \mathbf{X}_G \mathbf{X}_G^\top \right\|_F^2 LGram= XSXS⊤−XGXG⊤ F2 精炼阶段的损失函数定义为:
L R e f = w D L D I N O + L i B O T + w D K L D K o l e o + w G r a m L G r a m \mathcal{L}{\mathrm{Ref}} = w_D \mathcal{L}{\mathrm{DINO}} + \mathcal{L}{\mathrm{iBOT}} + w{DK} \mathcal{L}{\mathrm{DKoleo}} + w{\mathrm{Gram}} \mathcal{L}_{\mathrm{Gram}} LRef=wDLDINO+LiBOT+wDKLDKoleo+wGramLGram
- X S \mathbf{X}_S XS:学生网络输出的 P × d P \times d P×d 矩阵,矩阵每一行代表一个 patch 经过 ℓ 2 \ell_2 ℓ2 归一化后的局部特征。
- X G \mathbf{X}_G XG:Gram 教师网络输出的 P × d P \times d P×d 矩阵,矩阵每一行代表一个 patch 经过 ℓ 2 \ell_2 ℓ2 归一化后的局部特征。
- P P P:图像内 patch 的总数量。例如输入图像尺寸为 256 × 256 256\times256 256×256,patch 大小取 16,则 P = 16 × 16 = 256 P = 16 \times 16 = 256 P=16×16=256。
- d d d:特征维度。以 ViT‑7B 为例, d = 4096 d = 4096 d=4096。
- X S X S ⊤ \mathbf{X}_S \mathbf{X}_S^\top XSXS⊤:学生端 Gram 矩阵,维度为 P × P P \times P P×P。矩阵第 ( i , j ) (i,j) (i,j) 个元素为 patch i i i 与 patch j j j 学生特征的点积,用于表征二者特征相似度。
- X G X G ⊤ \mathbf{X}_G \mathbf{X}_G^\top XGXG⊤:教师端 Gram 矩阵,维度为 P × P P \times P P×P,含义与上述一致。
- ∥ ⋅ ∥ F 2 \left\| \cdot \right\|_F^2 ∥⋅∥F2:Frobenius 范数的平方,等价于矩阵全部元素的平方和,此处用于度量学生 Gram 矩阵与教师 Gram 矩阵之间的差异。
把每个 patch 看作一个点,Gram 矩阵记录所有点两两之间的"亲近程度"。Gram Anchoring 不要求学生的点位置和教师一样,只要求点与点之间的亲近关系保持一致。这样,学生可以在保持相似度结构的前提下自由调整特征,避免密集特征退化。
5.2.5、后训练:高分辨率适应与高效蒸馏
-
高分辨率适应: 混合分辨率(全局 512/768,局部 112/168/224/336)训练 10k 迭代,继续使用 Gram anchoring。
-
单教师多学生蒸馏: 共享 7B 教师推理,并行训练多个学生,蒸馏出 ViT-S/S+/B/L/H+ 及 ConvNeXt 系列。(多模型家族)
5.2.6、文本对齐与异常值处理
-
文本对齐: 训练文本编码器对齐 DINOv3 ViT-L 的 CLS 和 patch 输出,实现零样本分类、检索和开放词汇分割。
-
异常值处理: 使用 4 个 register tokens 消除高范数 patch 异常;对特征维度异常,建议对最终层应用 LayerNorm 或 BatchNorm。
5.3、关键突破与推进意义
关键突破: 用 Gram Anchoring 解决长训练密集特征退化,用 LVD-1689M 和 7B ViT 实现数据与模型规模扩展,用常数调度支持无限期训练,用单教师多学生蒸馏得到可部署模型家族,用高分辨率适应和文本对齐增强灵活性与零样本能力。
推进意义: 证明自监督学习可以训练出通用视觉基础模型,在密集任务上大幅超越弱监督和专用模型,在全局任务上与之相当或更优,并具备跨域通用性和可部署性,为视觉基础模型的发展开辟了新的路径。
**Figure 7 | 高分辨率密集特征:**展示了使用 DINOv3 输出特征,在带有红色十字标记的图像块与所有其他图像块之间生成的余弦相似度图。
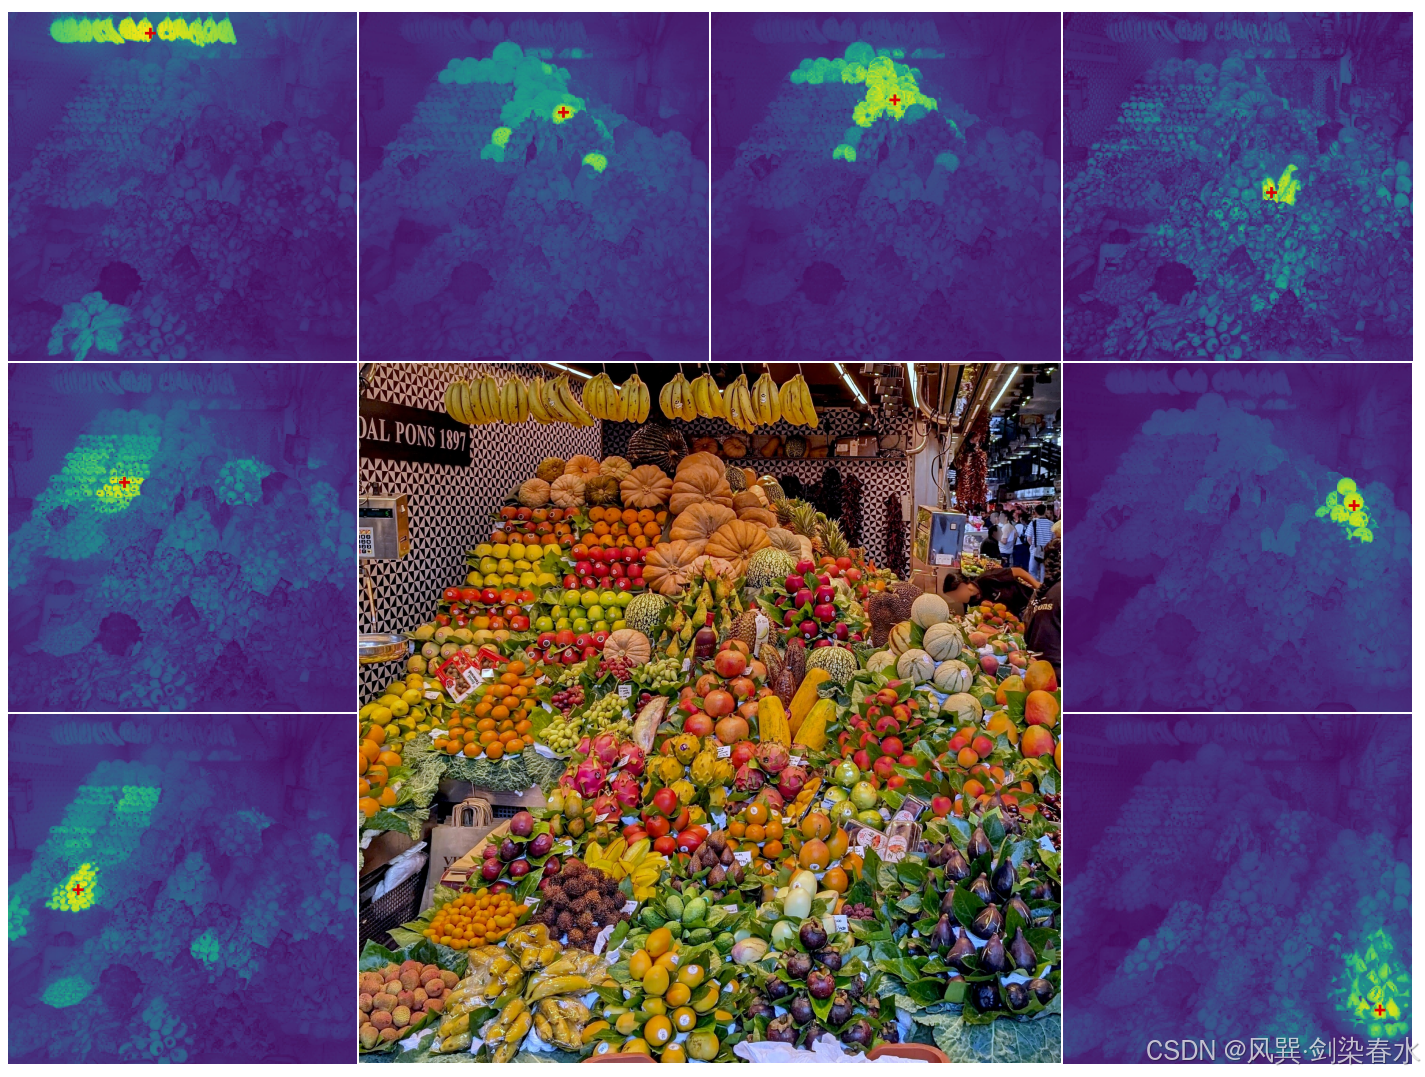
**Figure 8 | DINOv3 在极高分辨率下的表现:**通过将特征空间上计算得到的 PCA 的前三个成分映射到 RGB 空间,来可视化 DINOv3 的密集特征。为了将 PCA 聚焦于目标对象,通过背景扣除对特征图进行掩膜处理。随着分辨率的提升,DINOv3 生成的特征更加清晰,且仍保持语义意义。
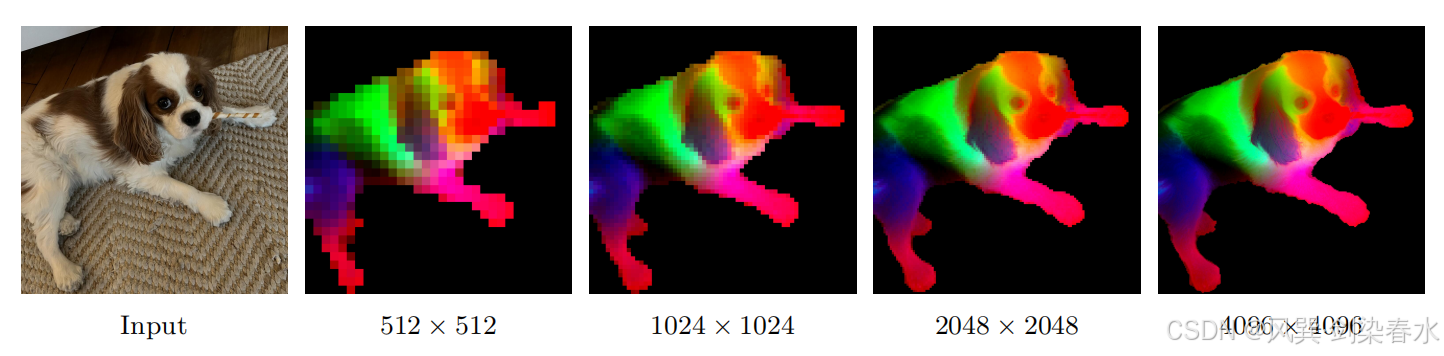
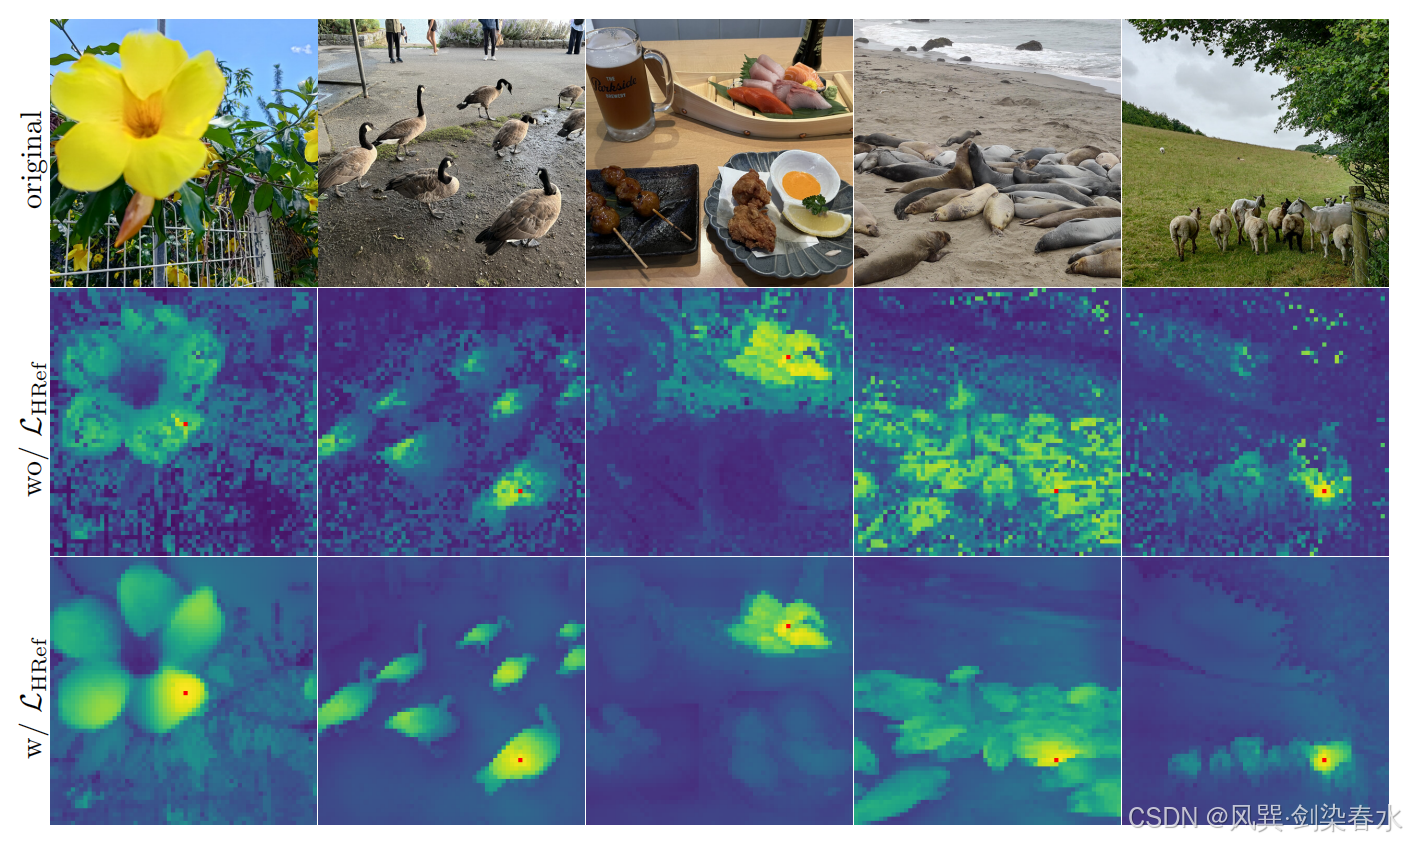
**Figure 9 | Gram Anchoring 技术的定性效果:**通过展示了在使用优化目标 L H R e f \mathcal{L}_{HRef} LHRef 前后所得到的余弦图。图像输入分辨率为 1024 × 1024 像素。
计算下采样后特征的 Gram 矩阵,并将其用于替换目标函数中的 X G \mathbf{X}G XG。将由此得到的全新精炼目标函数记为 L H R e f \mathcal{L}{\mathrm{HRef}} LHRef。
6、DINO 系列技术总结与演进路径
DINO 系列的核心主线是:用自监督自蒸馏训练 Vision Transformer,从验证"自监督 ViT 能否涌现好特征",到实现"通用视觉特征",再到构建"大规模、长训练、密集任务强大的视觉基础模型"。
6.1、总体演进路径
| 阶段 | 核心问题 | 关键突破 | 结果 |
|---|---|---|---|
| DINOv1 | 自监督能否让 ViT 产生独特性质? | 无标签自蒸馏 + 动量教师 + 多裁剪 + 中心化/锐化 | 自注意力涌现物体分割,k-NN 接近线性 |
| DINOv2 | 自监督能否学到通用视觉特征? | LVD-142M 数据筛选 + DINO+iBOT+KoLeo + 1B ViT-g + 蒸馏 | 冻结特征与弱监督模型竞争,多任务 SOTA |
| DINOv3 | 大规模长训练下密集特征退化怎么办? | Gram Anchoring + 7B ViT + 常数调度 + RoPE + 多学生蒸馏 | 密集任务大幅超越前代,通用基础模型 |
6.2、各代核心贡献
DINOv1
- 方法:学生匹配动量教师输出,多裁剪,中心化+锐化避免坍塌。
- 特点:无需负样本、对比损失、predictor、BN。
- 发现:自监督 ViT 自注意力图涌现物体分割;k-NN 性能接近线性分类。
- 意义:证明自监督 ViT 可产生独特且高质量的特征。
DINOv2
- 数据:自动筛选构建 LVD-142M(1.42 亿精选图像)。
- 目标:DINO + iBOT + KoLeo 联合自监督。
- 模型:训练 1B ViT-g/14,蒸馏到 ViT-S/B/L。
- 训练:解耦投影头、Sinkhorn-Knopp、LayerScale、Stochastic Depth、高分辨率适应等。
- 结果:冻结特征在图像级和像素级任务上与弱监督模型竞争。
- 意义:自监督可成为视觉基础模型的主流路径。
DINOv3
- 数据:LVD-1689M(16.89 亿精选图像),混合采样。
- 模型:7B ViT,RoPE + RoPE-box jittering,Register tokens,SwiGLU。
- 核心创新:Gram Anchoring 解决长训练密集特征退化。
- 训练:常数调度,支持无限期训练,1M 迭代。
- 后处理:高分辨率适应、单教师多学生蒸馏、文本对齐。
- 结果:密集任务大幅超越 DINOv2 和弱监督模型,全局任务相当或更优。
- 意义:证明自监督可训练出通用、可部署、跨域的视觉基础模型。
6.3、关键技术演进脉络
| DINOv1 | DINOv2 | DINOv2 | |
|---|---|---|---|
| 数据 | ImageNet-1k | LVD-142M(自动筛选) | LVD-1689M(层次聚类+检索+混合) |
| 模型 | ViT-S/B | ViT-S/B/L/g(1B) | Register tokens |
| 损失目标 | DINO 自蒸馏 | DINO + iBOT + KoLeo | 同 DINOv2 + Gram Anchoring |
| 避免坍塌 | 中心化 + 锐化 | Sinkhorn-Knopp + 动量教师 | 同 DINOv2,增加 Register tokens |
| 训练 | 余弦调度 | 余弦调度 + 稳定化技术 | 常数调度,支持长训练 |
| 密集特征 | 自注意力涌现分割 | 线性探测接近弱监督 | Gram Anchoring,密集任务 SOTA |
| 部署 | 无蒸馏 | 蒸馏 ViT-S/B/L | 单教师多学生蒸馏,ViT/ConvNeXt 家族 |
| 文本对齐 | 无 | 无 | dino.txt 零样本分类/检索/分割 |
6.4、总结
DINO 系列的演进路径可以概括为:
- DINOv1: 提出极简无标签自蒸馏,证明自监督 ViT 能涌现物体分割和强 k-NN 特征。
- DINOv2: 通过数据筛选、联合目标和模型扩展,使自监督特征通用化,与弱监督模型竞争。
- DINOv3: 用 Gram Anchoring 解决长训练密集特征退化,训练 7B ViT,实现大规模、长训练、密集任务强大的通用视觉基础模型。
DINO 系列从"自监督 ViT 能否涌现好特征"出发,走向"自监督能否通用",最终实现"自监督大规模基础模型在密集任务上超越专用 SOTA"。(●'◡'●)