✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
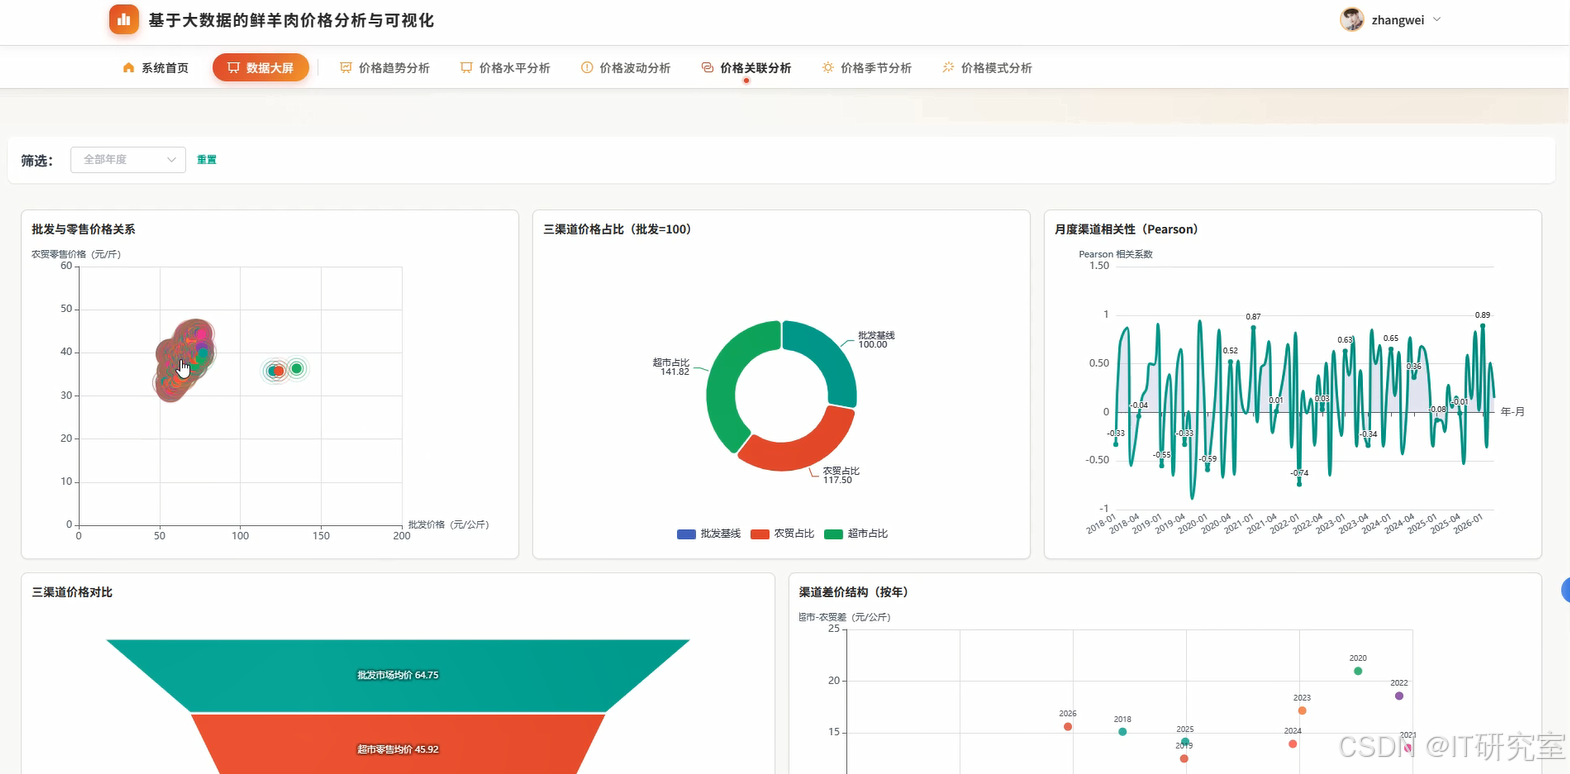
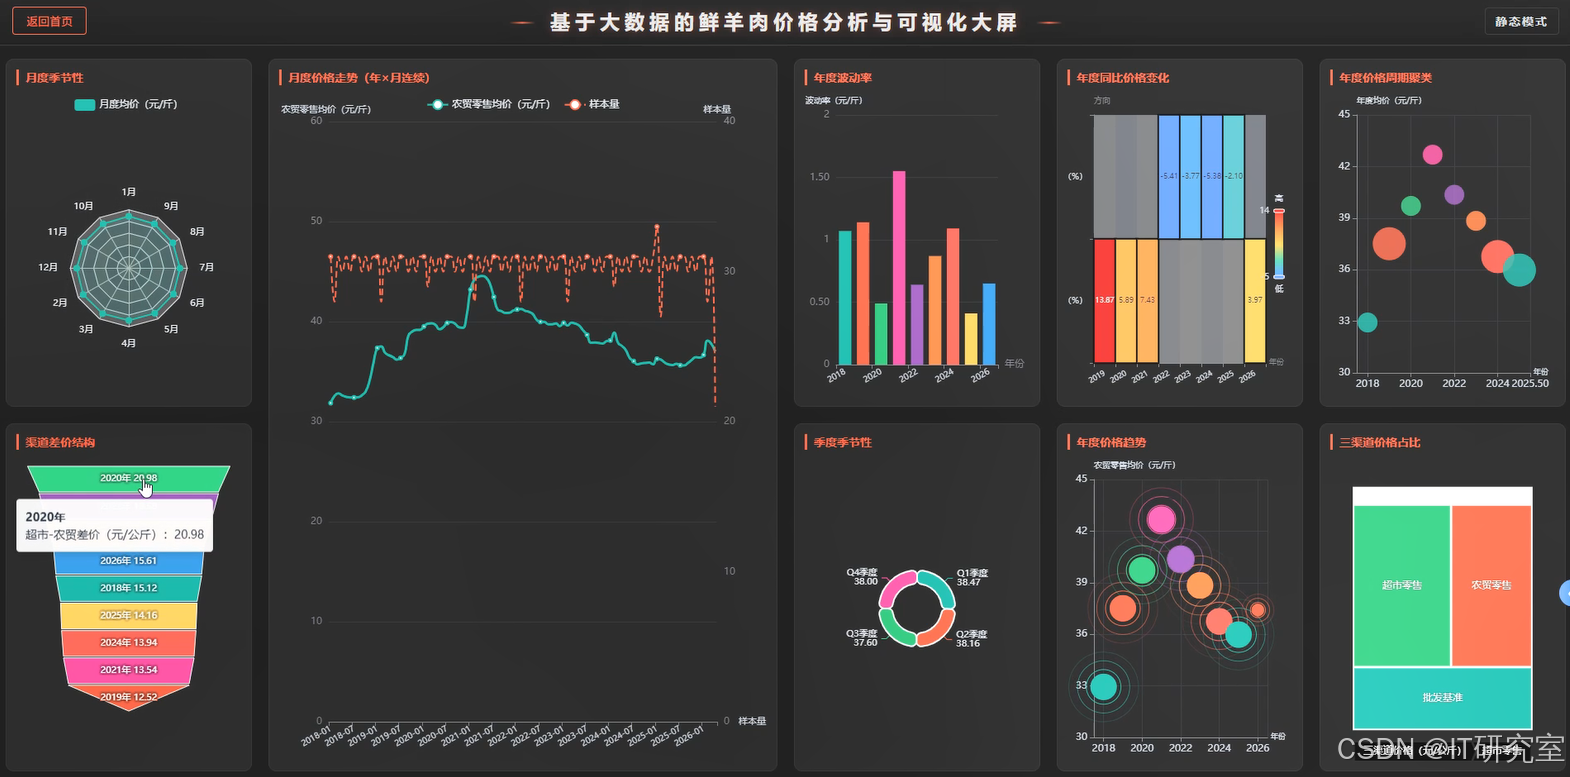
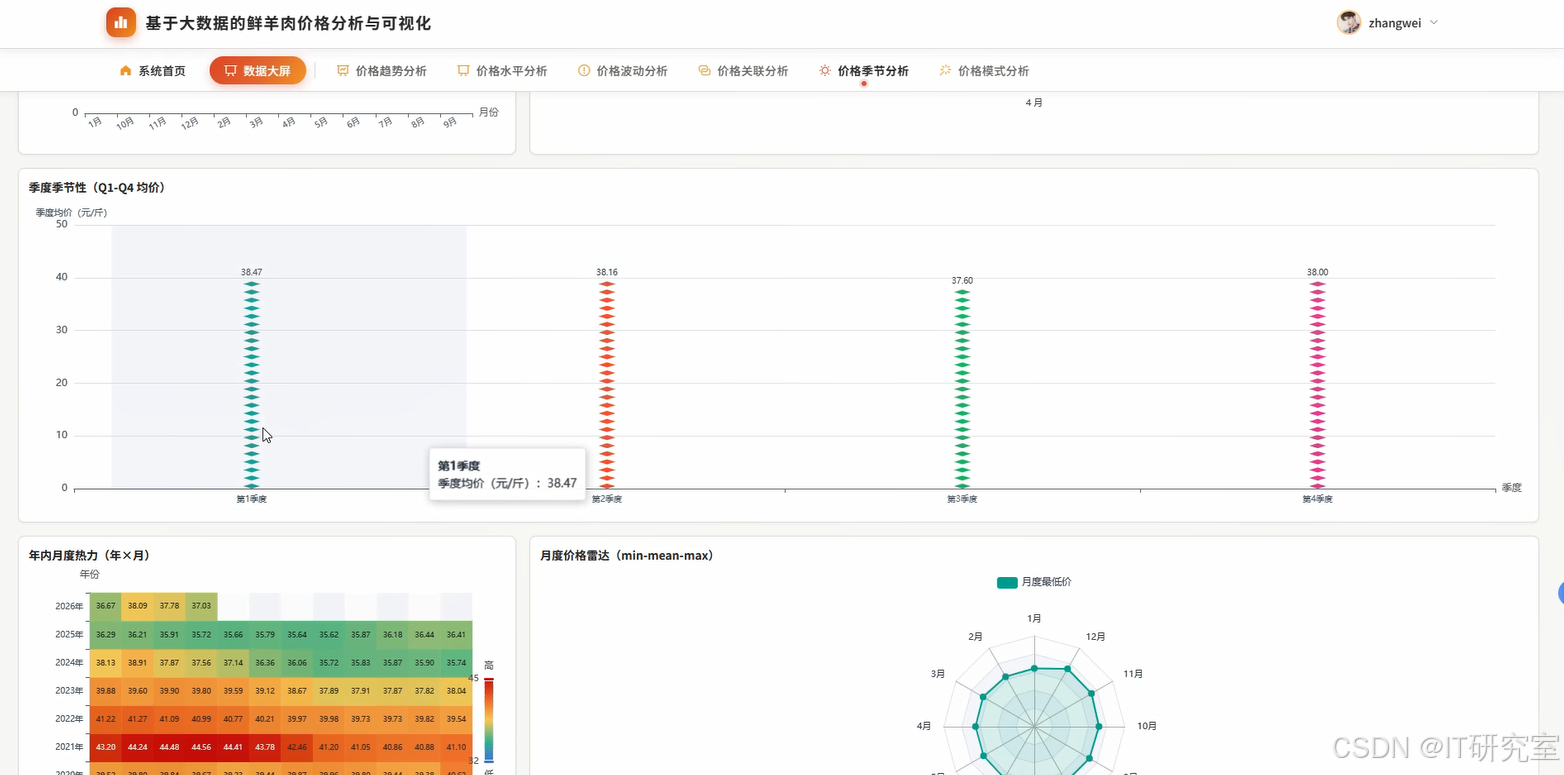
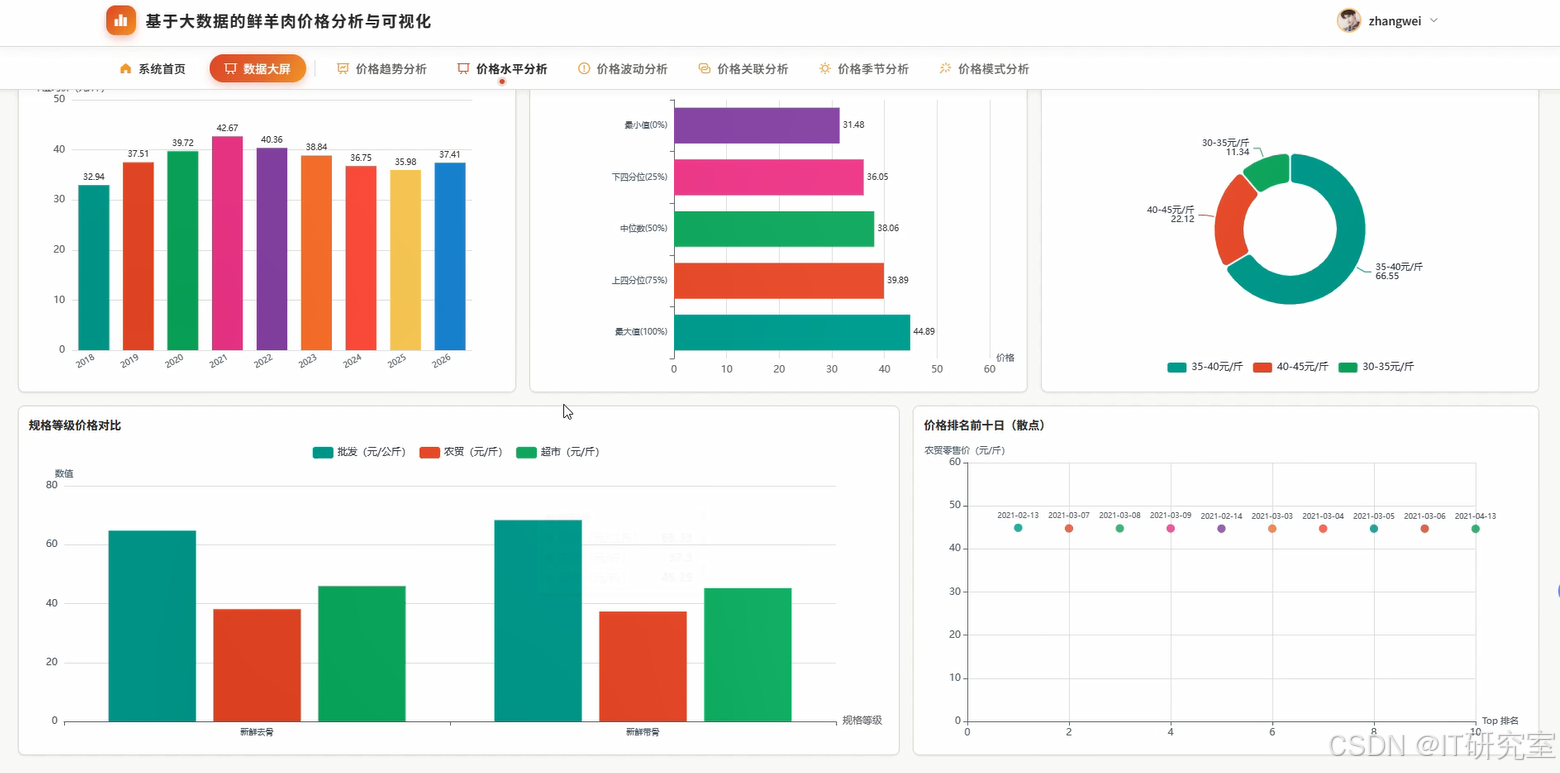
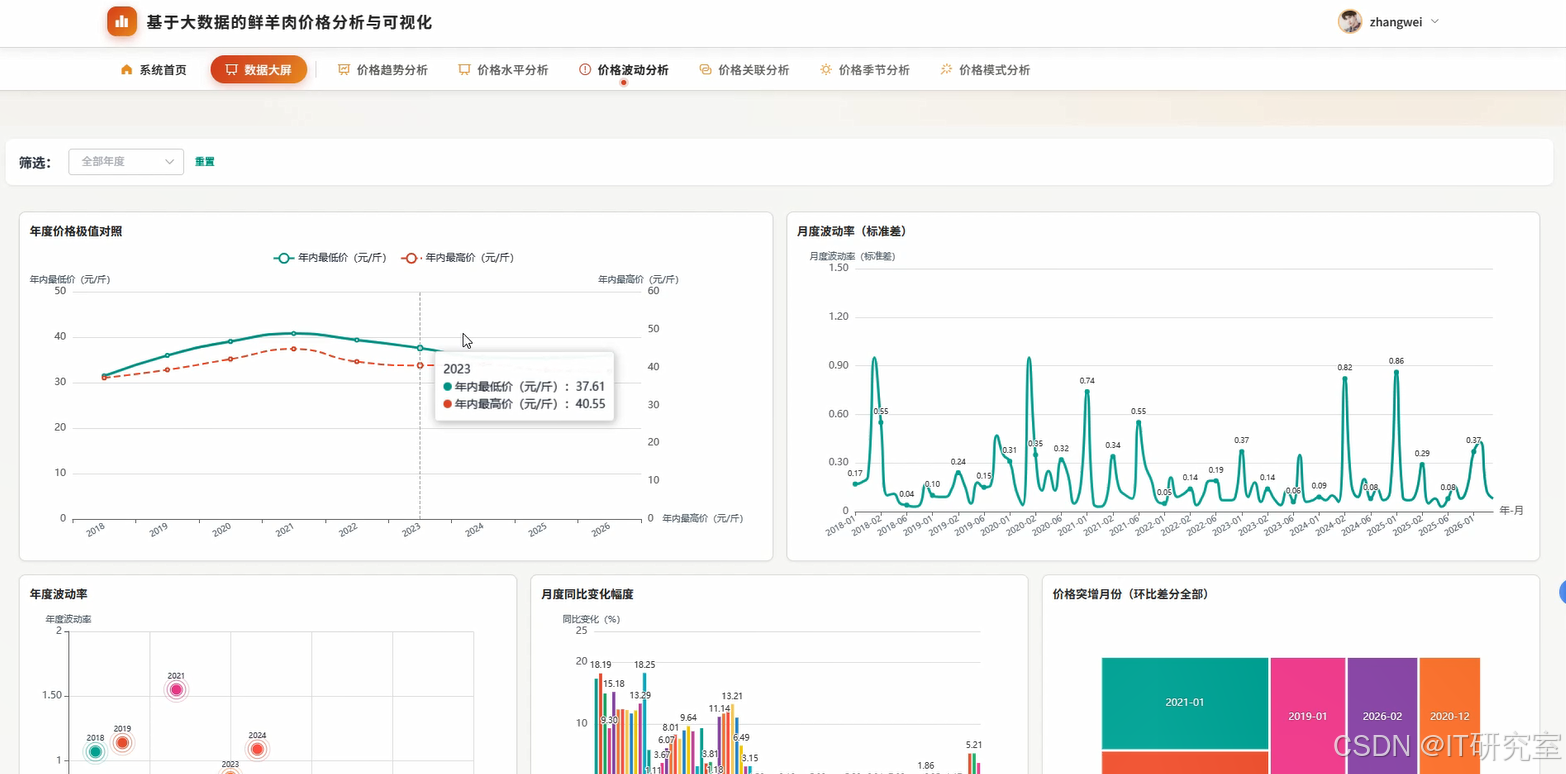
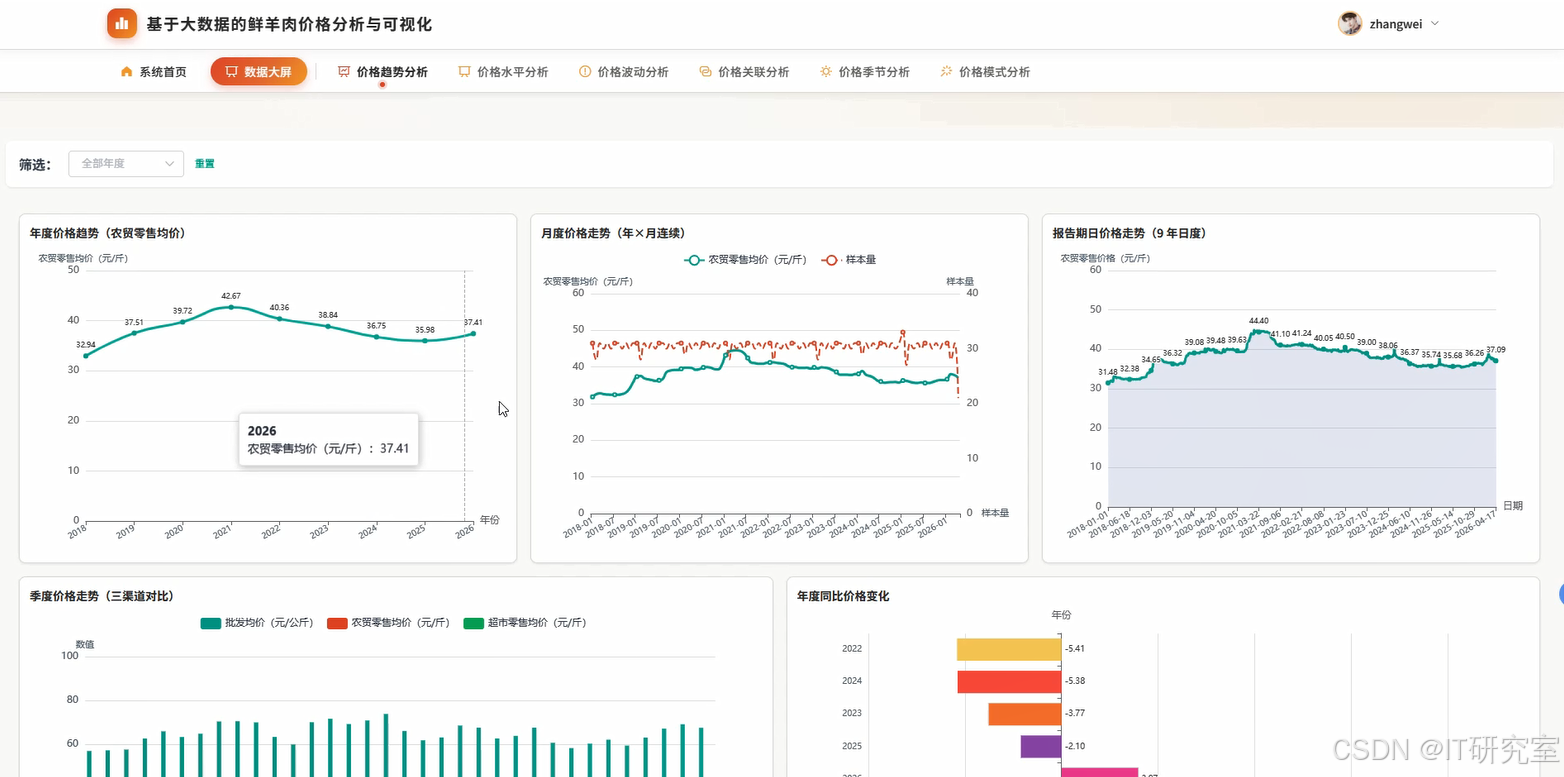
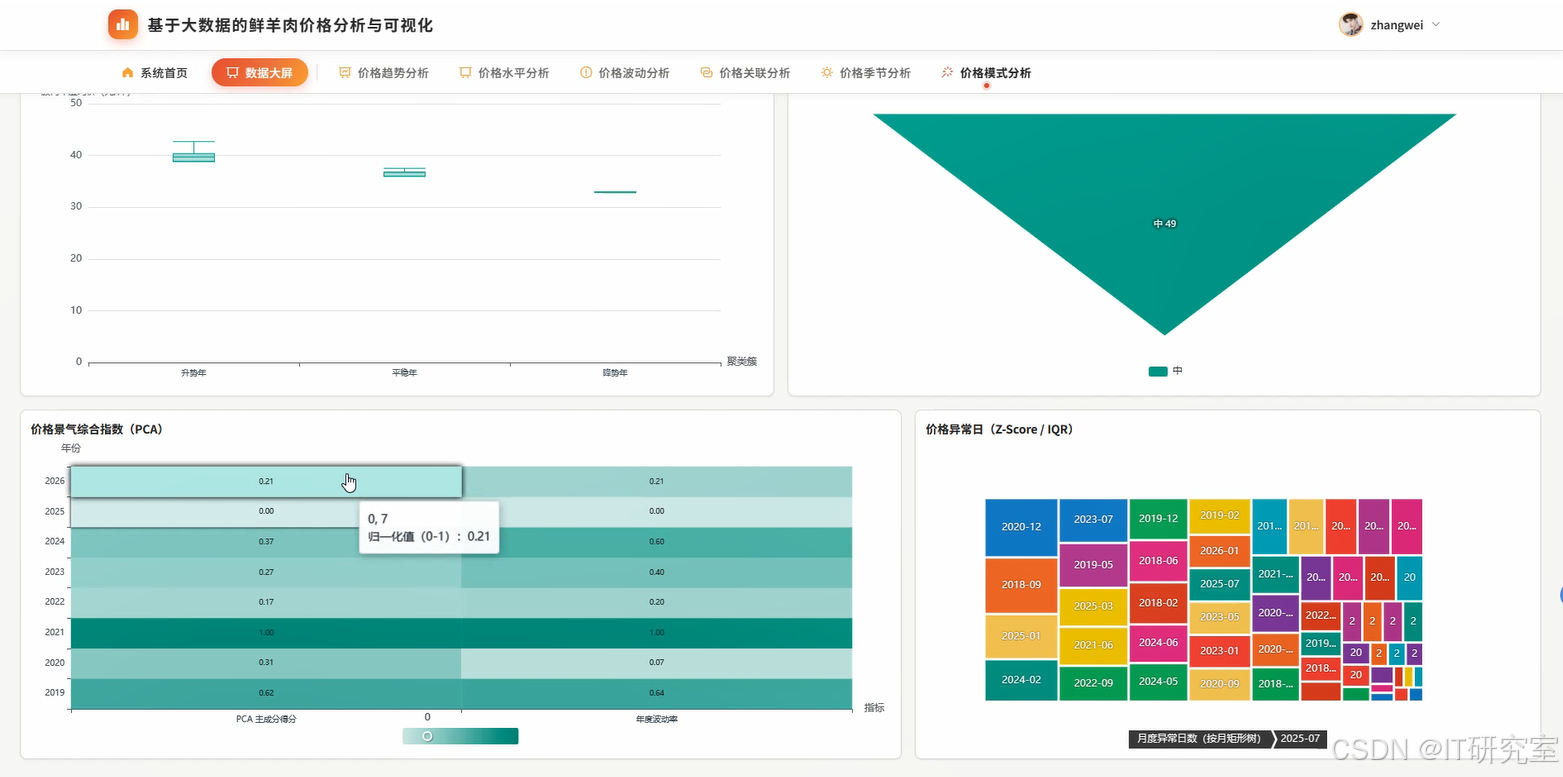
基于大数据的鲜羊肉价格分析与可视化系统是一套面向鲜羊肉市场价格数据的分析平台,系统以Hadoop与Spark作为大数据处理框架,依托HDFS完成价格数据的存储,通过Spark SQL与Pandas、NumPy对鲜羊肉价格数据进行清洗、统计与建模,后端采用Django框架搭建服务接口,前端结合Vue、ElementUI、Echarts、HTML、CSS、JavaScript与jQuery完成页面展示与图表渲染,数据库使用MySQL保存分析结果与基础数据。系统整体包含系统首页、数据大屏、价格趋势分析、价格水平分析、价格波动分析、价格关联分析、价格季节分析与价格模式分析等功能模块,能够对鲜羊肉价格在时间维度上的变化趋势、不同地区的价格水平差异、价格波动幅度、价格与其他因素的关联关系、季节性变化规律以及潜在价格模式进行多角度分析,并通过可视化图表与数据大屏直观呈现分析结果,帮助使用者较为清晰地了解鲜羊肉价格的变动特征与规律,同时也为计算机专业毕业设计提供一个结合大数据技术与Web系统开发的完整实践案例。
选题背景
鲜羊肉作为日常生活中比较常见的肉类消费品,其价格变化一直受到养殖户、批发商、零售商和普通消费者的关注。近些年,随着市场交易方式的变化和信息化程度的提高,鲜羊肉价格数据不再只来源于单一的线下市场记录,而是分散在多个销售渠道和不同地区之中,数据量逐渐增多,数据结构也变得更加复杂。传统方式下,人们往往只是通过简单的表格或单一折线图来看价格变化,很难同时从趋势、水平、波动、关联、季节和模式等多个角度去观察价格背后的规律。对于计算机专业的学生来说,如果只是做一个普通的价格展示页面,既不能体现大数据相关技术的应用,也不太容易满足毕业设计对数据处理与分析深度的要求。在这样的情况下,借助Hadoop和Spark来处理鲜羊肉价格数据,并结合可视化手段进行展示,就成为一个比较贴合实际、也相对适合作为毕业设计的研究方向。
选题意义
从实际应用角度看,这个系统能够把分散的鲜羊肉价格数据整理起来,通过Spark SQL和Pandas、NumPy做统计分析,再借助Echarts把趋势、水平、波动、关联、季节和模式等分析结果展示出来,让使用者不用自己去翻大量表格,也能较快地看出价格变化的大致规律。对于鲜羊肉相关经营者来说,这类分析结果可以作为了解市场价格走向的一个参考;对于消费者来说,也能帮助其更直观地认识价格波动情况。从学习角度看,这个毕业设计把Hadoop、Spark、HDFS、Django、Vue和MySQL等内容串在一起,能够让我在真实的数据处理与系统开发过程中加深对大数据技术链路的理解,也能锻炼从数据清洗到分析建模再到可视化呈现的完整能力。当然,受限于个人能力和数据来源,系统在分析深度和预测能力上还比较有限,更多是作为一个基础性的分析工具和毕业设计实践,谈不上有多大的商业价值,但对我个人而言,确实是一次比较完整的锻炼。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
- 基于大数据的鲜羊肉价格分析与可视化界面展示:
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, to_date, year, month, dayofweek, avg, stddev, lag, round as spark_round, when, count, sum as spark_sum
from pyspark.sql.window import Window
import pandas as pd
import numpy as np
spark = SparkSession.builder.appName("FreshMuttonPriceAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").enableHiveSupport().getOrCreate()
def price_trend_analysis(start_date, end_date):
    df = spark.read.format("csv").option("header", "true").option("inferSchema", "true").load("hdfs://localhost:9000/mutton/price_data.csv")
    df = df.withColumn("price_date", to_date(col("price_date"), "yyyy-MM-dd")).filter((col("price_date") >= start_date) & (col("price_date") <= end_date))
    df = df.withColumn("year", year(col("price_date"))).withColumn("month", month(col("price_date"))).withColumn("day", dayofweek(col("price_date")))
    trend_df = df.groupBy("year", "month").agg(spark_round(avg("price"), 2).alias("avg_price"), spark_round(stddev("price"), 2).alias("price_std"), count("price").alias("sample_count")).orderBy("year", "month")
    window_spec = Window.orderBy("year", "month")
    trend_df = trend_df.withColumn("prev_avg_price", lag("avg_price", 1).over(window_spec))
    trend_df = trend_df.withColumn("month_on_month", when(col("prev_avg_price").isNull(), 0).otherwise(spark_round((col("avg_price") - col("prev_avg_price")) / col("prev_avg_price") * 100, 2)))
    trend_pd = trend_df.toPandas()
    trend_pd["moving_avg_3"] = trend_pd["avg_price"].rolling(window=3, min_periods=1).mean().round(2)
    trend_pd["trend_direction"] = np.where(trend_pd["month_on_month"] > 0, "上涨", np.where(trend_pd["month_on_month"] < 0, "下跌", "持平"))
    result = trend_pd[["year", "month", "avg_price", "price_std", "month_on_month", "moving_avg_3", "trend_direction", "sample_count"]].to_dict(orient="records")
    return {"code": 200, "msg": "价格趋势分析完成", "data": result}
def price_fluctuation_analysis(region_code, year_value):
    df = spark.read.format("csv").option("header", "true").option("inferSchema", "true").load("hdfs://localhost:9000/mutton/price_data.csv")
    df = df.withColumn("price_date", to_date(col("price_date"), "yyyy-MM-dd")).filter((col("region_code") == region_code) & (year(col("price_date")) == year_value))
    df = df.withColumn("month", month(col("price_date")))
    month_stat = df.groupBy("month").agg(spark_round(avg("price"), 2).alias("month_avg"), spark_round(stddev("price"), 2).alias("month_std"), spark_round((spark_sum("price") / count("price")), 2).alias("month_mean"), count("price").alias("record_count")).orderBy("month")
    window_spec = Window.orderBy("month")
    month_stat = month_stat.withColumn("prev_month_avg", lag("month_avg", 1).over(window_spec))
    month_stat = month_stat.withColumn("fluctuation_rate", when(col("prev_month_avg").isNull(), 0).otherwise(spark_round((col("month_avg") - col("prev_month_avg")) / col("prev_month_avg") * 100, 2)))
    month_stat = month_stat.withColumn("fluctuation_level", when(col("fluctuation_rate").isNull(), "无").when(col("fluctuation_rate") > 5, "剧烈波动").when(col("fluctuation_rate") > 2, "中等波动").otherwise("平稳"))
    fluct_pd = month_stat.toPandas()
    fluct_pd["cv"] = (fluct_pd["month_std"] / fluct_pd["month_avg"]).round(4)
    fluct_pd["max_min_diff"] = (fluct_pd["month_avg"] - fluct_pd["month_avg"].min()).round(2)
    high_risk_months = fluct_pd[fluct_pd["fluctuation_level"] == "剧烈波动"]["month"].tolist()
    result = {"region_code": region_code, "year": year_value, "month_detail": fluct_pd[["month", "month_avg", "month_std", "fluctuation_rate", "fluctuation_level", "cv"]].to_dict(orient="records"), "high_risk_months": high_risk_months, "avg_fluctuation": round(float(fluct_pd["fluctuation_rate"].abs().mean()), 2)}
    return {"code": 200, "msg": "价格波动分析完成", "data": result}
def price_seasonal_analysis(category_name):
    df = spark.read.format("csv").option("header", "true").option("inferSchema", "true").load("hdfs://localhost:9000/mutton/price_data.csv")
    df = df.withColumn("price_date", to_date(col("price_date"), "yyyy-MM-dd")).filter(col("category") == category_name)
    df = df.withColumn("year", year(col("price_date"))).withColumn("month", month(col("price_date"))).withColumn("quarter", when(month(col("price_date")).between(1, 3), "Q1").when(month(col("price_date")).between(4, 6), "Q2").when(month(col("price_date")).between(7, 9), "Q3").otherwise("Q4"))
    season_df = df.groupBy("year", "quarter", "month").agg(spark_round(avg("price"), 2).alias("season_avg"), count("price").alias("cnt")).orderBy("year", "quarter", "month")
    season_pd = season_df.toPandas()
    season_pd["quarter_avg"] = season_pd.groupby(["year", "quarter"])["season_avg"].transform("mean").round(2)
    season_pd["month_deviation"] = (season_pd["season_avg"] - season_pd["quarter_avg"]).round(2)
    season_pd["season_index"] = (season_pd["season_avg"] / season_pd.groupby("year")["season_avg"].transform("mean")).round(4)
    season_pd["season_type"] = np.where(season_pd["season_index"] > 1.05, "旺季", np.where(season_pd["season_index"] < 0.95, "淡季", "平季"))
    quarter_summary = season_pd.groupby(["year", "quarter"]).agg({"season_avg": "mean", "season_index": "mean"}).round(3).reset_index().to_dict(orient="records")
    result = {"category": category_name, "month_season": season_pd[["year", "quarter", "month", "season_avg", "season_index", "season_type", "month_deviation"]].to_dict(orient="records"), "quarter_summary": quarter_summary}
    return {"code": 200, "msg": "价格季节分析完成", "data": result}
五、系统视频
基于大数据的鲜羊肉价格分析与可视化项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的鲜羊肉价格分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇