📚 本文收录于「流浪」的系列专栏
| 🐧 Linux系统 | ⚙️ C++ |
| 📊 数据结构与算法 | 🐍 Python |
| 🔗 LangChain & LangGraph | 🗄️ MySQL 数据库 |
| 🌿 Git 工具 | 🌐 计算机网络 |
| 🤖 AI | 💯 大厂面试、八股 |
| 📚 学习筑基专栏 |
🏠 博客主页:流浪 | 📝 原创首发于 CSDN
前言: 篇35 给信号系列收了尾------从信号是什么、怎么发怎么收,一路追到用户态与内核态的切换时机,"进程"这条主线到此闭环。接下来开一条新主线:线程 。本篇先把概念钉死:线程到底是什么?多个线程到底共用些什么?Linux 内核里为什么翻遍也找不到一个叫"线程"的结构? 三个问题,一次讲透。
一、线程是什么
1.1 为什么要有线程
写程序早晚会撞上一个需求:同一时刻干两件事。最经典的就是下载器------一边收数据,一边刷进度条。数据不等人,进度条也不能卡着不动,两件事必须"同时"进行。
串行做不到:单进程只有一条执行路径,收完数据再刷进度条,用户看到的就是卡半天、蹦一下。
fork 做得到,但代价别扭:子进程一 fork 出来就是独立地址空间,两边想共享一个"当前进度"变量,得靠管道、共享内存这些 IPC 手段绕一圈------通信系列五篇(篇23--28)讲的就是这套"绕"的成本。进程太重、共享太贵。
我们真正想要的,是一个"轻"的执行流 :不用背一整套地址空间,但能天然看到同一份数据。这个角色,就是线程。
1.2 概念角度,线程是进程内部的一个执行流
先给结论:
- 进程 = 内核描述数据结构 + 代码和数据,跑起来是一个执行流
- 线程 = 进程内部的一个执行流
篇11 讲过,进程 = task_struct(PCB)+ 代码和数据。程序跑起来,CPU 沿着代码一条条往下走------这条流动的执行路径,就是执行流。以前我们默认一个进程只有一条:main 函数从上到下,走完就退。
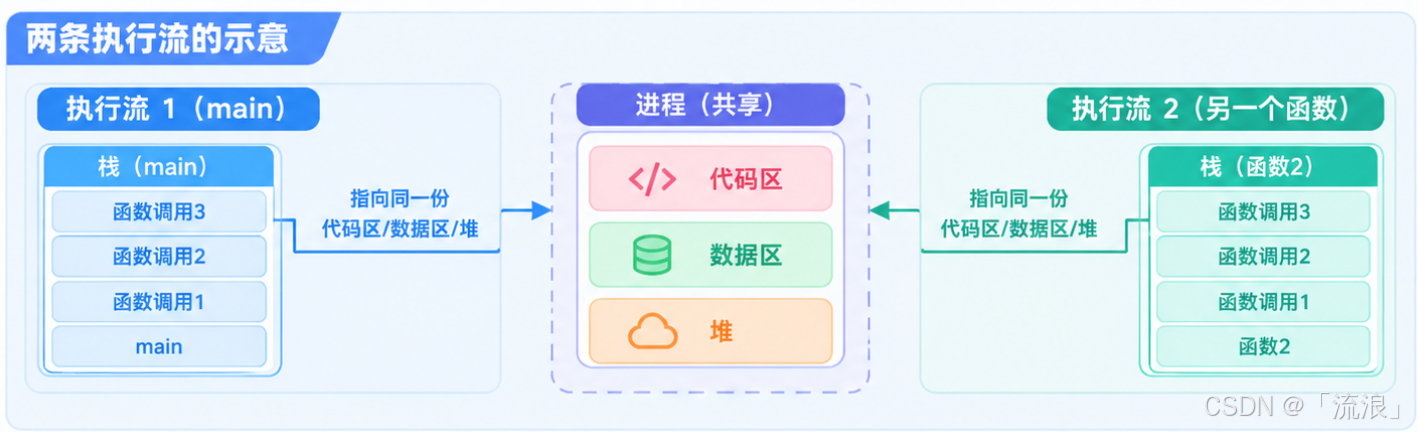
线程干的事,就是在同一个进程肚子里再开出一条(或几条)执行流:大家共用同一个"家底",各跑各的代码路径。
1.3 内核和资源角度,进程分配资源,线程被调度
教科书那句话------"进程是承担分配系统资源的基本实体,线程是 CPU 调度的基本单位"------为什么这么分?得从 CPU 调度的角度讲。
【衔接篇15】 篇15 讲虚拟地址空间时铺过:进程的资源------代码、数据、堆、栈、共享区------全被编排进虚拟地址空间,由页表映射到物理内存。也就是说,资源是挂在进程身上的。
【衔接篇12】 再看调度。篇12 讲调度切换时,被 CPU 换上换下的对象,本质就是执行流------只是当时一个进程只有一条执行流,进程和执行流一一对应,没必要拆开说。现在拆开了,这句话就变成:CPU 调度的基本单位,是线程。
两个角度是一体两面:概念角度回答"线程长什么样"(进程内部的执行流);内核资源角度回答"内核把什么分给谁"------资源分给进程,调度调的是线程。
二、线程的本质是共享地址空间、执行不同的函数
2.1 回顾进程的加载过程
【衔接篇15 / 篇16】 篇15、篇16 铺过这条链,这里只摆出来、不重讲:
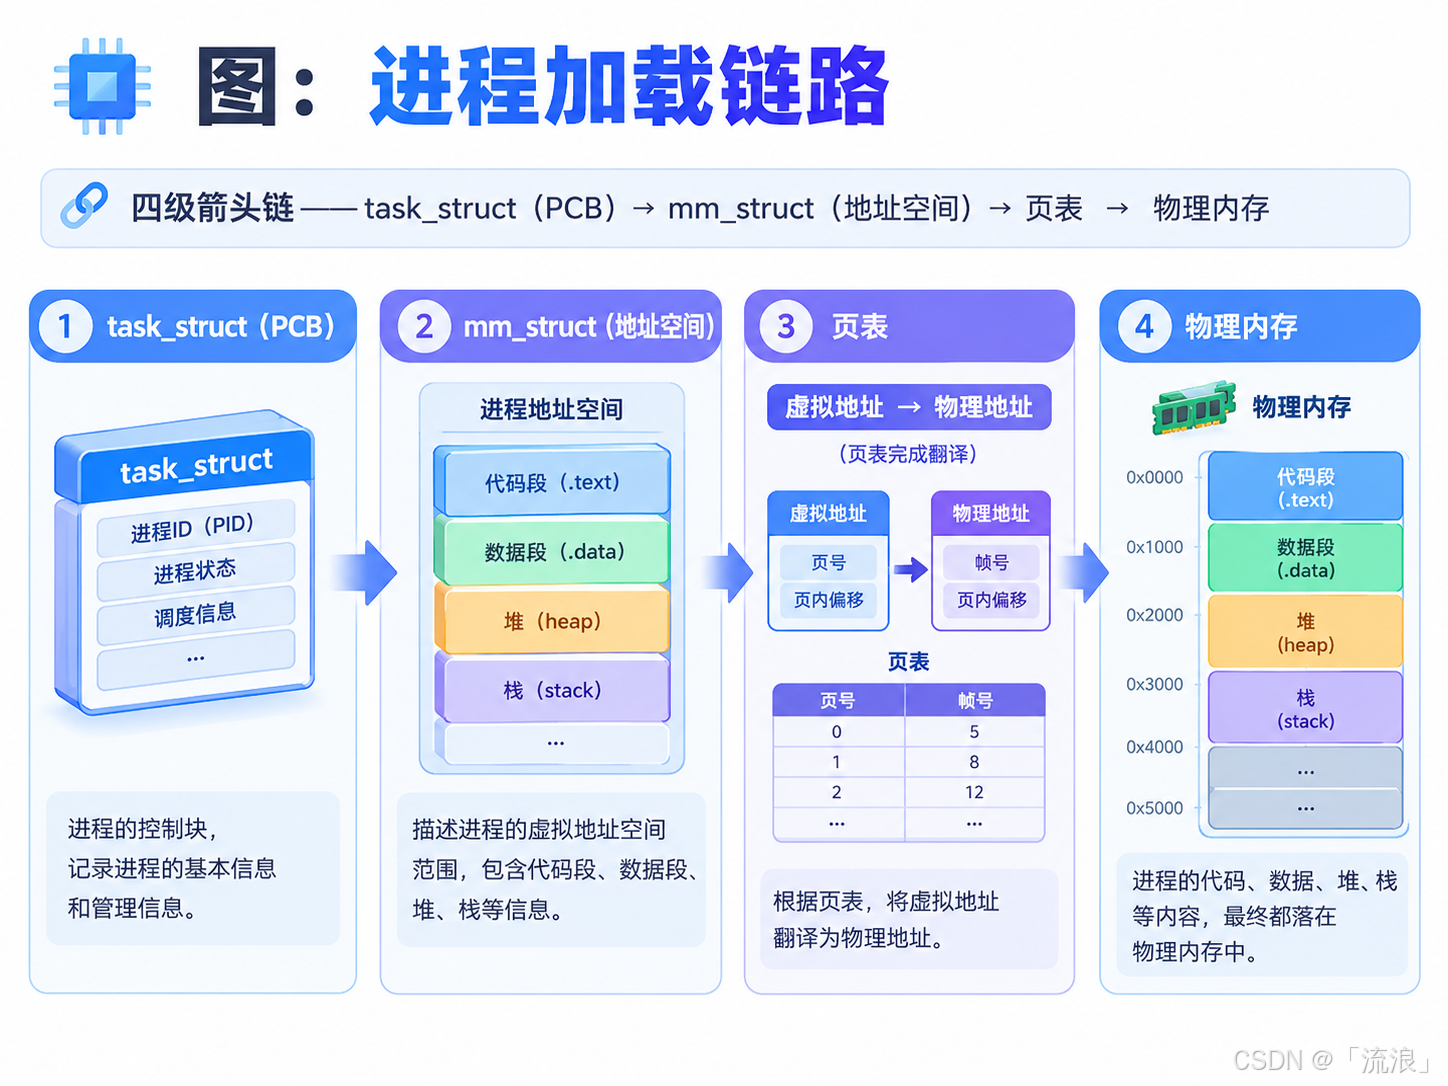
一个进程的加载 = task_struct → mm_struct → 页表 → 物理内存
进程要跑起来:内核先建 task_struct(PCB),它指向 mm_struct(虚拟地址空间),地址空间经页表映射到物理内存,程序的代码和数据加载到物理内存对应的位置。
2.2 地址空间是进程访问资源的窗口
进程访问的大部分资源,都是通过地址空间访问的。篇15 那张地址空间全景图里:凡是进程要碰的资源,都被编进了这张"大表",再由页表翻译到物理内存。
所以对进程来说,地址空间就是它接触资源的唯一"窗口":窗口里能看到什么,取决于地址空间怎么划分;窗外的物理内存怎么摆,是内核的事。
2.3 创建进程要把加载过程重走一遍
【衔接篇16 / 篇11】 篇16 讲 fork 时说过:创建子进程,内核要分配新的 task_struct、复制 mm_struct、复制页表。写时拷贝(篇11)省掉的是物理页的即时复制,但这一整套描述结构,每 fork 一次就要完整建一套。
这就是进程"重"的根源:每个进程独占一整套 PCB + 地址空间 + 页表。
2.4 共享窗口的新执行流就是线程
把 2.3 那套流程改一个字:新建 task_struct,但它不建新的 mm_struct、不建新的页表------直接指向原来那个 mm_struct。
结果:两个"进程"共享同一个窗口,看到同一份资源。mm_struct 只有一份,页表只有一套,两边看到的全局变量就是同一个。
这就是线程。
2.5 线程的本质是划分地址空间
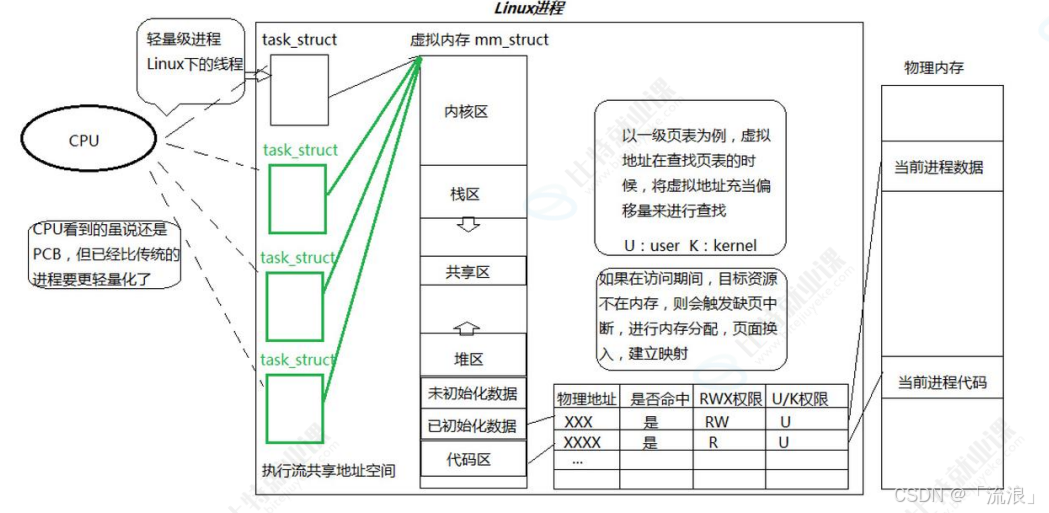
顺着推下去:把资源分配给不同的 task_struct------同一个 mm_struct,让不同的 task_struct 指向它的不同区域 ,各自执行不同代码。这就是线程,本质就是划分地址空间 。
两个结论落在这里:
- 结论 1:Linux 的"线程",可以用进程来模拟------它就是共享了资源的 task_struct
- 结论 2:对资源的划分,本质是对地址空间虚拟地址范围的划分。虚拟地址,就是资源的代表
2.6 多线程共享完整的虚拟地址空间和页表
一个进程内部本来只有一条执行流,代码串行走;开出多条执行流,各跑各的函数,串行变并行。
一句话钉死:多线程共享完整的虚拟地址空间和页表。1.1 那个下载器的需求,到这才算有了正解------不用 fork、不用 IPC,两条执行流天生看同一份数据。
2.7 代码的划分就是执行不同的函数
2.5 说"指向不同区域、执行不同代码"。可是代码不是抽象的一整块吗?"不同代码"怎么落到地址空间上?
【衔接篇21 / 篇22】 篇21、篇22 讲 ELF 时走过这条路:编译性语言经过预处理、编译、汇编、链接,落成 ELF 文件;代码段里是一条条指令,每条指令都有自己的地址。加载进内存后,映射到地址空间的代码区。
所以代码从来不是"一坨",它是虚拟地址空间里一段一段的地址区间。
每个函数都是一个代码块,代码就是虚拟地址(逻辑地址)空间的集合。不同的函数,落在地址空间的不同区间------正好对上 2.5 说的"不同区域"。
结论 3:让不同的线程,来执行 ELF 程序的不同函数,即可。
main 线程跑 main,新开的线程去跑你指定的那个函数------线程的"分工",落到底层就是各自跑在地址空间的不同函数区间里。
这也解释了创建线程的接口为什么总要你传一个函数进去:那个函数就是新执行流的起点。
三、Linux 用进程模拟线程
3.1 内核里没有独立的线程结构
前两章把"线程是什么、本质是什么"立住了,接下来看 Linux 怎么把它实现出来。先问一个最直接的问题:Linux 内核里,有独立叫"线程"的数据结构吗?
没有。 内核里描述执行流的,只有 task_struct 这一套。线程,就是共享了 mm_struct、文件描述符表、信号处理表的那批 task_struct。
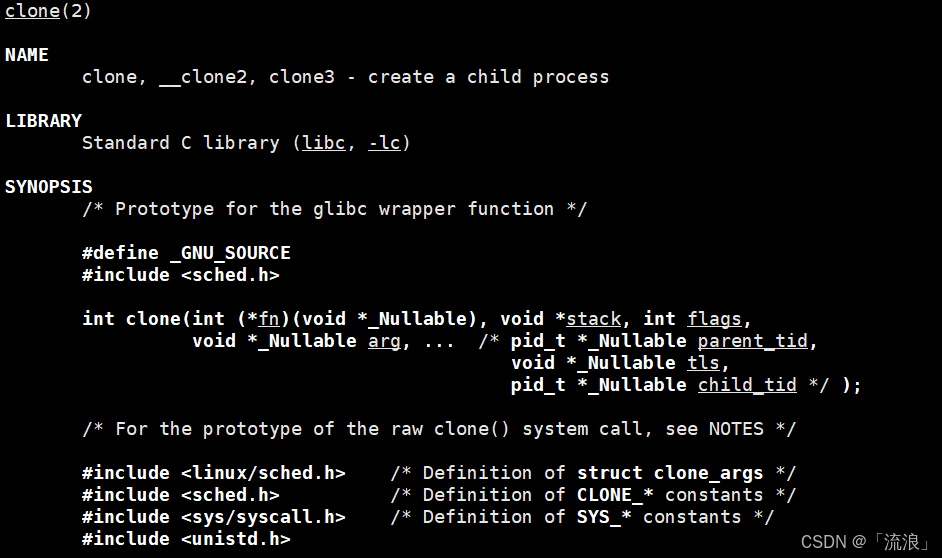
所以"用进程模拟线程"落到实处就一句话:不新增结构,只改共享方式 。结论 1 在 2.5 已经落下,这一章看它具体怎么落地------创建的入口,是 clone(2) 系统调用。
3.2 clone 系统调用和它的共享标志
按 man 2 clone:创建线程走的就是它,手册原文写明 clone 的用途之一就是 "implement threads: multiple flows of control ... in a shared address space"(在一个共享的地址空间里实现多条控制流)。共享什么,由 flags 说了算:
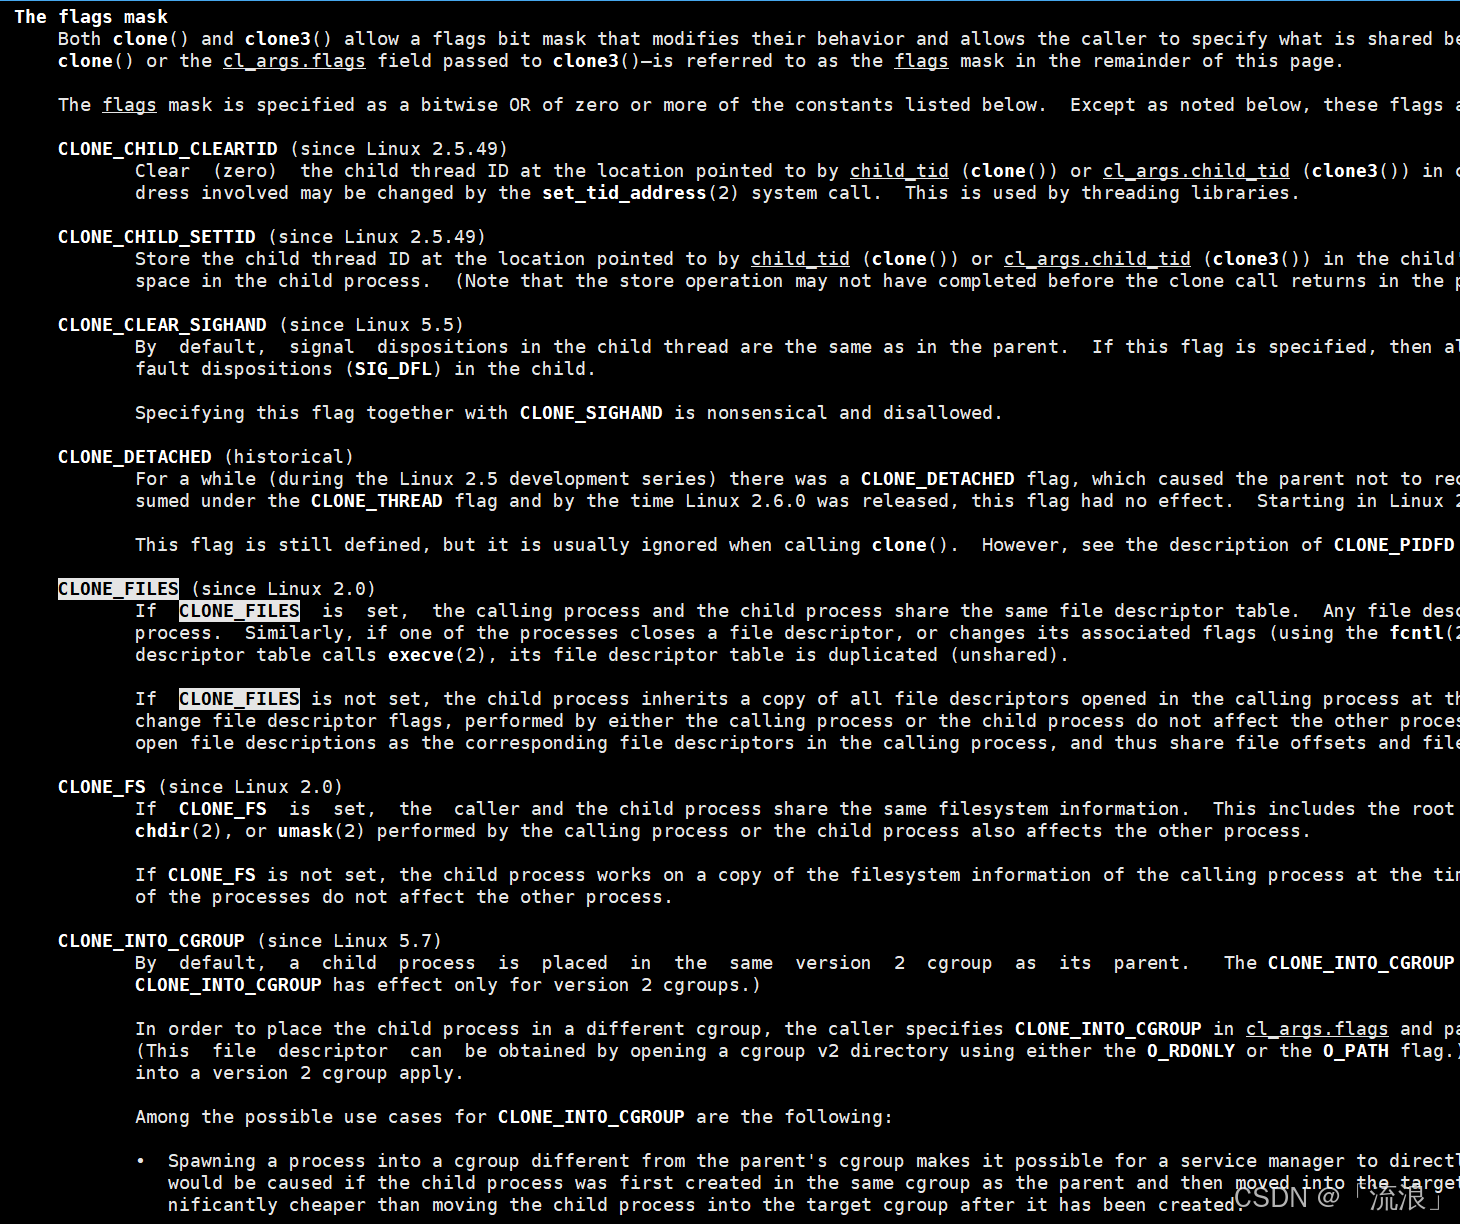
| 标志 | 共享什么 |
|---|---|
| CLONE_VM | 地址空间(mm_struct) |
| CLONE_FILES | 文件描述符表 |
| CLONE_SIGHAND | 信号处理函数表 |
| CLONE_THREAD | 线程组(放进同组,成为"线程") |
标志之间还有依赖链(man 2 clone 原文):设 CLONE_THREAD 必须同时设 CLONE_SIGHAND(自 2.5.35),设 CLONE_SIGHAND 必须同时设 CLONE_VM(自 2.6.0)------想共享信号处理表,前提是先共享地址空间,逻辑上自洽。
3.3 fork 是什么都不共享的 clone
反过来看 fork:同样走 clone(2) 这套机制,一个共享标志都不设,资源全部复制。
所以 fork 和创建线程不是两套机制,是同一套机制的两个极端 ------fork 是最"重"的 clone,线程是最"轻"的 clone,中间是一片连续的可调空间:想共享什么,就设哪个标志。
3.4 线程组、TGID 和 TID
手册还直接给了定义:"the term 'thread' is used to refer to the processes within a thread group"------线程,就是线程组里的进程。
线程组(Linux 2.4 引入)内共享一个 TGID,getpid() 返回的就是这个 TGID;每个线程有自己的 TID,用 gettid() 拿。所以同进程的线程 getpid 相同、gettid 各异------面试爱考这半句。
3.5 线程是轻量级进程,切换时不用换地址空间
Linux 线程的切入点,两个视角:
- Linux 视角:线程是执行流
- CPU 视角 :被换上换下的执行流,粒度比进程更细------轻量级的进程
结论 5:Linux 的线程只是轻量级进程(LWP,Lightweight Process),或者说,是用轻量级的进程模拟实现的。
为什么"轻"?看切换成本。【衔接篇35】 篇35 讲页表时埋过伏笔:跨进程切换,地址空间要换、页表要换,TLB 里缓存的地址翻译大面积作废,cache 里的热数据也要重新预热;同进程的线程切换,地址空间不变、页表不换,这两块缓存大体还是热的。
说准确点:线程切换省掉的是"换地址空间"这一大头;寄存器上下文、栈指针,两种切换都照换不误。"轻量级"三个字的底层含义,就是不换地址空间的执行流切换。
四、Linux 和 Windows 线程设计的差异
4.1 同一个思想,不同的实现方案
讲到这,两套话语都出现了:教科书说"线程是进程内部的执行流",Linux 说"我用进程模拟线程"------矛盾吗?不矛盾。
- OS(操作系统原理) :讲的是实现思想------线程该是什么、解决什么问题
- 具体的 OS(Linux / Windows) :讲的是实现方案------同一个思想,各自落地
学 OS 最忌讳的一件事,就是把某个具体系统的实现当成普世真理。教科书说的是思想,你手上的 man 手册说的是方案------两套话语体系,别搅在一起。
同一个"进程内部开执行流"的思想,Linux 选择了复用进程结构(第三章),Windows 选择了另一条路------两套独立的结构,接下来对照看。
4.2 Windows 用两套结构管理进程和线程
Windows 内核里,进程和线程各有各的数据结构:进程对象(EPROCESS / KPROCESS)和线程对象(ETHREAD / KTHREAD)(《Windows Internals》)。调度器调度的是线程,资源挂在进程上,两套结构、两套状态机,彼此的关系要专门维护。
这就是"从 PCB、TCB 的关系角度"看 Windows 的复杂所在。
4.3 Linux 复用进程结构,做得更健壮
Linux 不走双结构路线:用进程模拟线程------进程的内核代码、数据结构,全部复用(第三章的 clone 和 CLONE_* 标志,就是它的全部机制)。
这个选择使得整个设计更健壮。好处四条:
- 出错面小:一套结构、一条代码路径。两套结构、两套状态机并存,结构越多、交互越复杂,bug 概率越高------结构少本身就是健壮。
- 调度路径统一:调度器眼里只有 task,进程和线程走同一条调度逻辑,不存在"两套调度器状态不同步"这种问题。
- 内核能力天然继承:信号、权限、cgroup、命名空间------凡是加在 task 身上的能力,线程自动获得;内核演进只改一处,进程线程同时受益,不会出现"改了进程忘了线程"的撕裂。
- 长期实践验证:Linux 2.4 引入线程组、NPTL 一对一模型(2003 年随 glibc 2.3 / 内核 2.6 落地)沿用至今二十多年,主线从未推翻------简单换来了可维护。
| 维度 | Windows | Linux |
|---|---|---|
| 执行流描述结构 | EPROCESS + ETHREAD 两套 | task_struct 一套复用 |
| 线程怎么来 | 独立的线程对象,PCB / TCB 分立 | 共享资源的 task_struct(clone + CLONE_*) |
| 进程 / 线程创建 | 不同的创建路径 | 同一个 clone(2),标志不同 |
| 设计取向 | 结构化分工,代价是复杂 | 结构复用,代价是内核里没有"纯线程"概念 |
【衔接篇30 / 篇35】 信号系列两摸 task_struct------篇30 的信号位图、篇35 的用户态与内核态。加上本篇这个"执行流"身份,task_struct 的三张面孔就凑齐了。
五、进程和线程的关系总结
5.1 线程在进程的地址空间内运行
线程没有自己的地址空间。它执行的代码、访问的数据,全部落在进程的地址空间里;创建线程也不创建新的地址空间和页表(2.4 推过),只是同一个地址空间里多了一条执行流。
所以说线程"在进程内部",不是比喻,是物理事实------执行流跑的每一步,都踩在进程的地址空间上。
5.2 以前的进程是只有一个线程的进程
学完线程回头看:篇11 到篇16 讲的进程,其实都是内部只有一个线程的进程。
进程从来都是"资源容器 + 执行流"的组合,只不过以前那条执行流是唯一默认的,没必要拆开说。现在拆开了,账要重新算------结论 4:以前所谓的进程,内部只有一个线程。
5.3 进程强调独占,线程强调共享
进程的默认姿态是独占 ------自己的地址空间、页表、fd 表,为了协作才通过 IPC 共享(通信系列五篇讲的就是"绕"的成本);线程反过来,默认共享------地址空间、页表、fd 表、信号处理表,私有的只有栈、上下文、线程 ID 这几样。
一张表对照看:
| 对比项 | 两个进程之间 | 同一进程的线程之间 |
|---|---|---|
| 地址空间和页表 | 各自独立一套 | 共享同一份 |
| 文件描述符表 | 各自独立 | 共享同一份 |
| 信号处理表 | 各自独立 | 共享同一份 |
| 栈 | 各自独立 | 各自私有,互不共享 |
| 身份标识 | PID 各不相同 | TGID 相同,TID 各不相同 |
| 隔离性 | 地址空间隔离,一个崩了另一个照跑 | 没有隔离,一个线程崩了整个进程退出 |
表里最后一行是共享的代价,也是面经高频考点:线程之间没有隔离性 ------地址空间不设墙,一个线程非法访问内存触发段错误,整个进程跟着退出;进程之间有地址空间这堵墙,一个崩了,另一个照跑。所以"选多进程还是多线程",本质上是在共享的效率 和隔离的可靠性之间做取舍。
5.4 全篇结论回顾
五条结论串起来:Linux 线程可以用进程模拟(结论 1)→ 对资源的划分,本质是对地址空间虚拟地址范围的划分,虚拟地址是资源的代表(结论 2)→ 线程执行 ELF 的不同函数(结论 3)→ 以前的进程是单线程进程(结论 4)→ Linux 线程是轻量级进程(结论 5)。
六、面试官爱问(带答案)
6.1 什么是线程?它和进程是什么关系?
答(推导 · 面经高频,转述): 概念上,线程是进程内部的一个执行流;进程 = 内核描述数据结构 + 代码和数据。资源角度,进程是承担分配系统资源的基本实体,线程是 CPU 调度的基本单位。同进程的线程共享地址空间和页表,各自执行不同的函数。
6.2 为什么说"进程是资源分配的基本单位,线程是调度的基本单位"?
答(推导 · 已对照面经,转述): 资源------代码、数据、fd 表------都挂在进程的地址空间和描述结构上;而 CPU 换上换下的对象是执行流。一个进程可以有多个执行流,所以资源归进程、调度归线程。
6.3 Linux 内核是怎么实现线程的?
答(推导 · 已对照面经,转述): 没有独立的线程结构。描述执行流的只有 task_struct;线程就是通过 clone(2) 设置 CLONE_VM、CLONE_FILES、CLONE_SIGHAND、CLONE_THREAD 等共享标志创建出来的 task_struct。man 2 clone 原文:线程是"线程组内的进程"。
6.4 fork 和创建线程是什么关系?
答(推导): 同一个 clone(2) 机制,差别只在共享标志:fork 一个都不设、资源全复制;线程把该共享的都共享。可以记成"fork 是最重的 clone,线程是最轻的 clone"。
6.5 同一进程的两个线程,getpid() 一样吗?怎么区分它们?
答(推导 · 面经高频,转述): 一样。线程组内共享 TGID,getpid() 返回的是 TGID;区分靠 TID,用 gettid() 获取。这也是 ps 里同一进程多个线程 PID 相同、线程各有 tid 的原因。
6.6 线程切换为什么比进程切换轻?
答(推导 · 已对照面经,转述): 同进程的线程切换不换地址空间:页表不换,TLB 缓存的地址翻译大体保得住,cache 热数据残留更多;跨进程切换要换页表,这两块基本要重新预热。寄存器上下文和栈指针,两种切换都要换。
6.7 Linux 和 Windows 的线程设计有什么差异?
答(推导): Windows 用两套结构------进程对象(EPROCESS/KPROCESS)和线程对象(ETHREAD/KTHREAD),PCB / TCB 分立,关系要专门维护(《Windows Internals》);Linux 只用 task_struct 一套结构复用,用进程模拟线程。换来四点好处:出错面小、调度路径统一、内核能力天然继承、长期可维护。
6.8 多线程共享地址空间,会带来什么新问题?
答(推导): 共享是把双刃剑,代价两个。一是数据一致性:两个执行流同时读写同一份数据,可能互相踩踏、数据不一致,这就是线程安全问题,需要同步与互斥机制管住"谁能进、谁能改"。二是隔离性:地址空间不设墙,一个线程段错误,整个进程跟着退出。"选多进程还是多线程",本质上是在共享的效率和隔离的可靠性之间做取舍。
💬 线程的概念,说到底就藏在"共享窗口"四个字里:task_struct 还是那个 task_struct,mm_struct 只有那一份,变的是指向它的执行流数量。你是从哪一篇跟到现在的?线程这块踩过什么坑,评论区聊聊。