Linux基础IO万字详解:从文件描述符fd到重定向、FILE缓冲机制及MiniShell升级
🔥 星恒随风: 个人主页 ❄️ 个人专栏: 《指针合集》 | 《C语言基础》 | 《数据结构》 | 《机器学习导论》 | 《前端基础》 | 《python基础》 | 《C++从入门到入土》 | 《Linux的学习之旅》 ✨ 数据即知识,压缩即智能
文章目录
- Linux基础IO万字详解:从文件描述符fd到重定向、FILE缓冲机制及MiniShell升级
- 一、重新认识Linux中的文件
-
- [1.1 狭义上的文件](#1.1 狭义上的文件)
- [1.2 文件由什么组成?](#1.2 文件由什么组成?)
-
- [1.2.1 文件内容](#1.2.1 文件内容)
- [1.2.2 文件属性](#1.2.2 文件属性)
- [1.2.3 为什么空文件也可以存在?](#1.2.3 为什么空文件也可以存在?)
- [1.3 Linux为什么强调"一切皆文件"?](#1.3 Linux为什么强调“一切皆文件”?)
- [1.4 为什么文件操作一定和进程有关?](#1.4 为什么文件操作一定和进程有关?)
- 二、回顾C语言中的文件操作
-
- [2.1 fopen与fclose](#2.1 fopen与fclose)
-
- [2.1.1 文件路径是相对于谁的?](#2.1.1 文件路径是相对于谁的?)
- [2.1.2 如何查看进程的工作目录?](#2.1.2 如何查看进程的工作目录?)
- [2.2 fwrite与fread](#2.2 fwrite与fread)
-
- [2.2.1 fwrite](#2.2.1 fwrite)
- [2.2.2 fread](#2.2.2 fread)
- 三、为什么还需要系统文件IO?
-
- [3.1 C语言文件函数和操作系统的关系](#3.1 C语言文件函数和操作系统的关系)
- [3.2 Linux常见的文件系统调用](#3.2 Linux常见的文件系统调用)
- 四、open函数详解
-
- [4.1 函数原型](#4.1 函数原型)
- [4.2 文件打开标志位](#4.2 文件打开标志位)
- [4.3 为什么使用按位或?](#4.3 为什么使用按位或?)
- [4.4 mode与umask](#4.4 mode与umask)
- 五、read、write与close
-
- [5.1 write函数](#5.1 write函数)
- [5.2 使用系统调用写文件](#5.2 使用系统调用写文件)
- [5.3 read函数](#5.3 read函数)
- [5.4 实现一个简化版cat](#5.4 实现一个简化版cat)
- 六、文件描述符fd到底是什么?
-
- [6.1 Linux进程默认的三个文件描述符](#6.1 Linux进程默认的三个文件描述符)
- [6.2 为什么默认有0、1、2?](#6.2 为什么默认有0、1、2?)
- [6.3 文件描述符的内核管理结构](#6.3 文件描述符的内核管理结构)
- [6.4 为什么open返回整数?](#6.4 为什么open返回整数?)
- 七、文件描述符的分配规则
-
- [7.1 为什么第一次open通常返回3?](#7.1 为什么第一次open通常返回3?)
- [7.2 验证文件描述符分配规则](#7.2 验证文件描述符分配规则)
- [7.3 通过/proc查看文件描述符](#7.3 通过/proc查看文件描述符)
- 八、进一步认识内核打开文件对象
-
- [8.1 fd和文件对象不是一一对应的](#8.1 fd和文件对象不是一一对应的)
- [8.2 为什么这很重要?](#8.2 为什么这很重要?)
- 九、重定向究竟是什么?
-
- [9.1 从一个最简单的问题开始](#9.1 从一个最简单的问题开始)
- [9.2 重定向之前](#9.2 重定向之前)
- [9.3 重定向之后](#9.3 重定向之后)
- 十、通过关闭标准输出理解重定向
-
- [10.1 先看一个实验](#10.1 先看一个实验)
- [10.2 为什么要fflush(stdout)?](#10.2 为什么要fflush(stdout)?)
- 十一、dup2:真正适合实现重定向的接口
-
- [11.1 函数原型](#11.1 函数原型)
- [11.2 使用dup2实现输出重定向](#11.2 使用dup2实现输出重定向)
- [11.3 为什么dup2后还可以close(fd)?](#11.3 为什么dup2后还可以close(fd)?)
- 十二、理解Shell中三种常见重定向
-
- [12.1 输出重定向:>](#12.1 输出重定向:>)
- [12.2 追加重定向:>>](#12.2 追加重定向:>>)
- [12.3 输入重定向:<](#12.3 输入重定向:<)
- [12.4 三种重定向的对应关系](#12.4 三种重定向的对应关系)
- 十三、为什么重定向应该发生在exec之前?
- 十四、fd与FILE*究竟是什么关系?
-
- [14.1 为什么有了fd,还要FILE*?](#14.1 为什么有了fd,还要FILE*?)
- [14.2 fd是系统调用层的文件描述符](#14.2 fd是系统调用层的文件描述符)
- [14.3 FILE*是标准库的文件流对象](#14.3 FILE*是标准库的文件流对象)
- [14.4 为什么说FILE内部与fd有关?](#14.4 为什么说FILE内部与fd有关?)
- 十五、使用fileno与fdopen连接两层接口
-
- [15.1 fileno:从FILE*取得fd](#15.1 fileno:从FILE*取得fd)
- [15.2 fdopen:从已有fd构建FILE*](#15.2 fdopen:从已有fd构建FILE*)
- [15.3 fd与FILE*对比](#15.3 fd与FILE*对比)
- 十六、为什么需要缓冲区?
-
- [16.1 每输出一个字符都进行系统调用会怎样?](#16.1 每输出一个字符都进行系统调用会怎样?)
- [16.2 什么是缓冲区?](#16.2 什么是缓冲区?)
- 十七、用户态标准IO缓冲
-
- [17.1 printf并不一定立即调用write](#17.1 printf并不一定立即调用write)
- [17.2 标准IO的三种常见缓冲方式](#17.2 标准IO的三种常见缓冲方式)
-
- [17.2.1 全缓冲](#17.2.1 全缓冲)
- [17.2.2 行缓冲](#17.2.2 行缓冲)
- [17.2.3 无缓冲](#17.2.3 无缓冲)
- [17.3 fflush到底做了什么?](#17.3 fflush到底做了什么?)
- [十八、内核文件缓冲与Page Cache](#十八、内核文件缓冲与Page Cache)
- 十九、用fork实验理解用户态缓冲区
-
- [19.1 实验代码](#19.1 实验代码)
- [19.2 直接在终端执行](#19.2 直接在终端执行)
- [19.3 使用输出重定向](#19.3 使用输出重定向)
- [19.4 为什么write只出现一次?](#19.4 为什么write只出现一次?)
- [19.5 如何避免fork造成标准IO缓冲重复输出?](#19.5 如何避免fork造成标准IO缓冲重复输出?)
- 二十、升级我们的MiniShell:增加重定向功能
-
- [20.1 回顾原来的MiniShell](#20.1 回顾原来的MiniShell)
- [20.2 参考课件的实现思路](#20.2 参考课件的实现思路)
- [20.3 为什么不能直接复制课件的MiniShell?](#20.3 为什么不能直接复制课件的MiniShell?)
- 二十一、重新设计命令解析结构
-
- [21.1 定义重定向类型](#21.1 定义重定向类型)
- [21.2 使用CommandInfo保存一整条命令](#21.2 使用CommandInfo保存一整条命令)
- [21.3 为什么先解析重定向,再解析命令?](#21.3 为什么先解析重定向,再解析命令?)
- 二十二、如何实现ParseRedirection?
-
- [22.1 先限定作业范围](#22.1 先限定作业范围)
- [22.2 实现思路](#22.2 实现思路)
- 二十三、实现ApplyRedirection()
- 二十四、一个重要问题:内建命令如何重定向?
-
- [24.1 外部命令可以在子进程中重定向](#24.1 外部命令可以在子进程中重定向)
- [24.2 但是我们的echo是内建命令](#24.2 但是我们的echo是内建命令)
- [24.3 解决方式:临时重定向,再恢复](#24.3 解决方式:临时重定向,再恢复)
- 二十五、MiniShell增加重定向后的完整代码
-
- [25.1 完整源码:myshell.cpp](#25.1 完整源码:myshell.cpp)
- 二十六、分析新MiniShell的执行过程
-
- [26.1 外部命令:ls > log.txt](#26.1 外部命令:ls > log.txt)
- [26.2 内建命令:echo hello > log.txt](#26.2 内建命令:echo hello > log.txt)
- 二十七、MiniShell重定向功能测试
-
- [27.1 编译程序](#27.1 编译程序)
- [27.2 测试覆盖输出重定向](#27.2 测试覆盖输出重定向)
- [27.3 测试追加输出重定向](#27.3 测试追加输出重定向)
- [27.4 测试输入重定向](#27.4 测试输入重定向)
- [27.5 测试不带空格的重定向](#27.5 测试不带空格的重定向)
- [27.6 测试外部命令输出](#27.6 测试外部命令输出)
- [27.7 测试环境变量仍然有效](#27.7 测试环境变量仍然有效)
- [27.8 测试退出状态](#27.8 测试退出状态)
- [27.9 测试标准错误与标准输出的区别](#27.9 测试标准错误与标准输出的区别)
- 二十八、从重定向重新理解fd、FILE与缓冲区
-
- [28.1 当我们执行echo hello > log.txt时](#28.1 当我们执行echo hello > log.txt时)
- [28.2 当我们执行ls > log.txt时](#28.2 当我们执行ls > log.txt时)
- 二十九、基础IO常见错误总结
-
- [29.1 认为fd就是文件地址](#29.1 认为fd就是文件地址)
- [29.2 认为fd 1永远是显示器](#29.2 认为fd 1永远是显示器)
- [29.3 认为dup2会复制文件全部内容](#29.3 认为dup2会复制文件全部内容)
- [29.4 认为dup2成功后不能close原fd](#29.4 认为dup2成功后不能close原fd)
- [29.5 认为FILE*和fd可以直接互换](#29.5 认为FILE*和fd可以直接互换)
- [29.6 认为read会自动添加'\0'](#29.6 认为read会自动添加'\0')
- [29.7 认为write一次一定写完](#29.7 认为write一次一定写完)
- [29.8 认为fflush等于fsync](#29.8 认为fflush等于fsync)
- [29.9 认为write没有任何缓冲](#29.9 认为write没有任何缓冲)
- [29.10 在Shell父进程中重定向以后忘记恢复](#29.10 在Shell父进程中重定向以后忘记恢复)
- 三十、基础IO知识体系总结
- 总结
前言:从进程控制走向文件IO
在前面的 Linux 进程控制学习中,我们已经通过 fork()、execvp() 和 waitpid() 实现了一个简易 Shell。
目前,我们的 MiniShell 已经能够完成:
- 读取和解析用户输入的命令。
- 使用
fork()创建子进程。 - 使用
execvp()执行外部程序。 - 使用
waitpid()等待子进程并获取退出状态。 - 使用内建命令实现
cd、export、echo和exit。
例如:
bash
myshell$ ls -l
myshell$ cd /tmp
myshell$ echo hello
但是,如果尝试执行:
bash
myshell$ echo hello > log.txt我们之前的程序就无法正确处理。
真正的 Shell 会将 hello 写入 log.txt,而不是显示在终端上。
这便引出了一个重要问题:
程序默认向显示器输出数据,操作系统究竟怎样把这些数据转移到文件中?
要回答这个问题,我们首先需要理解 Linux 文件 IO 的底层机制。
本篇文章将按照下面的顺序展开:
text
理解Linux文件
      |
      v
回顾C语言文件操作
      |
      v
认识系统调用open/read/write/close
      |
      v
认识文件描述符fd
      |
      v
理解内核文件描述符表
      |
      v
理解dup2与重定向
      |
      v
认识fd与FILE*的关系
      |
      v
理解用户态缓冲与内核文件缓存
      |
      v
为MiniShell增加重定向功能
本文重点解决三个问题:
- 文件描述符是什么,为什么重定向只需要修改文件描述符的指向?
- 为什么
printf()使用FILE*,而write()使用整数fd? - 为什么执行了
printf()或write(),数据却不一定立刻写入磁盘?
一、重新认识Linux中的文件
1.1 狭义上的文件
从最直观的角度理解,文件就是保存在磁盘等存储设备中的数据。
例如:
text
hello.txt
main.cpp
a.out
image.png
这些文件通常具有持久化存储的特点。
即使程序结束,文件仍然可以保存在磁盘中。
但从操作系统角度考虑,仅仅把文件理解为一段数据是不够的。
1.2 文件由什么组成?
一个文件可以从逻辑上划分为:
text
文件
 |
 +-- 文件内容(Data)
 |
 +-- 文件属性(Metadata)
1.2.1 文件内容
例如:
text
hello world这属于文件的数据内容。
1.2.2 文件属性
例如:
- 文件大小。
- 文件权限。
- 文件所有者。
- 文件类型。
- 文件时间戳。
- 文件系统中的 inode 信息。
这些属于文件的元数据。
所以我们可以建立一个初步认识:
文件不仅仅是内容,也包含操作系统用于描述和管理它的属性信息。
1.2.3 为什么空文件也可以存在?
执行:
bash
touch empty.txt然后:
bash
ls -l empty.txt我们可以看到一个大小为 0 字节的文件。
虽然没有文件内容,但文件系统仍需要维护它的目录项、inode 等相关元数据。
因此:
text
文件内容为空不意味着:
text
文件不存在也不意味着文件系统完全不需要占用空间。
1.3 Linux为什么强调"一切皆文件"?
Linux 将普通文件、终端、管道、设备等多种资源抽象为能够通过文件接口访问的对象。
例如:
text
普通磁盘文件
终端设备
管道
某些设备文件
Socket
都可以在适当条件下使用文件描述符及相关接口进行操作。
这意味着程序可以使用相对统一的接口:
c
read()
write()
close()
处理不同类型的资源。
但需要注意:
"一切皆文件"是一种系统资源抽象思想,不意味着所有资源都支持完全相同的文件操作。
例如,普通磁盘文件通常支持 lseek(),但是管道一般不支持通过 lseek() 随意改变读写位置。
1.4 为什么文件操作一定和进程有关?
前面我们学习过:
进程是程序的一次执行实例。
当程序需要读取磁盘文件时,实际发起操作的是正在运行的进程。
例如:
c
fopen("hello.txt", "r");从进程和操作系统的关系来看:
text
用户进程
    |
    | 请求打开文件
    v
操作系统内核
    |
    | 检查路径、权限等
    v
文件系统
    |
    v
对应的文件对象
所以:
文件的读取、写入和关闭,都发生在进程使用操作系统提供的文件访问接口的过程中。
二、回顾C语言中的文件操作
2.1 fopen与fclose
在 C 语言中,我们通常使用:
c
#include <stdio.h>

FILE* fopen(const char* pathname, const char* mode);

int fclose(FILE* stream);
例如:
c
#include <stdio.h>

int main(void)
{
    FILE* fp = fopen("hello.txt", "w");

    if (fp == NULL)
    {
        perror("fopen");
        return 1;
    }

    fprintf(fp, "hello world\n");

    fclose(fp);

    return 0;
}
执行后,当前工作目录中会出现 hello.txt。
这里需要注意两件事。
2.1.1 文件路径是相对于谁的?
c
fopen("hello.txt", "w");使用的是相对路径。
它通常相对于当前进程的工作目录进行解析。
我们之前在 MiniShell 中使用过:
cpp
getcwd()就是用来获取当前工作目录的。
因此,文件的创建位置并不必然等于可执行程序所在目录。
2.1.2 如何查看进程的工作目录?
可以使用:
bash
ls -l /proc/self/cwd其中:
text
/proc/self指向当前访问该路径的进程。
对于指定进程,可以查看:
bash
ls -l /proc/进程PID/cwd以及:
bash
ls -l /proc/进程PID/exe两者含义不同:
| 路径 | 含义 |
|---|---|
cwd |
进程当前工作目录 |
exe |
进程当前执行的程序文件 |
fd |
进程打开的文件描述符 |
例如:
bash
ls -l /proc/$$/fd可以查看当前 Bash 进程的文件描述符信息。
2.2 fwrite与fread
2.2.1 fwrite
函数原型:
c
size_t fwrite(
    const void* ptr,
    size_t size,
    size_t nmemb,
    FILE* stream
);
其中:
ptr:待写入数据的起始地址。size:每个元素的大小。nmemb:元素个数。stream:目标文件流。
注意:fwrite() 返回的是成功写入的完整元素个数,不一定是字节数。
例如:
c
const char* msg = "hello world\n";

fwrite(msg, 1, strlen(msg), fp);
这里每个元素大小为 1 字节,所以返回的完整元素个数可以直接理解为写入的字节数。
2.2.2 fread
函数原型:
c
size_t fread(
    void* ptr,
    size_t size,
    size_t nmemb,
    FILE* stream
);
例如:
c
char buffer[1024];

size_t n = fread(buffer, 1, sizeof(buffer), fp);
这里 n 表示成功读取的字节数,因为每个元素大小为 1。
需要特别注意:
fread() 读取的数据并不会自动在末尾添加 '\0'。
所以不能直接假设:
c
printf("%s", buffer);一定安全。
对于任意文件数据,更合适的写法是:
c
fwrite(buffer, 1, n, stdout);这也是为什么实现 cat 这样的工具时,按实际字节数写出会更加合理。
三、为什么还需要系统文件IO?
3.1 C语言文件函数和操作系统的关系
前面使用的:
c
fopen()
fread()
fwrite()
fclose()
属于 C 标准库提供的接口。
但是,进程不能绕过操作系统直接任意访问磁盘。
因此在 Linux 中,标准库最终仍然需要通过操作系统提供的底层接口完成文件操作。
可以简单理解为:
text
用户程序
    |
    v
C标准库
    |
    | fopen、fwrite、fread等
    v
系统调用接口
    |
    | open、write、read等
    v
Linux内核
    |
    v
文件系统与设备
这里的封装关系并不是说每调用一次 fwrite() 都一定立即产生一次 write() 系统调用。
因为标准库可能先把数据暂存在用户态缓冲区中。
这部分后面会详细解释。
3.2 Linux常见的文件系统调用
最常用的四个接口:
c
open()
read()
write()
close()| 接口 | 主要作用 |
|---|---|
open() |
打开文件,取得文件描述符 |
read() |
从文件描述符读取数据 |
write() |
向文件描述符写入数据 |
close() |
关闭文件描述符 |
此外,还有:
c
lseek()
dup()
dup2()
分别用于调整文件偏移量和复制文件描述符。
其中,dup2() 是理解重定向的关键。
四、open函数详解
4.1 函数原型
c
#include <fcntl.h>

int open(const char* pathname, int flags);

int open(const char* pathname, int flags, mode_t mode);
参数含义:
| 参数 | 作用 |
|---|---|
pathname |
文件路径 |
flags |
文件打开方式 |
mode |
创建文件时使用的权限参数 |
返回值:
text
成功:
返回非负整数fd

失败:
返回-1,并设置errno
这里第一次出现了本篇的重要概念:
文件描述符(File Descriptor,简称 fd)。
暂时可以把它理解为:
当前进程用于引用一个已打开文件或其他打开对象的整数编号。
4.2 文件打开标志位
常见标志:
| 标志 | 含义 |
|---|---|
O_RDONLY |
只读 |
O_WRONLY |
只写 |
O_RDWR |
可读可写 |
O_CREAT |
文件不存在时创建 |
O_TRUNC |
将普通文件长度截断为0 |
O_APPEND |
每次写入时以追加方式定位 |
O_CLOEXEC |
在成功执行exec时关闭该描述符 |
其中 O_RDONLY、O_WRONLY 和 O_RDWR 是互斥的访问模式,应选择其中一个。
其他选项可以通过按位或组合。
例如:
c
O_WRONLY | O_CREAT | O_TRUNC含义是:
text
以只写方式打开
       +
不存在则创建
       +
若文件已存在则清空原内容
4.3 为什么使用按位或?
例如:
c
#define FLAG_A 0x01
#define FLAG_B 0x02
#define FLAG_C 0x04
可以使用:
c
int flags = FLAG_A | FLAG_C;组合多个独立标志位。
然后:
c
if (flags & FLAG_A)
{
    // 检测FLAG_A是否设置
}
类似地:
c
open("log.txt", O_WRONLY | O_CREAT | O_TRUNC, 0644);通过 flags 一次性描述多项打开要求。
需要注意的是,O_RDONLY 在 Linux 中通常为 0,因此不能简单用 flags & O_RDONLY 判断是否只读,应通过 O_ACCMODE 提取访问模式。
4.4 mode与umask
例如:
c
open("log.txt", O_WRONLY | O_CREAT, 0666);这里:
text
0666表示请求创建文件时允许:
text
所有者:读、写
所属组:读、写
其他用户:读、写
但最终创建权限还受到:
text
umask的影响。
可以简化理解为:
text
最终权限 = 请求权限中去掉umask指定的权限位准确的位运算关系是:
text
最终权限位 = mode & ~umask例如:
text
mode  = 0666
umask = 0022
最终常见结果为:
text
0644所以不应简单认为 open(..., 0666) 一定创建权限为 0666 的文件。
五、read、write与close
5.1 write函数
函数原型:
c
#include <unistd.h>

ssize_t write(int fd, const void* buf, size_t count);
三个参数:
fd:目标文件描述符。buf:数据缓冲区地址。count:本次请求写入的字节数。
返回值:
text
正整数:
实际写入的字节数

0:
本次没有写入字节

-1:
发生错误
注意:
一次 write() 不保证一定写完要求的全部字节。
所以严谨的程序需要处理部分写入和系统调用被信号中断的情况。
5.2 使用系统调用写文件
c
#include <stdio.h>
#include <string.h>
#include <fcntl.h>
#include <unistd.h>

int main(void)
{
    int fd = open(
        "log.txt",
        O_WRONLY | O_CREAT | O_TRUNC,
        0644
    );

    if (fd < 0)
    {
        perror("open");
        return 1;
    }

    const char* msg = "hello Linux IO\n";
    size_t len = strlen(msg);

    ssize_t ret = write(fd, msg, len);

    if (ret < 0)
    {
        perror("write");
        close(fd);
        return 1;
    }

    printf("本次写入字节数:%zd\n", ret);

    close(fd);

    return 0;
}
这个示例用于观察 write() 的基本接口。
如果要保证全部数据都写完,需要循环处理尚未写入的部分。
5.3 read函数
函数原型:
c
ssize_t read(int fd, void* buf, size_t count);返回值:
| 返回值 | 含义 |
|---|---|
> 0 |
实际读取的字节数 |
0 |
对普通文件通常表示到达文件末尾 |
-1 |
读取失败 |
例如:
c
char buffer[1024];

ssize_t n = read(fd, buffer, sizeof(buffer));
这里 buffer 是原始字节缓冲区,并不是一定以 '\0' 结尾的字符串。
因此,更推荐结合 write() 按实际长度输出:
c
write(STDOUT_FILENO, buffer, n);不过对于完整程序,还要处理 write() 的部分写入问题。
5.4 实现一个简化版cat
下面使用系统调用实现文件内容输出。
c
#include <stdio.h>
#include <errno.h>
#include <fcntl.h>
#include <unistd.h>

int WriteAll(int fd, const char* buf, size_t len)
{
    size_t written = 0;

    while (written < len)
    {
        ssize_t n = write(
            fd,
            buf + written,
            len - written
        );

        if (n < 0)
        {
            if (errno == EINTR)
                continue;

            return -1;
        }

        if (n == 0)
            return -1;

        written += (size_t)n;
    }

    return 0;
}

int main(int argc, char* argv[])
{
    if (argc != 2)
    {
        fprintf(stderr, "usage: %s file\n", argv[0]);
        return 1;
    }

    int fd = open(argv[1], O_RDONLY);

    if (fd < 0)
    {
        perror("open");
        return 1;
    }

    char buffer[1024];

    while (1)
    {
        ssize_t n = read(fd, buffer, sizeof(buffer));

        if (n > 0)
        {
            if (WriteAll(STDOUT_FILENO, buffer, (size_t)n) < 0)
            {
                perror("write");
                close(fd);
                return 1;
            }
        }
        else if (n == 0)
        {
            break;
        }
        else
        {
            if (errno == EINTR)
                continue;

            perror("read");
            close(fd);
            return 1;
        }
    }

    close(fd);

    return 0;
}
编译:
bash
gcc mycat.c -o mycat测试:
bash
./mycat log.txt这里的执行过程为:
text
open()
  |
  v
获取文件描述符
  |
  v
read()
  |
  v
读取文件字节
  |
  v
write(1, ...)
  |
  v
输出到标准输出
  |
  v
close()
注意,整个程序没有使用:
c
FILE* fp而是完全通过整数文件描述符完成 IO。
这就引出了一个问题:
这个整数究竟是如何代表文件的?
六、文件描述符fd到底是什么?
这是本篇文章最重要的部分之一。
6.1 Linux进程默认的三个文件描述符
一个正常启动的交互式程序,通常会继承三个标准文件描述符。
| 文件描述符 | 宏 | 通常的用途 |
|---|---|---|
| 0 | STDIN_FILENO |
标准输入 |
| 1 | STDOUT_FILENO |
标准输出 |
| 2 | STDERR_FILENO |
标准错误 |
这些宏在:
c
#include <unistd.h>中定义。
例如:
c
write(1, "hello\n", 6);等价于:
c
write(STDOUT_FILENO, "hello\n", 6);通常会把数据写入终端。
但需要注意:
文件描述符1并不天然等于显示器,它只是当前进程标准输出使用的描述符编号。
如果我们把编号1关联到一个磁盘文件,那么同样的 write(1, ...) 就会向文件写入。
这正是重定向的基础。
6.2 为什么默认有0、1、2?
当我们在 Shell 中启动一个外部程序时,新程序通常会继承 Shell 为它准备的标准输入、标准输出和标准错误。
在普通交互式终端中,可以将其理解为:
text
进程
 |
 +-- fd 0 ------> 终端输入
 |
 +-- fd 1 ------> 终端输出
 |
 +-- fd 2 ------> 终端错误输出
但这些描述符也可能指向:
text
文件
管道
Socket
伪终端
等对象。
因此:
text
fd 0、1、2代表标准流的编号约定,而不是与具体硬件永久绑定的关系。
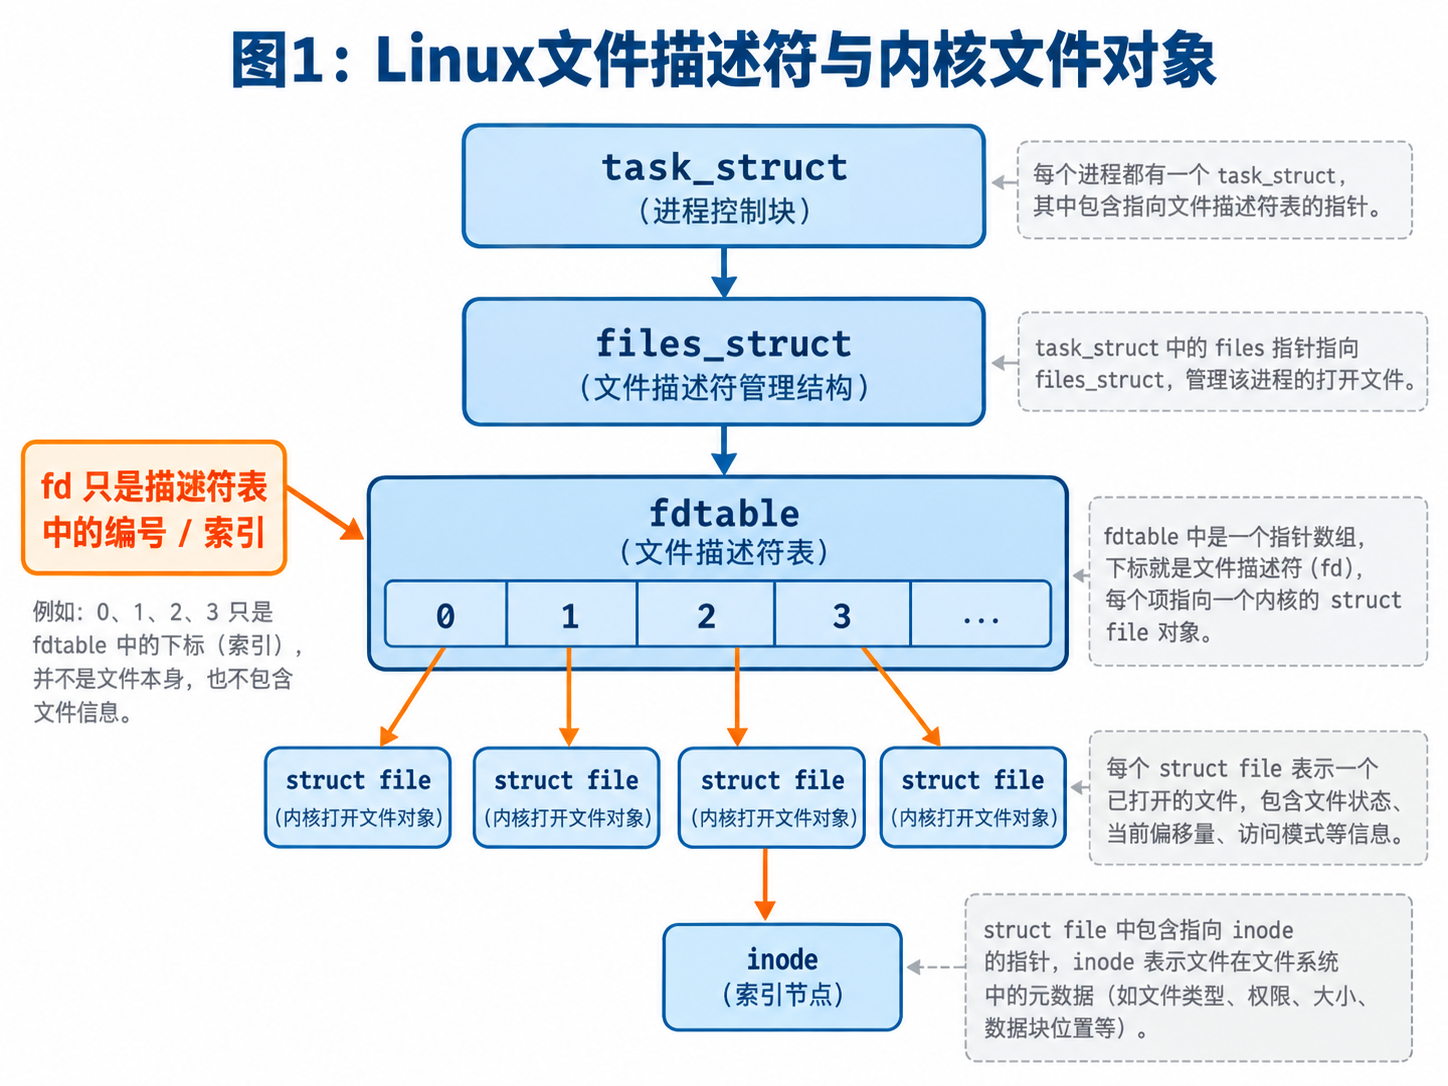
6.3 文件描述符的内核管理结构
前面我们学习进程管理时,知道 Linux 使用:
c
task_struct管理进程。
类似地,Linux 也需要维护进程打开的文件。
可以先建立一个简化模型:
text
进程task_struct
       |
       v
   files_struct
       |
       v
  文件描述符表
       |
       +-- fd 0 ------> 已打开文件对象A
       |
       +-- fd 1 ------> 已打开文件对象B
       |
       +-- fd 2 ------> 已打开文件对象C
       |
       +-- fd 3 ------> 已打开文件对象D
文件描述符表中的每个有效项,都用于引用一个内核打开文件对象。
在 Linux 内核中,常通过 struct file 描述一个打开文件实例。
对于普通文件,它还会与对应的 inode、文件系统操作等关联。
文件描述符本质上是当前进程文件描述符表中的一个编号。
因此,fd 并不是文件在磁盘上的地址,也不是 inode 编号。
6.4 为什么open返回整数?
考虑:
c
int fd = open("log.txt", O_RDONLY);操作系统需要完成:
- 根据路径定位文件。
- 检查访问权限。
- 建立或复用相关内核文件对象。
- 在当前进程文件描述符表中分配一个有效编号。
- 将编号返回给用户程序。
以后程序只需要:
c
read(fd, ...);就可以让内核定位对应的打开文件对象。
因此,用户程序无需知道底层 struct file 的内核地址。
七、文件描述符的分配规则
7.1 为什么第一次open通常返回3?
因为当前进程一般已经占用了:
text
0:标准输入
1:标准输出
2:标准错误
此时再调用:
c
open()通常就会得到:
text
3这是因为 Linux 会从允许使用的描述符编号中,选择当前尚未使用的最小编号。
7.2 验证文件描述符分配规则
c
#include <stdio.h>
#include <fcntl.h>
#include <unistd.h>

int main(void)
{
    int fd1 = open("a.txt", O_WRONLY | O_CREAT, 0644);
    int fd2 = open("b.txt", O_WRONLY | O_CREAT, 0644);

    if (fd1 < 0 || fd2 < 0)
    {
        perror("open");
        return 1;
    }

    printf("fd1 = %d\n", fd1);
    printf("fd2 = %d\n", fd2);

    close(fd1);

    int fd3 = open("c.txt", O_WRONLY | O_CREAT, 0644);

    printf("fd3 = %d\n", fd3);

    close(fd2);

    if (fd3 >= 0)
        close(fd3);

    return 0;
}
在标准描述符正常打开的典型情况下,输出:
text
fd1 = 3
fd2 = 4
fd3 = 3
因为:
text
第一次打开:
3被占用

第二次打开:
4被占用

关闭fd3号编号对应的描述符:
3变成空闲

第三次打开:
重新分配3
这里的"fd3号编号"不要和变量 fd3 混淆:我们关闭的是变量 fd1 保存的编号 3。
由此可以看出:
文件描述符编号可以被重复利用,它不代表某个文件的永久身份。
7.3 通过/proc查看文件描述符
运行:
bash
ls -l /proc/$$/fd或者在 C 程序中:
c
#include <stdio.h>
#include <unistd.h>

int main(void)
{
    printf("PID = %d\n", getpid());

    getchar();

    return 0;
}
运行程序后,在另一终端查看:
bash
ls -l /proc/对应PID/fd可能看到:
text
0 -> /dev/pts/0
1 -> /dev/pts/0
2 -> /dev/pts/0
这说明标准输入、标准输出和标准错误可以指向同一个终端设备。
但它们仍然是三个不同的文件描述符编号。
八、进一步认识内核打开文件对象
8.1 fd和文件对象不是一一对应的
前面的结构图可能让人误以为:
text
一个fd对应一个独立文件对象实际上,并不是所有情况都如此。
多个文件描述符可以引用同一个打开文件对象。
例如:
c
int fd1 = open("log.txt", O_WRONLY);
int fd2 = dup(fd1);
此时:
text
当前进程文件描述符表
          |
          +-- fd1 ----+
          |           |
          +-- fd2 ----+
                      |
                      v
                struct file
                      |
                      v
                   log.txt
两个 fd 指向同一个底层打开文件描述(open file description)。
这意味着它们会共享一些状态,例如:
- 当前文件偏移量。
- 文件状态标志,如
O_APPEND。
但描述符自身的某些标志(如 FD_CLOEXEC)仍然属于各自的文件描述符。
8.2 为什么这很重要?
因为后面的:
c
dup2()就是通过改变描述符引用关系完成重定向的。
因此我们必须区分:
text
文件描述符fd与:
text
内核打开文件对象fd 是当前进程持有的编号。
内核打开文件对象保存该次打开的状态,并关联真正的文件或其他 IO 对象。
九、重定向究竟是什么?
9.1 从一个最简单的问题开始
平时执行:
c
printf("hello world\n");数据一般输出到终端。
但是我们希望:
text
原本打印到终端的内容
             |
             v
         写入log.txt
一种直观的想法是:
text
修改printf,让它使用另外一个输出位置但这不是 Shell 重定向的核心实现思路。
真正关键的是:
让标准输出文件描述符1引用另一个打开文件对象。
这样程序不必改变自己的输出代码。
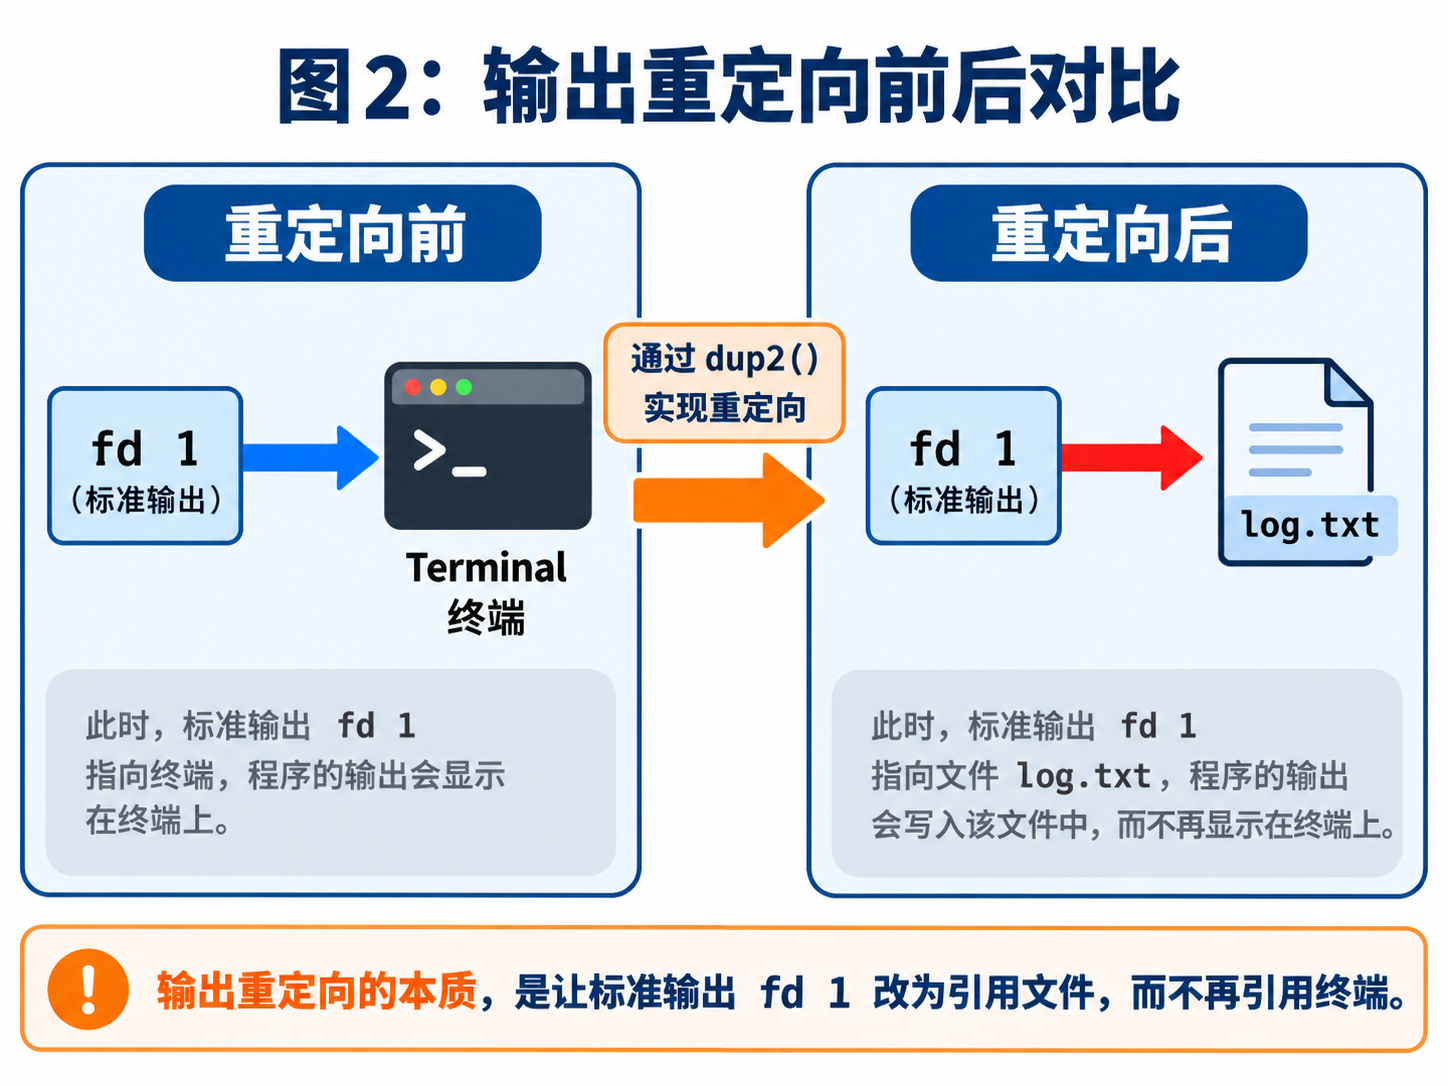
9.2 重定向之前
text
进程文件描述符表
       |
       +-- 0 ---> 终端输入
       |
       +-- 1 ---> 终端输出
       |
       +-- 2 ---> 终端错误输出
执行:
c
write(1, "hello\n", 6);数据输出到终端。
9.3 重定向之后
假设通过系统调用调整描述符关系:
text
进程文件描述符表
       |
       +-- 0 ---> 终端输入
       |
       +-- 1 ---> log.txt
       |
       +-- 2 ---> 终端错误输出
那么:
c
write(1, "hello\n", 6);就会写入 log.txt。
程序没有修改 write() 的参数。
变化的是:
text
fd 1所引用的对象所以:
重定向的本质,是修改文件描述符与打开文件对象之间的引用关系,而不是修改应用程序的输出语句。
十、通过关闭标准输出理解重定向
10.1 先看一个实验
c
#include <stdio.h>
#include <fcntl.h>
#include <unistd.h>

int main(void)
{
    close(STDOUT_FILENO);

    int fd = open(
        "log.txt",
        O_WRONLY | O_CREAT | O_TRUNC,
        0644
    );

    if (fd < 0)
    {
        perror("open");
        return 1;
    }

    printf("hello world\n");

    fflush(stdout);

    close(fd);

    return 0;
}
在标准输出原本有效、且没有其他描述符分配干扰的情况下:
c
close(1);释放了文件描述符1。
随后:
c
open()通常会优先使用空闲的编号1。
于是:
text
原来:

fd 1 ---> 终端


关闭之后:

fd 1 ---> 空闲


重新open之后:

fd 1 ---> log.txt
因此:
c
printf("hello world\n");会写入文件。
10.2 为什么要fflush(stdout)?
因为:
c
printf()属于标准库 IO 接口,可能先把数据放入用户态缓冲区。
如果在缓冲数据真正写出前关闭底层描述符,可能造成数据丢失或写入失败。
所以这个实验中显式执行:
c
fflush(stdout);确保标准 IO 缓冲数据被提交到底层文件描述符。
不过,实际开发中不应该依赖"先关闭1,再让open碰巧分配1"来实现重定向。
Linux 提供了更直接的接口:
c
dup2()十一、dup2:真正适合实现重定向的接口
11.1 函数原型
c
#include <unistd.h>

int dup2(int oldfd, int newfd);
可以理解为:
让
newfd引用与oldfd相同的打开文件对象。
参数:
| 参数 | 含义 |
|---|---|
oldfd |
已有的有效文件描述符 |
newfd |
希望使用的目标文件描述符 |
例如:
c
dup2(fd, STDOUT_FILENO);表示:
text
让标准输出fd 1
引用fd所指向的打开文件对象如果目标描述符原本已打开,dup2() 会在适当条件下原子地替换它的引用,不需要我们先手动 close(1)。
若 oldfd == newfd 且该描述符有效,则无需改变引用关系。
11.2 使用dup2实现输出重定向
c
#include <stdio.h>
#include <fcntl.h>
#include <unistd.h>

int main(void)
{
    int fd = open(
        "log.txt",
        O_WRONLY | O_CREAT | O_TRUNC,
        0644
    );

    if (fd < 0)
    {
        perror("open");
        return 1;
    }

    if (dup2(fd, STDOUT_FILENO) < 0)
    {
        perror("dup2");
        close(fd);
        return 1;
    }

    if (fd != STDOUT_FILENO)
    {
        close(fd);
    }

    printf("hello printf\n");

    write(
        STDOUT_FILENO,
        "hello write\n",
        sizeof("hello write\n") - 1
    );

    return 0;
}执行后,log.txt 中会出现两条输出。
但由于 printf() 可能经过标准 IO 缓冲,而 write() 不经过这个缓冲,两条内容的实际写出顺序未必与源代码顺序相同。
如果需要保证顺序,可以在 write() 前增加:
c
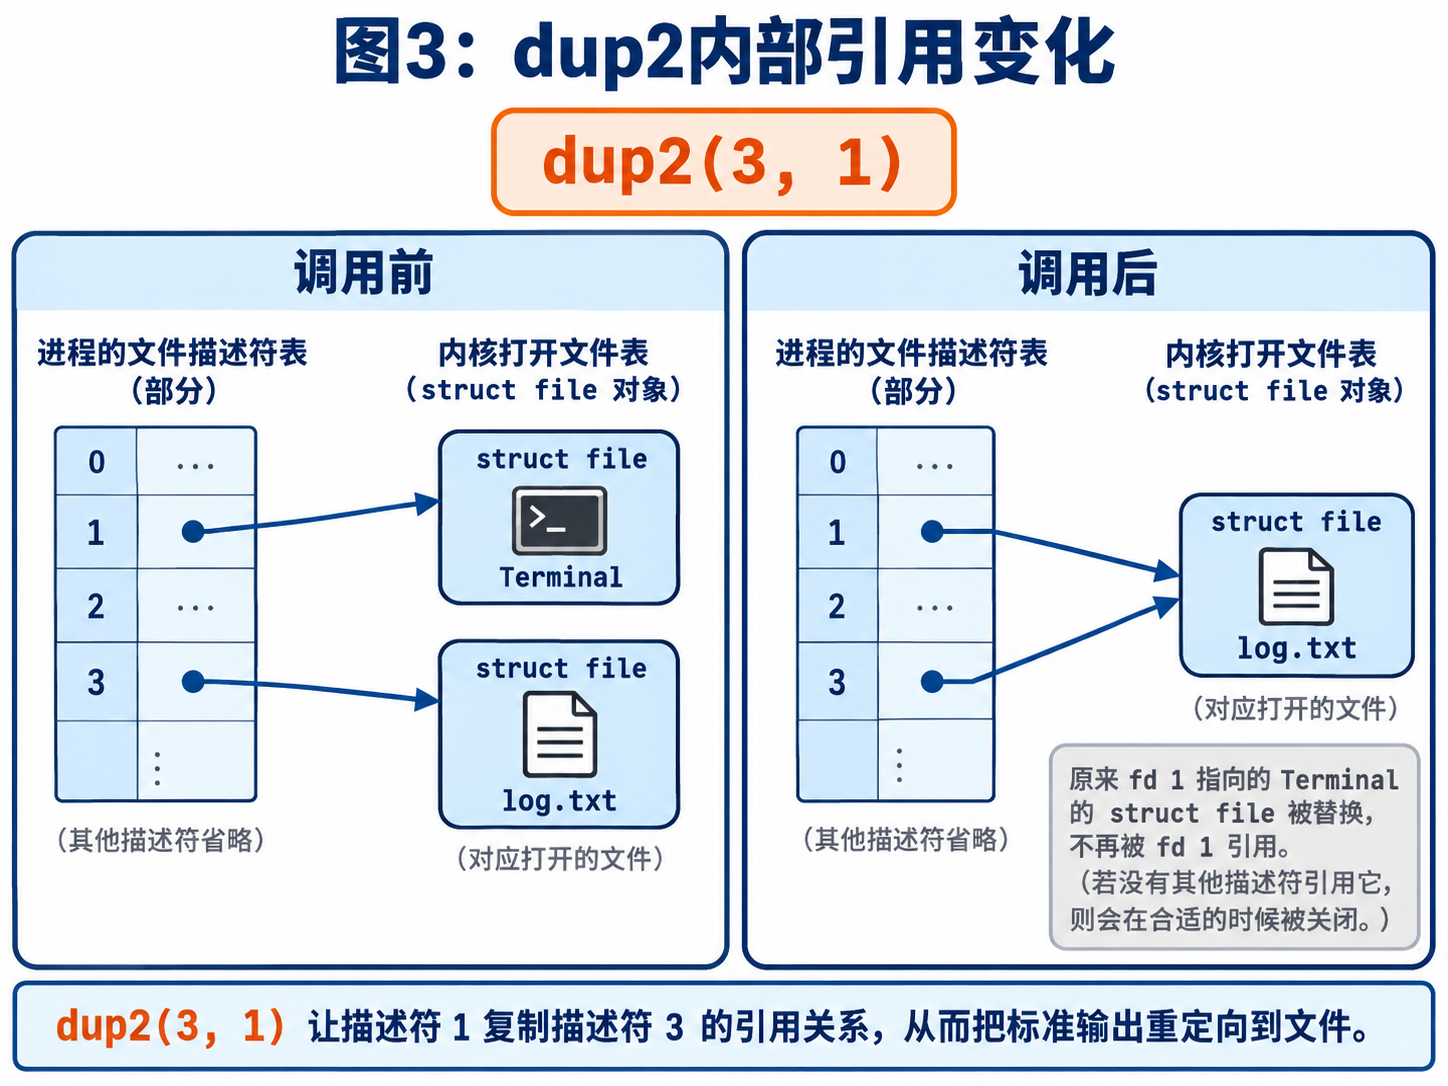
fflush(stdout);11.3 为什么dup2后还可以close(fd)?
假设:
text
fd = 3执行前:
text
fd 1 ---> 终端

fd 3 ---> log.txt
调用:
c
dup2(3, 1);执行后:
text
fd 1 ----+
         |
         v
       log.txt
         ^
         |
fd 3 ----+
随后:
c
close(3);结果:
text
fd 1 ---> log.txt因为 close(3) 只是关闭编号3的引用,不会把编号1一起关闭。
这里要牢记:
多个文件描述符可以引用同一个打开文件对象。
这也是 dup2() 的核心工作基础。
十二、理解Shell中三种常见重定向
12.1 输出重定向:>
例如:
bash
ls -l > log.txt作用:
text
将标准输出写入log.txt如果文件不存在,就创建文件。
如果文件已经存在,就截断原有内容。
对应的核心打开方式:
c
open(
    "log.txt",
    O_WRONLY | O_CREAT | O_TRUNC,
    0666
);
然后:
c
dup2(fd, STDOUT_FILENO);12.2 追加重定向:>>
例如:
bash
echo hello >> log.txt作用:
text
在文件末尾追加输出对应的打开方式:
c
open(
    "log.txt",
    O_WRONLY | O_CREAT | O_APPEND,
    0666
);
然后:
c
dup2(fd, STDOUT_FILENO);注意:
text
O_APPEND保证每次写入时以追加方式定位。
它并不是让程序自己先调用 lseek() 到文件末尾。
12.3 输入重定向:<
例如:
bash
cat < log.txt作用:
text
让cat从log.txt读取标准输入对应:
c
open("log.txt", O_RDONLY);然后:
c
dup2(fd, STDIN_FILENO);执行以后:
text
原来:

fd 0 ---> 终端输入


重定向后:

fd 0 ---> log.txt
cat 仍然可以从标准输入读取,但标准输入已经不再是键盘终端。
12.4 三种重定向的对应关系
| 符号 | 类型 | open标志 | dup2目标 |
|---|---|---|---|
> |
覆盖输出 | `O_WRONLY | O_CREAT |
>> |
追加输出 | `O_WRONLY | O_CREAT |
< |
输入 | O_RDONLY |
0 |
还有错误输出重定向:
bash
command 2> error.txt其目标文件描述符为:
text
2本文 MiniShell 升级先实现 <、>、>>,错误重定向留作进一步扩展。
十三、为什么重定向应该发生在exec之前?
回顾上一节的 MiniShell:
text
Shell
  |
  | fork()
  v
子进程
  |
  | execvp()
  v
新程序
现在需要加入:
text
重定向应该放在哪?
答案:
text
Shell
  |
  | fork()
  v
子进程
  |
  | open()
  v
dup2()
  |
  | execvp()
  v
新程序
原因是:
- 子进程先修改自己的文件描述符表。
execvp()替换程序映像。- 没有设置
FD_CLOEXEC的相关文件描述符通常继续保留。 - 新程序启动后,标准输入或标准输出已经指向新的对象。
例如:
text
子进程原来的fd 1
        |
        v
       终端
        |
        | dup2
        v
       文件
        |
        | exec
        v
     新程序ls
        |
        | write(1,...)
        v
       文件
新程序根本不需要知道是谁替它完成了重定向。
这就是 Unix/Linux 进程控制与文件描述符机制配合起来的一个经典设计。
十四、fd与FILE*究竟是什么关系?
接下来讨论本篇第二个重点。
14.1 为什么有了fd,还要FILE*?
我们已经可以使用:
c
write(fd, buffer, len);完成文件写入。
但 C 标准库还提供:
c
FILE* fp = fopen("log.txt", "w");
fprintf(fp, "hello\n");
这是因为标准库提供了更方便的文件流接口。
例如:
- 格式化输出。
- 按行读取。
- 标准 IO 缓冲。
- 文件流错误状态管理。
- 更方便的文本处理接口。
因此:
text
fd与:
text
FILE*位于不同的抽象层次。
14.2 fd是系统调用层的文件描述符
例如:
c
int fd = open("log.txt", O_WRONLY | O_CREAT, 0644);返回:
c
int类型的文件描述符。
然后:
c
write(fd, ...);通过它访问内核打开文件对象。
14.3 FILE*是标准库的文件流对象
例如:
c
FILE* fp = fopen("log.txt", "w");得到:
c
FILE*它指向 C 标准库维护的流对象。
流对象通常需要管理:
text
底层文件描述符
读缓冲区
写缓冲区
缓冲区当前位置
错误标志
EOF状态
其他流管理信息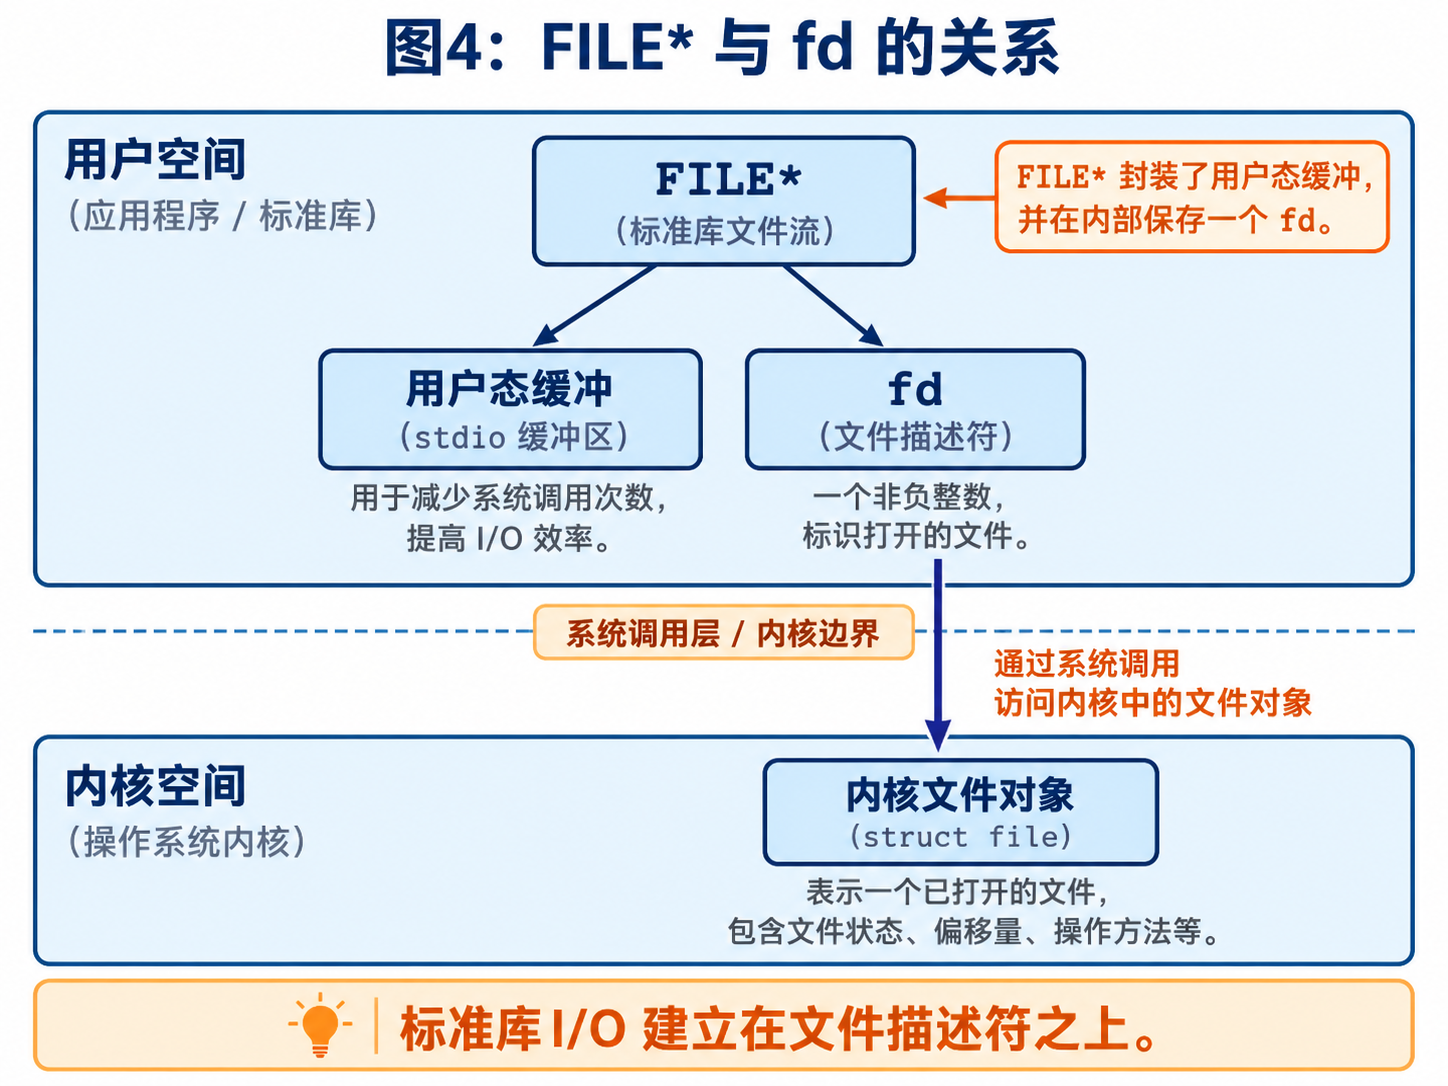
FILE*并不是fd的另一种写法,而是对底层IO能力的进一步封装。
14.4 为什么说FILE内部与fd有关?
因为在 Linux 上,典型的 C 标准库文件流最终需要通过底层文件描述符访问文件。
以 glibc 的实现为例,其文件流内部包含与底层文件描述符有关的成员。
但需要注意:
FILE 是标准库的抽象类型,具体结构布局并不是可移植的 C 语言接口。
不能依赖私有结构字段直接操作标准库内部实现。
十五、使用fileno与fdopen连接两层接口
15.1 fileno:从FILE*取得fd
POSIX 提供:
c
#include <stdio.h>

int fileno(FILE* stream);
例如:
c
#include <stdio.h>

int main(void)
{
    FILE* fp = fopen("log.txt", "w");

    if (fp == NULL)
    {
        perror("fopen");
        return 1;
    }

    int fd = fileno(fp);

    printf("fd = %d\n", fd);

    fclose(fp);

    return 0;
}
通过:
c
fileno(fp)可以获得文件流底层关联的文件描述符。
注意:
通过 fileno() 取得的fd属于对应文件流管理的一部分,不能随意在 fclose() 之前独立关闭它。
否则可能破坏文件流的正常工作。
15.2 fdopen:从已有fd构建FILE*
POSIX 还提供:
c
FILE* fdopen(int fd, const char* mode);例如:
c
#include <stdio.h>
#include <fcntl.h>
#include <unistd.h>

int main(void)
{
    int fd = open(
        "log.txt",
        O_WRONLY | O_CREAT | O_TRUNC,
        0644
    );

    if (fd < 0)
    {
        perror("open");
        return 1;
    }

    FILE* fp = fdopen(fd, "w");

    if (fp == NULL)
    {
        perror("fdopen");
        close(fd);
        return 1;
    }

    fprintf(fp, "hello from fdopen\n");

    fclose(fp);

    return 0;
}
这里:
c
fdopen()并不是重新打开一次文件,而是在已有文件描述符上创建文件流。
成功以后,文件流负责管理该描述符;执行:
c
fclose(fp);通常也会关闭相应的底层fd。
因此不应该再无条件调用:
c
close(fd);否则可能发生重复关闭,甚至误关闭后来复用同一编号的其他文件。
15.3 fd与FILE*对比
| 对比项 | fd | FILE* |
|---|---|---|
| 类型 | 整数 | 文件流指针 |
| 抽象层次 | 内核文件描述符接口 | C标准库文件流接口 |
| 常见创建方式 | open() |
fopen() |
| 读取接口 | read() |
fread()、fgets() |
| 写入接口 | write() |
fwrite()、fprintf() |
| 关闭接口 | close() |
fclose() |
| 标准IO缓冲 | 不经过C stdio缓冲 | 通常具有标准IO缓冲 |
| 格式化输出 | 需要自行处理 | 可直接使用 fprintf() |
这里需要强调:
write() 不经过用户态的 C 标准IO缓冲,但仍然可能涉及内核中的文件缓存。
这一点是接下来理解缓冲区的关键。
十六、为什么需要缓冲区?
16.1 每输出一个字符都进行系统调用会怎样?
假设我们要输出:
text
hello world如果每个字符都单独调用一次:
c
write()就会产生多次用户态和内核态之间的交互。
系统调用涉及一定的固定开销。
因此:
text
每次写入1字节通常没有:
text
把多个字节合并成一次写入高效。
于是便产生了缓冲区的设计。
16.2 什么是缓冲区?
缓冲区本质上是一块临时保存数据的内存区域。
例如:
text
程序产生数据
      |
      v
先放入缓冲区
      |
      | 累积到一定条件
      v
批量写出
它的主要目的之一是:
减少频繁的小规模IO操作,提高整体效率。
但 Linux 文件 IO 中的缓冲并不只有一种。
必须分清:
- 用户态标准IO缓冲。
- 内核文件页缓存等机制。
十七、用户态标准IO缓冲
17.1 printf并不一定立即调用write
例如:
c
printf("hello");并不意味着这行语句执行时,操作系统就一定立刻收到一次 write() 调用。
标准库可能先执行:
text
printf()
   |
   v
格式化数据
   |
   v
写入stdout的用户态缓冲区
   |
   v
满足刷新条件
   |
   v
调用底层write()
所以:
c
printf()与:
c
write()在缓冲行为上存在重要区别。
17.2 标准IO的三种常见缓冲方式
17.2.1 全缓冲
全缓冲的特点是:
text
通常等待缓冲区填满
或者发生显式刷新等情况
再写出数据
普通磁盘文件的标准IO流通常使用全缓冲。
例如:
c
FILE* fp = fopen("log.txt", "w");

fprintf(fp, "hello");
此时数据可能暂时留在用户态缓冲中。
17.2.2 行缓冲
行缓冲通常在输出换行符等条件下触发刷新。
例如,当 stdout 连接到交互式终端时,常采用行缓冲。
c
printf("hello\n");通常可以较及时地显示到终端。
但要注意:
换行并不是所有输出场景中的无条件刷新规则。
如果 stdout 被重定向到普通文件,其缓冲策略往往不同。
17.2.3 无缓冲
无缓冲表示标准IO库不采用通常意义上的数据累积缓冲方式。
标准错误流:
c
stderr通常是不缓冲的,以便错误信息能够及时出现。
例如:
c
fprintf(stderr, "error\n");通常比全缓冲输出更及时。
但"无缓冲"不等于直接越过内核缓存写入物理设备。
17.3 fflush到底做了什么?
函数原型:
c
int fflush(FILE* stream);例如:
c
printf("hello");

fflush(stdout);
作用是:
请求标准库把该输出流中尚未提交的用户态缓冲数据写向底层输出对象。
注意:
text
fflush解决的是标准IO流缓冲问题。
它并不等价于保证数据已经持久写入磁盘。
十八、内核文件缓冲与Page Cache
这是本篇文章需要重点补充的另一部分。
18.1 为什么write返回成功不代表数据已经到达磁盘?
假设调用:
c
write(fd, "hello", 5);成功返回:
text
5这表示操作系统接受了本次写入的5个字节。
但对于普通文件的常规缓冲IO,数据可能首先进入:
text
内核页缓存(Page Cache)而不是立刻写入持久存储设备。
简化过程如下:
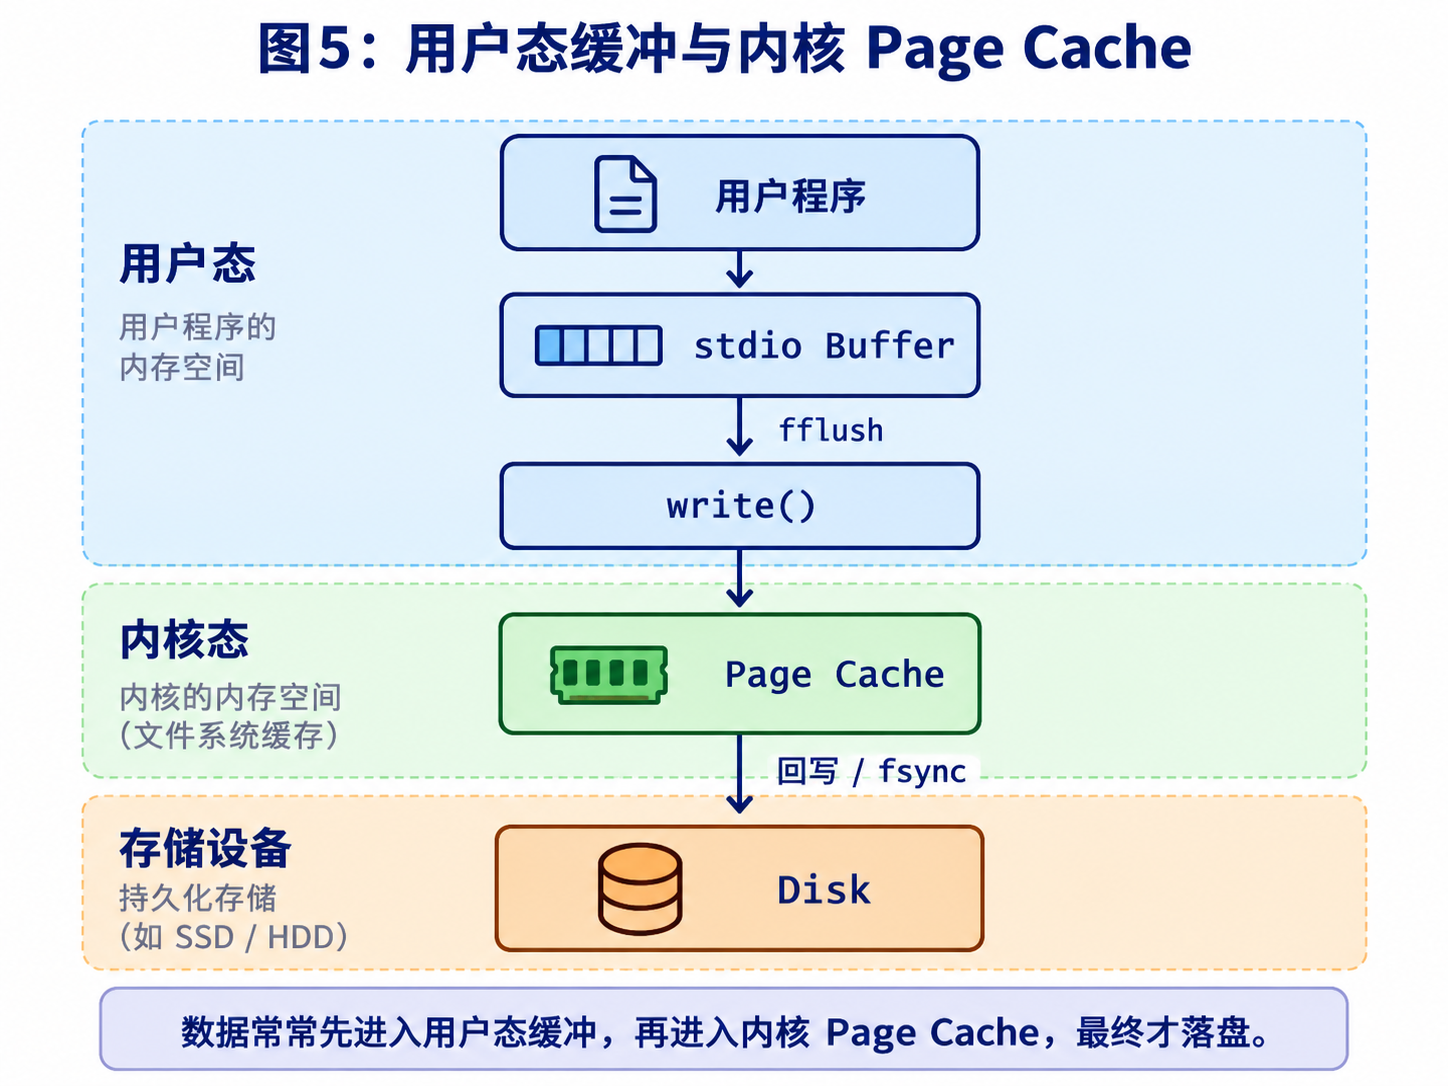
因此:
text
write返回成功通常只意味着:
text
本次写入已被内核接受不等于:
text
已经完成持久化18.2 为什么内核还要缓存文件数据?
主要是为了:
- 减少反复访问存储设备的次数。
- 合并或延迟部分写入操作。
- 提高文件读取命中率。
- 改善系统整体吞吐量。
例如第一次读取某个文件时,内核可能需要从存储设备读取数据。
如果数据仍然保留在页缓存中,后续读取就可能不必再次访问磁盘。
18.3 文件写入可能经过几层缓冲?
对于:
c
fprintf(fp, "hello");典型路径是:
text
应用程序
    |
    v
C标准库用户态缓冲
    |
    | fflush或其他刷新条件
    v
write系统调用
    |
    v
内核Page Cache
    |
    | 回写
    v
存储设备
可以把它概括为:
text
两类不同层次的缓存机制第一类:
text
用户态标准IO缓冲第二类:
text
内核文件页缓存前者主要由标准库管理。
后者由操作系统内核及其文件系统相关机制管理。
18.4 fflush和fsync有什么区别?
fflush
c
fflush(fp);主要用于刷新标准IO的用户态输出缓冲。
fsync
c
fsync(fd);请求内核同步与该文件相关的必要数据和元数据,使其达到接口规定的持久化要求。
二者作用的层次不同:
text
fflush
  |
  v
标准库缓冲区
      -> 内核


fsync
  |
  v
内核缓存中的相关文件数据
      -> 持久化存储同步
如果使用的是:
c
FILE* fp并希望在正常条件下完成文件数据同步,通常需要先:
c
fflush(fp);然后:
c
fsync(fileno(fp));当然,fsync() 仍然需要检查返回值,实际持久化保障还与文件系统和底层设备的正确实现有关。
18.5 为什么close也不能简单等同于fsync?
c
close(fd);主要作用是关闭当前进程持有的文件描述符。
它不等价于:
c
fsync(fd);因此不能认为:
text
close成功就绝对说明:
text
数据已安全持久写入磁盘对于数据库、事务日志等对数据持久性有严格要求的程序,必须认真设计同步策略。
十九、用fork实验理解用户态缓冲区
19.1 实验代码
c
#include <stdio.h>
#include <string.h>
#include <unistd.h>
#include <sys/wait.h>

int main(void)
{
    printf("hello printf\n");

    const char* msg = "hello fwrite\n";

    fwrite(msg, 1, strlen(msg), stdout);

    const char* raw = "hello write\n";

    write(
        STDOUT_FILENO,
        raw,
        strlen(raw)
    );

    pid_t pid = fork();

    if (pid < 0)
    {
        perror("fork");
        return 1;
    }

    if (pid > 0)
    {
        waitpid(pid, NULL, 0);
    }

    return 0;
}
编译:
bash
gcc buffer.c -o buffer19.2 直接在终端执行
bash
./buffer典型情况下:
text
hello printf
hello fwrite
hello write
因为 stdout 连接终端时通常是行缓冲。
带换行符的 printf() 和 fwrite() 输出通常会在 fork() 前被刷新。
19.3 使用输出重定向
bash
./buffer > result.txt然后:
bash
cat result.txt在常见的 glibc 行为下,可能看到:
text
hello write
hello printf
hello fwrite
hello printf
hello fwrite
为什么?
第一:printf和fwrite可能仍在用户态缓冲区
当标准输出指向普通文件时,标准IO通常采用全缓冲。
所以:
c
printf(...)和:
c
fwrite(...)的数据可能尚未交给底层 write()。
第二:fork复制了父进程的用户态执行状态
调用:
c
fork();时,子进程得到父进程当时的用户态内存视图。
因此未刷新的标准IO缓冲内容也会出现在父子进程各自的内存视图中。
第三:父子进程都正常退出
如果两者最后都按正常标准库退出流程结束,各自可能刷新那份缓冲数据。
因此:
text
printf内容和:
text
fwrite内容可能各自出现两次。
19.4 为什么write只出现一次?
因为:
c
write()不经过 C 标准IO的用户态缓冲区。
调用成功后,这次写入已经进入内核相应的IO处理流程。
后面的:
c
fork()不会让已经完成的那次 write() 系统调用重新执行。
因此只出现一次。
这里不能进一步推导出:
text
write没有任何缓冲因为内核仍可能使用 Page Cache。
正确的结论是:
write不经过C标准IO用户态缓冲,但可能经过内核文件缓存。
19.5 如何避免fork造成标准IO缓冲重复输出?
在 fork() 之前:
c
fflush(stdout);例如:
c
printf("hello\n");

fflush(stdout);

fork();
这样就可以避免父子进程分别继承同一份未刷新的标准输出缓冲数据。
这也是为什么我们之前的 MiniShell 在调用 fork() 前,会使用:
cpp
cout.flush();刷新已经准备好的提示信息。
二十、升级我们的MiniShell:增加重定向功能
前面已经掌握:
text
fd
dup2
open
close
现在可以真正升级之前实现的 MiniShell。
这里不重新设计一套 Shell,而是在已有的 C++11 框架上扩展。
20.1 回顾原来的MiniShell
我们之前的主要函数:
cpp
PrintPrompt()
ReadCommandLine()
ParseCommandLine()
IsBuiltin()
ExecuteBuiltin()
BuildArgv()
WaitForChild()
ExecuteExternal()
RunShell()
原来的核心过程:
text
读取命令
    |
    v
解析参数
    |
    v
判断内建命令
    |
    +-- 内建命令
    |      |
    |      v
    |   ExecuteBuiltin()
    |
    +-- 外部命令
           |
           v
        fork()
           |
           v
        execvp()
           |
           v
        waitpid()
现在需要增加:
text
识别重定向符号以及:
text
在执行命令前修改标准文件描述符20.2 参考课件的实现思路
课件采用的核心方式是:
text
读取命令
    |
    v
解析重定向符号
    |
    v
分离命令和文件名
    |
    v
创建子进程
    |
    v
在子进程中DoRedir()
    |
    v
exec执行外部程序
其中:
c
DoRedir()本质上就是根据重定向类型选择:
c
open()的参数,再调用:
c
dup2()修改对应文件描述符。
我们保留这个思想,同时结合自己的 vector<string>、ShellContext 和 ExecuteExternal() 设计进行改进。
20.3 为什么不能直接复制课件的MiniShell?
课件中主要使用:
c
char* gargv[]和全局变量记录:
text
重定向类型
重定向文件名
而我们的实现使用:
cpp
vector<string>以及:
cpp
ShellContext保存 Shell 状态。
为了保持结构清晰,我们使用一个结构体保存命令信息:
cpp
struct CommandInfo
{
    vector<string> args;
    RedirInfo redir;
};
这样一条命令可以同时包含:
text
真正要执行的程序及参数和:
text
重定向要求二十一、重新设计命令解析结构
21.1 定义重定向类型
cpp
enum class RedirType
{
    None,
    Input,
    Output,
    Append
};
分别表示:
text
None   :没有重定向
Input  :<
Output :>
Append :>>
然后:
cpp
struct RedirInfo
{
    RedirType type = RedirType::None;

    string filename;
};
例如:
bash
ls -l > log.txt解析以后:
text
type = Output

filename = "log.txt"
21.2 使用CommandInfo保存一整条命令
cpp
struct CommandInfo
{
    vector<string> args;

    RedirInfo redir;
};
例如:
bash
ls -l > log.txt应该得到:
text
args[0] = "ls"
args[1] = "-l"

redir.type = Output
redir.filename = "log.txt"
注意:
text
>
log.txt
不是传给 ls 的普通命令参数。
所以:
cpp
execvp()最终只应该接收:
text
ls
-l
两个字符串。
21.3 为什么先解析重定向,再解析命令?
例如:
text
ls -l > log.txt如果先按照空格全部分割:
text
"ls"
"-l"
">"
"log.txt"
再直接传给:
c
execvp()那么 ls 并不会自动理解 Shell 的重定向语法。
> 属于 Shell 解释器需要处理的控制符号。
因此正确顺序是:
text
原始输入
    |
    v
识别重定向符号
    |
    v
提取重定向文件名
    |
    v
去除重定向部分
    |
    v
解析真正的命令参数
例如:
text
原始:

"ls -l > log.txt"


解析重定向:

命令部分:"ls -l"

文件部分:"log.txt"


解析命令:

args = {"ls", "-l"}
二十二、如何实现ParseRedirection?
22.1 先限定作业范围
为了便于理解,我们暂时只支持:
bash
ls > file.txt
ls >> file.txt
cat < file.txt
echo hello>file.txt
不支持:
bash
command 2> error.txt
command > a.txt 2> b.txt
command < in.txt > out.txt
也暂时不支持:
text
引号
转义符
管道
命令替换
为了与课件保持一致,这里采用从命令右侧查找重定向符号的方式。
22.2 实现思路
例如:
text
echo hello >> log.txt从右向左检查重定向符号:
text
echo hello >> log.txt
           ^^
           ||
         追加符号
然后:
text
左侧:
echo hello

右侧:
log.txt
需要特别区分:
text
>和:
text
>>因为两个符号对应的打开方式不同。
二十三、实现ApplyRedirection()
这是本次 MiniShell 升级最核心的新函数。
23.1 函数职责
cpp
int ApplyRedirection(const RedirInfo& redir);只负责:
- 判断重定向类型。
- 打开目标文件。
- 调用
dup2()修改标准文件描述符。 - 关闭不再需要的原始描述符。
它不负责:
text
创建子进程
执行程序
等待子进程
这样每个函数职责更加明确。
23.2 三种情况
输入重定向
cpp
fd = open(filename, O_RDONLY);

dup2(fd, STDIN_FILENO);
覆盖输出重定向
cpp
fd = open(
    filename,
    O_WRONLY | O_CREAT | O_TRUNC,
    0666
);

dup2(fd, STDOUT_FILENO);
追加输出重定向
cpp
fd = open(
    filename,
    O_WRONLY | O_CREAT | O_APPEND,
    0666
);

dup2(fd, STDOUT_FILENO);
执行完成后,需要关闭已经不再需要的原始 fd。
但如果 open() 返回的就是目标编号,则不应该错误地把它关掉。
二十四、一个重要问题:内建命令如何重定向?
这是我们自己的 MiniShell 与课件基础实现之间需要特别处理的差异。
24.1 外部命令可以在子进程中重定向
例如:
bash
ls > log.txt执行过程:
text
Shell
  |
  v
fork()
  |
  v
Child
  |
  v
ApplyRedirection()
  |
  v
execvp("ls", ...)
  |
  v
ls把输出写入log.txt
父进程 Shell 自身的文件描述符没有被修改。
这是非常理想的情况。
24.2 但是我们的echo是内建命令
前面我们自己实现过:
cpp
if (args[0] == "echo")
{
    cout << ...;
}
它并不会执行:
c
execvp()而是在 Shell 进程内部直接运行。
如果我们只为外部命令增加重定向,就会出现:
bash
echo hello > log.txt无法正确重定向的问题。
因为:
text
echo并没有进入负责调用 ApplyRedirection() 的子进程分支。
24.3 解决方式:临时重定向,再恢复
对于内建命令:
text
保存Shell当前stdout
       |
       v
将stdout重定向到文件
       |
       v
执行内建echo
       |
       v
刷新输出缓冲区
       |
       v
恢复Shell原来的stdout
例如:
cpp
int saved = dup(STDOUT_FILENO);先备份原来的标准输出。
然后:
cpp
dup2(fd, STDOUT_FILENO);执行内建命令。
最后:
cpp
dup2(saved, STDOUT_FILENO);恢复标准输出。
为什么一定要恢复?
因为如果不恢复:
text
Shell自己的命令提示符也可能被写入文件中。
这也是为什么重定向时必须注意:
哪些修改应该只作用于子进程,哪些修改会作用于Shell自身。
二十五、MiniShell增加重定向后的完整代码
下面基于我们之前的 C++11 MiniShell 进行整合。
保留原来的:
cpp
PrintPrompt
ReadCommandLine
ParseCommandLine
IsBuiltin
ExecuteBuiltin
BuildArgv
WaitForChild
ExecuteExternal
RunShell
新增:
cpp
Trim
ParseRedirection
ApplyRedirection
ExecuteBuiltinWithRedirection
这样既保持之前的学习成果,又实现了课件提出的重定向功能。
25.1 完整源码:myshell.cpp
cpp
#include <iostream>
#include <string>
#include <vector>
#include <sstream>
#include <cstdlib>
#include <cerrno>
#include <cctype>
#include <cstdio>

#include <unistd.h>
#include <fcntl.h>
#include <sys/types.h>
#include <sys/wait.h>

using namespace std;

// ====================================================
// 1. Shell运行状态
// ====================================================

struct ShellContext
{
    int last_status = 0;
    bool running = true;
};

// ====================================================
// 2. 重定向相关数据结构
// ====================================================

enum class RedirType
{
    None,
    Input,
    Output,
    Append
};

struct RedirInfo
{
    RedirType type = RedirType::None;
    string filename;
};

struct CommandInfo
{
    vector<string> args;
    RedirInfo redir;
};

// ====================================================
// 3. 显示Shell提示符
// ====================================================

void PrintPrompt()
{
    char path[1024];

    if (getcwd(path, sizeof(path)))
    {
        cout << "[" << path << "]$ " << flush;
    }
    else
    {
        cout << "myshell$ " << flush;
    }
}

// ====================================================
// 4. 读取用户输入
// ====================================================

bool ReadCommandLine(string& line)
{
    return static_cast<bool>(getline(cin, line));
}

// ====================================================
// 5. 去除字符串两端空白
// ====================================================

string Trim(const string& s)
{
    size_t begin = 0;
    size_t end = s.size();

    while (begin < end &&
           isspace(static_cast<unsigned char>(s[begin])))
    {
        ++begin;
    }

    while (end > begin &&
           isspace(static_cast<unsigned char>(s[end - 1])))
    {
        --end;
    }

    return s.substr(begin, end - begin);
}

// ====================================================
// 6. 解析普通命令参数
// ====================================================

vector<string> ParseCommandLine(const string& command)
{
    vector<string> args;

    istringstream iss(command);
    string arg;

    while (iss >> arg)
    {
        args.push_back(arg);
    }

    return args;
}

// ====================================================
// 7. 解析重定向信息
// ====================================================

bool ParseRedirection(
    const string& raw,
    CommandInfo& cmd,
    string& error)
{
    string command = Trim(raw);

    // 从右侧寻找重定向符号
    size_t pos = command.find_last_of("<>");

    // 没有重定向
    if (pos == string::npos)
    {
        cmd.args = ParseCommandLine(command);
        return true;
    }

    size_t op_begin = pos;

    // 输入重定向
    if (command[pos] == '<')
    {
        cmd.redir.type = RedirType::Input;
    }
    // 追加重定向
    else if (pos > 0 && command[pos - 1] == '>')
    {
        cmd.redir.type = RedirType::Append;
        op_begin = pos - 1;
    }
    // 普通输出重定向
    else
    {
        cmd.redir.type = RedirType::Output;
    }

    // 提取命令部分
    string left = Trim(command.substr(0, op_begin));

    // 提取文件名部分
    string right = Trim(command.substr(pos + 1));

    // 教学版只支持一个重定向
    if (left.empty() ||
        right.empty() ||
        left.find_first_of("<>") != string::npos)
    {
        error = "命令或重定向文件名缺失,或存在多个重定向符";
        return false;
    }

    istringstream iss(right);
    string extra;

    // 暂时不支持包含空格的文件名
    if (!(iss >> cmd.redir.filename) || (iss >> extra))
    {
        error = "教学版暂不支持含空格的文件名";
        return false;
    }

    // 再解析真正的命令参数
    cmd.args = ParseCommandLine(left);

    return true;
}

// ====================================================
// 8. 判断是否为内建命令
// ====================================================

bool IsBuiltin(const string& name)
{
    return name == "cd" ||
           name == "exit" ||
           name == "export" ||
           name == "echo";
}

// ====================================================
// 9. 执行Shell内建命令
// ====================================================

int ExecuteBuiltin(
    const vector<string>& args,
    ShellContext& context)
{
    // exit
    if (args[0] == "exit")
    {
        if (args.size() != 1)
        {
            cerr << "usage: exit\n";
            return 2;
        }

        context.running = false;

        return context.last_status;
    }

    // cd
    if (args[0] == "cd")
    {
        if (args.size() > 2)
        {
            cerr << "usage: cd [directory]\n";
            return 2;
        }

        const char* path =
            args.size() == 1
                ? getenv("HOME")
                : args[1].c_str();

        if (!path)
        {
            cerr << "cd: HOME not set\n";
            return 1;
        }

        if (chdir(path) < 0)
        {
            perror("cd");
            return 1;
        }

        return 0;
    }

    // export
    if (args[0] == "export")
    {
        if (args.size() != 2)
        {
            cerr << "usage: export NAME=VALUE\n";
            return 2;
        }

        size_t pos = args[1].find('=');

        if (pos == string::npos || pos == 0)
        {
            cerr << "export: invalid assignment\n";
            return 2;
        }

        string name = args[1].substr(0, pos);
        string value = args[1].substr(pos + 1);

        if (setenv(name.c_str(), value.c_str(), 1) < 0)
        {
            perror("export");
            return 1;
        }

        return 0;
    }

    // echo
    if (args[0] == "echo")
    {
        for (size_t i = 1; i < args.size(); ++i)
        {
            if (i > 1)
            {
                cout << ' ';
            }

            // 上一条命令的退出状态
            if (args[i] == "$?")
            {
                cout << context.last_status;
            }
            // 环境变量
            else if (!args[i].empty() && args[i][0] == '$')
            {
                const char* value =
                    getenv(args[i].substr(1).c_str());

                if (value)
                {
                    cout << value;
                }
            }
            // 普通字符串
            else
            {
                cout << args[i];
            }
        }

        cout << '\n';

        return 0;
    }

    return 1;
}

// ====================================================
// 10. 构建execvp需要的argv
// ====================================================

vector<char*> BuildArgv(const vector<string>& args)
{
    vector<char*> argv;

    for (const string& arg : args)
    {
        argv.push_back(
            const_cast<char*>(arg.c_str())
        );
    }

    argv.push_back(nullptr);

    return argv;
}

// ====================================================
// 11. 执行重定向(核心新增函数)
// ====================================================

int ApplyRedirection(const RedirInfo& redir)
{
    if (redir.type == RedirType::None)
    {
        return 0;
    }

    int target =
        redir.type == RedirType::Input
            ? STDIN_FILENO
            : STDOUT_FILENO;

    int fd = -1;

    // 输入重定向 <
    if (redir.type == RedirType::Input)
    {
        fd = open(
            redir.filename.c_str(),
            O_RDONLY
        );
    }
    // 覆盖输出重定向 >
    else if (redir.type == RedirType::Output)
    {
        fd = open(
            redir.filename.c_str(),
            O_WRONLY | O_CREAT | O_TRUNC,
            0666
        );
    }
    // 追加输出重定向 >>
    else
    {
        fd = open(
            redir.filename.c_str(),
            O_WRONLY | O_CREAT | O_APPEND,
            0666
        );
    }

    if (fd < 0)
    {
        perror("open");
        return -1;
    }

    // 将打开的文件关联到目标标准描述符
    if (dup2(fd, target) < 0)
    {
        perror("dup2");
        close(fd);
        return -1;
    }

    // dup2成功后,不再需要额外的描述符
    // 但如果fd本来就等于target,不能关闭它
    if (fd != target)
    {
        close(fd);
    }

    return 0;
}

// ====================================================
// 12. 等待子进程
// ====================================================

int WaitForChild(pid_t pid)
{
    int status = 0;
    pid_t ret;

    do
    {
        ret = waitpid(pid, &status, 0);
    }
    while (ret < 0 && errno == EINTR);

    if (ret < 0)
    {
        perror("waitpid");
        return 1;
    }

    if (WIFEXITED(status))
    {
        return WEXITSTATUS(status);
    }

    if (WIFSIGNALED(status))
    {
        return 128 + WTERMSIG(status);
    }

    return 1;
}

// ====================================================
// 13. 执行外部命令
// ====================================================

int ExecuteExternal(const CommandInfo& cmd)
{
    vector<char*> argv = BuildArgv(cmd.args);

    // fork前刷新Shell自身的输出缓冲
    cout.flush();
    cerr.flush();

    pid_t pid = fork();

    if (pid < 0)
    {
        perror("fork");
        return 1;
    }

    if (pid == 0)
    {
        // 子进程先完成重定向
        if (ApplyRedirection(cmd.redir) < 0)
        {
            _exit(1);
        }

        // 再替换程序映像
        execvp(argv[0], argv.data());

        // 只有execvp失败才会运行到这里
        int err = errno;

        perror("execvp");

        _exit(
            (err == ENOENT || err == ENOTDIR)
                ? 127
                : 126
        );
    }

    // 父进程等待子进程
    return WaitForChild(pid);
}

// ====================================================
// 14. 执行带重定向的内建命令
// ====================================================

int ExecuteBuiltinWithRedirection(
    const CommandInfo& cmd,
    ShellContext& context)
{
    // 如果没有重定向,直接执行
    if (cmd.redir.type == RedirType::None)
    {
        return ExecuteBuiltin(cmd.args, context);
    }

    // 根据重定向类型判断目标描述符
    const int target =
        cmd.redir.type == RedirType::Input
            ? STDIN_FILENO
            : STDOUT_FILENO;

    // 修改描述符前先刷新已有输出
    cout.flush();
    cerr.flush();
    fflush(stdout);

    // 备份Shell原来的标准描述符
    int saved = dup(target);

    if (saved < 0)
    {
        perror("dup");
        return 1;
    }

    // 临时修改Shell自身的描述符
    if (ApplyRedirection(cmd.redir) < 0)
    {
        close(saved);
        return 1;
    }

    // 执行内建命令
    int result = ExecuteBuiltin(cmd.args, context);

    // 恢复前先刷新内建命令输出
    cout.flush();
    fflush(stdout);

    // 恢复Shell原来的标准描述符
    if (dup2(saved, target) < 0)
    {
        perror("restore dup2");
        result = 1;
    }

    close(saved);

    return result;
}

// ====================================================
// 15. Shell主循环
// ====================================================

void RunShell()
{
    ShellContext context;

    while (context.running)
    {
        PrintPrompt();

        string raw;

        if (!ReadCommandLine(raw))
        {
            cout << '\n';
            break;
        }

        CommandInfo cmd;
        string error;

        // 先解析重定向,再解析命令
        if (!ParseRedirection(raw, cmd, error))
        {
            cerr << "myshell: " << error << '\n';

            context.last_status = 2;

            continue;
        }

        if (cmd.args.empty())
        {
            continue;
        }

        // 内建命令
        if (IsBuiltin(cmd.args[0]))
        {
            context.last_status =
                ExecuteBuiltinWithRedirection(
                    cmd,
                    context
                );
        }
        // 外部命令
        else
        {
            context.last_status =
                ExecuteExternal(cmd);
        }
    }
}

// ====================================================
// 16. 程序入口
// ====================================================

int main()
{
    RunShell();

    return 0;
}
二十六、分析新MiniShell的执行过程
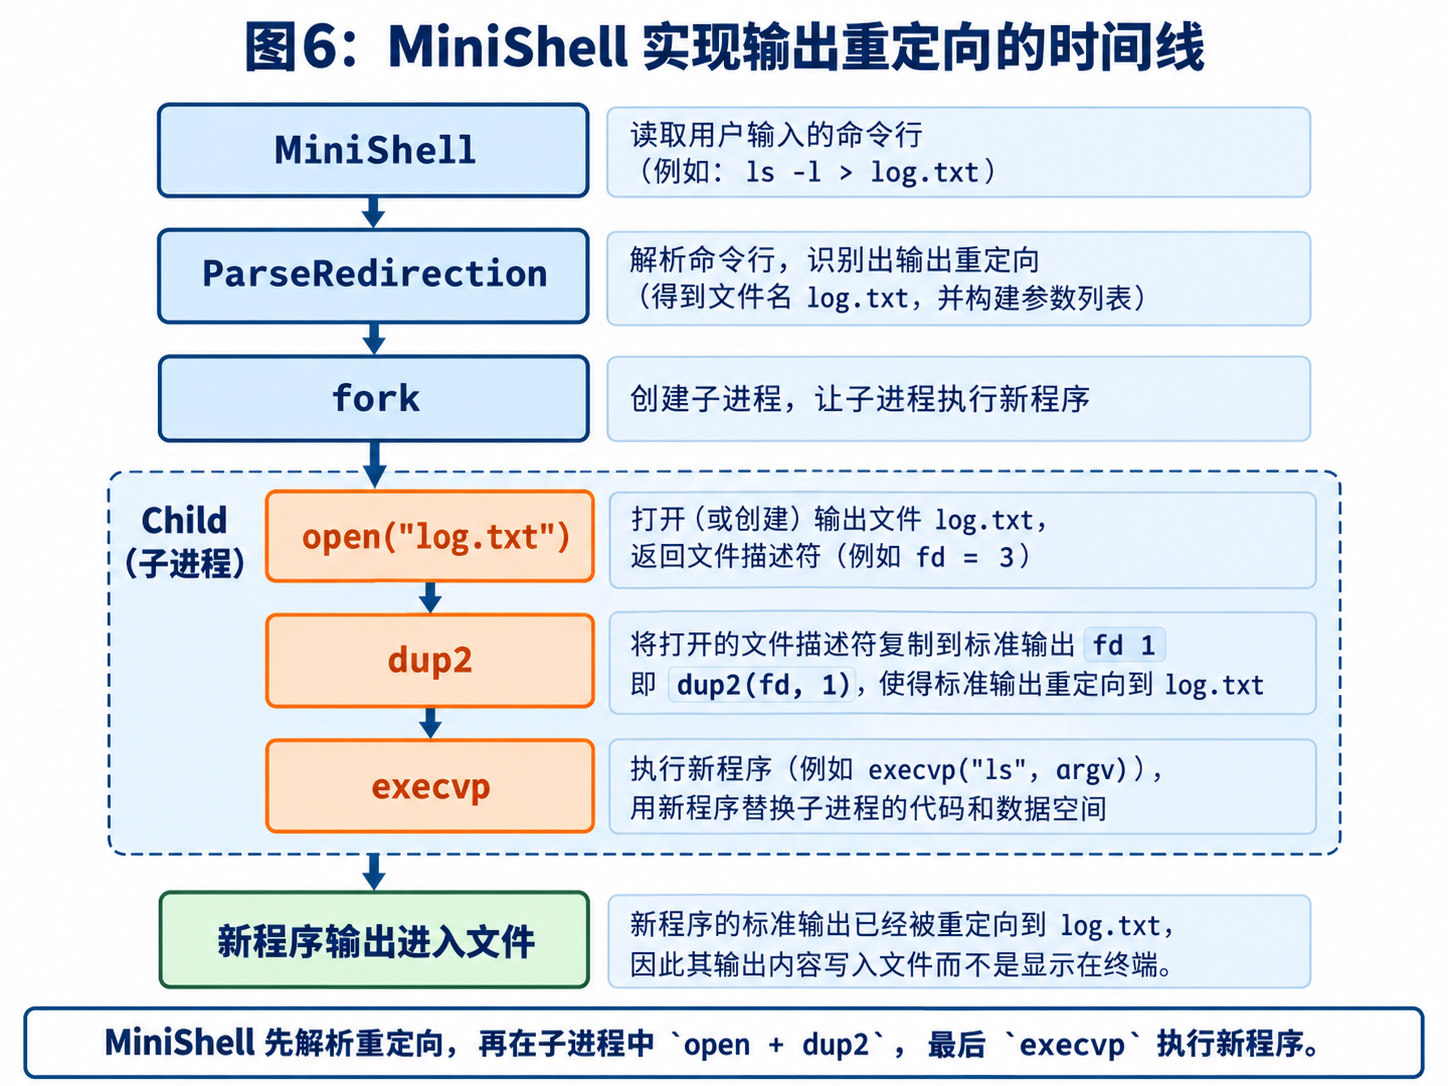
26.1 外部命令:ls > log.txt
用户输入:
bash
ls > log.txt解析后:
text
args = {"ls"}

redir.type = Output

redir.filename = "log.txt"
进入:
cpp
ExecuteExternal(cmd);然后:
text
fork()
   |
   +--------------------------+
   |                          |
   v                          v
父进程                     子进程
   |                          |
   |                          v
   |                 ApplyRedirection()
   |                          |
   |                          v
   |                 open("log.txt", ...)
   |                          |
   |                          v
   |                    dup2(fd, 1)
   |                          |
   |                          v
   |                    execvp("ls")
   |                          |
   |                          v
   |                      ls执行
   |                          |
   |                          v
   |                    输出进入文件
   |                          |
   v                          |
waitpid() <-------------------+
   |
   v
更新last_status
   |
   v
显示下一条命令提示符
这个过程中:
text
父进程Shell的标准输出始终没有被替换。
所以 Shell 能够正常显示下一次提示符。
26.2 内建命令:echo hello > log.txt
用户输入:
bash
echo hello > log.txt解析后:
text
args = {"echo", "hello"}

redir.type = Output

redir.filename = "log.txt"
进入:
cpp
ExecuteBuiltinWithRedirection(cmd, context);执行:
text
备份标准输出fd 1
       |
       v
将fd 1重定向到log.txt
       |
       v
执行ExecuteBuiltin()
       |
       v
cout输出hello
       |
       v
刷新输出
       |
       v
恢复原来的fd 1
因此:
text
hello进入 log.txt。
但后续 Shell 提示符仍然输出到终端。
这就是为什么内建命令和外部命令需要分别处理描述符恢复问题。
二十七、MiniShell重定向功能测试
27.1 编译程序
bash
g++ myshell.cpp \
    -std=c++11 \
    -Wall \
    -Wextra \
    -g \
    -o myshell
运行:
bash
./myshell27.2 测试覆盖输出重定向
bash
myshell$ echo hello > log.txt然后:
bash
myshell$ cat log.txt预期输出:
text
hello接着:
bash
myshell$ echo world > log.txt再次查看:
bash
myshell$ cat log.txt预期输出:
text
world因为 > 使用:
c
O_TRUNC会截断文件原有内容。
27.3 测试追加输出重定向
bash
myshell$ echo hello > log.txt
myshell$ echo world >> log.txt
myshell$ cat log.txt
预期输出:
text
hello
world
说明:
c
O_APPEND已经生效。
27.4 测试输入重定向
先创建:
bash
myshell$ echo hello Linux > input.txt执行:
bash
myshell$ cat < input.txt预期输出:
text
hello Linux这里 cat 没有接收到普通文件名参数。
它读取的是:
text
fd 0而 Shell 已经提前将 fd 0 重定向到 input.txt。
27.5 测试不带空格的重定向
bash
myshell$ echo hello>out.txt
myshell$ cat out.txt
预期:
text
hello因为我们解析时并不是单纯按空格识别 >,而是专门查找重定向符号。
27.6 测试外部命令输出
bash
myshell$ ls -l > list.txt
myshell$ cat list.txt
预期:
text
list.txt中保存 ls -l 的输出内容。
也可以测试:
bash
myshell$ pwd > pwd.txt
myshell$ cat pwd.txt
27.7 测试环境变量仍然有效
bash
myshell$ export MY_TEST=hello
myshell$ echo $MY_TEST > env.txt
myshell$ cat env.txt
预期:
text
hello这说明之前的 export 和 echo 功能没有被重定向扩展破坏。
27.8 测试退出状态
bash
myshell$ false
myshell$ echo $?
预期:
text
1再执行:
bash
myshell$ not_exist_command_12345
myshell$ echo $?
预期:
text
127说明:
text
fork
execvp
waitpid
last_status
整套机制仍然正常。
27.9 测试标准错误与标准输出的区别
执行:
bash
myshell$ ls /not_exist_12345 > result.txt典型情况下,你会发现:
text
错误信息仍然显示在终端而 result.txt 没有这些错误信息。
原因是:
text
>只重定向:
text
fd 1:标准输出但 ls 的错误消息通常写向:
text
fd 2:标准错误所以:
text
fd 1 ---> result.txt

fd 2 ---> 终端
这也是为什么真正的 Shell 还有:
bash
2>这样的错误输出重定向语法。
二十八、从重定向重新理解fd、FILE与缓冲区
现在可以把整篇文章的知识真正串起来。
28.1 当我们执行echo hello > log.txt时
我们自己的 echo 使用:
cpp
cout << "hello";其数据路径可以简化理解为:
text
C++标准输出流
       |
       v
用户态流缓冲
       |
       v
标准输出fd 1
       |
       v
内核打开文件对象
       |
       v
Page Cache等内核机制
       |
       v
log.txt对应的存储
Shell 使用:
c
dup2()改变的是:
text
fd 1引用的打开对象而不是直接去修改 cout 的输出语句。
28.2 当我们执行ls > log.txt时
过程:
text
MiniShell
    |
    v
fork()
    |
    v
子进程重定向fd 1
    |
    v
execvp("ls")
    |
    v
ls程序启动
    |
    v
ls向标准输出写数据
    |
    v
fd 1已经指向log.txt
    |
    v
数据进入log.txt
这里:
text
重定向与:
text
程序替换发生在同一子进程的不同阶段。
这正是前面进程控制和本篇基础IO之间最重要的联系。
二十九、基础IO常见错误总结
29.1 认为fd就是文件地址
错误。
fd 是:
text
当前进程文件描述符表中的编号并不是文件物理地址。
29.2 认为fd 1永远是显示器
错误。
fd 1 通常表示标准输出。
标准输出可以指向:
text
终端
文件
管道
Socket
等对象。
29.3 认为dup2会复制文件全部内容
错误。
c
dup2(fd, 1);不会复制文件数据。
它只是修改文件描述符的引用关系。
29.4 认为dup2成功后不能close原fd
错误。
如果:
c
dup2(fd, 1);成功,并且 fd != 1,通常可以:
c
close(fd);因为编号1已经建立了自己的引用。
29.5 认为FILE*和fd可以直接互换
错误。
c
FILE*是标准库文件流对象。
c
int fd是底层文件描述符。
如果需要连接两层接口,应使用适当的:
c
fileno()
fdopen()
同时遵守对应的资源所有权规则。
29.6 认为read会自动添加'\0'
错误。
c
read()按字节读取。
它不会保证缓冲区形成 C 风格字符串。
29.7 认为write一次一定写完
错误。
必须检查返回值。
某些情况下会发生部分写入。
29.8 认为fflush等于fsync
错误。
text
fflush主要针对标准IO用户态缓冲。
text
fsync用于请求底层文件数据同步。
两者不是同一层面的操作。
29.9 认为write没有任何缓冲
不准确。
write() 不经过 C 标准IO用户态缓冲。
但对于普通文件,内核仍可能使用 Page Cache。
29.10 在Shell父进程中重定向以后忘记恢复
这是实现 MiniShell 时很容易遇到的问题。
如果 Shell 自己的:
text
fd 1被永久改成了文件:
text
后面的Shell提示符也会进入文件。
所以内建命令需要格外注意描述符的备份与恢复。
三十、基础IO知识体系总结
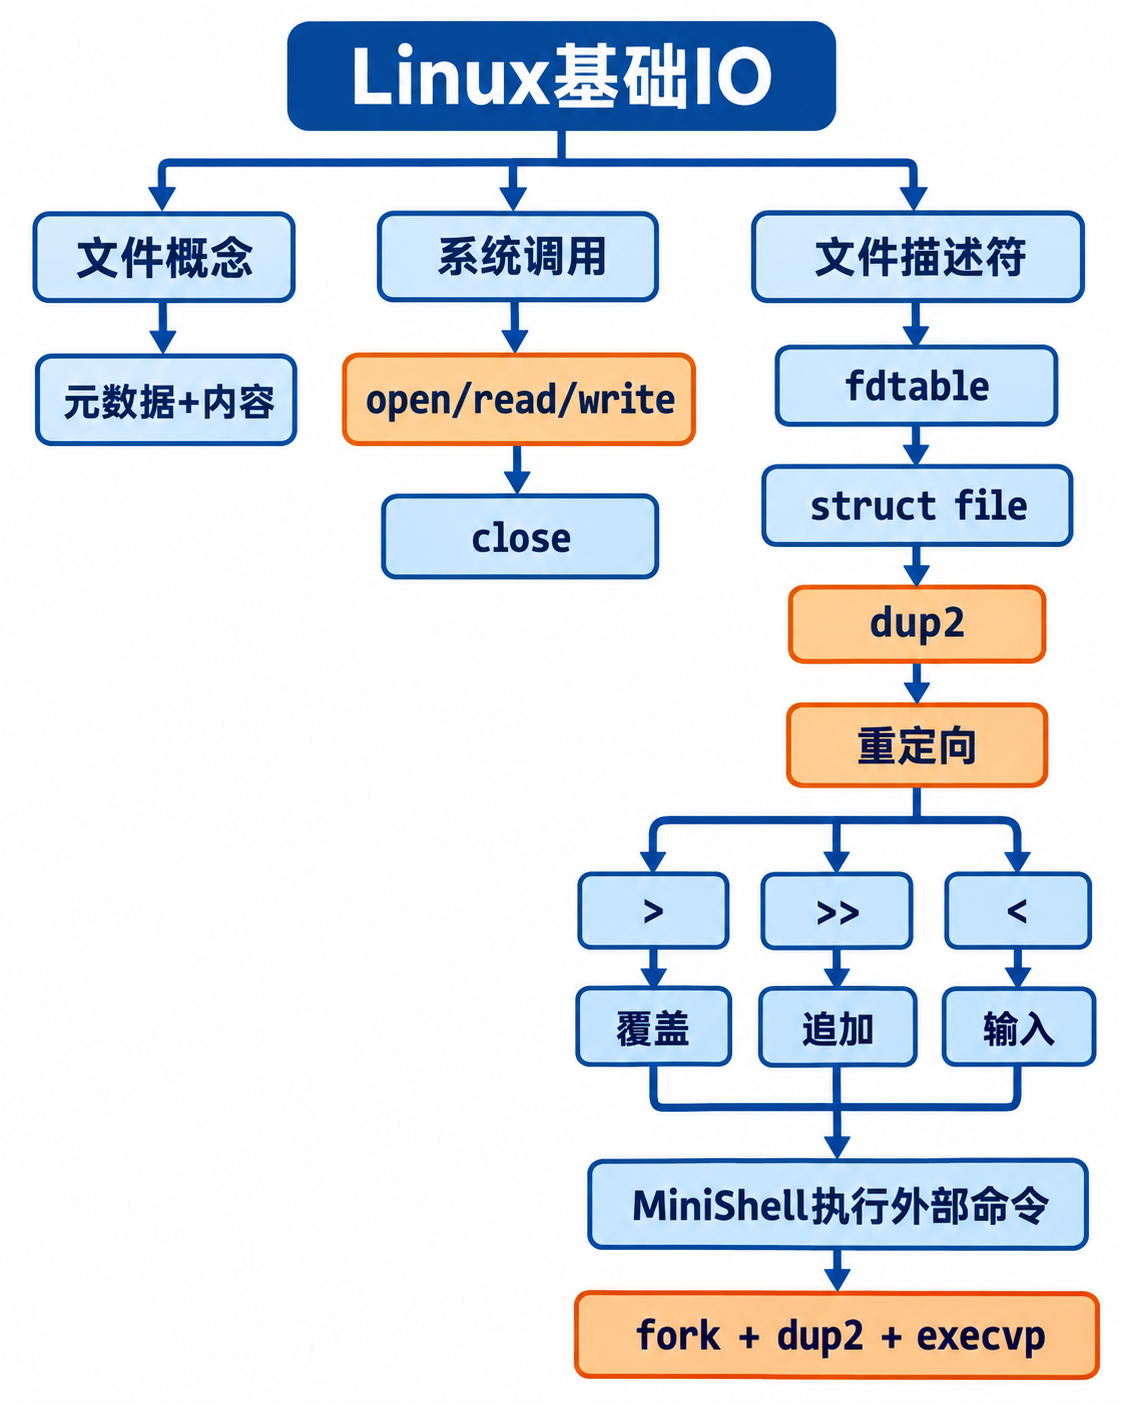
与此同时,还需要理解另一条重要关系:
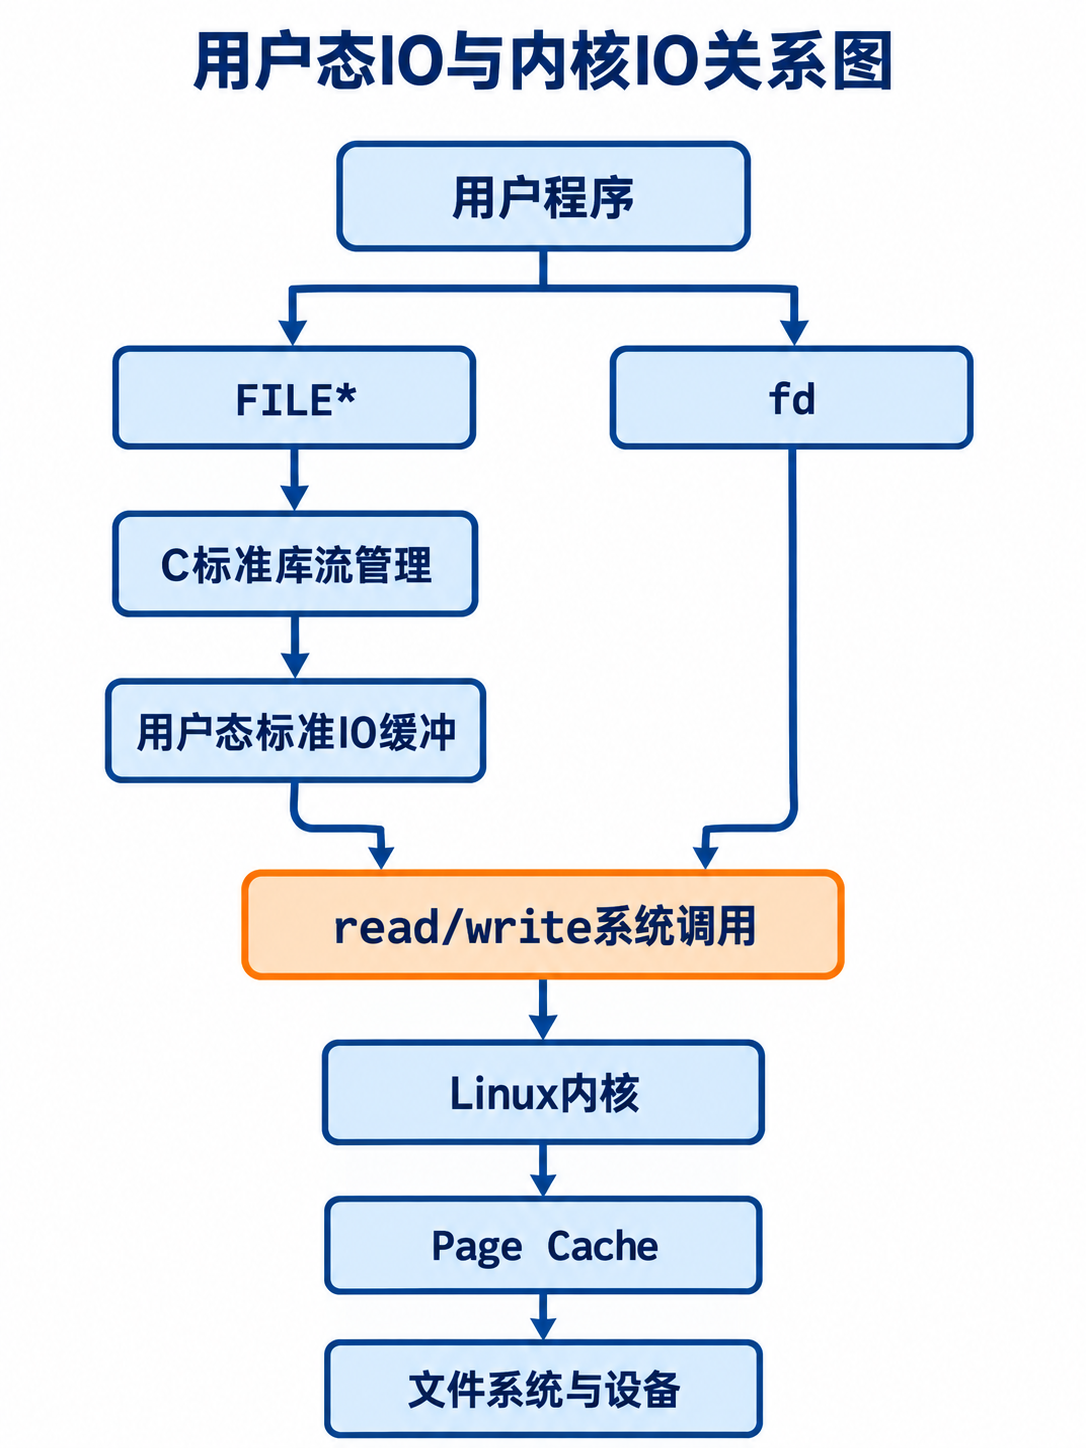
总结
本篇文章的核心是理解 Linux 文件 IO 的三个层次。
第一层:用户程序如何表示文件?
对于 C 标准库:
c
FILE* fp对于 Linux/POSIX 系统调用:
c
int fd两者服务于不同的抽象层次。
第二层:操作系统如何管理打开的文件?
通过:
text
进程
  |
  v
文件描述符表
  |
  v
内核打开文件对象
  |
  v
文件系统
完成文件访问。
因此:
文件描述符是连接进程与内核打开文件对象的重要接口。
第三层:数据是如何写入文件的?
对于标准库输出:
text
用户程序
    |
    v
标准IO用户态缓冲
    |
    v
write系统调用
    |
    v
内核文件缓存
    |
    v
存储设备
因此我们需要区分:
text
数据进入用户态缓冲和:
text
数据已经通过write交给内核以及:
text
数据完成持久化这三种不同状态。
最后,我们在原有 MiniShell 中加入:
text
ParseRedirection()
ApplyRedirection()
ExecuteBuiltinWithRedirection()
使原来只支持:
bash
ls -l
echo hello
的简易 Shell,进一步支持:
bash
ls -l > log.txt
echo hello >> log.txt
cat < log.txt
由此可以看出:
进程控制解决的是"谁来执行程序",文件描述符与重定向解决的是"程序从哪里读取数据、向哪里输出数据"。
当 fork()、execvp()、waitpid()、open() 和 dup2() 组合起来以后,一个简易命令解释器的基本工作机制就更加完整了。