Calibration:ECE 降低后,拒答阈值就可靠吗?
- 系列:开源 AI 论文复现实验与代码解读 · 第五轮 078
- 日期:2026-09-20
- 读者:研究生、科研新人和工程型研究者
- 复现范围:合成二分类上的温度拟合、校准指标与拒答协议;不复现原论文榜单。
目录
- 复现价值与论文假设
- 核心思想与公式
- 官方代码阅读路线
- 最小实验与运行方法
- 评测协议
- 实际结果与解释
- 失败排查与证据边界
- 后续科研问题
- 总结与参考资料
一、复现价值与论文假设
论文报告。 Guo、Pleiss、Sun、Weinberger 的 ICML 2017 论文研究神经分类器的概率校准,提出用单个温度参数做后处理,并在所测图像和文本任务上报告有效性。这是特定模型、数据和划分下的证据,不能直接替代今天任意大模型的测量。论文与全文
Geifman 与 El-Yaniv 的 NIPS 2017 工作讨论选择性分类:允许模型拒绝一部分输入,交换更低的接受集错误率。其风险控制论证依赖同分布独立采样等条件,还涉及统计上界。低 ECE 本身不构成这样的保证。论文全文
本次目标。 不训练大型网络,直接构造可追溯的分数失真,回答三个问题:能否恢复合理概率;是否改变预测答案和样本排序;校准集上的改进是否足以支持测试集拒答。这样做减少训练噪声,代价是不能据此判断真实网络为何过度自信。
二、核心思想与公式
logit 是归一化之前的类别分数。对样本的分数向量除以正温度,再经过 softmax,得到类别概率:
p i k ( T ) = exp ( z i k / T ) ∑ j = 1 K exp ( z i j / T ) , T ∗ = arg min T > 0 − 1 n ∑ i log p i , y i ( T ) . p_{ik}(T)=\frac{\exp(z_{ik}/T)}{\sum_{j=1}^{K}\exp(z_{ij}/T)},\qquad T^*=\arg\min_{T>0}-\frac1n\sum_i\log p_{i,y_i}(T). pik(T)=∑j=1Kexp(zij/T)exp(zik/T),T∗=argminT>0−n1∑ilogpi,yi(T).
这里分数矩阵为 [n,K],标签为 [n],温度是标量;负对数似然 NLL 衡量给真实标签分配的概率。本次只用校准集拟合温度,原始分数保持不动。正温度不会改变单个样本的最大分数类别;但这不意味着所有样本之间的最大概率排序都不变。公式来源
令置信度为最大类别概率,把它分进等宽区间,期望校准误差 ECE 的样本估计为:
E C E ^ = ∑ m = 1 M ∣ B m ∣ n ∣ a c c ( B m ) − c o n f ( B m ) ∣ . \widehat{\mathrm{ECE}}=\sum_{m=1}^{M}\frac{|B_m|}{n} \left|\mathrm{acc}(B_m)-\mathrm{conf}(B_m)\right|. ECE =∑m=1Mn∣Bm∣∣acc(Bm)−conf(Bm)∣.
B_m 是第几个分数箱对应的样本集合,两个均值分别是箱内准确率和置信度;空箱贡献零。它是经过分箱的总体摘要,不是单条预测的可靠性标签。本次保存每箱样本数,并同时计算 NLL 和两类别概率平方误差之和,即本文采用的 Brier 分数。
拒答规则则是只接受置信度不低于阈值的样本:
a i = 1 c i ≥ τ , C ^ = ∑ i a i n , R ^ = ∑ i a i 1 y \^ i ≠ y i ∑ i a i . a_i=\mathbf1c_i\\ge\\tau,\quad \widehat C=\frac{\sum_i a_i}{n},\quad \widehat R=\frac{\sum_i a_i\mathbf1\\hat y_i\\ne y_i}{\sum_i a_i}. ai=1ci≥τ,C =n∑iai,R =∑iai∑iai1y\^i=yi.
C 是覆盖率,R 是接受集错误率,阈值为标量。没有任何样本被接受时,风险没有定义,代码写入 null,不能用零冒充成功。
三、官方代码阅读路线
先读作者温度缩放仓库的维护说明,再打开 temperature_scaling.py。沿着三个入口看:temperature_scale 广播标量并除 logits;set_temperature 在评估模式、无梯度状态收集验证分数,再让 LBFGS 只更新温度;_ECELoss 按左开右闭区间计算加权误差,默认十五箱。
这里输入必须是 logits,不能把已经归一化的概率当分数再做一次 softmax。当前源码还有显式 CUDA 调用,温度本身是直接声明的参数,没有正值重参数化。本地实现改用正的逆温度区间求根;这是算法层面的对应,没有宣称运行旧版官方环境。两个仓库均按检索时的 master 阅读,未锁定提交,后续版本兼容性待人工核验。
再读选择性分类仓库和 risk_control.py:先确认 residuals 中一代表错误,再追踪排序、候选阈值与二项分布上界。本文采用的经验风险网格选择没有实现该上界,不能借用论文的高概率保证。
四、最小实验与运行方法
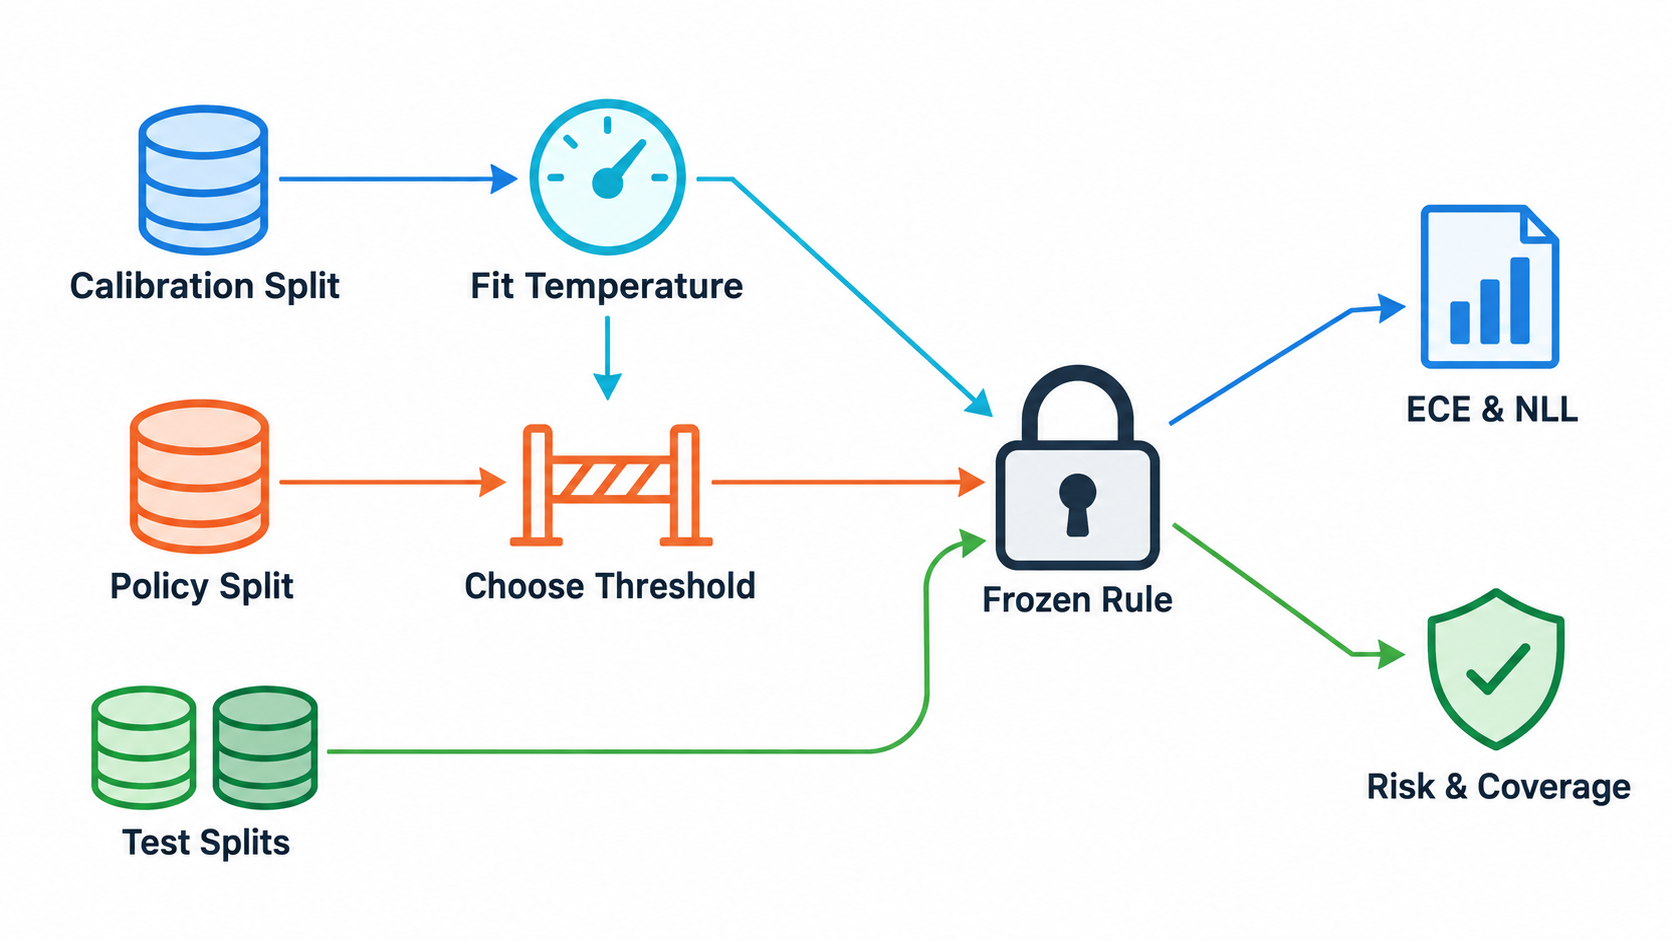
图中的三个数据入口分别承担拟合温度、选择阈值和最终评估;测试标签不会回流到前两步。锁表示温度与阈值已经冻结,右侧是两个不同的评估视角,不是保证通过的认证。
本次构造三维标准正态输入,令线性信号为 s=1.5x₁−0.8x₂+0.5x₃。同分布标签按 sigmoid(s) 抽样,冻结打分器输出 [0,3s],人为放大三倍造成过度自信。这个数据机制下温度三有明确意义,但有限校准样本估计不会恰好等于三。
分布变化组保持输入分布不变,只把标签概率改为 sigmoid(0.5s−1),即条件分布发生变化。这不是随机打乱标签,也不是自然语言领域迁移。设置在查看结果前固定;没有根据测试分数修改系数或挑种子。
每个种子生成校准集、阈值集各一千零二十四条,以及同分布、变化分布测试集各四千零九十六条;种子固定为 78、79、80。每组数据独立生成并检查完整输入行不重复。没有模型训练集,因为打分函数预先指定,唯一拟合参数是温度。
在文章目录运行:
bash
python3 -m pip install -r code/requirements.txt
python3 code/calibration.py
python3 code/audit.py
依赖与文件解释见 运行说明。实际环境为 Python 3.12.14、NumPy 2.3.5、CPU、双精度。程序打印 [1024,2] 分数与 [1024] 标签形状;逆温度在固定正区间内二分八十步求 NLL 导数的零点,保存轨迹。若根不在区间内会报错,避免静默输出边界解。
五、评测协议
先拟合温度,再分别对原始分数和校准分数在阈值集上扫描 0.50...0.99,步长零点零一。要求至少接受一百条且经验风险不超过一成,从可行候选中选择覆盖率最大者;无解则全部拒答。这里的一成只是选择条件,不是测试风险承诺。
两种策略冻结后,同时报告完整测试集准确率、NLL、Brier、五/十/十五/三十箱 ECE。对拒答,既报告统一的数值阈值零点九,也报告各自选出的阈值,始终成对报告风险和覆盖率。日志保存接受数、错误数和每条预测,避免只剩一个漂亮比例。
不要把校准集上的拟合损失直接当作泛化成绩。本文将温度拟合与阈值选择分开,仍然不能消除反复比较阈值带来的选择偏差;最终成绩只在独立测试集读取。若以后增加校准方法,方法选择也需要额外验证数据或嵌套划分,不能在当前测试集上挑最低 ECE 的方案。
二分类正温度缩放保持绝对 logit 差的顺序,因此按置信度排名截取相同数量样本,接受集合应一致。程序逐条比较排序和整条风险---覆盖率曲线;这个检查可以分辨概率刻度改善与筛选能力改善。多分类不能套用这一结论。
六、实际结果与解释
本次实际验证。 三次拟合温度为 2.7000、3.0224、3.0529。下表是三种数据种子的算术平均,误差项是种子间样本标准差,不是置信区间;完整结果见 实验记录。
| 测试分布与分数 | 全集准确率 | NLL | 十五箱 ECE |
|---|---|---|---|
| 同分布,原始 | 0.7558 | 0.7202 | 0.1451 ± 0.0016 |
| 同分布,校准 | 0.7558 | 0.4958 | 0.0174 ± 0.0058 |
| 条件变化,原始 | 0.6363 | 1.3834 | 0.2671 ± 0.0088 |
| 条件变化,校准 | 0.6363 | 0.7192 | 0.1310 ± 0.0120 |
固定阈值零点九时,同分布风险从 0.1623 降至 0.0579,覆盖率同时从 0.6799 降至 0.2206。校准后并没有突然会做更多题,而是同一个数值门槛变得严格。实际排序完全一致,相同覆盖率下风险曲线重合。
独立阈值集选出的校准阈值为 0.85、0.77、0.83,同分布测试风险平均 0.0987,覆盖率 0.4032。但种子 79 的风险为 0.1168,已经高于选择时的一成条件;不能用总体均值掩盖它。迁移到条件变化测试集后,平均风险升至 0.2769,覆盖率仍有 0.4176。
原始分数在种子 80 的预设网格中没有可行阈值,因此该策略覆盖率为零、风险未定义;更靠近一的阈值没有搜索,不能断言所有阈值都无解。这个差异还提醒我们:相同数值网格不代表相同候选接受集合,不能仅据网格结果宣布校准改善了排序。
七、失败排查与证据边界
先查统计定义。 附带二十条手工样例:十条置信度为零点六、九条答对;另十条置信度为零点九、六条答对。合成一个箱时 ECE 约为零,十箱时却为零点三。误差在大箱内相互抵消,足以说明单一分箱结果会隐藏问题;这不是本次模型的测试数据。
再查不变量。 温度为正时答案改变,应检查温度符号、类别轴、标签映射或浮点并列。多分类样例 [2,0,0] 与 [1.5,1.4,-10] 在温度一时最大概率分别约 0.787、0.525,温度十时约 0.379、0.434,跨样本顺序反转,却没有改变各自预测类别。
最后查证据范围。 两个脚本通过语法和 CPU 检查;独立标量审计重算保存的概率、各箱指标、阈值选择与风险曲线。开发时汇总器曾尝试对未定义风险取均值,已修正为保留空值,并记录有效种子数。详见 验证记录。
另外,生成标签的概率是实验者已知的,但温度拟合只读取抽样标签,不能偷看真实概率。这保留了有限样本估计的不确定性。三组种子一起改变了输入和标签,因此标准差描述的是本合成机制下的重复采样变化,不能解释成真实任务上的稳定性保证。
本次没有执行官方网络、真实数据集、GPU 或自由文本回答评测,也没有实现带置信上界的拒答算法。大模型自述"有九成把握"、某个 token 的概率和整段答案正确率是不同对象,迁移实验前必须先固定预测单位和正确性标签。
八、后续科研问题
作者推断。 下一步优先保持模型冻结,换入真实分类 logits,按来源、时间或主体分组划分数据,考察校准误差是否集中在小群体。需要保留组内样本量,避免把少量错误解释成稳定规律。
这些方向还需要区分总体校准与条件校准。即使整体分数对得上,也可能存在某一类别过度自信、另一类别不够自信的抵消。可以先报告预测类别或数据来源分组的可靠性表,再讨论是否需要分别拟合;分组参数更多,必须同步评估小样本过拟合。
第二步可在相同候选接受集合上比较经验阈值选择和统计风险上界,分别记录可行率、覆盖率与独立测试风险。第三步再研究多分类样本排序反转是否改变拒答效果。每一步只改变一个因素,才能判断收益来自概率校准、筛选顺序还是阈值搜索范围。
九、总结
温度缩放是理解校准的好入口:参数少、原理清楚、容易检查。但 ECE、完整集准确率和接受集风险回答不同问题。可复用的研究产物应同时保留温度拟合轨迹、分箱计数、阈值选择依据、逐样本预测和分布变化结果,让"分数更合理"成为可检查的陈述。
参考资料
以下一手来源均于 2026-09-20 实际检索并打开;仓库 master 未锁定提交,动态版本待人工核验。
- Chuan Guo, Geoff Pleiss, Yu Sun, Kilian Q. Weinberger. On Calibration of Modern Neural Networks . ICML 2017, PMLR 70:1321--1330。会议页;全文。支撑校准定义、温度目标与分箱指标。
- 作者官方 temperature_scaling 仓库;核心源码。支撑维护状态、logits 输入、温度优化和区间边界阅读。
- Yonatan Geifman, Ran El-Yaniv. Selective Classification for Deep Neural Networks . NIPS 2017。会议页;全文。支撑风险、覆盖率及同分布保证的条件。
- 作者官方 selective_deep_learning 仓库;risk_control.py。支撑经验错误与二项上界的区别。